Her gece saat ikide, başında ekran olmayan bir sunucu günün faturalarını PDF dosyasına çevirir. Kimse tarayıcı açmaz, ama her fatura bir tarayıcıdan geçer: HTML şablonu yüklenir, stil dosyası uygulanır, küçük bir betik toplamları ekler ve bitmiş sayfa dosyaya basılır. Bu tarayıcı hiçbir zaman pencere göstermez. Buna headless tarayıcı denir; aynı tür program uçtan uca testleri çalıştırır, ekran görüntüsü alır ve yapay zekâ ajanlarının sayfa okumasını sağlar.
Bu yazıda headless tarayıcının ne olduğunu, pencere olmadan neyin çalışmaya devam ettiğini, Chrome'un headless modunun bugün nasıl işlediğini, bir headless tarayıcıyı nasıl çalıştırıp yöneteceğinizi, basit bir HTTP isteğine göre maliyetini, sitelerin otomasyonla çalışan tarayıcılara neden farklı davranabildiğini ve nerede işe yaradığını anlatıyoruz. Komutları yerel bir test sayfasında çalıştırdık ve gördüklerimizi aktarıyoruz.
Headless tarayıcı nedir?
Headless tarayıcı, grafik arayüzü olmadan çalışan tam bir web tarayıcısıdır. Buradaki "head" (baş), görünen kısımdır: pencere, adres çubuğu, sekmeler ve menüler. Bunları çıkardığınızda geriye web sayfalarını yükleyip çalıştıran ve bir betikten ya da komut satırından talimat bekleyen motor kalır.
Tarayıcının basitleştirilmiş bir taklidi değildir. Chrome'un belgeleri headless modu tarayıcıyı "gözetimsiz bir ortamda" (unattended environment) çalıştırmanın yolu olarak tanımlar; iki mod aynı kodu paylaştığı için sayfa, her gün kullandığınız penceredekiyle aynı şekilde yüklenir, betikleri çalışır ve yerleşimi hesaplanır. curl gibi bir HTTP istemcisi ise HTML dosyasını indirir ve orada durur: sayfanın JavaScript'ini hiç çalıştırmaz, bu yüzden bir betiğin sonradan eklediği içerik hiç görünmez.
Pencere olmayınca ne çalışmaya devam eder?
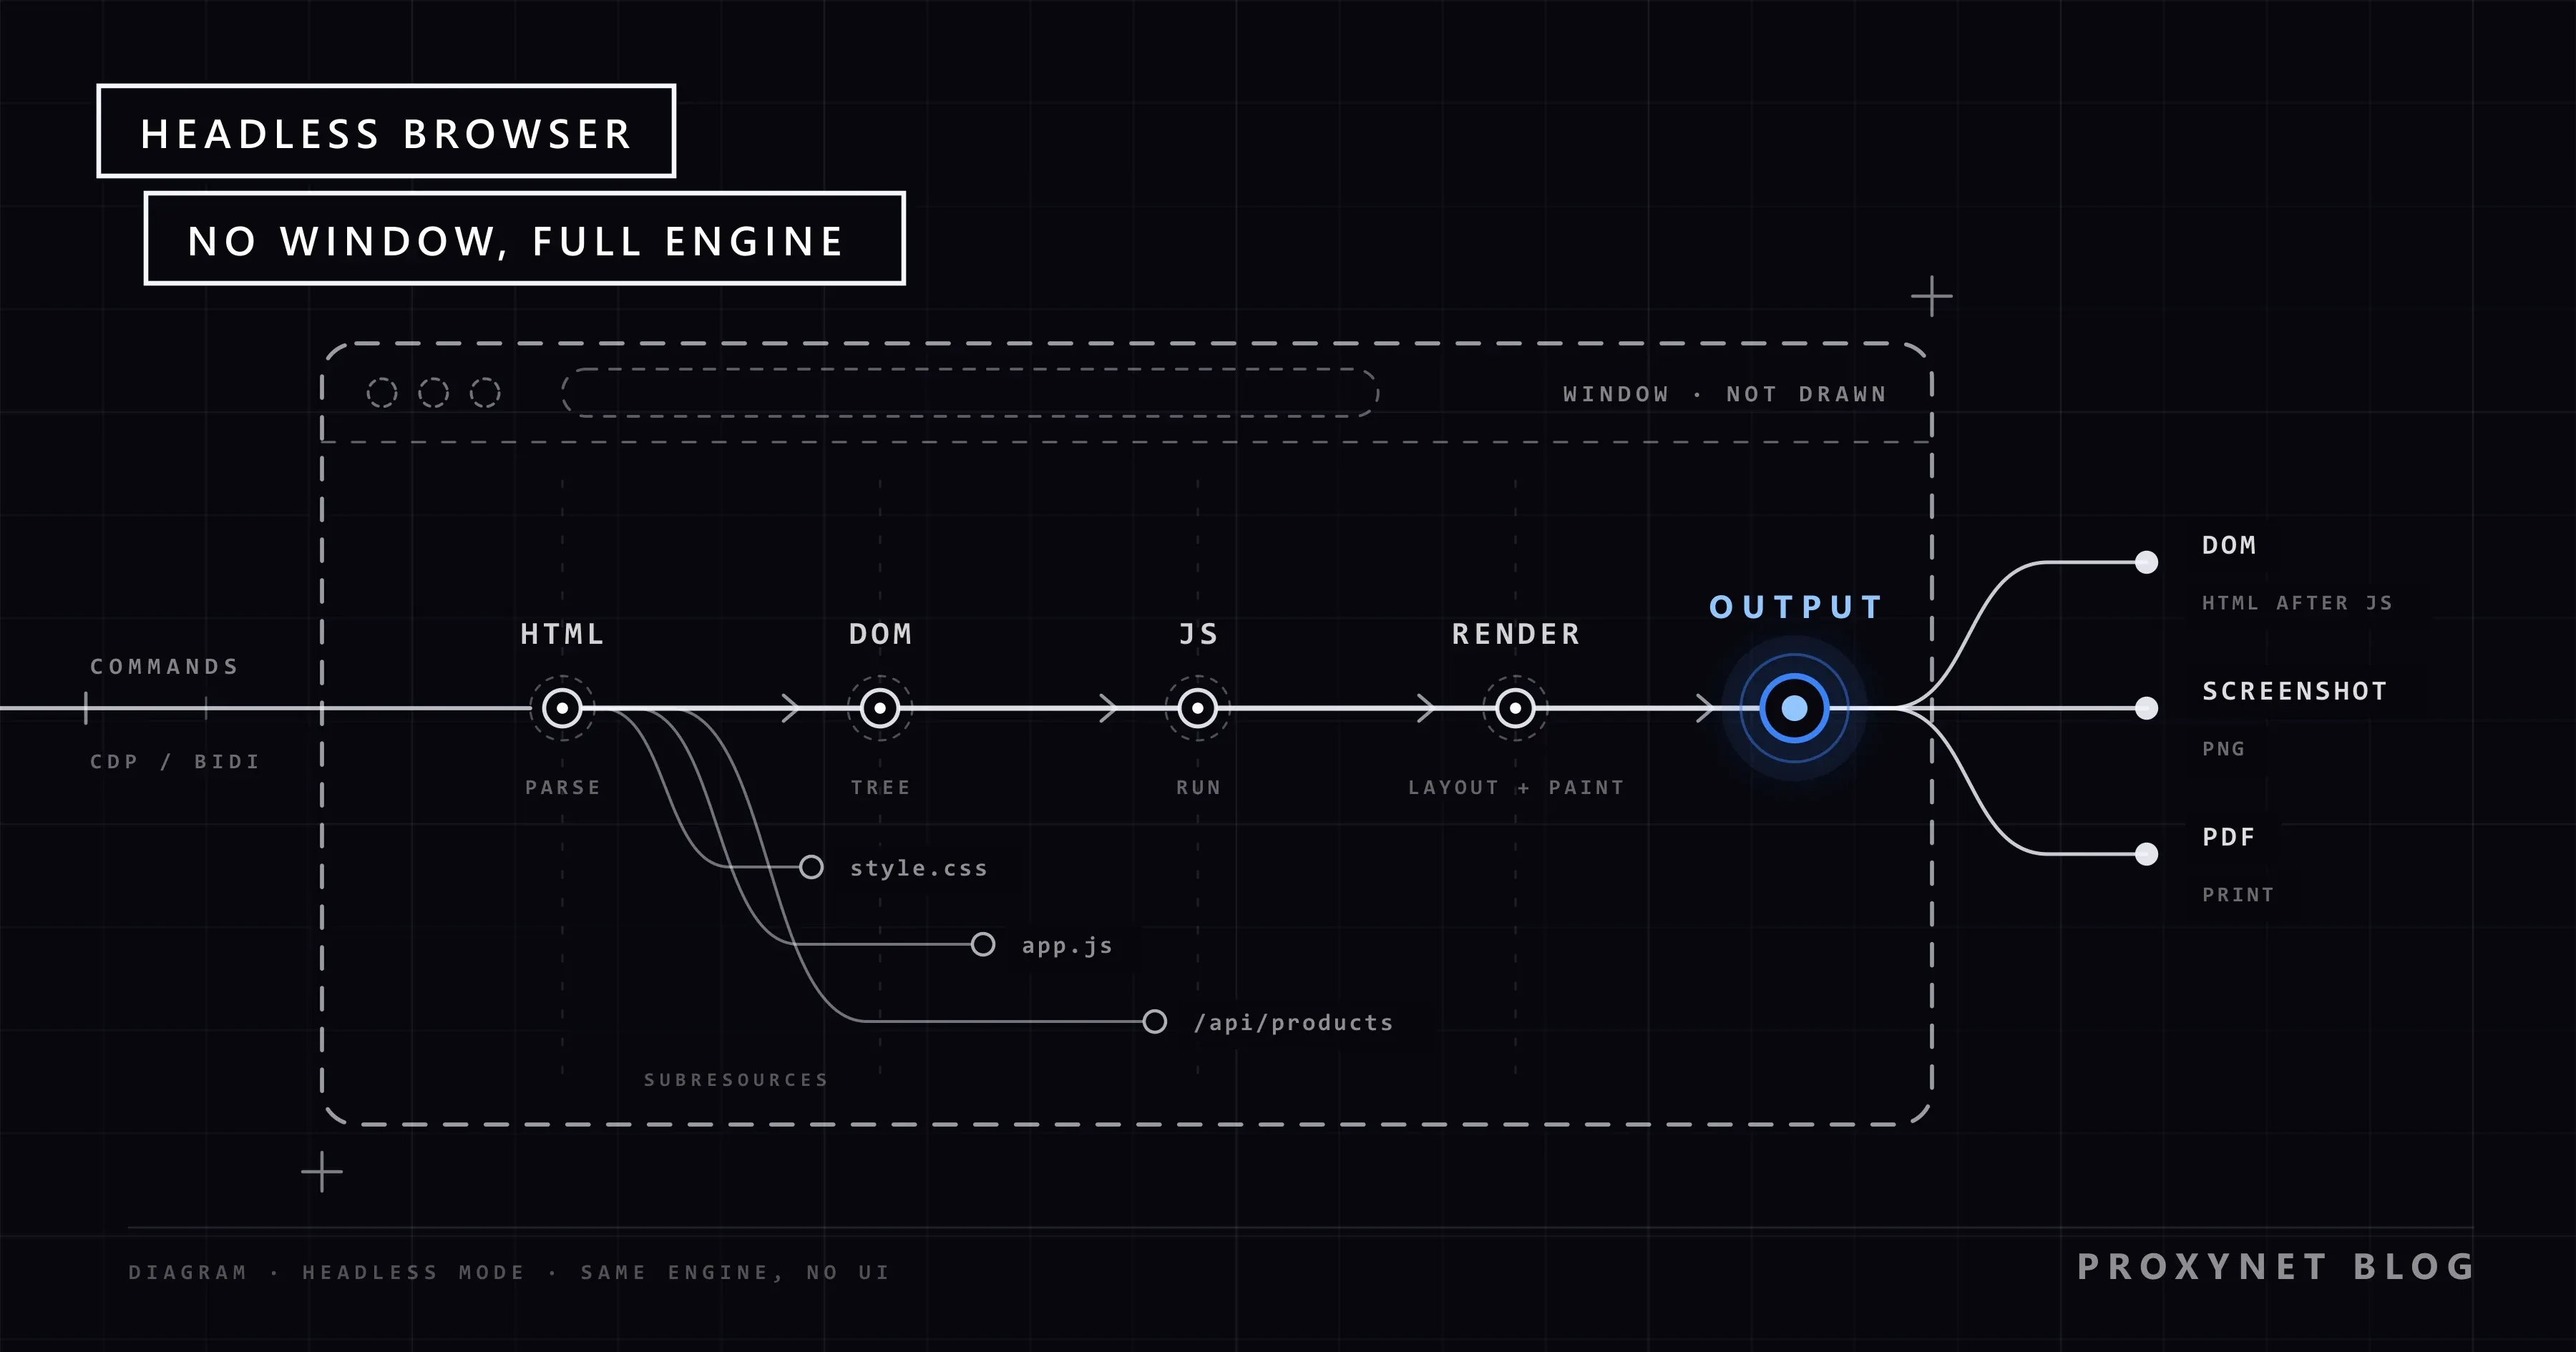
Neredeyse her şey çalışmaya devam eder; yalnızca insan için var olan parçalar ortadan kalkar. Headless tarayıcı bir sayfayı açarken normal tarayıcıyla aynı hattan geçer:
- Ağ. Alan adını çözer, TLS bağlantısı açar ve HTML'i ister; ardından sayfanın istediği her stil dosyasını, betiği, yazı tipini, görseli ve API çağrısını indirir. Çerezler ve depolama her zamanki gibi çalışır.
- DOM'a dönüştürme. HTML, DOM'a (Document Object Model) çevrilir; DOM, betiklerin okuyup değiştirdiği canlı öğe ağacıdır.
- Stiller. CSS kuralları öğelerle eşleştirilir.
- JavaScript. Betikler çalışır, ek veri çeker ve öğeleri yeniden yazar. Birçok modern sitede asıl içeriği sayfaya koyan adım budur.
- Yerleşim ve render. Motor, verilen pencere boyutuna göre her öğenin nereye düşeceğini hesaplar ve sonucu belleğe çizer.
- Çıktı. Sonuç ekrana değil programınıza gider: DOM'un o anki HTML hâli, bir ekran görüntüsü, bir PDF ya da betiğinizin sayfadan okuduğu değerler.
Eksik olan, arayüz ve başındaki insandır: pencere, adres çubuğu ve fare yoktur. Tıklamalar ve tuş vuruşları komut olarak gelir; yazdırma önizlemesi gibi normalde bir insanı bekleyen pencereler de "bu sayfayı PDF olarak kaydet" gibi doğrudan talimatlara dönüşür.
Chrome'un headless modu bugün nasıl çalışıyor?
Bugünkü headless Chrome, pencerelerini göstermeden çalışan gerçek Chrome'dur; eski ve ayrı uygulama ise chrome-headless-shell adlı bağımsız bir program olarak yaşamaya devam eder. İnternetteki kafa karıştırıcı tavsiyelerin çoğu bu ayrımdan gelir.
Headless mod yıllarca Chrome'la birlikte gelen, ama Chrome'un kendi tarayıcı kodunu paylaşmayan ayrı bir uygulamaydı; bu yüzden küçük noktalarda farklı davranıyordu. Chrome'un headless mod belgelerine göre Chrome'da artık headless ve pencereli modlar birleşiktir: Chrome 112'den itibaren headless Chrome platform pencerelerini oluşturur ama göstermez, diğer bütün işlevler de kullanılabilir. Chrome 132.0.6793.0'dan itibaren eski mod Chrome'un parçası değildir ve yalnızca Chrome for Testing panosundan indirilebilen chrome-headless-shell olarak dağıtılır.
Kütüphaneler farklı varsayılanlar seçti. Puppeteer'da varsayılan headless: true yeni modu başlatır, headless: "shell" ise shell'i seçer. Playwright varsayılan olarak headless çalışır ve bunun için ayrı bir Chromium headless shell sürümü kullanır; yeni moda chromium kanalıyla geçersiniz. Firefox'ta ise Firefox 56'dan beri bütün platformlarda -headless parametresiyle açılan bir headless mod vardır.
Headless tarayıcı komut satırından nasıl çalıştırılır?
Tarayıcının başlatma komutuna --headless ve hangi çıktıyı istediğinizi söyleyen bir parametre eklersiniz. Chrome'un headless komut satırı başvurusu şu parametreleri belgeler: --dump-dom (betikler çalıştıktan sonraki DOM'u yazdırır), --screenshot (PNG kaydeder), --print-to-pdf (PDF kaydeder) ve iki zamanlama parametresi, --timeout ile --virtual-time-budget. Örneklerdeki chrome, Chrome programınızın yerine geçer: Linux'ta google-chrome, Windows'ta chrome.exe dosyasının tam yolu.
# Sayfanın betikleri çalıştıktan sonraki DOM'u yazdır
chrome --headless --dump-dom https://example.com

# Seçilen pencere boyutunda ekran görüntüsü kaydet
chrome --headless --window-size=1280,800 --screenshot https://example.com

# Sayfayı tarih ve URL içeren üst/alt bilgi olmadan PDF olarak kaydet
chrome --headless --no-pdf-header-footer --print-to-pdf https://example.com

# Zamana bağlı betiklere DOM yazdırılmadan önce 5 saniyelik sanal süre ver
chrome --headless --virtual-time-budget=5000 --dump-dom https://example.com
Test makinemizde (Windows 11, Chrome 157) 127.0.0.1 üzerinde küçük bir test sayfası sunduk; sayfadaki ürün listesini JSON çeken bir betik dolduruyordu. Chrome'u yalnız bu test için açtığımız ayrı bir profil klasörüyle çalıştırdık. curl, listesi boş sayfayı döndürdü. İlk --dump-dom denemesi de aynı boş listeyi verdi: DOM, betiğin isteği sunucumuza ulaşmadan yazdırılmıştı. --virtual-time-budget=5000 ekleyince DOM çıktısında, ekran görüntüsünde ve PDF'te üç ürün de göründü.
Headless tarayıcılarda en sık yaşanan sürpriz budur: "sayfa yüklendi" ile "içerik geldi" farklı anlardır. Kodda sabit bir bekleme yerine ihtiyacınız olan öğeyi ya da yanıtı bekleyin.
Headless tarayıcı koddan nasıl yönetilir?
Headless tarayıcı bir otomasyon protokolüyle yönetilir: programınız bir bağlantı üzerinden "bu URL'yi aç" ya da "ekran görüntüsü al" gibi komutlar gönderir, tarayıcı da yanıt verir ve olayları bildirir. Bugün üç protokol önemlidir.
- Chrome DevTools Protocol (CDP). Chrome'un geliştirici araçlarının arkasındaki protokoldür; Chrome ve Edge gibi Chromium tabanlı tarayıcılarda bulunur. WebSocket üzerinden çalışır ve sayfalara, ağa ve DOM'a alt seviyede erişim verir.
- WebDriver (klasik). Selenium'un dayandığı W3C standardıdır: HTTP üzerinden istek ve yanıt, her tarayıcı için ayrı bir sürücü (driver) programıyla.
- WebDriver BiDi. İki yönlü iletişim getiren daha yeni bir W3C protokolüdür; tarayıcı konsol mesajları ve ağ etkinliği gibi olayları programınıza akıtabilir. WebDriver BiDi spesifikasyonu 13 Kasım 2026 tarihli bir W3C çalışma taslağıdır (Working Draft); Firefox'un uzaktan yönetim protokolleri WebDriver BiDi ve Marionette'tir.
Test Chrome'umuzu --remote-debugging-port=9333 ile başlattığımızda http://127.0.0.1:9333/json/version adresi tarayıcı sürümünü, "Protocol-Version": "1.3" bilgisini ve CDP komutları için bir WebSocket adresini döndürdü. Chrome 136'dan beri bu hata ayıklama parametreleri varsayılan profil klasöründe dikkate alınmaz ve başka bir klasörü gösteren --user-data-dir ister; Google bu değişikliği, zararlı yazılımların hata ayıklama portunu çerezleri okumak için kullanması üzerine yaptı.
Çoğu kişi protokol mesajlarını elle yazmaz; kütüphaneler bu işi üstlenir. Puppeteer varsayılan olarak Chrome'la CDP, Firefox'la WebDriver BiDi kullanır; Playwright birkaç dilden Chromium, Firefox ve WebKit sürümlerini yönetir; Selenium WebDriver kullanır ve altyapısını WebDriver BiDi'ye taşımaktadır. Üçü de headless ya da pencereli çalışabilir. Playwright ile Selenium'un bekleme, proxy ve dil desteğindeki farkları Playwright ve Selenium Farkı yazısında karşılaştırılıyor.
Headless ve pencereli tarayıcı arasındaki fark nedir?
Headless ve pencereli (headful) tarayıcılar sayfayı aynı motorla yükler; fark, sayfayı kimin izlediğinde ve çıktının ne olduğundadır.
| Konu | Headless | Pencereli |
|---|---|---|
| Pencere | Ekranda yok | Görünür pencere |
| Girdi | Koddan komutlar | Fare, klavye ya da kod |
| Çıktı | DOM, ekran görüntüsü, PDF, veri | Ekranda gördüğünüz |
| Nerede çalışır | Sunucu, CI, konteyner | Ekranı olan bir masaüstü |
| Hata ayıklama | Log, iz kaydı, ekran görüntüsü | Sayfayı canlı izleme |
| Tipik iş | Test, PDF, zamanlanmış görev | Betik yazma ve hata ayıklama |
Uygulamada ekipler ikisini birlikte kullanır: bir testin hata ayıklaması, tıklamanın nereye düştüğü görülebilsin diye pencereli modda yapılır; test sonra ekranı olmayan bir derleme sunucusunda headless çalışır. Bir betik iki modda farklı davranıyorsa önce zamanlamaya ve pencere boyutuna bakın; daha dar bir varsayılan pencere, duyarlı (responsive) bir sayfayı mobil düzenine geçirebilir.
Headless tarayıcının maliyeti bir HTTP isteğine göre ne kadardır?
Headless tarayıcı bir HTTP isteğinden çok daha pahalıdır, çünkü tek bir dosya yerine bütün sayfayı indirip çalıştırır ve bunun için birkaç süreci birden açık tutar.
Yerel testimiz farkı gösterdi. curl test sunucumuza tam olarak bir istek gönderdi; headless Chrome'da tek bir sayfa yüklemesi beş istek üretti: HTML, stil dosyası, betik, JSON çağrısı ve site simgesi. Gerçek bir mağaza sayfası ise onlarca görsele, yazı tipine ve betiğe başvurur. Tek sayfası açık bir headless Chrome için Windows on iki chrome.exe süreci listeledi (bir tarayıcı süreci, yedi render süreci, bir GPU süreci ve yardımcılar); bunlar birlikte yüzlerce megabayt bellek kullanıyordu.
Bu yüzden tarayıcıyı yalnızca sayfa gerçekten gerektirdiğinde kullanın. Veri HTML'in içindeyse ya da sayfanın çağırdığı bir JSON endpoint'inden geliyorsa basit bir HTTP isteği daha hızlı ve daha hafiftir; elinizdeki sayfanın hangi türden olduğunu nasıl anlayacağınız Statik ve Dinamik Sayfalar yazısında anlatılıyor.
Headless tarayıcıda proxy nerede devreye girer?
Proxy, headless tarayıcının trafiğine seçtiğiniz konumda bir çıkış IP'si verir; bu, fiyatları, dili ya da sonuçları ülkeye göre değişen sayfalarda önemlidir. Her kütüphane başlatma ya da bağlam (context) ayarlarında bir proxy sunucu kabul eder ve tarayıcı bundan sonra sayfanın bütün isteklerini onun üzerinden gönderir.
Bundan iki sonuç çıkar. Bant genişliği: Residential Proxy gibi gigabayt başına ücretlendirilen bir proxy kullanıyorsanız her görsel, yazı tipi ve betik hesaba girer; ihtiyacınız olmayan kaynakları engellemek faturayı istediğiniz veriye yakın tutar. Tutarlılık: tek bir sayfa ziyareti çok sayıda istektir ve sticky oturum, normal bir ziyaretçide olduğu gibi bu istekleri tek bir IP adresinde tutar.
Bir ekip büyük ölçekte sayfa verisine ihtiyaç duyuyor ama bir tarayıcı filosu işletmek istemiyorsa, Web Scraping API'miz satış ekibimiz üzerinden yönetilen sayfa çıkarma hizmeti sunar.
Siteler otomasyonla çalışan tarayıcılara neden farklı davranır?
Siteler otomasyonla çalışan tarayıcılara farklı davranabilir, çünkü bir siteyi zorlayan ya da kullanım koşullarını çiğneyen trafik çoğu zaman otomasyondan gelir ve otomatik bir tarayıcı tanınabilir izler taşır. Site niyeti göremez; sinyalleri görür ve kurallarını uygular.
Bazı sinyaller açıkça beyan edilir. Testimizde headless Chrome'un her isteğindeki User-Agent başlığı, tarayıcının varsayılan olarak kendini tanıttığı HeadlessChrome/157.0.0.0 ifadesini içeriyordu. W3C WebDriver standardı, tarayıcı uzaktan yönetildiğinde true olan navigator.webdriver özelliğini, sayfaya otomasyon altında olduğunu bildirmenin standart yolu olarak tanımlar. Siteler bunların yanında istek hızına, gezinme düzenine ve IP itibarına da bakar; bu katmanların tek bir puana nasıl dönüştüğü Bot Tespiti Nasıl Yapılır? yazısında anlatılıyor.
Meşru yol, bu kuralların etrafından dolaşmak değil, onlarla birlikte çalışmaktır. Sitenin robots.txt dosyasını okuyun; bu dosya, otomatik istemcilerin hangi yolları ziyaret edebileceğini belirtir. RFC 9309 bu dosyayı standartlaştırır ve kurallarının bir erişim yetkisi sayılmadığını not eder; bu yüzden sitenin kullanım koşullarını da okuyun. İstek hızını düşük tutun, varsa resmî API'yi kullanın ve site istiyorsa otomasyonunuzu tanıtın. Bu yazı, otomasyonu gizlemeyi ya da bot kontrollerini aşmayı anlatmaz.
Headless tarayıcı ne işe yarar?
Headless tarayıcı, bir programın sayfayı tam olarak bir tarayıcının kuracağı hâliyle görmesi gereken her yerde kullanılır.
- Otomatik test. Uçtan uca testler, her kod değişikliğinde gerçek uygulamada kayıt ya da ödeme adımlarını tıklayarak geçer; bunu ekranı olmayan derleme sunucularında yapar.
- PDF ve ekran görüntüsü. Fatura, rapor ve biletler HTML olarak tasarlanıp PDF'e basılır; bağlantı önizlemeleri ve görsel regresyon testleri ekran görüntüsü kullanır.
- İzleme. Zamanlanmış kontroller önemli sayfaları yükler, sürelerini ölçer, bir düğmenin ya da fiyatın yerinde olduğunu doğrular ve bir şey bozulduğunda uyarı verir.
- Yapay zekâ ajanları. Kullanıcı adına web'de gezinen ajanlar, aynı protokollerle gerçek bir tarayıcı yönetir; sunucuda headless, bir kişi izlerken pencereli.
- JavaScript ile kurulan sayfaları okuma. İçerik yalnızca betikler çalıştıktan sonra oluşuyorsa ve site otomatik erişime izin veriyorsa, headless tarayıcı sayfayı fiyat takibi ya da pazar araştırması için render eder.
- Ön render (pre-rendering). Bazı siteler JavaScript sayfalarını önceden statik HTML'e çevirir; böylece ziyaretçiler ve crawler'lar bitmiş içeriği alır.
Sık yapılan hatalar
- Statik bir sayfa için tarayıcı başlatmak. Veri HTML'in içindeyse curl ya da herhangi bir HTTP kütüphanesi işi kaynakların çok küçük bir kısmıyla görür.
- Sayfayı çok erken okumak. "Yüklendi", "hazır" demek değildir; sabit bir bekleme yerine ihtiyacınız olan öğeyi ya da yanıtı bekleyin.
- Otomasyonu günlük profilinizde çalıştırmak. Ayrı bir profil klasörü kullanın; Chrome 136'dan beri uzaktan hata ayıklama zaten varsayılan profili reddediyor.
- Eski parametre tavsiyelerini kopyalamak.
--headless=newya da eski headless moddan bahseden yazılar, Chrome 132 ile değişen bir ayrımı anlatır. - Headless çalışmanın sitelere görünmez olmak demek olduğunu sanmak. Varsayılan User-Agent ve
navigator.webdriverotomasyonu açıkça beyan eder. - robots.txt'yi ve hız sınırlarını (rate limit) yok saymak. Tarayıcı sayfa başına bir HTTP istemcisinden çok daha fazlasını yükler; özensiz bir döngü siteye çok daha fazla yük bindirir.
- Arkada süreç bırakmak. İş bitince tarayıcıyı kapatın, yoksa sunucu sahipsiz süreçlerle dolar.
Karar rehberi
| Durumunuz | Ne kullanmalı |
|---|---|
| Veri sayfanın HTML'inde | Basit bir HTTP isteği |
| Sayfa verisini bir JSON çağrısıyla alıyor | O endpoint'i, sitenin koşulları içinde isteyin |
| İçerik yalnızca betikler çalışınca beliriyor | Headless tarayıcı |
| Derleme sunucusunda uçtan uca test | Headless, hata ayıklaması pencereli |
| Bir sayfanın PDF'i ya da ekran görüntüsü | Headless Chrome parametreleri ya da bir kütüphane |
| Ajan, kullanıcının izlediği sayfalarda çalışacak | Otomasyonlu, pencereli tarayıcı |
| Site resmî bir API sunuyor | Tarayıcı değil, API |
Sıkça sorulan sorular
Headless tarayıcı ne demek?
"Başı", yani görünen penceresi ve arayüzü olmadan çalışan tarayıcı demektir. Motor normal çalışır, ama talimatları koddan ya da komut satırı parametrelerinden alır ve sayfayı ekrana çizmek yerine HTML, ekran görüntüsü, PDF ya da veri döndürür.
Headless tarayıcı normal tarayıcıdan daha hızlı mı?
Pek değil. Ekrana çizim yapmaz, ama ağ, JavaScript ve yerleşim işi iki modda da aynıdır; ikisi de tek bir dosyayı indiren basit bir HTTP isteğinden çok daha yavaştır.
Chrome headless modda nasıl çalıştırılır?
Chrome'u --headless ile ve --dump-dom, --screenshot ya da --print-to-pdf gibi bir çıktı parametresiyle başlatın. Tek bir çıktıdan fazlası için Chrome'u headless başlatıp yöneten Puppeteer, Playwright ya da Selenium gibi bir kütüphane kullanın.
chrome-headless-shell ile Chrome'un headless modu aynı şey mi?
Hayır. chrome-headless-shell, Chrome 132'den beri kendi programı olarak dağıtılan eski ve ayrı headless uygulamasıdır. --headless ile açılan Chrome, pencereleri görünmeyen gerçek Chrome'dur; shell ise Chrome'un kendi tarayıcı kodunu paylaşmayan ayrı bir programdır.
Yapay zekâ ajanları headless tarayıcı kullanır mı?
Birçoğu kullanır. Web sayfalarını okuyan ya da sayfalarda işlem yapan bir ajan çoğu zaman CDP ya da WebDriver BiDi üzerinden gerçek bir tarayıcıyı yönetir; sunucuda headless, bir kişi takip ederken pencereli çalışır. Basit sayfalardan yalnızca metin alan ajanlar basit HTTP istekleriyle yetinebilir.
Headless tarayıcı kullanmak yasal mı?
Headless tarayıcı çalıştırmak sıradan bir yazılım kullanımıdır; test, PDF üretimi ve kendi sitelerinizi izlemek özel bir soru doğurmaz. Başkalarının sitelerinde ise kullanım koşullarına ve robots.txt'ye uyun, istek hızını makul tutun ve kişisel verilerle ilgili kurallara dikkat edin. Bu genel bir bilgilendirmedir, hukuki danışmanlık değildir.
Özet
Headless tarayıcı, penceresi olmayan eksiksiz bir tarayıcıdır: sayfayı yükler, JavaScript'i çalıştırır, sonucu render eder ve programınıza HTML, ekran görüntüsü, PDF ya da veri olarak verir. Chrome'un headless modu artık gerçek Chrome'dur, eski uygulama ise chrome-headless-shell olarak sürüyor; kütüphaneler onu CDP, WebDriver ya da WebDriver BiDi ile yönetir. Tarayıcıyı yalnızca sayfa gerektirdiğinde kullanın, yükleme olayını değil içeriği bekleyin, istek hızını ölçülü tutun ve sayfa konuma göre değişiyorsa trafiği doğru ülkedeki bir proxy üzerinden geçirin.