


































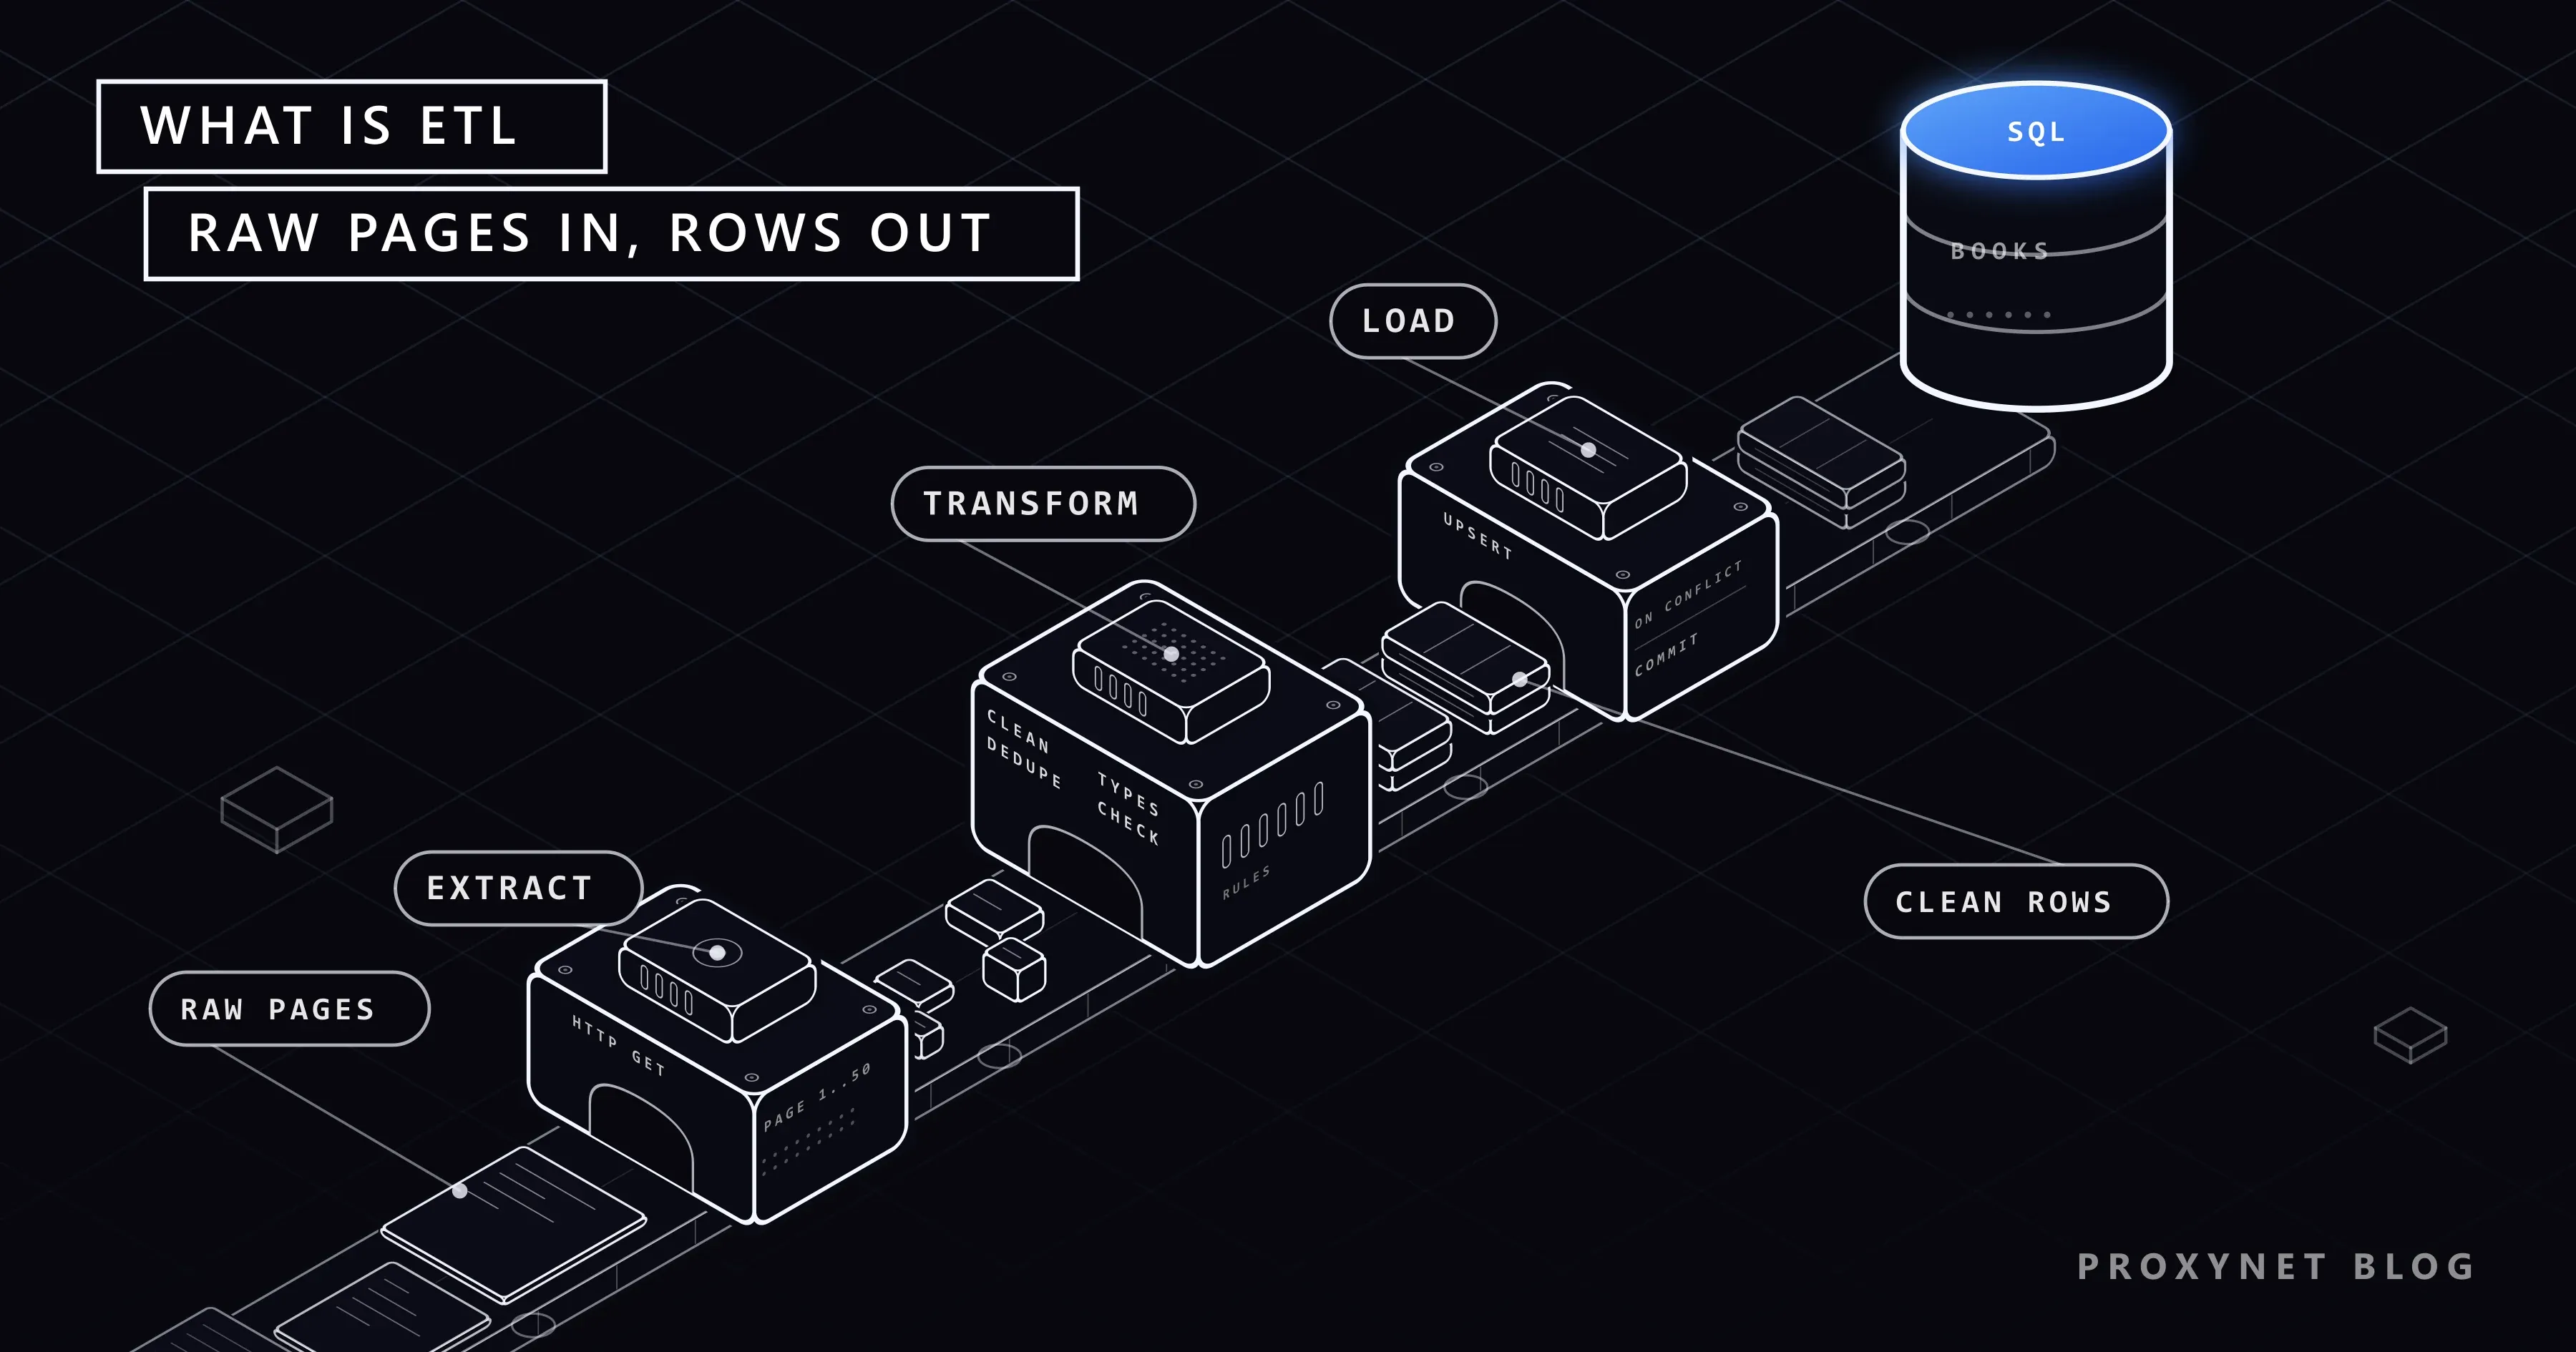
Geçen ay sorunsuz çalışan bir scraper, bugün bir tabloyu £51.77 gibi fiyatlarla, aynı kitabın üç kopyasıyla ve "In stock" ile "In stock (19 available)" değerlerinin yan yana durduğu bir sütunla dolduruyor. Bu verinin grafiğini kimse çizemez. Scraper kendi işini yaptı; eksik olan, ondan sonra gelen her şey: ham sayfa metnini türü belli, tekrarlardan arındırılmış satırlara çevirmek ve bir sonraki çalıştırmada kaybolmayacağı bir yerde saklamak. Bu eksik parçanın bir adı var ve web scraping'den daha eski: ETL.
Bu yazıda ETL'nin ne anlama geldiğini, üç adımın her birinin ne yaptığını ve bir ETL hattının (pipeline) tetiklenmesinden hazır tabloya kadar nasıl işlediğini anlatıyoruz. ETL'yi ELT ile karşılaştırıyor, bir betiği gerçek bir hattan ayıran iki özelliğe (güvenle yeniden çalıştırma ve izleme) bakıyor, ardından bir scraping deneme sitesinden kitap verisi çıkaran, bu veriyi temizleyen ve SQLite'a yükleyen, eksiksiz ve test edilmiş bir Python işi kuruyoruz. Son bölümlerde kullanım alanlarını, sık yapılan hataları ve kısa bir karar rehberini bulacaksınız.
ETL nedir?
ETL bir veri entegrasyonu sürecidir: Veri bir ya da birden çok kaynaktan alınır, sizin belirlediğiniz kurallarla yeniden biçimlendirilir ve sorgulanabileceği tek bir depoya yerleşir. Microsoft'un mimari rehberi ETL'yi, farklı kaynaklardan gelen veriyi tek bir veri deposunda birleştiren ve dönüşümü yüklemeden önce iş kurallarına göre uygulayan bir süreç olarak tanımlar.
Kavram veri ambarcılığından gelir, ama scraping'e de aynı ölçüde uyar. Bir web sitesi de diğerleri gibi bir kaynaktır, yalnızca daha dağınıktır: Verisi insanlar için biçimlendirilmiştir, sayfalara bölünmüştür ve haber vermeden değişebilir. Bir scraper yazıp ardından çıktısını düzeltmek için ikinci bir betik yazdıysanız, bir ETL hattının üçte ikisini zaten kurmuşsunuz demektir.
Her adım ne yapar?
Çıkarma (extract) ham veriyi toplar ve onu olabildiğince az değiştirir. Web verisinde bu, istek göndermek, sayfalandırmayı izlemek ve ihtiyaç duyduğunuz alanları HTML'den almak demektir. Çıktı hâlâ metindir: "£51.77", "Three", "\n In stock\n". Çıkarma adımını sade tutmanın bir yararı var: Bir şey bozulduğunda, değişenin kaynak mı yoksa sizin temizleme kurallarınız mı olduğunu anlayabilirsiniz.
Dönüştürme (transform) kuralların bulunduğu yerdir. Tipik işlemler şunlardır:
- türleri dönüştürmek (fiyat metnini sayıya, puan kelimesini tam sayıya, tarih dizesini tarihe)
- metni normalleştirmek (boşluklar, Unicode biçimleri, büyük-küçük harf)
- ürün URL'si gibi değişmeyen bir anahtara göre tekrarları ayıklamak
- doğrulamak (fiyat pozitif olmalı, puan 1 ile 5 arasında olmalı) ve geçemeyen satırları kenara ayırmak
- zenginleştirmek ya da birleştirmek (para birimi, kategori, veri toplama zaman damgası eklemek)
Sayfanın HTML'ini alanlara çevirmek başlı başına bir ayrıştırma adımıdır; parser türlerini ve nerelerde hata verdiklerini Veri Ayrıştırma (Parsing) Nedir? yazısında anlattık. pandas ile eksiksiz bir temizlik akışını ise kazınan veriyi pandas ile temizleme yazısında bulabilirsiniz.
Yükleme (load) temiz satırları hedefe yazar ve sonucu tek parça hâlinde görünür kılar. Küçük bir proje için bu bir SQLite dosyasıdır; bir ekip için PostgreSQL ya da bulut tabanlı bir veri ambarı. Tekrarlanan satır hatalarının çoğu da yükleme adımında doğar; bu yüzden yükleme yöntemi, hedefin ne olduğundan daha önemlidir. CSV, JSON ve SQLite arasındaki artı ve eksileri Kazınan Veri CSV, JSON ve SQLite'a Nasıl Kaydedilir? yazısında ele aldık.
Bir ETL hattı nasıl çalışır?
Zamanlanmış bir scraping ETL işinin tek bir çalıştırması şu adımlardan geçer:
- Bir tetikleyici çalıştırmayı başlatır. Bu bir cron kaydı, Apache Airflow gibi bir iş akışı yöneticisi (orchestrator) ya da betiği elle çalıştıran bir kişi olabilir.
- Çıkarma adımı kaynağı getirir. Sayfalar ölçülü bir hızla istenir, başarısız istekler bir süre beklendikten sonra yeniden denenir ve ham alanlar toplanır.
- Dönüştürme adımı her kaydı temizler. Türler dönüştürülür, tekrarlar atılır, bir kuralı çiğneyen kayıtlar sessizce geçip gitmek yerine sayılır ve günlüğe yazılır.
- Bir kalite kapısı karar verir. Çıkarma adımı hiç veri döndürmediyse ya da reddedilen satır sayısı çok yüksekse çalıştırma, hedefe dokunmadan durur. Sitedeki bir tasarım değişikliği, dünün sağlam verisinin üzerine yazılmasına yol açmamalıdır.
- Yükleme tek bir işlemde (transaction) yapılır. Satırlar anahtara göre upsert edilir; ya bütün parti kaydedilir ya da hiçbiri.
- Çalıştırma rapor verir. Çıkarılan, temiz, reddedilen ve yüklenen satır sayıları bir günlüğe ya da uyarıya gider; böylece sessiz bir hata görünür hâle gelir.
Büyük işlerde bu aşamalar üst üste binebilir: Dönüştürme, gelmiş olan veri üzerinde başlar. Birkaç bin satır için aşamaları sırayla çalıştırmak hata ayıklamayı kolaylaştırır.
ETL ile ELT arasındaki fark nedir?
ELT (extract, load, transform) aynı üç adımı korur, ama dönüştürmeyi hedefin içine taşır. Ham veri olduğu gibi yüklenir ve daha sonra SQL ya da veri ambarının motoru tarafından yeniden biçimlendirilir. Microsoft'un rehberi farkı açıkça koyar: ELT'de dönüşüm hedef veri deposunun içinde gerçekleşir.
| ETL | ELT | |
|---|---|---|
| Sıra | Çıkar, dönüştür, sonra yükle | Çıkar, yükle, sonra dönüştür |
| Temizlik nerede yapılır | Betiğinizde ya da ayrı bir motorda | Veritabanının ya da veri ambarının içinde (SQL) |
| Hedefte ne durur | Yalnızca temiz, doğrulanmış satırlar | Ham satırlar ile temizlenmiş tablolar ya da görünümler |
| Ham veri saklanır mı? | Yalnızca ayrıca kaydederseniz | Evet, yapısı gereği |
| Hedeften beklenen | Her depo olur, bir SQLite dosyası bile | Büyük ölçekte dönüşüm yapabilecek güçte bir hedef |
| Temizlik hatasını düzeltmek | Yeniden çıkarmak ya da kaydedilmiş ham dosyalardan yeniden çalıştırmak | SQL'i yeniden yazıp ham tablolardan yeniden kurmak |
| Uygun olduğu durum | Küçük ve orta ölçekli scraping işleri, katı şemalar | Büyük hacimler, keşif amaçlı analiz, değişen kurallar |
Scraping için kullanışlı bir orta yol var: Her çalıştırmanın ham HTML'ini ya da ham JSON'unu diske (bir ara depolama alanına, "staging" alanına) kaydedin ve dönüşümü bu dosyalardan yapın. Bir temizleme kuralının yanlış olduğu anlaşılırsa, siteye tek bir yeni istek göndermeden tabloyu yeniden kurarsınız.
Bir ETL işi neden iki kez güvenle çalışabilmeli?
İşler yarıda kesilir. Bağlantı 38. sayfada kopar, makine yeniden başlar, zamanlayıcı işi yeniden dener. Asıl soru, ikinci denemeden sonra hedefin nasıl göründüğüdür. Apache Airflow'un en iyi uygulamalar rehberi bu soruyu doğrudan yanıtlar: Bir görevi veritabanındaki bir işlem gibi ele alın, asla yarım sonuç üretmeyin ve düz bir INSERT yerine upsert kullanın; çünkü INSERT ile yapılan bir yeniden çalıştırma tekrar eden satırlar bırakabilir.
Bu özelliğe idempotentlik denir: İşi aynı girdi üzerinde ister bir kez ister üç kez çalıştırın, sonuç aynı kalır. Pratikte idempotentlik üç alışkanlıktan doğar:
- Doğal bir anahtar. Her satırın, çalıştırmalar arasında değişmeyen bir kimliği vardır. Bir ürün sayfası için URL bu işi görür; kendiliğinden artan (auto-increment) bir ID görmez.
- Insert yerine upsert. Upsert, "update" ve "insert" sözcüklerinden türemiştir ve "varsa güncelle, yoksa ekle" demektir. SQLite,
INSERT … ON CONFLICT DO UPDATEsöz dizimini 3.24.0 sürümünden beri destekler ve özelexcluded.öneki eklenmek istenen değerleri gösterir. PostgreSQL'de de aynı söz dizimi vardır. - Her yükleme için tek işlem. Parti ya bütünüyle kaydedilir ya da bütünüyle geri alınır; böylece bir çökme asla yarım bir tablo bırakmaz.
Bir ETL işini zamanlamak ve izlemek
Yalnızca aklınıza geldiğinde çalışan bir iş, bir betikten ibarettir. Tek makine ve tek iş için cron (Windows'ta Görev Zamanlayıcı) yeterlidir. İşler birbirine bağlı olduğunda (önce veri toplama, sonra temizleme, sonra rapor üretme) bir iş akışı yöneticisi kurmaya değer. Airflow'da bir hat bir DAG'dir, yani aralarında bağımlılıklar bulunan görevlerden oluşan bir kümedir; schedule parametresi @daily gibi hazır değerleri, bir cron dizesini ya da bir zaman aralığını kabul eder. Airflow başarısız görevleri yeniden de dener; bu da görevlerin idempotent olması için bir neden daha.
İzleme için ilk gün bir platform gerekmez. Her çalıştırmada dört sayıyı günlüğe yazın (getirilen sayfalar, çıkarılan satırlar, reddedilen satırlar, yüklenen satırlar) ve iki durumda uyarı verin: İş hiç çalışmadıysa ya da bu sayılardan biri olağan değerinden çok uzaklaştıysa. 1.000 satırdan 20 satıra düşüş, genellikle mağazanın stoklarının tükendiğini değil, sitenin tasarımını değiştirdiğini gösterir. Scraping tarafında bir sayfanın kendisinin ne zaman değiştiğini yakalamayı Web Sitesi Değişiklik Takibi Nasıl Yapılır? yazısında gösterdik.
Proxy'ler ETL'de nereye oturur?
Yalnızca çıkarma adımına ve yalnızca iş gerçekten ihtiyaç duyduğunda. Herkese açık bir siteden günde birkaç sayfa çeken bir işin buna nadiren ihtiyacı olur. Proxy, ülkeye göre değişen fiyatları topladığınızda, çok sayıda istek gönderen meşru bir iş sitenin IP başına uyguladığı hız sınırlarına (rate limit) takıldığında ya da kaynak konuma göre farklı içerik gösterdiğinde önem kazanır. Residential Proxy ile çıkarma adımı sayfaları seçtiğiniz ülke ve şehirden isteyebilir; Rotating Proxy ise daha büyük taramalarda istekleri birçok IP'ye dağıtır.
Proxy kuralları değiştirmez. Sitenin robots.txt dosyası, kullanım koşulları ve makul bir istek hızı yine geçerlidir; resmî bir API ya da dışa aktarma seçeneği varsa her zaman önce o gelir. İstek tarafını Web Scraping'de Engellenmeden Veri Toplama Yöntemleri yazısında ve veri kazıma sayfamızda daha ayrıntılı ele aldık.
Python ile eksiksiz bir ETL işi
Aşağıdaki betik, tek dosyada bütün bir hattır. Scraping pratiği için kurulmuş bir deneme sitesi olan books.toscrape.com üzerindeki bütün kitap kartlarını çıkarır, alanları türü belli satırlara dönüştürür ve bir upsert ile SQLite'a yükler. 429 ve 5xx yanıtlarında giderek uzayan beklemelerle yeniden dener, sayfalar arasında bir saniye bekler, doğrulamadan geçemeyen satır sayısı çok yüksekse durur ve trafiği yalnızca PROXY_URL değişkenini tanımladığınızda bir proxy üzerinden gönderir.
Önce iki bağımlılığı kurun:
pip install requests beautifulsoup4Ardından şunu etl_books.py olarak kaydedin:
"""Küçük bir ETL işi: books.toscrape.com -> temiz satırlar -> SQLite."""
import argparse
import logging
import os
import sqlite3
import time
import unicodedata
from datetime import datetime, timezone
from urllib.parse import urljoin

import requests
from bs4 import BeautifulSoup
from requests.adapters import HTTPAdapter
from urllib3.util.retry import Retry

BASE = "https://books.toscrape.com/catalogue/"
RATINGS = {"One": 1, "Two": 2, "Three": 3, "Four": 4, "Five": 5}
log = logging.getLogger("etl")


def make_session():
    retry = Retry(total=4, backoff_factor=1.5,
                  status_forcelist=(429, 500, 502, 503, 504),
                  respect_retry_after_header=True)
    s = requests.Session()
    s.mount("https://", HTTPAdapter(max_retries=retry))
    s.headers["User-Agent"] = "etl-demo/1.0 (contact: you@example.com)"
    proxy = os.getenv("PROXY_URL")  # örn. http://user:pass@pr.proxynet.io:8000
    if proxy:
        s.proxies = {"http": proxy, "https": proxy}
    return s


# ---------- EXTRACT (çıkarma): sayfaları getir, ham metni koru ----------
def extract(session, max_pages, delay=1.0):
    raw, url, page = [], urljoin(BASE, "page-1.html"), 0
    while url and page < max_pages:
        resp = session.get(url, timeout=15)
        resp.raise_for_status()
        soup = BeautifulSoup(resp.content, "html.parser")
        for card in soup.select("article.product_pod"):
            raw.append({
                "title": card.h3.a["title"],
                "href": card.h3.a["href"],
                "price": card.select_one("p.price_color").get_text(),
                "rating": card.select_one("p.star-rating")["class"][-1],
                "stock": card.select_one("p.availability").get_text(),
                "page_url": url,
            })
        page += 1
        nxt = soup.select_one("li.next a")
        url = urljoin(url, nxt["href"]) if nxt else None
        time.sleep(delay)
    log.info("extract: %d pages, %d raw rows", page, len(raw))
    return raw


# ---------- TRANSFORM (dönüştürme): türler, temizlik, tekrar ayıklama, doğrulama ----------
def transform(raw):
    clean, rejected, seen = [], 0, set()
    now = datetime.now(timezone.utc).isoformat(timespec="seconds")
    for r in raw:
        try:
            url = urljoin(r["page_url"], r["href"])
            if url in seen:
                continue
            seen.add(url)
            title = " ".join(unicodedata.normalize("NFKC", r["title"]).split())
            price = float(r["price"].strip().lstrip("£"))
            rating = RATINGS[r["rating"]]
            in_stock = "in stock" in r["stock"].lower()
            if not title or price <= 0:
                raise ValueError("empty title or bad price")
        except (KeyError, ValueError) as exc:
            rejected += 1
            log.warning("rejected %r: %s", r.get("title"), exc)
            continue
        clean.append((url, title, price, rating, int(in_stock), now))
    log.info("transform: %d clean, %d rejected", len(clean), rejected)
    return clean, rejected


# ---------- LOAD (yükleme): tek işlemde SQLite'a upsert ----------
def load(rows, db_path):
    con = sqlite3.connect(db_path)
    with con:  # başarılıysa kaydeder, hata olursa geri alır
        con.execute("""CREATE TABLE IF NOT EXISTS books (
            url TEXT PRIMARY KEY, title TEXT NOT NULL, price_gbp REAL NOT NULL,
            rating INTEGER, in_stock INTEGER, updated_at TEXT)""")
        con.executemany("""INSERT INTO books VALUES (?, ?, ?, ?, ?, ?)
            ON CONFLICT(url) DO UPDATE SET title=excluded.title,
              price_gbp=excluded.price_gbp, rating=excluded.rating,
              in_stock=excluded.in_stock, updated_at=excluded.updated_at""", rows)
        total = con.execute("SELECT COUNT(*) FROM books").fetchone()[0]
    con.close()
    log.info("load: %d rows upserted, %d rows in table", len(rows), total)
    return total


def main():
    ap = argparse.ArgumentParser()
    ap.add_argument("--pages", type=int, default=3)
    ap.add_argument("--db", default="books.db")
    args = ap.parse_args()
    logging.basicConfig(level=logging.INFO, format="%(asctime)s %(levelname)s %(message)s")
    raw = extract(make_session(), args.pages)
    rows, rejected = transform(raw)
    if not rows or rejected > len(raw) * 0.1:  # koruma: bozuk bir partiyi yükleme
        raise SystemExit(f"aborting load: {len(rows)} clean, {rejected} rejected")
    load(rows, args.db)


if __name__ == "__main__":
    main()
Bütün kataloğu çekmek için python etl_books.py --pages 60 komutunu çalıştırın. Sitede 50 sayfa var; bu yüzden döngü, "next" bağlantısı kaybolduğunda kendiliğinden durur. Bizim çalıştırmamızın çıktısı şöyleydi:
INFO extract: 50 pages, 1000 raw rows
INFO transform: 1000 clean, 0 rejected
INFO load: 1000 rows upserted, 1000 rows in table
Betiği ikinci kez çalıştırdığınızda son satır yine 1000 rows in table ile biter. Upsert kopya eklemek yerine var olan satırları güncelledi; yukarıda anlattığımız idempotentlik tam olarak budur. Hata yollarını da denedik. Bir bağlantı zaman aşımına uğradığında yeniden denemeler çalıştı ve betik, yükleme adımına gelmeden hata vererek sonlandı; tablo önceki satırlarını korudu. transform() fonksiyonuna £x fiyatı ve Six puanı verdiğimizde iki satır da gerekçesi günlüğe yazılarak reddedildi; tekrar eden bir URL ise kopya olarak atıldı.
Çıkarma adımını bir proxy üzerinden göndermek için çalıştırmadan önce değişkeni tanımlayın; başka hiçbir şey değişmez:
export PROXY_URL="http://user:pass@pr.proxynet.io:8000"
python etl_books.py --pages 60
Linux'ta her gece 03.00'te çalıştırmak için crontab'a 0 3 * * * cd /opt/etl && .venv/bin/python etl_books.py --pages 60 >> etl.log 2>&1 gibi bir satır ekleyin. Birbirine bağlı birkaç işiniz olduğunda onları bir iş akışı yöneticisine taşıyın.
Web verisiyle ETL nerelerde kullanılır?
- Fiyat takibi: Gece çalışan bir iş rakip fiyatlarını çıkarır, para birimlerini normalleştirir ve bir geçmiş tablosuna yükler; fiyat takibi sayfamıza ve E-Ticarette Rakip Fiyat Takibi Nasıl Yapılır? yazısına bakın.
- Pazar araştırması: Birçok mağazadaki ürün sayıları, puanlar ve ürün yelpazesi değişiklikleri tek bir şemaya yüklenir; pazar araştırması sayfamıza bakın.
- Büyük taramalar: Önce binlerce URL keşfedilir, sonra her birinden veri çıkarılır; keşif tarafını web crawler sayfamız anlatıyor.
- Alternatif veri: Analistler web verisini başka kaynaklarla birleştirir; sonuca güvenilip güvenilemeyeceğine dönüştürme adımındaki kalite kuralları karar verir. Ayrıntılar Alternatif Veri Nedir? yazısında.
- Analiz ve madencilik: Temizlenip yüklenmiş bir tablo, veri madenciliğinin ihtiyaç duyduğu girdidir.
Sık yapılan ETL hataları
- Temizliği çıkarma adımında yapmak. Ayrıştırma ve dönüştürme aynı döngüde yapıldığında, sitedeki bir değişikliği kurallarınızdaki bir hatadan ayıramazsınız. Çıkarma adımını ham tutun.
- Her çalıştırmada düz
INSERT. İkinci çalıştırma tabloyu ikiye katlar. Doğal bir anahtar ve upsert kullanın. - Kalite kapısı olmaması. Bir tasarım değişikliği her fiyatı
Noneyapar ve iş, sağlam verinin üzerine hiç duraksamadan 1.000 boş satır yükler. - Satır satır kaydetmek (commit). Yarıda gelen bir çökme, ne eski ne de yeni durumda olan bir tablo bırakır.
- Sessiz redler. Hatalı satırları saymadan atmak, biri sayıların azaldığını fark edene kadar sorunları gizler.
- Yanlış karakter kodlaması. Baytları yanlış karakter kümesiyle okumak
£işaretini£hâline getirir; nedenini Python Türkçe Karakter Sorunu yazısında açıkladık. - Kaynağın sınırlarını yok saymak. Gecikme yok, yeniden denemeler arasında bekleme yok,
Retry-Afterbaşlığına uyulmuyor. Site429ile yanıt vermeye başlar; 429 Too Many Requests ve Rate Limit Hatası Nedir? yazısına bakın.
Karar rehberi
| Durumunuz | Ne kullanmalı |
|---|---|
| Tek kaynak, birkaç bin satır, tek kişi | cron ile çalışan tek bir Python ETL betiği ve SQLite |
| Kurallar sık değişiyor, ham veriyi saklamak istiyorsunuz | ELT: ham satırları ya da dosyaları yükleyin, SQL ile dönüştürün |
| Birbirine bağlı birkaç iş | Apache Airflow gibi bir iş akışı yöneticisi |
| Büyük hacim, hazırda bir bulut veri ambarı | Veri ambarının içinde ELT |
| Ülkeye göre değişen fiyatlar ya da içerik | Çıkarma adımında residential proxy ile ETL |
| Kaynak bir API ya da indirme seçeneği sunuyor | Veriyi API'den çıkarın; scraping'e hiç gerek yok |
Sıkça sorulan sorular
ETL neyin kısaltmasıdır?
Extract, transform, load, yani çıkarma, dönüştürme, yükleme. Veri bir kaynaktan çıkarılır, tutarlı ve doğrulanmış bir yapıya dönüştürülür, ardından bir veritabanı ya da veri ambarı gibi bir hedef depoya yüklenir.
Web scraping ile ETL aynı şey mi?
Hayır. Scraping, çıkarma adımını yapmanın yollarından biridir. ETL bundan sonrasını da kapsar: veriyi temizlemek, tekrarları ayıklamak, doğrulamak ve sorgulanabileceği, güncel tutulabileceği bir yere yüklemek.
ETL hâlâ kullanılıyor mu, yoksa yerini ELT mi aldı?
İkisi de kullanılıyor. Ağır dönüşümü bir bulut veri ambarı üstlenebiliyorsa ve ham verinin saklanması gerekiyorsa ELT yaygındır. Hedef küçükse, şema katıysa ya da verinin saklanmadan önce temizlenmesi gerekiyorsa ETL doğal bir seçim olmayı sürdürür.
Yalnızca Python ile bir ETL hattı kurabilir miyim?
Evet. Küçük ve orta ölçekli işler için yukarıdaki betiğin gösterdiği gibi requests, bir HTML parser'ı ve standart kütüphanedeki sqlite3 modülü yeterlidir. Dönüştürme adımı ağırlaştığında pandas gibi kütüphaneler işinizi kolaylaştırır.
ETL hattı (pipeline) nedir?
Tekrar tekrar çalışacak şekilde kurulmuş ETL sürecidir: bir tetikleyici, üç adım, bir kalite denetimi ve bir rapor; çoğunlukla bir zamanlamaya bağlı olarak. Tek seferlik bir betik, gözetimsiz çalışabildiği ve hatalardan toparlanabildiği anda bir hatta dönüşür.
ETL için Airflow gerekir mi?
Tek makinedeki tek bir iş için gerekmez; cron yeterlidir. Bir iş akışı yöneticisi, birkaç görev birbirine bağlı olduğunda, yeniden deneme ve çalıştırma geçmişi gerektiğinde ya da işler bir ekip tarafından paylaşıldığında işe yarar.
Özet
ETL, bir veri projesinde toplama aşamasından sonra gelen kısımdır: ham veriyi çıkarmak, onu türü belli, tekrarlardan arındırılmış ve doğrulanmış satırlara dönüştürmek ve yeniden çalıştırmanın tabloyu asla ikiye katlamaması için tek bir işlemde, upsert ile yüklemek. ELT dönüştürme adımını hedefin içine taşır ve büyük veri ambarlarına uyar; scraping işlerinin çoğu için doğru başlangıç, SQLite kullanan küçük bir ETL betiğidir. Bir kalite kapısı ve günlüğe yazılan dört sayı ekleyin, işi zamanlayın ve bir proxy'yi yalnızca çıkarma adımı farklı bir konuma ya da daha fazla IP'ye ihtiyaç duyduğunda devreye alın. O noktaya geldiğinizde proxy paketlerimize göz atabilirsiniz.


