Uma equipe de precificação quer, toda manhã, os preços de 300 produtos de 40 lojas online, do jeito que os compradores de cinco países os veem. Metade das lojas monta as páginas com JavaScript, e cada uma organiza o HTML de um jeito. A equipe pode criar e manter os scrapers por conta própria ou enviar cada URL de produto para uma API de web scraping e receber os campos de volta em JSON.
Este post explica como funciona uma API de web scraping e que trabalho ela tira das suas mãos. Ele compara a API com outros quatro caminhos para obter dados da web, trata dos tipos, dos preços e do lado jurídico e termina com a pergunta de quem compra: uma API de scraping ou seus próprios proxies?
O que é uma API de web scraping?
Uma API de web scraping (web scraping API) é um serviço HTTP que busca uma página web em seu nome e devolve o conteúdo em um formato que o seu programa consegue usar. Você a chama como qualquer API, mas os dados vêm do scraping de uma página cujo dono nunca os ofereceu como API. Ela também é vendida como scraper API ou serviço de web scraping.
O post O que é web scraping e como funciona? explica o web scraping em si: um programa que baixa páginas e tira valores do HTML. Uma API de scraping faz o mesmo trabalho. A diferença está em quem opera a máquina.
Como é uma requisição?
O endpoint api.example.com e os nomes de campo abaixo foram inventados para ilustrar; cada provedor dá nomes diferentes às opções, mas a estrutura é parecida.
curl -s https://api.example.com/v1/scrape \
  -H "Authorization: Bearer $API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"url": "https://shop.example.com/p/1234", "country": "de", "render": false, "output": "json"}'
Enviada a um mock local (uma imitação) da mesma API inventada, a requisição retornou:
{
  "url": "https://shop.example.com/p/1234",
  "target_status": 200,
  "country": "de",
  "rendered": false,
  "attempts": 2,
  "data": {
    "name": "Desk lamp",
    "price": "24.90",
    "currency": "EUR",
    "in_stock": true
  }
}
target_status é o código de status da loja, attempts mostra que o serviço precisou de duas tentativas e data traz os campos que o parser dele extraiu. Com "output": "html", você recebe a própria página e faz o parsing do seu lado.
Como funciona uma API de web scraping?
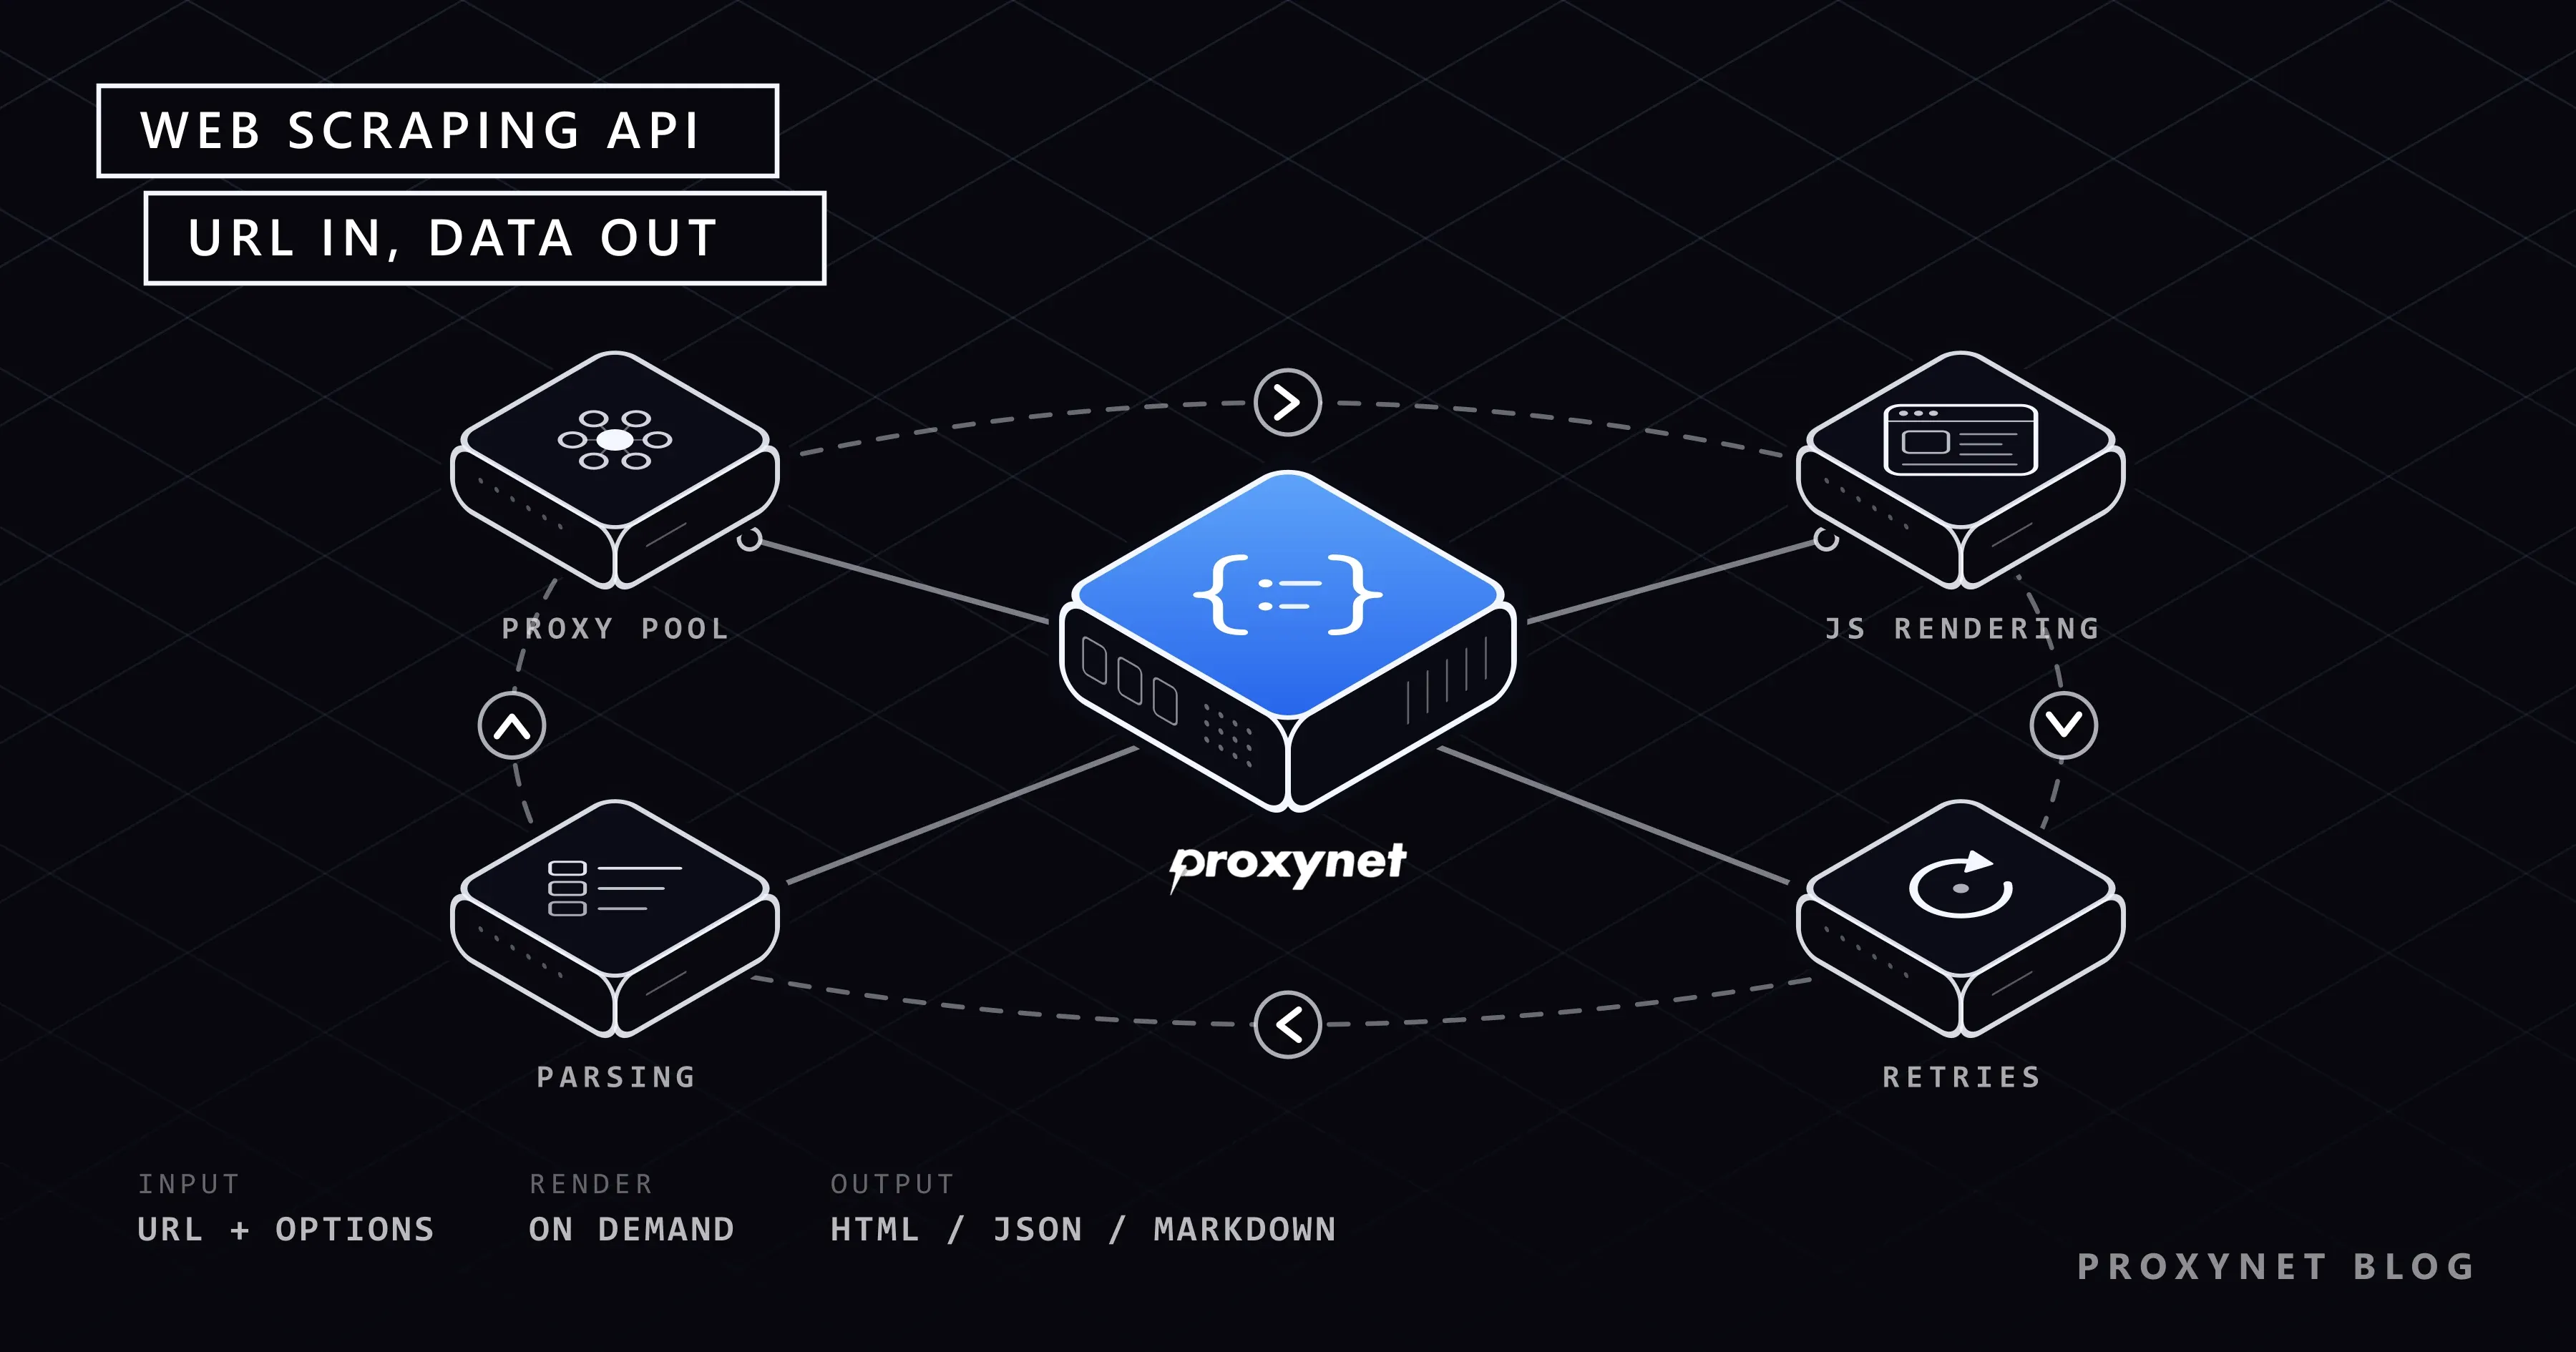
Uma API de web scraping roda, na própria infraestrutura, o pipeline de um scraper feito em casa:
- Você envia o pedido: a URL de destino e opções como país, renderização e formato de saída, às vezes um ID de sessão que mantém o mesmo IP por várias páginas.
- O serviço escolhe um IP de saída no pool de proxies dele, no país que você pediu.
- Ele busca a página com uma requisição HTTP simples ou em um navegador headless que executa o JavaScript da página.
- Ele confere a resposta: o código de status, um corpo vazio ou uma página de bloqueio no lugar do conteúdo.
- Ele repete as falhas com outro IP ou depois de uma pausa, dentro de um número fixo de tentativas.
- Ele converte o resultado em HTML bruto, Markdown limpo ou campos nomeados em JSON.
- Ele devolve o resultado com metadados, como o código de status do destino e as tentativas, e cobra a requisição.
O que uma API de web scraping faz por você?
Uma API de web scraping assume as cinco tarefas que mais tomam tempo no scraping: endereços IP, renderização, novas tentativas, tratamento de bloqueios e parsing.
Rotação de proxies e segmentação geográfica. Cada requisição sai por um IP do pool do provedor, no país (às vezes na cidade) que você escolher, com um endereço novo a cada requisição ou um que se mantém durante uma sessão. Os pools misturam IPs de datacenter baratos com IPs residenciais e móveis de conexões domésticas e móveis, que custam mais.
Renderização de JavaScript. Muitas páginas chegam como uma casca de HTML quase vazia que o JavaScript preenche depois. Nesse caso, o serviço abre a página em um navegador headless; a documentação do Chrome descreve esse modo como rodar o navegador "em um ambiente não supervisionado, sem nenhuma interface visível" (modo headless do Chrome). A renderização é a opção mais lenta e mais cara, então você a liga requisição por requisição.
Novas tentativas. Conexões caem, proxies estouram o timeout e servidores respondem 503 por um instante; o serviço repete essas falhas até um limite. Uma página inexistente (404) não vale uma nova tentativa, e um serviço bem-feito trata 429 Too Many Requests como um sinal para ir mais devagar.
Detecção de bloqueios e CAPTCHA. Um site que recusa uma requisição costuma mandar uma página de "Access denied" com aparência normal ou um CAPTCHA, um teste feito para separar pessoas de programas. Um bom serviço registra essa página como falha em vez de devolvê-la como dados. A recusa é uma decisão do site, então pergunte como o provedor reage quando ela acontece.
Parsing e saída estruturada. Muitas APIs devolvem campos nomeados, de parsers prontos ou de seletores que você informa; outras devolvem o texto principal em Markdown, que os modelos de linguagem leem com mais facilidade do que HTML. Você deixa de escrever um parser, mas é o parser de outra pessoa que decide o que "preço" significa.
API de web scraping vs. API oficial, proxies, ferramentas e conjuntos de dados
Os cinco caminhos terminam com os dados no seu sistema. A diferença está no que você recebe e em quem faz o trabalho.
| Caminho | O que você recebe | Quem faz o trabalho pesado | Melhor quando |
|---|---|---|---|
| API de web scraping | Páginas ou campos de qualquer URL | O provedor | Muitos sites, pouco tempo |
| API oficial | Os dados do próprio site, documentados | O site | Ela existe e tem seus campos |
| Serviço de proxy | Endereços IP para suas requisições | Você | Alto volume, controle total |
| Biblioteca de scraping | Código que você mesmo roda | Você | Você tem desenvolvedores e servidores |
| Compra de conjunto de dados | Dados prontos em arquivos | O fornecedor de dados | Os dados existem como produto |
Em relação a uma API oficial. Quem publica a API oficial é o site dono dos dados; uma API de scraping é um terceiro que lê as páginas públicas desse site. Web scraping vs. API compara as duas com um exemplo testado. Para quem compra, a diferença principal é o acordo: uma API oficial vem com termos que você aceita e, muitas vezes, com campos que nenhuma página mostra, como IDs internos. Uma API de scraping não tem acordo nenhum com o destino, e os campos dela podem quebrar quando o site é redesenhado. Se uma API oficial traz os seus campos, use-a.
Em relação a um serviço de proxy. Um serviço de proxy vende endereços IP para as suas próprias requisições; o scraper, o navegador, as novas tentativas e o parser continuam com você. Uma API de scraping cobra por página pronta, e a maioria roda, ela mesma, sobre pools de proxies.
Em relação a uma biblioteca de scraping. Scrapy, Playwright ou Beautiful Soup não custam nada em licença, mas a sua equipe escreve o código e mantém os servidores. Um meio-termo comum deixa o parsing na biblioteca e manda para uma API só as buscas mais difíceis.
Em relação a um conjunto de dados. Um fornecedor de dados vende dados já coletados e limpos, entregues em arquivos: é o mais rápido quando os dados existem como produto e o mais fraco quando você precisa de campos específicos ou de atualizações diárias.
Quais tipos de API de web scraping existem?
Os provedores empacotam a mesma máquina para destinos diferentes, e um mesmo provedor costuma vender vários tipos:
- APIs de uso geral buscam qualquer URL e devolvem HTML, HTML renderizado ou Markdown.
- APIs de SERP devolvem as páginas de resultados de busca como campos: posição, título, URL e snippet. Os termos dos buscadores restringem consultas automatizadas; para o ranking do seu próprio site, a API do Google Search Console fornece dados de primeira mão.
- APIs de e-commerce transformam páginas de produto de marketplaces em campos como preço, disponibilidade, vendedor e avaliação.
- APIs de redes sociais devolvem perfis, posts e comentários públicos. Quase tudo isso são dados pessoais e os termos das plataformas são rígidos, então a margem jurídica aqui é a mais estreita.
- APIs de extração prontas para IA devolvem o conteúdo principal de uma página como Markdown ou texto limpo, sem menus e rodapés, para modelos de linguagem e agentes de IA.
Como as APIs de web scraping cobram?
Quase toda API de scraping cobra por requisição; o que muda é quais requisições contam. Quatro modelos são comuns, muitas vezes combinados:
- Por requisição. Toda chamada é cobrada, com sucesso ou não.
- Por requisição bem-sucedida. Só os sucessos são cobrados, então a definição de sucesso vira a cláusula principal do contrato.
- Créditos com multiplicadores. Uma requisição simples custa um crédito; renderização, IPs residenciais ou móveis e destinos difíceis custam vários. Um preço por crédito diz pouco até você conhecer o seu multiplicador.
- Planos mensais. Uma franquia fixa de requisições ou créditos, muitas vezes com um teto de requisições simultâneas e uma tarifa para o excedente.
O que conta como requisição bem-sucedida?
O padrão HTTP diz que um código de status 2xx significa que a requisição "foi recebida, entendida e aceita com sucesso" (RFC 9110). Essa é a visão do servidor, não a sua: uma página de bloqueio pode chegar com status 200, e um 404 Not Found é uma resposta correta sem nenhum dado.
Por isso, antes de comprar, pergunte se um 404, um 200 com página vazia ou de bloqueio e um timeout depois da última tentativa são cobrados. Depois, meça o custo por 1.000 páginas aproveitáveis nos seus destinos reais.
Usar uma API de scraping ou seus próprios proxies?
Uma API de scraping compensa quando o trabalho é amplo e o seu tempo é curto; seu próprio scraper com proxies compensa quando o trabalho é estreito, grande e de longo prazo.
Escolha uma API de scraping quando:
- você precisa de páginas de muitos sites diferentes, cada um com o próprio layout;
- muitos destinos montam o conteúdo com JavaScript;
- a equipe é pequena e ninguém quer manter navegadores, proxies e parsers;
- o tempo até o primeiro conjunto de dados importa mais do que o custo por página.
Escolha seu próprio scraper e proxies quando:
- o volume é muito alto em um punhado de sites, e um preço por página vai se acumulando;
- o parser e a lógica de crawling são seus, ou você quer que sejam;
- você precisa de controle total sobre a taxa de requisições, as sessões e qual IP envia o quê.
Muitas equipes usam os dois: uma API para a cauda longa de sites difíceis e o próprio scraper para os poucos que concentram a maior parte do volume.
Para o caminho dos proxies próprios, a Proxynet vende proxies em autoatendimento. Os nossos Proxies residenciais oferecem sessões rotativas ou fixas com segmentação por país e cidade, cobradas por GB. Os proxies de ISP estático e de datacenter são cobrados por IP, com tráfego sem cota; eles vêm por padrão com uma restrição de sites de destino, e o acesso a todos os sites é um complemento pago.
Nossa Web Scraper API está disponível por enquanto pela equipe de vendas, não em autoatendimento. A página de extração de dados cobre a parte dos proxies; para a API, informe à equipe de vendas seus sites, países e formato de saída.
Usar uma API de web scraping é legal?
Uma API não muda o que você pode coletar: o robots.txt do site de destino, os termos dele e a lei de proteção de dados valem como se você mesmo baixasse as páginas, porque é você quem escolhe as URLs e a finalidade.
robots.txt. Esse arquivo diz aos crawlers quais caminhos eles podem buscar. O padrão dele, a RFC 9309, diz que "essas regras não são uma forma de autorização de acesso" (RFC 9309): o arquivo não tranca nada, então segui-lo depende do crawler. Pergunte se o provedor o respeita ou deixa essa verificação com você.
Termos de uso. Os termos do site de destino valem para você, não só para o provedor. Páginas atrás de login, principalmente com a conta de outra pessoa, são um caso diferente das páginas públicas.
Dados pessoais. Nomes, links de perfil, endereços de e-mail e avaliações com o nome do autor são dados pessoais pelo GDPR, mesmo quando públicos. As diretrizes em versão preliminar do Comitê Europeu para a Proteção de Dados (CEPD), adotadas para consulta pública em 7 de julho de 2026, afirmam que "a organização que faz o scraping não é necessariamente o controlador nos termos do GDPR" (Diretrizes 03/2026 do CEPD). Um prestador que faz scraping seguindo instruções documentadas de um cliente pode ser operador; o cliente, que define a finalidade, geralmente é o controlador.
As diretrizes tratam do scraping para treinar IA generativa, mas a divisão de papéis segue as regras gerais do GDPR. Elas também citam arquivos robots.txt e CAPTCHAs entre os sinais de que um site se opõe ao scraping.
Então colete só os campos de que você precisa e assine um acordo de processamento de dados (DPA) se o provedor tratar dados pessoais para você. Como tratar dados pessoais (PII) em dados de scraping mostra como reduzir e mascarar esses dados.
Casos de uso
- Monitoramento de preços e estoque em muitas lojas e países.
- Acompanhamento de resultados de busca para uma lista de palavras-chave, dentro dos termos do buscador.
- Pesquisa de mercado: sortimentos, catálogos e textos de avaliações sem dados do autor.
- Agregação de anúncios de portais de imóveis, viagens ou classificados.
- Pipelines de IA: documentação convertida em Markdown para recuperação de informação (retrieval).
- Verificação de anúncios e conteúdo: como uma página aparece em outro país.
Erros comuns
- Pagar por renderização de que você não precisa. Teste cada destino primeiro sem renderização; muitas páginas já trazem os dados no HTML.
- Comparar preços sem a definição de sucesso. Um preço baixo por requisição diz pouco se páginas de bloqueio e respostas
404são cobradas. - Confiar no JSON devolvido sem checar o schema. Depois de um redesign, um campo extraído pode virar
nullsem aviso. Valide cada resposta contra um schema; o JSON Schema é o formato mais usado. - Repetir tentativas em cima das tentativas do provedor. Três tentativas da API vezes três suas dão nove buscas de uma página que falha.
- Supor que a API cuida do consentimento e da legalidade. O provedor busca; você decide o quê e para quê.
- Usar uma API de scraping onde existe uma API oficial. Você paga para extrair dados que o dono já oferece.
Guia de decisão
| Necessidade | Recomendação |
|---|---|
| Dados de 50 sites diferentes, equipe pequena | Uma API de scraping |
| Muitos destinos montam as páginas com JavaScript | Uma API de scraping, com renderização só onde for preciso |
| Milhões de páginas por mês de três sites | Seu próprio scraper com proxies |
| Controle total de taxa, sessões e parsing | Seu próprio scraper com proxies |
| O site tem uma API oficial com seus campos | A API oficial |
| Preços como os compradores de cinco países os veem | Uma API de scraping ou proxies residenciais |
| Os dados existem como produto, atualização opcional | Compra de um conjunto de dados |
| Perfis públicos ou avaliações com nome do autor | Reduza os campos e resolva antes a base legal |
Perguntas frequentes
Para que serve uma API de web scraping?
Uma API de web scraping serve para coletar dados de sites sem manter a sua própria infraestrutura de scraping. Os usos típicos são monitoramento de preços, acompanhamento de resultados de busca, pesquisa de mercado, agregação de anúncios e envio de páginas web como texto limpo para sistemas de IA.
Uma API de web scraping é a mesma coisa que um proxy?
Não. Um proxy só encaminha suas requisições por outro endereço IP, e o seu código continua buscando, renderizando, repetindo tentativas e fazendo o parsing. Uma API de web scraping faz tudo isso e devolve a página pronta ou os campos.
Uma scraper API é melhor do que criar seu próprio scraper?
Para muitos sites e uma equipe pequena, geralmente sim: ela começa mais rápido e não exige infraestrutura. Para um volume muito alto em poucos sites, seu próprio scraper com proxies tende a custar menos por página e dá controle total.
Uma API de web scraping consegue extrair dados de sites em JavaScript?
Sim, se ela oferecer renderização: abre a página em um navegador headless e devolve o conteúdo pronto. Requisições renderizadas são mais lentas e muitas vezes custam mais, então confira primeiro se os dados já estão no HTML simples.
Quanto custa uma API de web scraping?
O modelo de cobrança pesa mais do que o preço anunciado. Os serviços cobram por requisição, por requisição bem-sucedida ou em créditos, e renderização ou IPs residenciais costumam multiplicar o custo de uma página. Compare o custo por 1.000 páginas aproveitáveis nos seus próprios destinos.
Usar uma API de web scraping é legal?
A questão jurídica não é usar o serviço, e sim o que você coleta com ele. Os termos do site de destino, o robots.txt dele e a lei de proteção de dados valem para você como se você mesmo fizesse o scraping das páginas. Para um projeto específico, consulte um advogado da sua jurisdição.
Em resumo
Uma API de web scraping é scraping vendido como serviço: ela cuida de endereços IP, renderização, novas tentativas, detecção de bloqueios e parsing, e devolve HTML, JSON ou Markdown. É o caminho rápido para muitos sites e equipes pequenas; seu próprio scraper com proxies sai mais barato para um volume grande e constante em poucos sites. Confira o que conta como sucesso cobrado e valide o que volta. Para conversar sobre a nossa Web Scraper API, fale com nossa equipe de vendas.