Sua equipe já trabalha com Node.js e alguém pede os títulos, preços e unidades em estoque de todos os livros de uma categoria de um catálogo. O código-fonte da página no navegador mostra os dados dentro de tags <article> comuns, então você não precisa de um navegador para lê-los. Você precisa de um jeito de baixar o HTML, escolher os elementos certos, seguir o link "next" e impedir que o script sobrecarregue o site ou pare no primeiro timeout. O caminho geral de uma página até um arquivo está em Como extrair dados de um site; este tutorial faz isso em JavaScript com o Cheerio.
Vamos ver o que o Cheerio é e o que ele não é, como carregar HTML com load e fromURL, seletores e listas, o método extract, mais recente, paginação, um limite de concorrência, retentativas com backoff, gravação em JSON e o envio das requisições por um proxy com o ProxyAgent do undici. A última parte explica quando o Cheerio não é a ferramenta certa. Todos os exemplos foram executados em 28 de setembro de 2026 com cheerio 1.2.0, undici 8.11.2 e Node.js 24.11.1 contra o books.toscrape.com, um site de testes criado para praticar web scraping.
O que é o Cheerio?
O Cheerio é um parser de HTML e XML para Node.js com uma API inspirada no jQuery. Você entrega a marcação, ele monta uma árvore do documento e você consulta essa árvore com $("seletor css"). Ele é rápido porque pula tudo o que um navegador faz depois do parsing: não calcula layout, não aplica CSS, não carrega imagens e não executa scripts.
A versão atual é a 1.2.0 (cheerio no npm) e exige Node.js 20.18.1 ou posterior. A versão 1.0, lançada em agosto de 2024, encerrou uma fase de release candidates que tinha começado em 2017. O pacote não tem exportação padrão, então você escreve import * as cheerio from "cheerio". Tutoriais que chamam require("cheerio").default foram escritos para versões antigas.
O Cheerio só enxerga o HTML que o servidor enviou. Se a lista de produtos é preenchida depois por JavaScript, os dados não estão nesse HTML e nenhum seletor vai encontrá-los. Páginas estáticas e dinâmicas mostra como verificar que tipo de página você tem antes de escrever qualquer código.
Como funciona um scraper com Cheerio?
Um scraper baseado no Cheerio repete os mesmos cinco passos em cada página:
- Baixar. Um cliente HTTP (aqui,
fetch) solicita a URL e recebe o HTML como texto. - Analisar.
cheerio.load(html)monta a árvore e devolve uma função$ligada àquele documento. - Selecionar.
$("article.product_pod")devolve todos os elementos correspondentes;.find(),.text()e.attr()leem dentro deles. - Seguir. O scraper lê a próxima URL na página (um link de paginação ou de detalhe) e a resolve em relação à URL atual.
- Armazenar. As linhas se acumulam na memória e, no final, são gravadas em um arquivo ou banco de dados.
Os passos 2 e 3 nunca tocam a rede. Essa separação ajuda na depuração: se um seletor não retorna nada, salve o HTML em um arquivo e teste o seletor nele, sem enviar outra requisição.
Cheerio vs jsdom vs Playwright
As três ferramentas mais comparadas para web scraping no Node.js fazem trabalhos diferentes:
| Ferramenta | O que faz | Executa o JavaScript da página | Custo por página | Uso indicado |
|---|---|---|---|---|
| Cheerio | Analisa HTML, consultas no estilo jQuery | Não | O menor: só parsing | HTML renderizado no servidor, grande volume de páginas |
| jsdom | Monta um DOM parecido com o do navegador no Node.js | Opcional, limitado | Maior que o Cheerio | Código que espera document e as APIs do DOM |
| Playwright | Controla um Chromium, Firefox ou WebKit de verdade | Sim | O maior: navegador completo | Páginas que montam o conteúdo com JavaScript, cliques, logins |
Uma configuração comum usa as duas pontas: Playwright para as poucas páginas que precisam de navegador e Cheerio para todo o resto. A escolha da linguagem é outra questão, tratada em Extração de dados: JavaScript ou Python?.
Instalando o Cheerio e carregando a primeira página
Crie um projeto e instale o pacote. Adicionar "type": "module" permite usar import e await no nível superior:
mkdir book-scraper && cd book-scraper
npm init -y
npm pkg set type=module
npm install cheerio
O Node.js 18 e versões posteriores já trazem fetch, então o primeiro script não precisa de mais nada:
import * as cheerio from "cheerio";

const url = "https://books.toscrape.com/";
const response = await fetch(url, {
  headers: { "user-agent": "book-research/1.0 (+mailto:you@example.com)" },
});
if (!response.ok) throw new Error(`HTTP ${response.status} for ${url}`);

const $ = cheerio.load(await response.text());

console.log($("title").text().trim());
console.log($("article.product_pod").length, "books on this page");

$("article.product_pod").slice(0, 3).each((i, el) => {
  const card = $(el);
  const title = card.find("h3 a").attr("title");
  const price = card.find(".price_color").text();
  console.log(i + 1, title, price);
});All products | Books to Scrape - Sandbox
20 books on this page
1 A Light in the Attic £51.77
2 Tipping the Velvet £53.74
3 Soumission £50.10O título vem do atributo title do link, não do texto dele: neste site o texto visível do link aparece cortado ("In a Dark, Dark ...") e o atributo guarda o título completo. Confira os dois no código-fonte antes de escolher. O cabeçalho user-agent identifica o seu script e dá ao dono do site uma forma de falar com você.
Métodos de carregamento
O Cheerio 1.x tem cinco formas de carregar um documento (documentação de carregamento do Cheerio):
| Método | Entrada | Quando usar |
|---|---|---|
load(html) | Uma string | Você mesmo baixou a página (o caso comum) |
loadBuffer(buffer) | Bytes brutos | A codificação é desconhecida; o Cheerio a detecta |
stringStream(options, cb) | Fluxo de texto decodificado | Arquivos grandes com codificação conhecida |
decodeStream(options, cb) | Fluxo de bytes brutos | Arquivos grandes com codificação desconhecida |
fromURL(url, options) | Uma URL | Scripts rápidos; o Cheerio baixa a página sozinho |
O fromURL é prático, mas abre o próprio cliente undici para a origem da página. No nosso teste, ele ignorou um dispatcher passado em requestOptions e se conectou diretamente, mesmo quando esse dispatcher apontava para um proxy que recusava todas as requisições. Para tudo o que precisa de proxy, retentativas ou timeouts, baixe com fetch e use load.
Selecionando elementos e lendo valores
A maior parte do código de scraping usa uma pequena parte da API:
$(selector)seleciona no documento inteiro;el.find(selector)busca dentro de um elemento..text()devolve o texto combinado da seleção;.attr("href")devolve um atributo do primeiro elemento..each((i, el) => …)percorre a seleção;.map((i, el) => value).get()transforma a seleção em um array comum..first(),.eq(n)e.slice(a, b)restringem uma seleção.
Um seletor que não encontra nada não lança exceção. .text() devolve uma string vazia e .attr() devolve undefined, então um nome de classe alterado gera campos vazios em vez de um erro. Valide as linhas que você coleta (mais detalhes na lista de erros abaixo). A sintaxe dos seletores e o motivo de o Cheerio não ter XPath estão em Seletor CSS vs XPath.
O método extract
O Cheerio 1.0 adicionou $.extract(), que descreve o registro inteiro como um único objeto (documentação do extract do Cheerio). Uma string traz o texto da primeira correspondência, colchetes reúnem todas as correspondências e { selector, value } lê uma propriedade ou executa uma função:
import * as cheerio from "cheerio";

const $ = await cheerio.fromURL("https://books.toscrape.com/");

const data = $.extract({
  heading: "h1",
  books: [
    {
      selector: "article.product_pod",
      value: {
        title: { selector: "h3 a", value: "title" },
        price: ".price_color",
        link: { selector: "h3 a", value: "href" },
        rating: {
          selector: "p.star-rating",
          value: (el) => $(el).attr("class").replace("star-rating", "").trim(),
        },
      },
    },
  ],
});

console.log(data.heading, data.books.length);
console.log(data.books[0]);All products 20
{
title: 'A Light in the Attic',
price: '£51.77',
link: 'catalogue/a-light-in-the-attic_1000/index.html',
rating: 'Three'
}Os seletores dentro de value são avaliados em relação a cada article, o que mantém juntos os campos de um mesmo livro. O link continua relativo, então resolva-o com new URL(link, pageUrl) antes de requisitá-lo.
Um scraper completo: paginação, concorrência, retentativas e JSON
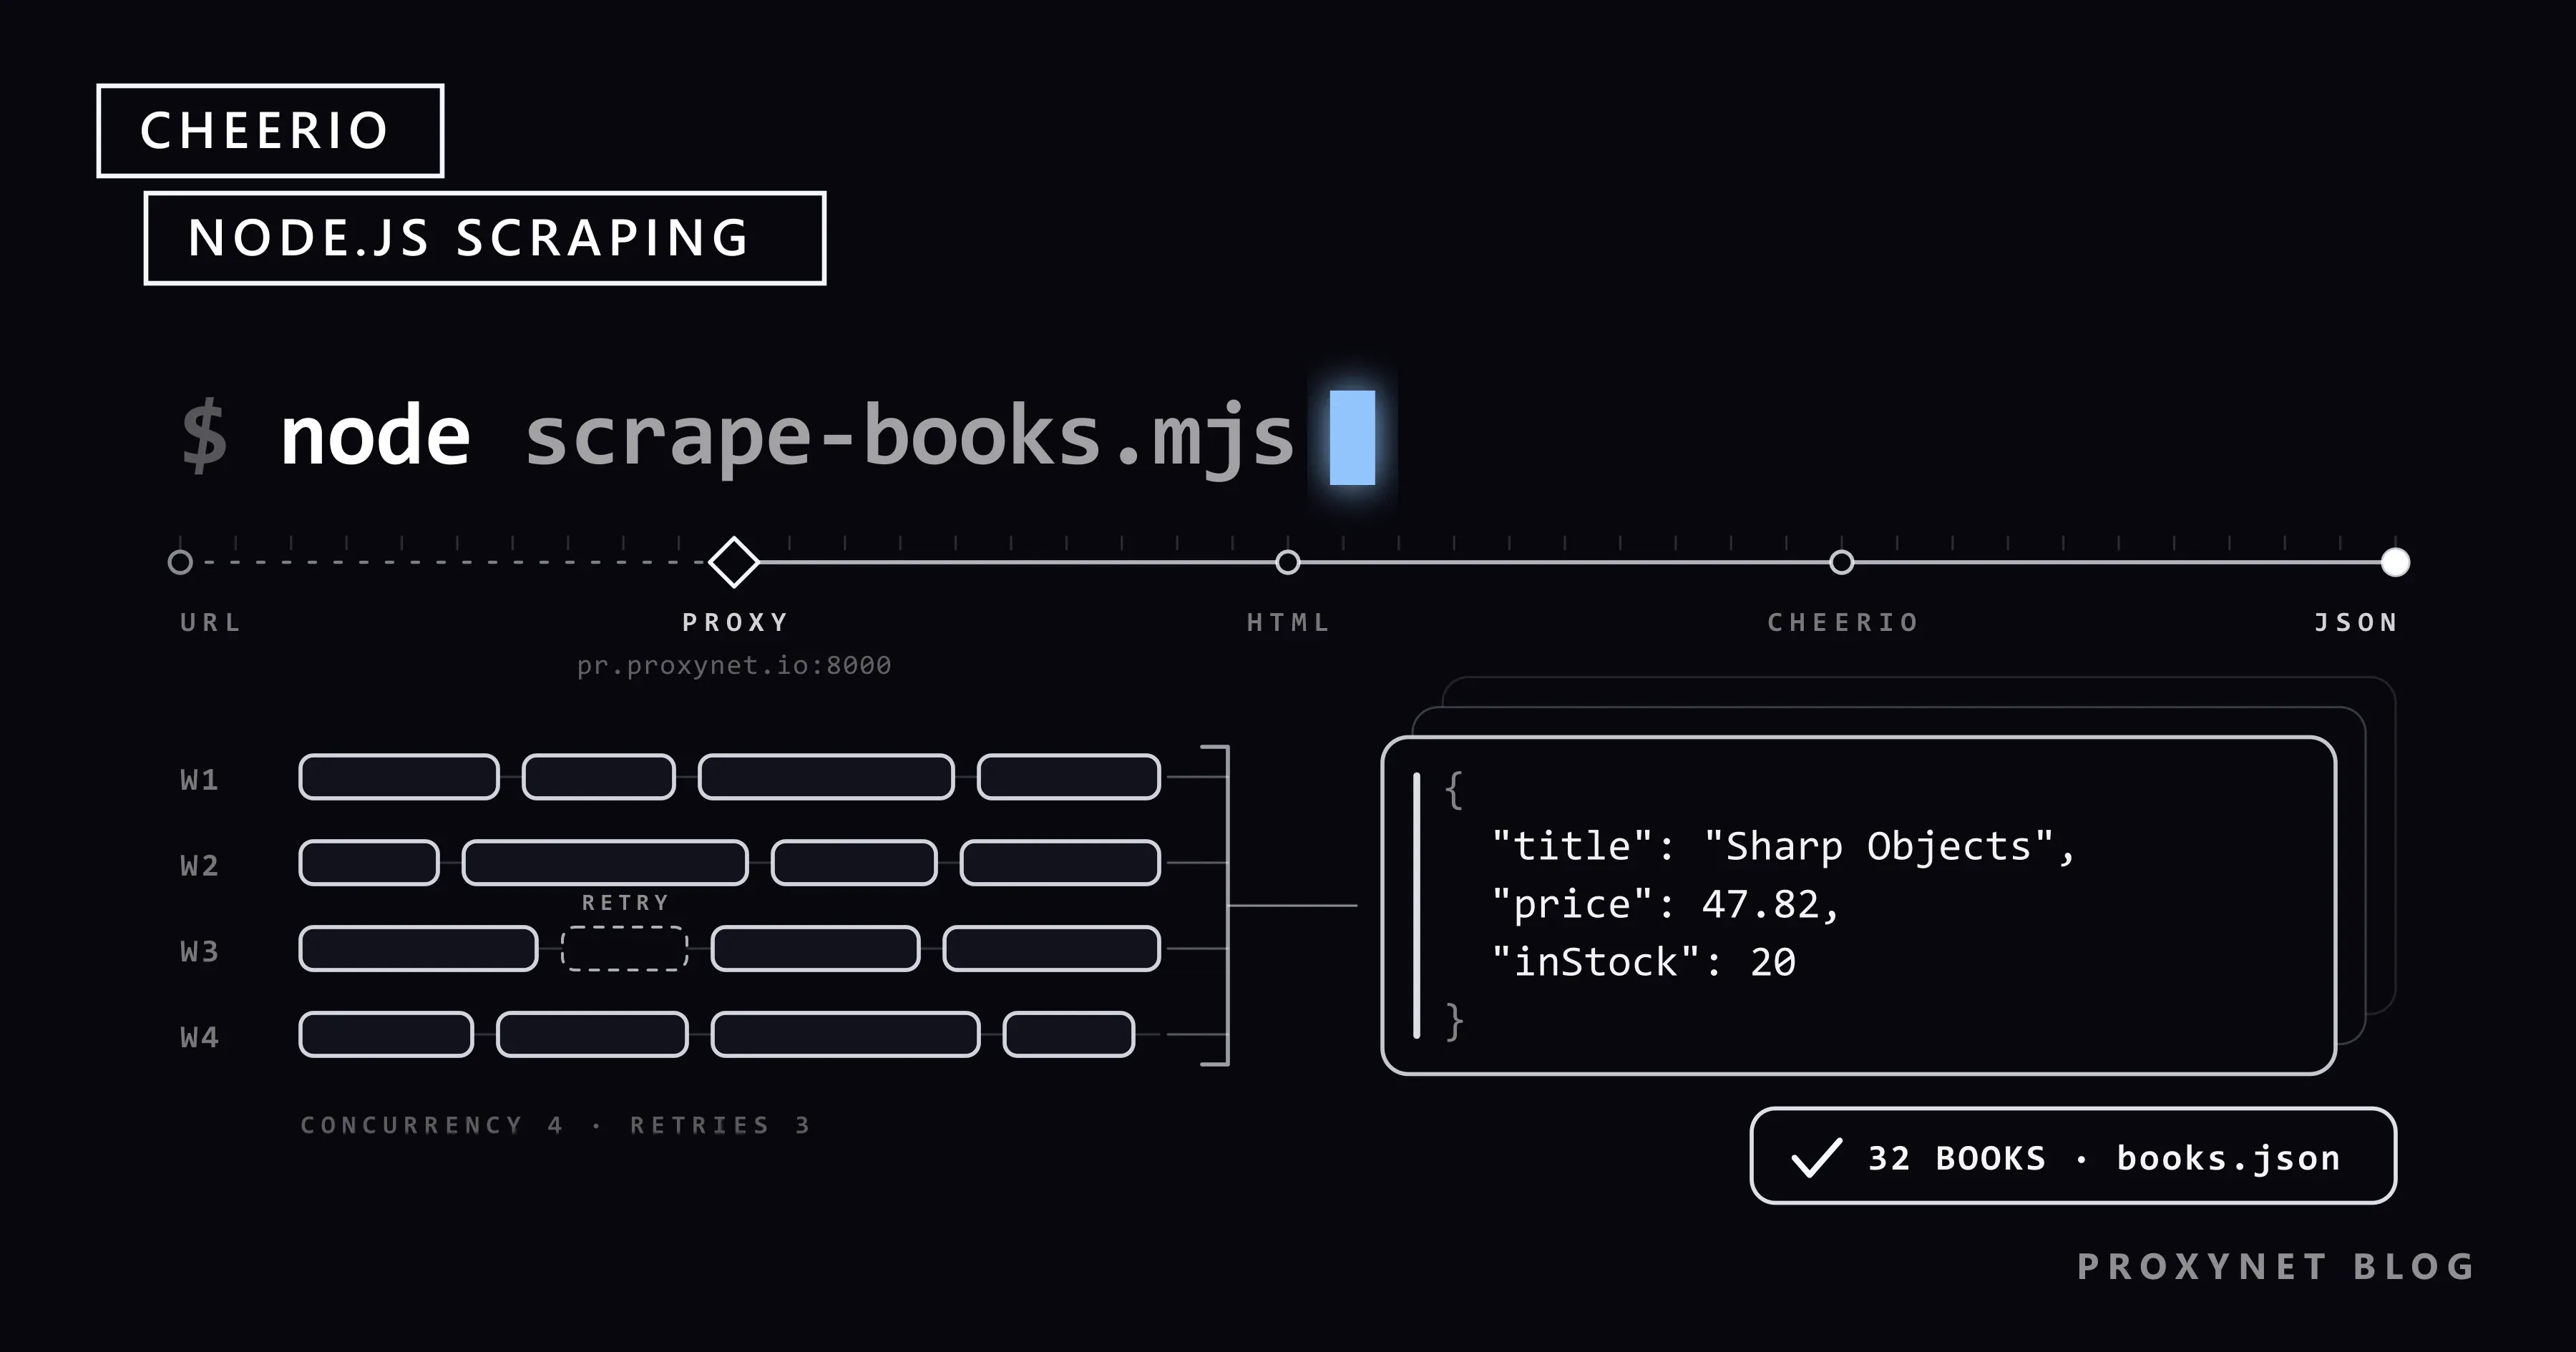
O script abaixo coleta todos os livros da categoria Mystery. Ele percorre as páginas da listagem seguindo o link "next", abre a página de detalhe de cada livro com no máximo quatro requisições em andamento, repete erros de rede, timeouts e respostas 429 e 5xx com backoff exponencial e grava books.json. Ele usa o fetch do undici para que o proxy opcional da próxima seção funcione sem mudanças. Instale com npm install cheerio undici (o undici 8 exige Node.js 22.19 ou posterior).
import * as cheerio from "cheerio";
import { fetch, ProxyAgent } from "undici";
import { writeFile } from "node:fs/promises";

const START_URL =
  "https://books.toscrape.com/catalogue/category/books/mystery_3/index.html";
const CONCURRENCY = 4;   // páginas de detalhe baixadas ao mesmo tempo
const MAX_RETRIES = 3;   // tentativas extras depois da primeira
const HEADERS = { "user-agent": "book-research/1.0 (+mailto:you@example.com)" };

// Proxy opcional: PROXY_URL=http://user:pass@pr.proxynet.io:8000
const dispatcher = process.env.PROXY_URL
  ? new ProxyAgent(process.env.PROXY_URL)
  : undefined;

const sleep = (ms) => new Promise((resolve) => setTimeout(resolve, ms));
const backoff = (attempt) => 1000 * 2 ** (attempt - 1) + Math.random() * 250;

class HttpError extends Error {
  constructor(status, url) {
    super(`HTTP ${status} for ${url}`);
    this.status = status;
  }
}

async function fetchHtml(url) {
  for (let attempt = 1; ; attempt++) {
    let wait;
    try {
      const res = await fetch(url, {
        headers: HEADERS,
        dispatcher,
        signal: AbortSignal.timeout(15_000),
      });
      if (res.ok) return await res.text();
      const retryable = res.status === 429 || res.status >= 500;
      if (!retryable || attempt > MAX_RETRIES) throw new HttpError(res.status, url);
      const retryAfter = Number(res.headers.get("retry-after"));
      wait = retryAfter > 0 ? retryAfter * 1000 : backoff(attempt);
    } catch (err) {
      if (err instanceof HttpError || attempt > MAX_RETRIES) throw err;
      wait = backoff(attempt); // erro de rede ou timeout
    }
    console.warn(`retry ${attempt}/${MAX_RETRIES} in ${Math.round(wait)} ms: ${url}`);
    await sleep(wait);
  }
}

// Executa fn sobre items com no máximo `limit` chamadas em andamento.
async function mapLimit(items, limit, fn) {
  const results = new Array(items.length);
  let next = 0;
  async function worker() {
    while (next < items.length) {
      const i = next++;
      results[i] = await fn(items[i], i);
    }
  }
  await Promise.all(Array.from({ length: Math.min(limit, items.length) }, worker));
  return results;
}

function parseListPage(html, pageUrl) {
  const $ = cheerio.load(html);
  const books = $("article.product_pod")
    .map((_, el) => {
      const card = $(el);
      const link = card.find("h3 a");
      return {
        title: link.attr("title"),
        price: Number(card.find(".price_color").text().replace(/[^0-9.]/g, "")),
        rating: card.find("p.star-rating").attr("class").split(" ").pop(),
        url: new URL(link.attr("href"), pageUrl).href,
      };
    })
    .get();
  const nextHref = $("li.next a").attr("href");
  return { books, nextUrl: nextHref ? new URL(nextHref, pageUrl).href : null };
}

function parseDetailPage(html) {
  const $ = cheerio.load(html);
  const info = {};
  $("table.table-striped tr").each((_, row) => {
    info[$(row).find("th").text().trim()] = $(row).find("td").text().trim();
  });
  const stock = info["Availability"]?.match(/\((\d+) available\)/);
  return {
    upc: info["UPC"],
    inStock: stock ? Number(stock[1]) : 0,
    description: $("#product_description + p").text().trim(),
  };
}

// 1. Percorrer as páginas da listagem seguindo o link "next".
const listed = [];
for (let url = START_URL; url; ) {
  const { books, nextUrl } = parseListPage(await fetchHtml(url), url);
  listed.push(...books);
  console.log(`${url} -> ${books.length} books`);
  url = nextUrl;
}

// 2. Abrir cada página de detalhe, quatro por vez.
const books = await mapLimit(listed, CONCURRENCY, async (book) => {
  try {
    return { ...book, ...parseDetailPage(await fetchHtml(book.url)) };
  } catch (err) {
    console.error(`skipped ${book.url}: ${err.message}`);
    return { ...book, error: err.message };
  }
});

// 3. Salvar o resultado.
await writeFile(
  "books.json",
  JSON.stringify({ scrapedAt: new Date().toISOString(), count: books.length, books }, null, 2),
);
console.log(`saved ${books.length} books to books.json`);https://books.toscrape.com/catalogue/category/books/mystery_3/index.html -> 20 books
https://books.toscrape.com/catalogue/category/books/mystery_3/page-2.html -> 12 books
saved 32 books to books.jsonUm registro de books.json (descrição encurtada):
{
  "title": "Sharp Objects",
  "price": 47.82,
  "rating": "Four",
  "url": "https://books.toscrape.com/catalogue/sharp-objects_997/index.html",
  "upc": "e00eb4fd7b871a48",
  "inStock": 20,
  "description": "…"
}
O que cada parte faz:
- Paginação. O loop para quando a página não tem
li.next a. O link na página 1 épage-2.html, relativo à pasta da categoria, e por isso toda URL passa pornew URL(href, pageUrl). Outros padrões (números de página na query string, cursores, APIs de "carregar mais") estão em Paginação em web scraping. - Limite de concorrência.
mapLimitinicia quatro workers que pegam o próximo item de um contador compartilhado. UmPromise.allsobre as 32 URLs enviaria 32 requisições de uma vez; com 1.000 URLs, o servidor veria isso como uma rajada. Quatro é um ponto de partida educado para um site pequeno. - Retentativas. Só são repetidos os erros que podem se resolver sozinhos: falhas de rede, o timeout de 15 segundos, 429 e 5xx. Um 404 falha na hora. Um cabeçalho
Retry-Afternumérico tem prioridade sobre a espera calculada; o backoff dobra a partir de mais ou menos um segundo e adiciona uma variação aleatória (jitter) para que os workers paralelos não repitam no mesmo instante. Por que o 429 acontece e como ler o cabeçalho está em HTTP 429 Too Many Requests. - Falha parcial. Uma página de detalhe que ainda falha depois de três retentativas vira uma linha com um campo
error, em vez de interromper a execução. Depois você pode reprocessar só essas linhas. - JSON. O arquivo traz
scrapedAtecount, o que ajuda na comparação entre execuções. Para CSV, JSON Lines ou SQLite com upserts, veja Como salvar dados de scraping em CSV, JSON e SQLite.
Usando um proxy com o Cheerio (undici ProxyAgent)
Neste script o Cheerio nunca abre uma conexão, então o proxy fica no cliente HTTP. Com o undici, você cria um ProxyAgent e o passa para o fetch como dispatcher. O script completo acima já faz isso quando PROXY_URL está definida:
PROXY_URL=http://user:pass@pr.proxynet.io:8000 node scrape-books.mjsO undici monta o cabeçalho Proxy-Authorization a partir do usuário e da senha da URL e os decodifica antes, então caracteres especiais em uma senha precisam de codificação percentual (documentação do ProxyAgent do undici). Para destinos HTTPS, o agente abre um túnel CONNECT, e o TLS até o site roda dentro dele.
Rodamos o script por um pequeno proxy local que exigia user:pass e registrava cada túnel. As 34 requisições (duas páginas de listagem e 32 páginas de detalhe) chegaram por um único CONNECT books.toscrape.com:443: o agente manteve o túnel aberto e o reutilizou. Com uma senha errada, o proxy respondeu 407 e o undici informou Proxy response (407) !== 200 when HTTP Tunneling. O script repetiu isso três vezes antes de desistir; uma senha errada nunca se corrige sozinha, então confira as credenciais em vez de aumentar o número de retentativas.
Se você preferir não adicionar o undici como dependência, o Node.js 24.5 e o 22.21 ganharam suporte nativo a proxy, que lê HTTP_PROXY, HTTPS_PROXY e NO_PROXY quando você define NODE_USE_ENV_PROXY=1 (suporte nativo a proxy do Node.js). A documentação o marca como em desenvolvimento ativo. No nosso teste com o Node.js 24.11.1, o fetch global comum passou pelo proxy local com esta configuração:
NODE_USE_ENV_PROXY=1 HTTPS_PROXY=http://user:pass@pr.proxynet.io:8000 node first-page.mjsAxios e node-fetch usam agentes em vez de dispatchers; Como usar proxy no Node.js cobre os dois. Para trocar o IP de saída a cada requisição ou para sessões fixas que mantêm um IP por um tempo, Proxies residenciais e Proxies rotativos aceitam a mesma URL user:pass@host:port.
Quando o Cheerio não basta
O Cheerio não consegue clicar, rolar a página nem esperar uma requisição que a página faz depois de carregar. Sinais de que você precisa de um navegador:
- O código-fonte da página (Ctrl+U) não tem os dados que a página renderizada mostra.
- O HTML traz um contêiner vazio como
<div id="root"></div>e um pacote de scripts grande. - Os dados só aparecem depois de um formulário de login, de um banner de cookies ou de uma "rolagem infinita".
Antes de abrir um navegador, abra a aba Rede das ferramentas de desenvolvedor. Muitas páginas "dinâmicas" carregam os dados de um endpoint JSON, e requisitar esse endpoint com fetch é mais leve do que renderizar a página. Se você realmente precisar de um navegador, o Playwright pode renderizar a página e entregar o HTML final ao Cheerio com cheerio.load(await page.content()), e o seu código de parsing continua o mesmo.
Onde os scrapers com Cheerio são usados
- Acompanhamento de preços: ler preços de páginas de produto renderizadas no servidor em horários programados (monitoramento de preços).
- Catálogo e dados de mercado: coletar linhas de produtos e níveis de estoque em várias lojas (pesquisa de mercado).
- Visibilidade em buscadores: verificar títulos, meta tags e cabeçalhos das suas próprias páginas (proxy para SEO).
- Pipelines de dados: alimentar um crawler ou um job de ETL maior com linhas já analisadas (extração de dados, web crawler).
- Parsing de HTML salvo: transformar páginas arquivadas em registros estruturados; a parte do parsing é explicada em O que é parsing de dados?.
Erros comuns e como diagnosticá-los
- Strings vazias por toda parte. O seletor não encontrou nada, ou os dados são adicionados por JavaScript. Salve o HTML com
writeFile("page.html", html)e procure nele um valor que você vê no navegador. require(...).default is not a functionoudoes not provide an export named 'default'. Estilo de importação antigo. Useimport * as cheerio from "cheerio".TypeError: fetch failedcominvalid onRequestStart method. Você passou umProxyAgentdo pacote undici do npm para ofetchglobal do Node.js. O Node 24.11.1 embute o undici 7.16.0, e as duas versões não compartilham a interface de dispatcher. ImportefetcheProxyAgentdo mesmo pacote.- Um proxy que "não faz nada". Você passou o agente para
cheerio.fromURL, que usa o próprio cliente. Baixe comfetche chamecheerio.load. - Links relativos falham.
fetch("catalogue/…")lançaFailed to parse URL. Resolva comnew URL(href, pageUrl). - Requisições demais ao mesmo tempo.
Promise.all(urls.map(fetch))envia tudo em paralelo e atrai respostas 429. Use um limite como omapLimit. - Desvio silencioso dos dados. O site renomeia uma classe e os preços viram
NaN. Verifique cada execução: conte as linhas, conte os preçosNaNe pare se os números caírem de forma brusca.
Antes de aumentar a escala, leia o robots.txt e os termos do site, prefira uma API oficial quando houver e mantenha um ritmo de requisições moderado. robots.txt explicado e Web scraping é legal? tratam das regras; Web scraping sem bloqueios trata do crawling educado.
Guia de decisão
| Necessidade | Recomendação |
|---|---|
| Os dados estão no código-fonte da página | fetch + cheerio.load |
| Script avulso, sem proxy | cheerio.fromURL |
| Muitos registros com a mesma estrutura | $.extract com um descritor de array |
| Centenas de páginas | Um limite de concorrência de 2-5 mais retentativas com backoff |
| Requisições por um proxy | fetch do undici + ProxyAgent, ou NODE_USE_ENV_PROXY=1 no Node.js 24.5+ |
| Os dados só aparecem depois que o JavaScript roda | Procure primeiro o endpoint JSON; se não houver, Playwright + Cheerio |
O código espera um DOM completo (document, eventos) | jsdom |
Perguntas frequentes
O Cheerio ainda é mantido em 2026?
Sim. O registro do npm lista a versão 1.2.0, publicada em janeiro de 2026, como a mais recente, e o site de documentação cobre a API 1.x, incluindo extract e fromURL.
O Cheerio executa JavaScript?
Não. Ele analisa a string HTML que você entrega e nada mais. Os scripts da página são tratados como texto. Para páginas que montam o conteúdo no navegador, use o Playwright ou encontre o endpoint de dados que a página chama.
Preciso do Axios com o Cheerio?
Não. O Node.js 18 e versões posteriores incluem fetch, que cobre o que a maioria dos scrapers precisa. O Axios é questão de gosto; se você usá-lo, passe o corpo da resposta (response.data) para cheerio.load.
Como fazer scraping de várias páginas com o Cheerio?
Leia o link da próxima página em cada página, resolva-o em relação à URL atual e repita o loop até o link não existir mais, como no script completo acima. Quando o número de páginas é conhecido, você também pode montar a lista de URLs antes e processá-la com um limite de concorrência.
Como usar um proxy com o Cheerio?
Configure o proxy no cliente HTTP, não no Cheerio. Com o undici: new ProxyAgent("http://user:pass@pr.proxynet.io:8000"), passado como dispatcher para o fetch do undici. No Node.js 24.5 ou posterior, você pode em vez disso definir NODE_USE_ENV_PROXY=1 e HTTPS_PROXY.
O Cheerio é mais rápido que o Puppeteer ou o Playwright?
Para páginas cujos dados estão no HTML, sim, porque ele só analisa texto, enquanto um navegador também baixa recursos, executa scripts e calcula o layout da página. Não fizemos benchmark da diferença, e ela depende da página, então meça nos seus próprios alvos se os números importarem.
Em resumo
O Cheerio transforma o HTML baixado em uma árvore que você consulta com seletores CSS e, na versão 1.x, acrescenta fromURL e extract. Um scraper confiável deixa o trabalho de rede fora do Cheerio: fetch com timeout, retentativas para 429, 5xx e erros de rede, um limite de concorrência pequeno e um arquivo JSON com data e hora. Quando as requisições precisam sair de outro IP ou de outro país, passe um ProxyAgent do undici como dispatcher e aponte-o para um proxy da Proxynet.