Toda segunda-feira, a dona de uma pequena livraria online confere quanto custam 150 dos seus títulos em outras três lojas. À mão, são 450 visitas a páginas e boa parte da manhã, e até quarta-feira alguns números já estão desatualizados. Um programa curto pode abrir as mesmas páginas, ler o preço ao lado de cada título e preencher a planilha sozinho. Esse programa é um web scraper, e o trabalho que ele faz se chama web scraping.
Este artigo acompanha um preço real desde a primeira requisição até a tabela pronta. No caminho, compara o scraping com o crawling e com as APIs, organiza as ferramentas pelo nível de conhecimento que exigem, trata da legalidade, explica por que os sites bloqueiam scrapers e onde entra um proxy, e termina com um exemplo curto em Python que executamos em um site de prática.
O que é web scraping?
Web scraping é usar um software para ler páginas web e copiar delas informações específicas para um formato estruturado. Quem olha a página de um produto vê uma imagem, um título e um preço. Um scraper vê o texto por trás da página, o código HTML, e tira só as partes que foi instruído a encontrar: nomes de produtos, preços, datas, células de tabelas, links.
Data scraping é o termo mais amplo e também cobre a retirada de dados de arquivos, PDFs ou telas de programas antigos; o web scraping é a parte que trabalha com sites. A extração de dados, por sua vez, é a etapa dentro do scraping em que os campos são separados. Um scraper também não é uma ferramenta de hacking. Ele lê as mesmas páginas que qualquer visitante pode abrir, só que mais rápido, e é essa velocidade que faz o scraping vir acompanhado de regras.
Antes de escrever qualquer código, decida de quais campos você precisa. O scraper então preenche uma linha por produto ou artigo. Coletar "tudo o que está na página, só por garantia" deixa os dados mais difíceis de limpar e mais propensos a incluir informações pessoais que você não deveria guardar.
Como funciona o web scraping?
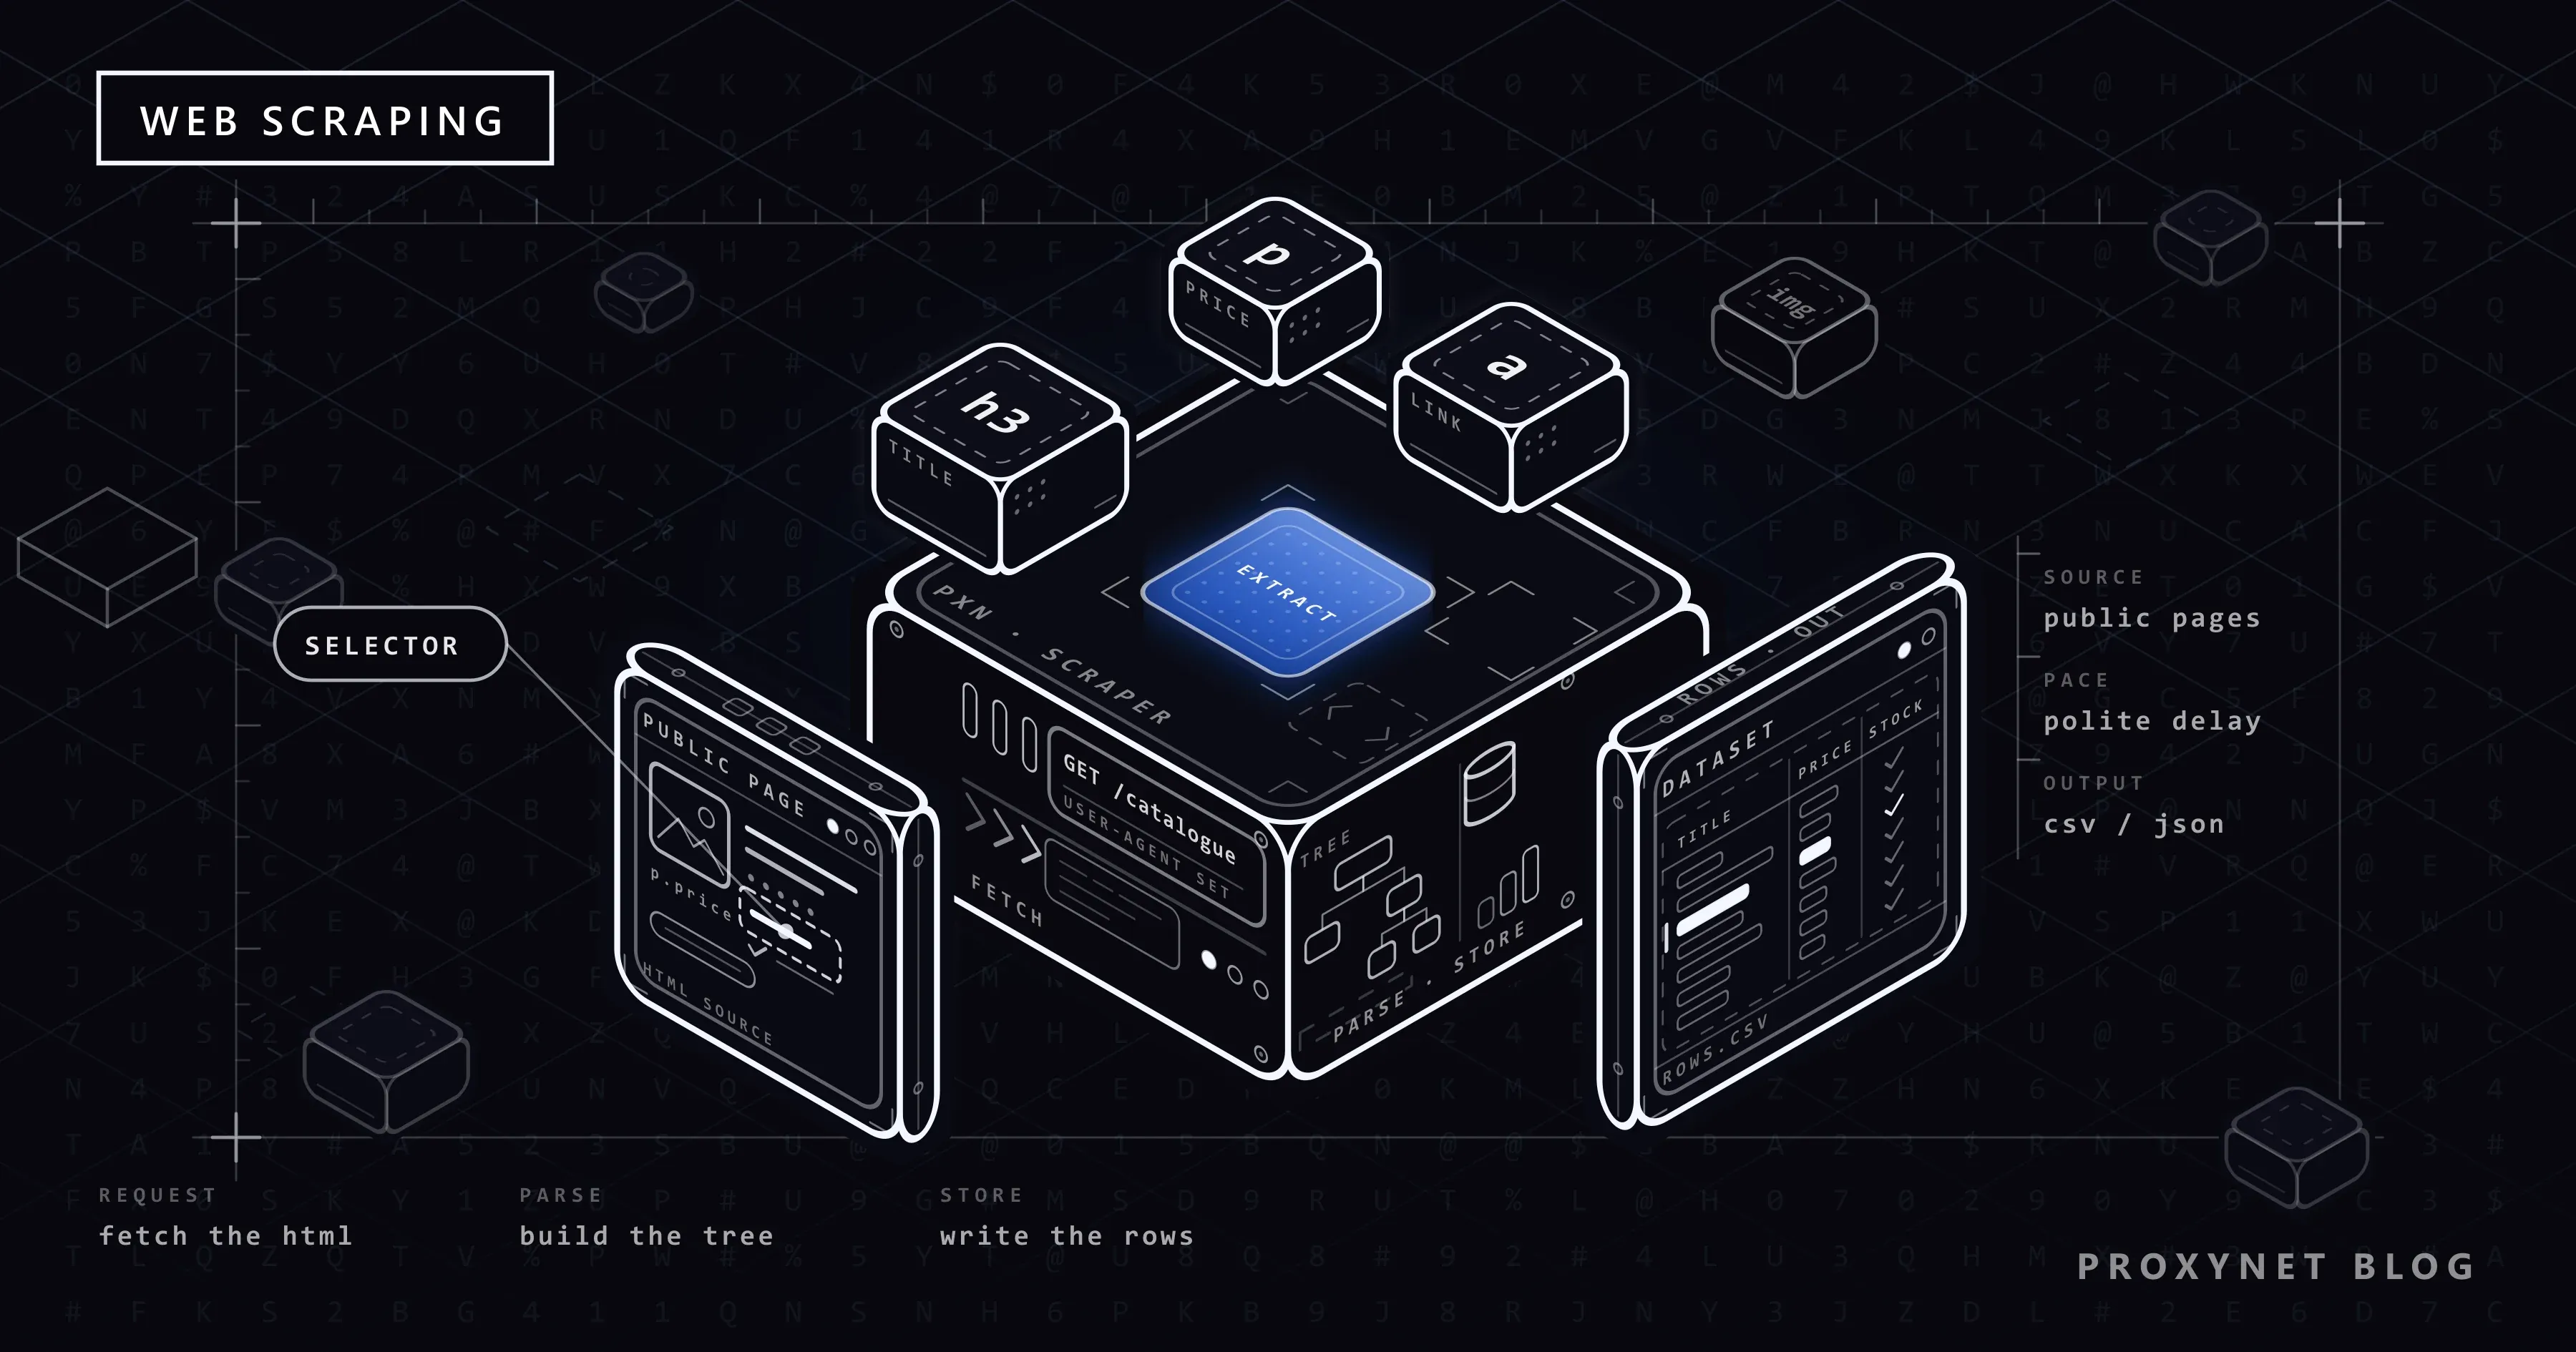
Todo scraper, de uma extensão de navegador a um sistema que visita milhões de páginas, executa o mesmo ciclo. Vamos acompanhar um preço real ao longo dele: o primeiro livro da página da categoria Travel do books.toscrape.com, um site que se apresenta como demonstração para fins de web scraping e cujos preços são aleatórios.
- Escolher as páginas. O scraper começa com uma lista de endereços, escrita por você ou montada por um crawler que segue links. A nossa tem uma única entrada: a página da categoria Travel.
- Verificar as regras. Procure uma API oficial ou um link de download, leia os termos de uso e abra o arquivo robots.txt do site. No site de prática, esse endereço retorna um erro 404; o site existe justamente para servir de alvo de scraping.
- Enviar uma requisição. O programa pede a página ao servidor com uma requisição HTTP, a mesma mensagem que um navegador envia. Um scraper bem-comportado acrescenta um cabeçalho User-Agent que diz o que ele é.
- Receber o HTML. O servidor responde com um código de status (200 significa que a página foi entregue) e o HTML. Nosso preço chega como
<p class="price_color">£45.17</p>: texto envolto em tags, ainda não um número. - Fazer o parsing do HTML. Um parser transforma o texto em uma árvore de elementos aninhados que o programa consegue pesquisar. Explicamos essa etapa no nosso artigo sobre parsing de dados.
- Extrair os campos. Um seletor CSS aponta para o elemento exato: dentro de cada card de produto, o parágrafo com a classe
price_color. O resultado é um pequeno registro: "It's Only the Himalayas",£45.17, "In stock". - Limpar e armazenar. Os espaços são removidos, o símbolo da moeda é separado se você quiser fazer contas, e o registro vira uma linha em um arquivo ou banco de dados; os formatos são comparados em Como salvar dados de scraping em CSV, JSON e SQLite.
- Repetir em uma programação. O scraper passa para a próxima página ou roda de novo amanhã. É comparando a linha de hoje com a de ontem que uma mudança de preço fica visível.
As etapas 3 a 7 levam bem menos de um segundo por página. O trabalho cuidadoso está nas etapas 1, 2 e 8.
Web scraping vs. web crawling vs. API
| Web scraping | Web crawling | API oficial | |
|---|---|---|---|
| O que faz | Tira campos de páginas conhecidas | Encontra páginas seguindo links | Entrega dados que o site já estruturou |
| O que você recebe | Linhas: título, preço, data | Uma lista de endereços de páginas | JSON ou CSV em um formato documentado |
| Quem define o formato | Você, com seletores | Ninguém; é uma lista de URLs | O site |
| Quando quebra | Quando o design da página muda | Quando os links do site mudam | Raramente; novas versões são anunciadas |
| O que o regula | robots.txt, termos de uso, a lei | robots.txt e ritmo de crawling | Uma chave de API e os termos da API |
Na prática, os dois primeiros trabalham juntos: um crawler encontra as páginas de produto e um scraper lê cada uma delas. Comparamos os dois com código Scrapy em Web scraping vs. web crawling: qual é a diferença?, e nossa página de web crawler trata de configurações de proxy para crawls grandes. Quando um site oferece uma API com os campos de que você precisa, ela é quase sempre o melhor caminho, porque não quebra quando um designer renomeia uma classe; nossa comparação entre web scraping e API percorre essa decisão.
Ferramentas de web scraping: qual tipo serve para quem?
Os tipos de ferramenta se diferenciam principalmente em quanto do ciclo fazem por você e em quanto controle deixam nas suas mãos.
| Tipo de ferramenta | Conhecimento necessário | Bom para | Onde deixa a desejar |
|---|---|---|---|
| Extensão de navegador | Nenhum | Algumas centenas de linhas de um site, uma única vez | Quebra sem aviso quando o layout muda |
| Ferramenta no-code para desktop ou nuvem | Baixo | Tarefas agendadas sem programação | Seus dados passam por terceiros; os planos gratuitos são limitados |
| Bibliotecas de Python ou Node.js | Médio | Tarefas regulares, milhares de páginas, seu próprio formato | Você escreve e mantém o código |
| Navegador headless | Médio a alto | Páginas que preenchem o conteúdo com JavaScript | Lento e pesado em memória |
| AI scraper | Baixo a médio | Layouts que mudam com frequência | Custo por página; um valor errado pode parecer certo |
| API de scraping hospedada | Baixo a médio | Entra uma URL, sai HTML ou JSON, sem servidores para manter | Custo mensal; as regras do site continuam valendo para você |
Um navegador headless é um navegador de verdade sem janela, que executa o JavaScript da página para o seu código; quando você precisa de um está explicado em Páginas estáticas e dinâmicas no web scraping. Um AI scraper entrega a etapa de "encontrar o campo" a um modelo de linguagem; os prós e contras estão no nosso artigo sobre AI web scraper. Sem código, comece pelo nosso guia para extrair dados de um site; com código, o tutorial de BeautifulSoup vai além do exemplo abaixo.
Web scraping é legal?
Coletar dados públicos e não pessoais em um ritmo razoável não é proibido em si na maioria dos sistemas jurídicos. O que muda a resposta é o que você coleta e como: dados pessoais estão sujeitos a leis como a LGPD no Brasil e o RGPD da União Europeia mesmo quando estão à vista de todos, textos e bancos de dados protegidos por direitos autorais têm proteção própria, e os termos de uso podem proibir a coleta automatizada. Fazer scraping atrás de um login ou contornando uma barreira técnica coloca você em terreno bem mais frágil. As regras por país estão em Web scraping é legal? Um panorama; este artigo não é aconselhamento jurídico.
Por que os sites bloqueiam scrapers?
Uma pessoa lê uma página em um minuto; um script descuidado pode pedir cem páginas nesse mesmo minuto e deixar o site lento para todo mundo. Três mecanismos decidem se um scraper continua recebendo respostas.
- Limites de taxa (rate limits). O servidor conta as requisições por endereço ou por conta dentro de uma janela de tempo. Passado o limite, ele responde
429 Too Many Requests, definido na RFC 6585, opcionalmente com um cabeçalhoRetry-Afterque diz quanto tempo esperar. A RFC não define como o servidor faz a contagem, então cada site fixa o próprio limite; veja nosso artigo sobre o erro 429 Too Many Requests. - Reputação do IP. Endereços têm histórico. Faixas de datacenter, endereços que apareceram em spam e endereços que enviam milhares de requisições por hora recebem menos confiança do que uma conexão residencial.
- Pontuações de bot. Serviços de proteção contra bots combinam em uma pontuação a taxa de requisições, os cabeçalhos, o handshake TLS e a execução ou não de JavaScript; abaixo de um limite, o visitante recebe um desafio ou um bloqueio. As camadas estão explicadas em Como funciona a detecção de bots.
Onde entra o proxy?
Um servidor proxy repassa suas requisições, e o site vê o endereço IP do proxy em vez do seu. Isso importa em duas situações legítimas. A primeira é a localização: uma loja que mostra um preço na Alemanha e outro em Türkiye só pode ser verificada a partir de cada país, e os Proxies residenciais com segmentação por localização permitem escolher o país e a cidade. A segunda é o volume: um trabalho grande não deve se acumular em um único endereço, e os Proxies rotativos dão a cada requisição, ou a cada sessão de alguns minutos, um IP diferente de um pool. Nossa página de extração de dados relaciona os tipos de proxy a cada trabalho.
Um proxy não é um jeito de contornar um limite de taxa ou um bloqueio. Se um site responde 429 ou pede que você pare, diminua o ritmo, passe para a API ou peça permissão; trocar de IP para manter o ritmo é exatamente o que o limite existe para impedir. A lista de diagnóstico está em Como fazer web scraping sem ser bloqueado.
Checklist de web scraping responsável
- API primeiro. Procure uma API oficial, um download ou um feed antes de fazer o parsing de uma página.
- Siga o robots.txt. A RFC 9309 coloca o arquivo em
/robots.txt, no caminho de nível mais alto, e diz que as regras dele não são uma forma de autorização de acesso. É um pedido, não uma tranca: nada impede um scraper de ignorá-lo, e por isso segui-lo é responsabilidade sua. Como ler o arquivo está no nosso guia de robots.txt. - Leia os termos de uso. Um site que proíbe a coleta automatizada não é um alvo.
- Só páginas públicas, nunca atrás do login de outra pessoa.
- Deixe os dados pessoais de fora. Veja Como tratar dados pessoais (PII) em dados de scraping para saber o que fazer quando eles entram por engano.
- Mantenha um ritmo lento e constante: segundos entre requisições a um site pequeno e uma parada total diante de um
429ou503. - Diga quem você é com um User-Agent honesto, não com uma identidade falsa de navegador.
Um exemplo curto de web scraping em Python
Python é um ponto de partida comum porque duas bibliotecas fazem a parte difícil. O Requests envia a requisição HTTP. O Beautiful Soup é, nas palavras da própria documentação, uma biblioteca Python para extrair dados de arquivos HTML e XML; ele mesmo não baixa nada.
pip install requests beautifulsoup4O script lê a categoria Travel do site de prática, pega o título, o preço e a situação de estoque de cada livro e grava tudo em um arquivo CSV. Os comentários numerados correspondem às etapas 3 a 7 acima.
import csv
import os

import requests
from bs4 import BeautifulSoup

URL = "https://books.toscrape.com/catalogue/category/books/travel_2/index.html"

# Opcional: PROXY_URL=http://user:pass@pr.proxynet.io:8000
proxy = os.environ.get("PROXY_URL")
proxies = {"http": proxy, "https": proxy} if proxy else None

# 1. Requisição: baixar a página
response = requests.get(
    URL,
    headers={"User-Agent": "scraping-intro/1.0 (contact: you@example.com)"},
    proxies=proxies,
    timeout=20,
)
response.raise_for_status()
response.encoding = "utf-8"

# 2. Parsing: transformar o texto HTML em uma árvore pesquisável
soup = BeautifulSoup(response.text, "html.parser")

# 3. Extração: os mesmos três campos de cada card de produto
rows = []
for card in soup.select("article.product_pod"):
    rows.append({
        "title": card.h3.a["title"],
        "price": card.select_one("p.price_color").get_text(strip=True),
        "stock": card.select_one("p.availability").get_text(strip=True),
    })

# 4. Armazenamento: gravar as linhas em um arquivo CSV
with open("travel_books.csv", "w", newline="", encoding="utf-8-sig") as f:
    writer = csv.DictWriter(f, fieldnames=["title", "price", "stock"])
    writer.writeheader()
    writer.writerows(rows)

print(len(rows), "livros salvos em travel_books.csv")
for row in rows[:3]:
    print(row["price"], "|", row["stock"], "|", row["title"])
Executado com Python 3.13, Requests 2.34 e Beautiful Soup 4.15, ele imprimiu:
11 livros salvos em travel_books.csv
£45.17 | In stock | It's Only the Himalayas
£49.43 | In stock | Full Moon over Noah’s Ark: An Odyssey to Mount Ararat and Beyond
£48.87 | In stock | See America: A Celebration of Our National Parks & Treasured Sites
Três linhas estão ali por um motivo. Sem timeout=20, o Requests nunca desiste de um servidor que não responde, como a própria documentação avisa, e o script trava. O site de prática envia Content-Type: text/html sem conjunto de caracteres, então o Requests recorre ao ISO-8859-1; quando removemos response.encoding = "utf-8", todos os preços saíram como £45.17. E raise_for_status() interrompe o script diante de uma resposta 4xx ou 5xx, para que uma página de erro nunca seja salva como dado.
Para passar por um proxy, defina PROXY_URL como http://user:pass@pr.proxynet.io:8000 antes de executar; nada mais muda. Testamos isso com um proxy de teste local: com as credenciais certas vieram as mesmas 11 linhas, e uma senha errada gerou um ProxyError contendo 407 Proxy Authentication Required. Para paginação, novas tentativas e um pool rotativo, continue com Web scraping em Python com proxies rotativos.
Para que serve o web scraping?
- Monitoramento de preços e estoque: acompanhar os preços públicos e os níveis de estoque da concorrência. A configuração está na nossa página de monitoramento de preços.
- Pesquisa de mercado: a quantidade de produtos, as faixas de preço e o mix de marcas em várias lojas mostram como um mercado se movimenta. Veja nossa página de pesquisa de mercado.
- Dados de SEO: suas próprias posições vêm da API oficial do Search Console, e dados de SERP licenciados preenchem as lacunas. As políticas de spam do Google tratam como violação a coleta de resultados para verificar posições sem permissão expressa; o caminho oficial está em Como automatizar o acompanhamento de posições no SEO.
- Pesquisa e ciência de dados: anúncios e estatísticas públicas coletados ao longo do tempo viram um conjunto de dados para análise, o tema de Mineração de dados: técnicas, usos e como obter os dados.
- Ferramentas de IA e RAG: na geração aumentada por recuperação (RAG, na sigla em inglês), um modelo de IA consulta documentos atuais antes de responder, e muitas vezes são scrapers que buscam esses documentos. Veja Acesso seguro à web para LLMs para conhecer os limites.
- Auditoria do seu próprio site: descrições ausentes, preços errados e links quebrados em milhares de páginas. Nosso artigo sobre códigos de status HTTP no web scraping ajuda a interpretar as respostas.
Erros comuns
- Fazer scraping quando existe uma API. O trabalho quebra a cada redesign.
- Não definir timeout. Um único servidor que não responde pode deixar um script travado a noite toda.
- Ignorar a codificação.
£no lugar de£, ou letras acentuadas quebradas, significa que o conjunto de caracteres foi adivinhado errado. - Tratar um resultado vazio como dado. Um seletor que deixa de encontrar o elemento costuma gerar uma coluna vazia, não um erro. Confira a quantidade de linhas a cada execução.
- Usar proxy para passar por cima de um limite. Um
429pede que você diminua o ritmo; rodar IPs para manter o ritmo só agrava o problema. - Começar com um navegador headless. Se os dados já estão no HTML, um navegador de verdade só acrescenta tempo e memória.
Guia de decisão
| Necessidade | Recomendação |
|---|---|
| O site oferece uma API com os seus campos | Use a API em vez de fazer scraping |
| Uma tabela de uma página, uma única vez | A importação de uma planilha ou uma extensão de navegador |
| As mesmas páginas todos os dias | Um script Python com pausa, timeout e conferência da quantidade de linhas |
| O conteúdo só aparece depois que o JavaScript roda | Primeiro a fonte JSON da página, depois um navegador headless |
| Os preços mudam conforme o país | Proxies residenciais segmentados para esse país |
| Milhares de páginas em ritmo educado | Um crawler com proxies rotativos para distribuir a carga |
| O site responde 429 | Diminua o ritmo e respeite o Retry-After |
| Dados pessoais ou o login de outra pessoa | Não faça scraping; fale com o dono do site |
Perguntas frequentes
Para que serve o web scraping na ciência de dados?
Para conjuntos de dados que não existem prontos: preços em várias lojas ao longo do tempo, vagas de emprego por cidade, avaliações para análise de texto. O valor costuma vir de repetir a coleta durante semanas, então uma programação estável importa mais do que a velocidade.
Dá para fazer web scraping sem programar?
Sim. Importações de planilha, extensões de navegador e ferramentas no-code resolvem trabalhos pontuais e layouts simples. Com grandes volumes, repetições diárias e páginas que mudam com frequência, um script curto com checagem de erros acaba dando menos trabalho.
Por que o Python é tão usado no web scraping?
Porque as peças já estão prontas: Requests para baixar, Beautiful Soup para o parsing, Scrapy para crawls grandes e Playwright para páginas que precisam de um navegador. O Node.js é uma alternativa comum; comparamos os dois em Extração de dados: JavaScript ou Python?
Um site consegue perceber que está sendo alvo de scraping?
Muitas vezes, sim. A taxa de requisições, o User-Agent, a ausência de execução de JavaScript e a reputação do IP apontam para automação. Um scraper que se identifica e mantém um ritmo baixo costuma ser tolerado; um que se passa por navegador e envia centenas de requisições por minuto costuma ser bloqueado.
O web scraping funciona em qualquer site?
Não. Páginas atrás de login, texto desenhado dentro de imagens e dados que só existem em um aplicativo móvel ficam fora do alcance de um scraper simples, e muitos deles devem continuar assim. Páginas que carregam o conteúdo com JavaScript podem ser lidas, mas precisam de um navegador headless ou da própria fonte de dados da página.
Você precisa de proxy para fazer web scraping?
Não para um trabalho pequeno e lento a partir de um só país. Você precisa quando o conteúdo muda conforme o país, quando um trabalho grande tem de distribuir a carga entre muitos endereços ou quando uma sessão com a sua própria conta precisa manter o mesmo IP. Um proxy não faz sumir o limite de taxa nem os termos de uso de um site.
Em resumo
Web scraping é a versão automatizada de ler uma página e copiar para uma tabela aquilo de que você precisa: pedir a página, fazer o parsing do HTML, extrair os campos, armazenar as linhas e repetir em uma programação. O crawling encontra as páginas, o scraping as lê, e uma API oficial torna os dois desnecessários quando existe. Escolha a ferramenta mais simples que resolva o trabalho, verifique antes o robots.txt e os termos de uso, deixe os dados pessoais de fora e mantenha o ritmo baixo. Quando um trabalho precisa de resultados específicos de um país ou tem de distribuir a carga entre muitos endereços, você encontra o tipo de proxy certo entre nossos serviços de proxy.