Seu script lê 2.000 páginas de produto toda noite. As primeiras 300 voltam bem, depois as respostas viram 429 Too Many Requests e, alguns minutos mais tarde, cada requisição recebe um 403. Nada mudou no código; o site contou as requisições vindas do seu endereço e decidiu que nenhum visitante se comporta assim. Um proxy rotativo é a resposta padrão, mas mal conectado ele cria problemas novos: o IP não muda quando você espera, um login quebra no meio do caminho ou vinte workers transformam um scraper educado em uma enxurrada.
Este tutorial monta a configuração em Python do início ao fim: por que um único IP acaba limitado, como um gateway rotativo atribui saídas, o dicionário proxies do requests, a reutilização de sessões e por que ela desliga a rotação sem avisar, repetições que respeitam Retry-After, um pool de threads e uma variante com httpx e asyncio, a escolha entre por requisição e sessão fixa, a checagem do IP de saída e os limites que você mantém. Cada trecho rodou em 29 de setembro de 2026 com Python 3.13.9, requests 2.34.2, httpx 0.28.1 e tenacity 9.1.4. Os conceitos estão em O que é rotação de IP e Como fazer scraping sem ser bloqueado; este artigo é o código.
Por que um único IP recebe 429 ou 403?
Os sites contam requisições por cliente, e o identificador de cliente mais simples é o IP de origem. Um limitador mantém um contador por endereço dentro de uma janela e, quando o contador passa do limite, responde com 429 Too Many Requests. A RFC 6585, seção 4 define o código para esse caso e diz que a resposta pode trazer um cabeçalho Retry-After informando quanto tempo esperar. Os algoritmos de contagem estão em Erro 429 Too Many Requests explicado.
Um 403 depois de vários 429 é outra camada: o limitador pediu para você desacelerar, você não desacelerou, e uma regra moveu seu endereço para uma lista de bloqueio que sobrevive ao seu script. Rotacionar saídas espalha as requisições por muitos endereços para que nenhum cruze o limite, mas não substitui desacelerar: envie 600 requisições por minuto de dez endereços para um site que permite 60 e você terá dez endereços bloqueados em vez de um.
Como funciona um gateway de proxy rotativo?
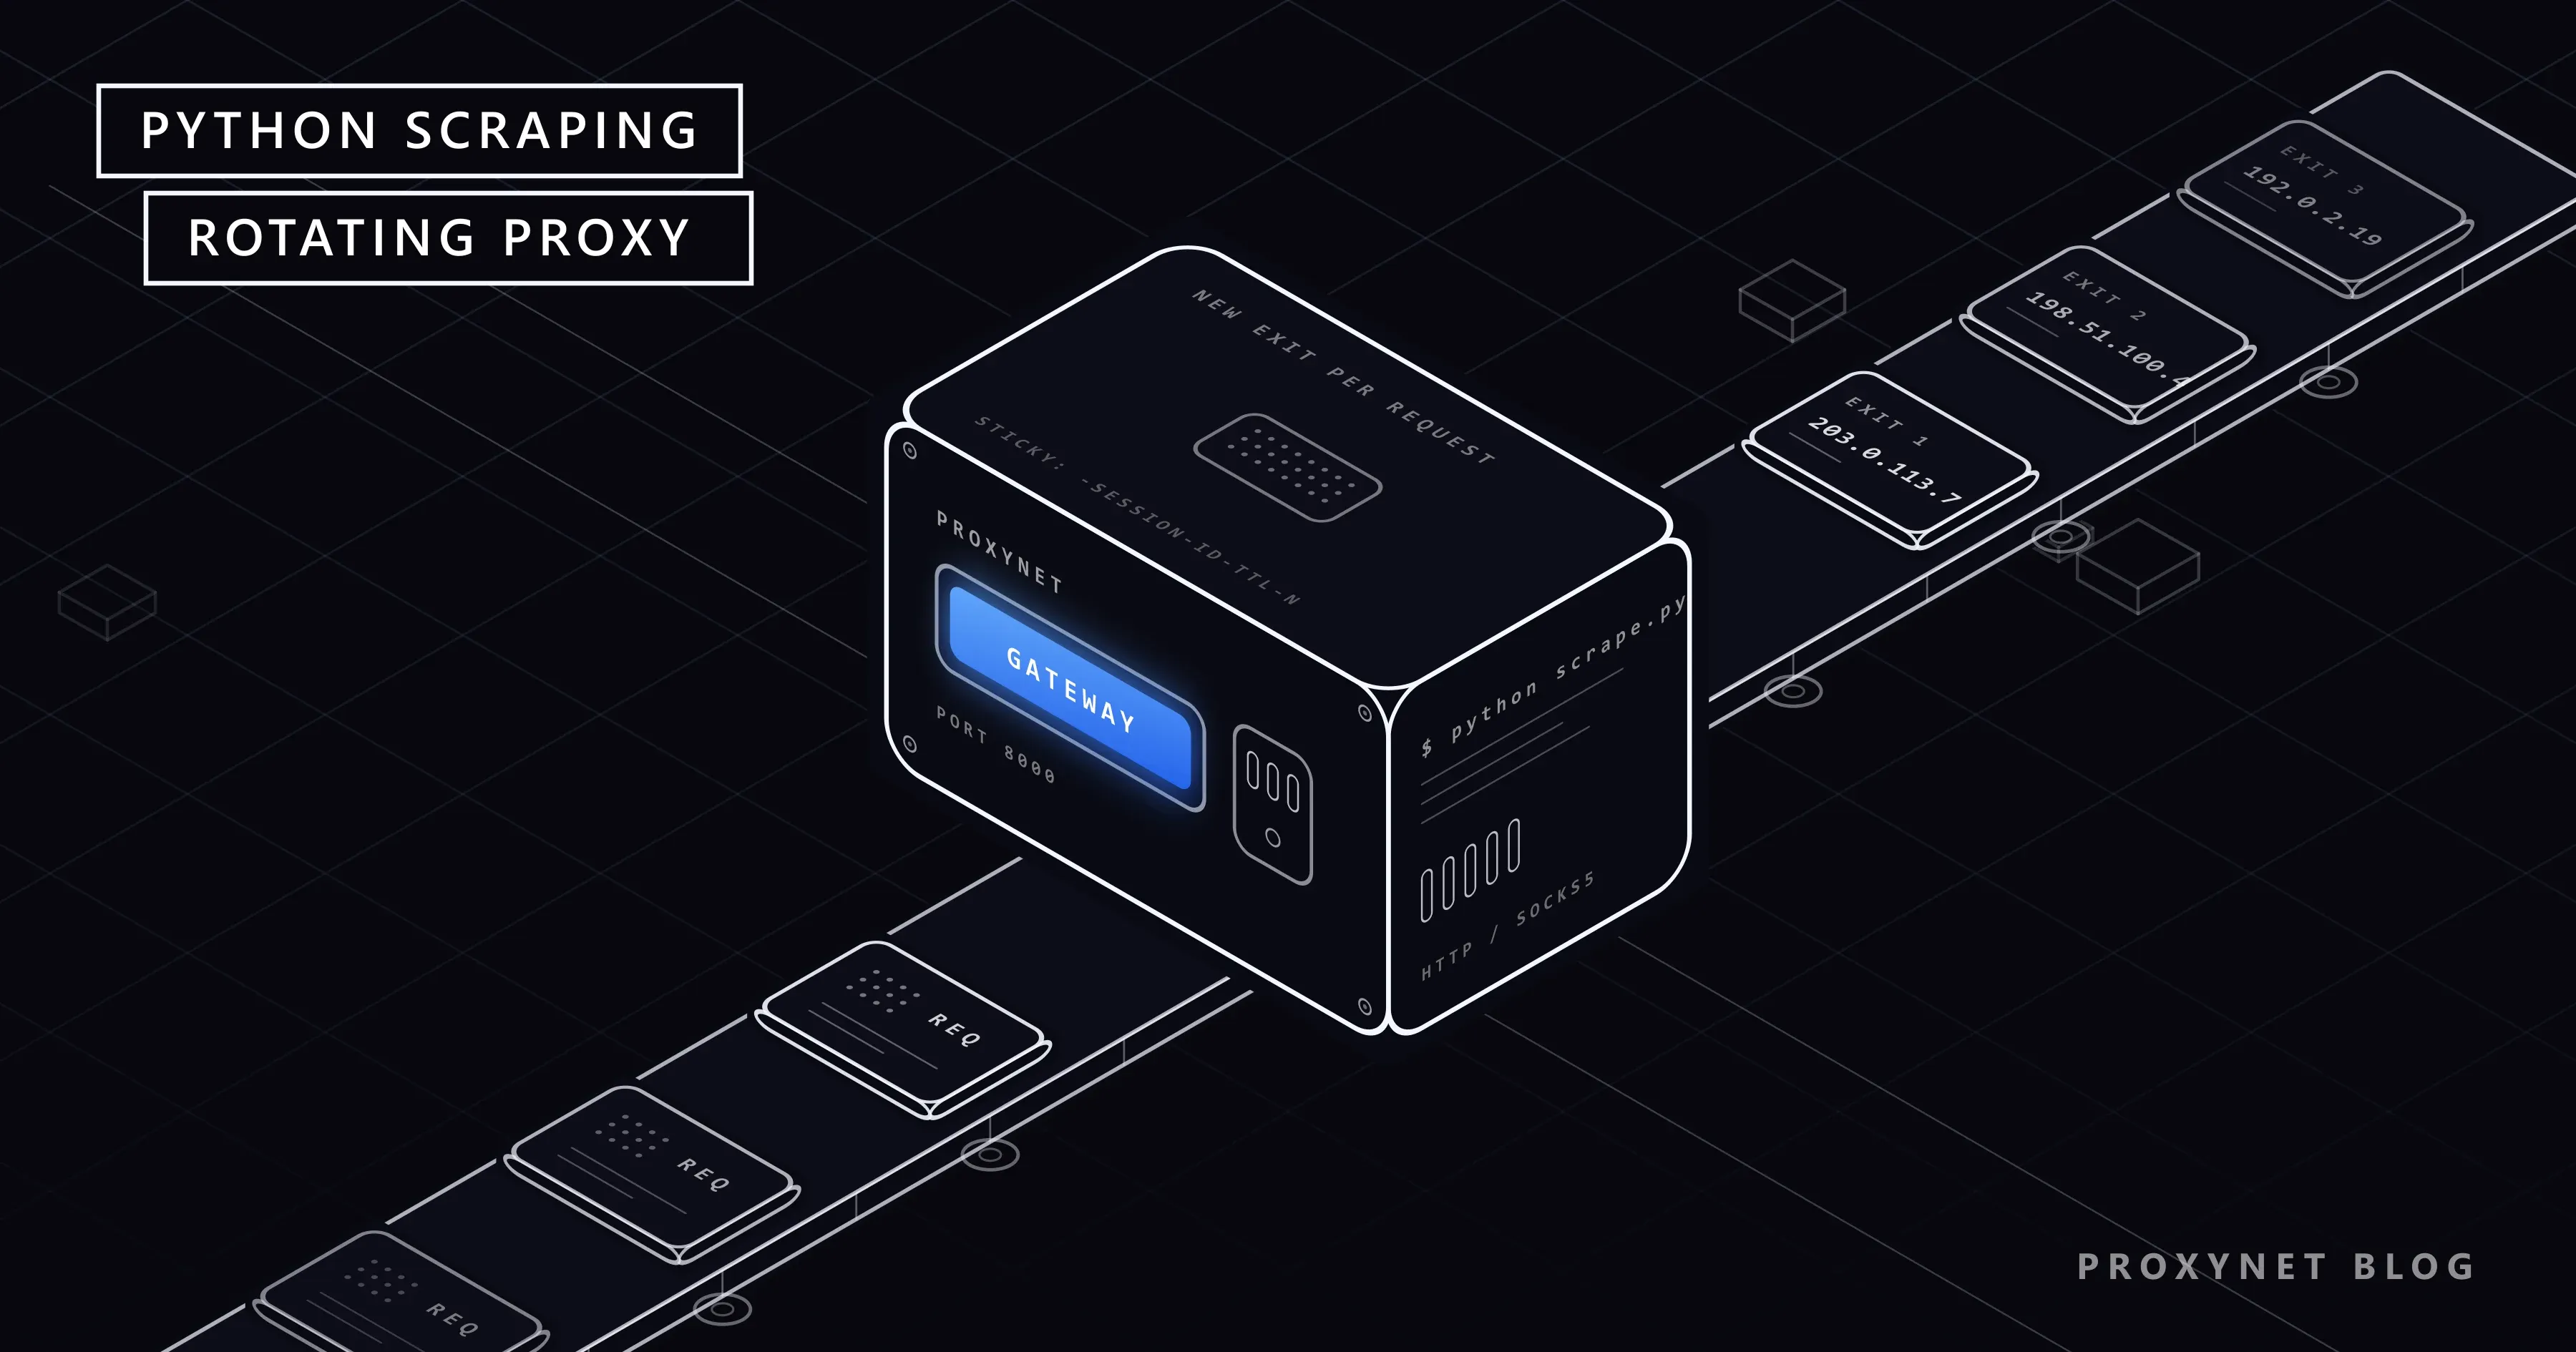
No modelo de gateway (backconnect) seu código conhece um único endereço, pr.proxynet.io:8000 nos exemplos, e o provedor gerencia o pool que fica atrás dele. Uma requisição HTTPS segue este caminho:
- Seu cliente abre uma conexão TCP com o gateway e envia
CONNECT target:443com um cabeçalhoProxy-Authorization: Basic ...montado a partir deuser:pass. - O gateway lê o nome de usuário. Tudo depois da parte da sua conta é um parâmetro:
-country-trfiltra o pool para um país,-session-<id>-ttl-<seconds>pede uma sessão fixa. - O gateway escolhe uma saída do pool filtrado: uma nova para cada túnel no modo por requisição, ou a que já está ligada ao seu ID de sessão no modo fixo.
- O túnel é estabelecido, o TLS corre entre seu cliente e o alvo, e o alvo vê o IP da saída.
- Quando o túnel fecha, o vínculo desaparece. A próxima conexão recebe uma saída nova, a menos que um ID de sessão esteja segurando uma.
O passo 3 é toda a história deste tutorial. A unidade da rotação é o túnel, não a requisição HTTP: enquanto um túnel CONNECT continuar aberto, cada requisição que passa por ele sai pela mesma saída. É por isso que o keep-alive, que todo cliente moderno liga por padrão, muda o que "por requisição" significa na prática. O lado do produto está na página de Proxies rotativos; as saídas aqui vêm de um pool de Proxies residenciais, então o alvo vê um endereço doméstico comum. O painel gera o nome de usuário real (proxynet-xxxxxxxx-country-tr-session-…-ttl-1800); abaixo ele aparece abreviado como user.
Rotação por requisição vs. sessão fixa vs. IP estático
| Rotação por requisição | Sessão fixa | IP estático | |
|---|---|---|---|
| O que muda o IP | Cada conexão nova | A troca do ID de sessão ou o fim do TTL (de 1 a 60 minutos) | Nada; o endereço é seu |
| Nome de usuário | user | user-session-<id>-ttl-<seconds> | Produto separado, host:port fixo |
| Cookies e logins | Quebram; o site vê um cookie vindo de muitas cidades | Preservados durante o TTL | Preservados indefinidamente |
| Custo por requisição | Handshake TCP e TLS novo a cada vez | Um handshake, depois keep-alive | Um handshake, depois keep-alive |
| Workers em paralelo | Cada conexão recebe sua própria saída | Um ID por worker, uma saída por ID | Tantas saídas quantos endereços você alugar |
| Trabalho típico | Páginas de produto ou listagens independentes | Login, carrinho, paginação em várias páginas | Listas de permissão de API, contas de longa duração |
A sessão fixa é um pedido para segurar a saída, não uma garantia; um dispositivo residencial pode ficar offline e o gateway move a sessão antes da hora. O comportamento do produto está na página de Proxies de sessão fixa.
Configurando o requests: o dicionário proxies
A documentação do requests sobre proxies recomenda passar proxies explicitamente em cada requisição, porque valores definidos em session.proxies podem ser sobrescritos pelas variáveis de ambiente HTTP_PROXY e HTTPS_PROXY. As chaves são o esquema da URL de destino, e ambas apontam para o mesmo endereço http:// do gateway, já que o tráfego HTTPS é tunelado:
import os
import requests

# Esta string é gerada pelo painel; guarde em uma variável de ambiente, não no git.
GATEWAY = os.environ.get("PROXY_URL", "http://user:pass@pr.proxynet.io:8000")
PROXIES = {"http": GATEWAY, "https": GATEWAY}
HEADERS = {"User-Agent": "price-monitor/1.0 (+mailto:you@example.com)"}

resp = requests.get("https://httpbin.org/ip", proxies=PROXIES, headers=HEADERS, timeout=(5, 30))
print(resp.status_code, resp.json())
A tupla timeout define 5 segundos para conectar e 30 para ler; sem ela, uma saída travada deixa um worker pendurado para sempre. O User-Agent nomeia seu script e dá ao dono do site um jeito de falar com você, o que O que é user agent recomenda em vez de fingir ser um navegador. As credenciais ficam em uma variável de ambiente porque a mesma documentação alerta contra arquivos sob controle de versão. Para SOCKS5 instale requests[socks] e use socks5h://user:pass@pr.proxynet.io:1080; o h faz o proxy resolver o DNS, e a porta SOCKS5 rotaciona do mesmo jeito.
Reutilização de sessão: por que o IP não mudou
Uma requests.Session reutiliza a conexão TCP, o que atrás de um proxy significa reutilizar o túnel e, portanto, a saída. Medimos isso com um proxy de teste local que registra cada CONNECT:
Três GET para o mesmo host | Túneis abertos | Saídas atribuídas (uma por túnel) |
|---|---|---|
requests.get(...) três vezes, sem sessão | 3 | 3 |
Uma Session, três s.get(...) | 1 | 1 |
Uma Session, headers={"Connection": "close"} | 3 | 3 |
Um httpx.AsyncClient, três await client.get(...) sequenciais | 1 | 1 |
A regra vem daí: para rotação por requisição, chame requests.get sem sessão ou envie Connection: close; para trabalho com sessão fixa, use uma Session e um ID de sessão juntos, porque senão uma conexão derrubada reatribuiria a saída.
Repetições com backoff que respeitam Retry-After
Atrás de um gateway rotativo duas coisas falham: a rede (uma saída cai, o túnel é recusado, uma leitura estoura o tempo) e o alvo (um 429 ou um 5xx). As duas merecem uma nova tentativa, mas não a mesma espera. Um 429 pode trazer o número do próprio site em Retry-After, e esse número vence. Todo o resto recebe backoff exponencial com jitter, para que quatro workers que falharam juntos não repitam juntos:
import logging
import random
import time

import requests

MAX_ATTEMPTS = 4         # primeira tentativa + 3 repetições
RETRY_STATUS = {429, 500, 502, 503, 504}
TIMEOUT = (5, 30)        # conexão, leitura - segundos
log = logging.getLogger("scraper")


def backoff(attempt: int) -> float:
    """1, 2, 4, 8 s ... mais jitter para que os workers não repitam em sincronia."""
    return min(2 ** (attempt - 1), 30) + random.uniform(0, 1)


def fetch(url: str) -> requests.Response:
    """GET de uma URL com repetições. Lança exceção depois da última tentativa falha."""
    for attempt in range(1, MAX_ATTEMPTS + 1):
        try:
            resp = requests.get(url, proxies=PROXIES, headers=HEADERS, timeout=TIMEOUT)
        except (requests.ConnectionError, requests.Timeout) as exc:
            # Inclui ProxyError: o gateway recusou ou derrubou o túnel.
            log.warning("attempt %d/%d %s: %s", attempt, MAX_ATTEMPTS, url, exc.__class__.__name__)
            if attempt == MAX_ATTEMPTS:
                raise
            time.sleep(backoff(attempt))
            continue

        if resp.status_code not in RETRY_STATUS:
            return resp  # 200, 404, 301 ... quem chamou decide

        # O site pediu para desacelerar. O número dele vence o nosso cronograma.
        retry_after = resp.headers.get("Retry-After")
        wait = float(retry_after) if retry_after and retry_after.isdigit() else backoff(attempt)
        log.warning("attempt %d/%d %s: HTTP %d, sleeping %.1fs", attempt, MAX_ATTEMPTS, url, resp.status_code, wait)
        if attempt == MAX_ATTEMPTS:
            resp.raise_for_status()
        time.sleep(wait)
    raise RuntimeError("unreachable")
requests.ProxyError é uma subclasse de ConnectionError, então um gateway que responde ao CONNECT com erro é repetido em um túnel novo, o que no modo por requisição significa uma saída nova. Um 404 é devolvido como está: a página se foi, e outro endereço não vai trazê-la de volta.
A mesma política como decorador do tenacity é mais curta, ao custo de transformar Retry-After em uma exceção, de modo que vale o cronograma do tenacity em vez do cabeçalho:
from tenacity import retry, retry_if_exception_type, stop_after_attempt, wait_exponential_jitter


class RetryableStatus(Exception):
    """Lançada para 429 e 5xx para que o tenacity os repita como um erro de rede."""


@retry(
    stop=stop_after_attempt(4),
    wait=wait_exponential_jitter(initial=1, max=20),
    retry=retry_if_exception_type((requests.ConnectionError, requests.Timeout, RetryableStatus)),
    reraise=True,
)
def fetch_with_tenacity(url: str) -> requests.Response:
    resp = requests.get(url, proxies=PROXIES, headers=HEADERS, timeout=TIMEOUT)
    if resp.status_code in RETRY_STATUS:
        raise RetryableStatus(f"HTTP {resp.status_code} for {url}")
    return resp
Contra https://httpbin.org/status/503 ele repetiu após 1,5, 2,8 e 4,8 segundos e então lançou RetryableStatus.
Um scraper completo: pool de threads, repetições e log
ThreadPoolExecutor executa quatro chamadas a fetch ao mesmo tempo, as_completed devolve os resultados conforme terminam, e uma página que falha é registrada sem interromper a execução. Salve como scrape.py:
"""scrape.py - busca uma lista de páginas através de um gateway de proxy rotativo."""
import logging
import os
import random
import sys
import time
from concurrent.futures import ThreadPoolExecutor, as_completed

import requests

GATEWAY = os.environ.get("PROXY_URL", "http://user:pass@pr.proxynet.io:8000")
PROXIES = {"http": GATEWAY, "https": GATEWAY}
HEADERS = {"User-Agent": "price-monitor/1.0 (+mailto:you@example.com)"}

MAX_WORKERS = 4          # requisições em andamento ao mesmo tempo
MAX_ATTEMPTS = 4
RETRY_STATUS = {429, 500, 502, 503, 504}
TIMEOUT = (5, 30)

log = logging.getLogger("scraper")


def backoff(attempt: int) -> float:
    return min(2 ** (attempt - 1), 30) + random.uniform(0, 1)


def fetch(url: str) -> requests.Response:
    # o laço de repetição da seção anterior, sem alterações
    ...


def scrape(url: str) -> dict:
    started = time.monotonic()
    resp = fetch(url)
    return {
        "url": url,
        "status": resp.status_code,
        "bytes": len(resp.content),
        "seconds": round(time.monotonic() - started, 2),
    }


def main(urls: list[str]) -> None:
    logging.basicConfig(level=logging.INFO, format="%(asctime)s %(levelname)s %(message)s")
    results, failed = [], []
    with ThreadPoolExecutor(max_workers=MAX_WORKERS) as pool:
        futures = {pool.submit(scrape, url): url for url in urls}
        for future in as_completed(futures):
            url = futures[future]
            try:
                row = future.result()
                results.append(row)
                log.info("ok   %s -> %d in %.1fs", url, row["status"], row["seconds"])
            except Exception as exc:  # uma página ruim não pode parar a execução
                failed.append((url, repr(exc)))
                log.error("fail %s -> %s", url, exc)
    log.info("done: %d ok, %d failed", len(results), len(failed))
    for row in results:
        print(row)


if __name__ == "__main__":
    targets = sys.argv[1:] or [f"https://httpbin.org/ip?n={i}" for i in range(8)]
    main(targets)
Rodamos o script por um proxy de teste local que recusa um a cada três túneis com 429 para exercitar o caminho de repetição. Oito URLs, quatro workers, oito túneis, três falhas injetadas, zero páginas perdidas:
03:32:27 WARNING attempt 1/4 https://httpbin.org/ip?n=2: ProxyError
03:32:28 INFO ok   https://httpbin.org/ip?n=3 -> 200 in 1.1s
03:32:28 INFO ok   https://httpbin.org/ip?n=1 -> 200 in 1.1s
03:32:28 INFO ok   https://httpbin.org/ip?n=0 -> 200 in 1.1s
03:32:28 WARNING attempt 1/4 https://httpbin.org/ip?n=5: ProxyError
03:32:29 INFO ok   https://httpbin.org/ip?n=4 -> 200 in 0.9s
03:32:29 WARNING attempt 1/4 https://httpbin.org/ip?n=7: ProxyError
03:32:29 INFO ok   https://httpbin.org/ip?n=6 -> 200 in 0.9s
03:32:30 INFO ok   https://httpbin.org/ip?n=2 -> 200 in 2.6s
03:32:31 INFO ok   https://httpbin.org/ip?n=5 -> 200 in 2.4s
03:32:31 INFO ok   https://httpbin.org/ip?n=7 -> 200 in 2.0s
03:32:31 INFO done: 8 ok, 0 failed
O log faz parte do projeto: URL, número da tentativa, status ou classe da exceção e a espera em cada linha bastam para distinguir "o site está nos limitando" de "o gateway está derrubando túneis" sem rodar nada de novo. Quatro workers é pouco de propósito; a concorrência multiplica sua taxa de requisições, e a taxa é o que o alvo mede. Grave as linhas de results do jeito que Salvar dados de scraping em CSV, JSON e SQLite mostra; a etapa de parsing entre resp.text e uma linha está em Como extrair dados de um site.
O mesmo trabalho com httpx e asyncio
O httpx recebe o proxy no cliente, conforme a documentação de proxies do httpx. Um Semaphore substitui o pool de threads como teto de concorrência; o laço de repetição mantém a forma, só os sleeps viram await:
import asyncio
import random

import httpx

MAX_IN_FLIGHT = 4


async def fetch(client: httpx.AsyncClient, url: str) -> httpx.Response:
    for attempt in range(1, MAX_ATTEMPTS + 1):
        try:
            resp = await client.get(url)
        except (httpx.TransportError, httpx.ProxyError) as exc:
            log.warning("attempt %d/%d %s: %s", attempt, MAX_ATTEMPTS, url, exc.__class__.__name__)
            if attempt == MAX_ATTEMPTS:
                raise
            await asyncio.sleep(2 ** (attempt - 1) + random.uniform(0, 1))
            continue
        if resp.status_code not in RETRY_STATUS:
            return resp
        retry_after = resp.headers.get("Retry-After")
        wait = float(retry_after) if retry_after and retry_after.isdigit() else 2 ** (attempt - 1) + random.uniform(0, 1)
        log.warning("attempt %d/%d %s: HTTP %d, sleeping %.1fs", attempt, MAX_ATTEMPTS, url, resp.status_code, wait)
        if attempt == MAX_ATTEMPTS:
            resp.raise_for_status()
        await asyncio.sleep(wait)
    raise RuntimeError("unreachable")


async def main(urls: list[str]) -> None:
    gate = asyncio.Semaphore(MAX_IN_FLIGHT)
    async with httpx.AsyncClient(proxy=GATEWAY, headers=HEADERS, timeout=httpx.Timeout(30, connect=5)) as client:

        async def one(url: str):
            async with gate:
                resp = await fetch(client, url)
                return {"url": url, "status": resp.status_code}

        rows = await asyncio.gather(*(one(u) for u in urls), return_exceptions=True)
    for url, row in zip(urls, rows):
        print("FAIL" if isinstance(row, Exception) else "ok  ", url, row)


asyncio.run(main([f"https://httpbin.org/ip?n={i}" for i in range(8)]))
Um cliente significa um pool de conexões, e conexões do pool reutilizam túneis: com quatro requisições em andamento e oito URLs, nossa execução abriu quatro túneis, então pares de páginas compartilharam uma saída. Se cada página precisa sair pelo próprio endereço, envie headers={"Connection": "close"}; se um grupo de páginas precisa compartilhar uma, isso é uma sessão fixa, não um acaso do pool. Qual biblioteca serve para qual trabalho está em HTTPX vs. Requests vs. AIOHTTP.
Escolhendo entre por requisição e sessão fixa, e verificando o IP de saída
Decida por trabalho. Páginas de produto, listagens de busca e perfis públicos são independentes: rotação por requisição, sem objeto de sessão. Um login seguido de vinte páginas paginadas é uma única conversa: uma Session para os cookies, um ID de sessão para a saída, um worker. Um pote de cookies que permanece enquanto o IP muda é o jeito mais comum de ser deslogado no meio da execução; o lado do login está construído em Sessões e cookies em Python.
Antes de confiar em qualquer um dos modos, pergunte a um serviço de eco qual endereço ele vê: três chamadas sem sessão devem devolver três endereços diferentes, três com o mesmo ID de sessão devem devolver o mesmo:
import uuid
import requests

HOST = "pr.proxynet.io:8000"
USER, PASSWORD = "user", "pass"
ECHO = "https://httpbin.org/ip"


def proxies_for(username: str) -> dict:
    url = f"http://{username}:{PASSWORD}@{HOST}"
    return {"http": url, "https": url}


print("per request:")
for _ in range(3):  # sem Session, então cada chamada abre um túnel novo
    print("  ", requests.get(ECHO, proxies=proxies_for(USER), timeout=20).json()["origin"])

sid = uuid.uuid4().hex[:8]
sticky = proxies_for(f"{USER}-session-{sid}-ttl-600")  # mesma saída por até 600 s
print(f"sticky {sid}:")
with requests.Session() as s:
    for _ in range(3):
        print("  ", s.get(ECHO, proxies=sticky, timeout=20).json()["origin"])
Rode isso no início de um trabalho e registre o resultado. Se "per request" imprimir o mesmo endereço três vezes, olhe primeiro a reutilização de conexão; se "sticky" imprimir três diferentes, o ID de sessão não está chegando ao gateway, geralmente porque uma etapa de codificação de URL estragou o nome de usuário.
Limites de taxa, robots.txt e os limites que você mantém
Um proxy rotativo muda qual endereço o site vê, não o que o site permite:
- Leia o robots.txt primeiro.
urllib.robotparserrespondecan_fetch(user_agent, url)em três linhas; um caminho não permitido fica fora da lista de URLs. O que o arquivo consegue expressar está em O que é robots.txt. - Leve
Retry-Afterao pé da letra. O laço de repetição dorme o número do site mesmo quando a rotação deixaria você continuar por outra saída. - Limite a taxa, não só os workers. Quatro workers sem atraso ainda podem enviar 40 requisições por segundo a um site rápido; adicione um
time.sleeppequeno por worker se o site publica um limite. - Prefira a API oficial quando existir; ela é mais barata para os dois lados do que parsear HTML através de um proxy.
- Nada de serviços para resolver CAPTCHA nem plugins para evitar detecção. Um CAPTCHA significa que o site quer uma pessoa; a resposta é uma taxa menor, a API ou pedir acesso.
Onde essa configuração é usada
- Monitoramento de preços. Milhares de páginas de produto independentes por dia, rotação por requisição, de quatro a oito workers; o dimensionamento do pool está na página de extração de dados.
- Painéis próprios com login. Uma sessão fixa por conta, um worker, cookies persistidos entre execuções como em Sessões e cookies em Python.
- Substituir uma lista de proxies feita à mão. Rotacionar uma lista no código, como em Como rotacionar proxies em Python, é a abordagem antiga; o gateway elimina a lista e a contabilidade de endereços mortos.
Erros comuns
- Reutilizar uma
Sessione esperar um IP novo por página. Um túnel, uma saída. Tire a sessão ou envieConnection: close. - Um ID fixo sem
Session. A saída fica presa, mas cada chamada paga um handshake novo e os cookies se perdem. Use os dois juntos. - Repetir um
404. A página se foi; outra saída não vai encontrá-la. Repita só429,5xxe erros de rede. - Sem timeout. Uma saída travada bloqueia um worker até o processo ser morto. Passe sempre
timeout=(5, 30). - Credenciais no script. Elas acabam no histórico do git. Leia-as do ambiente.
Guia de decisão
| Necessidade | Recomendação |
|---|---|
| Muitas páginas independentes, sem login | Rotação por requisição, requests.get sem sessão, 4 workers para começar |
| Login e depois muitas páginas | Sessão fixa (-session-<id>-ttl-<seconds>) mais uma requests.Session, um worker por conta |
| Milhares de requisições pequenas, limitadas por E/S | AsyncClient do httpx com um Semaphore; Connection: close se cada uma precisar da própria saída |
| O site publica um limite de taxa | Primeiro ajuste workers e atrasos abaixo desse limite, depois a rotação |
| Preços por país | -country-xx no nome de usuário, rotação por requisição dentro desse país |
| O endereço nunca pode mudar (lista de permissão de API) | Não é um produto rotativo; use um IP estático |
Perguntas frequentes
Por que o IP não muda a cada requisição?
Porque seu cliente reutiliza a conexão. A Session do requests e o Client do httpx mantêm a conexão TCP, e portanto o túnel do proxy, aberta entre as requisições; a saída é escolhida quando o túnel é aberto. Use chamadas requests.get avulsas ou um cabeçalho Connection: close para ter uma saída nova por requisição.
Como uso uma sessão fixa em Python?
Acrescente -session-<id>-ttl-<seconds> ao nome de usuário na URL do proxy, mantenha o mesmo ID durante toda a conversa e faça as chamadas por uma única requests.Session para que cookies e túnel sejam reutilizados. O TTL pode ir de 1 a 60 minutos; escolha um valor maior que a duração do trabalho.
Devo usar requests ou httpx para scraping com proxies?
Para algumas centenas de páginas por noite, requests com um pool de threads basta e é mais fácil de depurar. Para dezenas de milhares de requisições pequenas, o cliente assíncrono do httpx com um Semaphore consome menos recursos. Os dois aceitam a mesma URL de gateway e a mesma lógica de repetição.
Quantos workers concorrentes são seguros?
Comece com quatro e observe as respostas. O que importa são as requisições por minuto como o alvo as vê, então a resposta depende do limite do site, não do tamanho do pool. Se 429 aparecerem com quatro, reduza o número ou adicione um atraso.
Um proxy rotativo contorna um 429?
Ele espalha as requisições por mais endereços para que cada um fique abaixo do limite; ele não remove o limite. Se o site definiu um limite, respeite Retry-After, reduza a taxa ou use a API. Rotacionar mais rápido para passar por cima de um 429 é como os endereços acabam em listas de bloqueio.
Como verifico que o proxy está funcionando?
Requisite um endpoint de eco de IP como https://httpbin.org/ip através do proxy e compare a resposta com o seu próprio endereço: três vezes sem sessão para ver a rotação, três vezes com um ID de sessão para ver a fixação.
Em resumo
Um proxy rotativo em Python é uma URL de gateway em um dicionário proxies, um laço de repetição que respeita Retry-After, um teto de poucos workers e uma regra clara sobre quando uma página pode compartilhar uma saída com a anterior. Mantenha o objeto de sessão e o ID de sessão juntos para o trabalho com login, mantenha os dois longe das páginas independentes e confira o IP de saída antes da primeira execução real. O pool atrás do gateway está na página de proxy.