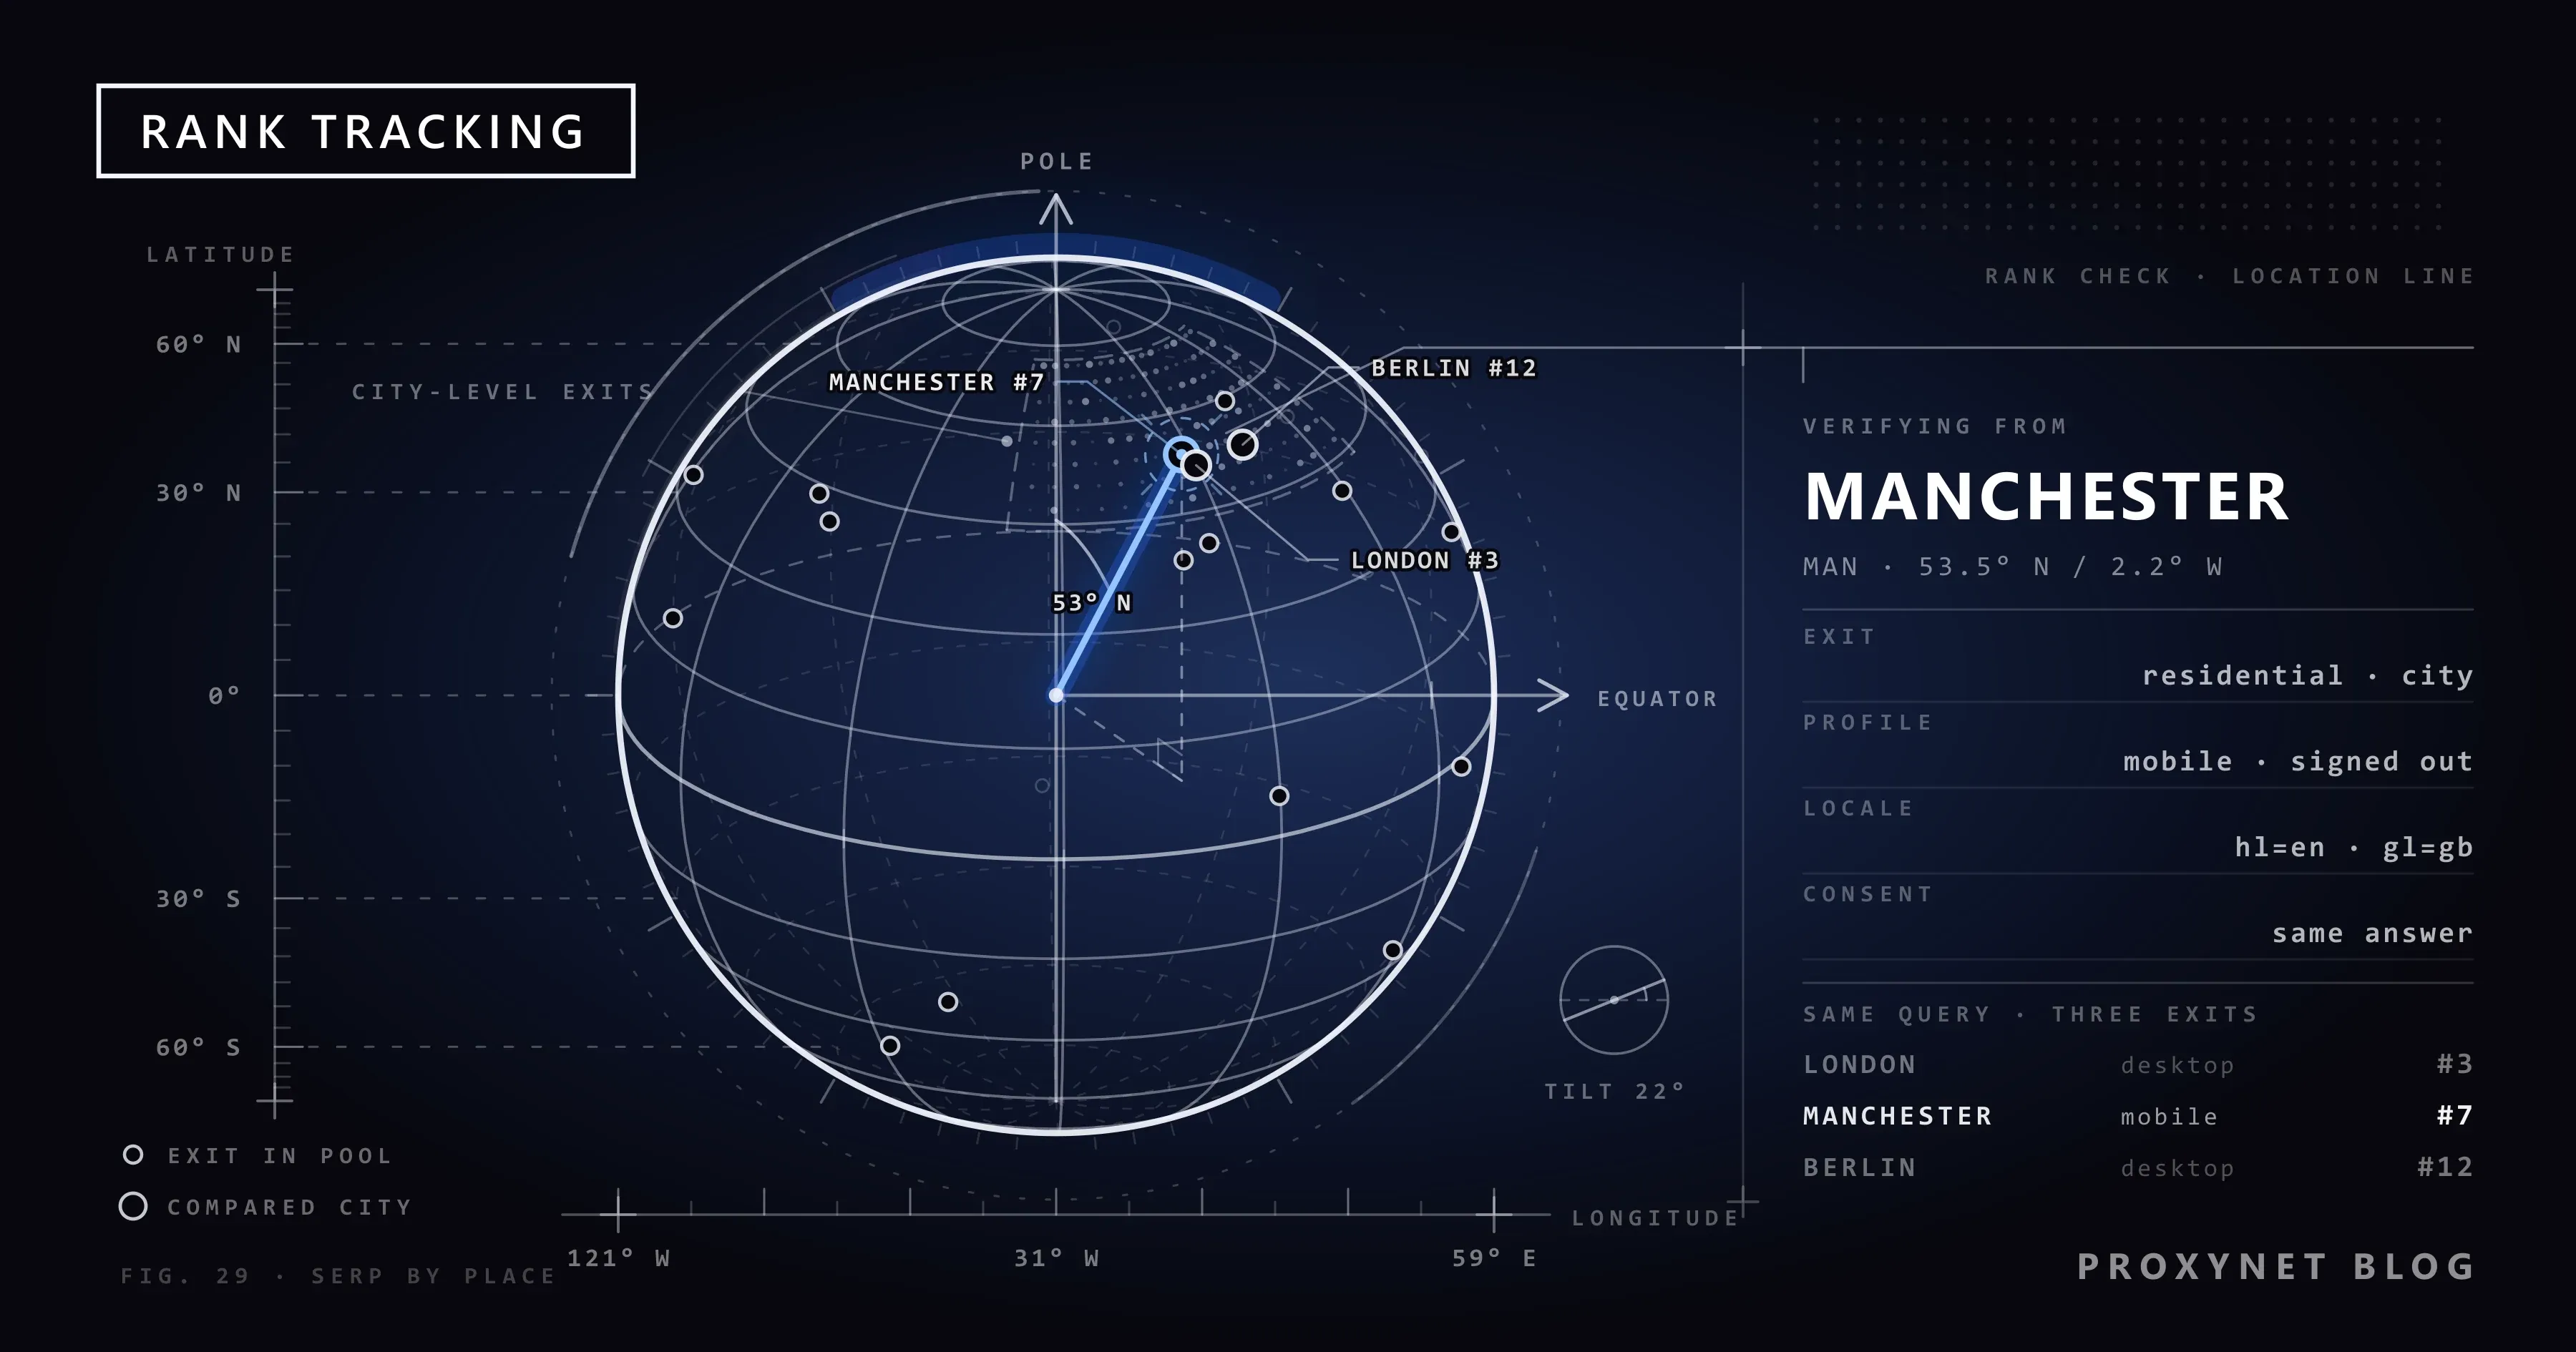
Uma agência envia ao cliente o relatório mensal: "aluguel de carros Manchester", posição 3. O cliente abre o notebook no escritório de Manchester, pesquisa as mesmas palavras e encontra o site na posição 7, abaixo de uma caixa de mapa e dois anúncios. O gerente de contas pesquisou de Londres, no desktop; o cliente pesquisou de Manchester, no celular. As duas páginas são reais; o relatório só nunca disse qual delas estava descrevendo.
Este artigo é para quem precisa tornar esse relatório defensável. Ele explica por que uma mesma consulta devolve posições diferentes por país, cidade, idioma, dispositivo e personalização, o que uma verificação exata exige, onde um proxy entra em uma pilha de rank tracking ao lado da API do Search Console e de um serviço de acompanhamento, qual tipo de proxy serve para cada verificação, como dosar as verificações e um fluxo de trabalho da lista de palavras-chave até a comparação. O caminho oficial vem primeiro; nada aqui ensina a fazer scraping do Google.
Por que a mesma consulta devolve posições diferentes?
O Google não mantém uma lista ordenada por palavra-chave. Ele gera uma página para cada solicitação, e várias entradas dessa página variam de um pesquisador para outro.
- País. Quais páginas são elegíveis, quais versões de idioma são preferidas e quais empresas locais aparecem depende do país que o Google atribui à pesquisa.
- Cidade e bairro. Em consultas com intenção local, o pacote local (local pack) e, muitas vezes, os resultados orgânicos são ordenados pela distância até a posição estimada do pesquisador. "Dentista" recebe uma página diferente em cada cidade, e em uma cidade grande a página muda de bairro para bairro.
- Idioma. O idioma da interface e o cabeçalho
Accept-Languagedo navegador decidem quais páginas vêm primeiro. Uma pessoa que pesquisa em turco e outra que pesquisa em alemão na mesma rua de Berlim não veem os mesmos dez primeiros resultados. - Dispositivo. No celular, o pacote local e o bloco "As pessoas também perguntam" ficam mais acima e empurram os resultados orgânicos para baixo, e a versão ranqueada é a versão mobile da página.
- Personalização. Uma conta logada traz o histórico de pesquisa e, no celular, a localização precisa do dispositivo para dentro da página. Se você visita o site do seu cliente todo dia, o Google pode mostrá-lo mais acima para você do que para um desconhecido.
Cada fator está explicado em por que os resultados do Google variam entre pessoas. Para o rank tracking, o ponto é que "posição 3" não é uma propriedade de uma palavra-chave; é uma propriedade de uma palavra-chave mais uma localização, um idioma, um dispositivo e um momento.
Como o Google decide de onde vem uma pesquisa?
A página de ajuda do Google sobre como ele usa sua localização na Pesquisa cita quatro fontes: a localização do próprio dispositivo, os endereços de casa e trabalho da Conta do Google, a atividade anterior e o endereço IP da conexão. Essas quatro são as alavancas que uma verificação precisa controlar, e a ordem delas importa:
- A localização do dispositivo vence quando está disponível. Um celular que concedeu permissão de localização diz ao Google onde está com precisão de metros, e uma verificação nesse celular relata a posição dele, não a do proxy.
- Depois vêm os dados da conta. Endereços salvos e atividade recente alimentam a estimativa quando há login. Um perfil deslogado remove essa camada.
- O endereço IP é o recurso de reserva. Sem localização do dispositivo e sem conta, o Google lê o endereço IP da conexão. É aqui que um proxy trabalha: ele encaminha sua solicitação, então o Google vê o endereço do proxy em vez do seu, e quando esse endereço pertence a uma conexão doméstica ou móvel em Manchester, a estimativa vira Manchester. A geolocalização por IP costuma acertar no nível de país e muitas vezes no de cidade, mas pode errar por um bairro ou mais; veja qual é a precisão da geolocalização por IP.
- A página diz o que decidiu. No rodapé de toda página de resultados aparece a localização que o Google usou e a origem dela, como "Com base no seu endereço de internet". Uma verificação que não registra essa linha não provou de onde foi feita.
Como as fontes têm prioridade, trocar o IP de saída não faz nada enquanto o navegador ainda compartilha a localização do dispositivo ou ainda está logado.
O que uma verificação de posição exata exige?
Uma verificação defensável controla todas as entradas acima. É um perfil fixo que você configura uma vez e reutiliza.
| Entrada | O que definir | Por que importa |
|---|---|---|
| Endereço IP de saída | Um IP residencial ou móvel na cidade-alvo | O recurso de reserva do Google para localização; a única alavanca que um proxy controla |
Parâmetro de país gl | O código de duas letras do país-alvo | Declara o mercado em vez de deixar isso para o IP |
Parâmetro de idioma hl | O idioma do público-alvo | Decide quais páginas ranqueiam primeiro |
| Dispositivo | Um navegador mobile ou desktop compatível com o público | Layout diferente, posições diferentes dos elementos |
| Estado de login | Deslogado, perfil novo | Remove o histórico da conta e os endereços salvos |
| Localização do dispositivo | Negada ou indisponível | Caso contrário, ela se sobrepõe ao endereço IP |
| Consentimento de cookies | A mesma resposta ao aviso toda vez | A escolha decide quais cookies a sessão carrega |
| Linha de localização | Lida e guardada com o resultado | Prova de onde a verificação foi feita |
gl e hl restringem o que você pede, não onde o Google acha que você está, então complementam o IP de saída em vez de substituí-lo. O lado manual dessa lista está em como verificar sua posição no Google com precisão; as opções em nível de país que dispensam proxy são comparadas em como pesquisar no Google a partir de outro país.
O consentimento de cookies é a entrada que as agências mais esquecem: onde o Google mostra um aviso de consentimento a visitantes deslogados, um perfil novo o encontra em toda visita, então decida uma vez, escolha a opção que guarda menos dados e dê a mesma resposta em toda verificação.
Onde os proxies entram em uma pilha de rank tracking?
Uma pilha de rank tracking tem três camadas, e os proxies pertencem a duas delas.
Camada 1: a API do Search Console, fonte principal para o seu próprio site. O método de consulta do Search Analytics devolve cliques, impressões, CTR e posição média por query, page, country (um código de três letras ISO 3166-1 alpha-3), device (DESKTOP, MOBILE, TABLET) e date, até 25.000 linhas por solicitação. É o registro do próprio Google das páginas que usuários reais viram, então não precisa de proxy nem de navegador. Os limites dele são o motivo de as outras camadas existirem: médias em vez de uma página, nível de país em vez de cidade, nada sobre concorrentes. A extração diária está em como automatizar o acompanhamento de posições no SEO.
Camada 2: um serviço de rank tracking para concorrentes, cidades e capturas diárias. Essas plataformas operam a própria infraestrutura de localização: defina uma palavra-chave como "Manchester, mobile" e o serviço verifica a partir de uma saída em Manchester com um perfil mobile. O proxy já está dentro do produto; o seu trabalho é configurar localizações e dispositivos corretamente e perguntar ao fornecedor como ele obtém os dados e se o contrato cobre o seu uso.
Camada 3: suas próprias verificações a partir de uma cidade onde você não está. O serviço diz posição 3 em Manchester; o cliente diz 7. Alguém precisa olhar a página real: um navegador limpo e deslogado, hl e gl definidos, roteado por um IP residencial ou móvel em Manchester, uma pesquisa, a linha de localização lida e a página salva. É para isso que os proxies servem em uma agência: verificação em escala humana, capturas de tela para o cliente, um olhar no pacote local e nos anúncios acima da dobra. As configurações estão nas nossas páginas de proxy para SEO e proxy para Google.
O que não pertence a lugar nenhum da pilha é um script seu que envie consultas ao Google. As políticas de spam do Google definem "tráfego gerado por máquina" como o envio de consultas automatizadas ao Google sem permissão expressa, incluindo o scraping de resultados para verificar posições, e afirmam que isso viola tanto as políticas de spam quanto os Termos de Serviço. Um pool de proxies muda quais endereços estão envolvidos, não a política. Se você precisa de volume, compre de um serviço licenciado; se precisa de prova, olhe com os próprios olhos.
Qual tipo de proxy serve para verificar a SERP?
| Tipo de proxy | De onde vem o IP | Adequação para verificações de SERP |
|---|---|---|
| Residencial | Banda larga doméstica, escolhida por país e cidade | Verificações em desktop, pacote local, páginas de cidade |
| Móvel | Redes de operadoras, escolhidas por país e cidade | Verificações mobile onde o público está no celular |
| Residencial rotativo | Um IP residencial novo por solicitação ou sessão | Verificações separadas espalhadas por dias, uma sessão cada |
| Residencial sticky | O mesmo IP residencial por 1 a 60 minutos | Uma sessão de verificação com várias capturas de tela |
| ISP estático | Um IP fixo registrado em nome de um ISP e hospedado em datacenter | Login em ferramentas de SEO com lista de IPs permitidos |
| Datacenter | Faixas de nuvem e hospedagem | Fraco: telas de verificação, sem cidade de pesquisador; melhor para rastrear o seu próprio site |
A divisão da tabela se resume a onde o endereço mora. Endereços de datacenter pertencem a faixas de hospedagem, que são de conhecimento público e não estão ligadas a nenhuma cidade no sentido que importa para resultados locais; uma saída de datacenter costuma encontrar a tela de "tráfego incomum" antes de ver um resultado, e quando vê, a linha de localização aponta para a cidade do datacenter (veja por que o Google mostra o erro de tráfego incomum). Os endereços de um Proxies residenciais vêm de conexões domésticas e carregam uma cidade, que é o que uma verificação local precisa. Para um público majoritariamente mobile, uma saída de Proxies móveis na rede de uma operadora, combinada com um perfil de navegador mobile, reproduz o que a maioria dos clientes do seu cliente vê; a saída é escolhida por país e cidade, não por operadora. Escolha o dispositivo de onde, segundo os dados do Search Console do cliente, vem o tráfego, e depois o proxy que combina com ele. As diferenças mais amplas estão em diferença entre proxy residencial e datacenter, e a nossa comparação de cinco fornecedores para trabalho de SEO está em os melhores proxies para ferramentas de SEO.
Como dosar e cachear as verificações para ser respeitoso?
Mesmo uma verificação legítima entra em uma zona cinzenta assim que passa a parecer um script. Quatro hábitos a mantêm do lado humano da linha.
- Dose como uma pessoa. Uma consulta por vez, uma pausa entre consultas, uma sessão por cidade. Quinze palavras-chave em três cidades são quarenta e cinco pesquisas em uma manhã, não quatro mil. Se a lista passa do que uma pessoa pesquisaria à mão, ela pertence ao serviço de rank tracking.
- Cacheie o que você captura. Guarde a página, a linha de localização, o carimbo de data e hora e as configurações do perfil com cada verificação, e responda à pergunta de um colega com a captura guardada, não com uma pesquisa nova.
- Uma sessão sticky por verificação. Uma sessão de Proxies de sessão fixa mantém o mesmo IP pelos minutos que uma verificação leva, então a localização não pula entre capturas. Um Proxies rotativos é para os intervalos entre sessões e cidades, não para o meio de uma verificação.
- Respeite a tela de verificação. Se o Google mostrar uma, a verificação acabou. Resolvê-la com um serviço ou tentar de novo por outro endereço é o comportamento que a política de spam descreve.
Um fluxo de trabalho de rank tracking
- Palavras-chave. Liste as consultas que importam, cada uma com página-alvo, prioridade, idioma e o dispositivo do público. Parta do relatório de consultas do Search Console.
- Localizações. Atribua a cada palavra-chave um país e, nas consultas com intenção local, uma cidade. Clientes com várias filiais recebem uma linha por cidade de filial.
- Cronograma. O Search Console é extraído diariamente; o serviço roda no próprio ritmo; a verificação acontece em eventos como um lançamento, uma atualização do algoritmo ou uma reunião com o cliente, mais uma amostra mensal das palavras-chave críticas.
- Captura. Registre a consulta, os valores de
hlegl, o perfil de dispositivo, a escolha de cookies, a cidade de saída, a linha de localização, o carimbo de data e hora e uma captura de tela. Uma captura sem linha de localização é descartada. - Armazenamento. Uma única tabela, com carimbo de data e hora, nunca sobrescrita, marcada com a origem, porque linhas do Search Console, capturas do serviço e capturas manuais medem coisas diferentes.
- Comparação. Igual com igual: a captura mobile de Manchester deste mês contra a do mês passado; quatro semanas de Search Console contra as quatro anteriores. Relate as condições junto com o número, para que "posição 3" sempre se leia "posição 3, Manchester, mobile, inglês, 14 de outubro".
Casos de uso
- Clientes com várias cidades: uma verificação por cidade de filial, com o pacote local e a página da cidade capturados. Os resultados de mapas seguem regras próprias, explicadas em como ver os resultados do Google Maps de outra cidade.
- Expansão para outro país: verificar que a nova versão de idioma ranqueia no novo mercado antes de a campanha começar; os pontos de saída estão nas nossas páginas de localizações.
- Disputas com clientes: reproduzir o que o cliente viu, da cidade e do dispositivo dele, e explicar a diferença com a linha de localização e o layout dos anúncios em mãos; o lado dos anúncios está na nossa página de verificação de anúncios.
Erros comuns
- Verificar pelo IP do escritório. Todo resultado carrega a cidade do escritório, e todo cliente em outro lugar recebe um relatório sobre a página errada.
- Ignorar o pacote local. Contar só os dez links azuis esconde uma caixa de mapa que, no celular, empurra o resultado do cliente para baixo da dobra.
- Misturar dispositivos. Comparar uma verificação em desktop com a verificação mobile do mês passado produz uma "queda" que nunca aconteceu.
- Pular a linha de localização. Sem ela não há prova de onde a verificação foi feita, e a geolocalização por IP erra, sim.
- Rodar um script seu contra o Google. Viola as políticas de spam e não se torna aceitável por causa de um pool de proxies.
Guia de decisão
| Sua necessidade | Recomendação |
|---|---|
| A posição do seu próprio site por consulta, país e dispositivo | API do Search Console, extração diária para um banco de dados |
| Posições de concorrentes e capturas diárias em várias cidades | Um serviço de rank tracking, com localizações e dispositivos por palavra-chave |
| Prova do que um usuário local vê em uma cidade | Uma verificação manual por um IP residencial de lá, deslogado, com a linha de localização registrada |
| Público mobile em uma cidade específica | Uma saída de proxy móvel mais um perfil de navegador mobile |
| Login em um painel com lista de IPs permitidos | Um proxy ISP estático com endereço fixo |
| Milhares de consultas enviadas ao Google por um script seu | Não é uma opção; use um serviço licenciado |
Perguntas frequentes
Por que meu rank tracker mostra uma posição diferente da do meu navegador?
Porque os dois olharam páginas diferentes: o tracker rodou a partir da localização e do dispositivo que você configurou, e o seu navegador a partir da sua cidade, talvez logado, em outro dispositivo. Compare primeiro as linhas de localização e os perfis de dispositivo.
Ainda preciso de proxy se pago uma ferramenta de rank tracking?
Não para as verificações da própria ferramenta. Você precisa para a verificação manual: reproduzir uma página à mão a partir de uma cidade onde não tem escritório, capturar telas para um cliente ou conferir o pacote local e os anúncios que um número de posição não mostra.
Proxy residencial ou móvel para rank tracking?
O que combina com o dispositivo do público. Se os dados do Search Console do cliente mostram a maior parte do tráfego no mobile, verifique em um perfil de navegador mobile por uma saída móvel; a verificação em desktop usa uma saída residencial na cidade-alvo.
Um proxy de datacenter consegue verificar posições no Google?
Serve mal. As faixas de hospedagem não estão ligadas a uma cidade como as conexões domésticas, e muitas vezes encontram uma tela de verificação antes de mostrar resultados. Use-as para rastrear o seu próprio site e para chamadas de API.
Verificar posições por um proxy vai contra as regras do Google?
Uma pessoa pesquisando à mão de outra localização está navegando normalmente. O que as políticas de spam proíbem é o tráfego gerado por máquina: consultas automatizadas ao Google, incluindo scraping para verificar posições, qualquer que seja o endereço IP que a automação use.
Com que frequência as verificações de posição devem rodar?
Extraia o Search Console diariamente e avalie em janelas de quatro semanas; deixe o serviço rodar no cronograma dele; faça verificação manual em eventos como um lançamento ou uma atualização, mais uma amostra mensal das palavras-chave críticas.
Em resumo
Uma posição é uma página montada para um pesquisador específico, então uma verificação só é tão exata quanto o lugar, o idioma, o dispositivo, o estado de login e o consentimento de cookies sob os quais foi feita. Tire os números do seu próprio site da API do Search Console, as capturas de concorrentes e cidades de um serviço de rank tracking que verifica a partir das localizações certas, e use um proxy para o que nenhum dos dois dá: uma página capturada à mão da cidade-alvo, com a linha de localização como prova. Saídas residenciais e móveis servem para esse trabalho; faixas de datacenter, não. Dose as verificações como uma pessoa, cacheie o que captura e nunca envie consultas por script ao Google. Para saídas em nível de cidade, veja a nossa solução de proxy para SEO.