A sua verificação de preços funciona no seu notebook. Você a leva para um servidor, passa o tráfego por um proxy e, depois de meio minuto, o log mostra TimeoutError: page.goto: Timeout 30000ms exceeded. Na execução seguinte a página abre, e o script para uma linha depois com locator.click: Timeout 30000ms exceeded. Você muda o número para 60000, e agora o script falha depois de um minuto inteiro, porque o número nunca foi o problema.
Este guia cobre os quatro tipos de timeout, o call log, o waitUntil, onde definir os limites, proxies lentos e páginas de bloqueio que acabam virando "elemento não encontrado"; depois vêm um script de novas tentativas testado em Python e Node.js e o equivalente no Puppeteer. Todas as mensagens abaixo saíram das nossas execuções com Playwright 1.63 e Puppeteer 25.12 contra um site de teste local e um proxy de teste.
O que significa "Timeout 30000ms exceeded" no Playwright?
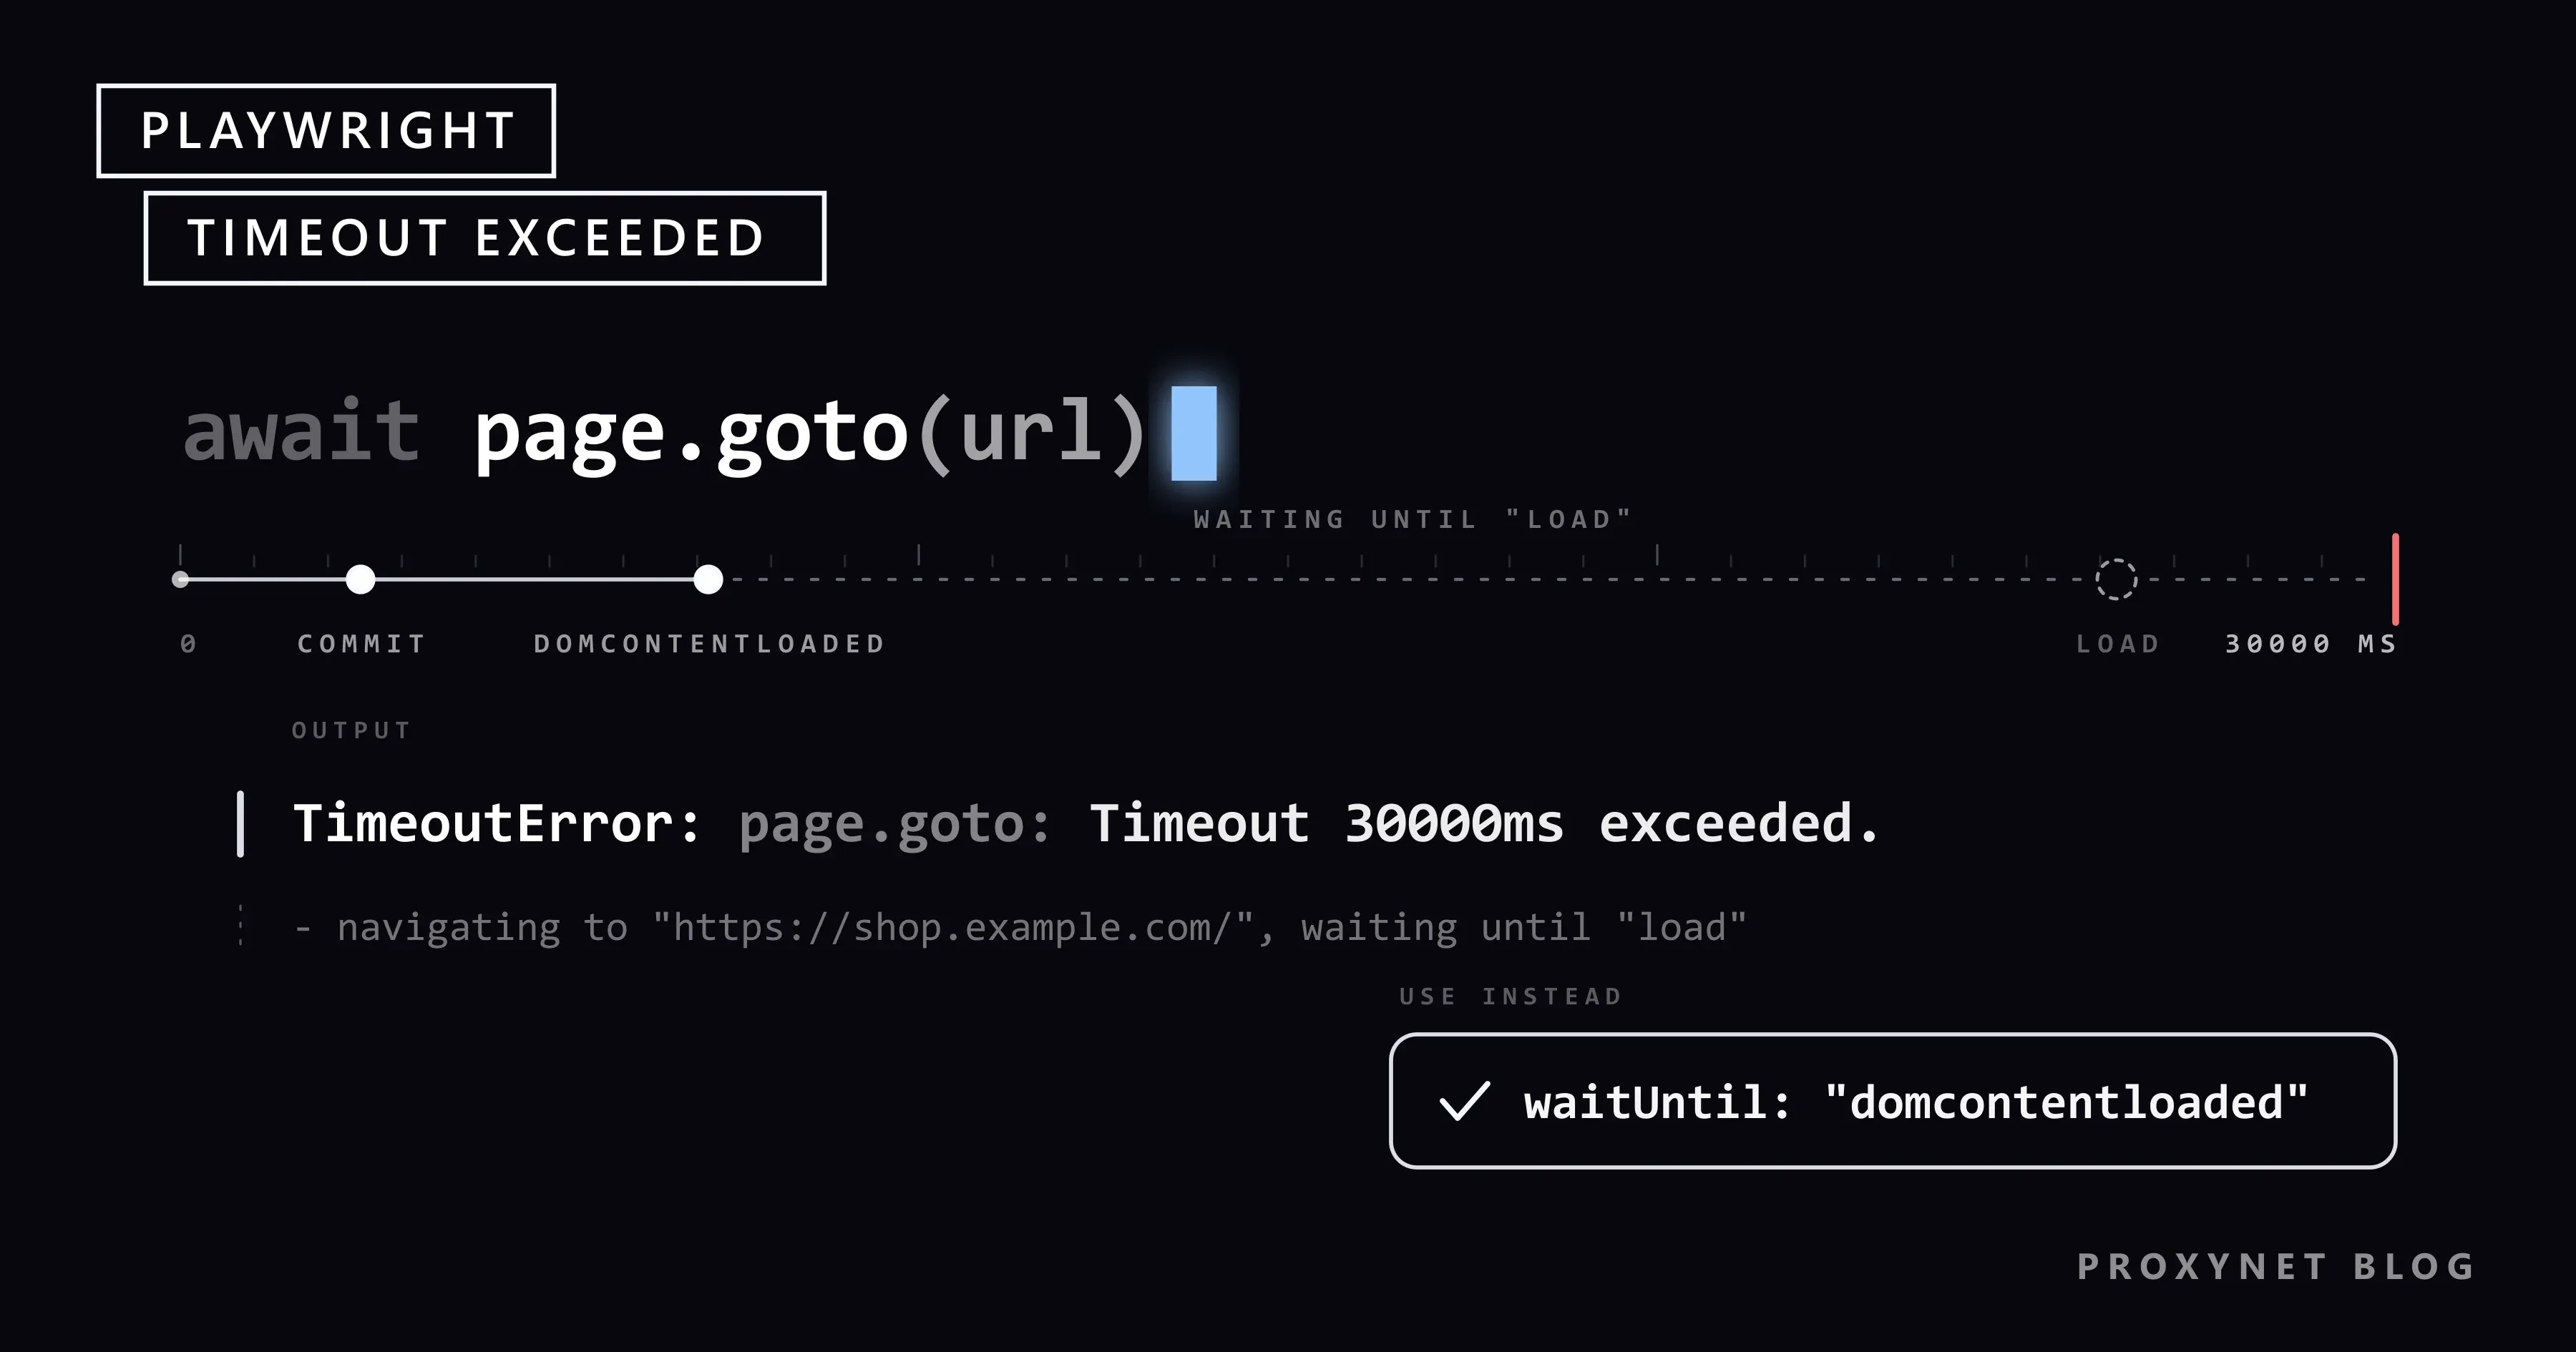
O Playwright espera sozinho: page.goto() até a página atingir um estado de carregamento, e cada ação de locator até o elemento existir e poder receber a ação. Quando uma espera chega ao limite, o Playwright lança um TimeoutError. Na biblioteca, esse limite é de 30.000 ms, ou seja, 30 segundos; as nossas execuções em Python e em Node.js pararam exatamente em 30,0 segundos.
A mensagem traz o método que esperou, o limite e, em um call log, o que o Playwright estava fazendo. Esta veio de uma página de teste cujo servidor nunca respondeu:
TimeoutError: page.goto: Timeout 30000ms exceeded.
Call log:
  - navigating to "http://127.0.0.1:8090/slow", waiting until "load"
O Python escreve Page.goto e Locator.click com inicial maiúscula; o Node.js, page.goto e locator.click. Em Python, importe a classe com outro nome, porque o TimeoutError de playwright.sync_api esconderia o TimeoutError nativo do Python. No Node.js, é errors.TimeoutError do pacote playwright.
Qual timeout se esgotou? Os quatro tipos
A biblioteca, que é o que os scrapers usam, dá 30 segundos a cada navegação e a cada ação. O executor de testes Playwright Test não lhes dá um limite próprio e, em vez disso, dá 30 segundos ao teste inteiro, como lista a documentação de timeouts do Playwright; é por isso que a referência da API JavaScript indica 0 como padrão do goto.
| A mensagem começa com | Tipo | Padrão | Como mudar |
|---|---|---|---|
page.goto: Timeout … | Navegação | 30 s (biblioteca), nenhum (Test) | timeout na chamada, set_default_navigation_timeout(), navigationTimeout |
locator.click: Timeout … | Ação ou locator | 30 s (biblioteca), nenhum (Test) | timeout na chamada, set_default_timeout(), actionTimeout |
expect(locator)… failed com Timeout: 5000ms | Asserção | 5 s | expect: { timeout }, em Python expect.set_options(timeout=…) |
Test timeout of 30000ms exceeded. | Teste inteiro (Playwright Test) | 30 s | timeout na configuração, test.setTimeout(), test.slow() |
Dois detalhes das nossas execuções. Em Python, um expect() que falha lança um AssertionError comum, que except PlaywrightTimeoutError não captura. E, quando o timeout do teste estoura durante o page.goto, o Playwright Test acrescenta page.goto: net::ERR_ABORTED; maybe frame was detached? abaixo da linha do timeout. Não é um erro de rede: o executor fechou a página enquanto a chamada ainda esperava.
Como ler o call log?
O call log, o registro de chamadas que aparece abaixo da linha do erro, é a parte mais útil da mensagem. Aqui está um clique em um botão coberto por um aviso de cookies, resumido da nossa execução:
Locator.click: Timeout 5000ms exceeded.
Call log:
  - waiting for locator("#buy")
    - locator resolved to <button id="buy">Add to cart</button>
  - attempting click action
    2 × waiting for element to be visible, enabled and stable
      - element is visible, enabled and stable
      - scrolling into view if needed
      - done scrolling
      - <div id="cookie-banner">We use cookies</div> intercepts pointer events
    - retrying click action
Leia em quatro passos:
- O método na primeira linha diz qual foi a espera:
goto,click,fill,textContent. - O último passo do log mostra onde parou.
waiting for locator("#price")sem nada embaixo significa que nada correspondeu;locator resolved to …significa que o elemento foi encontrado, mas a ação não pôde ser executada. - A linha do motivo, se houver:
intercepts pointer events(algo está por cima),element is not visible,element is not enabled. - O tempo decorrido. Uma falha exatamente no seu limite é uma espera real. Um erro anterior, como
net::ERR_PROXY_CONNECTION_FAILED, é outro problema, tratado em O que é Playwright e como usá-lo com proxy.
Timeouts de navegação: page.goto e waitUntil
O page.goto() espera um evento do ciclo de vida, escolhido com waitUntil (wait_until em Python):
commit: a resposta chegou e o documento começou a carregar.domcontentloaded: o HTML foi analisado; imagens, fontes e iframes ainda podem estar carregando.load(o padrão): a página e os recursos que ela puxa, incluindo imagens e folhas de estilo, terminaram de carregar.networkidle: nenhuma conexão de rede por pelo menos 500 ms. A referência do page.goto o marca como desaconselhado (discouraged) e recomenda confiar nas asserções.
O load padrão causa muitos timeouts de navegação: uma imagem lenta, um pixel de rastreamento ou um widget impede o evento de disparar enquanto o texto que você quer já está na página. Na nossa página de teste, o preço estava no HTML e uma imagem nunca terminava de carregar. Com load, o goto estourou o timeout após 10 segundos; com domcontentloaded, retornou em 0,1 segundo com o preço legível. O networkidle falhou em uma página que chama um endpoint a cada 300 ms, como fazem widgets de chat e preços ao vivo.
O padrão que se sustenta: navegue com domcontentloaded e depois espere o elemento específico de que você precisa.
response = page.goto(url, wait_until="domcontentloaded")
price = page.locator("#price").inner_text() # espera o elemento, no máximo até o timeout de açãoconst response = await page.goto(url, { waitUntil: "domcontentloaded" });
const price = await page.locator("#price").innerText();Se o goto ainda estourar o timeout com domcontentloaded, o próprio HTML chegou tarde demais, e isso é uma questão de rede (veja a seção sobre proxies). Se os dados estão no HTML ou em um endpoint JSON, talvez você nem precise de um navegador; Páginas estáticas e dinâmicas no web scraping mostra como verificar.
Timeouts de locator e de ação: a espera automática e o que a bloqueia
Antes de um clique, o Playwright verifica se o elemento está visível, estável (sem se mover) e habilitado e se ele realmente recebe o clique naquele ponto, e repete as verificações até o limite acabar. Um timeout de locator se resume a uma lista curta de causas:
- O seletor não corresponde a nada. Um erro de digitação, um nome de classe que muda a cada build ou um texto que varia conforme o idioma. Atributos estáveis (
id,data-*) ouget_by_role()duram mais. - O elemento aparece tarde demais. Um preço renderizado 12 segundos depois do carregamento falha sempre com um limite de 10 segundos.
- Algo o cobre. Avisos de cookies e janelas modais aparecem como
intercepts pointer events. Feche a camada sobreposta como um visitante faria;force=Truepula a verificação, e o clique cai onde nenhum usuário conseguiria clicar. - Ele está dentro de um iframe.
page.locator("#price")não olha dentro de frames; no nosso teste, ele estourou o timeout, enquantopage.frame_locator("iframe").locator("#price")devolveu o preço na hora. - Você está em uma página diferente da que imagina. Uma página de bloqueio ou uma tela de login não tem
#price(veja abaixo).
O page.wait_for_selector() ainda funciona, mas a referência da API do Playwright o marca como desaconselhado e prefere os locators, que buscam o elemento de novo a cada tentativa e por isso sobrevivem a uma nova renderização. Como isso difere das esperas explícitas do Selenium está em Playwright ou Selenium: qual escolher no seu projeto?.
Definir timeouts de propósito: por chamada, por contexto, na configuração
Um timeout passado a uma chamada vale mais do que qualquer outro. Abaixo dele, os padrões da página valem mais do que os do contexto, e um padrão de navegação vale mais do que o geral. Em Python, defina os padrões no contexto para que todas as páginas dele os herdem:
context = browser.new_context()
context.set_default_navigation_timeout(15_000)  # goto, reload, wait_for_url
context.set_default_timeout(10_000)             # locators, cliques, esperas
page = context.new_page()
page.goto(slow_report_url, timeout=45_000)      # uma página sabidamente lenta ganha mais
No Playwright Test, os limites ficam na configuração. Com esta configuração, na nossa execução um elemento ausente falhou com locator.click: Timeout 10000ms exceeded. e uma página que nunca respondeu, com page.goto: Timeout 15000ms exceeded.:
import { defineConfig } from "@playwright/test";

export default defineConfig({
  timeout: 60_000,              // o teste inteiro, incluindo hooks e fixtures
  expect: { timeout: 10_000 },  // cada asserção expect(...)
  use: {
    actionTimeout: 10_000,      // click, fill, textContent ...
    navigationTimeout: 15_000,  // goto, reload, waitForURL ...
  },
});
test.slow() triplica o limite de um teste lento. Evite timeout=0 em produção: uma página que nunca responde passa a segurar um contexto para sempre. Limites de dois minutos em toda parte não são muito melhores; uma fila com cem URLs mortas passa a levar mais de três horas.
Proxies lentos: meça primeiro, depois defina o timeout
Um proxy acrescenta um salto a cada requisição, e um navegador faz muitas requisições por página. IPs residenciais passam por conexões domésticas e costumam acrescentar mais latência do que os de datacenter, então um limite que nunca dispara na linha do seu escritório pode disparar por um IP de saída distante. Meça antes de escolher um número. Este script abre a mesma página cinco vezes em contextos novos, com o limite desligado só durante a medição:
import statistics
import time

from playwright.sync_api import sync_playwright

PROXY = {"server": "http://pr.proxynet.io:8000", "username": "user", "password": "pass"}
URL = "https://shop.example.com/product/42"

with sync_playwright() as p:
    browser = p.chromium.launch(proxy=PROXY)
    times = []
    for _ in range(5):
        context = browser.new_context()  # sessão nova, sem cache entre as execuções
        page = context.new_page()
        start = time.monotonic()
        page.goto(URL, wait_until="domcontentloaded", timeout=0)  # sem limite durante a medição
        page.locator("#price").wait_for(timeout=0)
        times.append(time.monotonic() - start)
        context.close()
    browser.close()

print("runs:", " ".join(f"{t:.2f}s" for t in times))
print(f"median {statistics.median(times):.2f}s, slowest {max(times):.2f}s")
Pelo nosso proxy local de teste, que acrescenta 2 segundos a cada requisição, ele imprimiu:
runs: 3.42s 3.38s 3.37s 3.38s 3.38s
median 3.38s, slowest 3.42s
Baseie o limite na execução mais lenta, com folga acima dela; nós escolhemos 15 segundos. Em um alvo real, colete mais amostras e meça de novo quando o país, o tipo de proxy ou o site mudarem. Mais três pontos:
- Carregue menos. Bloquear imagens, mídia e fontes com
page.route()reduz as requisições por página; o código está no nosso guia de Playwright com proxy. - Escolha a saída conforme o trabalho. Os IPs de saída dos Proxies de datacenter são mais rápidos quando o alvo aceita IPs de datacenter. Quando um site exige IPs domésticos ou uma cidade, use os Proxies residenciais, com um limite próprio medido.
- Confira as credenciais. Com uma senha de proxy errada em um site HTTPS, o nosso listener de
requestfailedimprimiunet::ERR_TUNNEL_CONNECTION_FAILEDna hora, mas opage.gotosó falhou quando o seu limite de 10 segundos acabou. Um problema de credenciais pode parecer um proxy lento, então acrescente este listener enquanto depura:
page.on("requestfailed", lambda r: print("FAILED:", r.url, r.failure))Fora do navegador, o Requests do Python relata falhas de proxy como "Max retries exceeded"; Max Retries Exceeded With URL: o que é e como resolver explica como ler essa mensagem.
Quando uma página de bloqueio vira "elemento não encontrado"
Este é o caso que mais custa tempo. O site recusa a requisição e serve uma página de bloqueio com status 403 ou 429. O page.goto() não lança exceção para status de erro HTTP; o nosso goto retornou normalmente com um 403. Em seguida, o script espera o limite inteiro por um elemento que a página de bloqueio nunca vai conter. O log fala em timeout; a resposta real era uma recusa.
A nossa página de bloqueio de teste tinha o título "Access denied", e o erro do expect() em Python chegou a imprimir o snapshot de acessibilidade dela, com heading "Access denied" dentro. Olhe antes de esperar:
- Guarde a resposta que o
gotoretorna e leia o status dela. - Leia
page.title(); páginas de bloqueio e de desafio têm títulos próprios. - Se qualquer um dos dois indicar bloqueio, pare: sem nova tentativa e sem esperar o elemento.
- Descubra o motivo: o seu ritmo de requisições, o
robots.txte os termos do site, ou se ele oferece uma API.
Tentar de novo em uma página de bloqueio piora a situação, e trocar de IP para passar por cima de uma recusa não é solução: o site disse não. Um 429 significa requisições demais; diminua o ritmo e respeite o Retry-After (429 Too Many Requests: o que é o erro de rate limit). Por que os sites sinalizam visitantes automatizados está em Como funciona a detecção de bots: a lógica anti-bot. Não tratamos de formas de contornar essas páginas; o que dura é uma varredura mais lenta, uma permissão ou a API oficial (Web scraping vs. API: qual você deve usar?).
Exemplo completo: timeouts medidos, verificação de bloqueio e novas tentativas
O script abre páginas de produto por um proxy. Cada tentativa recebe um contexto novo com limites definidos de propósito. Ele confere o status e o título antes de esperar o conteúdo, para diante de uma página de bloqueio e só tenta de novo nos timeouts, com uma espera que cresce de forma exponencial (exponential backoff) mais um componente aleatório (jitter), para que workers em paralelo não repitam as tentativas no mesmo compasso.
"""Abre páginas de produto por um proxy com timeouts medidos, verificação de bloqueio e novas tentativas."""
import random
import time

from playwright.sync_api import TimeoutError as PlaywrightTimeoutError
from playwright.sync_api import sync_playwright

PROXY = {"server": "http://pr.proxynet.io:8000", "username": "user", "password": "pass"}
URLS = [f"https://shop.example.com/product/{n}" for n in (42, 43, 44)]

NAV_TIMEOUT = 15_000     # ms: cerca de 4x a página mais lenta que medimos pelo proxy
ACTION_TIMEOUT = 10_000  # ms: locators, cliques e esperas
ATTEMPTS = 3
STOP_STATUS = {403, 429}  # uma recusa ou um rate limit: tentar de novo só piora
STOP_WORDS = ("access denied", "blocked", "captcha", "verify you are human")  # ajuste para cada site


class Blocked(Exception):
    """O site respondeu com uma página de bloqueio ou de rate limit: pare e descubra o motivo."""


def fetch_price(browser, url):
    for attempt in range(1, ATTEMPTS + 1):
        context = browser.new_context()  # cookies e cache limpos a cada tentativa
        context.set_default_navigation_timeout(NAV_TIMEOUT)
        context.set_default_timeout(ACTION_TIMEOUT)
        page = context.new_page()
        start = time.monotonic()
        try:
            response = page.goto(url, wait_until="domcontentloaded")
            status = response.status if response else None
            title = page.title()
            if status in STOP_STATUS or any(word in title.lower() for word in STOP_WORDS):
                raise Blocked(f"HTTP {status}, title {title!r}")
            return page.locator("#price").inner_text()  # espera automaticamente até ACTION_TIMEOUT
        except PlaywrightTimeoutError as exc:
            print(f"  attempt {attempt}: {str(exc).splitlines()[0]} ({time.monotonic() - start:.1f}s)")
            if attempt == ATTEMPTS:
                raise
            time.sleep(2**attempt + random.random())  # 2-3 s, depois 4-5 s
        finally:
            context.close()


with sync_playwright() as p:
    browser = p.chromium.launch(proxy=PROXY)
    for url in URLS:
        print(url)
        try:
            print("  price:", fetch_price(browser, url))
        except Blocked as exc:
            print("  stopped, not retrying:", exc)
        except PlaywrightTimeoutError:
            print(f"  gave up after {ATTEMPTS} attempts")
    browser.close()
Executamos o script com o host trocado pelo nosso site de teste local (shop.test), pelo proxy que acrescenta 2 segundos por requisição; a terceira página foi configurada para travar nas duas primeiras requisições:
http://shop.test/product/42
  price: $19.90
http://shop.test/product/43
  stopped, not retrying: HTTP 403, title 'Access denied'
http://shop.test/product/44
  attempt 1: Page.goto: Timeout 15000ms exceeded. (15.0s)
  attempt 2: Page.goto: Timeout 15000ms exceeded. (15.0s)
  price: $19.90
A página de bloqueio custou uma requisição e nenhuma espera; a página travada custou dois timeouts e depois deu certo. Novas tentativas guiadas por códigos de status, como 503 com Retry-After, ficam em uma camada separada; Códigos de status HTTP no web scraping: 403, 407, 429, 503 traz esse código. O mesmo núcleo em Node.js:
import { chromium, errors } from "playwright";

const PROXY = { server: "http://pr.proxynet.io:8000", username: "user", password: "pass" };
const URLS = ["https://shop.example.com/product/42", "https://shop.example.com/product/45"];

const browser = await chromium.launch({ proxy: PROXY });
for (const url of URLS) {
  const context = await browser.newContext();
  context.setDefaultNavigationTimeout(15_000); // goto, reload, waitForURL
  context.setDefaultTimeout(10_000);           // locators, cliques, esperas
  const page = await context.newPage();
  try {
    const response = await page.goto(url, { waitUntil: "domcontentloaded" });
    console.log(url, "status", response?.status(), "title", await page.title());
    console.log("  price:", await page.locator("#price").innerText());
  } catch (err) {
    if (!(err instanceof errors.TimeoutError)) throw err;
    console.log("  timeout:", err.message.split("\n")[0]);
  } finally {
    await context.close();
  }
}
await browser.close();
No nosso site de teste, a segunda página renderiza o preço depois de 12 segundos:
http://shop.test/product/42 status 200 title Product
  price: $19.90
http://shop.test/product/45 status 200 title Product
  timeout: locator.innerText: Timeout 10000ms exceeded.
Puppeteer: "Navigation timeout of 30000 ms exceeded"
O Puppeteer usa o mesmo modelo com outros nomes. O padrão dele também é de 30 segundos, page.setDefaultNavigationTimeout() e page.setDefaultTimeout() o alteram, e waitUntil aceita load, domcontentloaded, networkidle0 e networkidle2. A referência de eventos do ciclo de vida do Puppeteer define os dois últimos como no máximo 0 ou 2 conexões abertas por 500 ms, então eles falham em páginas movimentadas, assim como o networkidle.
import puppeteer, { TimeoutError } from "puppeteer";

const browser = await puppeteer.launch({ args: ["--proxy-server=http://pr.proxynet.io:8000"] });
const page = await browser.newPage();
await page.authenticate({ username: "user", password: "pass" });
page.setDefaultNavigationTimeout(15_000); // goto, reload, waitForNavigation
page.setDefaultTimeout(10_000);           // waitForSelector e outras esperas

try {
  const response = await page.goto("https://shop.example.com/product/45", { waitUntil: "domcontentloaded" });
  console.log("status", response?.status(), "title", await page.title());
  await page.waitForSelector("#price");
} catch (err) {
  if (!(err instanceof TimeoutError)) throw err;
  console.log(`${err.name}: ${err.message} (${err.cause?.message})`);
} finally {
  await browser.close();
}
As nossas execuções com Puppeteer 25.12 imprimiram estas mensagens; a primeira vem de uma página que nunca respondeu, com o limite padrão:
TimeoutError: Navigation timeout of 30000 ms exceeded
TimeoutError: Waiting for selector `#price` failed (Waiting failed: 10000ms exceeded)
A mensagem do seletor omite o limite; ele fica em err.cause. O proxy entra como flag do Chromium e as credenciais, por page.authenticate(), que liga a interceptação de requisições em segundo plano. As causas e soluções acima valem sem mudanças.
Onde você encontra esse erro
- Scraping de lojas renderizadas com JavaScript: os preços carregam depois do HTML, então espere o elemento (extração de dados).
- Varredura de uma fila longa: uma página travada deve custar um timeout, não a execução inteira (web crawler).
- Testes do seu próprio aplicativo a partir de outros países: cada IP de saída tem a sua própria latência, então defina limites por país (testes de aplicativos).
- Agentes de IA que controlam um navegador: um agente que chama
gotoesbarra nos mesmos limites (Playwright MCP). - Varreduras agendadas: leia as regras de rastreamento do site antes de ajustar a velocidade (O que é robots.txt e como ler o arquivo?).
Erros comuns
- Aumentar o padrão para 60 ou 120 segundos. Uma espera que não tem como dar certo só falha mais tarde.
- Tratar o
networkidlecomo "pronto". Páginas movimentadas nunca ficam em silêncio. - Pausas fixas antes de cada passo.
time.sleep()ewaitForTimeout()são longas demais em páginas rápidas e curtas demais nas lentas. - Capturar só
TimeoutErrorem volta deexpect()em Python. Ele lançaAssertionError. - Pular o status e o título. Uma página de bloqueio vira então um "elemento não encontrado" de 30 segundos.
- Repetir requisições bloqueadas. Novas tentativas servem para timeouts e quedas de rede, não para
403e429. - Calar as camadas sobrepostas com
force=True. O clique cai onde um usuário não conseguiria clicar.
Guia de decisão
| O que você vê | O que fazer |
|---|---|
page.goto: Timeout com waiting until "load" | domcontentloaded e depois espere o elemento |
page.goto: Timeout com waiting until "networkidle" | Abandone o networkidle; espere um elemento |
page.goto: Timeout com domcontentloaded | Meça o tempo de carregamento pelo proxy e defina o limite a partir dele |
waiting for locator(...) sem nada embaixo | Confira o seletor, os frames e em que página você está |
intercepts pointer events | Feche a camada sobreposta como um usuário faria |
Status 403 ou 429, ou um título de bloqueio | Pare; diminua o ritmo, confira o robots.txt, peça permissão ou use uma API |
Test timeout of 30000ms exceeded. | Encontre o passo que travou; aumente o limite só para testes lentos |
requestfailed mostra ERR_TUNNEL_CONNECTION_FAILED | Corrija as credenciais do proxy antes de mexer nos timeouts |
Perguntas frequentes
Qual é o timeout padrão do Playwright?
Na biblioteca, 30 segundos para navegações e ações. No Playwright Test, um teste inteiro tem 30 segundos e cada expect(), 5 segundos; ações e navegações não têm um limite próprio.
Como aumentar o timeout do page.goto?
Passe-o na chamada (page.goto(url, timeout=60_000) em Python, { timeout: 60_000 } em Node.js), defina set_default_navigation_timeout() no contexto ou navigationTimeout na configuração do Playwright Test. Aumente só depois de medir.
Por que o page.goto estoura o timeout se a página já aparece na tela?
O goto espera o evento load por padrão, e uma única imagem ou widget que nunca termina o segura. Use domcontentloaded e espere o elemento de que você precisa.
Devo usar networkidle?
Não. A referência do Playwright o marca como desaconselhado, e páginas com polling ou chat ao vivo podem nunca alcançá-lo. Espere um elemento específico.
Como capturar um TimeoutError do Playwright em Python?
Importe-o como from playwright.sync_api import TimeoutError as PlaywrightTimeoutError e capture esse nome. Um expect() que falha lança AssertionError.
Um proxy pode causar timeouts no Playwright?
Sim. Um IP de saída lento pode empurrar as páginas além do limite, e credenciais erradas em um site HTTPS podem aparecer como timeout. Meça pelo proxy, defina os limites a partir dos resultados e escute o requestfailed. Uma página de bloqueio não se resolve com outro proxy.
Em resumo
"Timeout 30000ms exceeded" aponta a espera que se esgotou, não a causa. Leia o método e o fim do call log e corrija o que eles indicam: uma espera por load ou networkidle, um seletor, uma camada sobreposta, um frame, uma página de bloqueio ou um IP de saída lento. Defina os limites no contexto a partir de tempos de carregamento medidos, dê à página lenta ocasional um limite próprio, tente de novo só nos timeouts, com backoff, e pare diante de bloqueios. Para escolher proxies que combinem com os seus alvos, compare nossos serviços de proxy.