اگر وبسایتی دارید، احتمالاً نام llms.txt از یکی از این دو راه به گوشتان خورده است. یا افزونه سئو پیشنهاد کرده آن را بسازد «تا هوش مصنوعی شما را پیدا کند»، یا گزارش Lighthouse زیر عنوان تازه Agentic Browsing (مرور عاملی) سطر "llms.txt does not follow recommendations" («فایل llms.txt از توصیهها پیروی نمیکند») را نشان داده است. بعد خواندهاید که جستوجوی گوگل این فایل را نادیده میگیرد. هر دو درست است، و وقتی بدانید این فایل برای چه کاری است، دیگر با هم متناقض به نظر نمیرسند.
در این نوشته قالب فایل، llms-full.txt و نسخههای Markdown صفحهها را توضیح میدهیم و تفاوت آن را با robots.txt و sitemap.xml نشان میدهیم. بخشی از فایل /llms.txt خودمان را میآوریم، بررسی میکنیم گوگل، Chrome، OpenAI و Anthropic تا 5 اکتبر 2026 چه گفتهاند و در پایان شیوه ساختن آن را شرح میدهیم.
llms.txt چیست؟
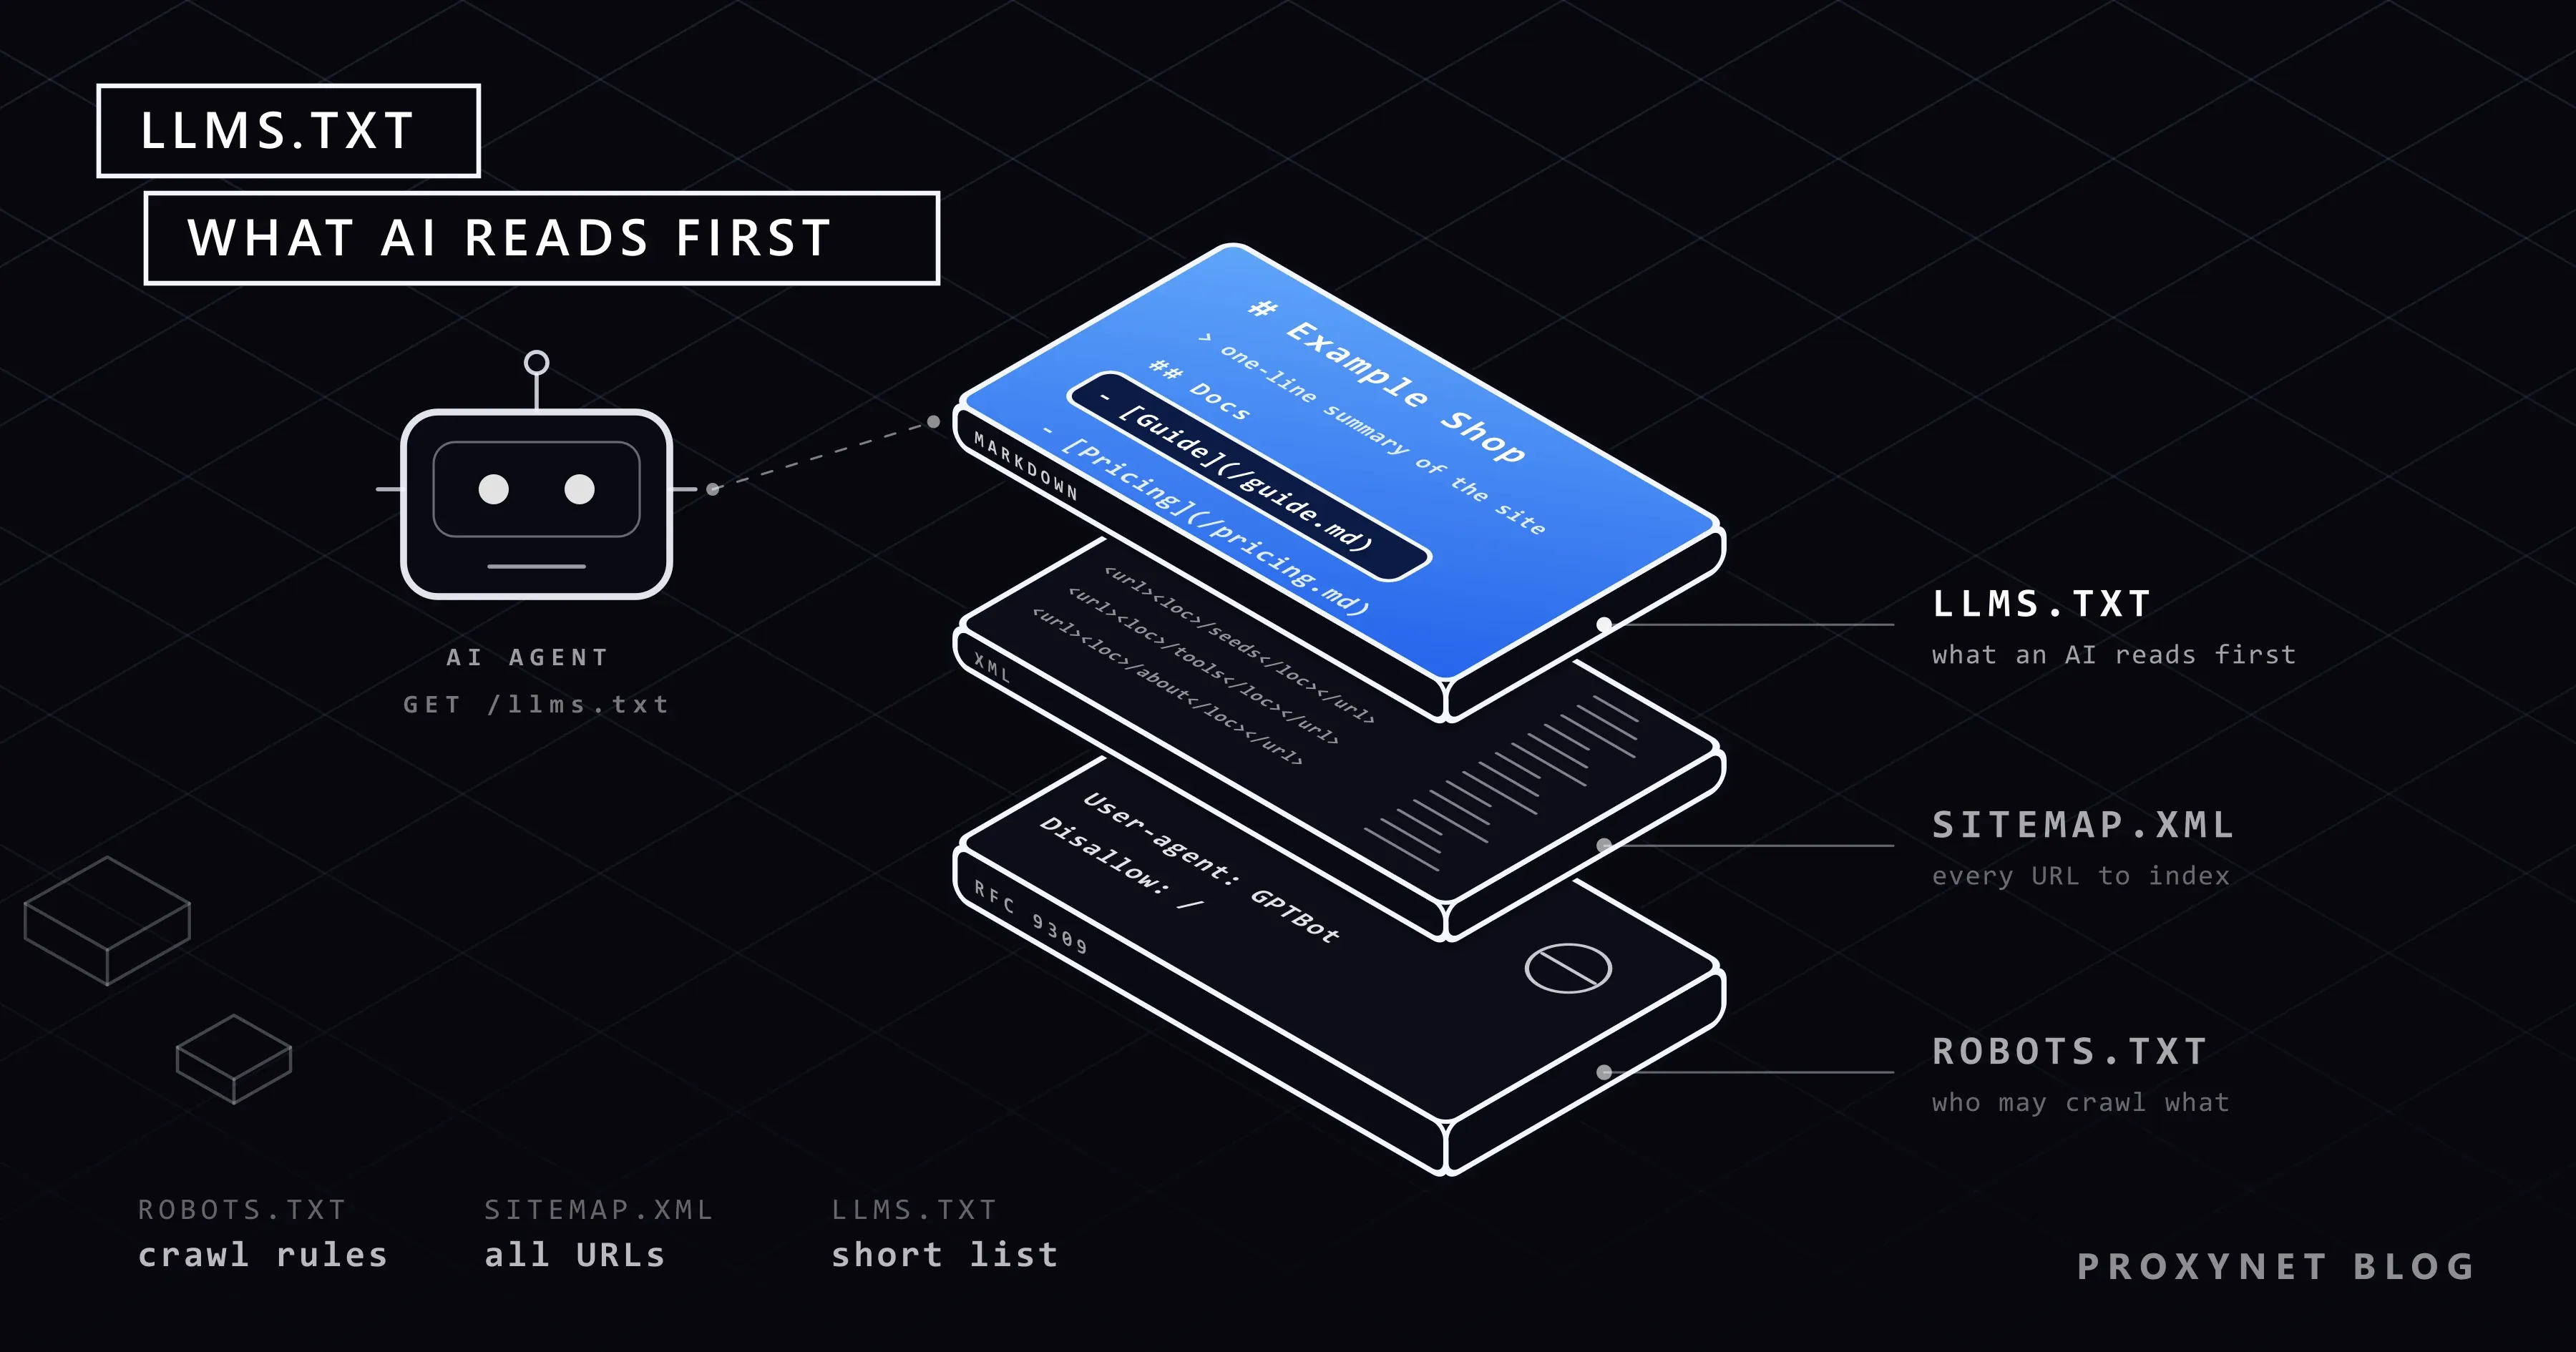
llms.txt فایلی متنی است که با Markdown نوشته میشود و سایت آن را در نشانی /llms.txt میگذارد. این فایل به مدل زبانی بزرگ (LLM)، یعنی همان نوع هوش مصنوعی که پشت ChatGPT، Claude و Gemini است، میگوید سایت چیست و کدام صفحهها ارزش خواندن دارند. مسئلهای که حل میکند اندازه است: مدل در هر لحظه فقط مقدار محدودی متن را میتواند در نظر بگیرد که به آن پنجره زمینه میگویند، و کل یک وبسایت با منوها و اسکریپتهایش بهندرت در این پنجره جا میشود.
جرمی هاوارد این پیشنهاد را در 3 سپتامبر 2024 در llmstxt.org منتشر کرد؛ نسخه دوم با تاریخ 10 اوت 2026 تجربه دو سال استفاده را در خود دارد. فایل برای استنتاج (inference)، یعنی لحظهای که مدل به پرسشی پاسخ میدهد، طراحی شده است، نه برای آموزش مدل: آن را دستیاری میخواند که کاربر از او چیزی پرسیده است، نه خزندهای که برای مدل بعدی مطلب جمع میکند.
llms.txt یک قرارداد است و هیچ RFC یا مشخصات W3C پشت آن نیست. مجموعه قواعد هم نیست: هیچ سطری در این فایل دسترسی به صفحهای را مجاز یا ممنوع نمیکند.
فایل llms.txt چه شکلی دارد؟
پیشنهاد، ترتیب بخشها را تعیین میکند. فقط بخش نخست الزامی است:
- یک عنوان H1 با نام سایت یا پروژه.
- یک بلوک نقلقول (blockquote) با خلاصهای کوتاه از واقعیتهای اصلی.
- پاراگرافها یا فهرستهای بیعنوان، برای جزئیاتی مانند اینکه سایت چگونه سازمان یافته است.
- بخشهای H2 با فهرست پیوندها، که هر مورد آن یک پیوند Markdown با یادداشتی اختیاری است:
- [Name](url): note. - بخشی به نام
Optionalکه طبق قرارداد، پیوندهایی را نگه میدارد که عامل هنگام کمبود جا میتواند از آنها بگذرد.
فایل یک فروشگاه اینترنتی کوچک میتواند اینگونه باشد. فروشگاه و نشانیهایش ساختگیاند و متن نمونه را به انگلیسی آوردهایم:
# Example Garden Supply

> Example Garden Supply sells seeds, garden tools and irrigation parts online and ships to all EU countries.

Every product page shows stock per warehouse. Care guides are written by our own staff.

## Shop

- [Seeds](https://example.com/seeds.md): vegetable and flower seeds, sorted by sowing month
- [Irrigation](https://example.com/irrigation.md): drip kits, timers and spare parts, with compatibility tables

## Help

- [Shipping and returns](https://example.com/shipping.md): delivery times per country, return window and costs
- [Contact](https://example.com/contact): email and phone support hours

## Optional

- [Company history](https://example.com/about.md)یادداشتها مهماند: عامل فقط از روی نام و یادداشت یک پیوند تصمیم میگیرد آن را باز کند یا نه. برای همین یادداشت "delivery times per country, return window and costs" (زمان تحویل برای هر کشور، مهلت بازگرداندن کالا و هزینهها) از یک "Shipping" (ارسال) خالی بسیار کارآمدتر است.
یک نمونه واقعی: فایل /llms.txt خودمان
فایل llms.txt ما در proxynet.io/llms.txt هرگز دستی ویرایش نمیشود: اسکریپتی آن را در هر بار ساخت (build) سایت از همان دادهای تولید میکند که صفحهها را میسازد، پس ممکن نیست نوشته تازهای در وبلاگ از قلم بیفتد. فایل با # Proxynet و یک بلوک نقلقول چهارسطری آغاز میشود که میگوید ما که هستیم، چه میفروشیم و صورتحساب و پرداخت چگونه انجام میشود. نخستین بخش اینطور شروع میشود:
## Company

- [Homepage](https://proxynet.io): overview of all proxy types, the network and the panel
بخش آخر از قرارداد Optional پیروی میکند:
## Optional

- [Proxynet (Deutsch)](https://proxynet.io/de): site home in Deutsch
- [Blog (Deutsch)](https://proxynet.io/de/blog): blog index in Deutsch; every post is also available as plain Markdown by adding .md to its URLصفحههای انگلیسی و ترکی یکییکی فهرست شدهاند؛ چهار زبان دیگر، از جمله فارسی، همان ساختار انگلیسی را دارند و برای همین زیر Optional آمدهاند. نوشتههای وبلاگ با نشانی .md خود فهرست شدهاند، یعنی رونوشتی ساده به Markdown که با هدر X-Robots-Tag: noindex فرستاده میشود تا هرگز در نتایج جستوجو با صفحه اصلی رقابت نکند. چون هر نوشته به دو زبان در فایل آمده است، فایل چند صد پیوند دارد؛ بیشتر سایتها با فایلی به اندازه یکی دو صفحه نتیجه بهتری میگیرند.
PageSpeed Insights نخستین نسخه ما را که دستی نوشته بودیم با پیام "llms.txt does not follow recommendations" علامت زد. همه پیوندها نشانی خام بودند، یعنی URL بدون قالب پیوند Markdown، پس بررسی پیوند Markdown هیچ پیوندی پیدا نکرد. فایل همچنین فهرستها را زیر عنوانهای H3 گذاشته بود و دو نشانی جاینگهدار داشت که خطای 404 برمیگرداندند. تولید خودکار فایل هر سه مشکل را برطرف کرد.
llms-full.txt و نسخههای Markdown صفحهها
llms.txt فهرستی است که به صفحهها اشاره میکند. اغلب دو همراه هم کنار آن دیده میشوند.
نسخههای Markdown. پیشنهاد از سایتها میخواهد رونوشت تمیزی به Markdown از صفحههای مفید را در همان نشانی با پسوند افزوده .md ارائه کنند (/guide.html.md، یا /guide/index.html.md وقتی نشانی نام فایل ندارد). Markdown عنوانها، فهرستها، جدولها و پیوندها را نگه میدارد اما منوها و اسکریپتها را کنار میگذارد، پس محتوا جای بسیار کمتری از پنجره زمینه را میگیرد. نسخه 2 راهی برای یافتن این رونوشتها افزوده است: پیوند rel="alternate" از نوع text/markdown، در HTML صفحه یا در هدر HTTP به نام Link. نوشتههای وبلاگ ما این برچسب را دارند.
اگر سایت پشت Cloudflare باشد، قابلیت Markdown for Agents بینیاز از فایلهای جداگانه کار مشابهی میکند: وقتی کلاینت هدر Accept: text/markdown را بفرستد، Cloudflare صفحه HTML را به Markdown تبدیل میکند. این قابلیت در پلنهای Pro، Business و Enterprise با یک کلید زیر بخش AI Crawl Control (کنترل خزش هوش مصنوعی) روشن میشود.
llms-full.txt. این فایل بخشی از پیشنهاد نیست، بلکه قراردادی است که از پلتفرمهای مستندات آمده است: متن کامل مستندات در یک فایل. مستندات توسعهدهندگان Anthropic هر دو را منتشر میکند و فایل llms.txt آن با پیوندی به llms-full.txt تمام میشود. این فایل برای مرجع API که دستیار برنامهنویسی از ابتدا تا انتها میخواند مناسب است؛ برای فروشگاه، همان فهرست کافی است.
تفاوت llms.txt با robots.txt و sitemap.xml
این سه فایل کنار هم در ریشه سایت قرار دارند، اما به پرسشهای متفاوتی پاسخ میدهند:
robots.txt | sitemap.xml | llms.txt | |
|---|---|---|---|
| پرسش | رباتها کدام مسیرها را میتوانند بخزند؟ | چه نشانیهایی وجود دارد؟ | هوش مصنوعی اول چه چیزی را بخواند؟ |
| خواننده اصلی | خزندههای جستوجو و هوش مصنوعی | موتورهای جستوجو | دستیارها و عاملهای هوش مصنوعی |
| قالب | قواعد متنی ساده | XML | Markdown |
| وضعیت | استاندارد (RFC 9309) | پروتکل Sitemaps | پیشنهاد جامعه |
| دسترسی را کنترل میکند؟ | از خزندهها میخواهد دور بمانند | نه | نه |
| گستره | فقط قواعد | هر صفحهای که باید ایندکس شود | گزیدهای کوتاه |
robots.txt در RFC 9309 تعریف شده است و این RFC صریحاً میگوید قواعد آن نوعی مجوز دسترسی نیستند: خزندههای خوشرفتار از آنها پیروی میکنند، اما هیچ چیز آنها را به اجرا وادار نمیکند. هر قاعده را در راهنمای robots.txt توضیح دادهایم.
نقشه سایت (sitemap) هر نشانی را که میخواهید موتورهای جستوجو پیدا کنند فهرست میکند و طبق پروتکل Sitemaps هر فایل تا 50,000 نشانی را در خود جا میدهد؛ اینکه کجا را بگردید در پیدا کردن نقشه سایت آمده است. نقشه سایت میخواهد کامل باشد و یادداشتی ندارد، در حالی که llms.txt عمداً گزینشی است.
آیا llms.txt کار میکند؟
پاسخ بستگی دارد به اینکه انتظار دارید چه کسی آن را بخواند. آنچه هر شرکت گفته یا عرضه کرده در ادامه آمده است؛ همه را در 5 اکتبر 2026 بررسی کردهایم.
جستوجوی گوگل: بیاثر. راهنمای بهینهسازی برای هوش مصنوعی گوگل که 15 مه 2026 منتشر شد میگوید برای دیده شدن در جستوجو، از جمله در قابلیتهای هوش مصنوعی مولد آن، به فایلهای ماشینخوان تازه یا Markdown نیازی ندارید. یادداشتی که 15 ژوئن 2026 به آن افزوده شد روشنتر است: llms.txt نه به دیده شدن و رتبه کمک میکند و نه آسیب میزند، چون جستوجوی گوگل این فایلها را نادیده میگیرد.
Lighthouse در Chrome: بررسی قالب. Lighthouse، ابزار ممیزی Chrome DevTools و PageSpeed Insights، دسته تازهای به نام Agentic Browsing دارد که صفحه امتیازدهی Chrome آن را آزمایشی میخواند: به Chrome 150 یا جدیدتر نیاز دارد و امتیاز 0 تا 100 نمیدهد. Lighthouse رابط فارسی ندارد، برای همین نام دسته و پیامهایش را به انگلیسی آوردهایم. صفحه ممیزی llms.txt تاریخ 5 مه 2026 را دارد و کد منبع کل آزمون را نشان میدهد: سطری که با # آغاز شود، دستکم یک پیوند Markdown و دستکم 50 نویسه. پاسخ 404 آزمون را «قابل اجرا نیست» میکند و خطای سرور آن را رد میکند. این ممیزی قالب را میسنجد، نه اینکه هوش مصنوعیای از فایل استفاده میکند یا نه.
OpenAI: robots.txt برای خزندهها. مستندات خزندههای OpenAI خزندههای OAI-SearchBot (جستوجوی ChatGPT)، GPTBot (آموزش)، OAI-AdsBot و ChatGPT-User (کارهایی که کاربر آغاز میکند) و شیوه مدیریت آنها در robots.txt را شرح میدهد. OpenAI برای مستندات توسعهدهندگان خودش یک llms.txt منتشر میکند، اما نگفته است که خزندههایش فایل سایتهای دیگر را میخوانند.
Anthropic: robots.txt برای خزندهها. مقاله راهنمای Anthropic درباره خزش که 7 آوریل 2026 بهروز شده است، ClaudeBot (آموزش)، Claude-User (صفحههایی که به درخواست کاربر گرفته میشوند) و Claude-SearchBot (کیفیت جستوجو) را نام میبرد که هر سه با robots.txt کنترل میشوند. این مقاله نامی از llms.txt نمیبرد، هرچند مستندات توسعهدهندگان Anthropic یک llms.txt منتشر میکند.
پس هیچیک از این شرکتها اعلام نکرده است که llms.txt را نشانهای برای خزش، رتبهبندی یا ارجاع به منبع به کار میبرد، در حالی که آزمایشگاههای هوش مصنوعی خودشان آن را برای مستنداتشان منتشر میکنند. کاربردی که پابرجا میماند خواندن بههنگام نیاز است: دستیار برنامهنویسی llms.txt یک کتابخانه را میگیرد تا صفحه درست را پیدا کند، یا عاملی که به سایت شما فرستاده شده بهجای حدس زدن از روی منو آن را میخواند. فایل متنی هیچ اسکریپت ردیابیای اجرا نمیکند، پس درخواستهای /llms.txt را در لاگهای سرور جستوجو کنید، نه در ابزار تحلیل بازدید.
خزندههای هوش مصنوعی را robots.txt کنترل میکند، نه llms.txt
llms.txt نمیتواند به شرکتهای هوش مصنوعی بگوید از چه چیزی اجازه استفاده دارند. کنار گذاشتن یک صفحه از فایل آن را پنهان نمیکند و آوردنش در فهرست هم مجوزی نمیدهد. خزندهها به robots.txt نگاه میکنند که در آن برای هر User-Agent یک گروه جداگانه نوشته میشود:
User-agent: GPTBot
Disallow: /

User-agent: ClaudeBot
Disallow: /

User-agent: Google-Extended
Disallow: /
دو گروه نخست از خزندههای آموزشی OpenAI و Anthropic میخواهند از سایت دور بمانند. Google-Extended تعیین میکند آیا گوگل میتواند محتوای شما را برای آموزش مدلهای Gemini و برای مستند کردن پاسخها به منبع (grounding) به کار ببرد؛ مستندات خزندههای گوگل میگوید این نشانه بر حضور یا رتبه در جستوجو اثری ندارد. خزندههای جستوجو مانند OAI-SearchBot و Claude-SearchBot نشانههای جداگانه خود را دارند، پس سایت میتواند در جستوجوی هوش مصنوعی بماند و همزمان از آموزش مدل کنار بکشد. robots.txt خود ما صریحاً به GPTBot، ClaudeBot و Google-Extended اجازه میدهد؛ تصمیم شما هر چه باشد، جای آن در robots.txt است.
چگونه فایل llms.txt بسازیم؟
- صفحههایی را انتخاب کنید که به پرسشهای مشتری از یک دستیار درباره شما پاسخ میدهند: محصولات یا خدمات، قیمتها، مستندات، سیاستها، تماس.
- عنوان H1 و بلوک نقلقول را بنویسید و در آن واقعیتهایی را بیاورید که مدل در غیر این صورت باید حدس بزند: چه چیزی، به چه کسی و در کجا ارائه میکنید.
- پیوندها را زیر عنوانهای H2 گروهبندی کنید، به شکل
- [Name](url): noteو با نشانی کامل، و صفحههای فرعی را زیر## Optionalببرید. - اگر میتوانید نسخه Markdown صفحهها را ارائه کنید، به آنها پیوند بدهید.
- فایل را در ریشه سایت بارگذاری کنید تا
https://yourdomain.com/llms.txtبا کد وضعیت 200 و بهصورت متن ساده پاسخ دهد؛ سپس Lighthouse را در Chrome DevTools یا PageSpeed Insights اجرا کنید و سطرllms.txtرا زیر Agentic Browsing پیدا کنید. - فایل را بهروز نگه دارید یا آن را خودکار تولید کنید. پیوند کهنه عامل را به صفحه 404 میفرستد.
ابزارهای تولید، افزونهها و پلتفرمها
- وردپرس. برخی افزونههای سئو فایل را میسازند و بهروز نگه میدارند. در Yoast SEO این قابلیت یک کلید در گروه ابزارهای هوش مصنوعی است: از منوی Yoast SEO به صفحه Settings (تنظیمات) بروید و بخش امکانات سایت را باز کنید (صفحه راهنمای Yoast). این گزینه در نصبهای چندسایتی (multisite) در دسترس نیست. llmstxt.org افزونه AIOSEO را هم فهرست کرده است.
- Shopify. از زمان یادداشت تغییرات 28 مه 2026، هر فروشگاه یک
/agents.mdپیشفرض ارائه میکند و/llms.txtو/llms-full.txtبه همان محتوا اشاره میکنند. برای تغییر آن، یک قالبtemplates/agents.md.liquidیا یکllms.txt.liquidجداگانه در ویرایشگر کد پوسته (theme) اضافه کنید. - پلتفرمهای مستندات و سایتسازها. llmstxt.org از Mintlify، GitBook و Wix در میان پلتفرمهایی نام میبرد که فایل را تولید میکنند و افزونههایی برای VitePress، Docusaurus و Drupal را هم فهرست کرده است.
- ابزارهای آنلاین تولید فایل سایت شما را میخزند و پیشنویسی از فایل میسازند. این پیشنویس را نقطه شروع بدانید: خزنده نمیتواند بداند کدام صفحهها برای مشتریان شما مهماند.
- فرایند ساخت خودتان. اگر سایت، مانند سایت ما، از داده ساختاریافته ساخته میشود، فایل را در همان فرایند ساخت (build) تولید کنید تا از صفحهها عقب نماند.
چه کسانی llms.txt را میخوانند و عاملها چگونه باید آن را بخوانند؟
- مستندات API و نرمافزار. دستیارهای برنامهنویسی مستندات را بههنگام نیاز میخوانند، اغلب از راه ابزارهایی که با پروتکل MCP (Model Context Protocol) وصل شدهاند.
llms.txtاز همینجا آغاز شد. - فروشگاهها و سایتهای رزرو. عاملهایی که محصولات را مقایسه میکنند به اطلاعات صفحههای شما نیاز دارند؛ رفتار سایتها با این عاملها را در چرا سایتها عاملهای خرید هوش مصنوعی را مسدود میکنند؟ بررسی کردهایم.
- سایتهایی که مردم با مرورگرهای هوش مصنوعی به آنها سر میزنند. این مرورگرها صفحهها را کموبیش مانند یک عامل میخوانند؛ نوشته مرورگر هوش مصنوعی چیست؟ را ببینید.
- تیمهایی که عامل میسازند. فایل
llms.txtیک سایت درخواست نخستین کمهزینهای است که نشان میدهد گام بعدی کجاست؛ حلقهای را که این درخواست در آن جا میگیرد در عاملهای هوش مصنوعی چگونه کار میکنند؟ توضیح دادهایم.
اگر عامل را خودتان میسازید، اول robots.txt را بخوانید: پیوندی در llms.txt قاعده Disallow را که برای User-Agent شما نوشته شده لغو نمیکند. فایل را ورودی نامطمئن بدانید که ممکن است تزریق پرامپت (prompt injection)، یعنی دستورهایی پنهانشده در محتوا، در خود داشته باشد؛ فهرست مجاز و محدودیت نرخ را در دسترسی امن LLM به وب شرح دادهایم. ربات خود را با یک User-Agent روشن معرفی کنید. برای جمعآوری صفحههای عمومی در مقیاس بزرگ، صفحههای خزنده وب و استخراج داده ما نشان میدهند پروکسی در خزندهای که این قواعد را رعایت میکند کجا جا میگیرد.
اشتباهات رایج
- نشانی خام بهجای پیوند Markdown. Lighthouse پیام "File does not appear to contain any links" (به نظر نمیرسد فایل هیچ پیوندی داشته باشد) را نشان میدهد؛ برای نسخه اول ما هم همین را نشان داد.
- استفاده از آن برای جلوگیری از آموزش هوش مصنوعی. این درخواست را فقط گروههای
robots.txtمنتقل میکنند. - چسباندن نقشه سایت در آن. هزاران نشانی بییادداشت هیچ دلیلی به عامل نمیدهد که صفحهای را بر صفحه دیگر ترجیح دهد.
- پیوندهای جاینگهدار یا مرده، مانند متغیرهای قالب از نوع
{slug}یا صفحههایی که اکنون خطای 404 برمیگردانند. - سروری که با HTML پاسخ میدهد. برخی پیکربندیها برای هر مسیر ناشناخته صفحه اصلی را برمیگردانند؛ این پاسخ عنوان Markdown ندارد و Lighthouse نبود H1 را گزارش میکند.
- یک بار نوشتن و فراموش کردن. خلاصه کهنه دقیقاً همان چیزی است که دستیار تکرار خواهد کرد.
راهنمای انتخاب
| وضعیت شما | پیشنهاد |
|---|---|
| ترافیک بیشتری از گوگل میخواهید، از جمله در AI Overviews | برای این هدف سراغ llms.txt نروید؛ روی محتوا، خزش و ایندکس شدن کار کنید |
| مستندات API یا محصول منتشر میکنید | llms.txt را همراه نسخههای Markdown منتشر کنید؛ llms-full.txt را هم در نظر بگیرید |
| سایت وردپرسی دارید | قابلیت را در افزونه سئو روشن کنید، سپس فهرست پیوندها را دستی کوتاه کنید |
| فروشگاه Shopify دارید | فایل پیشفرض agents.md را با یک قالب پوسته ویرایش کنید |
| میخواهید خزندههای آموزشی هوش مصنوعی را دور نگه دارید | در robots.txt گروههایی برای GPTBot، ClaudeBot و Google-Extended بیفزایید |
| Lighthouse پیام "llms.txt does not follow recommendations" را نشان میدهد | یک H1 بیفزایید، پیوند Markdown به کار ببرید و فایل را بهصورت متن با کد وضعیت 200 ارائه کنید |
پرسشهای متداول
آیا llms.txt به سئو کمک میکند؟
در جستوجوی گوگل نه. راهنمای بهینهسازی گوگل برای هوش مصنوعی میگوید جستوجو فایلهای llms.txt را نادیده میگیرد، پس این فایلها نه به رتبه و قابلیتهای هوش مصنوعی کمک میکنند و نه آسیبی میزنند. هر سودی از ابزارهای هوش مصنوعی میآید که فایل را بههنگام نیاز میخوانند.
آیا ChatGPT و Claude فایل llms.txt را میخوانند؟
نه OpenAI و نه Anthropic نگفتهاند که خزندههایشان از llms.txt استفاده میکنند؛ هر دو robots.txt را ابزار کنترل معرفی میکنند. با این حال دستیار میتواند وقتی کاربر یا ابزاری از او میخواهد آن نشانی را بگیرد، فایل را باز کند.
آیا llms.txt میتواند خزندههای هوش مصنوعی یا آموزش مدل را مسدود کند؟
نه، این فایل هیچ قاعدهای ندارد. برای اینکه از خزندهای بخواهید دور بماند، در robots.txt گروهی با نشانه User-Agent آن بیفزایید.
فایل llms.txt را کجا بگذارم؟
در ریشه دامنه، تا در https://example.com/llms.txt باز شود. پیشنهاد زیرپوشهای مانند /docs/llms.txt را هم مجاز میداند که فقط صفحههای زیر خودش را پوشش میدهد؛ این حالت وقتی به کار میآید که فقط بخشی از یک دامنه در اختیار شماست.
تفاوت llms.txt و llms-full.txt چیست؟
llms.txt فهرست کوتاهی از پیوندهاست. llms-full.txt متن کامل صفحهها را در یک فایل نگه میدارد؛ قراردادی است که از پلتفرمهای مستندات آمده و بخشی از پیشنهاد نیست.
آیا ابزاری برای اعتبارسنجی یا بررسی llms.txt وجود دارد؟
نزدیکترین چیز به یک بررسی رسمی، ممیزی llms.txt در Lighthouse است. این ممیزی فقط وجود H1، دستکم یک پیوند Markdown، حداقل طول و پاسخ سالم سرور را میآزماید، نه اینکه پیوندهای شما درست انتخاب شدهاند یا نه.
خلاصه
llms.txt فهرستی به Markdown برای ابزارهای هوش مصنوعی است: یک نام، یک خلاصه و پیوندهای گزیده. پیشنهاد است نه استاندارد، و هیچ چیزی را کنترل نمیکند؛ هنوز robots.txt است که به خزندههای هوش مصنوعی میگوید چه چیزی را میتوانند بگیرند. جستوجوی گوگل آن را نادیده میگیرد و Lighthouse فقط قالبش را بررسی میکند، پس ارزش آن در سایتهای مستندات، فروشگاهها و خدماتی است که عاملها از طرف کاربر میخوانند. فایل خود را کوتاه نگه دارید و آن را از دادههای سایتتان تولید کنید. اگر عامل یا خزندهای میسازید که صفحههای عمومی را میخواند، نگاهی به خدمات پروکسی ما بیندازید.