

































وب اسکرپینگ · وبلاگ Proxynet – صفحه 4

تاریخ انتشار
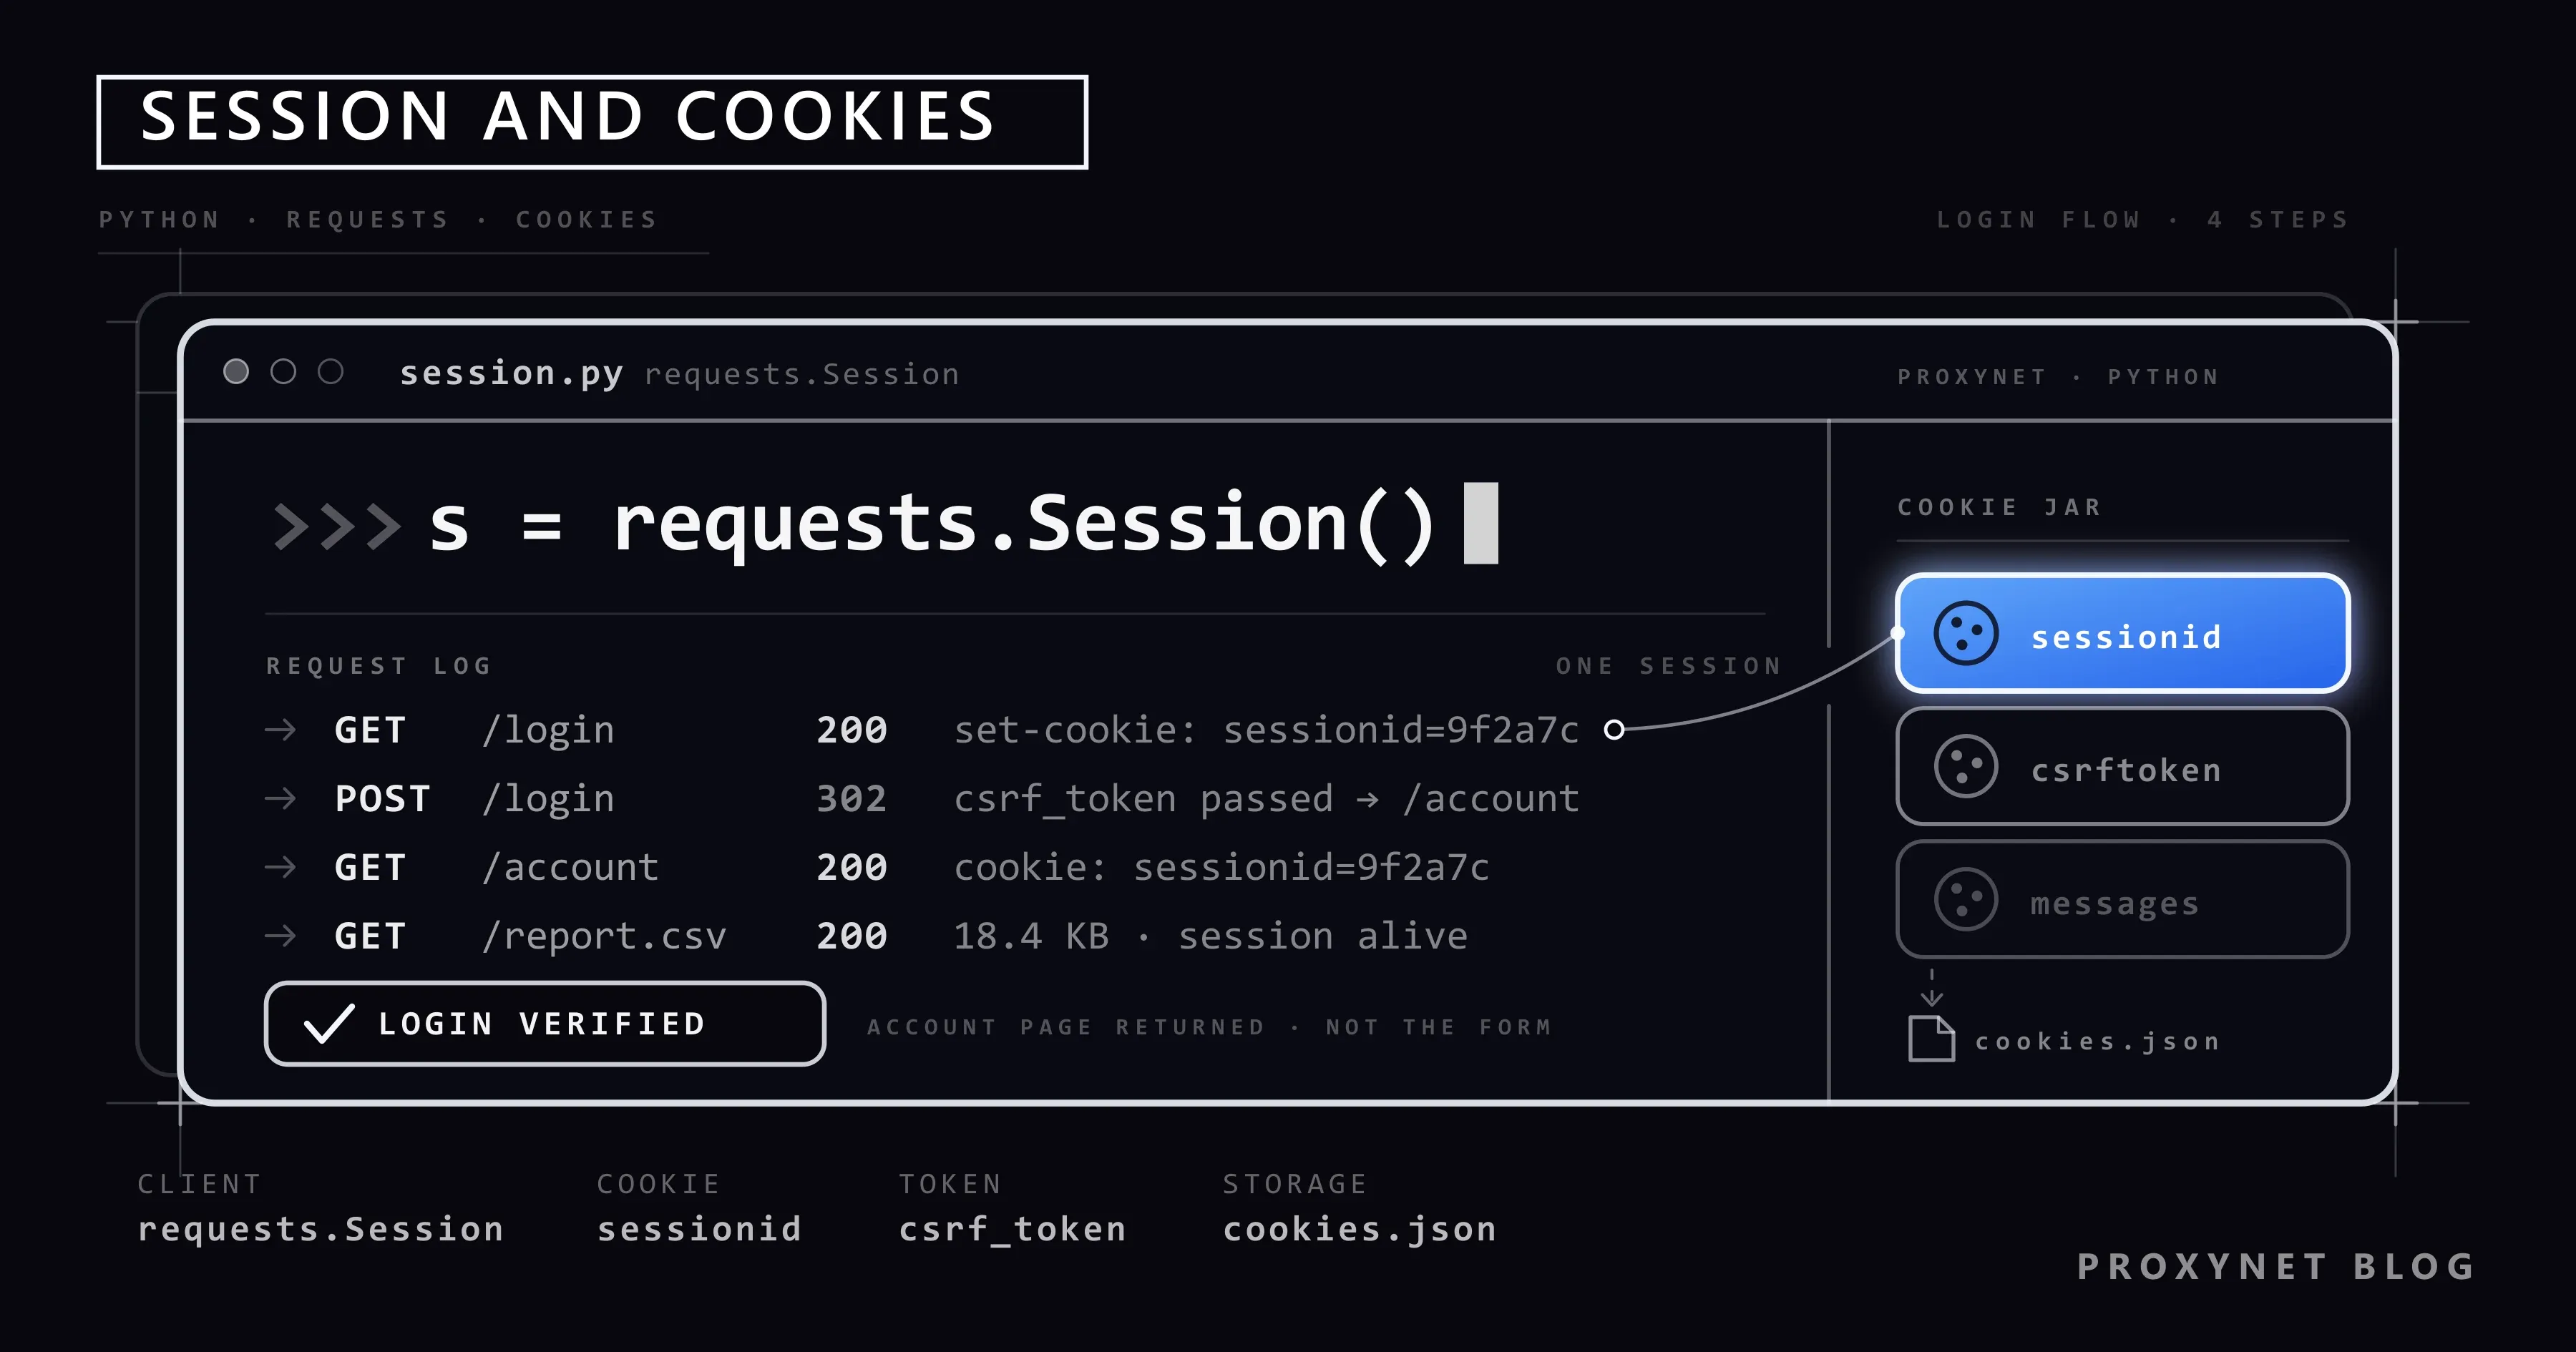
نشست و کوکی در Python: ورود با requests
requests.Session کوکیها را میان درخواستها میبرد و نشست را باز نگه میدارد. خواندن توکن CSRF از فرم، تأیید ورود و ذخیره نشست را نشان میدهیم.
نویسنده: Acar Diveroli
تاریخ انتشار
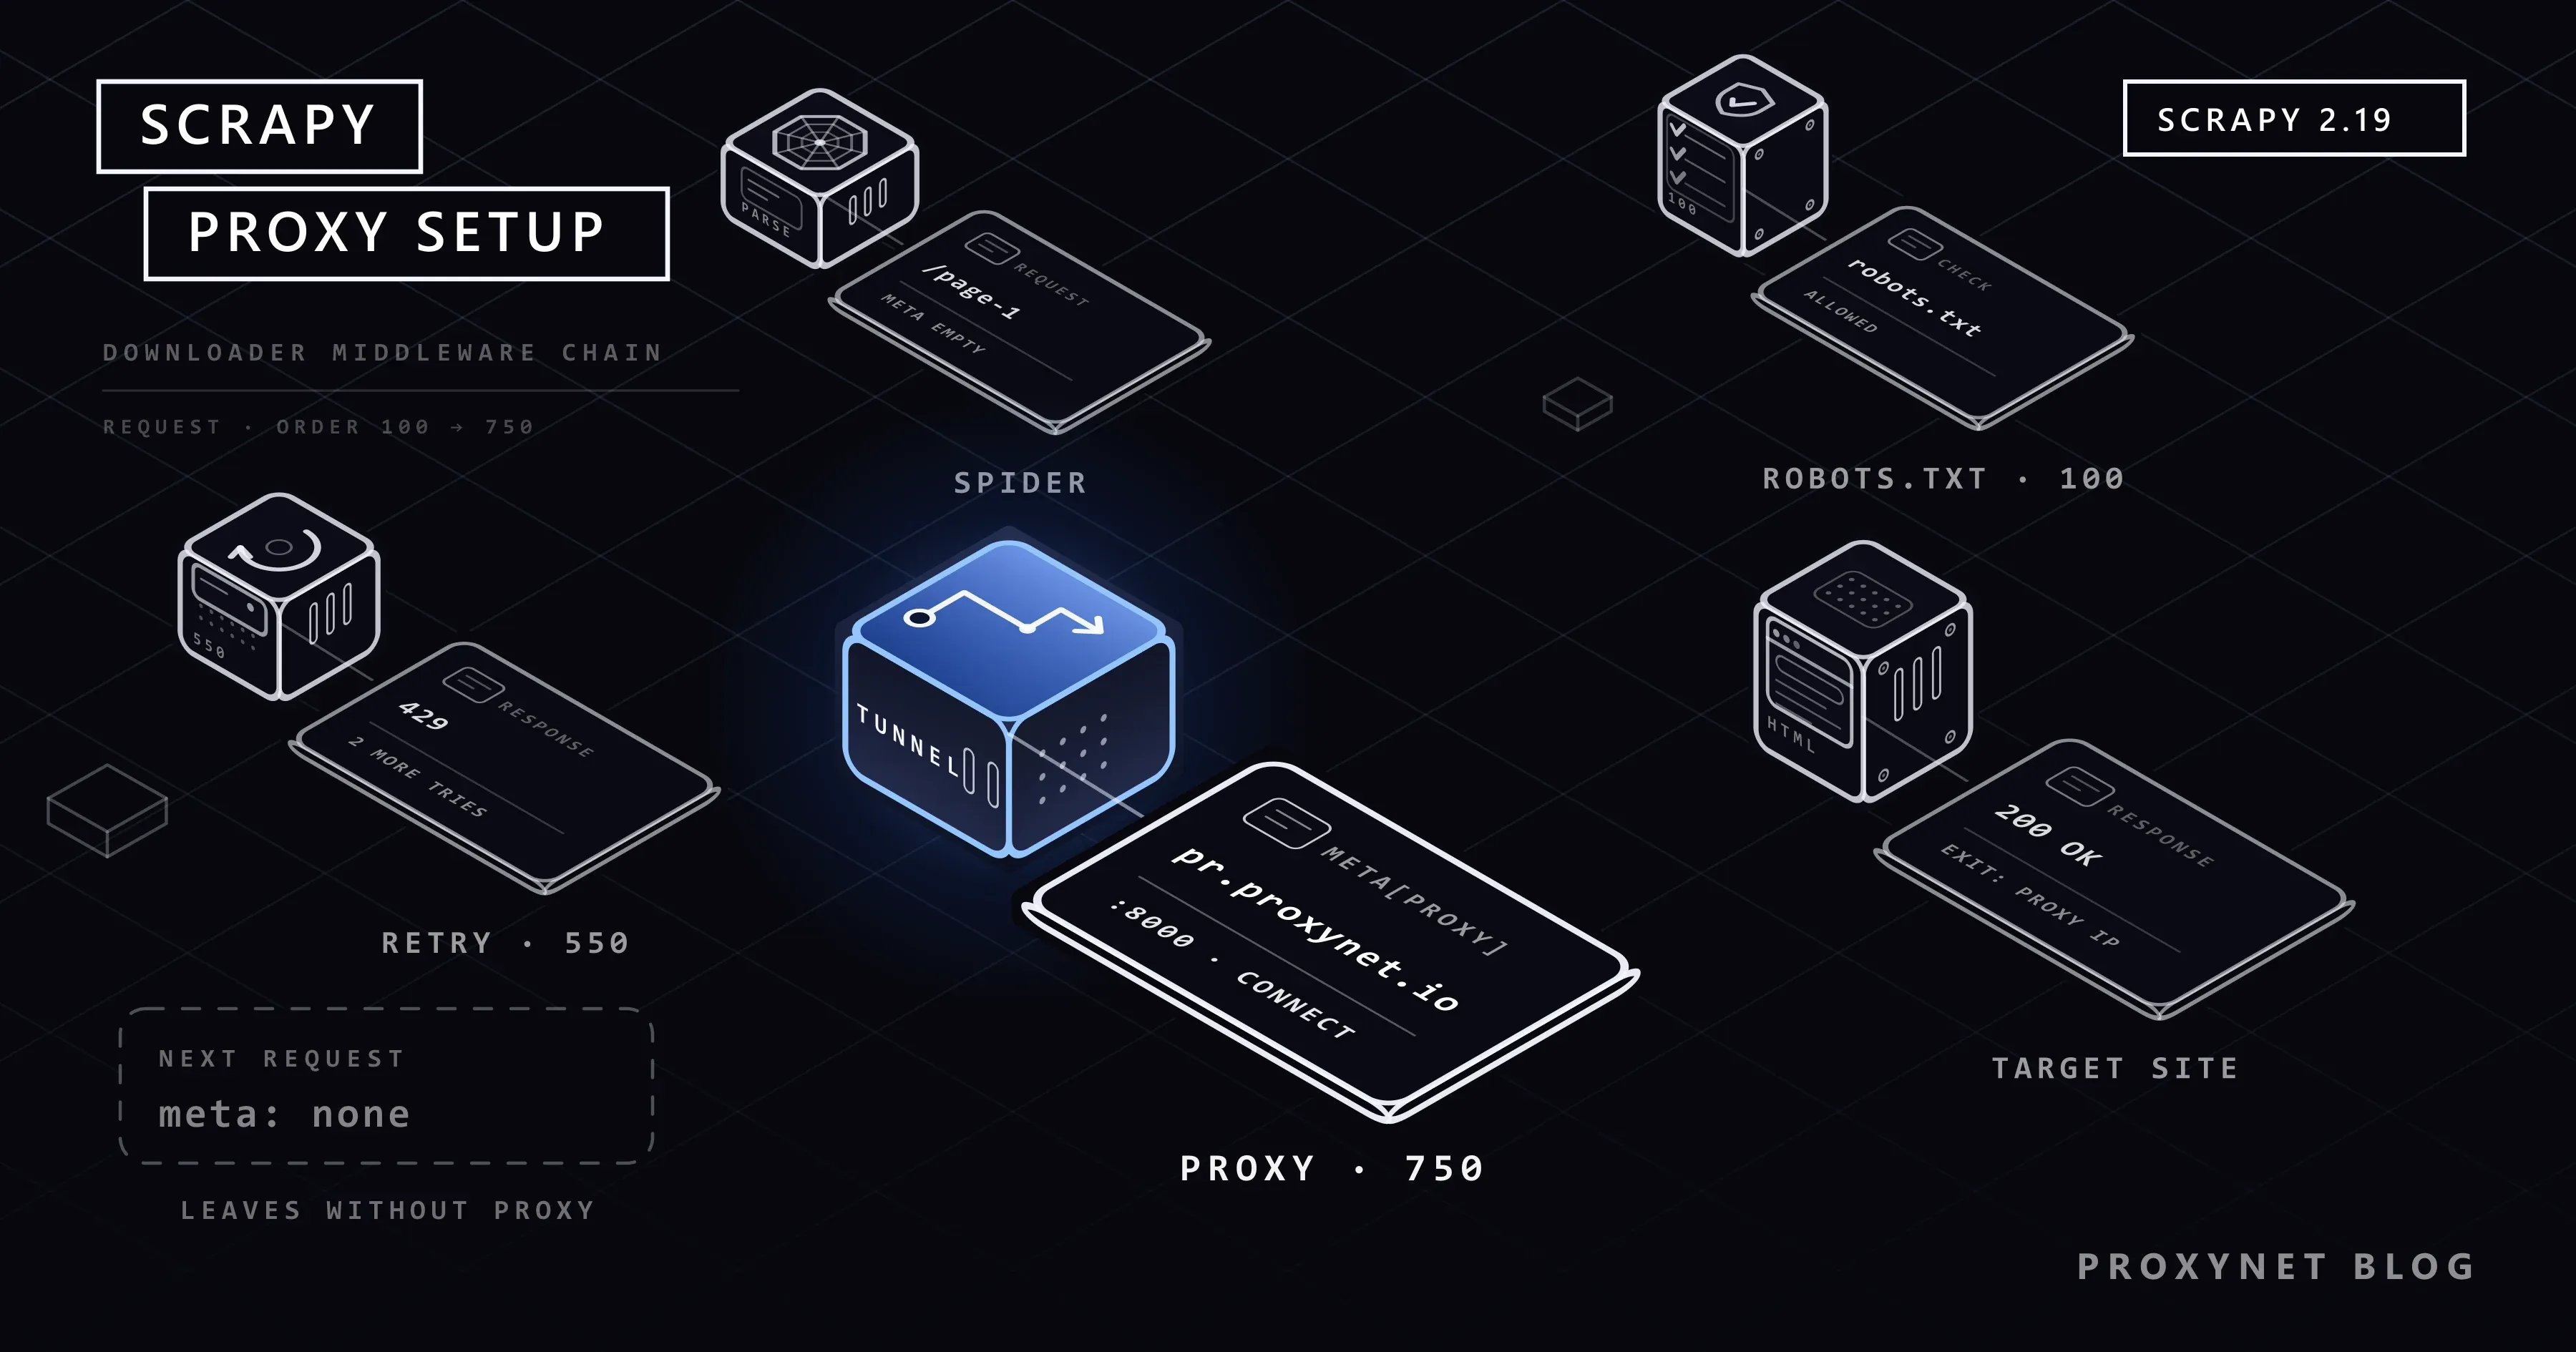
Scrapy چیست و چگونه با پروکسی استفاده میشود؟
در Scrapy پروکسی با فیلد meta درخواست یا با یک میانافزار تعریف میشود. نصب، احراز هویت، تنظیم AutoThrottle و چرخش IP را همراه با کد توضیح میدهیم.
نویسنده:Acar Diveroli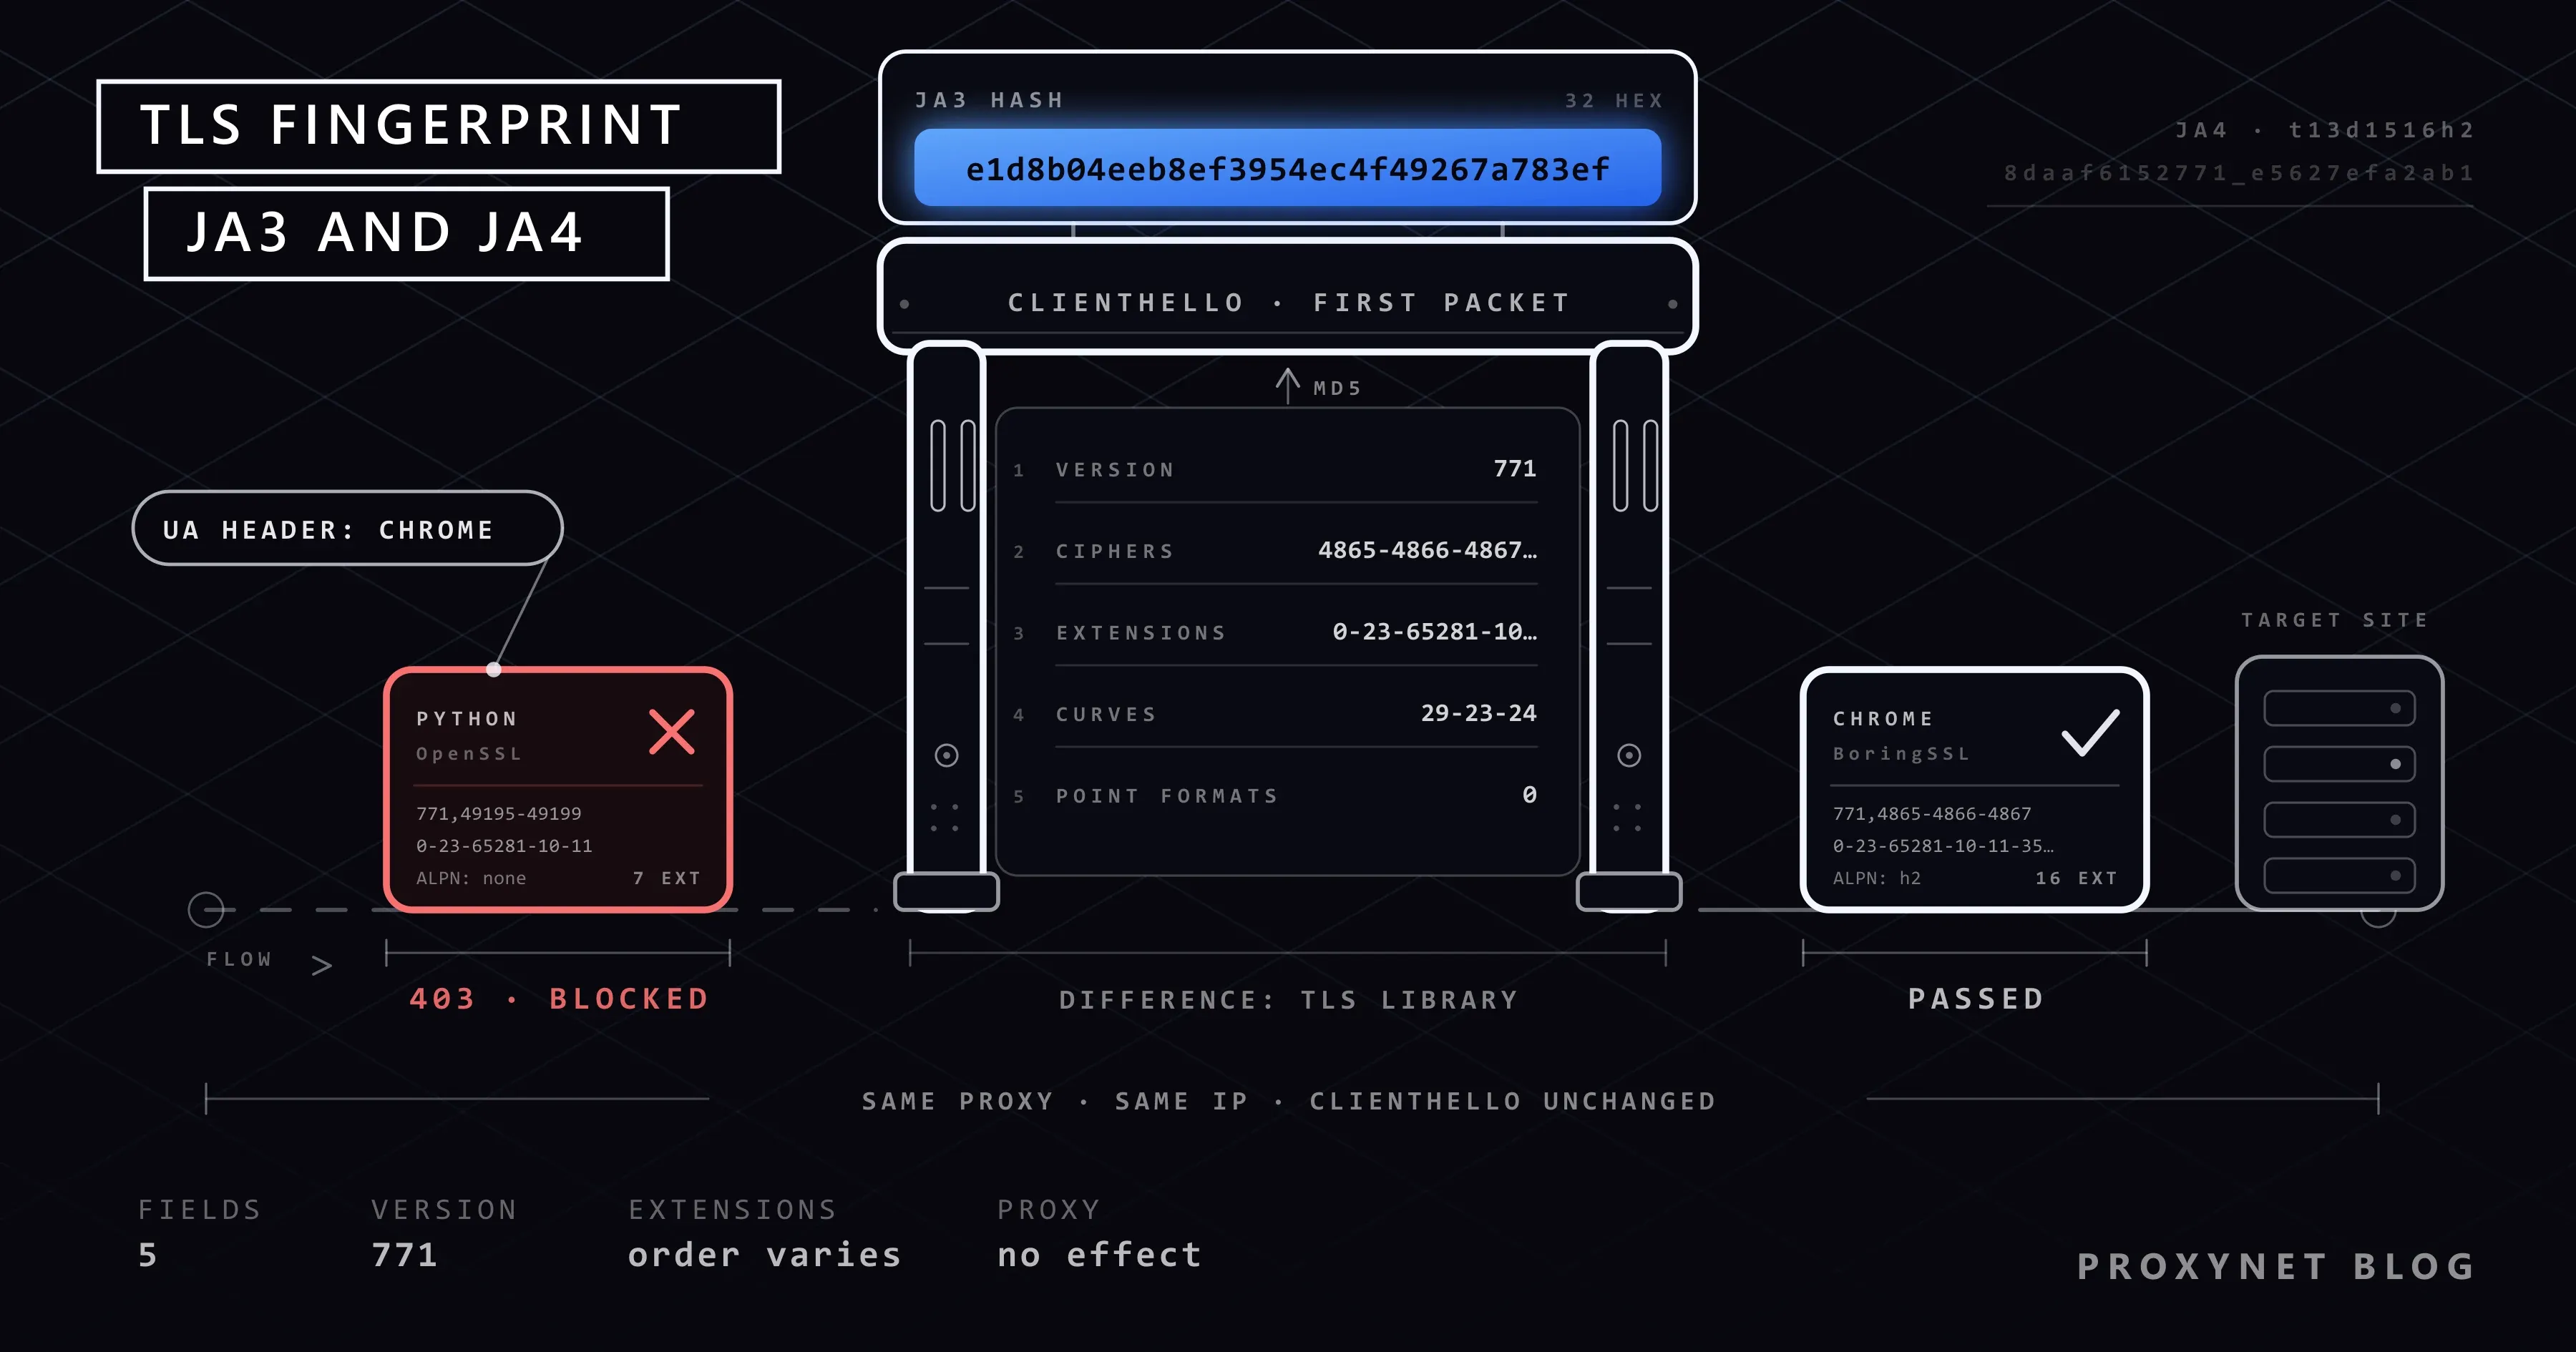
تاریخ انتشار
اثر انگشت TLS و JA3 چیست و چگونه کار میکند؟
اثر انگشت TLS شناسهای است که از فهرست رمزها و افزونههای پیام ClientHello ساخته میشود؛ محاسبه JA3 و JA4 و نقش پروکسی را توضیح میدهیم.
نویسنده:Acar Diveroli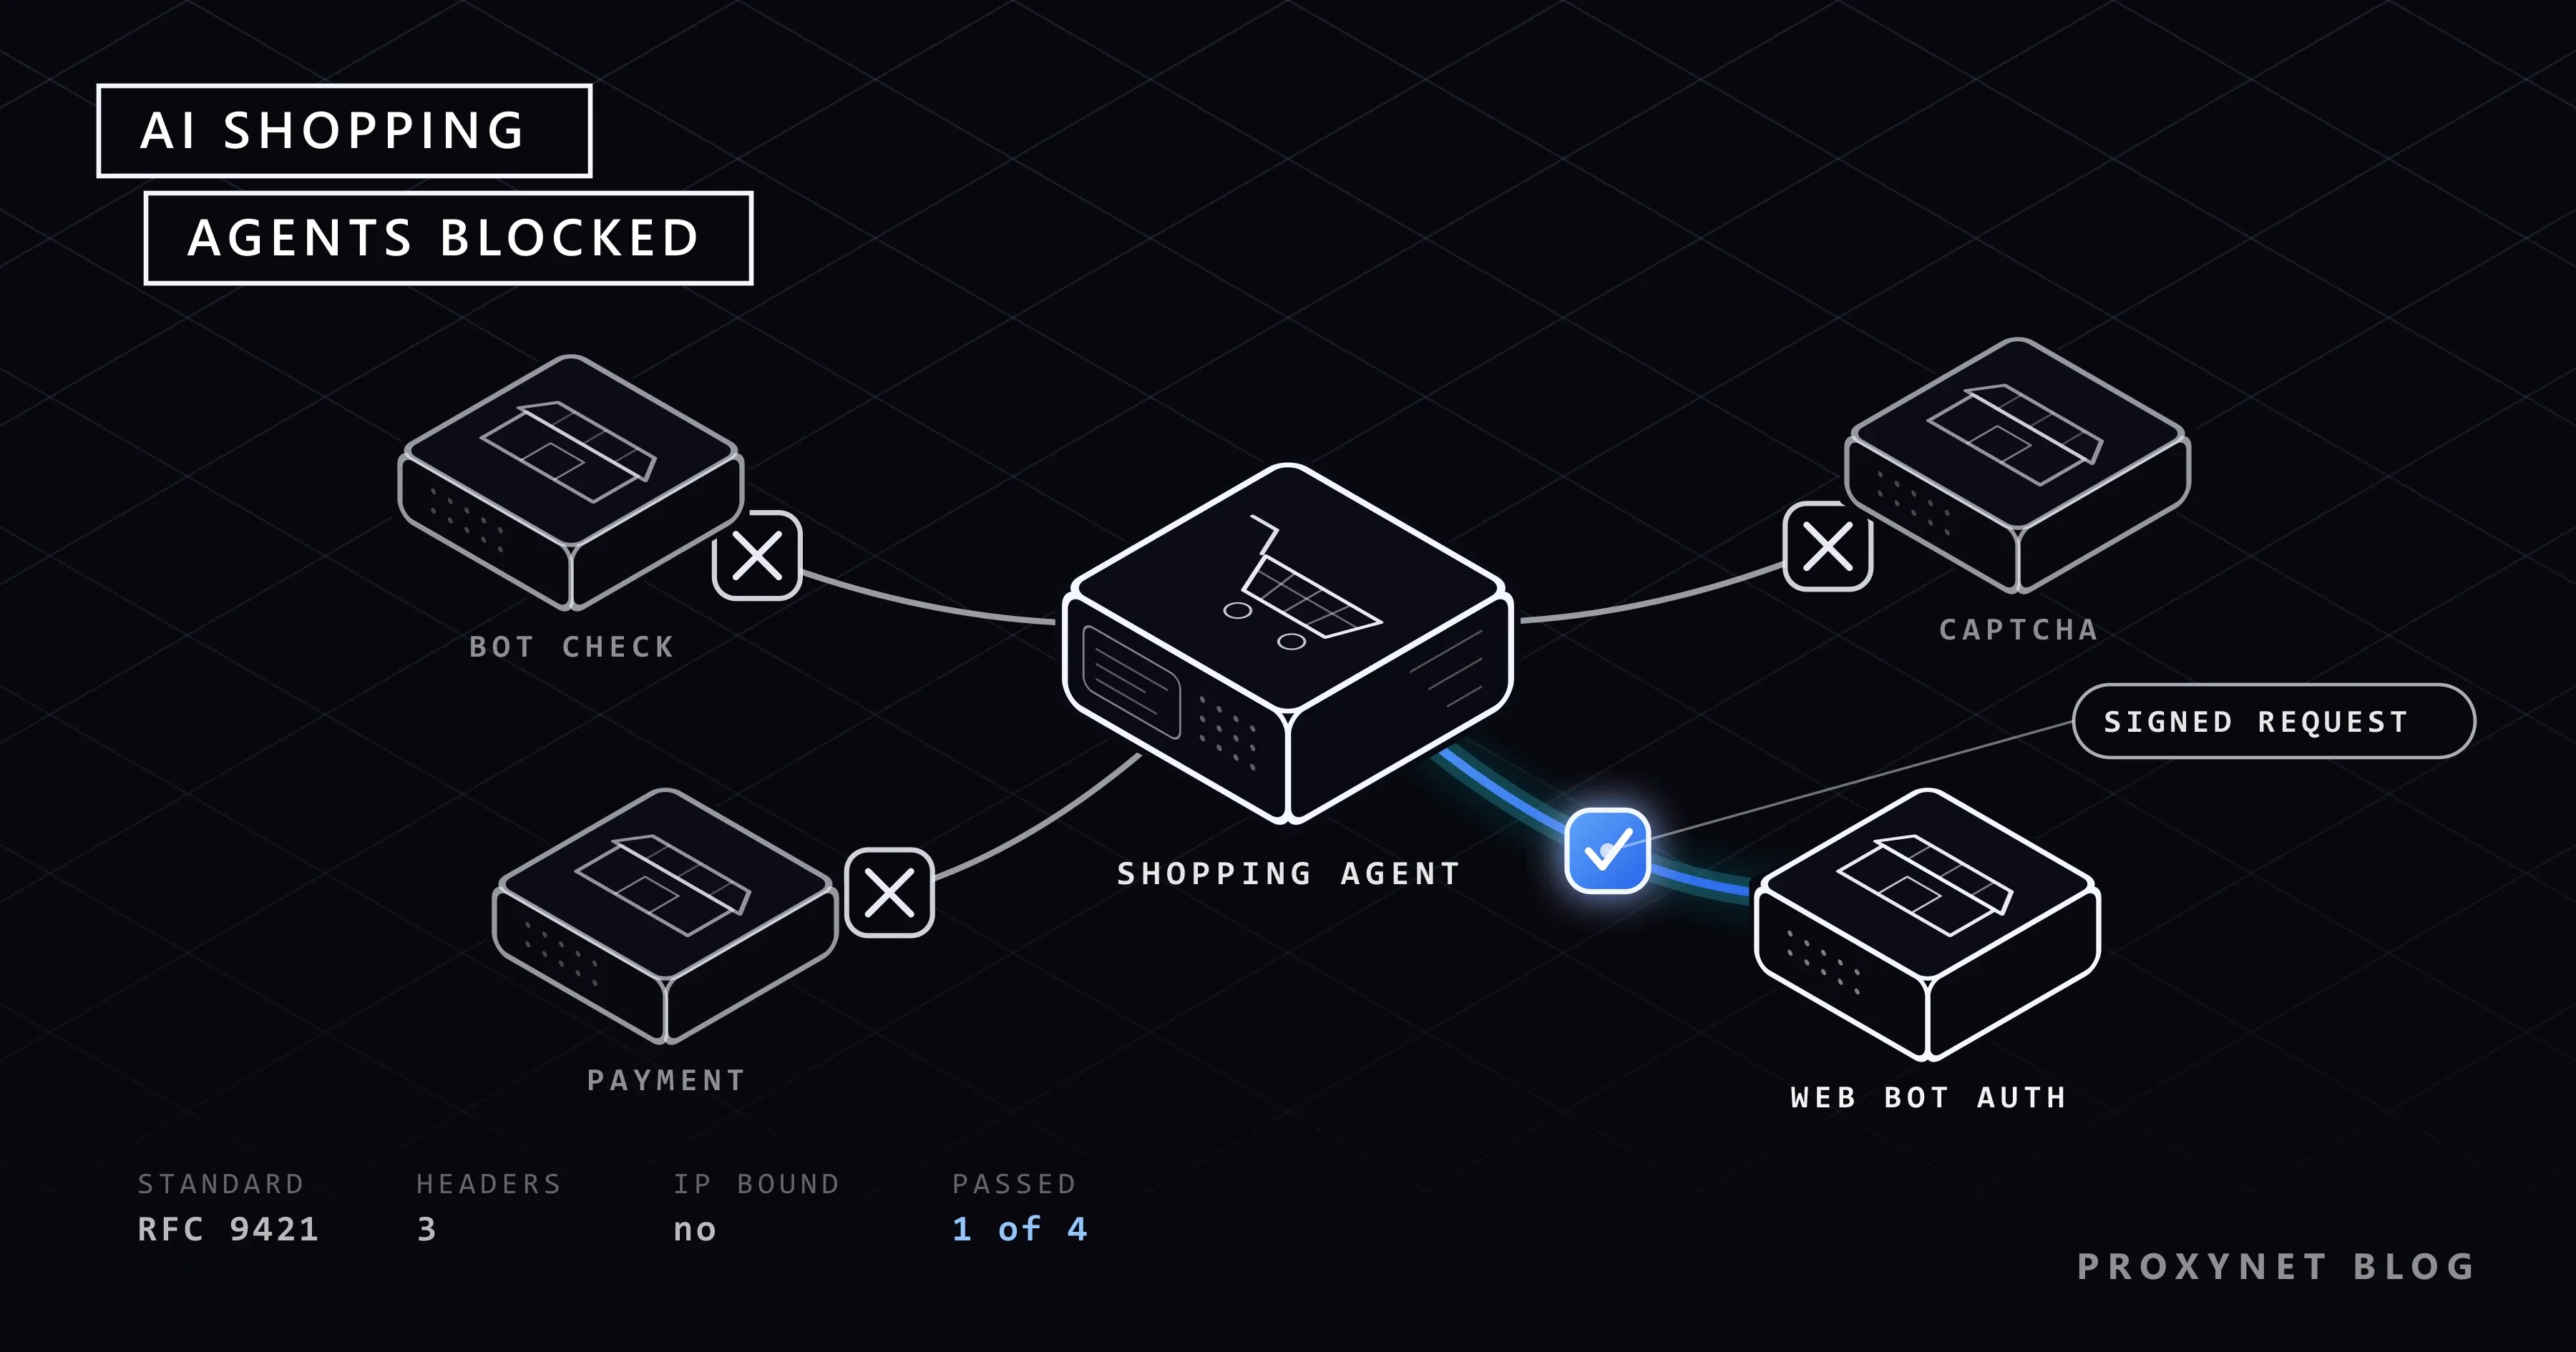
تاریخ انتشار
چرا سایتها عاملهای خرید هوش مصنوعی را مسدود میکنند؟
عاملهای خرید به محافظت ربات برمیخورند چون سایت نمیتواند انسان را از عامل مجاز تشخیص دهد. علت و راهحلهای تازه مانند عامل امضاشده را توضیح میدهیم.
نویسنده:Acar Diveroli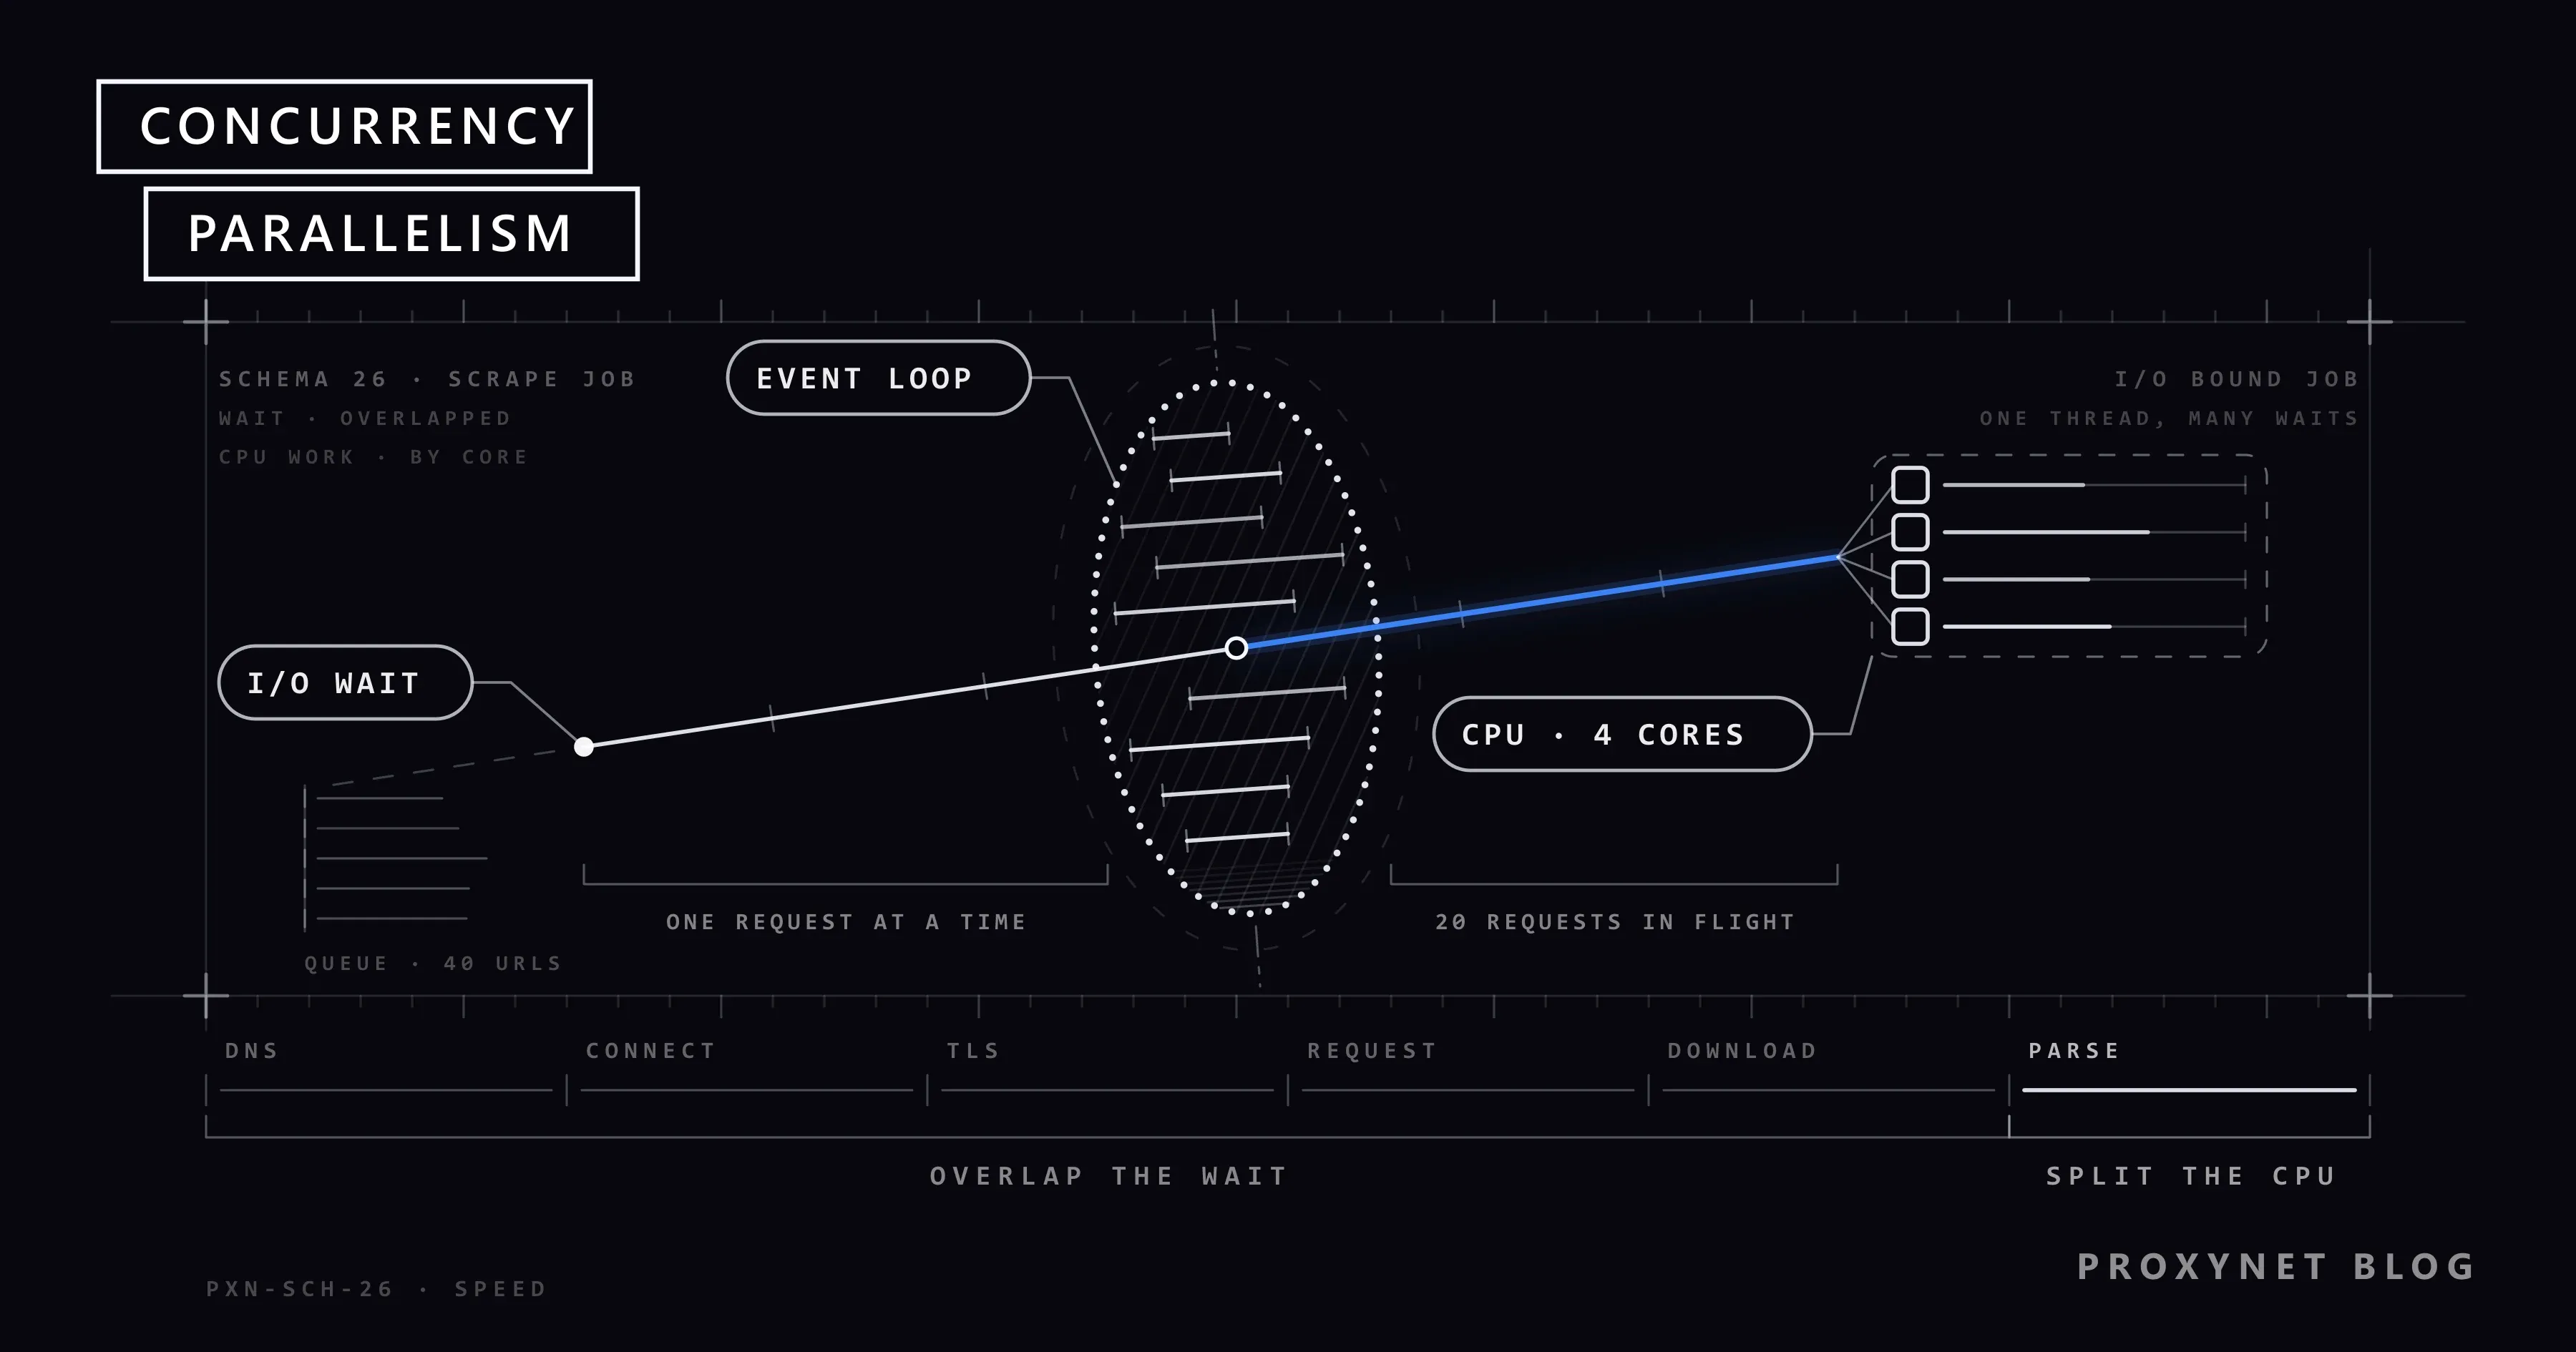
تاریخ انتشار
همروندی و موازیسازی در وب اسکرپینگ
همروندی از زمان انتظار و موازیسازی از توان پردازنده بهره میگیرد. توضیح میدهیم کدام سرعت اسکرپینگ را بالا میبرد، با نمونههایی در پایتون و Node.js.
نویسنده:Acar Diveroli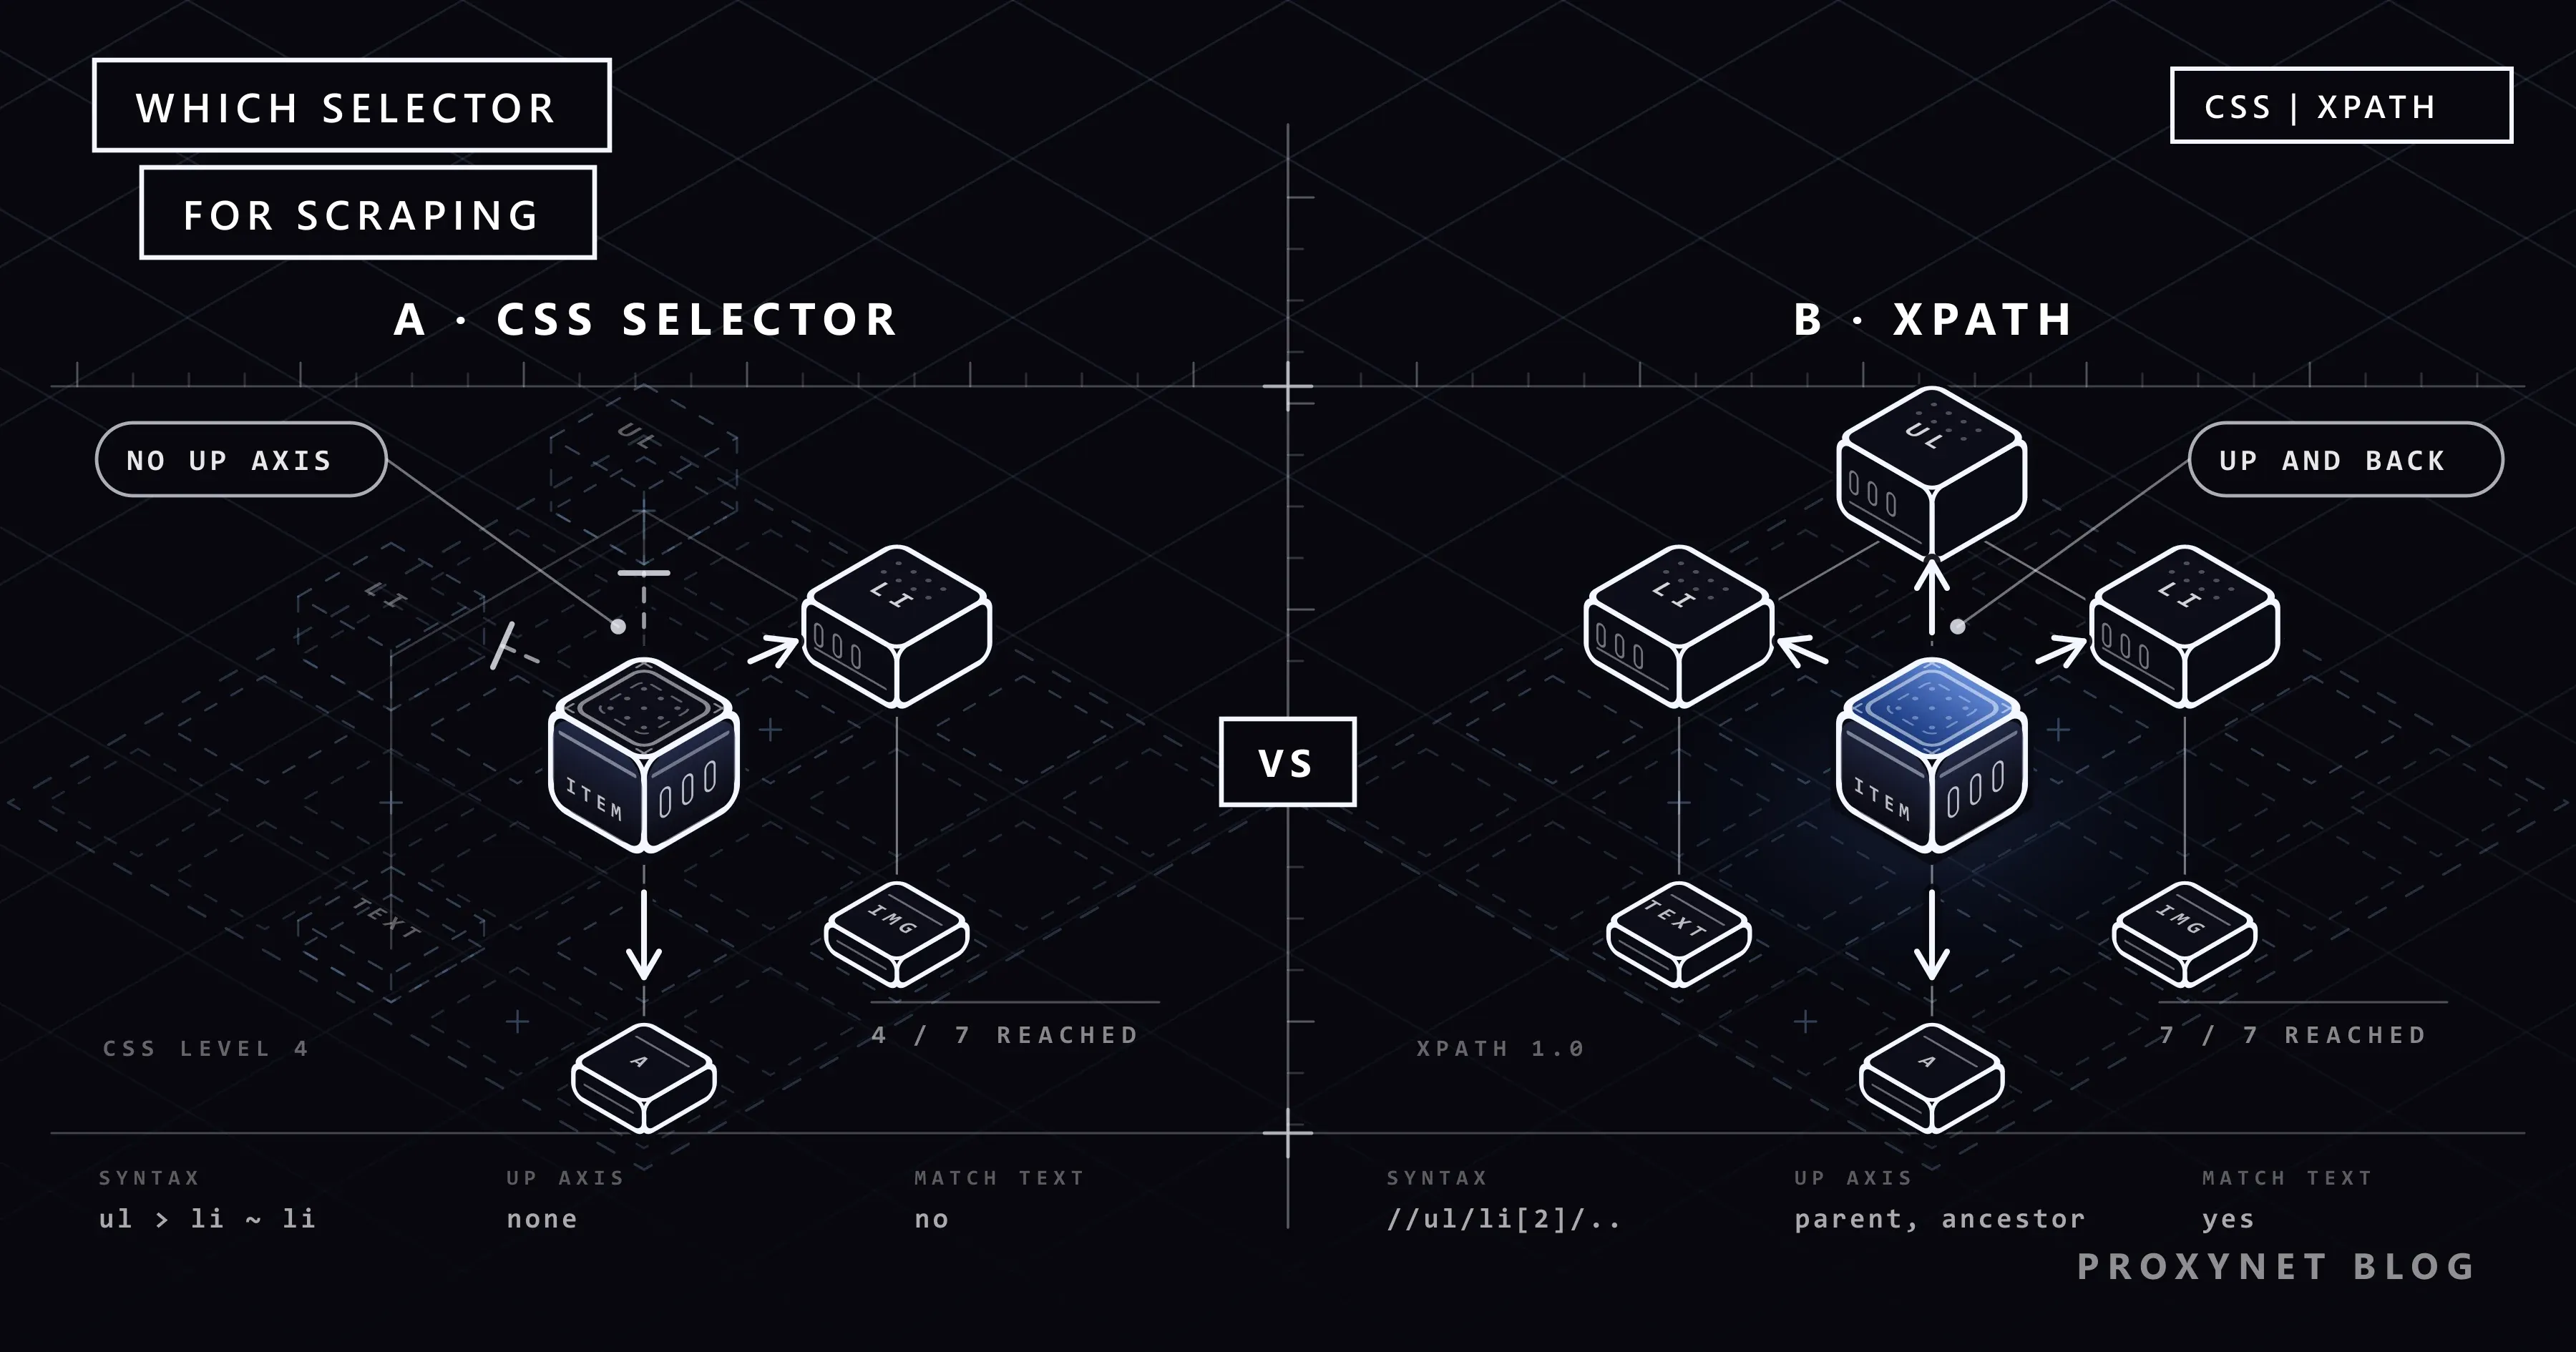
تاریخ انتشار
انتخابگر CSS یا XPath: کدام برای اسکرپینگ؟
انتخابگر CSS کوتاه و خواناست و XPath میتواند بر اساس متن و عنصر والد هم انتخاب کند. نحو، سرعت و نمونههای پایتون هر دو روش را مقایسه میکنیم.
نویسنده:Acar Diveroli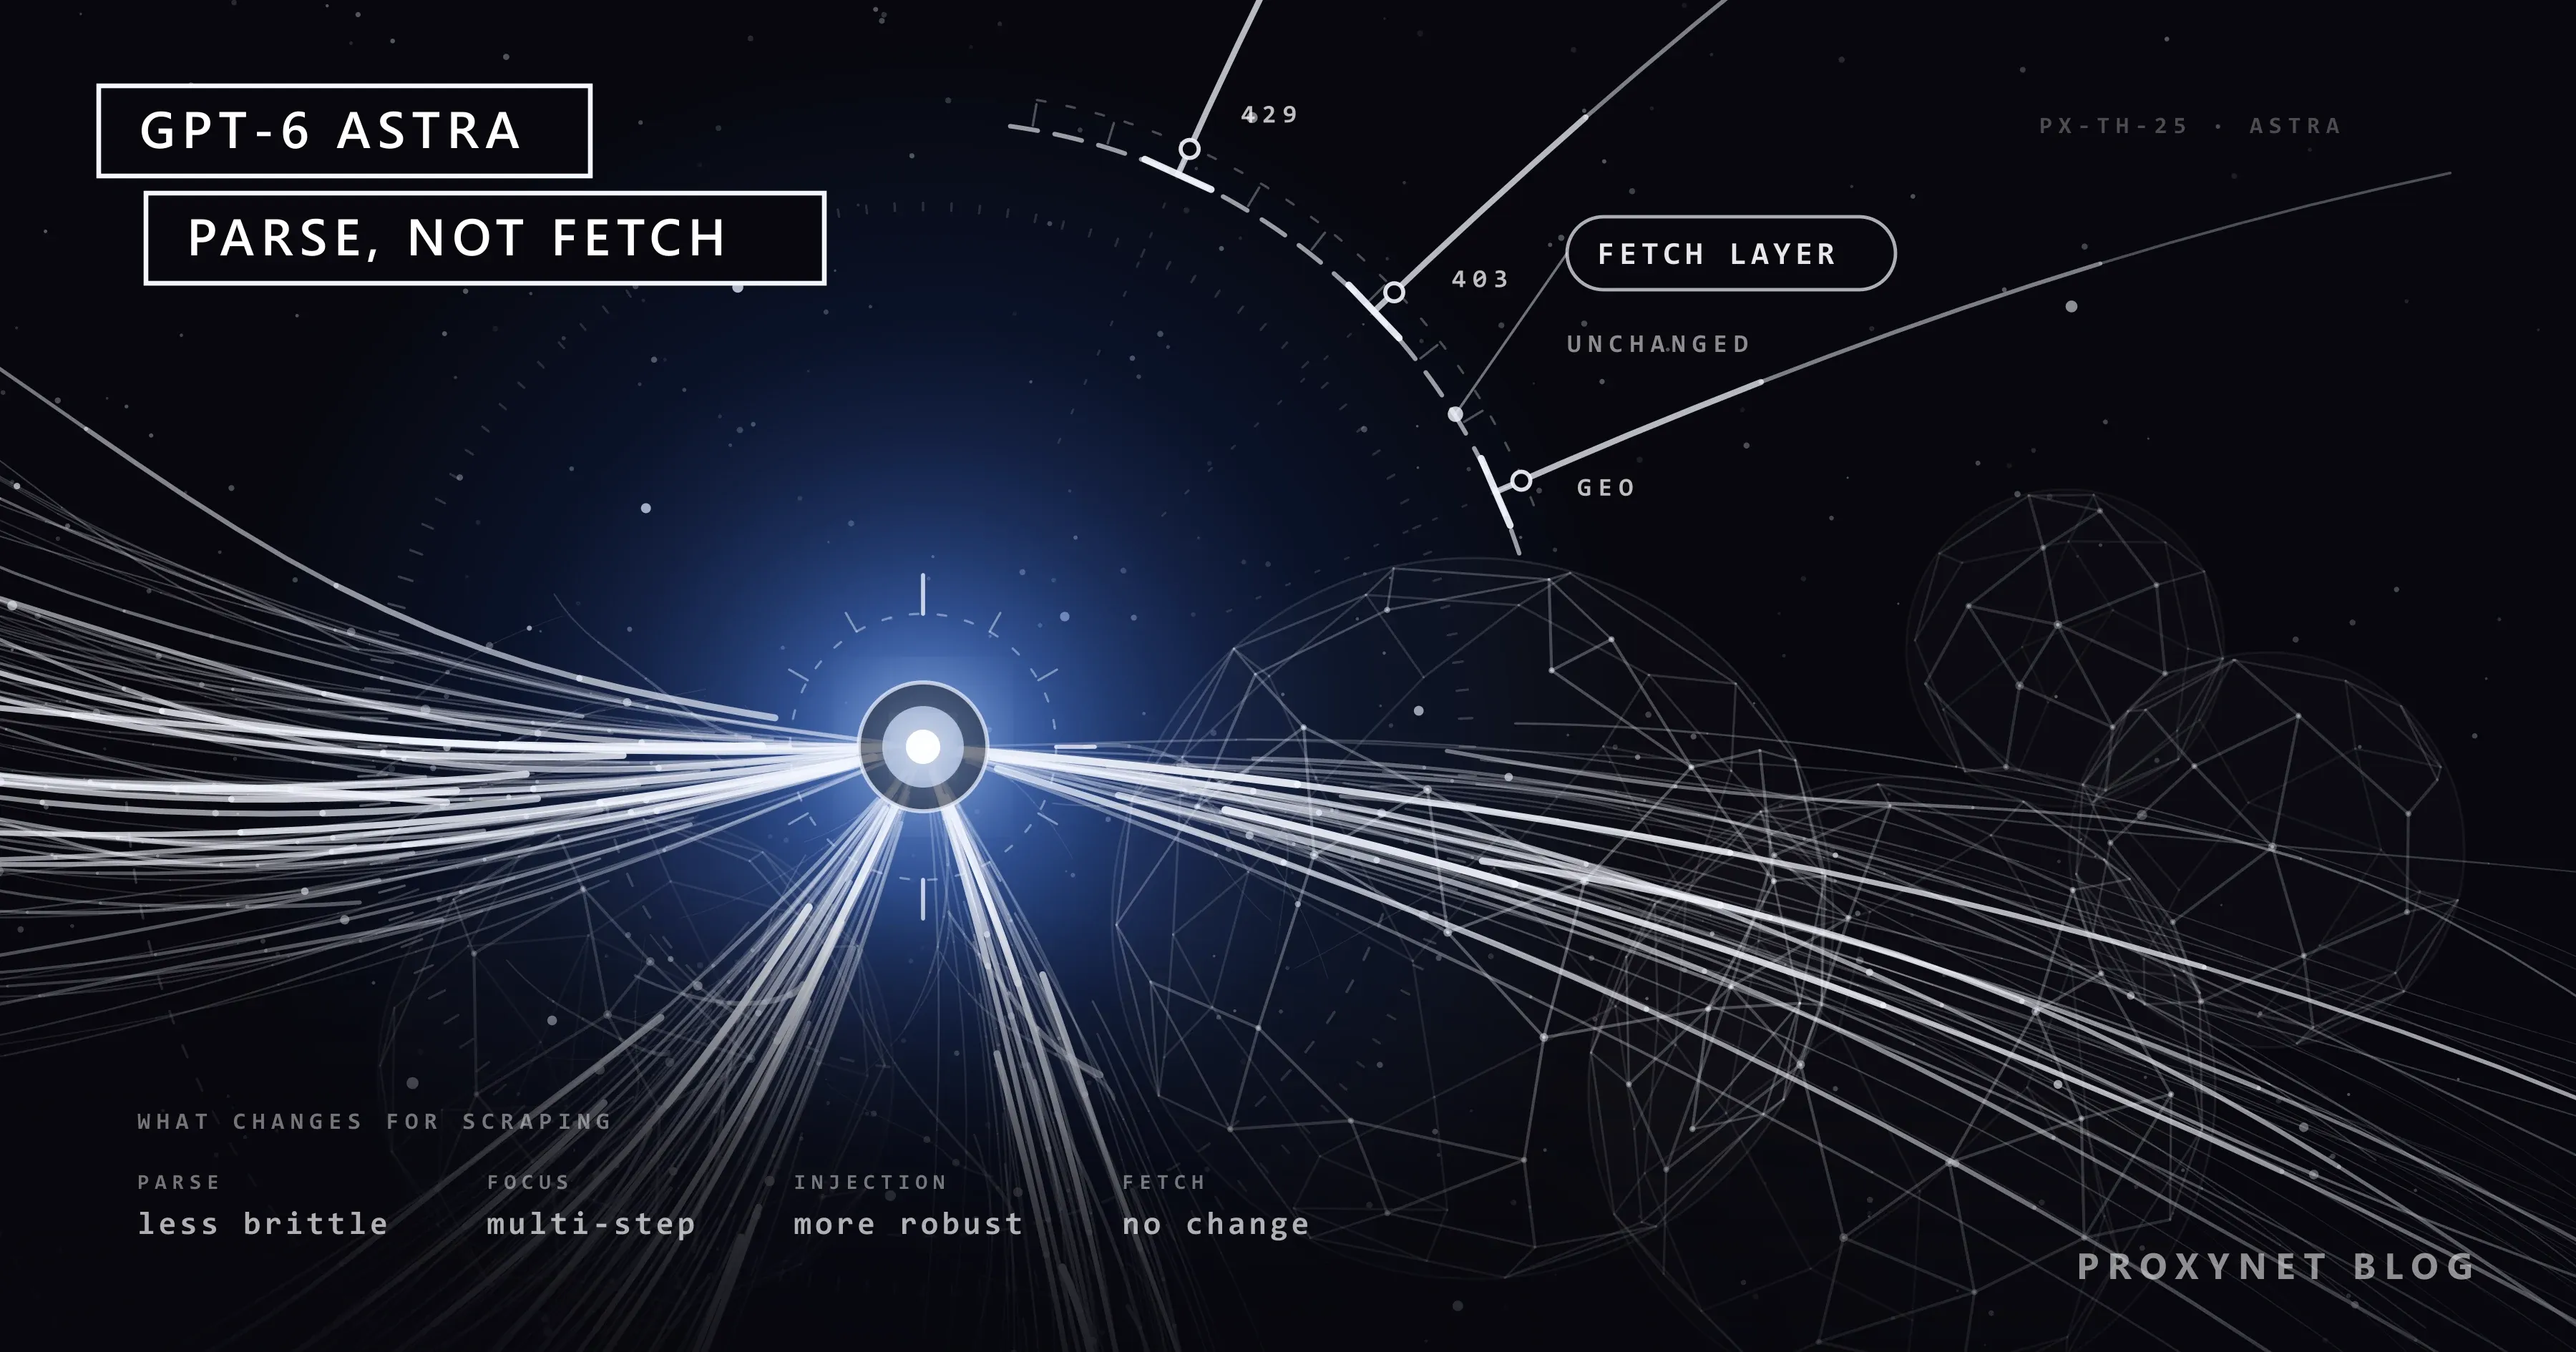
تاریخ انتشار
اسکرپینگ وب با GPT-6 Astra: چه چیزی تغییر کرد؟
GPT-6 Astra خواندن صفحه و مدیریت مرورگر را قویتر میکند، اما مسدودسازی، CAPTCHA و محدودیت درخواست را حل نمیکند؛ جای واقعی مدل را نشان میدهیم.
نویسنده:Acar Diveroli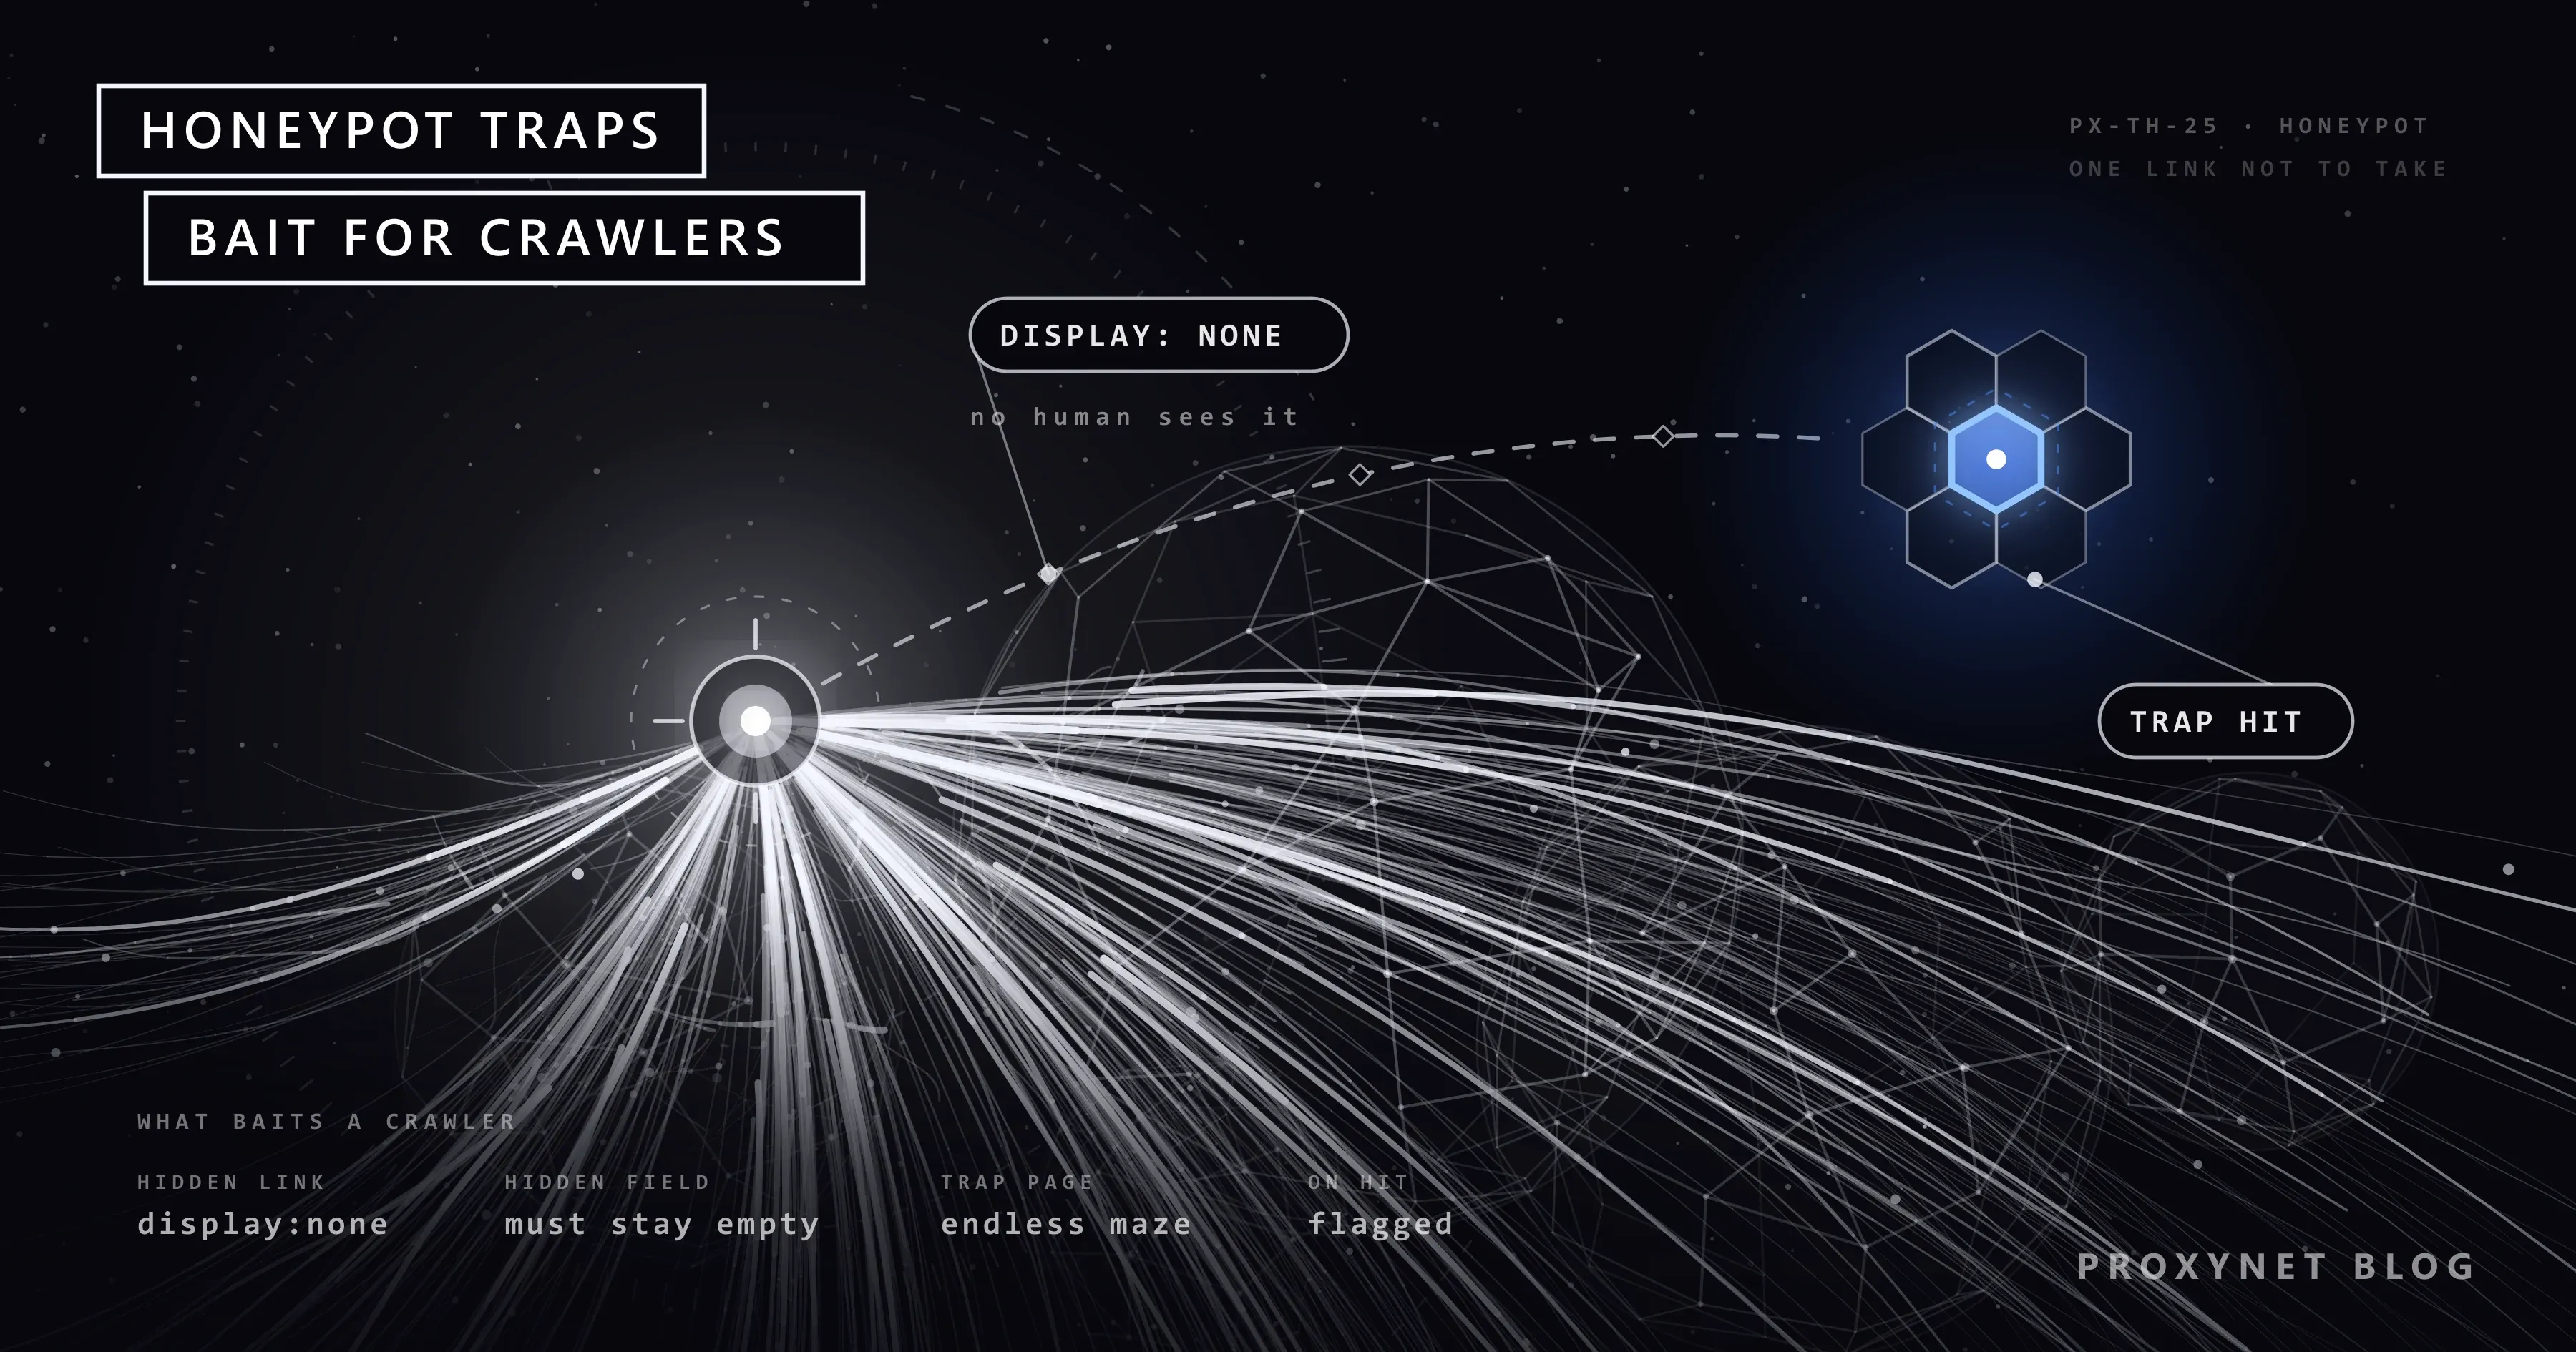
تاریخ انتشار
تلههای هانیپات چیست و چه اثری بر اسکرپینگ دارد؟
هانیپات پیوند پنهانی است که بازدیدکنندگان نمیبینند اما رباتها در آن گیر میافتند. سازوکار آن را بدون آموزش دور زدن توضیح میدهیم.
نویسنده:Acar Diveroli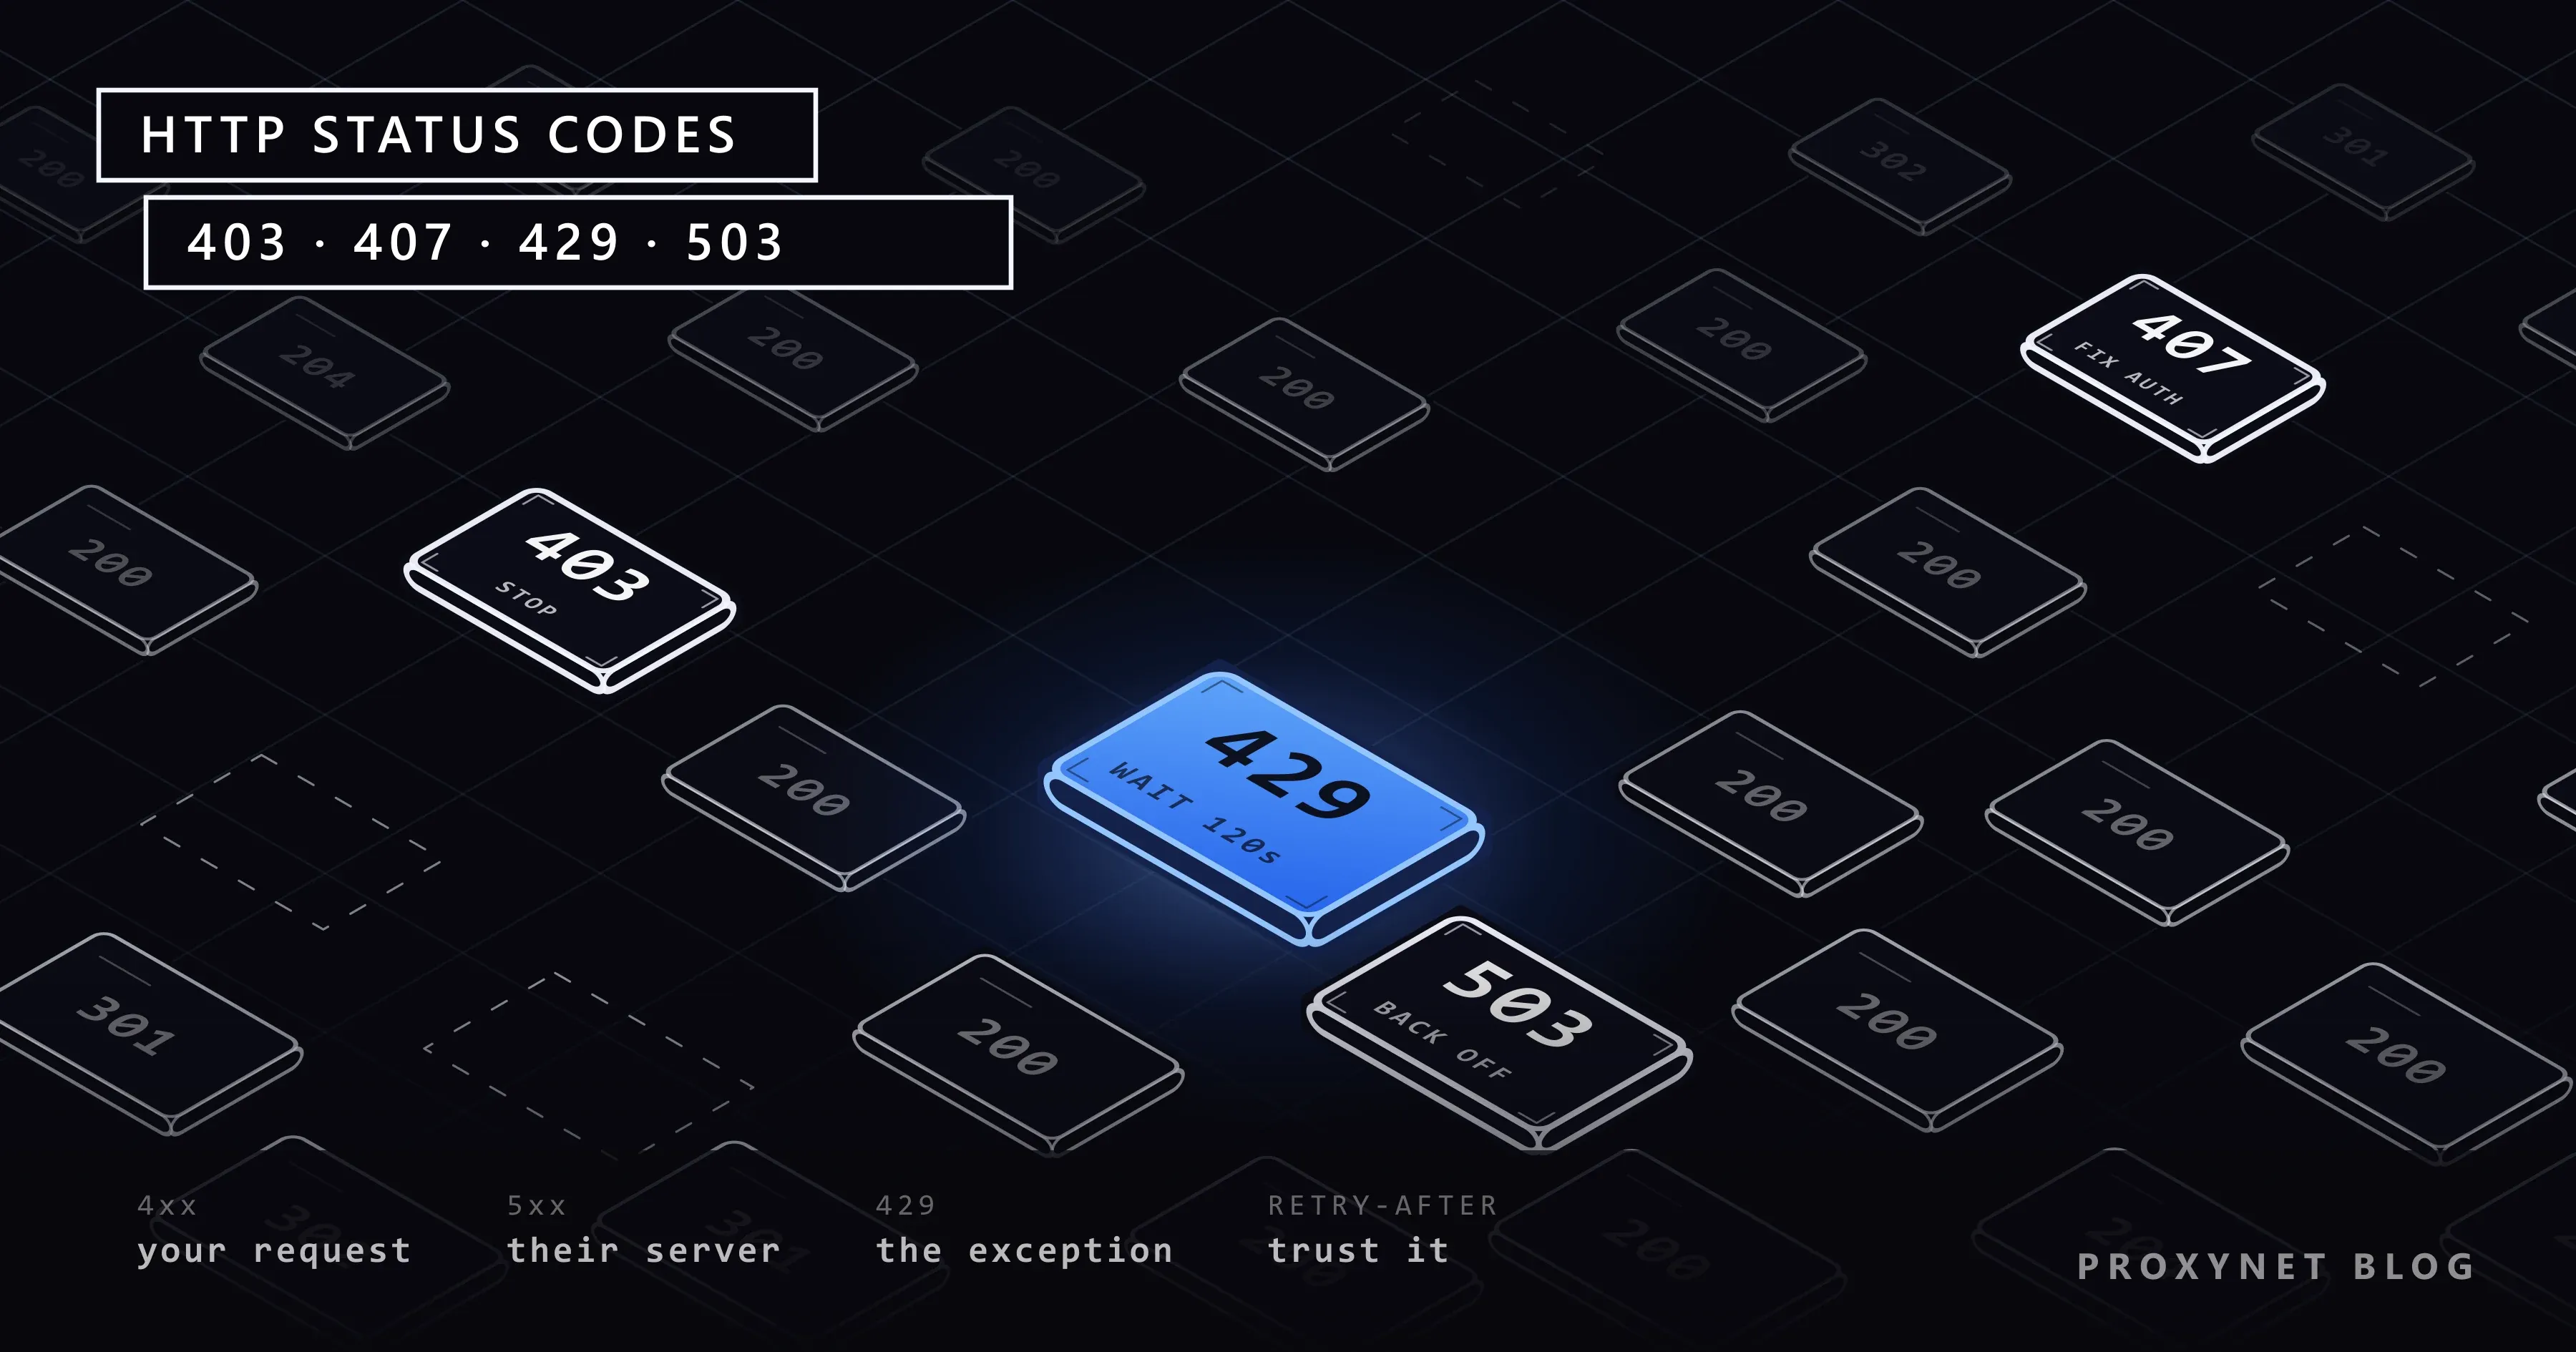
تاریخ انتشار
کدهای وضعیت HTTP در وب اسکرپینگ: 403، 407، 429، 503
پاسخهای 403، 407، 429 و 503 در اسکرپینگ به مشکلات متفاوتی اشاره دارند. معنا و علت هر کد و شیوه درست تلاش دوباره با Retry-After را توضیح میدهیم.
نویسنده:Acar Diveroli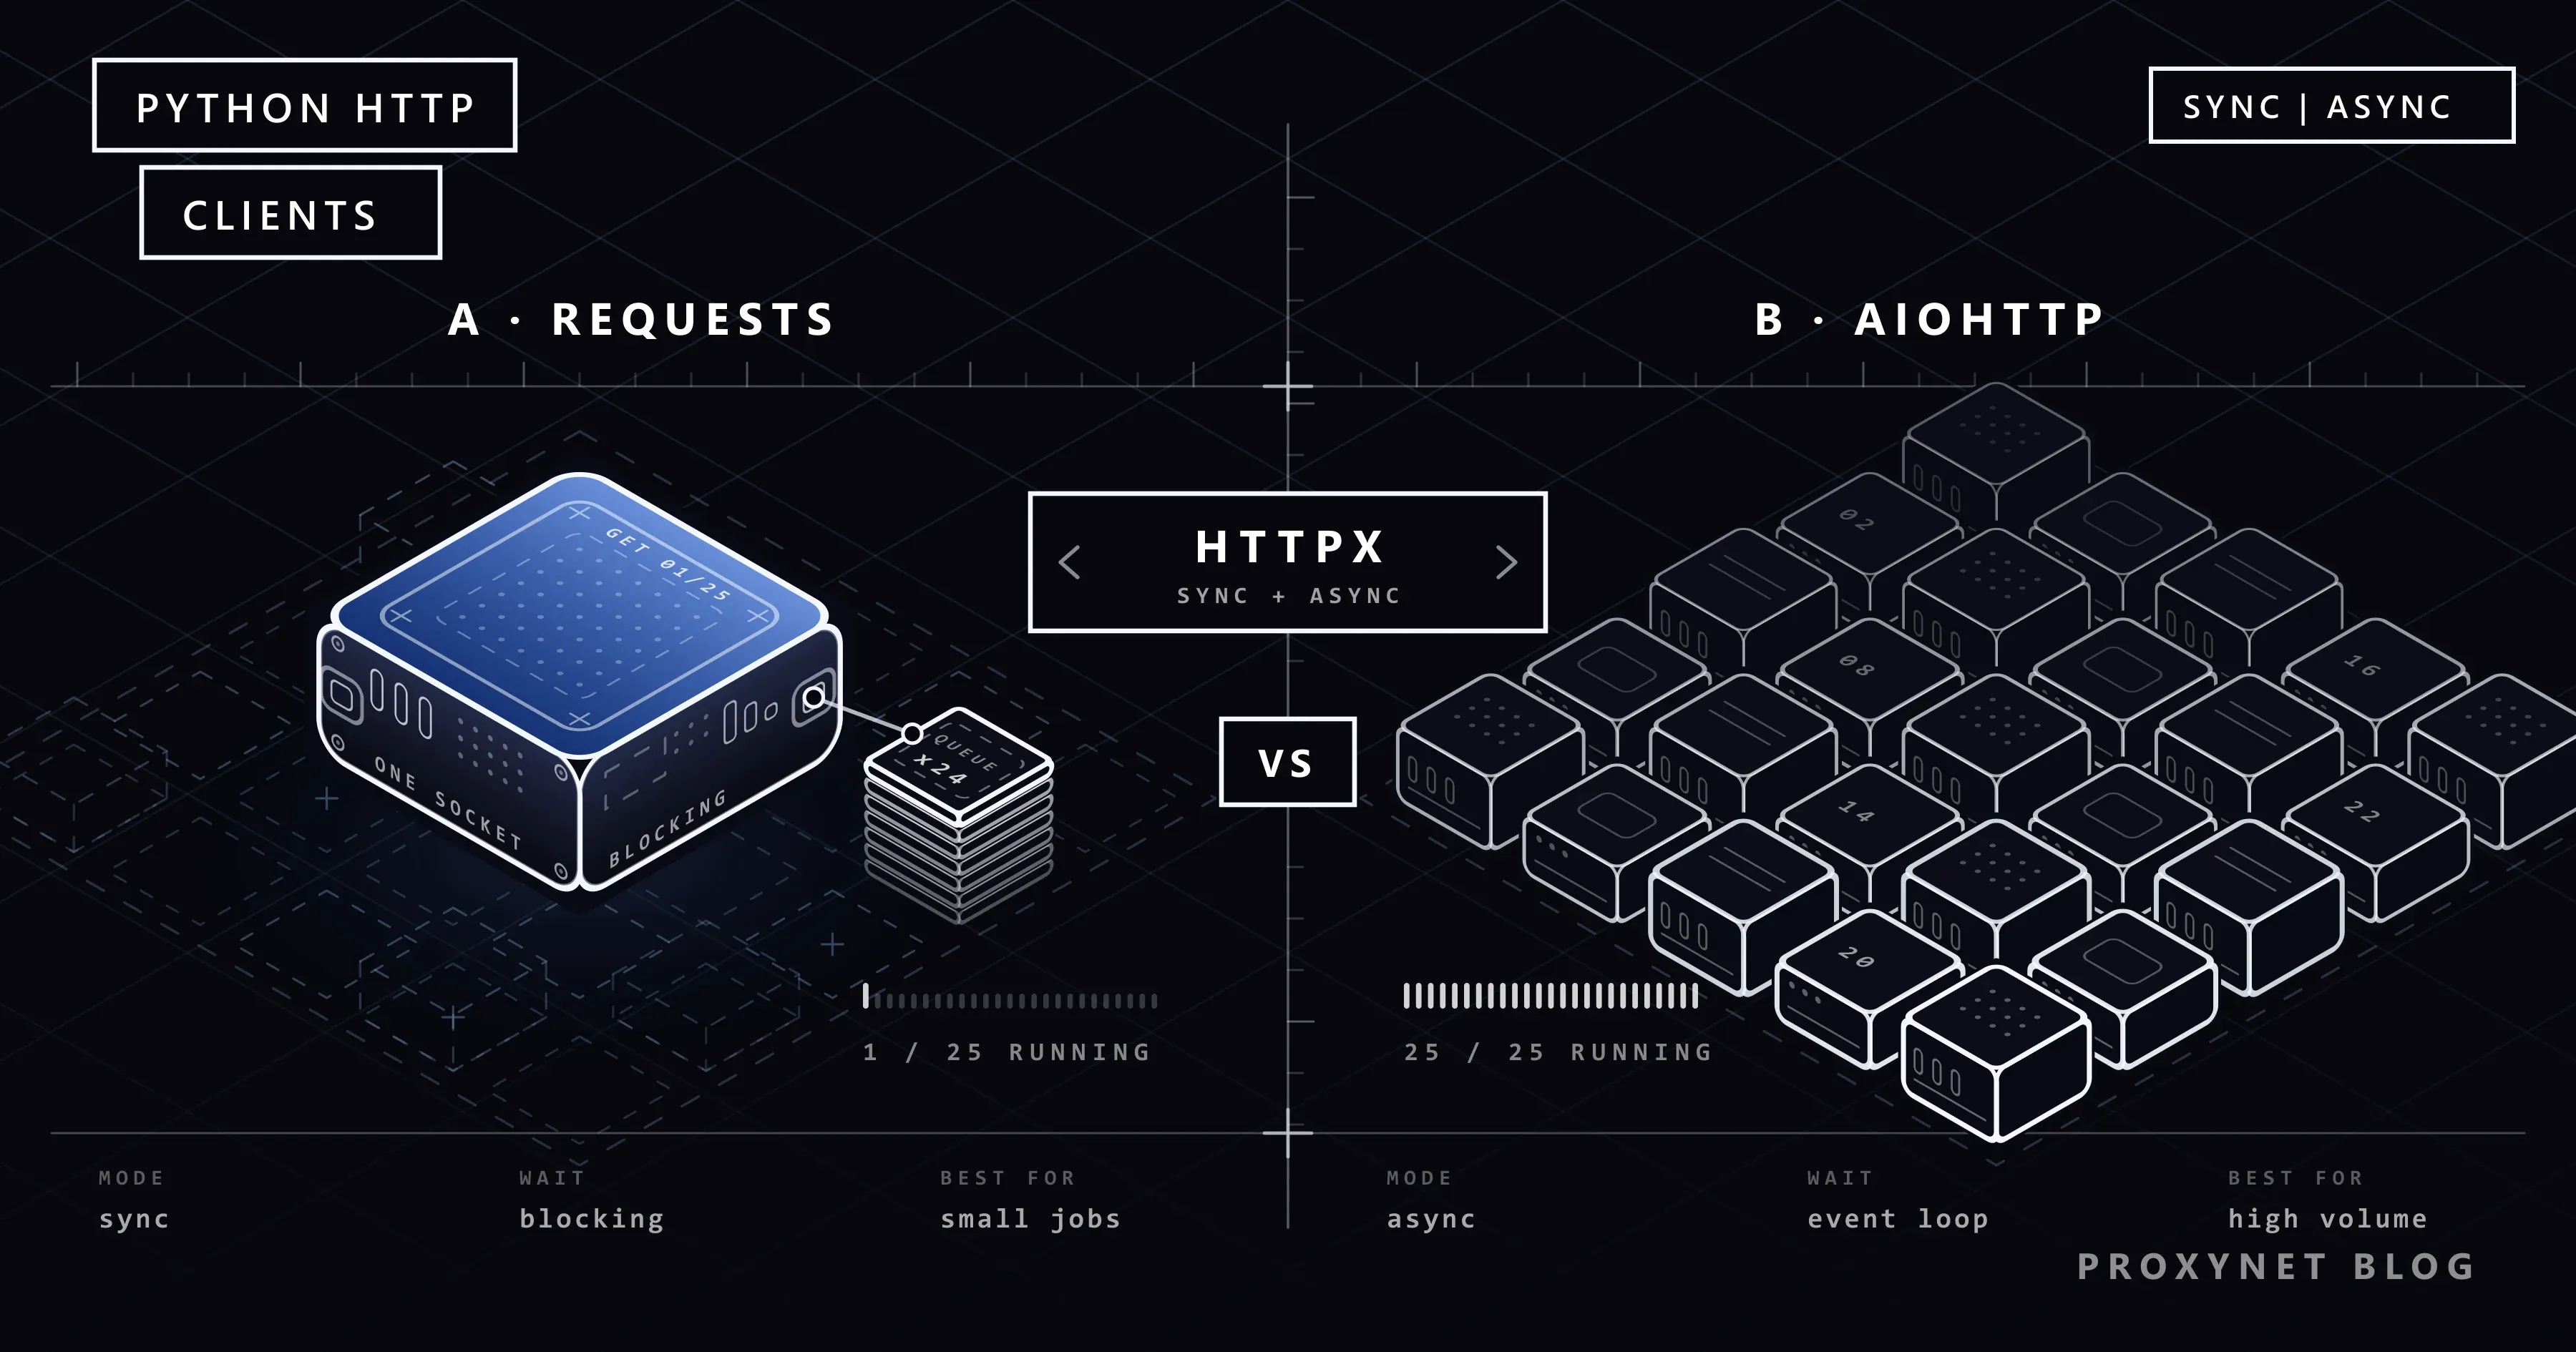
تاریخ انتشار
مقایسه HTTPX، Requests و AIOHTTP
Requests ساده و همگام است، AIOHTTP ناهمگام است و HTTPX هر دو حالت را دارد. استفاده از پروکسی، کارایی و انتخاب مناسب برای هر پروژه را با کد نشان میدهیم.
نویسنده:Acar Diveroli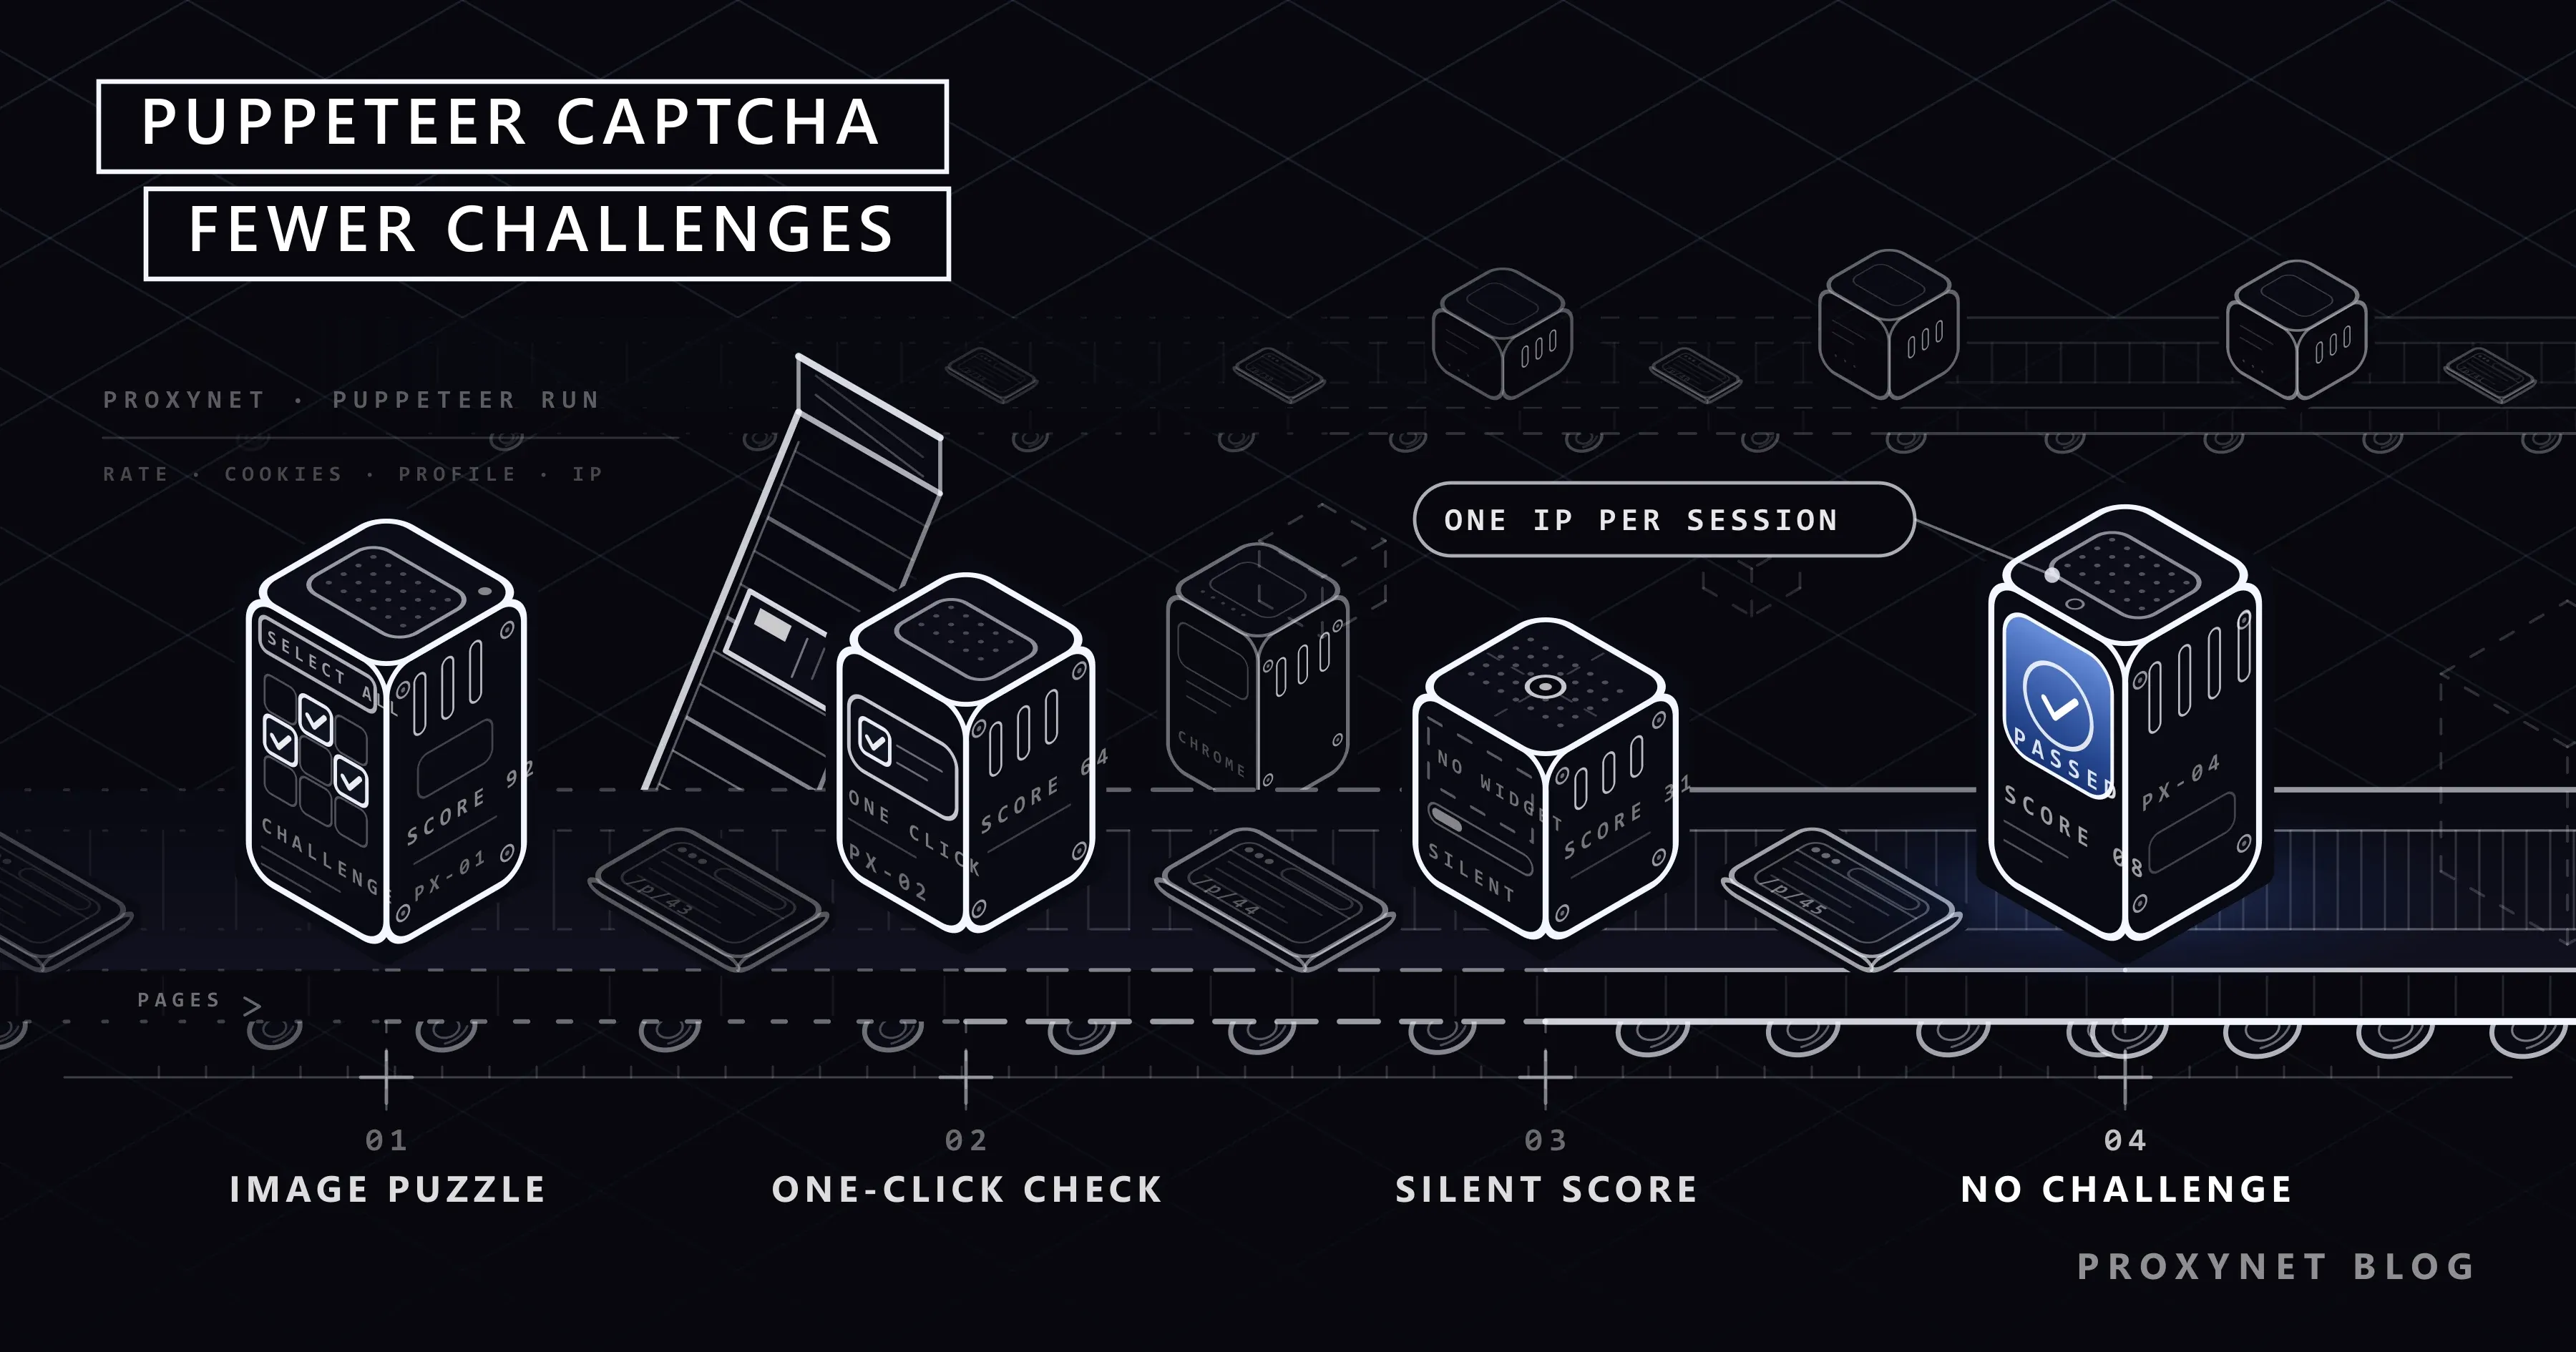
تاریخ انتشار
Puppeteer و CAPTCHA: چرا ظاهر میشود و چگونه کم میشود؟
در Puppeteer کپچا اغلب به دلیل اعتبار IP، سرعت درخواستها و ردپای مرورگر بدون رابط فعال میشود. علتها و راههای مشروع کاهش آن را توضیح میدهیم.
نویسنده:Acar Diveroli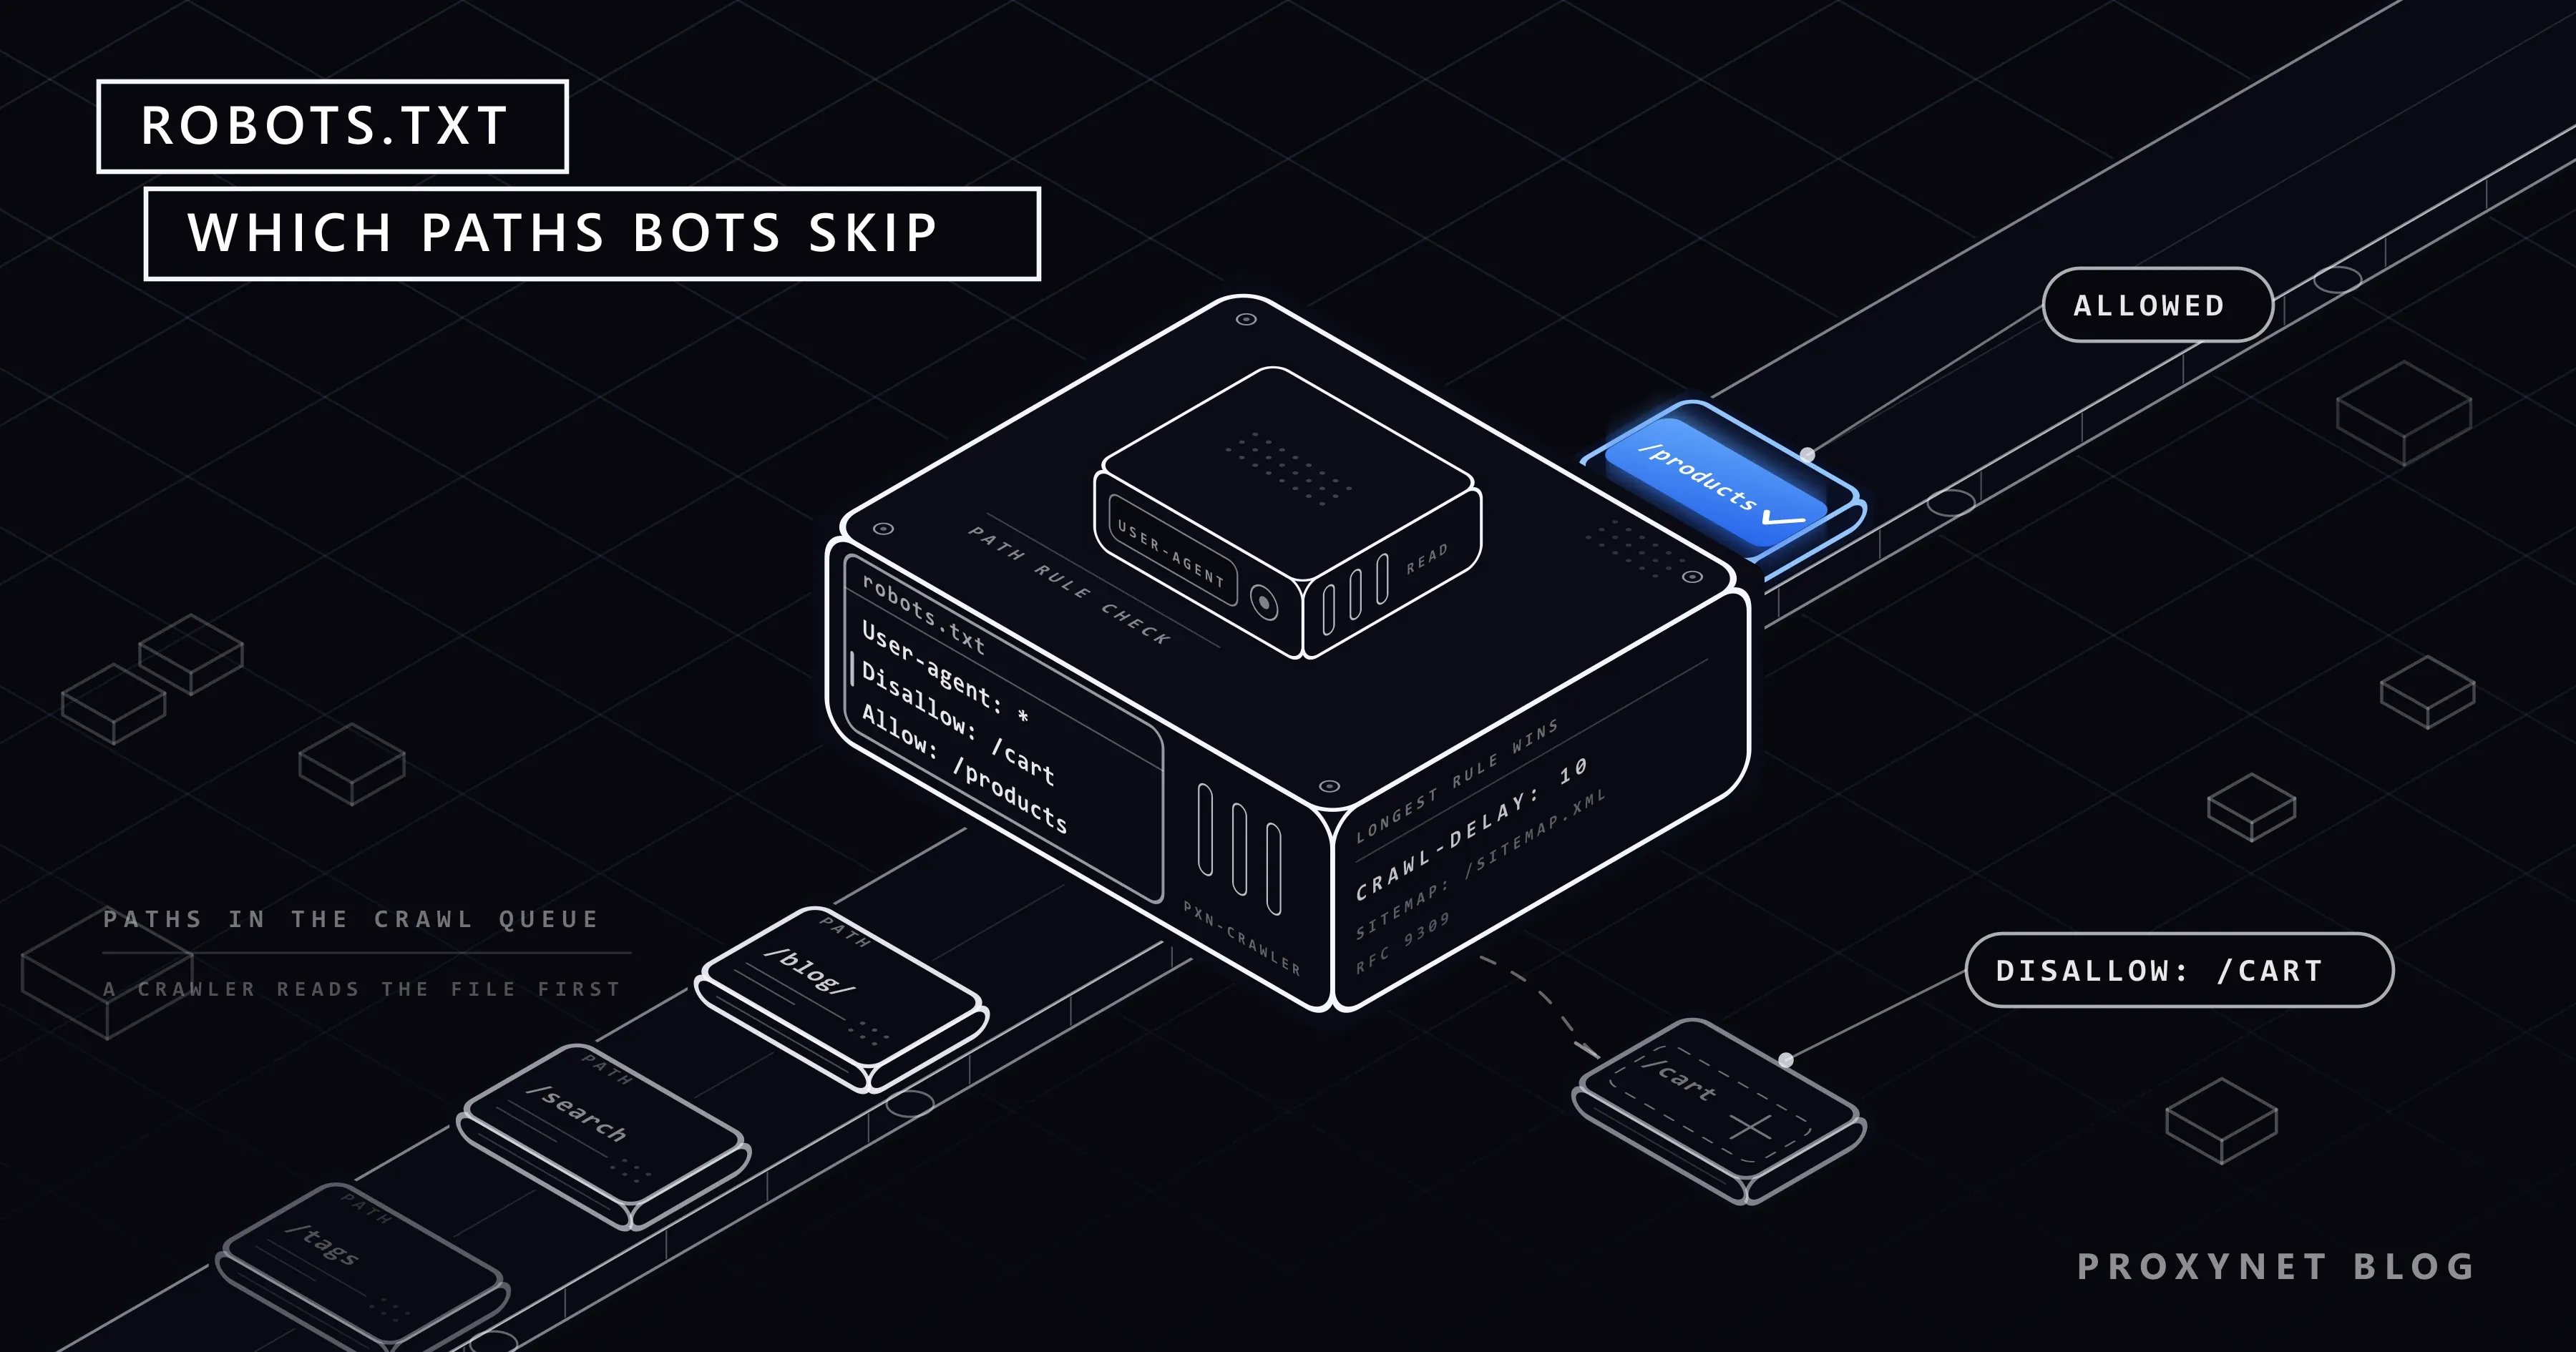
تاریخ انتشار
فایل robots.txt چیست و چگونه آن را بخوانیم؟
robots.txt فایلی است که سایت در آن به رباتها میگوید کدام مسیرها را نخزند. قواعد Disallow، Allow و Crawl-delay و خواندن آن با پایتون را توضیح میدهیم.
نویسنده:Acar Diveroli
نشست و کوکی در Python: ورود با requests
نویسنده: Acar Diveroliآموزشهاتاریخ انتشار
Scrapy چیست و چگونه با پروکسی استفاده میشود؟
نویسنده: Acar Diveroliوب اسکرپینگتاریخ انتشار
اثر انگشت TLS و JA3 چیست و چگونه کار میکند؟
نویسنده: Acar Diveroliوب اسکرپینگتاریخ انتشار
چرا سایتها عاملهای خرید هوش مصنوعی را مسدود میکنند؟
نویسنده: Acar Diveroliهوش مصنوعیتاریخ انتشار
همروندی و موازیسازی در وب اسکرپینگ
نویسنده: Acar Diveroliمقایسهتاریخ انتشار
انتخابگر CSS یا XPath: کدام برای اسکرپینگ؟
نویسنده: Acar Diveroliمقایسهتاریخ انتشار
اسکرپینگ وب با GPT-6 Astra: چه چیزی تغییر کرد؟
نویسنده: Acar Diveroliهوش مصنوعیتاریخ انتشار
تلههای هانیپات چیست و چه اثری بر اسکرپینگ دارد؟
نویسنده: Acar Diveroliوب اسکرپینگتاریخ انتشار
کدهای وضعیت HTTP در وب اسکرپینگ: 403، 407، 429، 503
نویسنده: Acar Diveroliوب اسکرپینگتاریخ انتشار
مقایسه HTTPX، Requests و AIOHTTP
نویسنده: Acar Diveroliمقایسهتاریخ انتشار
Puppeteer و CAPTCHA: چرا ظاهر میشود و چگونه کم میشود؟
نویسنده: Acar Diveroliآموزشهاتاریخ انتشار
فایل robots.txt چیست و چگونه آن را بخوانیم؟
نویسنده: Acar Diveroliوب اسکرپینگتاریخ انتشار
نوشتهای پیدا نشد
تاریخ انتشار
تاریخ انتشار