اسکریپتی که نام و قیمت محصول را از یک فروشگاه اینترنتی جمع میکند، ماهها بیدردسر کار کرد. سایت طراحی خود را نو کرد، عنصر <span class="price"> به کامپوننت دیگری منتقل شد و همان شب اسکریپت نوشتن رکوردهای خالی را آغاز کرد. پاسخ کلاسیک به این سناریو بازنویسی گزینشگر است. وعده اسکرپر وب هوش مصنوعی چیز دیگری است: دستور «نام و قیمت محصول را پیدا کن» حتی وقتی ساختار صفحه تغییر میکند معنای خود را نگه میدارد.
در این نوشته توضیح میدهیم اسکرپر وب هوش مصنوعی چیست، چگونه یک صفحه را در پنج گام به داده ساختیافته تبدیل میکند، چهار نوع ابزار کداماند، در چه کارهایی نتیجه خوب میدهد و در سمت مسدود شدن تفاوتی با اسکرپر کلاسیک دارد یا نه. نسخه عاملمحور که راه را خودش برمیگزیند و با کلیک کردن پیش میرود، موضوعی جداگانه است؛ در بخش آخر مرز این دو را مشخص میکنیم و به آن نوشته ارجاع میدهیم.
اسکرپر وب هوش مصنوعی چیست؟
اسکرپینگ وب دو کار جداگانه است: دریافت محتوای صفحه و تجزیه محتوای رسیده و تبدیل آن به داده ساختیافته. این تفکیک را بهعنوان جایگاه واقعی مدل در این جریان، وابسته به خود مدل، در نوشته وب اسکرپینگ با GPT-6 Astra توضیح دادهایم؛ بحث اصطلاحات اینجاست. وقتی «اسکرپر وب هوش مصنوعی» گفته میشود بیشتر افراد ابزاری را میفهمند که سمت تجزیه این دو کار را به مدل میسپارد. دریافت همچنان با یک کلاینت HTTP یا مرورگر بدون رابط گرافیکی انجام میشود؛ آنچه تغییر میکند کدی است که تصمیم میگیرد کدام عنصر صفحه «قیمت» یا «موجودی» به شمار آید.
دو حالت بیرون از این تعریف سردرگمی میسازند. نخست ابزارهای بدون کد: برخی سرویسها میخواهند فیلدهای موردنظرتان را با ماوس روی صفحه انتخاب کنید و مدل انتخاب شما را تعمیم دهد و روی صفحههای مشابه اعمال کند. نردبان کامل گرفتن داده بدون نوشتن کد (از Excel تا مرورگر بدون رابط گرافیکی) را در نوشته استخراج داده از وبسایت مرتب کردهایم؛ اسکرپر هوش مصنوعی ساکن پله بالای این نردبان است. دوم سامانههای عاملمحور که راه را هم به مدل میسپارند؛ آنها موضوع این نوشته نیستند، بلکه موضوع نوشته Agentic Web Scraping هستند.
اسکرپر هوش مصنوعی چگونه یک صفحه را به داده تبدیل میکند؟
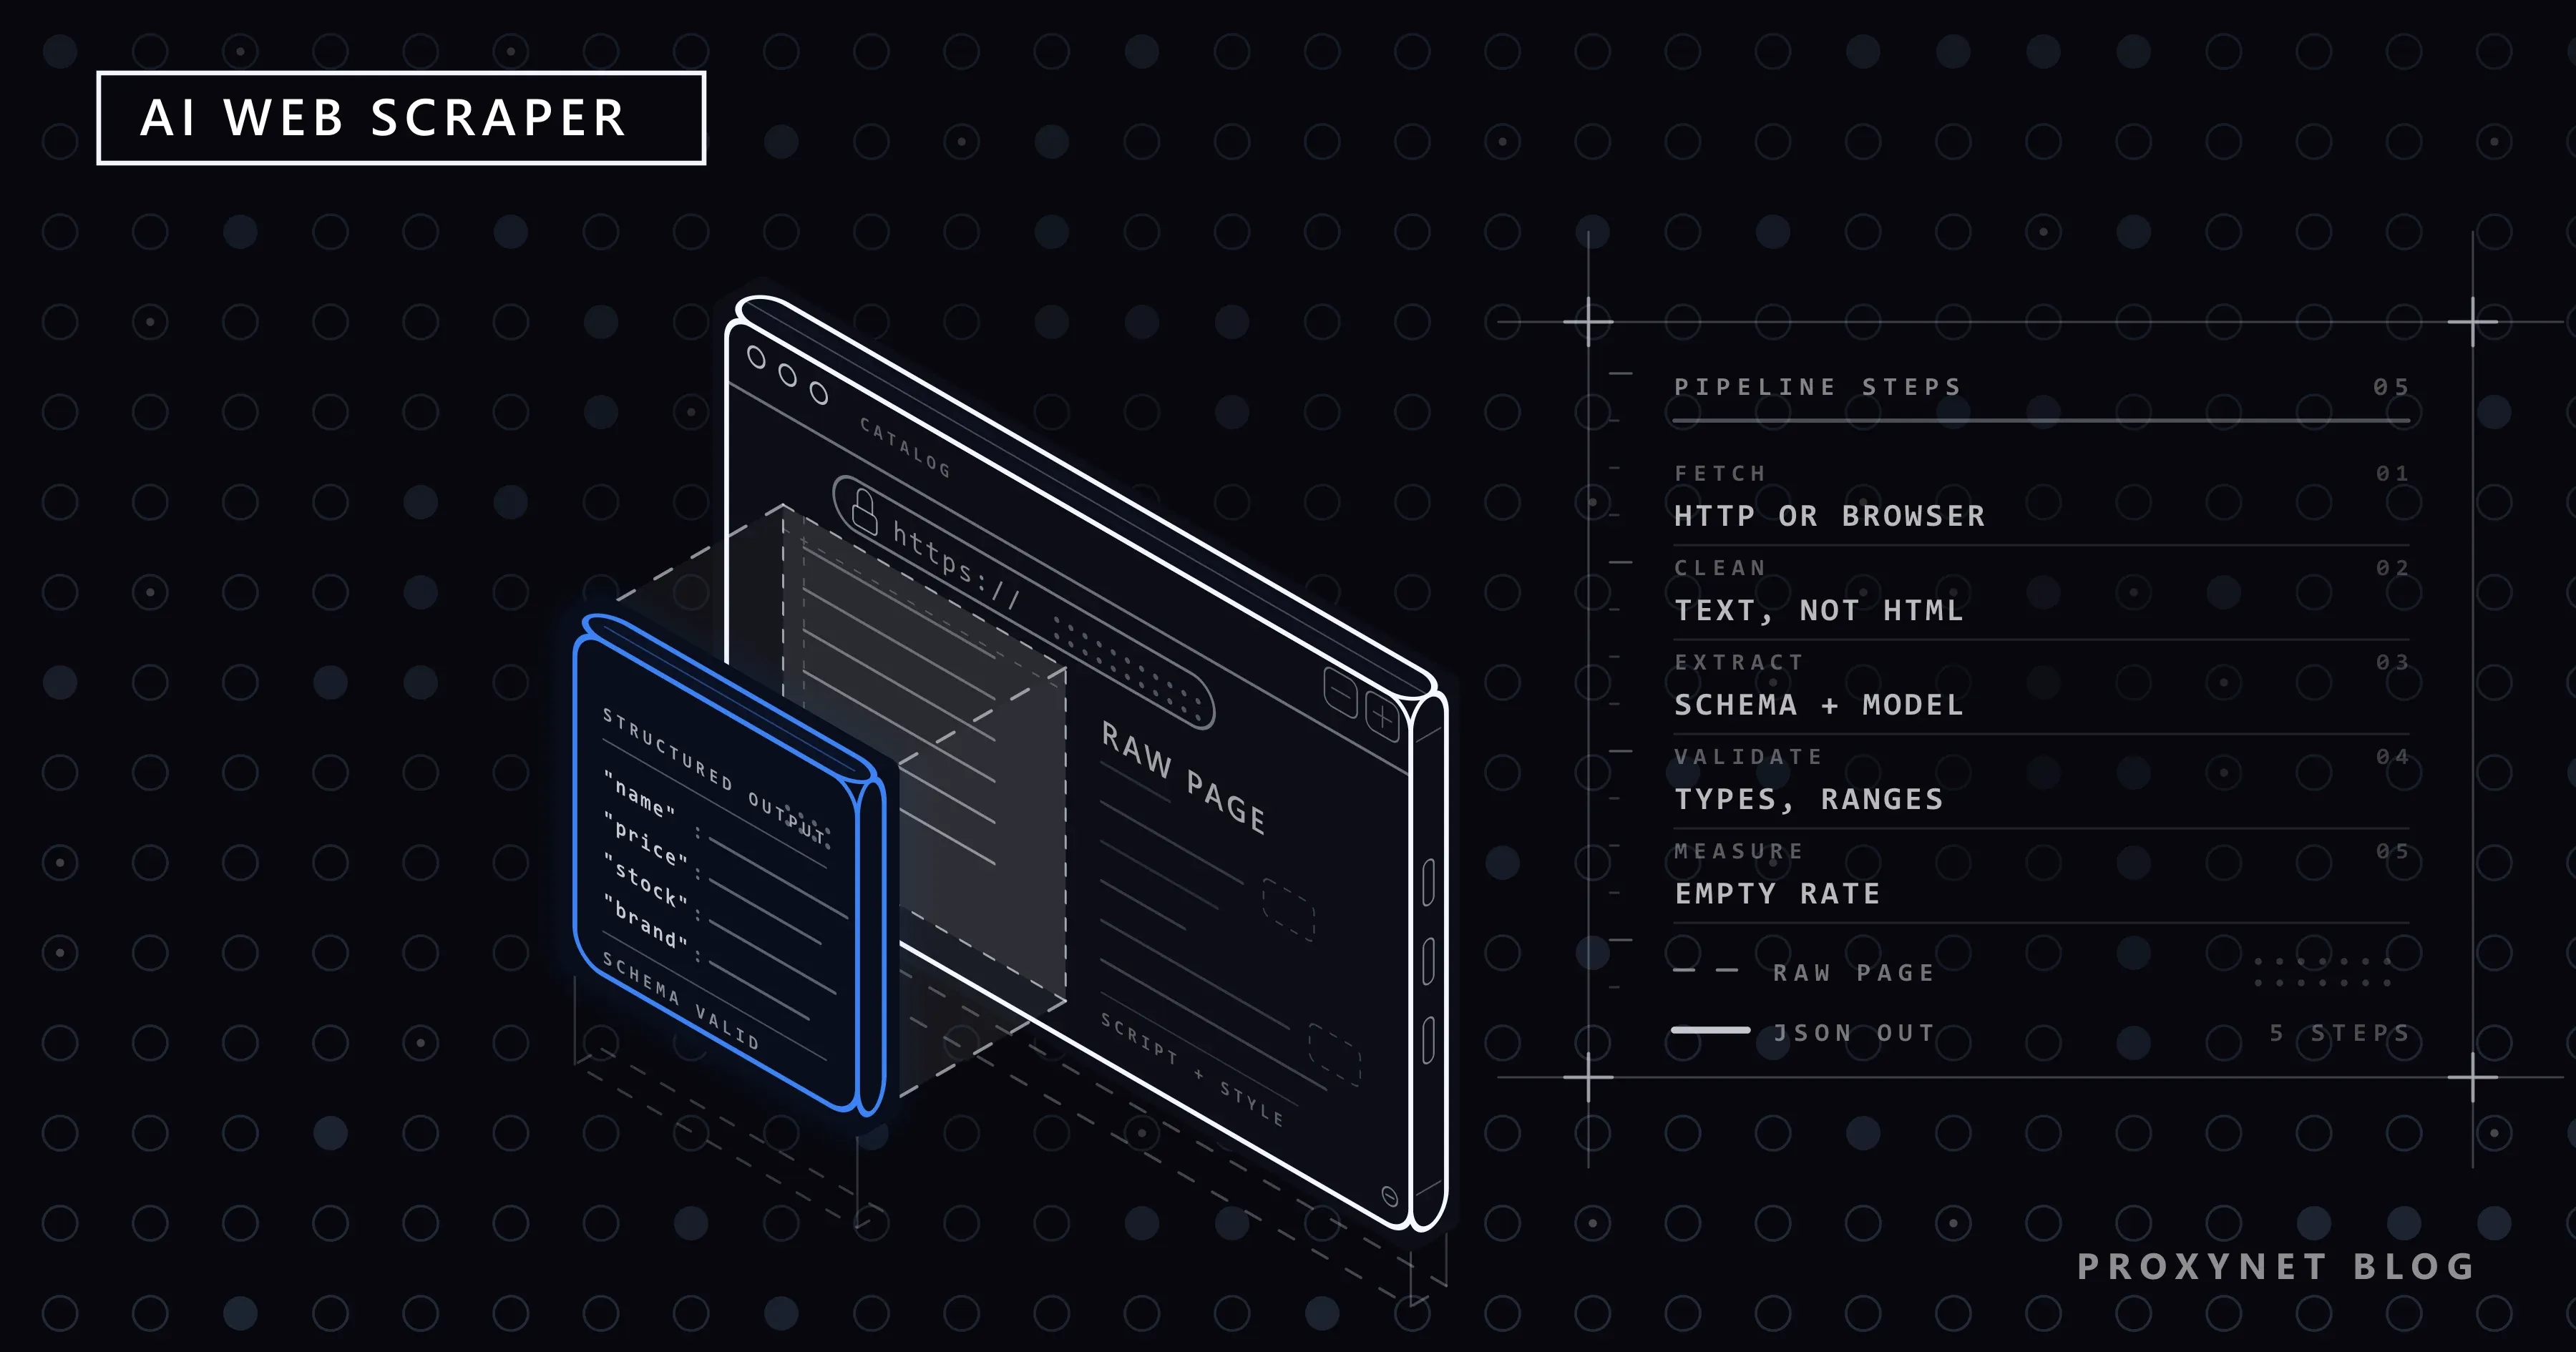
هر برندی که ابزار داشته باشد، جریان از پنج گام تشکیل میشود. تفاوت بیشتر در این است که این گامها چندتا با شماست و چندتا با سرویس.
- صفحه را بگیرید. برای HTML ایستا یک درخواست HTTP ساده کافی است. اگر صفحه محتوایش را با جاوااسکریپت پر میکند، با مرورگر بدون رابط گرافیکی رندر میشود. در این گام IP استفادهشده، سرعت درخواست و اثر انگشت مرورگر نقش دارند؛ مدل با اینها کاری ندارد.
- نویز را کنار بگذارید. HTML خام یک صفحه محصول چند برابر متن دیدنی است؛ اگر بلوکهای اسکریپت و ناوبری به مدل برسد هم کند میشود هم گران. عناصر اسکریپت و استایل پاک میشوند و در صورت نیاز فقط بلوک محتوای اصلی استخراج میشود. کتابخانه Readability موزیلا، نسخه متنباز الگوریتم پشت «نمای خواندن» مرورگر، شناختهشدهترین مرجع برای این کار است.
- شما و دستور را بدهید. فیلدهای موردنظر را بهصورت شمای JSON تعریف میکنید: کدام فیلد اجباری است، کدام عدد است، کدام تاریخ. APIهای امروزی مدل با پشتیبانی خروجی ساختیافته پاسخ مدل را ملزم به همخوانی با این شما میکنند؛ فرق آن با یک پاسخ آزادِ متنی همین است.
- خروجی را اعتبارسنجی کنید. پاسخ همخوان با شما ممکن است هنوز غلط باشد: در فیلد قیمت متن «1.299 TL» میرسد، واحد پول گم است، محصول ناموجود «true» برمیگرداند. بررسیهای نوع، بازه و فیلد اجباری با کد انجام میشود؛ رکورد مشکوک به پایگاه داده نمیرود، به صفی جداگانه میرود.
- ذخیره و سنجش. رکوردهای معتبر به انبار میروند؛ نرخ صفحههایی که خالی برمیگردند، اصلاح میخواهند یا با شما همخوان نیستند زیر نظر است. اگر این نرخ بیسروصدا بالا برود یا سایت تغییر کرده یا مدل از پس این ساختار صفحه برنمیآید؛ هیچکدام خطای کدی نیست که نوشتهاید و فقط با سنجش دیده میشود.
قرارداد گام سوم چنین دیده میشود. شمای JSON:
{
  "name": "string (اجباری)",
  "price": "number (اجباری)",
  "currency": "string",
  "in_stock": "boolean"
}
پاسخی که انتظار میرود مدل برگرداند:
{
"name": "ماوس بیسیم",
"price": 1299,
"currency": "TRY",
"in_stock": true
}انواع اسکرپر هوش مصنوعی و ابزارها
ابزارهای بازار به چهار گروه تقسیم میشوند. پرسش هنگام انتخاب این نیست که کدام برتری دارد، بلکه این است که کدام گامها با شماست و کدام با سرویس.
| نوع | کد لازم دارد؟ | نماینده | کار مناسب |
|---|---|---|---|
| ابزارهای بدون کد | نه | ابزارهای پایش مانند Browse AI | پایش تکراری صفحه، هشدار تغییر |
| APIهای اسکرپینگ با تجزیه هوش مصنوعی | در حد فراخوانی یک endpoint | Firecrawl، Apify | یکپارچهسازی آماده، کارهای میانمقیاس |
| کتابخانههای سمت کد | بله | ScrapeGraphAI، زنجیرههای استخراج LangChain | تیمهایی که خط لوله خودشان را میسازند و سفارشی میکنند |
| چارچوبهای عامل | بله | Browser Use، Playwright MCP | کارهای چندگامی با مسیری که از پیش معلوم نیست |
کوتاه باز کنیم. Firecrawl یک API اسکرپینگ متنباز است که یک URL میگیرد و صفحه را به Markdown تمیزِ مناسب مدلهای زبانی و در صورت درخواست به JSON همخوان با شما تبدیل میکند. Apify بستری است که برنامههای آماده اسکرپینگ در ابر روی آن اجرا میشوند؛ از میان صدها «actor» آماده انتخاب و اجرا میکنید. ScrapeGraphAI کتابخانهای متنباز در Python است که خط لوله دریافت و تجزیه را پیرامون یک مدل زبانی میسازد؛ میگویید «این اطلاعات را از این سایت بیرون بکش» و باقی خط لوله به کتابخانه واگذار میشود. LangChain چارچوبی همهمنظوره برای مدلهای زبانی است؛ زنجیرههایی که از سندها فیلد استخراج میکنند را در همین چارچوب میسازید. سطر چهارم خط لوله را ترک میکند: در چارچوبهای عامل، مدل تصمیم میدهد به کدام صفحه برود و چه چیزی کلیک کند.
دو گروه نخست جدول کار را سریع میکنند، دو گروه آخر شکل تعریف کار شما را عوض میکنند. بیشتر تیمها با گروه دوم شروع میکنند و با بزرگ شدن مقیاس و سفارشیسازی به گروه سوم میروند؛ جای گروه چهارم نوشتهای جداگانه است.
در چه کاری خوب است و در چه کاری از پسش برنمیآید؟
سمت قوی تجزیه مبتنی بر مدل همانجایی است که اسکریپت کلاسیک میشکند:
- تابآوری در برابر تغییر سایت. وقتی طراحی نو میشود، عناصر جابهجا میشوند یا نام کلاسها عوض میشود، دستور همان میماند. ردیف «درست کردن گزینشگر» از فهرست نگهداری حذف نمیشود، اما کمیابتر میشود.
- سایتهای دمبلند. نوشتن گزینشگر جداگانه برای صدها سایت کوچک با ساختارهای متفاوت در بیشتر پروژهها ناممکن است؛ دادن همان شما و همان دستور به هر یک ممکن است.
- متن آزاد. بیرون کشیدن زمان تحویل از جمله «ارسال در دو روز» یا طبقه آپارتمان از توضیحات آگهی با گزینشگر نوشته نمیشود؛ کار استخراج معناست.
در سمت مقابل سه هزینه ماندگار وجود دارد. هزینه و سرعت: گزینشگر در چند میلیثانیه و بیهزینه اجرا میشود؛ مدل چند ثانیه وقت میگیرد و برای هر صفحه توکن میخواهد. در خط لوله ثابتی که روزانه صد هزار صفحه پردازش میکند همین تفاوت حساب را وارونه میکند. ثبات: ممکن است یک ورودی هر بار خروجی یکسانی ندهد؛ به همین دلیل گام چهارم نادیده گرفتنی نیست. توهم: مدل میتواند فیلدی را که در صفحه نیست با دانش خودش پر کند. به دلیل این دو ریسکِ ساختار، در یک سایت تنها که ساختارش ماههاست تغییر نکرده گزینشگر CSS همچنان سریعترین و ارزانترین راه است؛ هوش مصنوعی اینجا بهبود نیست، هزینه است.
در سمت مسدود شدن چه چیزی تغییر میکند؟
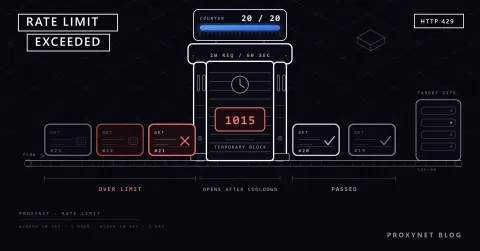
هیچ چیز تغییر نمیکند، یک چیز سنگینتر میشود. مدل در نحوه رسیدن به صفحه تغییری نمیدهد، پس اعتبار IP، سرعت درخواست و محدودیتهای موقعیت همان اسکرپ کلاسیک است؛ پاسخ 429 ربطی به مدل ندارد. سنگینتر شدنش این است: اسکرپرهای هوش مصنوعی برای اینکه بتوانند جاوااسکریپت را حل کنند بیشتر مواقع با مرورگر بدون رابط گرافیکی کار میکنند؛ یعنی هر درخواست یک مرورگر باز میکند، اجرا میکند و میبندد. این از یک درخواست HTTP ساده کندتر و پررنگتر است؛ در سرعت بالا زودتر به سقف درخواستهای مجاز میخورد.
به همین دلیل لایه دریافت در اسکرپر هوش مصنوعی از گذشته مهمتر است. نقطه آغاز همچنان قواعد خود سایت است: اگر فایل robots.txt اجازه ندهد اسکرپینگ انجام نمیشود، برای سایتی که API دارد از API استفاده میشود و محدودیت سرعت رعایت میشود. چارچوب اینها را در نوشته وب اسکرپینگ بدون مسدود شدن مرتب کردهایم. در کارهای حجیم و شلوغ اگر درخواستها از یک IP بیرون بزنند، آن آدرس سریع علامت میخورد؛ پروکسی مسکونی که از آدرسهای کاربر واقعی میآید در حساب اطمینان سایت مقصد جای بهتری میگیرد و پروکسی چرخشی که در هر درخواست آدرس را عوض میکند بار را میان استخر پخش میکند. انتخاب ارائهدهنده را در عنوانی جداگانه بررسی کردهایم: پروکسیها برای وب اسکرپینگ.
خلاصه اینکه انتظار «با هوش مصنوعی اسکرپ کنم مسدود نمیشوم» نادرست است؛ برعکس، اسکرپر هوش مصنوعی در یک پروژه معمول ترافیکی میفرستد که برای محافظت ضدربات سنگینتر دیده میشود. لایه دریافت به همین دلیل جداگانه طراحی و جداگانه پایش میشود.
تفاوت اسکرپر هوش مصنوعی با اسکرپینگ عاملمحور چیست؟
این دو اصطلاح زیاد با هم اشتباه گرفته میشوند چون در هر دو یک مدل زبانی صفحه را میخواند. تفاوت در این است که تصمیم دست کیست. اسکرپر وب هوش مصنوعی خط لولهای ثابت است: گامها را توسعهدهنده مینویسد و مدل فقط در گام تجزیه کار میکند. صفحه گرفته میشود، تجزیه میشود، تمام؛ مدل درباره دور بعدی جریان تصمیم نمیگیرد.
در اسکرپینگ عاملمحور مدل درون حلقه است: خودش تصمیم میگیرد به کدام پیوند برود، کجا بایستد، آیا برنامه به هم ریخته است یا نه. این یعنی گذر از کارهای تکصفحهای به کارهای چندگامی؛ بهایش این است که هزینه و زمان به تعداد گام گره میخورد. حلقه عمومی عامل چگونه کار میکند را در نوشته عاملهای هوش مصنوعی چگونه کار میکنند؟ توضیح دادهایم؛ حالت مخصوص اسکرپینگ، بلوکهای سازنده و حالتهای خطا را در نوشته Agentic Web Scraping بررسی کردهایم.
کاربردها
- رصد قیمت و موجودی. صفحه محصول صدها فروشنده به یک شمای واحد درمیآید؛ تغییر طراحی خط لوله را از کار نمیاندازد. راهاندازی سرتاسری را در نوشته رصد قیمت رقبا توضیح دادهایم.
- جمعآوری داده دمبلند. بیرون کشیدن همان فیلدها از صدها سایت کوچک با ساختارهای متفاوت بسیار ارزانتر از نوشتن گزینشگر برای هر سایت درمیآید.
- استخراج اطلاعات از متن آزاد. در متنهای بدون ساختار مانند نظرها، توضیحات آگهی و آگهیهای شغلی جای گزینشگر نیست؛ فیلدهای استخراجشده ورودی خط لوله دادهکاوی میشوند.
- داده بهروز برای کاربردهای مدل زبانی. اگر لازم است اطلاعاتی بهروز مانند کاتالوگ محصول، مستندات یا قیمت به مدل داده شود، اسکرپر هوش مصنوعی این کار را بهصورت ساختیافته انجام میدهد؛ برای طراحی امن لایه دسترسی دسترسی امن LLM به وب ما را ببینید.
اشتباهات رایج
- فرستادن هر صفحه به مدل. ناحیه باثباتی که گزینشگر در آن کار میکند نباید به مدل برسد؛ تنگ کردن ناحیه با یک گزینشگر خام و سپردن درونش به مدل، مزیت دو روش را با هم ترکیب میکند.
- فرستادن HTML خام. بلوکهای اسکریپت و استایل بودجه توکن را هدر میدهند؛ اگر گام پاکسازی حذف شود همان کار چند برابر گران درمیآید.
- خروجی بدون اعتبارسنجی. همخوانی با شما به معنای درست بودن داده نیست. بدون بررسی نوع، بازه و فیلد اجباری، تنها یک پاسخ غلط مدل بیسروصدا در پایگاه داده شما نوشته میشود.
- تعریف نکردن شما. دستوری آزاد مانند «اطلاعات محصول این صفحه را بده» در هر صفحه به شکل متفاوتی پاسخ میگیرد؛ ساختن خط لوله بدون گره زدن مجموعه فیلدها به قرارداد، کار بیهوده است.
- درمان نشانههای مسدودی با مدل. پاسخ
429، محتوای خالی یا CAPTCHA به شکل مشکل تجزیه خودش را نشان میدهد؛ عوض کردن پرامپت اینها را حل نمیکند، درست کردن لایه دریافت (سرعت، راهبرد IP) حل میکند. - باز کردن صفحههای خصوصی در ابزار شخص ثالث. بارگذاری صفحههایی که نشست میخواهند یا داده شخصی دارند در پنجره یک سرویس بدون کد، آن داده را به شخص ثالث منتقل میکند؛ چنین صفحههایی در زیرساخت خودتان پردازش میشوند.
راهنمای انتخاب
| نیاز | پیشنهاد |
|---|---|
| یک صفحه تنها با ساختاری که بهندرت عوض میشود؛ حجم بالا | گزینشگر کلاسیک؛ نیازی به هوش مصنوعی نیست |
| پایش تکراری بدون نوشتن کد | ابزار بدون کد |
| کار میانمقیاس در سایتی که ساختارش زیاد عوض میشود | API با تجزیه هوش مصنوعی یا کتابخانه |
| صدها سایت با ساختارهای متفاوت، متن آزاد | تجزیه با LLM + لایه اجباری اعتبارسنجی |
| کارهای چندگامی که گامهایشان از پیش معلوم نیست | چارچوب عامل (Agentic Web Scraping) |
پرسشهای متداول
برای استفاده از اسکرپر وب هوش مصنوعی باید کد بلد بود؟
لزومی ندارد. ابزارهای بدون کد اجازه میدهند فیلدها را روی صفحه انتخاب کنید و پایش تکراری برپا کنید؛ کتابخانههای سمت کد به کسانی که میخواهند خط لوله را خودشان بسازند انعطاف میدهند. با بزرگ شدن کار و بیشتر شدن نیاز به سفارشیسازی، سمت کد گریزناپذیر میشود.
آیا اسکرپرهای هوش مصنوعی راحتتر از اسکرپرهای کلاسیک مسدود میشوند؟
علت مسدود شدن خود ترافیک است نه مدل؛ اما چون اسکرپر هوش مصنوعی معمولاً با مرورگر بدون رابط گرافیکی کار میکند، هر درخواست کندتر و پررنگتر است. در سرعت بالا این ممکن است زودتر از یک درخواست ساده کلاسیک به سقف بخورد. به همین دلیل طراحی جداگانه لایه دریافت مهم است.
آیا استخراج داده با هوش مصنوعی قانونی است؟
استفاده از هوش مصنوعی پرسش حقوقی را عوض نمیکند: داده شخصی، محتوای پشت ورود به حساب و قواعد حق نشر همانگونه برقرارند؛ robots.txt و شرایط سایت همچنان نقطه آغازند. چارچوب را در نوشته آیا اسکرپینگ وب قانونی است؟ توضیح دادهایم. نکته توجه اضافی: فرستادن محتوای صفحه به API مدل یک شخص ثالث، خود به خود یک انتقال داده است.
آیا میتوانم با ChatGPT از وبسایت داده بگیرم؟
برای کارهای کوچک تکصفحهای بله: صفحه را از مرورگر کپی میکنید، شمای خودتان را میدهید و خروجی پردازششده میگیرید. این خط لوله نیست؛ نه دریافت دارد، نه اعتبارسنجی، نه تکرار. در کارهای پیوسته یا چندصفحهای به خط لولهای نیاز است که با اسکریپت و فراخوانی API ساخته شده باشد.
آیا میتوان به دادهای که اسکرپر هوش مصنوعی استخراج میکند اعتماد کرد؟
خروجی همخوان با شما به معنای خروجی درست نیست. بررسی نوع و فیلد اجباری، بازرسی بازهها و مقایسه دستی نمونهای رویه استاندارد است؛ رکوردهای مشکوک پیش از نوشته شدن در انبار اصلی صف میشوند. آنچه اعتماد را زیاد میکند بزرگ کردن مدل نیست، برپا کردن جدی لایه اعتبارسنجی است.
در چه حالتی اسکریپت کلاسیک منطقیتر است؟
در کارهایی که ساختار صفحه ماههاست تغییر نکرده، حجم بالاست و مجموعه فیلد ثابت است. گزینشگر در چند میلیثانیه و بدون توکن اجرا میشود؛ مدل اینجا بهبود نیست، هزینهای ماندگار است. استثناهایی که گزینشگر در آنها میشکند و سایتهای دمبلند باید به هوش مصنوعی سپرده شوند.
خلاصه
اسکرپر وب هوش مصنوعی پایان شکننده اسکرپینگ — کار استخراج فیلدها — را به مدل زبانی میسپارد؛ دریافت، اعتبارسنجی و سنجش با نظم کلاسیک همان میماند. سود کوتاهمدت، ردیفهایی است که از فهرست نگهداری پاک میشوند؛ بهای آن، هزینه توکنی است که برای هر صفحه پرداخت میشود. تیمی که این دو را توازن میکند، در صفحههای باثبات از گزینشگر و در ساختارهای متغیر از مدل استفاده میکند. هنگام برپا کردن خط لوله جمعآوری داده، نگاهی به راهحلهای اسکرپینگ داده ما بیندازید.