Descargas air-quality-2025.zip del portal de datos abiertos de una ciudad. Dentro hay tres archivos: un CSV con una fila por estación de medición y por hora, un PDF breve llamado «diccionario de datos» y un archivo de texto con una licencia. El CSV contiene las cifras, pero por sí solo no te dice si pm25 es una media horaria o diaria, si las horas están en hora local o en UTC, ni si puedes publicar un gráfico hecho con él. Los tres archivos juntos forman el conjunto de datos; el CSV por sí solo no es más que datos.
Este artículo explica qué es un conjunto de datos (en inglés, dataset), cómo se organizan sus filas, columnas y tipos, cómo se construye y se divide para el aprendizaje automático, y repasa ejemplos conocidos, fuentes, formatos de archivo, licencias, documentación y datos personales.
¿Qué es un conjunto de datos?
Un conjunto de datos es un grupo de datos sobre un mismo tema, registrados con un único nivel de detalle y guardados juntos para analizarlos como un todo. El historial de pedidos de una tienda, las lecturas horarias de una estación meteorológica y 10.000 fotos etiquetadas de señales de tráfico son conjuntos de datos, porque cada registro de cada uno describe el mismo tipo de cosa de la misma manera.
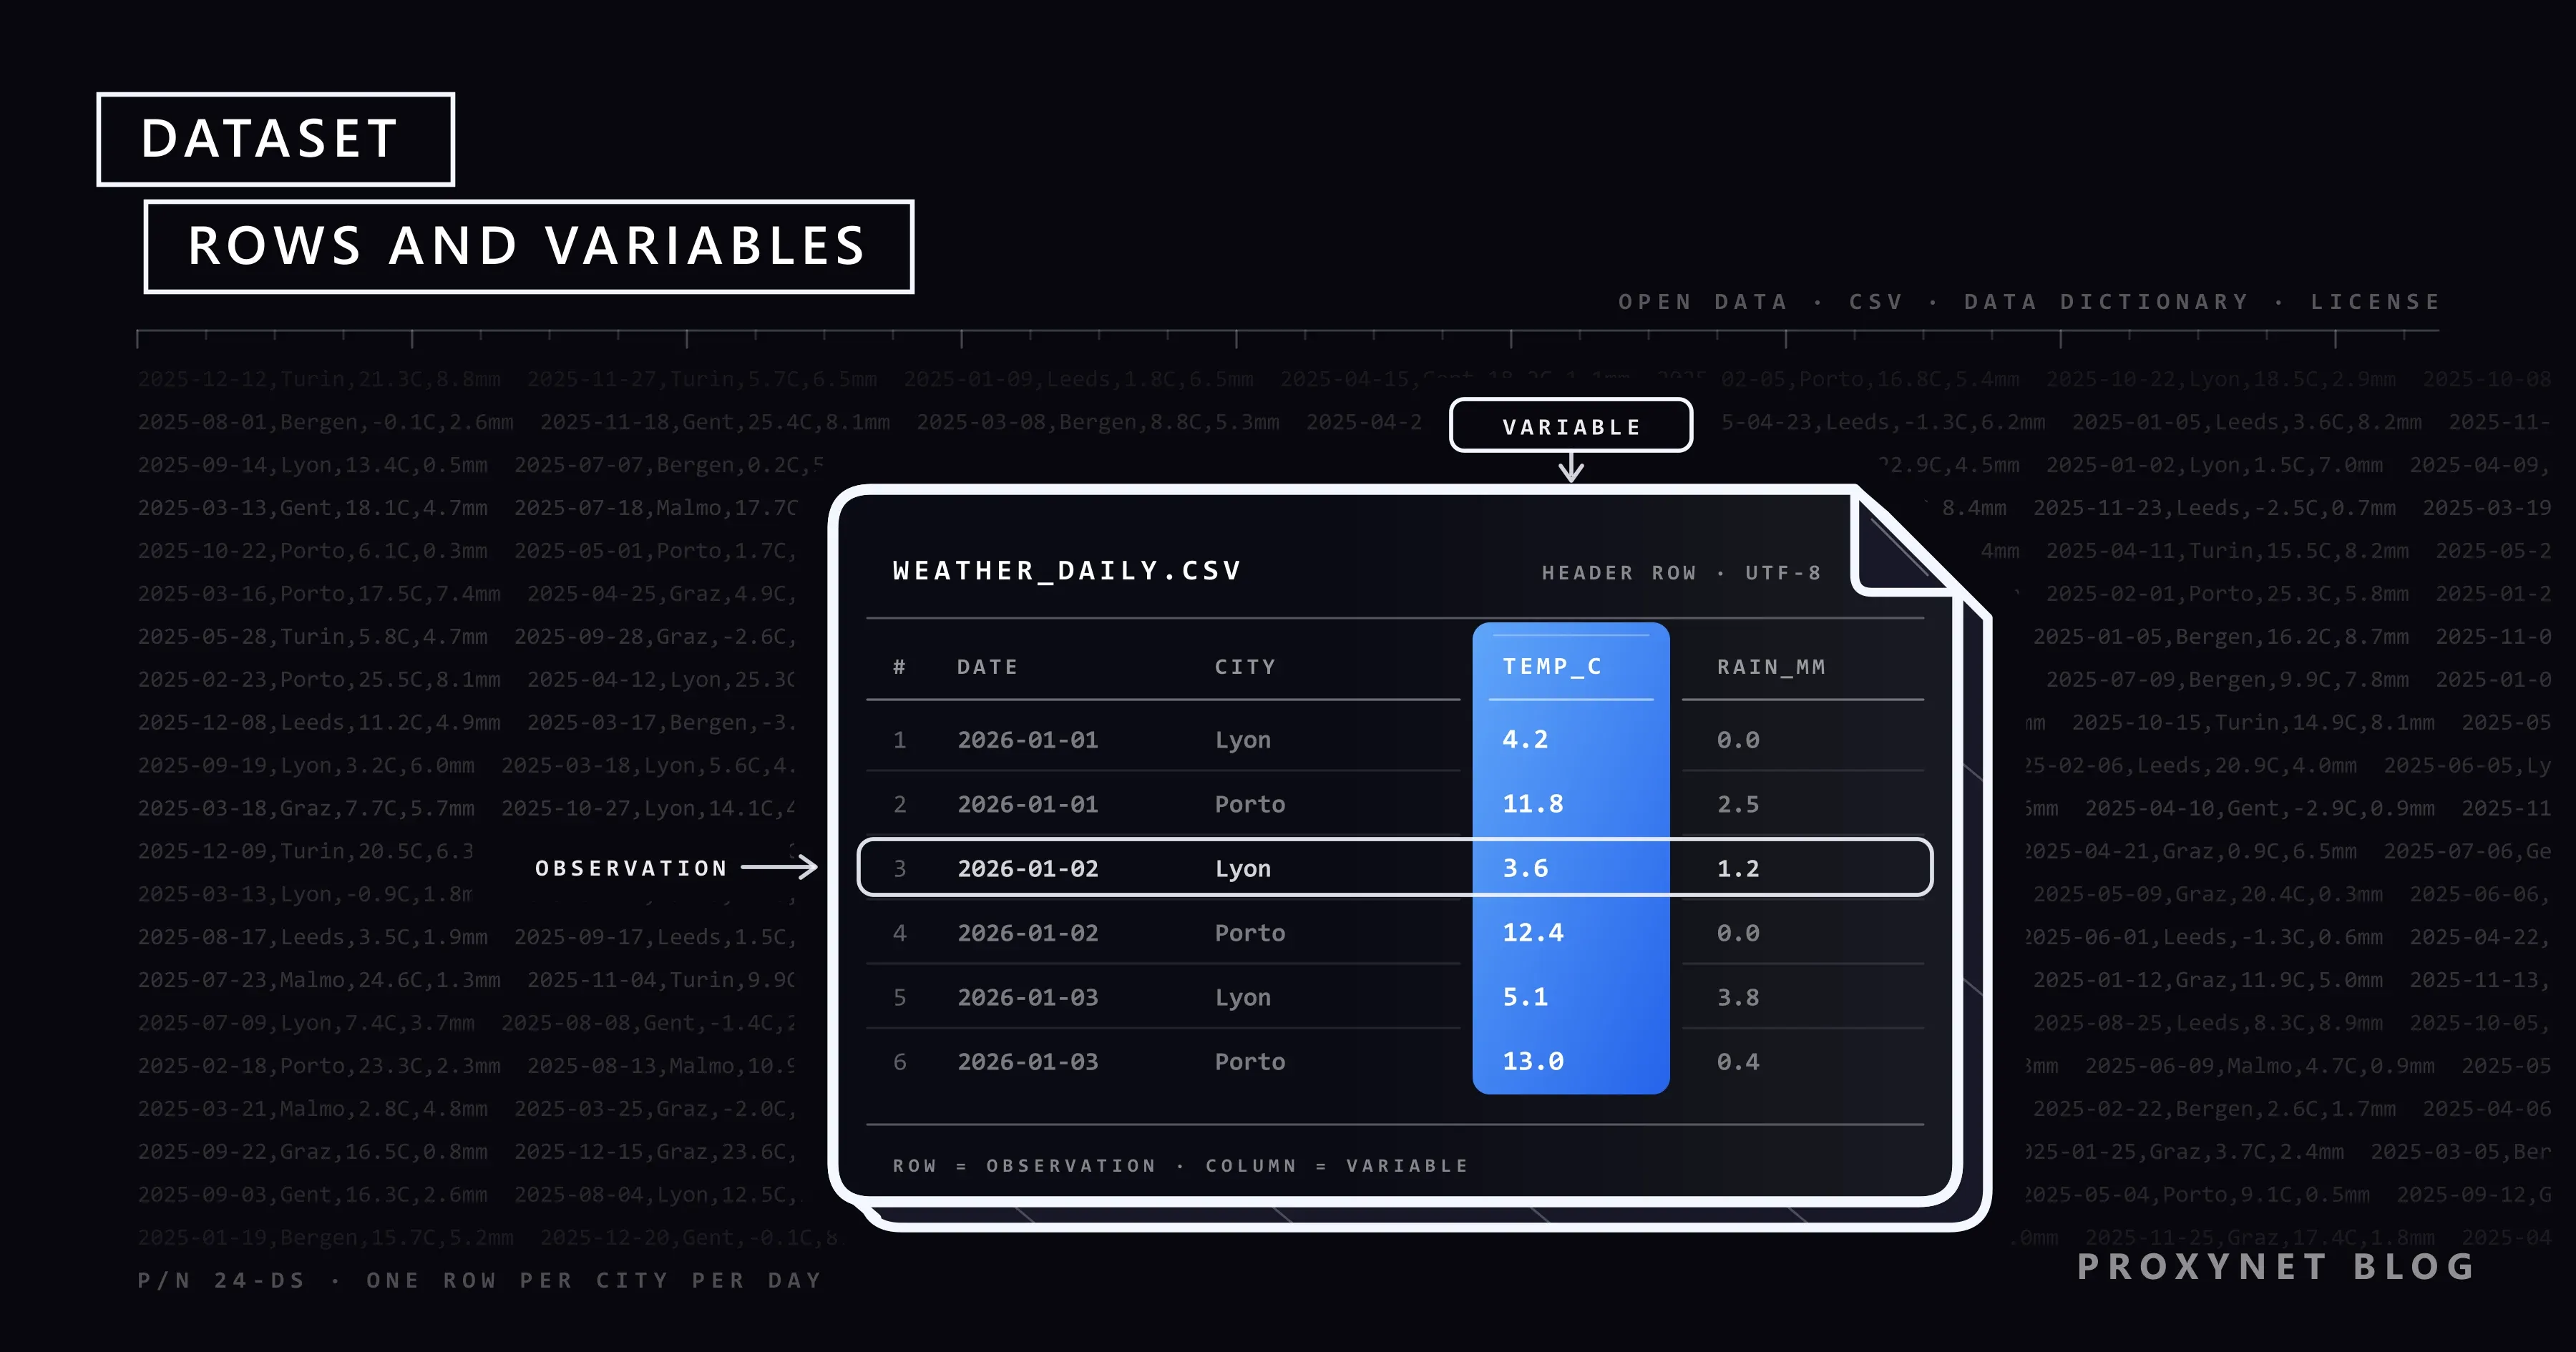
La mayoría de los conjuntos de datos que encontrarás en el trabajo son tablas. Estas son las primeras filas de un pequeño conjunto de datos meteorológicos en formato CSV, donde las comas separan los valores:
date,city,temp_c,rain_mm
2026-01-01,Lyon,4.2,0.0
2026-01-01,Porto,11.8,2.5
2026-01-02,Lyon,3.6,1.2
Cada línea después del encabezado es una observación: una ciudad en un día. Cada columna es una variable, registrada para todas las observaciones, y donde se cruzan una fila y una columna hay un valor, como 4,2 grados. Lo que describe una fila se llama unidad de observación; decidirla primero (una fila por ciudad y día, no una por lectura del sensor) condiciona todo lo demás.
¿Qué son las filas, columnas y valores de un conjunto de datos?
Las filas son observaciones, las columnas son variables y cada celda contiene exactamente un valor. Esta disposición, a menudo llamada «tidy data» (datos ordenados), hace que un conjunto de datos sea fácil de filtrar, sumar y combinar con otra tabla, porque casi todas las herramientas de análisis esperan una observación por fila. Una hoja de cálculo con celdas combinadas y subtotales en medio parece una tabla, pero rompe la regla.
El tipo de variable decide qué puedes calcular con ella:
- Numérica: mediciones (4,2 grados) o recuentos (3 pedidos). Las medias tienen sentido.
- Categórica: etiquetas de un conjunto fijo, como la ciudad. Se cuentan; una «ciudad media» no significa nada.
- Fecha y hora: solo son comparables si se conocen el formato y la zona horaria.
- Texto: texto libre, como las reseñas, que hay que procesar antes del análisis.
- Identificador: un número de pedido o un ID de producto que enlaza una fila con otras tablas. Parece numérico, pero nunca se promedia.
Un diccionario de datos enumera cada variable con su tipo, su unidad y sus valores permitidos. Sin él, una columna llamada temp podría estar en grados Celsius o Fahrenheit, y una celda vacía podría significar cero, desconocido o no aplicable.
¿Qué significa conjunto de datos en estadística?
En estadística y en las matemáticas escolares, un conjunto de datos es simplemente la lista de valores que analizas, a menudo una sola variable. Las notas 4, 7, 7, 9 y 13 forman un conjunto de cinco valores: su rango es 13 − 4 = 9, su mediana (el valor central una vez ordenados) es 7, su moda (el valor más frecuente) es 7 y su media es 40 ÷ 5 = 8.
Una tabla con 12 columnas son doce listas así registradas una al lado de otra para las mismas observaciones, lo que permite compararlas, por ejemplo para ver si los días de lluvia son más fríos.
¿Qué tipos de conjuntos de datos existen?
Los conjuntos de datos se agrupan según lo estrictamente estructurados que estén los datos y según el aspecto de un registro. Los datos estructurados encajan en columnas fijas, como una hoja de cálculo. Los datos semiestructurados llevan sus propias etiquetas sin una tabla fija, como el JSON de una API o las líneas de registro con pares key=value. Los datos no estructurados, como el texto libre, las imágenes y el audio, no tienen campos predefinidos y suelen necesitar etiquetas o características extraídas antes del análisis.
Según la forma de un registro, estos son los tipos más habituales:
| Tipo | Un registro es | Ejemplo | Formato típico |
|---|---|---|---|
| Tabular | Una observación, campos fijos | Pedidos, respuestas de encuestas | CSV, Excel, Parquet |
| Serie temporal | Un valor en un momento | Temperatura por hora | CSV, Parquet |
| Datos de panel | Una unidad en un momento | Precios diarios de 500 productos | CSV, Parquet |
| Texto | Un documento | Reseñas, noticias | JSON Lines, TXT |
| Imagen o audio | Un archivo con su etiqueta | Fotos etiquetadas «gato» | Carpetas + archivo de etiquetas |
| Grafo | Un nodo o un enlace | Enlaces entre páginas web | Listas de aristas, JSON |
Una serie temporal sigue una sola cosa a lo largo del tiempo, un conjunto de datos de corte transversal es una instantánea de muchas cosas en un momento, y los datos de panel combinan ambos. En una serie temporal cada valor depende de los anteriores, así que sus filas no se pueden barajar como las respuestas de una encuesta.
¿Cómo se construye un conjunto de datos?
Un conjunto de datos se construye decidiendo qué significa una fila, recogiendo todas las filas de la misma manera y dejando por escrito cómo se hizo:
- Define la pregunta. «¿Cómo se comparan nuestros precios con los de tres competidores cada semana?» marca el alcance.
- Elige la unidad de observación. Aquí: una fila por producto, por competidor y por día.
- Elige las variables. ID de producto, competidor, precio, moneda, existencias y hora de recogida, cada una con su tipo y su unidad.
- Recoge los datos. Desde tus propios sistemas, una API, una descarga oficial o páginas web públicas, con el mismo método para cada fila.
- Revisa y limpia. Elimina duplicados, corrige los tipos y marca los valores que faltan; ¿Qué es la calidad de los datos? convierte estas comprobaciones en reglas que se ejecutan en cada lote.
- Documenta. Escribe el diccionario de datos, la fuente, las fechas de recogida y las lagunas conocidas.
- Versiona y guarda. Asigna a cada publicación una fecha o un número, para que un gráfico hecho en marzo se pueda reproducir en junio.
¿Cómo se usan los conjuntos de datos en el aprendizaje automático?
En el aprendizaje automático, un conjunto de datos es el grupo de ejemplos del que aprende un modelo: cada fila contiene características (features, las entradas) y, en el aprendizaje supervisado, una etiqueta (la respuesta que el modelo debe aprender a predecir). Un filtro de spam, por ejemplo, aprende de miles de correos que las personas han etiquetado como spam o no spam.
Antes del entrenamiento, el conjunto de datos se divide en tres partes que nunca se solapan:
- Conjunto de entrenamiento: los ejemplos de los que aprende el modelo, normalmente la parte más grande.
- Conjunto de validación: se usa durante el desarrollo para comparar ajustes y decidir cuándo detener el entrenamiento.
- Conjunto de prueba: se reserva y se usa una sola vez al final, para estimar cómo se comporta el modelo con datos que nunca ha visto.
Si filas casi idénticas, como dos fotos del mismo objeto, acaban tanto en el conjunto de entrenamiento como en el de prueba, la puntuación parece mejor de lo que es; esto se llama fuga de datos (data leakage). Las series temporales se dividen por fecha, entrenando con el pasado y probando con un periodo posterior, para que el modelo no pueda asomarse al futuro.
¿Qué conjuntos de datos famosos hay?
Tres conjuntos de datos públicos muestran todo lo que abarca el término:
- Iris: 150 flores de tres especies, con cuatro medidas cada una, publicado por el estadístico R. A. Fisher en 1936. El UCI Machine Learning Repository lo distribuye con una licencia CC BY 4.0.
- MNIST: 70.000 imágenes en escala de grises de dígitos escritos a mano, de 28 × 28 píxeles cada una, divididas en 60.000 imágenes de entrenamiento y 10.000 de prueba, cada una etiquetada del 0 al 9. Es un primer ejercicio clásico de clasificación de imágenes.
- Common Crawl: petabytes de páginas web recopiladas con regularidad desde 2008 y disponibles de forma gratuita. Muchos conjuntos de texto para entrenar modelos de lenguaje se filtran a partir de él; ¿Qué es Common Crawl? explica qué contiene un rastreo.
¿De dónde salen los conjuntos de datos?
Los conjuntos de datos proceden de unos pocos lugares, y la fuente decide cuánto puedes confiar en ellos y reutilizarlos:
- Estadísticas oficiales: los institutos nacionales de estadística y los organismos internacionales publican datos de población, precios y comercio con métodos documentados.
- Portales de datos abiertos: gobiernos y ciudades publican presupuestos, horarios y lecturas de calidad del aire, normalmente con una licencia abierta.
- Repositorios de investigación: universidades y revistas alojan los datos que respaldan los artículos publicados.
- API: los servicios ofrecen datos a través de endpoints documentados, con sus propios límites y condiciones.
- Tus propios sistemas: pedidos, registros del servidor y fichas del CRM; a menudo la fuente más valiosa y la que más probablemente contiene datos personales.
- Páginas web públicas: precios, anuncios, ofertas de empleo y reseñas, recogidos dentro de las condiciones y los límites de solicitudes de cada sitio.
Para encontrar un conjunto de datos que ya exista, empieza por la organización que lo recogería: los datos de desempleo, en el instituto de estadística; los retrasos de los autobuses, en el portal de datos abiertos de la ciudad.
¿Qué formatos de archivo usan los conjuntos de datos?
La mayoría de los conjuntos de datos tabulares se comparten en CSV, los registros anidados en JSON o JSON Lines, y las tablas analíticas grandes en Parquet. CSV es texto plano con una fila por línea y comas entre los valores; el RFC 4180 documenta su forma habitual, incluidas las comillas dobles alrededor de cualquier valor que contenga una coma, unas comillas o un salto de línea.
En nuestro equipo de pruebas (Node.js 24) guardamos la misma tabla de 1.000 filas y 4 columnas en ambos formatos: el CSV ocupó 25.492 bytes y el array JSON 68.468 bytes, unas 2,7 veces más, porque JSON repite el nombre de cada columna en cada registro. Al dividir la línea 2026-01-01,"Washington, D.C.",4.2,0.0 por las comas salieron cinco campos en lugar de cuatro, mientras que un analizador que respeta las comillas devolvió los cuatro correctos. Lee siempre un CSV con un analizador de CSV de verdad.
Parquet es un formato de código abierto orientado a columnas que almacena y comprime juntos los valores de cada columna, de modo que una consulta que necesita 2 de 50 columnas solo lee esas 2. JSON Lines pone un registro en cada línea, algo que encaja con registros de actividad y textos que no dejan de crecer.
¿Qué licencia tiene un conjunto de datos?
La licencia de un conjunto de datos indica qué puedes hacer con él; sin ella no tienes un permiso claro para reutilizarlo, porque los derechos de autor o los derechos sobre bases de datos pueden seguir aplicándose. Las licencias abiertas más comunes son:
- CC BY 4.0: compartir y adaptar con cualquier fin, incluso comercial, siempre que cites al autor, enlaces la licencia e indiques si hiciste cambios. El resumen de Creative Commons recoge las condiciones exactas.
- ODbL 1.0 (Open Database License): pensada para bases de datos. Cita la fuente, ofrece con la misma licencia cualquier base de datos adaptada que uses públicamente y, si añades restricciones técnicas, distribuye también una versión sin ellas.
- CC0: el editor renuncia a sus derechos en la medida en que la ley lo permite, así que no se aplica ninguna condición.
- Condiciones de uso: los datos de una API o de un sitio web se rigen por las condiciones de ese servicio, que pueden ser más estrictas que cualquier licencia abierta.
Una licencia cubre los derechos del editor, no los de las personas que aparecen en los datos. Un conjunto de datos CC BY con nombres y correos electrónicos sigue conteniendo datos personales.
¿Cómo se debe documentar un conjunto de datos?
Un conjunto de datos debe llevar documentación suficiente para que un desconocido pueda usarlo bien sin preguntar a su autor. El artículo Datasheets for Datasets (Gebru y otros, publicado por primera vez en 2018) propone que cada conjunto de datos vaya acompañado de una hoja de datos (datasheet) que cubra su motivación, su composición, el proceso de recogida y los usos recomendados, igual que los componentes electrónicos se entregan con sus hojas de datos.
Incluso un README breve ayuda mucho: qué es una fila, la fuente y el método, el periodo cubierto, las unidades y la zona horaria, las lagunas conocidas, la licencia, la versión y un contacto.
¿Qué pasa si un conjunto de datos contiene datos personales?
Si alguna fila se refiere a una persona que puede ser identificada, el conjunto contiene datos personales y se aplica la normativa de protección de datos. El RGPD define los datos personales en el artículo 4, apartado 1 como toda información sobre una persona física identificada o identificable, directamente o mediante elementos como un nombre, un número de identificación, datos de localización o un identificador en línea. La KVKK de Türkiye (Ley n.º 6698 de Protección de Datos Personales) recoge la misma idea en su artículo 3.
Quitar los nombres no basta: los datos seudonimizados, en los que los nombres se sustituyen por códigos y la clave se guarda en otro sitio, siguen siendo datos personales según el RGPD. Recoge solo las columnas que necesitas, enmascara los identificadores directos, limita el acceso y fija una fecha de borrado; Cómo tratar datos personales (PII) en datos de scraping recorre estos pasos para los datos web.
¿Cómo se crea un conjunto de datos a partir de páginas web públicas?
Cuando no existe ni descarga ni API, lo difícil de usar páginas web públicas es recoger todas las filas en las mismas condiciones. Muchos sitios muestran precios, monedas, existencias e idioma distintos según el país del visitante, así que un conjunto de datos recogido desde un solo lugar describe en silencio solo ese lugar. Los Proxies residenciales con segmentación por país y ciudad permiten recoger las filas de cada mercado tal como las vería un visitante local, y una sesión fija mantiene la misma dirección IP entre 1 y 60 minutos durante una comprobación de varias páginas.
Registra el país y la hora de recogida en cada fila, respeta el robots.txt, las condiciones y los límites de solicitudes de cada sitio, y usa una API oficial o una descarga siempre que exista. Los equipos que prefieran no encargarse de la recogida pueden usar la extracción gestionada de páginas de nuestra Web Scraping API, disponible a través de nuestro equipo de ventas.
¿Dónde se usan los conjuntos de datos?
- Análisis de negocio: tablas de ventas y costes detrás de los paneles y los informes.
- Aprendizaje automático e IA: datos de entrenamiento y de prueba, desde filtros de spam hasta modelos de lenguaje.
- Investigación: encuestas, experimentos y estadísticas oficiales en las que se basan los estudios publicados.
- Precios y comercio electrónico: precios y existencias de la competencia seguidos a lo largo del tiempo.
- Sector público y periodismo: presupuestos y datos de transporte que permiten verificar afirmaciones.
Errores frecuentes
- Sin unidad de observación. Mezclar una fila por pedido con una fila por cliente falsea todos los totales.
- Dos valores en una celda. «12 kg / 26 lb» no se puede sumar ni filtrar.
- Unidades y zonas horarias ausentes. Un precio sin moneda es una suposición.
- Dividir un CSV por las comas. Los valores entre comillas que contienen comas desplazan las columnas.
- Ignorar la licencia. «Lo encontré en internet» no es una licencia.
- Filtrar datos de prueba al entrenamiento. Los duplicados a ambos lados de la división inflan cada puntuación.
- Sin versión ni fecha de recogida. Los resultados que nadie puede reproducir no son fiables.
Guía de decisión
| Necesidad | Recomendación |
|---|---|
| Una tabla pequeña que se edita a mano | Excel o CSV con diccionario de datos |
| Compartir una tabla con otras herramientas | CSV con fila de encabezado, UTF-8, valores entre comillas |
| Tablas grandes para análisis | Parquet, particionado por fecha |
| Registros anidados de una API | JSON Lines |
| Entrenar un modelo | Conjuntos separados de entrenamiento, validación y prueba |
| Datos ordenados en el tiempo | Dividir por fecha, nunca al azar |
| Reutilizar datos ajenos | Revisar antes la licencia y sus condiciones |
| Datos sobre personas | Recoger solo lo necesario; enmascarar identificadores |
| Precios o anuncios en varios países | Recoger cada mercado desde ese mercado |
Preguntas frecuentes
¿Qué es un conjunto de datos, en pocas palabras?
Un conjunto de datos es una colección de datos relacionados que se guardan juntos con un propósito, casi siempre una tabla. Cada fila describe una cosa, como una venta o un día, y cada columna registra una propiedad de ella, como el precio o la temperatura.
¿Qué diferencia hay entre un conjunto de datos y una base de datos?
Un conjunto de datos son los propios datos, recogidos con un fin; una base de datos es el software que almacena datos y responde a consultas. Una base de datos puede contener muchos conjuntos de datos, y un conjunto de datos puede estar en una base de datos, en un archivo CSV o en una hoja de cálculo.
¿Cuál es un ejemplo de conjunto de datos?
La lista de pedidos de una tienda es un conjunto de datos: una fila por pedido, con columnas de fecha, producto, cantidad y precio. Ejemplos públicos conocidos son Iris, MNIST y Common Crawl.
¿Qué es un conjunto de datos en el aprendizaje automático?
Es el grupo de ejemplos con el que un modelo aprende y con el que se evalúa. Cada ejemplo contiene características (las entradas) y normalmente una etiqueta (la respuesta correcta), y se reparte en conjuntos de entrenamiento, validación y prueba.
¿Dónde encuentro conjuntos de datos gratuitos?
Empieza por la organización que recogería esos datos: institutos nacionales de estadística, portales de datos abiertos de gobiernos y ciudades, repositorios de investigación como el UCI Machine Learning Repository y organismos internacionales. Revisa la licencia de cada conjunto antes de reutilizarlo, aunque la descarga sea gratuita.
¿Cómo creo mi propio conjunto de datos?
Decide la pregunta, define qué representa una fila y elige las variables con sus tipos y unidades. Recoge todas las filas de la misma manera, revisa y limpia el resultado, y después escribe un README breve con la fuente, las fechas y la licencia, y asigna una versión a cada publicación.
En resumen
Un conjunto de datos son datos relacionados y organizados con un propósito, normalmente una tabla de observaciones y variables, más la documentación y la licencia que lo hacen utilizable. Decide qué significa una fila antes de recoger nada, mantén un valor por celda y registra unidades, zonas horarias y fechas de recogida. Revisa la licencia antes de reutilizar, trata los datos personales como una obligación legal y, cuando las páginas web cambian según el país, recoge cada mercado desde ese mercado.