Un equipo de soporte convierte 100.000 respuestas de su mesa de ayuda en embeddings y crea un botón de «buscar tickets similares». El prototipo compara cada ticket nuevo con todos los vectores guardados, y la respuesta parece instantánea. Luego el archivo crece hasta 20 millones de pasajes, cada búsqueda lee los 20 millones de vectores y el botón se vuelve más lento con cada importación. Cerrar esa brecha entre «comparar con todo» y «encontrar los pocos más cercanos en milisegundos» es el trabajo de una base de datos vectorial.
Este artículo explica qué guarda una base de datos vectorial, cómo se ejecuta una búsqueda, qué medidas de similitud y tipos de índice usa (HNSW, IVF y cuantización de producto en palabras sencillas), cómo encajan los filtros y la búsqueda híbrida, cuándo basta con una extensión en la base de datos que ya usas y cuánta memoria cuesta.
¿Qué es una base de datos vectorial?
Una base de datos vectorial es una base de datos pensada para guardar vectores y responder rápido a un solo tipo de pregunta: ¿qué elementos guardados se parecen más a este? Una base de datos relacional responde «qué filas cumplen esta condición»; una base de datos vectorial responde «qué elementos son los más parecidos», y siempre devuelve los más cercanos, aunque ninguno encaje de verdad.
Cada registro suele contener cuatro cosas:
- Un ID, para poder rastrear el resultado hasta un documento, un producto o una imagen.
- El vector, una lista de números de longitud fija generada por un modelo de embeddings.
- Metadatos, como idioma, fecha, país, dirección de origen o quién puede ver el elemento, que sirven para filtrar resultados.
- El contenido o una referencia a él, para que la aplicación pueda mostrar el pasaje o el producto que representa el vector.
{
  "id": "faq-0412#2",
  "vector": [0.021, -0.113, 0.087, "... 381 números más"],
  "metadata": { "lang": "es", "country": "DE", "updated": "2026-11-02" },
  "text": "Los pedidos a Alemania suelen llegar en tres días hábiles."
}
¿Qué es un embedding vectorial?
Un embedding vectorial es una lista de números que un modelo de embeddings, una red neuronal entrenada para esta tarea, genera para un dato de modo que los significados parecidos queden cerca unos de otros. «Vuelos baratos a Roma» y «billetes de avión económicos con destino Roma» reciben vectores cercanos aunque casi no compartan palabras; cómo funciona esa coincidencia por significado en una búsqueda se explica en ¿Qué es la búsqueda semántica?.
Los embeddings reales tienen de cientos a unos pocos miles de números, llamados dimensiones, y el modelo fija esa cantidad. De ahí salen dos reglas: todos los vectores de un índice tienen el mismo número de dimensiones, y las consultas deben convertirse en embeddings con el mismo modelo y la misma versión que los elementos guardados. Los vectores de dos modelos distintos no se pueden comparar, aunque tengan la misma longitud.
¿Cómo funciona una base de datos vectorial?
Una base de datos vectorial trabaja en dos fases: primero ingiere e indexa los elementos y después responde cada consulta buscando en ese índice.
- Prepara los elementos. Los documentos largos se dividen en pasajes, cada uno con su dirección de origen y otros metadatos.
- Genera los embeddings. El modelo de embeddings convierte cada pasaje, imagen o producto en un vector, normalmente en tu aplicación o tu pipeline y no dentro de la base de datos.
- Guarda los registros. La base de datos escribe el ID, el vector, los metadatos y el contenido.
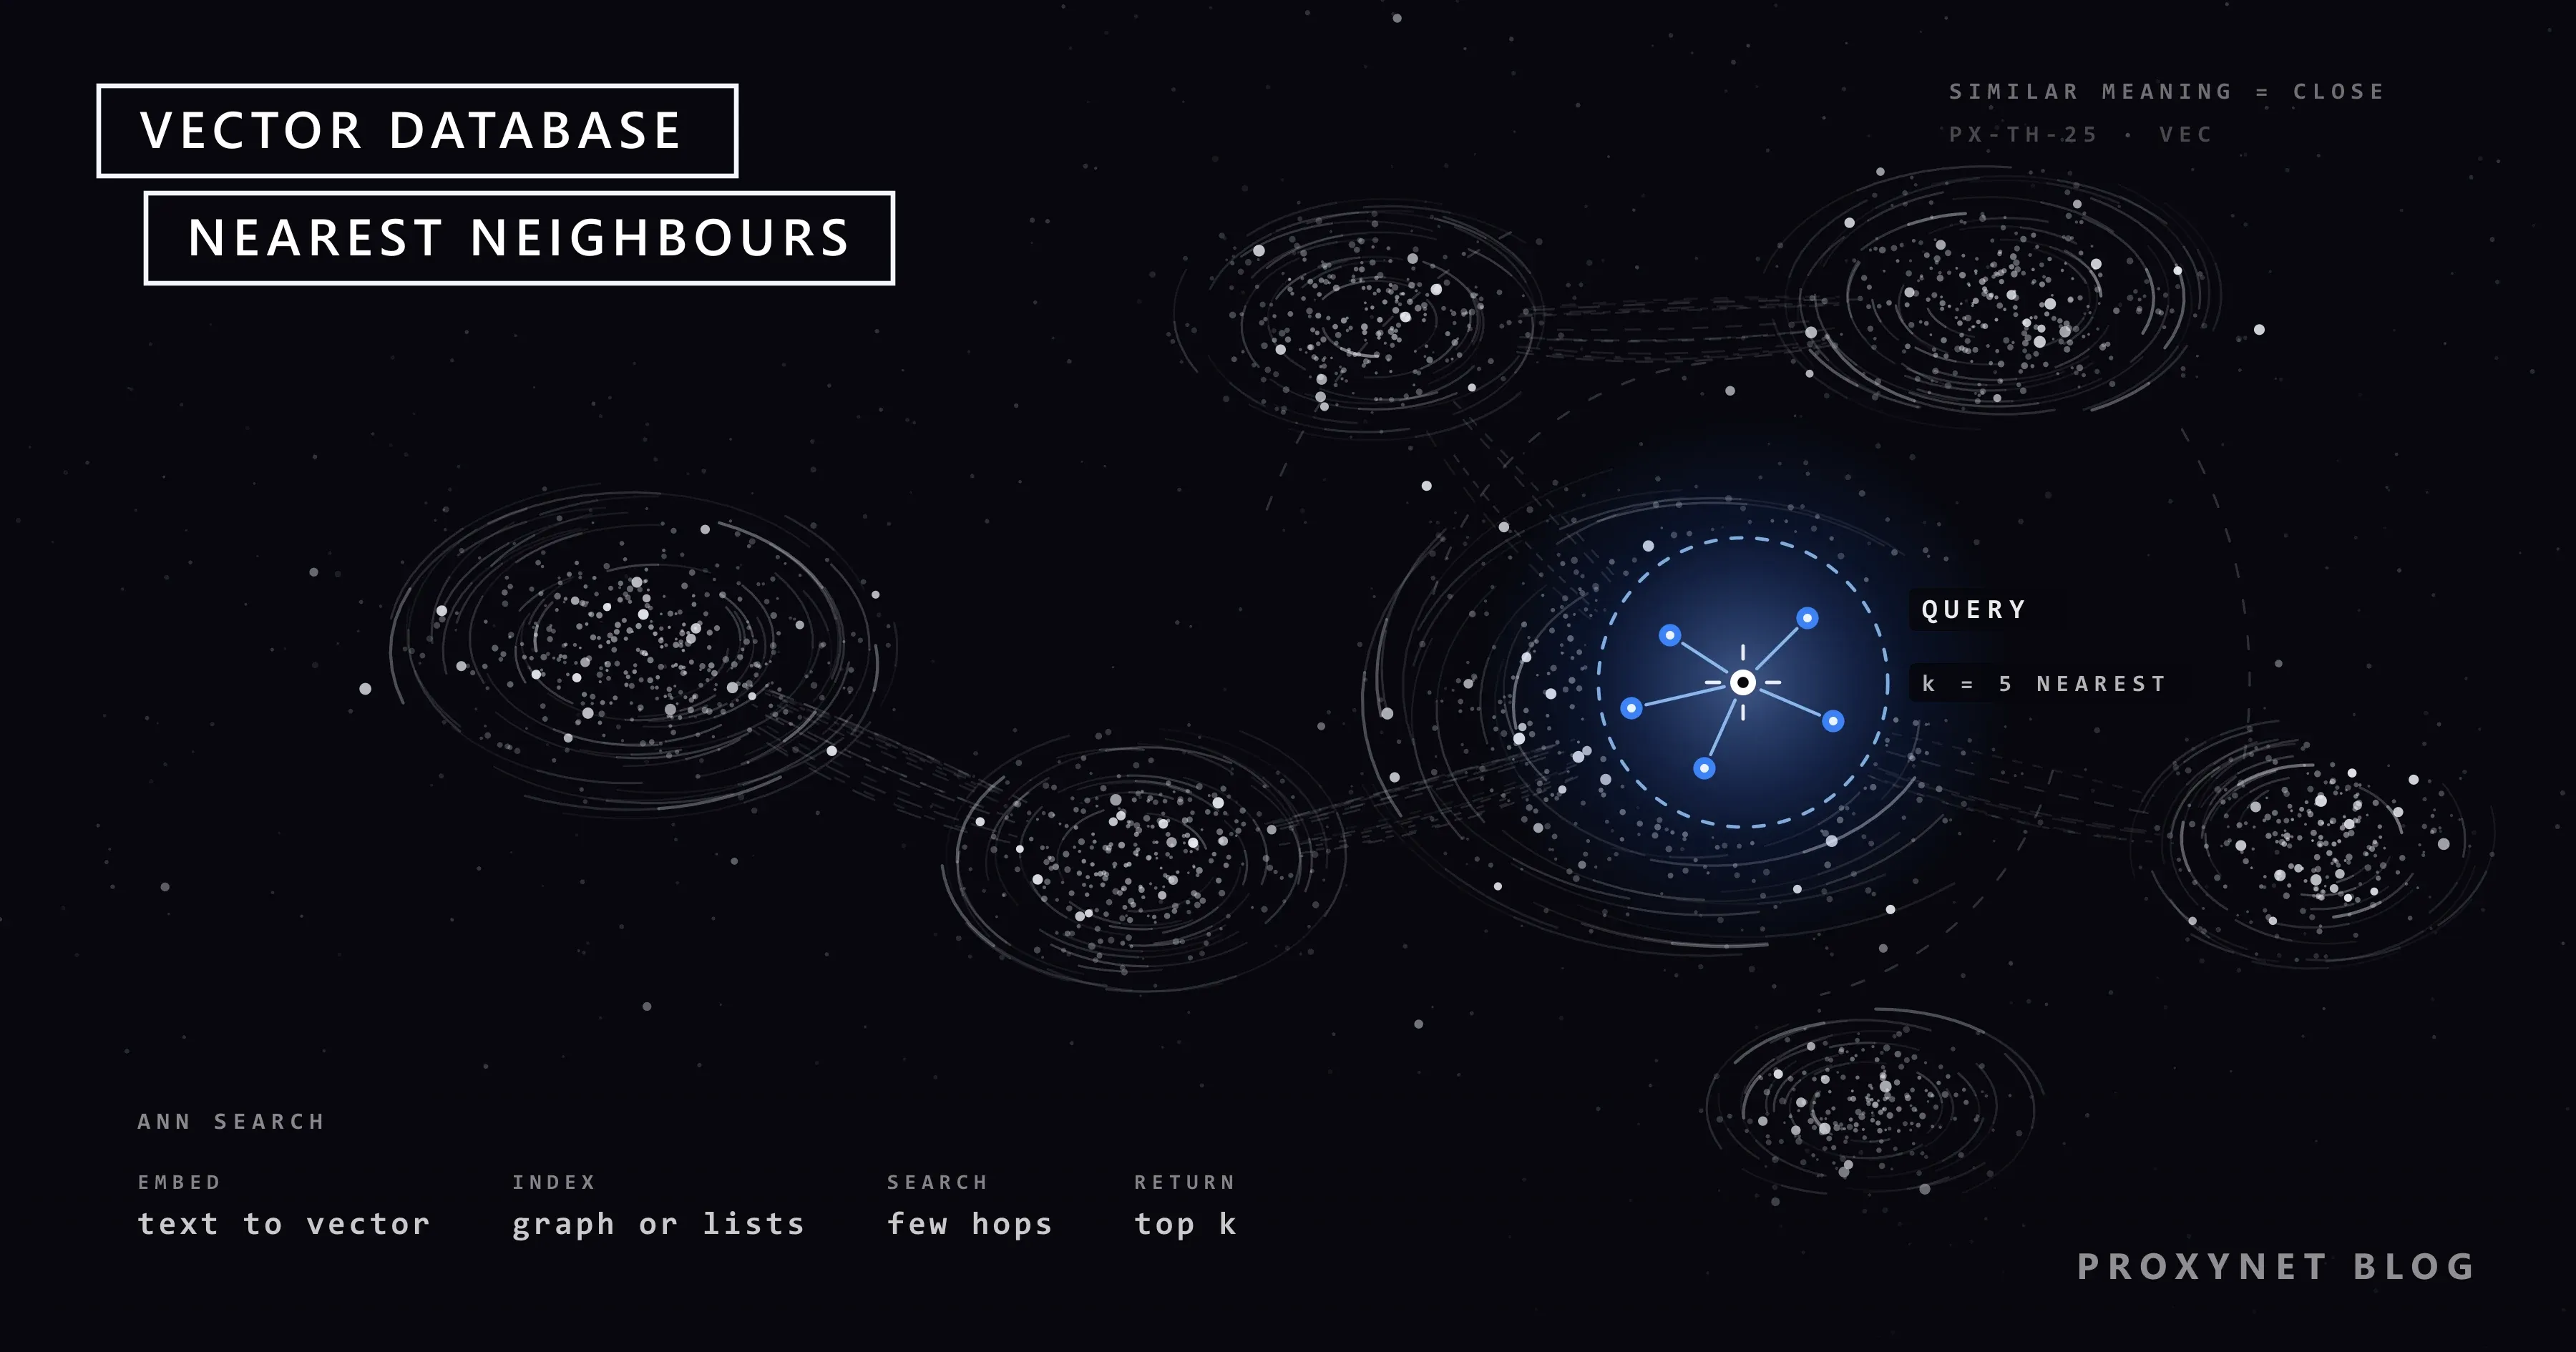
- Construye el índice. Un índice ANN organiza los vectores en un grafo o en clústeres para que una búsqueda pueda saltarse la mayoría.
- Convierte la consulta. La pregunta del usuario pasa por el mismo modelo y se convierte en un vector de consulta.
- Busca y filtra. El índice devuelve candidatos cercanos a la consulta, y condiciones de metadatos como «el idioma es alemán» eliminan los que no cumplen.
- Devuelve los k primeros. Los k elementos más cercanos vuelven con sus puntuaciones de similitud, listos para mostrarse, reordenarse o pasarse a un modelo de lenguaje.
Las actualizaciones siguen el mismo camino: un documento modificado se convierte de nuevo en embedding y su vector anterior se reemplaza; si no, el índice sigue respondiendo con un texto que ya no existe.
¿Qué medidas de similitud usa una base de datos vectorial?
Las bases de datos vectoriales ordenan los resultados con una de tres medidas habituales: similitud del coseno, producto escalar o distancia euclidiana. La correcta es la medida con la que se entrenó el modelo de embeddings, que su documentación indica.
| Medida | Qué compara | Un valor más alto significa |
|---|---|---|
| Similitud del coseno | El ángulo entre dos vectores | Más parecido |
| Producto escalar | Ángulo y longitud a la vez | Más parecido |
| Distancia euclidiana (L2) | La distancia en línea recta | Menos parecido |
Cuando todos los vectores están normalizados a longitud 1, algo que hacen muchos modelos de embeddings, las tres medidas ordenan los resultados igual: el coseno coincide con el producto escalar, y una distancia menor equivale a un producto escalar mayor. Por eso la documentación de pgvector recomienda el producto interno para vectores normalizados: el mismo orden con el menor cálculo. Con vectores sin normalizar, indexar con una medida y consultar con otra cambia el orden sin avisar.
¿Qué diferencia hay entre la búsqueda exacta y la aproximada de vecinos más cercanos?
La búsqueda exacta compara la consulta con cada vector guardado y siempre encuentra los vecinos realmente más cercanos; la aproximada revisa solo una parte pequeña y bien elegida de la colección y suele encontrar casi todos. La búsqueda exacta, también llamada por fuerza bruta o plana (flat), cuesta un tiempo directamente proporcional al número de vectores.
La búsqueda aproximada de vecinos más cercanos (ANN) cambia un poco de precisión por mucha velocidad. La precisión se mide como recall (exhaustividad), la proporción de los verdaderos vecinos más cercanos que se encuentran: si el índice devuelve 9 de los 10 verdaderos más cercanos, el recall a 10 es 0,9. Todo índice ANN tiene ajustes que se mueven a lo largo de esa línea, así que afínalo con tus datos en lugar de fiarte de los valores por defecto.
Probamos nosotros mismos una versión pequeña de este equilibrio, en JavaScript puro y con datos sintéticos. En nuestra máquina de prueba, recorrer 100.000 vectores de 384 números tardó unos 40 milisegundos por consulta; un índice IVF mínimo con 256 clústeres respondió en alrededor de medio milisegundo cuando buscaba en un solo clúster, pero encontró solo unos 7 de los 10 vecinos realmente más cercanos, y buscar en 32 clústeres tardó unos 10 milisegundos y encontró unos 8,5. Los índices reales son mucho más refinados, pero el patrón es el mismo: más trabajo por consulta, más recall.
¿Cuáles son los principales tipos de índice vectorial?
Los principales tipos de índice son el plano (sin índice), los índices de grafo como HNSW, los índices de clústeres como IVF y la compresión con cuantización de producto, que a menudo se combina con IVF. Cada uno equilibra de forma distinta velocidad, memoria y recall.
| Índice | Cómo se ejecuta una búsqueda | Costo principal |
|---|---|---|
| Plano (flat) | Compara la consulta con cada vector | Lento en conjuntos grandes |
| HNSW | Salta por un grafo de vecinos en capas | Memoria, construcción lenta |
| IVF | Recorre solo los clústeres más cercanos | Menos recall a igual velocidad |
| PQ | Compara códigos cortos comprimidos | Distancias aproximadas |
HNSW (hierarchical navigable small world, un grafo jerárquico navegable de «mundo pequeño») lo describieron Yury Malkov y Dmitry Yashunin en un artículo de 2016. Cada vector está enlazado con algunos de sus vecinos, y unos pocos vectores elegidos al azar aparecen también en capas superiores más dispersas. Una búsqueda empieza arriba, da saltos largos por la colección y luego baja capa a capa hacia vecindarios más finos, de modo que el trabajo crece más o menos con el logaritmo del tamaño de la colección y no con el tamaño mismo. El precio es la memoria de todos esos enlaces y una construcción más lenta.
IVF (inverted file index, índice de archivo invertido) agrupa los vectores en clústeres con k-means al construir el índice, como describe el artículo sobre la biblioteca Faiss. Una consulta se compara primero con los centros de los clústeres y después solo con los vectores de los pocos clústeres más cercanos; el número de clústeres que se recorren, a menudo llamado nprobe, es el principal control del recall.
La cuantización de producto (product quantization, PQ), presentada por Hervé Jégou, Matthijs Douze y Cordelia Schmid en un artículo de 2011, comprime los propios vectores. Divide cada vector en subvectores cortos y sustituye cada subvector por el número de la entrada más cercana en un pequeño libro de códigos aprendido. Un vector de 768 números guardados como flotantes de 4 bytes ocupa 3.072 bytes; como 64 códigos de un byte ocupa 64 bytes, a cambio de distancias aproximadas. Muchos sistemas guardan los vectores completos en disco y los usan para reordenar la lista corta.
¿Cómo funciona el filtrado por metadatos en una base de datos vectorial?
El filtrado por metadatos limita una búsqueda vectorial a los elementos que cumplen condiciones exactas, como idioma, país, fecha, precio o permisos de acceso. Convierte «los 10 pasajes más cercanos» en «los 10 pasajes más cercanos en alemán, actualizados este año, que este usuario puede leer».
Importa dónde se aplica el filtro. Si la base de datos primero encuentra los candidatos más cercanos y después elimina los que no pasan el filtro, un filtro estricto puede dejar muy pocos resultados: la documentación de pgvector muestra una búsqueda HNSW con la configuración por defecto y una condición que cumple el 10 % de las filas que devuelve, de media, solo unas 4 filas. Su versión 0.8.0 añadió los escaneos iterativos del índice (iterative index scans), que siguen buscando hasta que pasan suficientes filas; otros sistemas filtran durante la propia búsqueda en el grafo o en los clústeres. En cualquier caso, prueba tus filtros reales más estrictos.
¿Qué es la búsqueda híbrida en una base de datos vectorial?
La búsqueda híbrida ejecuta una búsqueda por palabras clave y una búsqueda vectorial sobre la misma colección y fusiona las dos listas de resultados. Los vectores encuentran paráfrasis; las palabras clave encuentran cadenas exactas como números de pedido, códigos de error y nombres de producto, que los embeddings tienden a difuminar. Muchas bases de datos vectoriales guardan un índice de palabras clave o vectores dispersos (vectores largos con casi todo ceros, una posición por palabra) junto a los embeddings para que una sola consulta pueda usar ambos; si no, la propia aplicación fusiona las dos listas.
¿Necesitas una base de datos vectorial dedicada o una extensión vectorial?
Necesitas una base de datos vectorial dedicada cuando los vectores son una parte central, grande y muy usada de tu sistema; cuando son una columna más junto a datos que ya guardas, suele bastar una extensión vectorial o una biblioteca. La decisión depende de la operación del sistema, no de una clasificación de productos.
- Una extensión vectorial en tu base de datos actual. pgvector, por ejemplo, añade a PostgreSQL un tipo vectorial, operadores de distancia e índices HNSW e IVFFlat. Su búsqueda es exacta por defecto, una columna
vectorsimple guarda hasta 16.000 dimensiones y se puede indexar hasta 2.000, y los filtros, los joins, las copias de seguridad y las reglas de acceso siguen siendo los que ya tienes. - Una base de datos vectorial dedicada. Un sistema aparte construido en torno a la búsqueda ANN, con su propio escalado, replicación, filtrado y funciones híbridas. Compensa con colecciones muy grandes, muchas consultas por segundo, actualizaciones frecuentes o varias aplicaciones que comparten un mismo índice.
- Una biblioteca dentro de tu programa. Faiss, por ejemplo, construye índices y busca en ellos en memoria, sin servidor. Encaja en trabajos por lotes y en la detección de duplicados sin conexión, pero el almacenamiento, las actualizaciones y el filtrado corren por tu cuenta.
A veces no necesitas ninguna. Hasta unos cientos de miles de vectores se pueden buscar de forma exacta; nuestro recorrido de 100.000 vectores tardó unos 40 milisegundos en JavaScript puro. Una búsqueda por SKU o número de pedido, o «pedidos de más de 500 unidades el mes pasado», es una consulta por palabras clave o SQL y nunca debería ser «casi correcta». Empieza donde ya viven tus datos y cambia solo cuando el recall y la latencia medidos te lo indiquen.
¿Cuánta memoria necesita una base de datos vectorial?
Los vectores en bruto necesitan número de vectores × dimensiones × bytes por número, antes de cualquier índice. Con los habituales flotantes de 4 bytes, un millón de vectores de 768 dimensiones ocupa unos 3,1 GB, y un millón de vectores de 1.536 dimensiones, unos 6,1 GB; diez millones de estos últimos ocupan unos 61 GB.
El índice se suma a eso: un grafo HNSW guarda una lista de IDs de vecinos para cada vector, y una búsqueda rápida espera tener el grafo, y normalmente también los vectores, en la RAM. Los números de media precisión (2 bytes en lugar de 4), los códigos de cuantización de producto y un modelo con menos dimensiones reducen la factura, y cada uno puede costar algo de recall, así que mide antes y después.
Volver a generar los embeddings es el costo oculto. Un modelo de embeddings nuevo hace que cada vector guardado deje de ser comparable con las consultas nuevas, así que hay que convertir de nuevo toda la colección y reconstruir el índice.
¿Dónde se usan las bases de datos vectoriales?
Las bases de datos vectoriales se usan siempre que una aplicación tiene que encontrar «cosas como esta» entre muchos elementos.
RAG y asistentes de IA. En la generación aumentada por recuperación (RAG), la base de datos vectorial encuentra los pasajes más relacionados con la pregunta de un usuario y se los pasa a un modelo de lenguaje grande, que redacta la respuesta a partir de ellos y puede citar sus fuentes.
Búsqueda, recomendaciones y duplicados. El buscador de un centro de ayuda o de una tienda encuentra páginas por significado; los «productos similares» son los vecinos más cercanos del artículo que se acaba de ver; dos tickets o anuncios que dicen lo mismo con otras palabras quedan tan cerca que un umbral de distancia los marca como duplicados. Los modelos que convierten imágenes y texto al mismo espacio permiten además que una consulta de texto encuentre fotos que encajan.
¿De dónde salen las páginas de origen de los vectores?
Un índice vectorial vale lo que vale el contenido que tiene detrás. Cuando un asistente responde a partir de páginas web públicas, como documentación de productos, precios o normativas locales, esas páginas hay que recopilarlas, limpiarlas y volver a descargarlas cuando cambian; cómo convertir HTML en fragmentos limpios con su fuente se explica en Web scraping para RAG.
Muchas páginas públicas también cambian según el país del visitante: precios, existencias, plazos de entrega e incluso el idioma del texto. Si tus usuarios están en Alemania y el índice contiene la versión que vio un servidor de otro país, los vecinos más cercanos estarán equivocados con total seguridad. Recopilar las páginas públicas a través de Proxies residenciales con IPs en el país de destino, con segmentación por país y ciudad, mantiene la copia indexada cerca de lo que ven los visitantes locales.
Los equipos que prefieran no encargarse ellos mismos de esa recopilación pueden preguntar por nuestra Web Scraping API, un servicio gestionado de extracción de páginas disponible a través del equipo de ventas y descrito en la página de extracción de datos. Recopiles como recopiles, respeta el robots.txt, los términos y los límites de frecuencia de cada sitio, y deja los datos personales fuera del índice salvo que tengas una base legal para tratarlos.
Errores comunes
- Mezclar modelos o versiones de embeddings. Los vectores de modelos distintos no se pueden comparar; cambiar de modelo obliga a volver a generar todos los embeddings.
- Usar la medida de similitud equivocada. Usa aquella con la que se entrenó el modelo, y la misma para indexar y para consultar.
- Fiarse de la configuración por defecto del índice. Mide el recall a 10 frente a una búsqueda exacta con una muestra de consultas reales y después ajusta los parámetros del grafo o de los clústeres.
- Probar sin filtros. Un filtro de metadatos estricto puede reducir la lista de resultados a un puñado de elementos; prueba los filtros que los usuarios aplican de verdad.
- No fijar un umbral de similitud. Los vecinos más cercanos siempre existen, así que sin una puntuación mínima un asistente responde a partir de pasajes que solo son los menos irrelevantes.
- Olvidar los borrados y los permisos de acceso. Los documentos borrados o restringidos siguen apareciendo en las búsquedas hasta que se eliminan o se filtran sus vectores.
Guía de decisión
| Tu situación | Qué usar |
|---|---|
| Menos de unos cientos de miles de vectores | Búsqueda exacta o una extensión vectorial |
| Datos ya en PostgreSQL | pgvector, con un índice HNSW cuando haga falta |
| Millones de vectores, muchas consultas | Una base de datos vectorial dedicada |
| Trabajos por lotes sin conexión o investigación | Una biblioteca en memoria como Faiss |
| Los usuarios también buscan códigos y nombres | Búsqueda híbrida, palabras clave más vectores |
| Filtros estrictos en la mayoría de consultas | Un sistema que filtre durante la búsqueda |
| La memoria es el límite | Media precisión o cuantización de producto |
| Respuestas sacadas de páginas web públicas | Recopilar y actualizar las páginas por mercado |
Preguntas frecuentes
¿Qué diferencia hay entre una base de datos vectorial y un vector store?
«Vector store» (almacén de vectores) es un término más laxo para cualquier cosa que guarde embeddings y devuelva los más cercanos, desde una lista en memoria hasta una base de datos completa. Una base de datos vectorial añade la parte de base de datos: persistencia, actualizaciones y borrados, filtros, control de acceso, copias de seguridad y escalado. Muchos frameworks de IA llaman «vector store» a la interfaz que se pone delante de cualquiera de los dos.
¿Necesito una base de datos vectorial para RAG?
No siempre. RAG necesita un paso de recuperación, y para una colección modesta puede ser una búsqueda exacta en memoria, una extensión vectorial en tu base de datos actual o un índice de palabras clave. Una base de datos vectorial dedicada empieza a ser útil cuando la colección es grande, cambia a menudo o atiende a muchos usuarios con filtros estrictos.
HNSW o IVF: ¿qué índice es mejor?
Ninguno es mejor en todos los casos. HNSW suele dar más recall a la misma velocidad, pero usa más memoria y se construye más despacio; IVF se construye más rápido y usa menos memoria, y combinado con la cuantización de producto permite meter colecciones muy grandes en una RAM limitada. Prueba los dos con tus propios datos y filtros.
¿Qué diferencia hay entre una base de datos vectorial y una base de datos de grafos?
Una base de datos de grafos guarda relaciones explícitas, como «este cliente compró este producto», y las recorre. Una base de datos vectorial guarda similitud implícita: los elementos están «relacionados» porque sus vectores están cerca. Algunos sistemas combinan ambas cosas y usan los vectores para encontrar un punto de partida y el grafo para seguir conexiones conocidas.
¿Cuál es un ejemplo de base de datos vectorial?
pgvector es un ejemplo de código abierto de la vía de la extensión: añade búsqueda vectorial a PostgreSQL. Faiss es un ejemplo de la vía de la biblioteca, y varios sistemas de código abierto y gestionados son bases de datos vectoriales dedicadas. Cuál encaja depende del tamaño de tus datos, de tus filtros y de lo que ya tienes en marcha.
¿Cuántas dimensiones deberían tener mis vectores?
El modelo de embeddings decide el número de dimensiones, normalmente entre unos cientos y unos pocos miles. Más dimensiones pueden recoger más detalle, pero cuestan proporcionalmente más memoria, así que compara un modelo más pequeño con uno más grande en tus propias consultas de prueba antes de pagar por el índice más grande.
En resumen
Una base de datos vectorial guarda embeddings con un ID y metadatos y encuentra los elementos más parecidos a un vector de consulta. La búsqueda exacta sirve para colecciones pequeñas; a gran escala, los grafos HNSW, los clústeres IVF y la cuantización de producto cambian un poco de recall por respuestas mucho más rápidas, así que ajústalos con tus propias consultas y filtros. Empieza con la base de datos que ya usas, añade búsqueda híbrida para las cadenas exactas y calcula la memoria como vectores × dimensiones × bytes. Cuando el índice se construye a partir de páginas web públicas, mantener esas páginas actualizadas y con la versión correcta de cada país es la mitad del trabajo.