Bir destek ekibi, desteklediği ürünlerin herkese açık dokümantasyonundan cevap veren bir asistan istiyor. İlk sürüm sayfaları Requests ile indirip HTML'i olduğu gibi modele veriyor. Cevaplar çerez bildirimini alıntılıyor, menü prompt'ta makaleden daha çok yer kaplıyor, metnini JavaScript ile yükleyen sayfalar boş geliyor ve geçen hafta değişen bir sayfa hâlâ eski kopyasından cevaplanıyor. Modelde bir sorun yok. Veri hiç hazırlanmamış.
Bu yazı o hazırlığı anlatıyor: RAG nedir, web sayfaları neden hazırlanması en zor kaynaktır, Markdown neden hem HTML'den hem düz metinden iyidir, sayfayı getirmekten yenilemeye uzanan hat nasıl kurulur, gerçek bir sayfa üzerinde 58 satırlık bir Python betiğiyle ölçülmüş bir örnek ve web scraping (veri kazıma) API'leri ile proxy'lerin bu hattın neresinde durduğu. Betiği 9 Kasım 2026'da trafilatura 2.3.1, tiktoken 0.14.0 ve Python 3.13 ile çalıştırdık.
RAG nedir ve ne işe yarar?
RAG, açılımıyla retrieval-augmented generation (getirmeyle zenginleştirilmiş üretim), bir dil modeline cevap verdirirken bilgiyi yalnızca modelin eğitiminden değil, soru anında getirilen belgelerden alan yöntemdir. Bir arama bileşeni (retriever) pasajlardan oluşan bir indeksi tarar, en iyi eşleşmeler prompt'a girer ve model cevabını bunlardan yazar. İndekste metne çevrilmiş her şey durabilir: PDF'ler, destek kayıtları, veritabanı satırları ve web sayfaları.
Adı, Patrick Lewis, Ethan Perez, Aleksandra Piktus ve arkadaşlarının 2020 tarihli Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks makalesinden geliyor. Makale, bilgisi parametrelerinde duran önceden eğitilmiş bir diziden diziye modeli, bir sinirsel arama bileşeninin okuduğu yoğun bir Wikipedia vektör indeksiyle eşliyor; yazarlar buna parametrik olmayan bellek diyor. Makalenin saydığı iki sorun, web içeriğinin ortaya çıkardığı sorunların ta kendisi: modelin bildiğini güncellemek ve cevabın nereden geldiğini göstermek. İnce ayar (fine-tuning) bilgiyi modelin ağırlıklarına işler; her sayfa değişikliği yeni bir eğitim turu demektir ve gösterilecek kaynak yoktur. RAG'de değişen sayfa yeniden getirilip yeniden indekslenir ve her cevap URL'sini ve bölümünü taşıyabilir.
Web sayfaları neden en zor RAG kaynağıdır?
Web sayfaları zordur, çünkü istediğiniz içerik sunucunun gönderdiğinin küçük bir bölümüdür. Bir dokümantasyon sayfası gezinme ağacı, üst bilgi, alt bilgi, çerez bildirimi, paylaşım düğmeleri ve "ilgili yazılar" taşır; naif bir hat bunların hepsini makalenin yanına indeksler. Kullanıcı hız sınırını sorduğunda arama bileşeni çerez bildirimini getirir, çünkü içinde "sınır" sözcüğü geçer.
Üç sorun daha web'e özgüdür. Birçok sayfa metnini JavaScript ile yükler; indirdiğiniz HTML'de bir başlık ve boş bir div vardır. Aynı makale çoğu zaman birden fazla URL'de yaşar: izleme parametreleri, yazdırma görünümü, http ile https, sondaki eğik çizgi. Böylece aynı pasaj indekse üç kez girer ve ilk sonuçları kendi kopyalarıyla doldurur. Sayfalar da sessizce değişir: mart ayında indekslediğiniz PDF hâlâ o PDF'dir, fiyat sayfası değildir. Buna bir belgeyi birkaç sayfaya bölen sayfalandırmayı ve — işaretini — yapan kodlama hatalarını ekleyin; karşınızda sıradan bir herkese açık sitenin olağan hâli var.
Neden HTML ya da düz metin değil, Markdown?
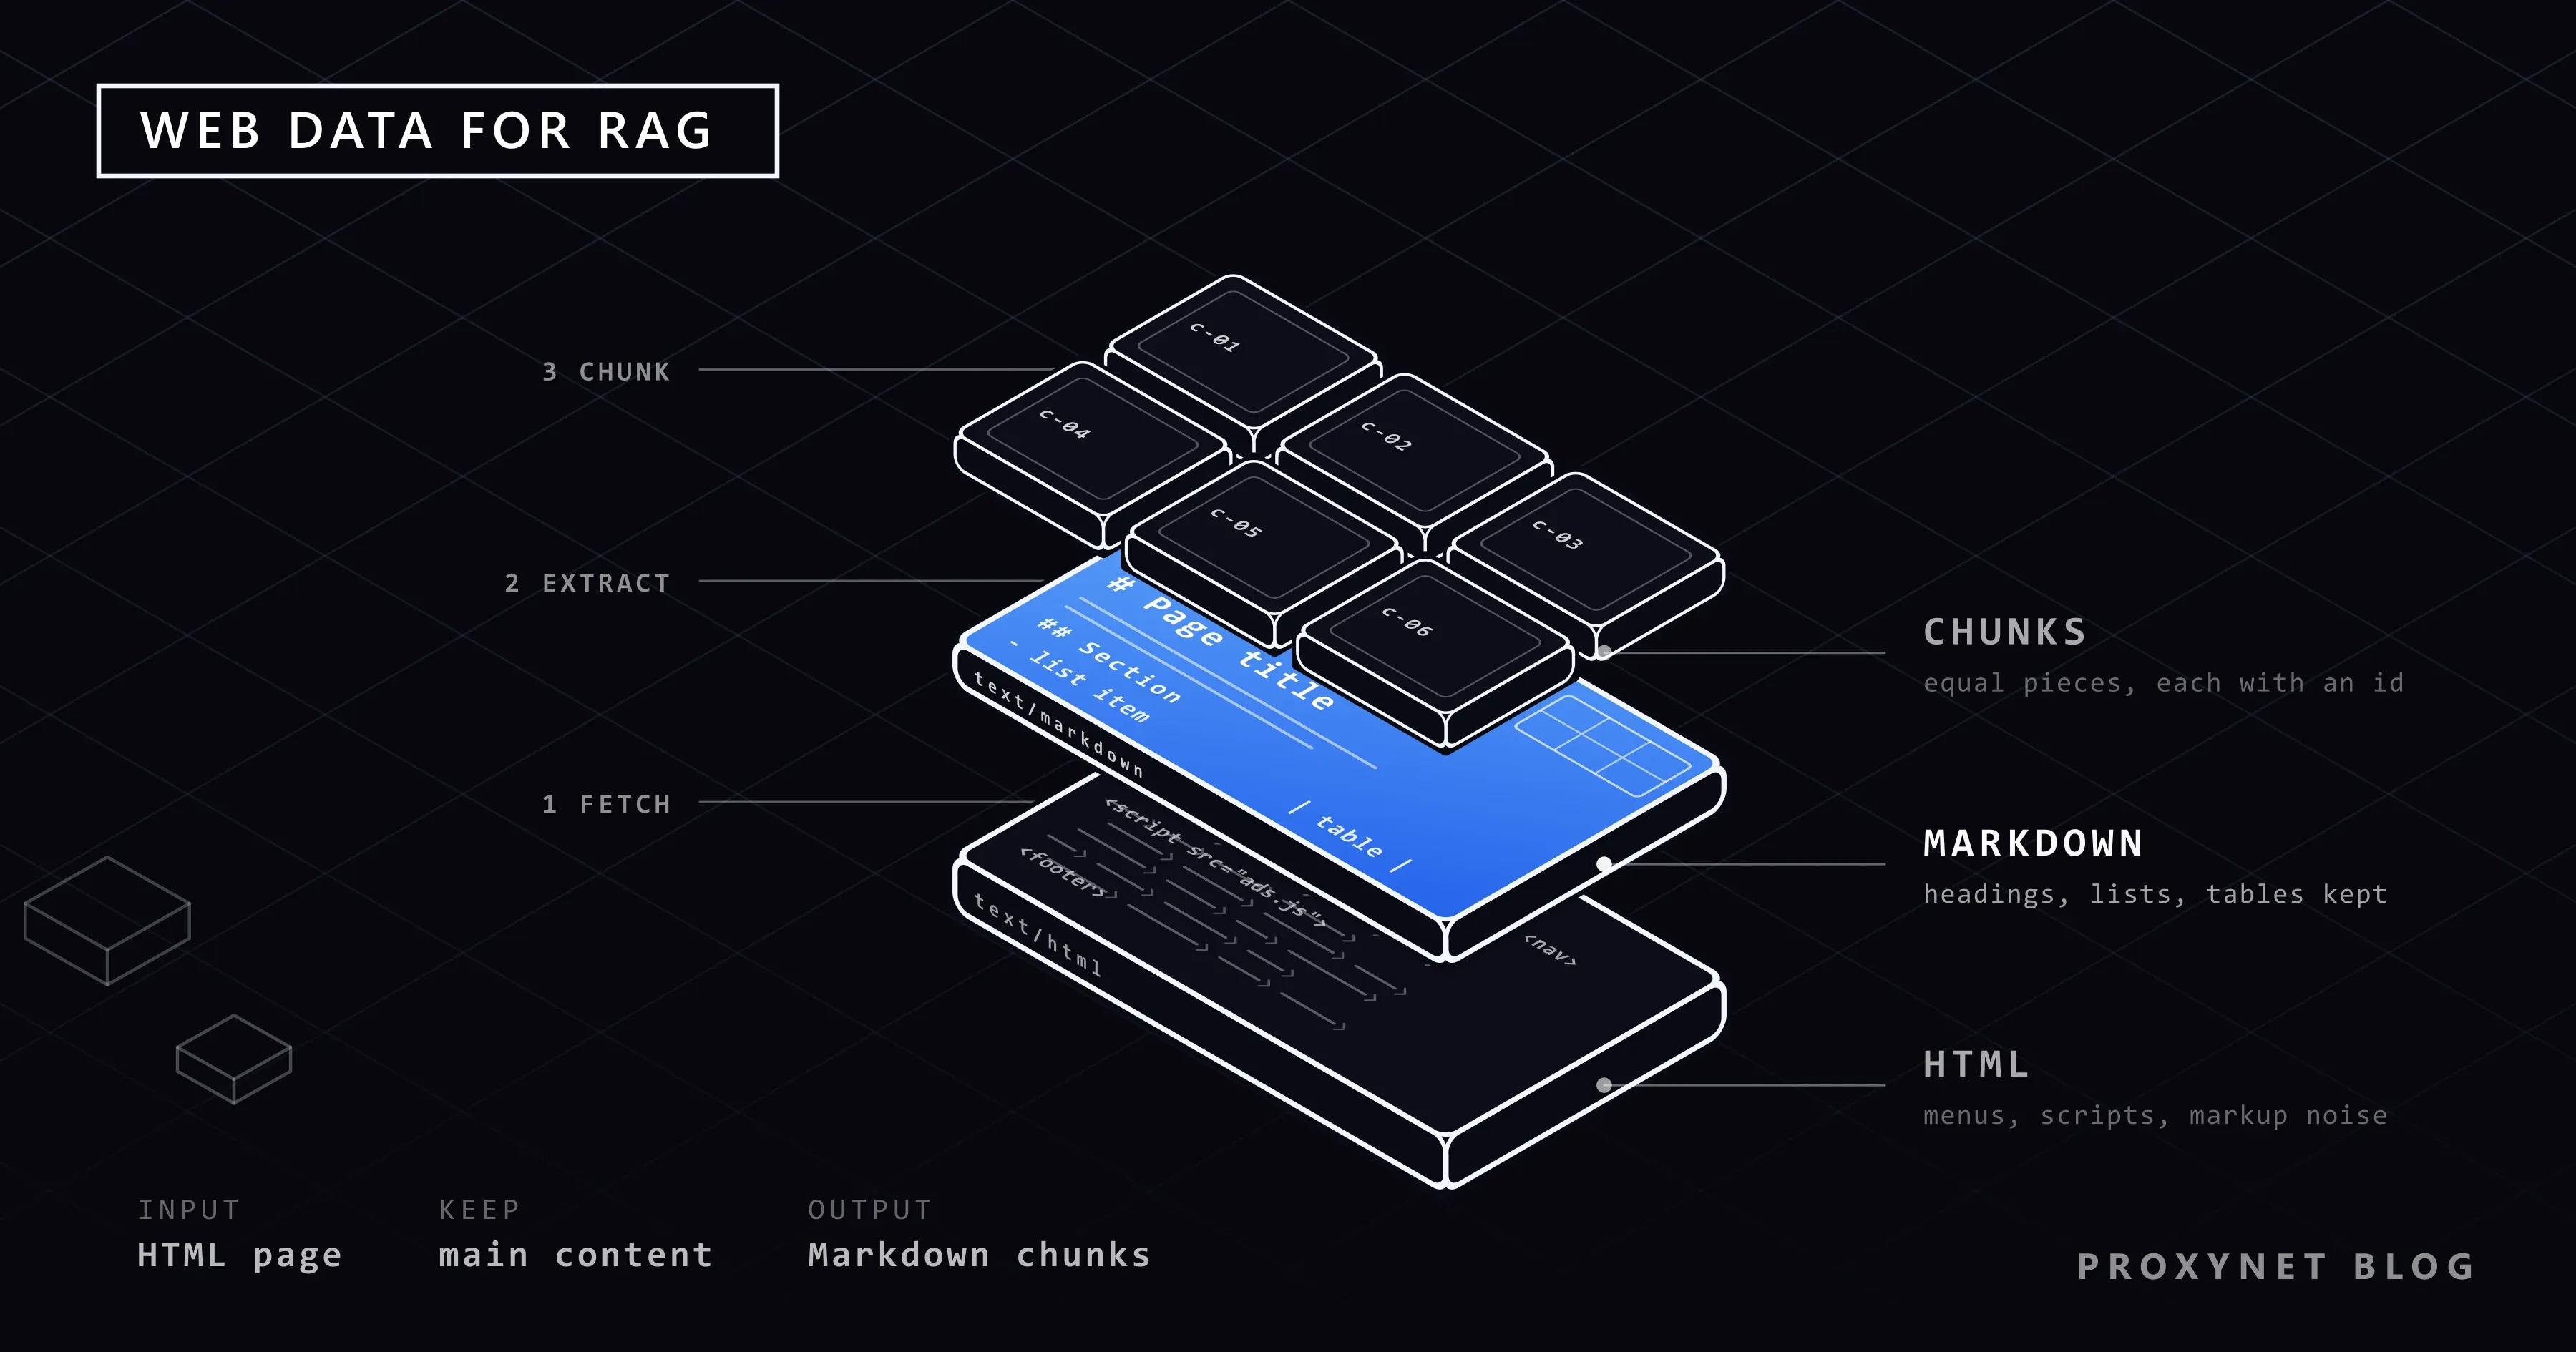
Markdown doğru ara biçimdir, çünkü arama bileşeninin ve modelin ihtiyaç duyduğu yapıyı (başlık, liste, tablo, kod bloğu, link) korurken anlam taşımayan işaretlemeyi, betikleri ve stilleri atar. HTML, token'larının çoğunu etiketlere ve özniteliklere harcar. Düz metin ise öbür uca savrulur: tablo bir sözcük yığınına döner, başlık herhangi bir satır gibi görünür ve parçayı kesecek güvenilir bir yer kalmaz. Sitelerden sayfalarının Markdown sürümlerini yayımlamalarını isteyen llms.txt önerisi bunu açıkça söylüyor: "At the moment the most widely and easily understood format for language models is Markdown" (şu anda dil modellerinin en yaygın ve en kolay anladığı biçim Markdown'dır).
Farkı gerçek bir sayfada ölçtük: Python dokümantasyonunun urllib ile internet kaynaklarını getirme HOWTO sayfası, tiktoken'ın o200k_base tokenizer'ıyla. Sayılar bu sayfayı anlatır, genel olarak web'i değil.
| Biçim | Ne kalır | Test sayfasında token | Parça nereden kesilir |
|---|---|---|---|
| Ham HTML | Menüler, betikler ve işaretleme dahil her şey | 21.044 | Anlam hakkında hiçbir şey söylemeyen etiketlerden |
| Düz metin | Yalnızca sözcükler; başlıklar ve tablolar düzleşir | 4.133 | En iyi ihtimalle boş satırlardan |
| Markdown | Başlıklar, listeler, tablolar, kod ve linkler | 4.405 | Başlık satırlarından |
Markdown bu sayfada düz metinden 272 token, yani yaklaşık yüzde 7 daha pahalıya geldi; karşılığında her bölüm başlığı hâlâ bir başlık. Ham HTML'e göre ise 4,8 kat küçük. Bir uyarı: Markdown'ın çekirdeği için bir belirtim var, CommonMark (sürüm 0.31.2, Ocak 2024); ama dikey çizgili tablolar ve çitli kod blokları GitHub'ın yaygınlaştırdığı uzantılardır. Dönüştürücünüzün bunları atmak yerine yazdığını kontrol edin.
Web'den RAG'e veri hattı nasıl çalışır?
Hat on adımdan oluşur ve sıra önemlidir, çünkü her adım bir öncekine dayanır.
- Yalnızca getirmenize izin verileni getirin. İlk istekten önce sitenin robots.txt dosyasını okuyun ve yasaklı yolları atlayın; kuralları robots.txt rehberimizde anlattık. Kullanım şartlarını okuyun, botunuzun adını ve bir iletişim adresini taşıyan bir
User-Agentgönderin, alan adı başına nazik bir hız tutun. Site sayfalarının Markdown sürümlerini yayımlıyorsa HTML ayrıştırmak yerine onları kullanın. - Ana içeriği çıkarın. trafilatura, Apache 2.0 lisanslı bir Python paketi ve komut satırı aracıdır; ham HTML'i metne, Markdown'a, XML'e ya da JSON'a çevirir, başlığı, yazarı ve tarihi de çıkarır. Mozilla Readability, Firefox'un okuyucu görünümünün (Reader View) arkasındaki JavaScript kütüphanesidir;
new Readability(document).parse()başlığı, temizlenmiş içeriği ve yazar satırını döndürür. İkisi de siteye özel bir ayrıştırıcı olmadan, yapıdan ve metin yoğunluğundan çalışır. - Markdown'a çevirin. trafilatura
output_format="markdown"ile doğrudan Markdown yazar. Elinizde temizlenmiş HTML varsa Python'da markdownify, JavaScript'te Turndown onu çevirir; ATX biçimli#başlıkları seçin, çünkü parçalayıcı onlardan böler. İçeriğini JavaScript ile kuran sayfalar için tarayıcı gerekir: Crawl4AI sayfayı Chromium'da işler ve menüsüz bir "fit" Markdown döndürür; Crawl4AI rehberimizde gösterdik. - Temizleyin. Çıkarıcının bıraktıklarını silin: başlıkların ardındaki çapa işaretleri, "Bu sayfayı düzenle" linkleri, gezinti satırları, çoğalmış boşluklar. Kodlamayı metinde değil kaynağında düzeltin. Kod bloklarına ve tablolara dokunmayın.
- Başlıklardan, bir token bütçesi içinde parçalayın. Bir başlık satırının başladığı yerden kesin, başlık yolunu üst veri olarak saklayın (
Fetching URLs > Data) ve bütçeyi aşan bölümleri paragraf sınırlarından bölün. Token'ları embedding için kullanacağınız modelin tokenizer'ıyla sayın; tiktoken OpenAI modellerinin hızlı BPE tokenizer'ıdır veo200k_base, README'sinin kullandığı kodlamadır. Karakter sayısı token'ın yerini tutmaz: 500 karakter İngilizce düzyazıda yaklaşık 100 token eder, kodda çok daha fazla. - Yinelenen parçaları ayıklayın. Normalleştirilmiş parça metninin özetini (hash) alın; özeti aynı olan iki parça, hangi URL'den gelirse gelsin aynı pasajdır. Aynı sayfanın farklı bir "son güncelleme" satırı taşıyan kopyası gibi yakın kopyalar için sözcük dizileri ya da embedding'ler üzerinde bir benzerlik testi gerekir.
- Köken bilgisi ekleyin. Her parça URL'sini, getirme zamanını, sayfa başlığını, bölüm yolunu, içerik özetini ve token sayısını taşır. Bunlar olmadan ne kaynak gösterebilir ne yenileyebilir ne de silebilirsiniz.
- Embedding üretin ve indeksleyin. Her parça bir vektör indeksinde bir vektöre dönüşür; birçok ekip yanına bir anahtar sözcük indeksi ekleyip iki sonuç listesini birleştirir. Hangi modeli ve veritabanını seçtiğiniz yukarıdaki adımları değiştirmez.
- Yenileyin.
ETagveLast-Modifiedbaşlıklarını saklayın, bir sonraki ziyaretteIf-None-Matchya daIf-Modified-Sincegönderin;304 Not Modifiedcevabı neredeyse bedavadır ve test sayfamız iki başlığı da gönderdi. Önce neye bakacağınıza site haritasındakilastmodtarihleriyle karar verin, parçaları URL ve bölüme göre değiştirin, artık 404 ya da 410 dönen sayfaların parçalarını silin. - Getirmeyi değerlendirin. Her birinin cevabını içeren pasajla birlikte 30-50 gerçek soru yazın ve doğru parçanın ilk sonuçlar arasında ne sıklıkla çıktığını ölçün. Parça boyutunu, örtüşmeyi ve bütçeyi hisle değil, bu sayıya göre ayarlayın.
Test edilmiş örnek: bir sayfa HTML'den Markdown parçalarına
Betik ilk yedi adımı tek bir sayfada çalıştırıp bulduklarını yazdırıyor. Python dokümantasyonundan bir sayfa seçtik; sitenin robots.txt dosyası /dev, /release ve /3.10/ gibi eski sürüm yollarını yasaklıyor, /3/ yoluna izin veriyor (9 Kasım 2026'da kontrol ettik). Betik getirmeden önce bunu urllib.robotparser ile bir kez daha kontrol ediyor.
python -m venv .venv
.venv/bin/pip install trafilatura tiktoken requests   # Windows: .venv\Scripts\pip
İki ayrıntı kodun iki satırını açıklıyor. docs.python.org, Content-Type: text/html başlığını karakter kümesi belirtmeden gönderiyor; bu yüzden Requests'in resp.text özelliği sayfayı ISO-8859-1 olarak çözer ve her başlığın sonunda fazladan bir  kalır. Sayfa <meta charset> etiketinde UTF-8 bildirdiği için betik baytları kendisi çözüyor. Ayrıca dokümantasyon üreteci her başlığın ardına çapa linki olarak bir paragraf işareti (¶) bırakıyor ve trafilatura bunu metin olarak tutuyor; temizleme adımı onu siliyor. Üçüncü bir ayrıntı parçalama için önemli: sayfada 17 çitli kod bloğu var ve içlerindeki Python yorumları # ile başlıyor. Her # satırından bölen bir parçalayıcı kodun ortasını keser ve yorumları başlık sanır. Betik her çitli bloğu bütün tutuyor.
"""Herkese açık bir sayfayı getir, ana içeriğini Markdown olarak tut, başlıklardan parçala ve token say."""
import hashlib, json, re, sys
from datetime import datetime, timezone
from urllib.parse import urlsplit
from urllib.robotparser import RobotFileParser
import requests
import tiktoken
import trafilatura

URL = sys.argv[1] if len(sys.argv) > 1 else "https://docs.python.org/3/howto/urllib2.html"
UA = "rag-prep-demo/1.0 (+https://example.com/bot)"
BUDGET = 512                                  # parça başına en çok token; uzun bölümler paragraftan bölünür
enc = tiktoken.get_encoding("o200k_base")     # OpenAI'ın güncel modellerinin tokenizer'ı
tokens = lambda s: len(enc.encode(s))

# 1. önce robots.txt: yol bizim user agent için yasaklıysa dur
robots = RobotFileParser(urlsplit(URL)._replace(path="/robots.txt", query="", fragment="").geturl())
robots.read()
if not robots.can_fetch(UA, URL):
    sys.exit(f"robots.txt disallows {URL}")

# 2. tek getirme, aynı sayfanın üç görünümü: ham HTML, Markdown olarak ana içerik, düz metin
resp = requests.get(URL, headers={"User-Agent": UA}, timeout=30)
resp.raise_for_status()
html = resp.content.decode("utf-8")           # sayfa UTF-8 bildiriyor; resp.text ISO-8859-1 tahmin ederdi
fetched_at = datetime.now(timezone.utc).isoformat(timespec="seconds")
md = trafilatura.extract(html, url=URL, output_format="markdown", include_tables=True, include_formatting=True)
md = md.replace("¶", "")                 # temizlik: Sphinx her başlığın ardına paragraf işareti bırakır
txt = trafilatura.extract(html, url=URL, output_format="txt", include_tables=True)
title = trafilatura.extract_metadata(html, default_url=URL).title

# 3. bloklara ayır (paragraflar, başlık satırları, bütün kod çitleri), sonra başlıklardan ve bütçeden kes
blocks = []
for seg in re.split(r"(```[\s\S]*?```)", md.strip()):           # çitli kod bloğu tek bloktur, asla kesilmez
    blocks += [seg] if seg.startswith("```") else [p.strip() for p in re.split(r"\n\s*\n|\n(?=#{1,6} )", seg) if p.strip()]
chunks, path, piece = [], [], ""
for block in blocks + ["# end"]:                                 # nöbetçi başlık son parçayı kapatır
    head = re.match(r"(#{1,6}) (.+)", block)
    if head or (piece and tokens(piece + "\n\n" + block) > BUDGET):
        if piece:
            chunks.append((list(path), piece))                   # altında metin olmayan başlık parça üretmez
        piece = "" if head else block
    else:
        piece = f"{piece}\n\n{block}".strip()
    if head:
        path = path[:len(head.group(1)) - 1] + [head.group(2).strip()]

# 4. köken bilgisi: her parça nereden, ne zaman geldiğini ve tekilleştirme için bir özet taşır
records = [{"url": URL, "fetched_at": fetched_at, "title": title, "section": " > ".join(p[1:]) or "(top)",
            "content_hash": hashlib.sha256(text.encode()).hexdigest()[:16], "tokens": tokens(text), "text": text}
           for p, text in chunks]

print(f"page: {title}\nfetched: {fetched_at}")
print(f"tokens (o200k_base): html={tokens(html)}  markdown={tokens(md)}  text={tokens(txt)}")
sizes = sorted(r["tokens"] for r in records)
print(f"chunks: {len(records)}  min={sizes[0]}  median={sizes[len(sizes) // 2]}  max={sizes[-1]}  budget={BUDGET}")
print("\n".join(f"  {r['tokens']:>4} tok  {r['content_hash']}  {r['section'][:60]}" for r in records[:6]))
print(json.dumps({k: v for k, v in records[1].items() if k != "text"}, indent=2))
Bastığı çıktı:
page: HOWTO Fetch Internet Resources Using The urllib Package
fetched: 2026-11-09T12:32:13+00:00
tokens (o200k_base): html=21044  markdown=4405  text=4133
chunks: 19  min=10  median=183  max=495  budget=512
   276 tok  e21a9bc9bc9dc71b  Introduction
   460 tok  30fc2c8722d53c1a  Fetching URLs
   434 tok  51aca2bdee7780e4  Fetching URLs > Data
   144 tok  f8e6254387670d87  Fetching URLs > Data
   329 tok  3b49bcc1ef1326f3  Fetching URLs > Headers
    79 tok  3928e9cb23c19eee  Handling Exceptions
{
  "url": "https://docs.python.org/3/howto/urllib2.html",
  "fetched_at": "2026-11-09T12:32:13+00:00",
  "title": "HOWTO Fetch Internet Resources Using The urllib Package",
  "section": "Fetching URLs",
  "content_hash": "30fc2c8722d53c1a",
  "tokens": 460
}
Sayfa, medyanı 183 token olan 19 parçaya bölündü ve hiçbiri 512 token'lık bütçeyi aşmadı. "Fetching URLs > Data" iki kez görünüyor, çünkü o bölüm bütçeden uzundu ve bir paragraf sınırından 434 ve 144 token'lık iki parçaya kesildi; iki parça aynı bölüm yolunu paylaşıyor ama özetleri farklı, tekilleştirme adımının ihtiyacı da tam olarak bu. En küçük parça 10 token: sayfanın tek cümlelik "Footnotes" bölümü. Canlı bir hat bunu komşusuyla birleştirirdi. Özgün sayfanın kenar çubuğu, önceki ve sonraki sayfa linkleri ve alt bilgisi Markdown'da hiç yok; çıkarıcı işini yapmış. JSON kaydı, parçayla birlikte indekse giden köken bilgisidir; birçok ekip embedding üretmeden önce bölüm yolunu da metnin başına ekler.
Scraping API'leri nerede devreye girer?
Scraping API'si, sayfayı işleme, ana içeriği çıkarma ve nezaket kurallarına uyma işini başkasına bırakmak istediğinizde devreye girer. Çoğu doğrudan Markdown döndürür, JavaScript'li sayfaları tarayıcıda işler ve alan adı başına istek hızını yönetir; böylece hattınız parçalama adımından başlar. Dört kontrol, bir servisin RAG derlemine uyup uymadığını söyler: tanıdığınız on sayfayı getirip Markdown'da menü kalıp kalmadığına ve tabloların bütün gelip gelmediğine bakın; başlığın, kanonik URL'nin ve varsa son değişiklik tarihinin içerikle birlikte geldiğinden emin olun, çünkü bunlar köken bilgisine dönüşür; değişmemiş aynı sayfayı iki kez çekip çıktıları karşılaştırın, yoksa özetleriniz her sayfayı değişmiş sayar; servisin robots.txt ve hız sınırlarına nasıl davrandığını sorun, çünkü istekler sizin adınıza yapılıyor.
Proxy nerede işe yarar?
Proxy bu hatta iki durumda işe yarar ve ikisi de tek bir siteden daha hızlı çekmekle ilgili değildir. Birincisi genişlik: bir RAG derlemi çoğu zaman yüzlerce alan adına yayılır ve her alan adının hızına saygı gösteren bir crawler yine de birçok alan adını aynı anda gezebilir. Bu getirmeleri birden fazla çıkış adresine dağıtmak, örneğin bir Rotating Proxy üzerinden, her bir alan adının yavaş ve nazik bir istemci görmesini sağlarken işin tamamı günler yerine saatler içinde biter.
İkincisi konum. Dokümantasyon, yardım ve fiyat sayfaları çoğu zaman ziyaretçinin ülkesine ya da diline göre değişir; yanlış sürümden kurulan bir indeks kullanıcılara hiç görmedikleri içerikten cevap verir. Kullanıcılarınızın bulunduğu ülkeden, ülke hedeflemeli bir Residential Proxy ile getirmek, onların gerçekten okuyacağı sayfayı indeksler. İstek hangi adresten çıkarsa çıksın robots.txt, site şartları ve istek hızı aynı kalır.
Sık yapılan hatalar
- Başlıkları gözetmeden karakter sayısına göre parçalamak. İki bölümün üstüne oturan 1.000 karakterlik bir pencere iki soruya da cevap vermez. Önce başlıklardan, sonra paragraflardan kesin.
- Kalıp içeriği indekslemek. Çerez bildirimleri, menüler ve alt bilgiler her şeyle biraz, hiçbir şeyle tam eşleşen parçalara dönüşür.
- Köken bilgisi tutmamak. URL, getirme zamanı ve bölüm olmadan kaynak gösteremez, değişen sayfayı yenileyemez, kaldırılan sayfayı silemezsiniz.
- Hiç yenilememek. Bir kez kurulan derlem bir anlık görüntüdür;
ETagveLast-Modifiedile koşullu istekler haftalık yenilemeyi ucuzlatır. - Aynı sayfadan birkaç kez embedding üretmek. İzleme parametreleri, yazdırma görünümleri ve sondaki eğik çizgiler ilk sonuçları dolduran kopyalar yaratır; URL'yi değil içeriği özetleyin.
- Token yerine karakter saymak ya da embedding modelinden farklı bir tokenizer ile saymak.
- Kod bloklarının ve tabloların içinden bölmek. Kodun içindeki bir
#yorumu başlık değildir; yarım tablo hiçbir şeye cevap vermez. - Boş sayfayı indekslemek. İçerik JavaScript ile kuruluyorsa indirilen HTML'de makale yoktur; indekslemeden önce çıkarılan metnin token sayısına bakın.
- robots.txt'nin ya da şartların dışladığını getirmek veya bir insanın okuyacağından hızlı çekmek. Hukuki durum (son SSS sorusu) hacimle düzelmez.
Karar rehberi
| İhtiyaç | Öneri |
|---|---|
| Birkaç yüz dokümantasyon sayfası | trafilatura ile Markdown, 200-500 token'lık başlık parçaları, haftalık yenileme |
| JavaScript ile işlenen sayfalar | Crawl4AI gibi tarayıcı tabanlı bir çıkarıcı ya da Markdown döndüren bir scraping API'si |
| Site Markdown sürümleri ya da llms.txt sunuyor | .md ikizlerini getirin, çıkarma adımını atlayın |
| Cevaplar kaynak göstermeli | Her parçada köken bilgisi: URL, getirme zamanı, başlık, bölüm yolu, özet |
| Aynı pasaj sonuçlarda tekrar tekrar çıkıyor | İçerik özetleri, URL normalleştirme, yakın kopya testi |
| Her biri nazik hızda yüzlerce alan adı | Rotating proxy ile birkaç çıkış üzerinden paralel alan adları |
| Ülkeye özgü dokümantasyon ya da fiyat sayfaları | Ülke hedeflemeli residential proxy |
| Hattı işletecek ekip yok | Üst verisiyle birlikte Markdown teslim eden yönetilen bir scraping API'si |
Sıkça sorulan sorular
RAG'in açılımı nedir, ince ayardan farkı ne?
RAG, retrieval-augmented generation'ın kısaltmasıdır: model, soru anında getirilen pasajlardan cevap verir. İnce ayar modelin ağırlıklarını eğitim verisiyle değiştirir; yeni bilgi yeni bir eğitim turu ister ve model cevabın hangi belgeden geldiğini söyleyemez. RAG bir sayfayı yeniden indeksleyerek güncellenir ve kullandığı URL ile bölümü gösterebilir.
LLM'ler için Markdown neden HTML'den iyidir?
Markdown önemli yapıyı (başlık, liste, tablo, kod) birkaç karakterle korur; HTML ise token'larının çoğunu etiketlere, özniteliklere ve betiklere harcar. Test sayfamızda Markdown 4.405 token iken HTML 21.044 token çıktı ve parçalar yine de başlıklardan kesilebildi.
RAG için ideal parça boyutu nedir?
Tek bir sayı yok; dokümantasyon için işe yarayan aralık, başlıklardan kesilmiş 200-500 token'dır ve doğru değer, kendi getirme testinizde en iyi puanı alandır. Küçük parçalar daha isabetli eşleşir ama bağlamı kaybeder; büyük parçalar bağlamı taşır ama eşleşmeyi sulandırır.
RAG için sayfalar ne sıklıkla yeniden taranmalı?
Sayfalar ne sıklıkla değişiyorsa o sıklıkla; bunu koşullu istekler ucuza söyler: sakladığınız ETag ya da Last-Modified değerini gönderin, 304 Not Modified cevabı hiçbir şeyin değişmediği anlamına gelir. Dokümantasyon genellikle haftalık yeterlidir, fiyat ve durum sayfaları günlük ister; site haritasındaki lastmod tarihleri önce nereye bakacağınızı söyler.
llms.txt scraping'in yerini tutar mı?
Hayır. llms.txt, bir sitenin önemli sayfalarını yapay zekâ araçları için seçilmiş bir dizinde toplar ve aynı öneri sitelerden sayfaların Markdown sürümlerini sunmalarını ister; ikisi de varsa Markdown'ı getirip çıkarma adımını atlarsınız. Çoğu site ikisini de yayımlamaz ve dosya erişim konusunda hiçbir şeyi denetlemez; llms.txt rehberimizde anlattığımız gibi neyi getirebileceğinize yine robots.txt ve site şartları karar verir.
Kazınan web sayfalarını RAG'de kullanmak yasal mı?
Siteye ve ülkeye göre değişir; bu bir açıklamadır, hukuki tavsiye değildir. Genellikle dört şeye bakılır: RFC 9309'un bir erişim yetkisi değil crawler'lara yönelik bir rica olarak tanımladığı robots.txt; çoğu zaman otomatik erişimi yasaklayan kullanım şartları; metni çoğaltmayla ilgili olan ve bir cevabın sayfanın ne kadarını tekrar ettiğine ve kaynak gösterip göstermediğine göre değişen telif hakkı; sayfalardaki kişisel veriler, ki bunları GDPR ve Türkiye'de KVKK düzenler ve bir RAG derlemi hiç toplamamalıdır. Her parçadaki köken bilgisi, talep geldiğinde bir kaynağı kaldırmanızı sağlar. Üçüncü taraf sitelerden bir derlem kurmadan önce bir avukata danışın.
Özet
RAG getirilen pasajlardan cevap verir; cevapların kalitesini pasajların kalitesi belirler. Web kaynakları için bu şu demektir: yalnızca izin verileni getirmek, ana içeriği çıkarmak, HTML ya da düz metin yerine Markdown'a çevirmek, bir token bütçesi içinde başlıklardan parçalamak, köken bilgisi eklemek, yinelenen parçaları ayıklamak ve koşullu isteklerle yenilemek. Test sayfamızda bu hat 21.044 token'lık HTML'i, 4.405 token'lık bir Markdown üzerinden 19 temiz parçaya çevirdi; betik tek oturuşta okunacak kadar kısa. Hattı kurmak yerine Markdown'ı hazır almak isterseniz, satış ekibi üzerinden sunulan yönetilen sayfa çıkarma hizmetimiz Web Scraping API'yi veri kazıma sayfasında anlattık.