Ein Support-Team möchte einen Assistenten, der aus der öffentlichen Dokumentation der Produkte antwortet, die es betreut. Die erste Version lädt die Seiten mit Requests herunter und übergibt das HTML dem Modell. Die Antworten zitieren das Cookie-Banner, das Menü nimmt im Prompt mehr Platz ein als der Artikel, Seiten, die ihren Text per JavaScript laden, kommen leer zurück, und eine Seite, die sich letzte Woche geändert hat, wird noch aus der alten Kopie beantwortet. Am Modell liegt es nicht. Die Daten wurden nie aufbereitet.
Dieser Beitrag behandelt diese Aufbereitung: was RAG ist, warum Webseiten die am schwersten aufzubereitende Quelle sind, warum Markdown sowohl HTML als auch reinen Text schlägt, die Pipeline vom Abruf bis zur Aktualisierung, ein gemessenes Beispiel an einer echten Seite mit einem 58-zeiligen Python-Skript und die Frage, wo Scraping-APIs und Proxys ins Bild kommen. Das Skript lief am 9. November 2026 mit trafilatura 2.3.1, tiktoken 0.14.0 und Python 3.13.
Was ist RAG und wofür wird es verwendet?
RAG, kurz für Retrieval-Augmented Generation (etwa „abrufgestützte Generierung“), ist eine Art, mit einem Sprachmodell zu antworten, bei der die Fakten aus Dokumenten stammen, die zum Zeitpunkt der Frage abgerufen werden, und nicht allein aus dem Training des Modells. Ein Retriever, die Suchkomponente, durchsucht einen Index aus Passagen, die besten Treffer wandern in den Prompt, und das Modell schreibt seine Antwort daraus. Der Index kann alles enthalten, was in Text verwandelt wurde: PDFs, Tickets, Datenbankzeilen und Webseiten.
Der Name stammt aus einem Paper von 2020 von Patrick Lewis, Ethan Perez, Aleksandra Piktus und Kollegen, Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks. Es kombiniert ein vortrainiertes Sequence-to-Sequence-Modell, dessen Wissen in seinen Parametern sitzt, mit einem dichten Vektorindex der Wikipedia, den ein neuronaler Retriever liest; die Autoren nennen das nicht-parametrisches Gedächtnis. Zwei Probleme, die das Paper nennt, sind genau die, die Webinhalte aufwerfen: das Wissen des Modells zu aktualisieren und zu zeigen, woher eine Antwort stammt. Fine-Tuning schreibt Wissen in die Gewichte, sodass jede Seitenänderung einen weiteren Trainingslauf bedeutet und es keine Quelle zum Zitieren gibt; mit RAG wird eine geänderte Seite erneut abgerufen und neu indexiert, und jede Antwort kann ihre URL und ihren Abschnitt mitführen.
Warum sind Webseiten die schwierigste RAG-Quelle?
Webseiten sind schwierig, weil der Inhalt, den Sie wollen, nur einen kleinen Teil dessen ausmacht, was der Server sendet. Eine Dokumentationsseite trägt einen Navigationsbaum, einen Header, einen Footer, einen Cookie-Hinweis, Teilen-Buttons und „verwandte Artikel“, alles als Text, den eine naive Pipeline neben dem Artikel indexiert. Fragt ein Nutzer nach Rate Limits, liefert der Retriever das Cookie-Banner, weil darin das Wort „Limit“ vorkommt.
Drei weitere Probleme sind webspezifisch. Viele Seiten laden ihren Text per JavaScript, sodass das heruntergeladene HTML einen Titel und ein leeres div enthält. Ein Artikel lebt oft unter mehreren URLs, mit Tracking-Parametern, einer Druckansicht, http und https oder einem abschließenden Schrägstrich, sodass dieselbe Passage dreimal im Index landet und die besten Treffer mit Kopien ihrer selbst füllt. Und Seiten ändern sich still: Ein PDF, das Sie im März indexiert haben, ist immer noch dieses PDF, eine Preisseite nicht. Nehmen Sie Paginierung dazu, die ein Dokument über mehrere Seiten verteilt, und Kodierungsfehler, die aus — ein — machen, und Sie haben den Normalzustand einer öffentlichen Website.
Warum Markdown und nicht HTML oder reiner Text?
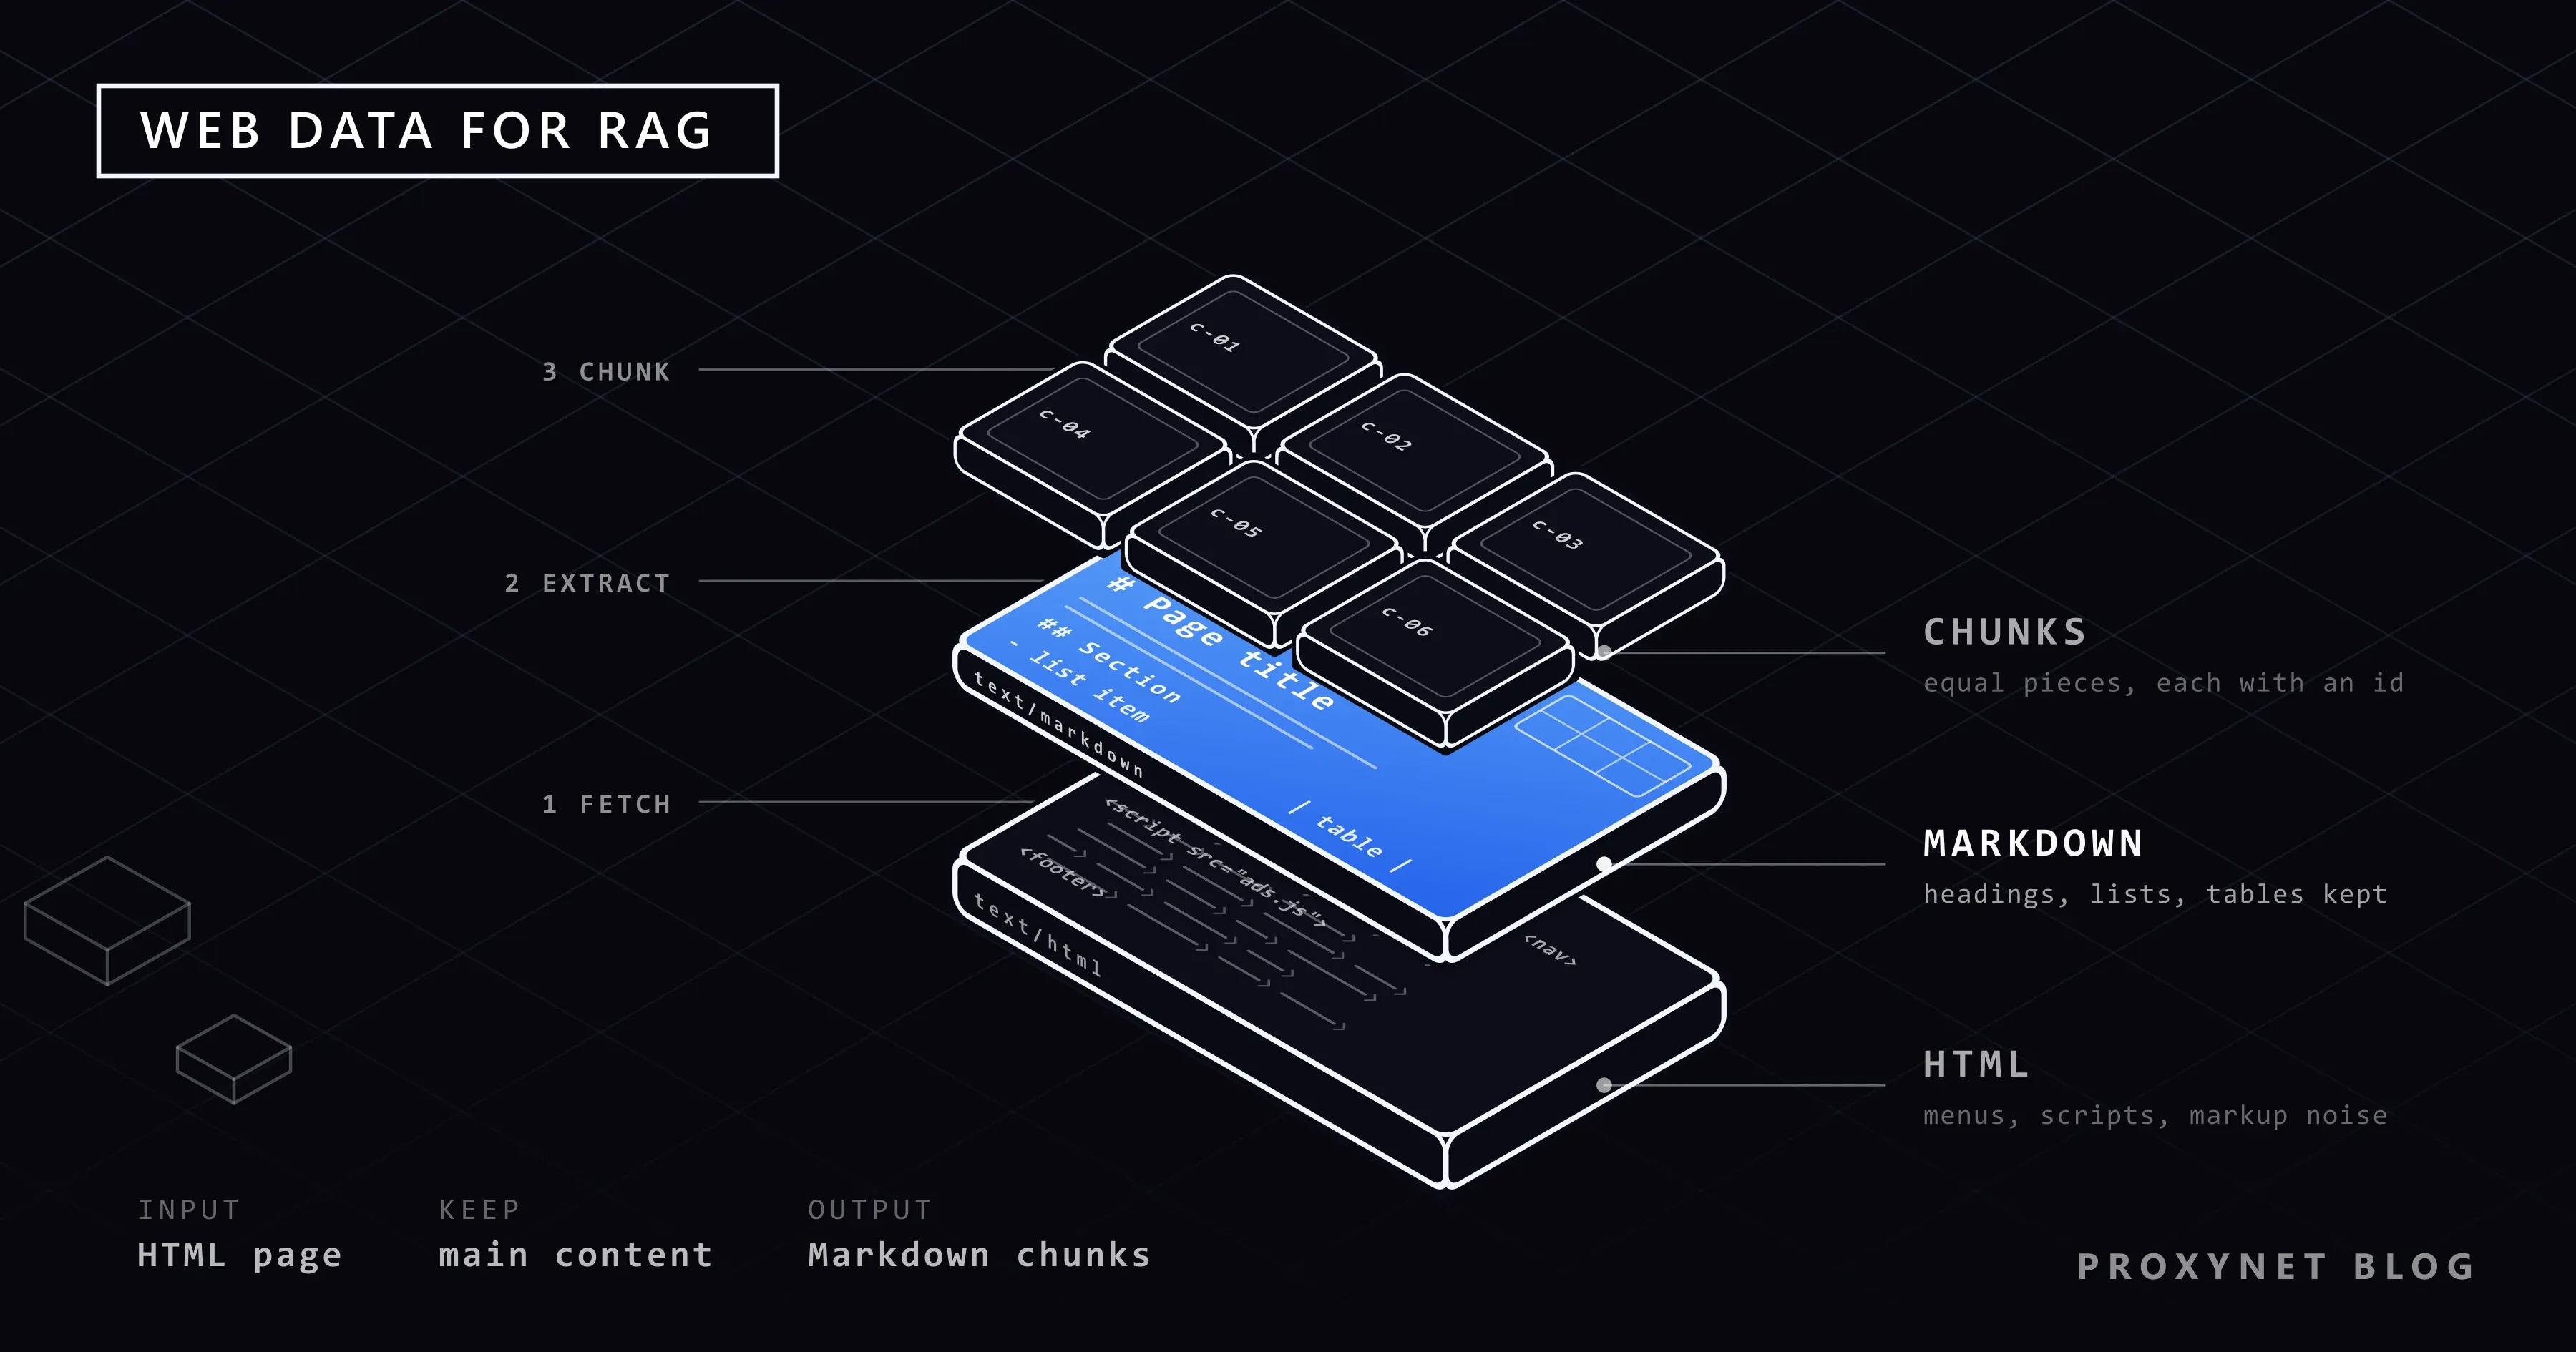
Markdown ist das richtige Zwischenformat, weil es die Struktur behält, die ein Retriever und ein Modell brauchen, also Überschriften, Listen, Tabellen, Codeblöcke und Links, und zugleich das Markup, die Skripte und die Styles verwirft, die keine Bedeutung tragen. HTML gibt die meisten seiner Tokens für Tags und Attribute aus. Reiner Text geht zu weit in die andere Richtung: Eine Tabelle wird zu einer Wortfolge, eine Überschrift zu einer Zeile wie jede andere, und es gibt keine verlässliche Stelle mehr, an der sich ein Chunk schneiden lässt. Der llms.txt-Vorschlag, der Websites bittet, Markdown-Versionen ihrer Seiten zu veröffentlichen, sagt es klar: „At the moment the most widely and easily understood format for language models is Markdown“ (derzeit ist Markdown das Format, das Sprachmodelle am weitesten verbreitet und am leichtesten verstehen).
Wir haben den Unterschied an einer echten Seite gemessen, dem HOWTO der Python-Dokumentation zum Abrufen von Internetressourcen mit urllib, mit dem Tokenizer o200k_base aus tiktoken. Die Zahlen beschreiben diese Seite, nicht das Web im Allgemeinen.
| Format | Was erhalten bleibt | Tokens auf der Testseite | Wo Chunks geschnitten werden können |
|---|---|---|---|
| Rohes HTML | Alles, einschließlich Menüs, Skripte und Markup | 21.044 | An Tags, die nichts über die Bedeutung sagen |
| Reiner Text | Nur Wörter; Überschriften und Tabellen werden flach | 4.133 | Bestenfalls an Leerzeilen |
| Markdown | Überschriften, Listen, Tabellen, Code und Links | 4.405 | An Überschriftenzeilen |
Markdown kostete auf dieser Seite 272 Tokens mehr als reiner Text, etwa 7 Prozent, und dafür ist jede Abschnittsüberschrift immer noch eine Überschrift. Gegenüber dem rohen HTML ist es 4,8-mal kleiner. Eine Einschränkung: Markdown hat eine Spezifikation für seinen Kern, CommonMark (Version 0.31.2, Januar 2024), aber Pipe-Tabellen und eingefasste Codeblöcke (fenced code blocks) sind Erweiterungen, die GitHub populär gemacht hat. Prüfen Sie also, ob Ihr Konverter sie schreibt, statt sie zu verwerfen.
Wie funktioniert die Pipeline vom Web zu RAG?
Die Pipeline hat zehn Schritte, und die Reihenfolge zählt, weil jeder auf dem vorherigen aufbaut.
- Rufen Sie nur ab, was Sie abrufen dürfen. Lesen Sie die robots.txt der Website vor der ersten Anfrage und überspringen Sie gesperrte Pfade; die Regeln erklärt unser Leitfaden zur robots.txt. Lesen Sie die Nutzungsbedingungen, senden Sie einen
User-Agent, der Ihren Bot und eine Kontaktadresse nennt, und halten Sie pro Domain ein rücksichtsvolles Tempo. Veröffentlicht die Website Markdown-Versionen ihrer Seiten, nutzen Sie diese, statt HTML zu parsen. - Extrahieren Sie den Hauptinhalt. trafilatura ist ein Python-Paket und Kommandozeilenwerkzeug unter der Apache-2.0-Lizenz, das rohes HTML in Text, Markdown, XML oder JSON verwandelt und zusätzlich Titel, Autor und Datum herauszieht. Mozilla Readability ist die JavaScript-Bibliothek hinter der Reader View (Leseansicht) von Firefox;
new Readability(document).parse()liefert den Titel, den bereinigten Inhalt und die Autorenzeile. Beide arbeiten mit Struktur und Textdichte, ohne einen Parser pro Website. - Wandeln Sie in Markdown um. trafilatura schreibt mit
output_format="markdown"direkt Markdown. Haben Sie bereits bereinigtes HTML, konvertieren es markdownify in Python oder Turndown in JavaScript; wählen Sie Überschriften im ATX-Stil mit#, weil der Chunker an ihnen trennt. Seiten, die ihren Inhalt mit JavaScript aufbauen, brauchen einen Browser: Crawl4AI rendert sie in Chromium und liefert ein „fit“-Markdown ohne Menüs, wie unser Crawl4AI-Leitfaden zeigt. - Bereinigen Sie. Entfernen Sie, was der Extraktor übrig gelassen hat: Ankerzeichen hinter Überschriften, „Diese Seite bearbeiten“-Links, Breadcrumbs, doppelte Leerzeichen. Beheben Sie die Kodierung an der Quelle, nicht im Text. Lassen Sie Codeblöcke und Tabellen genau so, wie sie sind.
- Zerlegen Sie an Überschriften innerhalb eines Token-Budgets in Chunks. Schneiden Sie dort, wo eine Überschriftenzeile beginnt, behalten Sie den Überschriftenpfad als Metadaten (
Fetching URLs > Data) und teilen Sie Abschnitte über dem Budget an Absatzgrenzen. Zählen Sie Tokens mit dem Tokenizer des Modells, mit dem Sie die Embeddings berechnen; tiktoken ist der schnelle BPE-Tokenizer für die Modelle von OpenAI, undo200k_baseist die Kodierung, die seine README verwendet. Zeichen sind kein Ersatz: 500 Zeichen sind in englischer Prosa etwa 100 Tokens und in Code weit mehr. - Entfernen Sie Duplikate. Hashen Sie den normalisierten Chunk-Text; zwei Chunks mit demselben Hash sind dieselbe Passage, egal von welcher URL sie stammen. Beinahe-Duplikate, etwa dieselbe Seite mit einer anderen „Zuletzt aktualisiert“-Zeile, brauchen einen Ähnlichkeitstest auf Wort-Shingles oder auf den Embeddings.
- Hängen Sie Herkunftsangaben an. Jeder Chunk trägt seine URL, die Abrufzeit, den Seitentitel, den Abschnittspfad, den Inhalts-Hash und die Token-Zahl. Ohne diese Angaben können Sie weder zitieren noch aktualisieren noch löschen.
- Berechnen Sie Embeddings und indexieren Sie. Jeder Chunk wird zu einem Vektor in einem Vektorindex; viele Teams ergänzen einen Stichwortindex und führen die beiden Ergebnislisten zusammen. Welches Modell und welche Datenbank Sie wählen, ändert nichts an den Schritten oben.
- Aktualisieren Sie. Speichern Sie die Header
ETagundLast-Modifiedund senden Sie beim nächsten MalIf-None-MatchoderIf-Modified-Since; ein304 Not Modifiedkostet fast nichts, und unsere Testseite sendete beide Header. Nutzen Sie dielastmod-Daten der Sitemap, um zu entscheiden, was Sie zuerst erneut besuchen, ersetzen Sie Chunks nach URL und Abschnitt, und verwerfen Sie die Chunks von Seiten, die jetzt 404 oder 410 zurückgeben. - Bewerten Sie das Retrieval. Schreiben Sie 30 oder 50 echte Fragen samt der Passage auf, die jede beantwortet, und messen Sie, wie oft der richtige Chunk unter den besten Treffern ist. Stimmen Sie Chunk-Größe, Überlappung und Budget auf diese Zahl ab, nicht auf ein Gefühl.
Ein getestetes Beispiel: eine Seite von HTML zu Markdown-Chunks
Das Skript führt die ersten sieben Schritte an einer Seite aus und gibt aus, was es gefunden hat. Wir haben eine Seite der Python-Dokumentation gewählt, deren robots.txt /dev, /release und alte Versionen wie /3.10/ sperrt, /3/ aber erlaubt, geprüft am 9. November 2026; das Skript prüft das vor dem Abruf mit urllib.robotparser erneut.
python -m venv .venv
.venv/bin/pip install trafilatura tiktoken requests   # Windows: .venv\Scripts\pip
Zwei Details erklären zwei Zeilen des Codes. docs.python.org sendet Content-Type: text/html ohne Zeichensatz, sodass resp.text von Requests die Seite als ISO-8859-1 dekodieren würde und jede Überschrift auf ein verirrtes  enden würde; die Seite deklariert UTF-8 in ihrem <meta charset>, deshalb dekodiert das Skript die Bytes selbst. Und der Dokumentationsgenerator lässt hinter jeder Überschrift ein Absatzzeichen (¶) als Ankerlink stehen, das trafilatura als Text behält, weshalb der Bereinigungsschritt es entfernt. Ein drittes Detail ist für das Chunking wichtig: Die Seite enthält 17 eingefasste Codeblöcke, deren Python-Kommentare mit # beginnen, sodass ein Chunker, der an jeder #-Zeile trennt, mitten in den Code schneiden und Kommentare als Überschriften behandeln würde. Das Skript hält jeden eingefassten Block zusammen.
"""Eine öffentliche Seite abrufen, ihren Hauptinhalt als Markdown behalten, an Überschriften in Chunks zerlegen und Tokens zählen."""
import hashlib, json, re, sys
from datetime import datetime, timezone
from urllib.parse import urlsplit
from urllib.robotparser import RobotFileParser
import requests
import tiktoken
import trafilatura

URL = sys.argv[1] if len(sys.argv) > 1 else "https://docs.python.org/3/howto/urllib2.html"
UA = "rag-prep-demo/1.0 (+https://example.com/bot)"
BUDGET = 512                                  # max. Tokens pro Chunk; längere Abschnitte werden an Absätzen geteilt
enc = tiktoken.get_encoding("o200k_base")     # der Tokenizer der aktuellen OpenAI-Modelle
tokens = lambda s: len(enc.encode(s))

# 1. zuerst robots.txt: abbrechen, wenn der Pfad für unseren User-Agent gesperrt ist
robots = RobotFileParser(urlsplit(URL)._replace(path="/robots.txt", query="", fragment="").geturl())
robots.read()
if not robots.can_fetch(UA, URL):
    sys.exit(f"robots.txt disallows {URL}")

# 2. ein Abruf, drei Ansichten derselben Seite: rohes HTML, Hauptinhalt als Markdown, reiner Text
resp = requests.get(URL, headers={"User-Agent": UA}, timeout=30)
resp.raise_for_status()
html = resp.content.decode("utf-8")           # die Seite deklariert UTF-8; resp.text würde ISO-8859-1 raten
fetched_at = datetime.now(timezone.utc).isoformat(timespec="seconds")
md = trafilatura.extract(html, url=URL, output_format="markdown", include_tables=True, include_formatting=True)
md = md.replace("¶", "")                 # bereinigen: Sphinx lässt hinter jeder Überschrift ein Absatzzeichen als Anker stehen
txt = trafilatura.extract(html, url=URL, output_format="txt", include_tables=True)
title = trafilatura.extract_metadata(html, default_url=URL).title

# 3. in Blöcke teilen (Absätze, Überschriftenzeilen, ganze Codeblöcke), dann an Überschriften und am Budget schneiden
blocks = []
for seg in re.split(r"(```[\s\S]*?```)", md.strip()):           # ein eingefasster Codeblock ist ein Block und wird nie geschnitten
    blocks += [seg] if seg.startswith("```") else [p.strip() for p in re.split(r"\n\s*\n|\n(?=#{1,6} )", seg) if p.strip()]
chunks, path, piece = [], [], ""
for block in blocks + ["# end"]:                                 # die Wächter-Überschrift schließt den letzten Chunk ab
    head = re.match(r"(#{1,6}) (.+)", block)
    if head or (piece and tokens(piece + "\n\n" + block) > BUDGET):
        if piece:
            chunks.append((list(path), piece))                   # eine Überschrift ohne Text darunter ergibt keinen Chunk
        piece = "" if head else block
    else:
        piece = f"{piece}\n\n{block}".strip()
    if head:
        path = path[:len(head.group(1)) - 1] + [head.group(2).strip()]

# 4. Herkunft: jeder Chunk trägt, woher er stammt, wann er abgerufen wurde und einen Hash für die Deduplizierung
records = [{"url": URL, "fetched_at": fetched_at, "title": title, "section": " > ".join(p[1:]) or "(top)",
            "content_hash": hashlib.sha256(text.encode()).hexdigest()[:16], "tokens": tokens(text), "text": text}
           for p, text in chunks]

print(f"page: {title}\nfetched: {fetched_at}")
print(f"tokens (o200k_base): html={tokens(html)}  markdown={tokens(md)}  text={tokens(txt)}")
sizes = sorted(r["tokens"] for r in records)
print(f"chunks: {len(records)}  min={sizes[0]}  median={sizes[len(sizes) // 2]}  max={sizes[-1]}  budget={BUDGET}")
print("\n".join(f"  {r['tokens']:>4} tok  {r['content_hash']}  {r['section'][:60]}" for r in records[:6]))
print(json.dumps({k: v for k, v in records[1].items() if k != "text"}, indent=2))
Die Ausgabe:
page: HOWTO Fetch Internet Resources Using The urllib Package
fetched: 2026-11-09T12:32:13+00:00
tokens (o200k_base): html=21044  markdown=4405  text=4133
chunks: 19  min=10  median=183  max=495  budget=512
   276 tok  e21a9bc9bc9dc71b  Introduction
   460 tok  30fc2c8722d53c1a  Fetching URLs
   434 tok  51aca2bdee7780e4  Fetching URLs > Data
   144 tok  f8e6254387670d87  Fetching URLs > Data
   329 tok  3b49bcc1ef1326f3  Fetching URLs > Headers
    79 tok  3928e9cb23c19eee  Handling Exceptions
{
  "url": "https://docs.python.org/3/howto/urllib2.html",
  "fetched_at": "2026-11-09T12:32:13+00:00",
  "title": "HOWTO Fetch Internet Resources Using The urllib Package",
  "section": "Fetching URLs",
  "content_hash": "30fc2c8722d53c1a",
  "tokens": 460
}
Die Seite wurde zu 19 Chunks mit einem Median von 183 Tokens, und keiner überschritt das Budget von 512 Tokens. „Fetching URLs > Data“ erscheint zweimal, weil dieser Abschnitt länger als das Budget war und an einer Absatzgrenze in 434 und 144 Tokens geschnitten wurde; die beiden Teile teilen sich einen Abschnittspfad, haben aber verschiedene Hashes, und genau das braucht ein Deduplizierungsschritt. Der kleinste Chunk hat 10 Tokens, der Ein-Satz-Abschnitt „Footnotes“ der Seite; eine produktive Pipeline würde ihn mit seinem Nachbarn zusammenlegen. Die Seitenleiste, die Links zur vorherigen und nächsten Seite und der Footer der Originalseite tauchen im Markdown gar nicht auf; hier hat der Extraktor seine Arbeit getan. Der JSON-Datensatz ist die Herkunftsangabe, die mit dem Chunk in den Index wandert; viele Teams stellen dem Text vor dem Embedding außerdem den Abschnittspfad voran.
Wo kommen Scraping-APIs ins Spiel?
Eine Scraping-API passt, wenn Rendering, Extraktion und Rücksichtnahme das Problem von jemand anderem sein sollen. Viele von ihnen liefern direkt Markdown, rendern JavaScript-Seiten in einem Browser und steuern die Anfragerate pro Domain, sodass Ihre Pipeline beim Chunking beginnt. Vier Prüfungen zeigen, ob ein Dienst zu einem RAG-Korpus passt: Rufen Sie zehn Seiten ab, die Sie kennen, und suchen Sie im Markdown nach Menüs und nach Tabellen, die vollständig angekommen sind; stellen Sie sicher, dass Titel, kanonische URL und, falls vorhanden, das Datum der letzten Änderung mit dem Inhalt kommen, denn sie werden zu Herkunftsangaben; rufen Sie dieselbe unveränderte Seite zweimal ab und vergleichen Sie die Ausgabe, sonst markieren Ihre Hashes jede Seite als geändert; und fragen Sie, wie der Dienst mit robots.txt und Rate Limits umgeht, denn die Anfragen werden in Ihrem Namen gestellt.
Wo kommt ein Proxy ins Spiel?
Ein Proxy passt hier in zwei Situationen, und in keiner geht es darum, von einer Website schneller abzurufen. Die erste ist Breite: Ein RAG-Korpus erstreckt sich oft über Hunderte Domains, und ein Crawler, der das Tempo jeder Domain respektiert, kann trotzdem viele Domains gleichzeitig bearbeiten. Verteilt man diese Abrufe auf mehr als eine Ausgangsadresse, zum Beispiel indem der Ausgang ein Rotierender Proxy ist, sieht jede einzelne Domain weiterhin einen langsamen, rücksichtsvollen Client, während der gesamte Job in Stunden statt Tagen fertig ist.
Die zweite ist der Standort. Dokumentations-, Hilfe- und Preisseiten unterscheiden sich oft nach Land oder Sprache des Besuchers, und ein Index, der aus der falschen Version gebaut wurde, antwortet Nutzern mit Inhalten, die sie nie sehen. Wer aus dem Land abruft, in dem die eigenen Nutzer sind, mit einem Residential-Proxy und Länder-Targeting, indexiert die Seite, die sie tatsächlich lesen werden. robots.txt, die Nutzungsbedingungen und das Tempo bleiben gleich, von welcher Adresse die Anfrage auch ausgeht.
Häufige Fehler
- Chunking nach Zeichenzahl über Überschriften hinweg. Ein Fenster von 1.000 Zeichen, das zwei Abschnitte überspannt, beantwortet keine der beiden Fragen. Schneiden Sie an Überschriften, dann an Absätzen.
- Boilerplate indexieren. Cookie-Hinweise, Menüs und Footer werden zu Chunks, die zu allem ein wenig und zu nichts richtig passen.
- Keine Herkunftsangaben. Ohne URL, Abrufzeit und Abschnitt können Sie keine Quelle zitieren, keine geänderte Seite aktualisieren und keine entfernte Seite löschen.
- Nie aktualisieren. Ein einmal gebauter Korpus ist eine Momentaufnahme; bedingte Anfragen mit
ETagundLast-Modifiedmachen eine wöchentliche Aktualisierung günstig. - Dieselbe Seite mehrfach einbetten. Tracking-Parameter, Druckansichten und abschließende Schrägstriche erzeugen Kopien, die die besten Treffer verstopfen; hashen Sie den Inhalt, nicht die URL.
- Zeichen statt Tokens zählen oder mit einem anderen Tokenizer zählen als dem des Embedding-Modells.
- Innerhalb von Codeblöcken und Tabellen trennen. Ein
#-Kommentar im Code ist keine Überschrift, und eine halbe Tabelle beantwortet nichts. - Eine leere Seite indexieren. Wird der Inhalt mit JavaScript aufgebaut, enthält das heruntergeladene HTML keinen Artikel; prüfen Sie die Token-Zahl des extrahierten Texts, bevor Sie indexieren.
- Abrufen, was robots.txt oder die Nutzungsbedingungen ausschließen, oder schneller, als ein Mensch lesen würde. Die rechtliche Lage (siehe die letzte Frage unten) wird mit der Menge nicht besser.
Entscheidungshilfe
| Bedarf | Empfehlung |
|---|---|
| Einige hundert Dokumentationsseiten | trafilatura zu Markdown, Überschriften-Chunks von 200 bis 500 Tokens, wöchentliche Aktualisierung |
| Seiten, die mit JavaScript rendern | Ein browserbasierter Extraktor wie Crawl4AI oder eine Scraping-API, die Markdown liefert |
| Die Website bietet Markdown-Versionen oder llms.txt | Die .md-Zwillinge abrufen und die Extraktion überspringen |
| Antworten müssen ihre Quelle nennen | Herkunftsangaben an jedem Chunk: URL, Abrufzeit, Titel, Abschnittspfad, Hash |
| Dieselbe Passage taucht in den Ergebnissen immer wieder auf | Inhalts-Hashes, URL-Normalisierung, ein Test auf Beinahe-Duplikate |
| Hunderte Domains, jede in rücksichtsvollem Tempo | Parallele Domains über mehrere Ausgänge mit einem rotierenden Proxy |
| Länderspezifische Dokumentation oder Preise | Ein Residential-Proxy mit Länder-Targeting |
| Kein Team, das die Pipeline betreibt | Eine verwaltete Scraping-API, die Markdown mit Metadaten liefert |
Häufige Fragen
Wofür steht RAG und worin unterscheidet es sich vom Fine-Tuning?
RAG steht für Retrieval-Augmented Generation: Das Modell antwortet aus Passagen, die zum Zeitpunkt der Frage abgerufen werden. Fine-Tuning verändert die Gewichte des Modells mit Trainingsdaten, sodass neue Informationen einen neuen Trainingslauf brauchen und das Modell nicht sagen kann, aus welchem Dokument eine Antwort stammt. RAG aktualisiert sich, indem eine Seite neu indexiert wird, und kann die URL und den Abschnitt nennen, die es verwendet hat.
Warum ist Markdown für LLMs besser als HTML?
Markdown behält die Struktur, auf die es ankommt, also Überschriften, Listen, Tabellen und Code, in wenigen Zeichen, während HTML die meisten seiner Tokens für Tags, Attribute und Skripte ausgibt. Auf unserer Testseite hatte das Markdown 4.405 Tokens gegenüber 21.044 für das HTML, und die Chunks ließen sich trotzdem an Überschriften schneiden.
Was ist die ideale Chunk-Größe für RAG?
Es gibt keine einzelne Zahl; ein brauchbarer Bereich für Dokumentation sind 200 bis 500 Tokens mit Schnitten an Überschriften, und der richtige Wert ist der, der in Ihrem eigenen Retrieval-Test am besten abschneidet. Kleinere Chunks passen genauer, verlieren aber Kontext; größere tragen Kontext, verwässern aber den Treffer.
Wie oft sollte ich Seiten für RAG erneut crawlen?
So oft, wie sich die Seiten ändern, und das verraten bedingte Anfragen günstig: Senden Sie den gespeicherten ETag- oder Last-Modified-Wert, und eine Antwort 304 Not Modified bedeutet, dass sich nichts geändert hat. Für Dokumentation reicht meist wöchentlich, Preis- und Statusseiten brauchen täglich, und die lastmod-Daten der Sitemap sagen, wo Sie zuerst nachsehen sollten.
Ersetzt llms.txt das Scraping?
Nein. llms.txt ist ein kuratierter Index der wichtigen Seiten einer Website für KI-Tools, und derselbe Vorschlag bittet Websites, Markdown-Versionen ihrer Seiten anzubieten; wo beides existiert, rufen Sie das Markdown ab und überspringen die Extraktion. Die meisten Websites veröffentlichen keines von beiden, und die Datei regelt nichts am Zugriff, wie unser Leitfaden zu llms.txt erklärt, sodass weiterhin robots.txt und die Nutzungsbedingungen entscheiden, was Sie abrufen dürfen.
Ist es legal, gescrapte Webseiten in RAG zu verwenden?
Das hängt von der Website und der Rechtsordnung ab, und dies ist eine Beschreibung, keine Rechtsberatung. Vier Dinge werden üblicherweise geprüft: die robots.txt, die RFC 9309 als Bitte an Crawler und nicht als Zugriffsautorisierung beschreibt; die Nutzungsbedingungen der Website, die automatisierten Zugriff oft untersagen; das Urheberrecht, das die Vervielfältigung von Text betrifft und davon abhängt, wie viel einer Seite eine Antwort wiedergibt und ob sie die Quelle nennt; und personenbezogene Daten auf den Seiten, die die DSGVO und in Türkiye das KVKK regeln und die ein RAG-Korpus gar nicht erst sammeln sollte. Herkunftsangaben an jedem Chunk erlauben es, eine Quelle auf Anfrage zu entfernen. Sprechen Sie mit einem Anwalt, bevor Sie einen Korpus aus fremden Websites aufbauen.
Fazit
RAG antwortet aus abgerufenen Passagen, also bestimmt die Qualität der Passagen die Qualität der Antworten. Für Webquellen heißt das: nur abrufen, was erlaubt ist, den Hauptinhalt extrahieren, in Markdown statt in HTML oder reinen Text umwandeln, an Überschriften innerhalb eines Token-Budgets in Chunks zerlegen, Herkunftsangaben anhängen, Duplikate entfernen und mit bedingten Anfragen aktualisieren. Auf unserer Testseite machte diese Pipeline aus 21.044 Tokens HTML 19 saubere Chunks aus einem Markdown mit 4.405 Tokens, mit einem Skript, das kurz genug ist, um es in einem Zug zu lesen. Wenn Sie lieber Markdown erhalten, als die Pipeline zu bauen: Unsere Web Scraping API, ein verwalteter Dienst zur Seitenextraktion, der über das Vertriebsteam erhältlich ist, wird auf der Seite Data Scraping beschrieben.