


































In den meisten C#-Beispielen zum Datenabruf stehen bis heute WebClient und fünfzehn Zeilen, die eine einzige Seite herunterladen. Dieses Beispiel läuft beim ersten Versuch, bricht aber an drei verschiedenen Stellen, sobald der Umfang wächst: Die Sockets gehen aus, weil für jede Anfrage ein neues Client-Objekt entsteht; die Website antwortet mit 429, sobald sie Dutzende Anfragen pro Sekunde von derselben Adresse sieht; und der Parser stirbt an einer Nullreferenz, sobald sich die Seitenstruktur ändert. Keines der drei Probleme kommt von der gewählten Bibliothek, alle drei kommen davon, wie der Client aufgesetzt wurde.
Dieser Beitrag baut einen Scraping-Job auf aktuellem .NET auf: die Lebensdauer der HttpClient-Instanz, die Wahl zwischen HtmlAgilityPack und AngleSharp für das Parsen von HTML, die Proxy-Definition über HttpClientHandler oder SocketsHttpHandler, die Authentifizierung mit Benutzername und Passwort, SOCKS5-Adressen, Timeout und Abbruch, ein Nebenläufigkeitslimit und Wiederholungen. Als Ziel dient books.toscrape.com, eine Übungsseite, die genau für solche Arbeiten veröffentlicht wurde.
Aus welchen Schritten besteht ein Scraping-Job in C#?
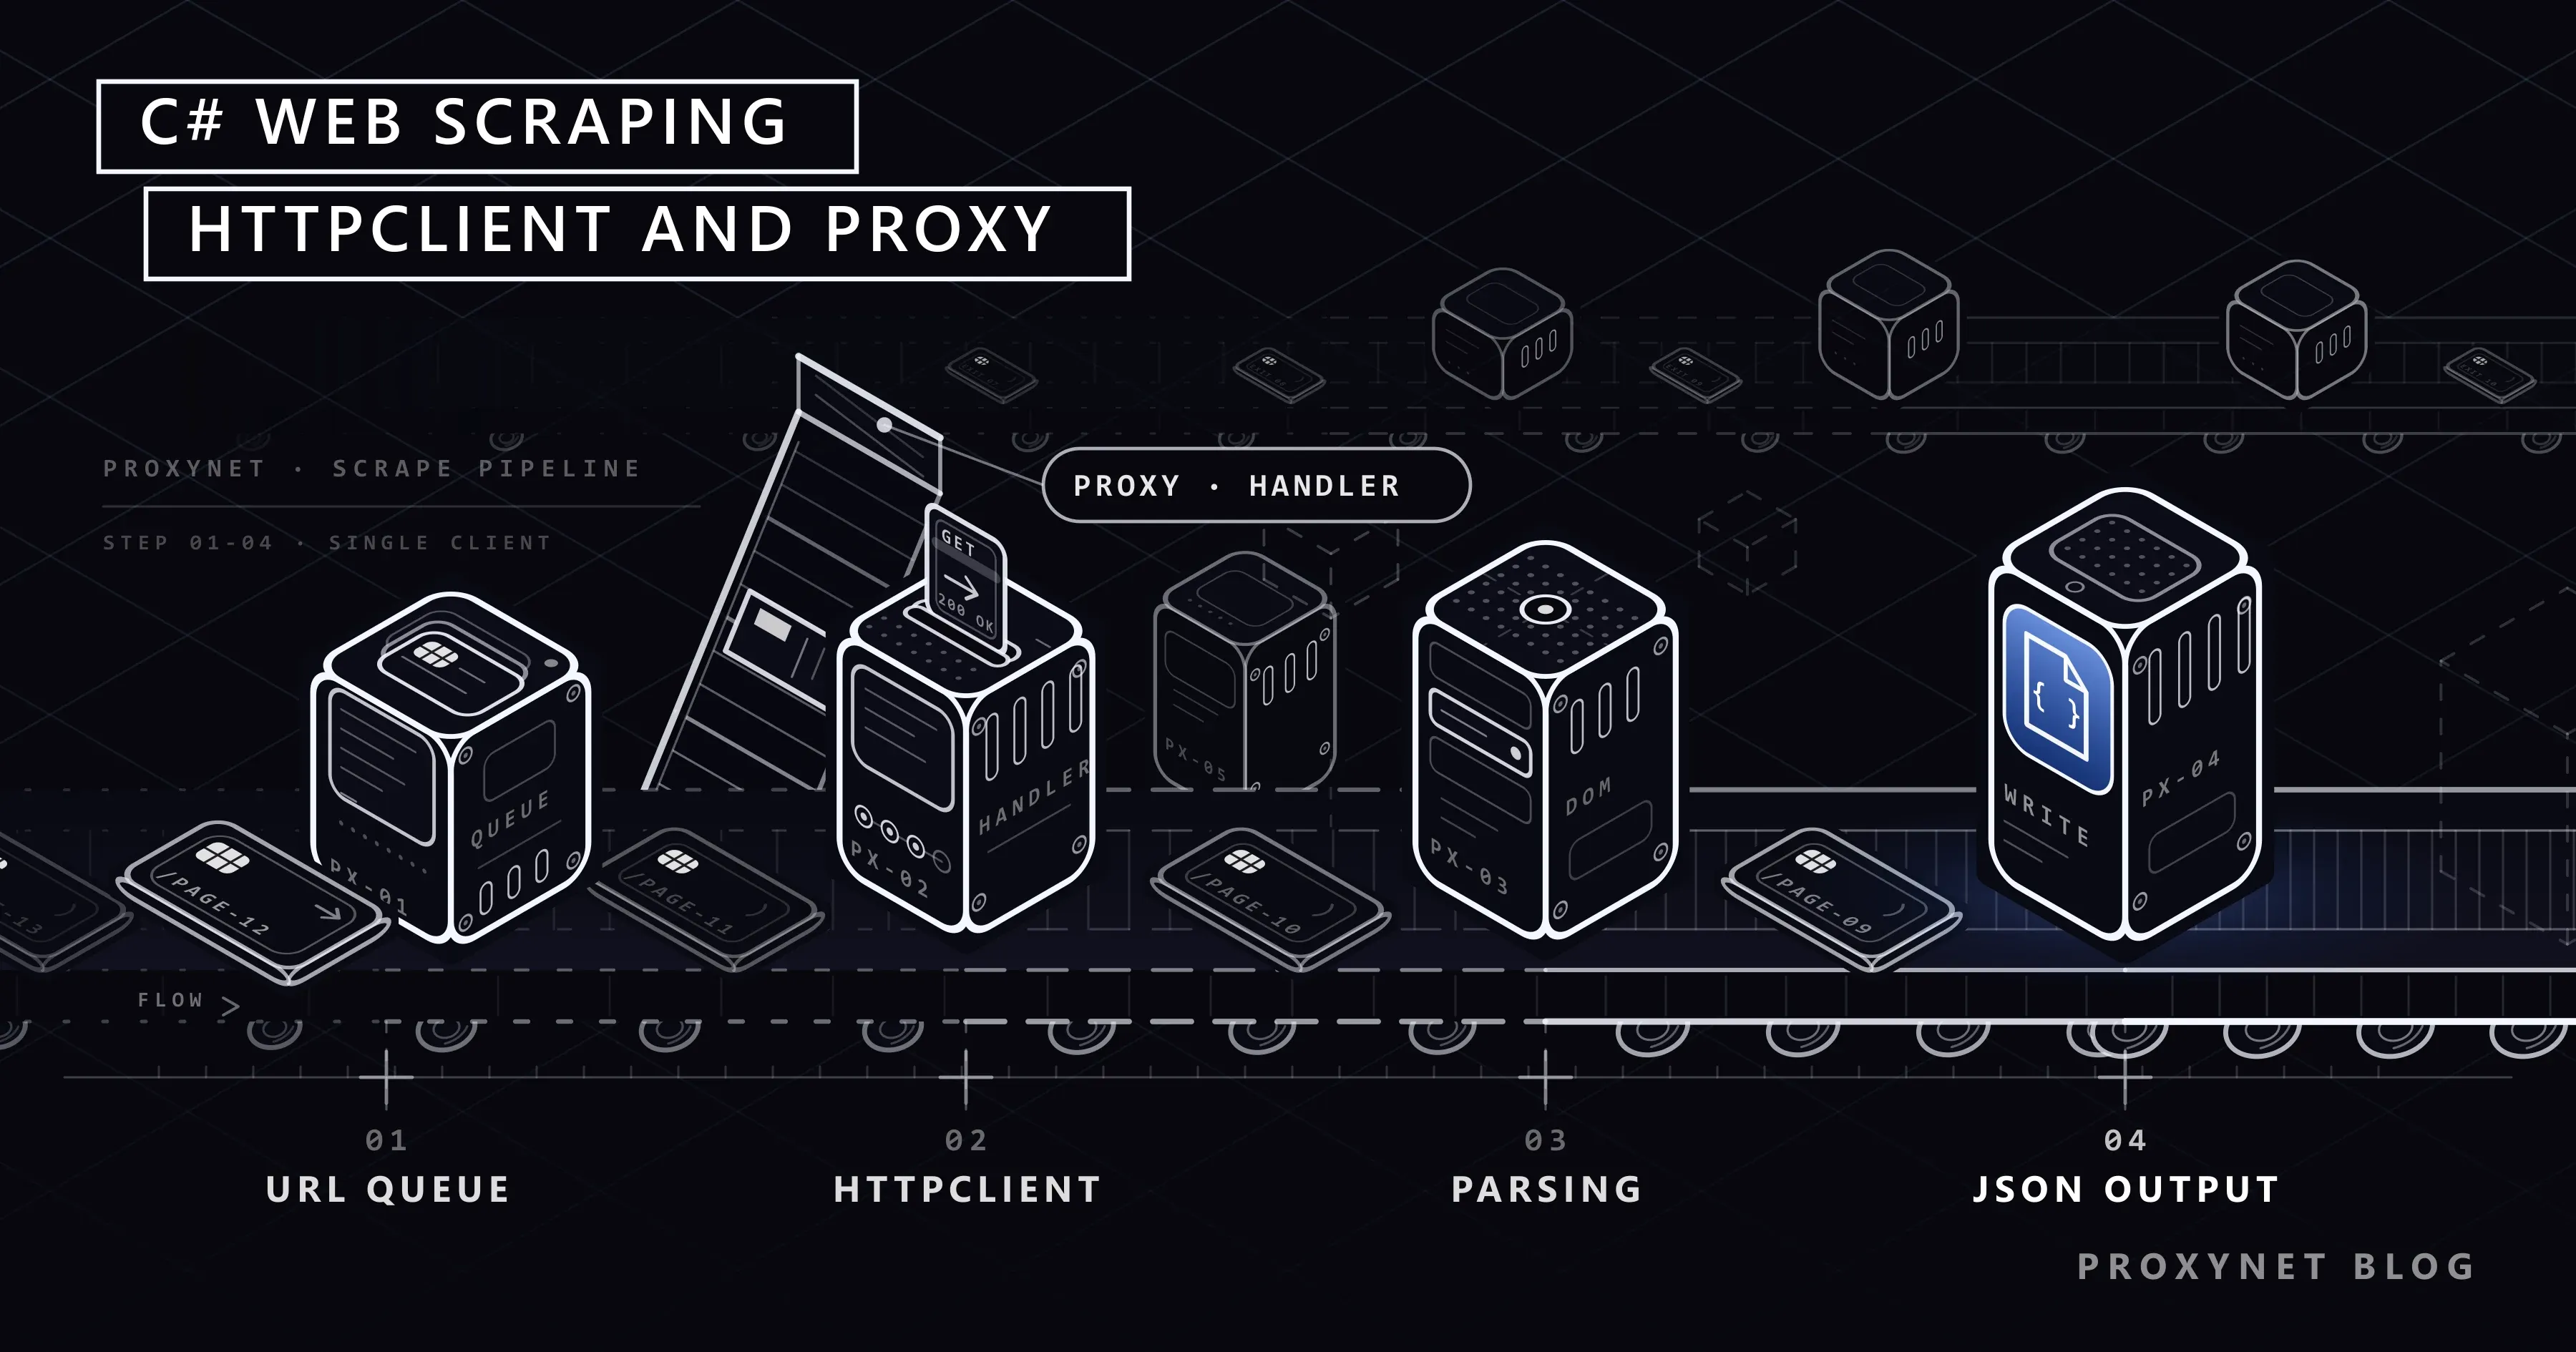
Unabhängig von der Sprache folgt jeder Scraping-Job denselben fünf Schritten. Auf der C#-Seite sieht jeder Schritt so aus:
- Die Adressliste erzeugen. Kategorieseiten, Paginierungslinks oder die Sitemap. Halten Sie die Liste als Warteschlange, damit ein unterbrochener Job dort weitermacht, wo er stehen geblieben ist.
- Die Anfrage senden.
GetAsyncüber denHttpClient. Der Statuscode der Antwort wird geprüft, der Rumpf als Text gelesen. - Das HTML parsen. Der eintreffende Text wird zu einem Dokumentobjekt, und die gesuchten Felder werden mit einem XPath- oder CSS-Selektor gefunden.
- Die Daten normalisieren. Das Währungszeichen im Preis, überflüssige Leerzeichen in einer Zeile und fehlende Felder werden hier bereinigt.
- Speichern. JSON, CSV oder eine Datenbanktabelle. Wenn der Speicherschritt getrennt bleibt, müssen Sie die Daten nicht neu herunterladen, sobald Sie den Parser ändern.
Zwischen diesen Schritten stehen zwei weitere Dinge: die Wartezeit zwischen den Anfragen und das Verhalten im Fehlerfall. Beides ist keine nachträgliche Zierde, sondern gehört in die erste Fassung des Jobs. Die folgenden Abschnitte bauen beides auf.
Vor dem Start: robots.txt, Tempo und eine ehrliche Client-Kennung
Bevor Sie eine Anfrage an eine Website senden, sehen Sie in deren robots.txt nach. Format und Auslegungsregeln der Datei wurden mit RFC 9309 standardisiert. Der Standard sagt: Kann die Datei nicht vom Server abgerufen werden, darf der Crawler auf die Ressourcen zugreifen. Eine Adresse, die 404 liefert, bedeutet also kein Verbot. Das Beispielziel dieses Beitrags ist ein typischer Fall: books.toscrape.com ist eine Schauseite zum Üben, hat deshalb keine robots.txt, und die Adresse antwortet mit 404. Wie die Regeln zu lesen sind, haben wir in Was ist robots.txt und wie liest man die Datei? ausführlich beschrieben.
robots.txt ist kein Erlaubnisschein, sondern nur das, was die Website automatischen Clients mitteilt. Darüber stehen zwei weitere Verantwortlichkeiten. Erstens das Tempo: Eine einzelne Seite mehrmals pro Sekunde anzufragen bedeutet, auf dem Server derselben Warteschlange anzugehören wie echte Besucher. Legen Sie eine bewusste Pause zwischen die Anfragen und begrenzen Sie die Zahl gleichzeitig offener Anfragen. Zweitens die Kennung: Der gesendete User-Agent ist der einzige Anhaltspunkt für eine Administratorin, die Sie erreichen möchte. Den Namen der eigenen Anwendung und eine Kontaktadresse einzutragen ist ehrlicher und praktischer, als die Zeichenkette eines verbreiteten Browsers zu kopieren. Wozu der Header dient, steht in Was ist ein User-Agent? Auslesen und ändern.
Eine dritte Grenze ist rechtlicher Natur. Seiten mit personenbezogenen Daten, Inhalte hinter einem Login und Nutzungen, die die Nutzungsbedingungen ausdrücklich untersagen, sind keine technische Frage. Den Rahmen dazu haben wir in Ist Web Scraping legal? Ein Überblick gesammelt.
Warum wird HttpClient nicht bei jeder Anfrage neu erzeugt?
Hier liegt der häufigste Fehler auf der C#-Seite. Weil das HttpClient-Objekt IDisposable ist, erzeugen viele Beispiele es in einem using-Block und schließen es bei jeder Anfrage. Microsofts HttpClient-Leitfaden schreibt deutlich, warum das falsch ist: Der Verbindungspool lebt im Handler-Objekt unter dem Client, und wer den Client bei jeder Anfrage erzeugt und verwirft, nimmt den Pool gleich mit. Da die Ports geschlossener TCP-Verbindungen nicht sofort frei werden, stoßen Sie bei steigender Anfragerate an das Portlimit des Betriebssystems. Das Symptom sieht eher nach einer Netzwerkstörung als nach einem Fehler im Code aus: Der Job läuft eine Weile störungsfrei, dann kommen Verbindungsfehler in Serie.
Richtig ist ein einziger Client, der so lange lebt wie die Anwendung. Der einzige Nachteil eines langlebigen Clients ist DNS: HttpClient löst den Domainnamen nur beim Aufbau der Verbindung auf und verfolgt Änderungen im DNS-Eintrag nicht. Der Leitfaden nennt auch die Lösung. Wenn der Eigenschaft PooledConnectionLifetime eines SocketsHttpHandler-Objekts eine Dauer zugewiesen wird, schließt sich die Verbindung im Pool nach dieser Zeit, und beim Aufbau der neuen Verbindung wird DNS erneut abgefragt. Im Codebeispiel des Leitfadens stehen fünfzehn Minuten, der Text sagt aber, dieser Wert sei nur zur Veranschaulichung gewählt und solle sich nach der erwarteten Häufigkeit von DNS-Änderungen richten; im Abschnitt zur empfohlenen Nutzung wird ein Intervall von zwei Minuten genannt.
Der andere Weg ist IHttpClientFactory. Die Factory hält Handler-Objekte in einem eigenen Pool und gibt einen Handler, dessen Lebensdauer noch nicht abgelaufen ist, an neue Clients weiter; das Socket-Problem tritt damit ebenfalls nicht auf. Wenn Sie in einer ASP.NET-Core-Anwendung oder in einem generischen Host mit Dependency Injection arbeiten, passt die Factory besser. In einem eigenständigen Konsolenskript reichen ein static gehaltener Einzelclient und PooledConnectionLifetime, und es sind weniger Teile im Spiel.
Noch ein Punkt: Die Verbindungseinstellungen des Handlers lassen sich nach der ersten gesendeten Anfrage nicht mehr ändern. Wenn Sie mit verschiedenen Proxys oder verschiedenen Cookie-Containern arbeiten müssen, richten Sie für jede Konfiguration ein eigenes Client-Objekt ein. Die Regel „ein Client" heißt nicht „ein Objekt in der Anwendung", sondern „kein neues Objekt pro Anfrage".
Wie wählt man zwischen HtmlAgilityPack und AngleSharp?
Für das Parsen von HTML gibt es unter .NET zwei etablierte Optionen. Beide sind NuGet-Pakete, beide kommen mit kaputtem HTML zurecht; der Unterschied liegt in der Selektorsprache und im Arbeitsmodell.
| HtmlAgilityPack | AngleSharp | |
|---|---|---|
| Selektorsprache | XPath (SelectNodes, SelectSingleNode) | CSS-Selektoren (QuerySelector, QuerySelectorAll) |
| DOM-Modell | Eigenes Baummodell | Nah an der W3C-DOM-API |
| Text direkt parsen | HtmlDocument.LoadHtml(html) | Über einen Browsing-Kontext |
| Seite selbst herunterladen | Nein, Sie liefern das HTML | Ja, mit dem Standardlader |
| Typischer Einsatz | Mit HttpClient geladenes HTML parsen | Eine Seite öffnen und mit CSS-Selektoren navigieren |
Das Beispiel zum Laden aus einer Zeichenkette in der Dokumentation von HtmlAgilityPack zeigt das Muster: Ein HtmlDocument wird erzeugt, mit LoadHtml die HTML-Zeichenkette übergeben und über DocumentNode eine XPath-Abfrage ausgeführt (der Aufruf in der Dokumentation lautet SelectSingleNode, das Gegenstück für mehrere Knoten ist SelectNodes). AngleSharp öffnet im Beispiel des eigenen Repositorys die Adresse selbst über einen mit dem Standardlader aufgebauten Kontext und wendet mit QuerySelectorAll einen CSS-Selektor an.
Die Wahl hängt meist an der Gewohnheit. Wenn Sie die Anfrage ohnehin mit HttpClient senden, haben Sie eine HTML-Zeichenkette in der Hand, und der Weg über LoadHtml aus HtmlAgilityPack ist der kürzeste; die Beispiele in diesem Beitrag nutzen ihn. Wenn Sie den in der Browserkonsole erprobten CSS-Selektor unverändert in den Code übernehmen wollen, ist AngleSharp bequemer. Die beiden Selektorsprachen haben wir in CSS-Selektor oder XPath: Was passt zum Web Scraping? verglichen und wiederholen das hier nicht.
Keine der beiden Bibliotheken führt JavaScript aus. Kommen die Daten erst durch ein Skript im Browser, brauchen Sie keinen Parser, sondern Browserautomatisierung: Statische und dynamische Seiten beim Web Scraping erklärt den Unterschied, Playwright und Selenium im Vergleich stellt die beiden Werkzeuge gegenüber.
Erstes Beispiel: eine einzelne Seite laden und parsen
Das folgende Beispiel lädt eine einzelne Katalogseite und gibt Buchtitel samt Preis aus. Der Code folgt der Konsolenvorlage von .NET 8 und neuer, mit Top-Level-Anweisungen und impliziten using-Direktiven; deshalb stehen System, System.Linq und System.Net.Http nicht extra darin.
using HtmlAgilityPack;

// Der Verbindungspool lebt im Handler; wir bauen den Client einmal und nutzen ihn wieder.
var handler = new SocketsHttpHandler
{
    PooledConnectionLifetime = TimeSpan.FromMinutes(2) // Verbindungsdauer wegen DNS-Änderungen
};

using var client = new HttpClient(handler)
{
    Timeout = TimeSpan.FromSeconds(30)
};

// Eine ehrliche Kennung: wer wir sind und wie man uns erreicht.
client.DefaultRequestHeaders.UserAgent.ParseAdd("BookTracker/1.0 (+https://ornek.com/bot)");

var url = "https://books.toscrape.com/catalogue/page-1.html";

using var response = await client.GetAsync(url);
response.EnsureSuccessStatusCode(); // wirft bei Codes außerhalb von 2xx eine HttpRequestException

var html = await response.Content.ReadAsStringAsync();

var document = new HtmlDocument();
document.LoadHtml(html);

// SelectNodes liefert null, wenn kein Knoten passt, deshalb prüfen wir zuerst.
var cards = document.DocumentNode.SelectNodes("//article[contains(@class,'product_pod')]");
if (cards is null)
{
    Console.WriteLine("Seitenstruktur anders als erwartet: keine Produktkarte gefunden.");
    return;
}

foreach (var card in cards)
{
    var title = card.SelectSingleNode(".//h3/a")?.GetAttributeValue("title", "");
    var price = card.SelectSingleNode(".//p[@class='price_color']")?.InnerText.Trim();
    Console.WriteLine($"{title} | {price}");
}
Achten Sie auf drei Details. EnsureSuccessStatusCode wirft eine HttpRequestException, wenn der Statuscode außerhalb des Bereichs 200-299 liegt; wollen Sie den Code selbst lesen, sehen Sie stattdessen in die Eigenschaft IsSuccessStatusCode. SelectNodes liefert ohne Treffer keine leere Sammlung, sondern null; in Code, der das Ergebnis direkt in ein foreach steckt, kommt dieses Verhalten als NullReferenceException zurück. Schließlich verhindert das ? am Ende der SelectSingleNode-Aufrufe, dass ein fehlendes Feld auf einer einzigen Karte den ganzen Job stürzen lässt.
Wie fügt man dem HttpClient einen Proxy hinzu?
Die Proxy-Einstellung sitzt nicht auf dem Client, sondern auf dem darunterliegenden Handler. Die Eigenschaft HttpClientHandler.Proxy nimmt ein Objekt vom Typ IWebProxy entgegen, ihr Standardwert ist null; geben Sie also nichts an, nutzt .NET die Proxy-Einstellung des Betriebssystems oder der Umgebungsvariablen. Für einen Proxy mit Benutzername und Passwort wird ein WebProxy-Objekt aufgebaut, und die Zugangsdaten kommen als NetworkCredential in dessen Eigenschaft Credentials.
using System.Net;

var proxy = new WebProxy("http://pr.proxynet.io:8000")
{
    // Benutzername und Passwort aus dem Panel; nicht fest im Code halten, aus den Einstellungen lesen.
    Credentials = new NetworkCredential("user", "pass")
};

var handler = new SocketsHttpHandler
{
    Proxy = proxy,
    UseProxy = true,
    PooledConnectionLifetime = TimeSpan.FromMinutes(2),
    MaxConnectionsPerServer = 4 // Zahl gleichzeitiger Verbindungen zum selben Server
};

using var client = new HttpClient(handler) { Timeout = TimeSpan.FromSeconds(30) };

using var response = await client.GetAsync("https://books.toscrape.com/");
Console.WriteLine((int)response.StatusCode);
Neben Proxy und UseProxy trägt die Klasse SocketsHttpHandler auch Einstellungen wie PooledConnectionLifetime, MaxConnectionsPerServer, ConnectTimeout und AutomaticDecompression; deshalb greift Code, der Proxy und Verbindungspool gemeinsam konfigurieren will, meist zu ihr statt zu HttpClientHandler.
Zwei Hinweise. Erstens: Enthält das Passwort Zeichen wie @ oder :, betten Sie diese nicht in die Adresszeichenkette ein; als getrennte Felder an ein NetworkCredential übergeben, entfällt das Kodierungsproblem. Zweitens: Schlägt die Proxy-Authentifizierung fehl, kommt die Antwort 407 nicht von der Zielseite, sondern vom Proxy; das Problem liegt also nicht in den Regeln der Website, sondern in Ihrer Konfiguration. Die beiden Authentifizierungsverfahren und die Diagnose dieses Fehlers haben wir in Proxy-Authentifizierung: User:Pass oder IP-Whitelist beschrieben.
Welcher Proxy-Typ passt, hängt von der Aufgabe ab. Bei umfangreichen Jobs gegen die eigene Testumgebung oder gegen Quellen ohne Zugriffsbeschränkung ist Datacenter-Proxy beim Tempo im Vorteil. Bei Zielen, die Rechenzentrumsbereiche sperren, wird Residential-Proxy bevorzugt, dessen Austrittspunkt zu einem Internetanbieter gehört; den Unterschied beider Gruppen auf ASN-Ebene erklären wir in ISP- oder Residential-Proxy: Unterschied und Auswahl.
Wie gibt man in C# einen SOCKS5-Proxy an?
Neben dem HTTP-Proxy lässt sich auch SOCKS nutzen. Microsofts Dokumentation zu HttpClient.DefaultProxy zählt die unterstützten Schemata einzeln auf: http, https, socks4, socks4a und socks5. Dieselbe Seite nennt auch die Adressformate; das Muster für socks5 lautet socks5://[benutzer:passwort@]host[:port]. Bei socks4 und socks4a steht, dass das Passwort ignoriert wird, weil diese Protokolle keine Passwortauthentifizierung kennen.
DefaultProxy ist die statische Eigenschaft, die für alle Clients gilt, deren Handler keinen ausdrücklichen Proxy erhalten hat. Die Standardinstanz wird zuerst aus den Umgebungsvariablen aufgebaut; sind diese nicht definiert, greifen Windows und macOS auf die Proxy-Einstellung des Betriebssystems zurück, während unter Linux eine Instanz ohne Proxy entsteht. Die Variablen in der Dokumentation sind HTTP_PROXY, HTTPS_PROXY, ALL_PROXY und NO_PROXY, das die auszunehmenden Domainnamen enthält. Der Code lässt sich also ohne jede Änderung so ausführen:
# Vor dem Start der Anwendung (Windows PowerShell)
$env:ALL_PROXY = "socks5://user:pass@pr.proxynet.io:1080"
dotnet run
Die Einzelheiten der Proxy-Angabe über Umgebungsvariablen und die Entsprechungen in anderen Werkzeugen haben wir in Proxy-Nutzung mit wget gesammelt. Das Protokoll selbst, seine Unterschiede zum HTTP-Proxy und die Frage, welche Aufgabe zu welchem passt, stehen auf unserer Seite SOCKS5-Proxy.
Wie richtet man Timeout, Abbruch und Wiederholung ein?
Der Standardwert der Eigenschaft HttpClient.Timeout liegt bei 100 Sekunden und gilt für alle Anfragen dieses Clients. Für einen Scraping-Job ist das viel zu lang: Eine einzige Adresse ohne Antwort hält den Ablauf anderthalb Minuten auf. Ein Wert um dreißig Sekunden reicht für die meisten Seiten.
Brauchen einzelne Anfragen eine andere Dauer, nutzen Sie eine CancellationTokenSource. Microsofts Dokumentation schreibt, dass beide Mechanismen zusammenwirken und der kürzere von beiden gilt. Dasselbe Token dient auch dazu, dem gesamten Job eine Obergrenze zu geben: Stoppt die Nutzerin die Arbeit oder ist die Gesamtzeit überschritten, werden alle wartenden Anfragen an einer Stelle abgebrochen.
Die Wiederholungslogik müssen Sie nicht von Grund auf schreiben. Microsofts NuGet-Paket Microsoft.Extensions.Http.Resilience bietet einen fertigen Resilienz-Handler für den HttpClient; beim Aufruf von AddStandardResilienceHandler auf einem IHttpClientBuilder greifen nacheinander die Schichten Ratenbegrenzer, Gesamttimeout, Wiederholung, Schutzschalter und Timeout pro Versuch. Die Standardstrategie macht höchstens drei Wiederholungen und nutzt exponentielles Zurückweichen mit einem Zufallsanteil; zu den behandelten Antworten gehören 408, 429 sowie Codes ab 500. Wie sich das Paket mit einzelnen Clients ohne Dependency Injection einrichten lässt, zeigt der Leitfaden ebenfalls an einem Beispiel.
Bei welchem Statuscode eine Wiederholung sinnvoll ist, ist eine eigene Frage, und die Entscheidung trifft nicht die Bibliothek, sondern Sie: 429 und 503 bessern sich durch Warten, 403 und 407 nicht. Das Lesen des Retry-After-Headers, der richtige Aufbau des exponentiellen Zurückweichens und ein vollständiges Beispiel einer Schleife, die nach Statuscode entscheidet, stehen in HTTP-Statuscodes beim Web Scraping; diesen Code wiederholen wir hier nicht.
Vollständiges Beispiel: ein Job, der die Seiten der Reihe nach durchgeht
Das folgende Beispiel geht die ersten zehn Katalogseiten über einen Proxy durch, begrenzt die gleichzeitigen Anfragen auf zwei, wartet vor jeder Anfrage und schreibt das Ergebnis in eine JSON-Datei.
using System.Collections.Concurrent;
using System.Net;
using System.Text.Json;
using HtmlAgilityPack;

var proxy = new WebProxy("http://pr.proxynet.io:8000")
{
    Credentials = new NetworkCredential("user", "pass")
};

var handler = new SocketsHttpHandler
{
    Proxy = proxy,
    UseProxy = true,
    PooledConnectionLifetime = TimeSpan.FromMinutes(2),
    MaxConnectionsPerServer = 4
};

using var client = new HttpClient(handler) { Timeout = TimeSpan.FromSeconds(30) };
client.DefaultRequestHeaders.UserAgent.ParseAdd("BookTracker/1.0 (+https://ornek.com/bot)");

// Obergrenze für den ganzen Job: läuft die Zeit ab, werden alle wartenden Anfragen abgebrochen.
using var cts = new CancellationTokenSource(TimeSpan.FromMinutes(5));
var token = cts.Token;

var gate = new SemaphoreSlim(2); // höchstens zwei Anfragen gleichzeitig
var results = new ConcurrentBag<Book>();

var tasks = Enumerable.Range(1, 10).Select(async page =>
{
    await gate.WaitAsync(token);
    try
    {
        // Wir legen eine bewusste Pause zwischen die Anfragen.
        await Task.Delay(TimeSpan.FromMilliseconds(500), token);

        var url = $"https://books.toscrape.com/catalogue/page-{page}.html";
        using var response = await client.GetAsync(url, token);

        if (!response.IsSuccessStatusCode)
        {
            Console.WriteLine($"{url}: HTTP {(int)response.StatusCode}");
            return;
        }

        var html = await response.Content.ReadAsStringAsync(token);
        foreach (var book in ParseBooks(html, page))
        {
            results.Add(book);
        }
    }
    finally
    {
        gate.Release();
    }
}).ToList();

await Task.WhenAll(tasks);

var options = new JsonSerializerOptions { WriteIndented = true };
var json = JsonSerializer.Serialize(results.OrderBy(book => book.Page), options);
await File.WriteAllTextAsync("books.json", json, token);

Console.WriteLine($"{results.Count} Datensätze geschrieben.");

// Das Parsen steht in einer eigenen Funktion: ändert sich die Seitenstruktur, ändert sich nur hier etwas.
static IEnumerable<Book> ParseBooks(string html, int page)
{
    var document = new HtmlDocument();
    document.LoadHtml(html);

    var cards = document.DocumentNode.SelectNodes("//article[contains(@class,'product_pod')]");
    if (cards is null)
    {
        yield break;
    }

    foreach (var card in cards)
    {
        var title = card.SelectSingleNode(".//h3/a")?.GetAttributeValue("title", "") ?? "";
        var price = card.SelectSingleNode(".//p[@class='price_color']")?.InnerText.Trim() ?? "";
        yield return new Book(title, price, page);
    }
}

record Book(string Title, string Price, int Page);
SemaphoreSlim bestimmt, wie viele Anfragen gleichzeitig unterwegs sind; Task.WhenAll startet zwar alle Aufgaben der Liste, aber die Semaphore lässt nicht mehr als zwei davon gleichzeitig weiterlaufen. Verwechseln Sie das nicht mit der Einstellung MaxConnectionsPerServer des Handlers: Die eine begrenzt die Zahl der zu öffnenden TCP-Verbindungen, die andere die Zahl der gleichzeitigen Aufgaben, die Ihr Code erzeugt. Den begrifflichen Unterschied behandeln wir in Concurrency und Parallelism.
Das Beispiel geht einen festen Seitenbereich durch. In einem echten Job ist die Seitenzahl vorher nicht bekannt, der Link „weiter" wird verfolgt und die besuchten Adressen werden in einer Warteschlange gehalten. Diesen Aufbau bauen wir in Paginierung im Web Scraping.
Einsatzbereiche
- Preis- und Bestandsverfolgung. Regelmäßige Durchläufe über die eigenen Produkte und über Vergleichsartikel in offenen Katalogen. Den allgemeinen Aufbau beschreibt unsere Lösung zur Preisüberwachung.
- Datensammlung im Unternehmen. Bank-, Versicherungs- und ERP-Teams, die mit C# arbeiten, schreiben die gesammelten Daten ohnehin in eine Datenbank auf der .NET-Seite; im selben Stack zu bleiben, statt eine weitere Sprache aufzunehmen, senkt die Wartungskosten. Für umfangreiche Aufgaben ist unsere Data-Scraping-Lösung der Ausgangspunkt.
- Regelmäßige Durchläufe über viele Quellen. Damit sich die Last nicht auf einen einzigen Austrittspunkt häuft, kommt Rotierender Proxy zum Einsatz.
- Ein eigenes Panel, das eine Sitzung braucht. Ändert sich die IP mitten in einer angemeldeten Sitzung, bricht die Sitzung ab; für solche Aufgaben wird Sticky-Proxy bevorzugt.
- Prüfung regional unterschiedlicher Inhalte. Zu vergleichen, wie dieselbe Seite aus verschiedenen Ländern aussieht, gelingt über den Wechsel des Austrittsorts.
Häufige Fehler
- Bei jeder Anfrage einen neuen
HttpClienterzeugen. Die erste Hälfte des Jobs läuft glatt, dann beginnen die Verbindungsfehler. Weil das Symptom nach einer Netzwerkstörung aussieht, wird die Ursache meist an der falschen Stelle gesucht. - Den Einzelclient ohne
PooledConnectionLifetimeaufsetzen. Ändert sich in einem lang laufenden Dienst der DNS-Eintrag des Ziels oder des Proxys, geht der Client weiter an die alte Adresse. - Das Ergebnis von
SelectNodesnicht prüfen. Ohne Treffer ist der Rückgabewertnull;foreachüberspringt diesen Wert nicht stillschweigend, sondern wirft eine Ausnahme. - Den Code
200ohne Blick in den Antwortrumpf als Erfolg werten. Auch Prüfseiten kommen mit200. Bestätigen Sie, dass ein erwartetes Element auf der Seite steht. - Alle Adressen ohne Pause gleichzeitig starten.
Task.WhenAllstartet Hunderte Aufgaben der Liste ohne Widerspruch; die Grenze müssen Sie setzen. - Zugangsdaten in den Code schreiben. Benutzername und Passwort des Proxys werden aus einer Einstellungsdatei oder einer Umgebungsvariablen gelesen und gehören nicht ins Repository.
- Das Passwort in die Adresszeichenkette einbetten und die Kodierung vergessen. Ein Passwort mit
@zerlegt den Rest der Adresse;NetworkCredentialbeseitigt dieses Problem.
Entscheidungshilfe
| Bedarf | Empfehlung |
|---|---|
| Eigenständiger Konsolenjob | Ein static gehaltener HttpClient plus PooledConnectionLifetime |
| Anwendung mit Dependency Injection | IHttpClientFactory, vorzugsweise als typisierter Client |
| Parsen mit XPath | HtmlAgilityPack, LoadHtml plus SelectNodes |
| Im Browser erprobter CSS-Selektor | AngleSharp, QuerySelectorAll |
| Inhalt, der über JavaScript kommt | Browserautomatisierung statt Parser |
| Proxy mit Benutzername und Passwort | WebProxy plus NetworkCredential |
| SOCKS5-Austritt | socks5://-Adresse, Umgebungsvariable oder DefaultProxy |
| Wiederholung und Schutzschalter | Microsoft.Extensions.Http.Resilience |
| Nebenläufigkeitsgrenze | SemaphoreSlim plus MaxConnectionsPerServer |
Häufige Fragen
Welche Pakete brauche ich, um mit C# Daten abzurufen?
Auf der HTTP-Seite ist kein zusätzliches Paket nötig, System.Net.Http gehört zur Laufzeit. Für das Parsen von HTML fügen Sie ein NuGet-Paket hinzu: HtmlAgilityPack, wenn Sie mit XPath arbeiten, AngleSharp, wenn Sie mit CSS-Selektoren arbeiten. Wollen Sie Wiederholung und Schutzschalter, kommt Microsoft.Extensions.Http.Resilience dazu. System.Text.Json zum Schreiben der Daten als JSON ist ohnehin enthalten.
Warum sollte ich das HttpClient-Objekt nicht in einem using-Block nutzen?
Weil der Verbindungspool im Handler unter dem Client liegt. Bei jeder Anfrage einen neuen Client zu erzeugen und zu schließen, schließt auch den Pool, und da die Ports geschlossener TCP-Verbindungen nicht sofort frei werden, stoßen Sie bei viel Last an das Portlimit. Richtig ist ein Client, der so lange lebt wie die Anwendung, oder die Verwaltung über IHttpClientFactory.
Ich habe einen Proxy gesetzt, bekomme aber Fehler 407: wo soll ich suchen?
407 kommt nicht von der Zielseite, sondern vom Proxy-Server und sagt, dass Ihre Identität nicht bestätigt wurde. Prüfen Sie zuerst, ob die Eigenschaft Credentials des WebProxy-Objekts gefüllt ist, dann, ob Benutzername und Passwort richtig geschrieben sind. Arbeiten Sie mit IP-Freigabe, muss die öffentliche IP-Adresse, von der die Anfrage ausgeht, auf der Liste stehen. Wiederholen löst diesen Fehler nicht.
Lässt sich in C# ein SOCKS5-Proxy nutzen?
Ja. Microsofts Dokumentation zu HttpClient.DefaultProxy führt http, https, socks4, socks4a und socks5 als unterstützte Adressformate auf. Das Muster für socks5 lautet socks5://benutzer:passwort@host:port. Auf derselben Seite steht auch, dass ein bei socks4 oder socks4a angegebenes Passwort ignoriert wird, weil diese Protokolle keine Passwortauthentifizierung kennen.
Mein Code bricht, sobald sich die Seitenstruktur ändert, was tun?
Verhindern lässt sich der Bruch nicht, früh bemerken schon. Halten Sie das Parsen in einer eigenen Funktion, protokollieren Sie ein null aus SelectNodes als Fehler und notieren Sie bei jedem Lauf die Zahl der gefundenen Datensätze. Deutlich weniger Datensätze als erwartet sind das erste Zeichen einer Strukturänderung. Selektoren so kurz und aussagekräftig wie möglich zu halten, senkt die Bruchgefahr zusätzlich.
Wann sollte ich zu Selenium oder Playwright wechseln?
Wenn die gesuchten Daten im heruntergeladenen HTML überhaupt nicht vorkommen. Öffnen Sie die Seite in den Entwicklerwerkzeugen des Browsers und sehen Sie sich den Quelltext an: Stehen die Daten im Quelltext, reicht HttpClient, und Browserautomatisierung bringt nur Langsamkeit. Kommen die Daten später über eine Anfrage, ist es meist am saubersten, die Adresse dieser Anfrage direkt aufzurufen. Geht beides nicht, wechseln Sie auf den Weg aus Selenium mit Proxy.
Fazit
Das Schwierige am Datenabruf mit C# ist nicht das Parsen, sondern der Aufbau des Clients. Eine einzige HttpClient-Instanz, die so lange lebt wie die Anwendung, eine mit PooledConnectionLifetime begrenzte Verbindungsdauer und ein Timeout um dreißig Sekunden halten den Job aufrecht, während er wächst. Den Proxy geben Sie der Eigenschaft Proxy des Handlers als WebProxy, die Zugangsdaten halten Sie mit NetworkCredential in getrennten Feldern. Die Ratengrenze setzen Sie mit SemaphoreSlim im eigenen Code, die Wiederholung überlassen Sie einem fertigen Resilienz-Handler. Das Parsen in einer eigenen Funktion zu halten sorgt dafür, dass Sie bei einer Strukturänderung nur eine Stelle anfassen. Die passenden Proxy-Typen für Ihre Datensammlung finden Sie in unseren Proxy-Diensten.


