Bir web siteniz varsa llms.txt büyük ihtimalle karşınıza iki yoldan biriyle çıkmıştır. Ya bir SEO eklentisi "yapay zekâ sizi bulsun" diye bu dosyayı oluşturmayı önerdi ya da bir Lighthouse raporunda, yeni Ajan Tabanlı Tarama başlığının altında "llms.txt, önerilere uygun değil" satırını gördünüz. Ardından Google Arama'nın bu dosyayı yok saydığını okudunuz. İkisi de doğru; dosyanın ne işe yaradığını görünce aralarındaki çelişki de ortadan kalkıyor.
Bu yazıda dosyanın biçimini, llms-full.txt'yi ve sayfaların Markdown sürümlerini, llms.txt'nin robots.txt ve sitemap.xml'den farkını anlatıyoruz. Kendi /llms.txt dosyamızdan bir bölüm gösteriyoruz; ardından Google, Chrome, OpenAI ve Anthropic'in 5 Ekim 2026 itibarıyla ne söylediğine bakıyor, dosyanın nasıl oluşturulacağıyla bitiriyoruz.
llms.txt nedir?
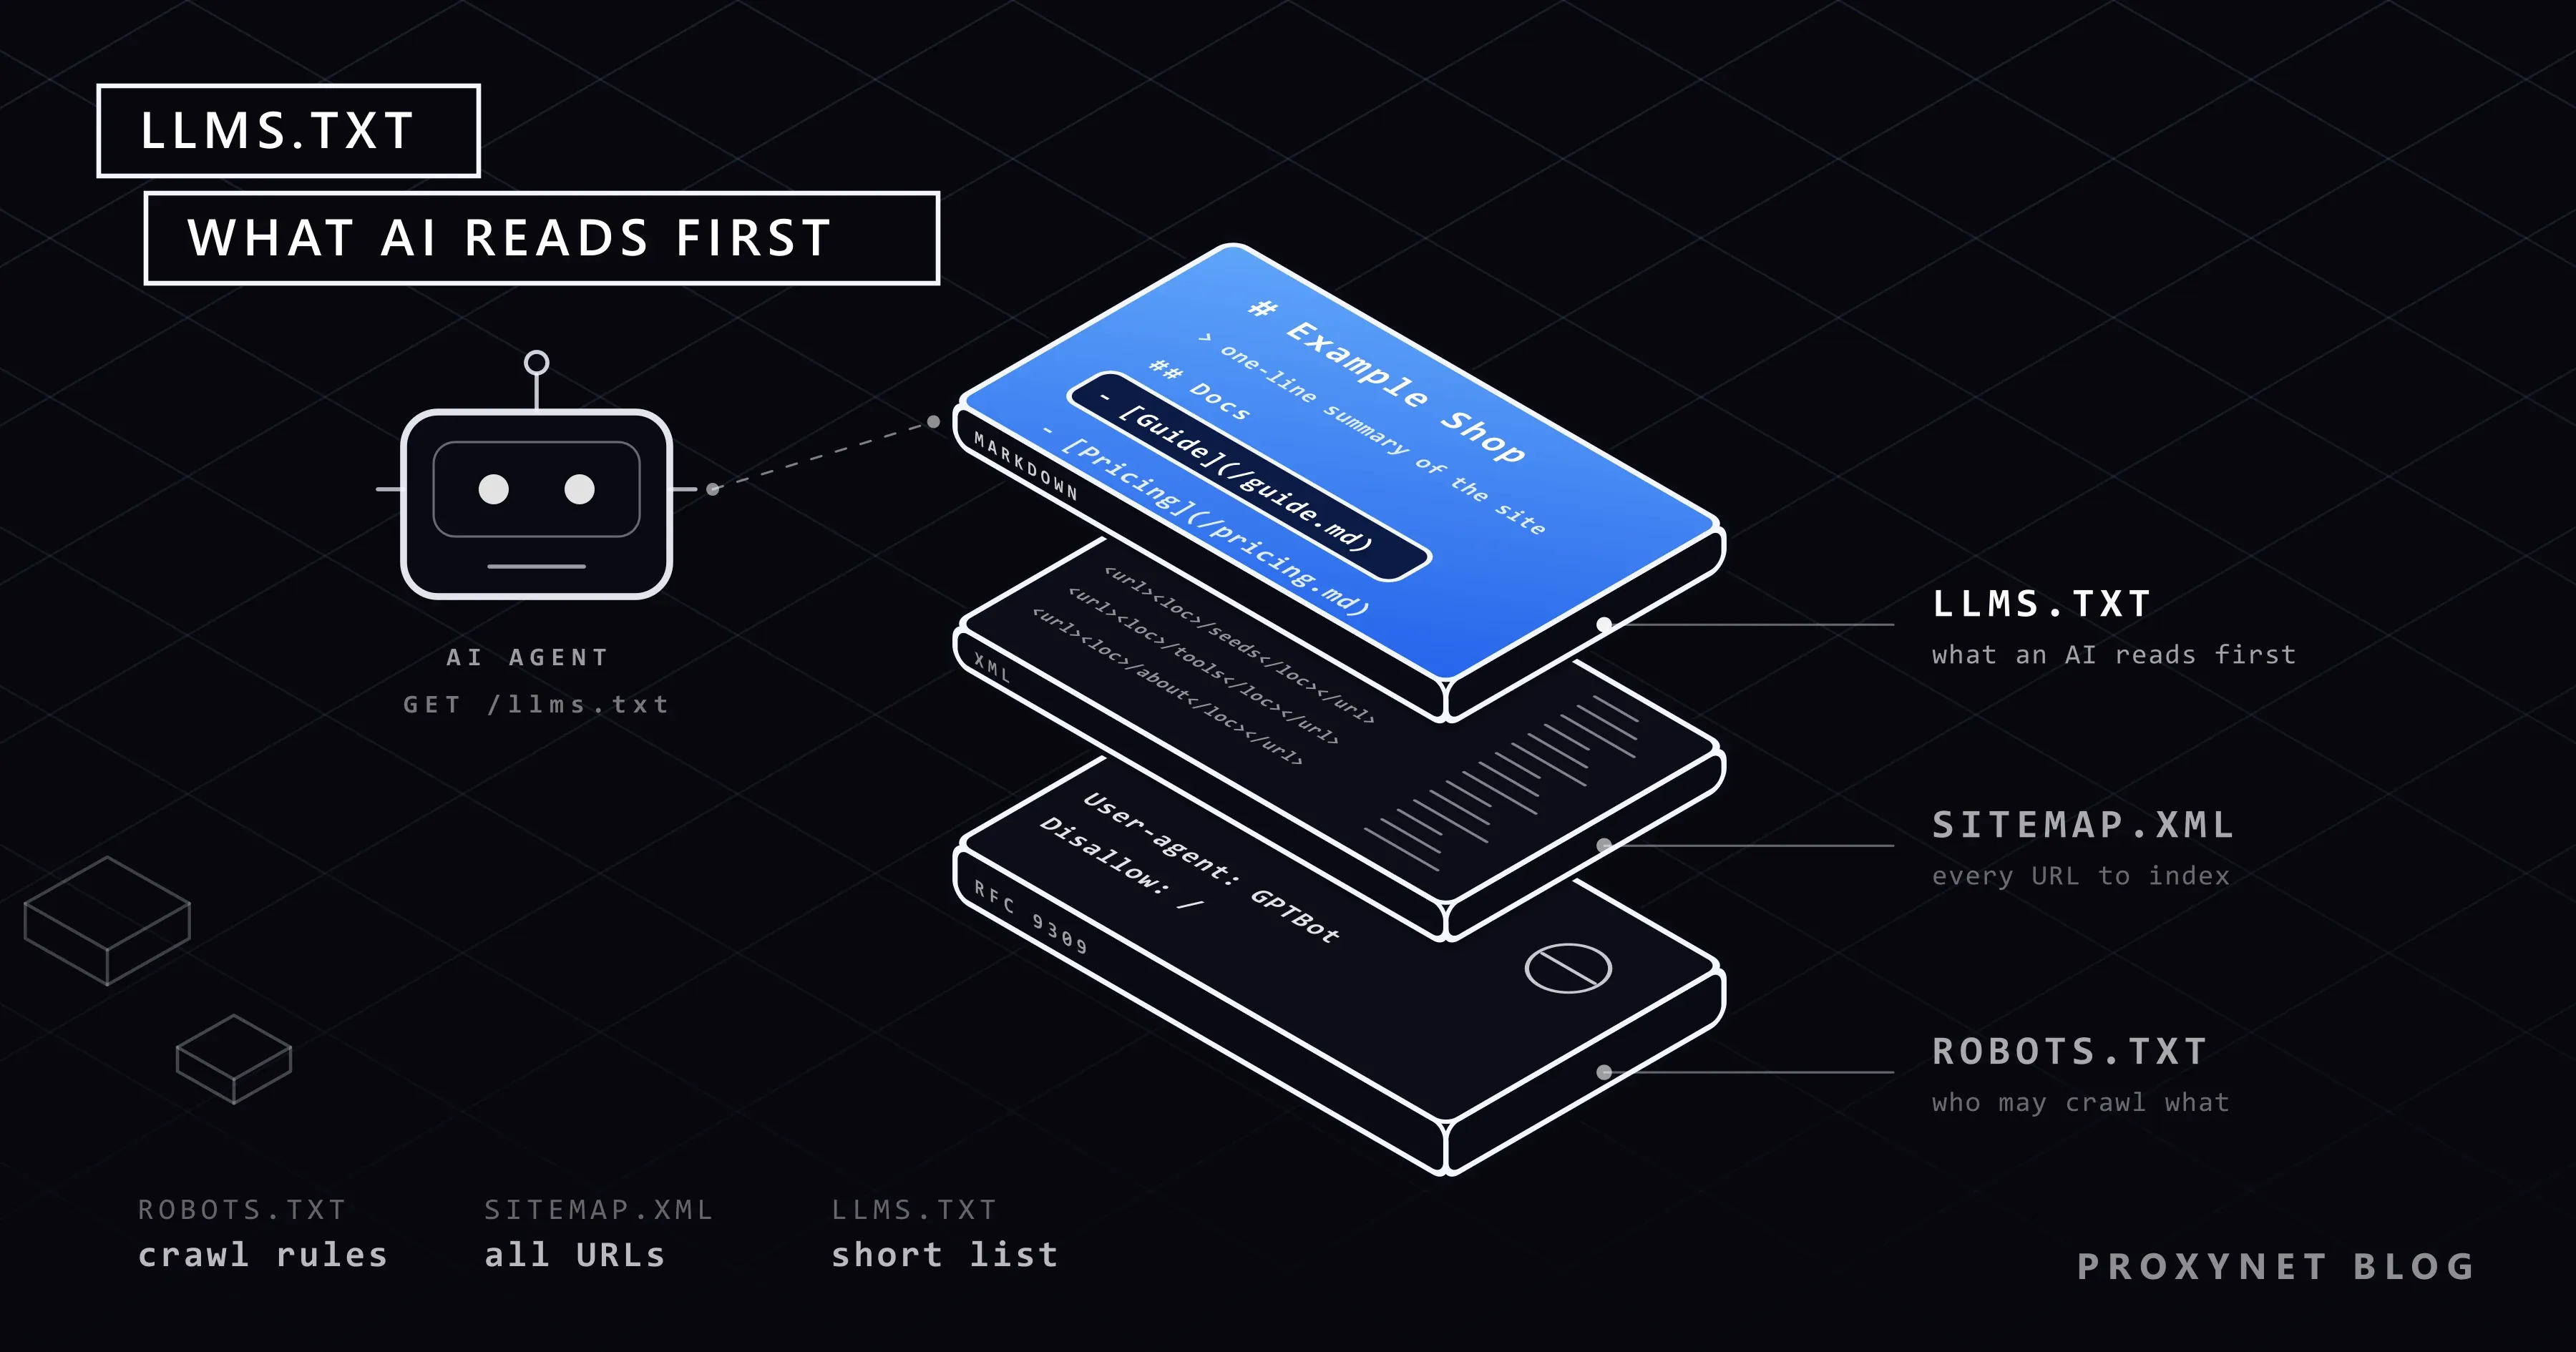
llms.txt, bir sitenin /llms.txt adresine koyduğu, Markdown ile yazılmış bir metin dosyasıdır. ChatGPT, Claude ve Gemini gibi araçların arkasındaki büyük dil modeline (LLM) sitenin ne olduğunu ve hangi sayfaların okunmaya değer olduğunu söyler. Çözdüğü sorun boyuttur: Bir model aynı anda ancak sınırlı miktarda metni dikkate alabilir, buna bağlam penceresi denir. Menüleri ve betikleriyle bütün bir web sitesi bu pencereye nadiren sığar.
Jeremy Howard öneriyi 3 Eylül 2024'te llmstxt.org adresinde yayımladı; 10 Ağustos 2026 tarihli ikinci sürüm, iki yıllık kullanım deneyimini yansıtıyor. Dosya eğitimden çok çıkarım (inference), yani modelin bir soruya cevap ürettiği an için düşünülmüştür: Onu bir sonraki model için malzeme toplayan bir crawler (tarama botu) değil, kullanıcı bir şey sorduğunda cevap arayan bir asistan okur.
llms.txt yaygınlaşmış bir uygulamadır; arkasında bir RFC ya da W3C belirtimi yoktur. Bir kural dosyası da değildir: İçindeki hiçbir satır bir sayfaya erişime izin vermez ya da erişimi yasaklamaz.
llms.txt dosyası neye benzer?
Öneri, bölümlerin sırasını belirler. Yalnızca ilki zorunludur:
- Sitenin ya da projenin adını taşıyan bir H1 başlığı.
- Alıntı bloğu (blockquote) içinde, temel bilgileri veren kısa bir özet.
- Başlıksız paragraflar ya da listeler, örneğin sitenin nasıl düzenlendiği gibi ayrıntılar için.
- Link listeleri taşıyan H2 bölümleri. Her madde bir Markdown linkidir, ardından isteğe bağlı bir not gelir:
- [Ad](url): not. Optionaladlı bir bölüm. Yerleşik kullanıma göre, ajanın yer kalmadığında atlayabileceği linkler buraya konur.
Küçük bir online mağazanın dosyası şöyle olabilir. Mağaza da adresleri de gerçek değildir:
# Örnek Bahçe Malzemeleri

> Örnek Bahçe Malzemeleri tohum, bahçe aletleri ve sulama parçalarını online satar ve tüm AB ülkelerine gönderim yapar.

Her ürün sayfası depo bazında stok bilgisini gösterir. Bakım rehberlerini kendi ekibimiz yazar.

## Mağaza

- [Tohumlar](https://example.com/tohumlar.md): ekim ayına göre sıralanmış sebze ve çiçek tohumları
- [Sulama](https://example.com/sulama.md): damla sulama setleri, zamanlayıcılar ve yedek parçalar, uyumluluk tablolarıyla

## Yardım

- [Kargo ve iade](https://example.com/kargo.md): ülkelere göre teslim süreleri, iade süresi ve masraflar
- [İletişim](https://example.com/iletisim): e-posta ve telefon destek saatleri

## Optional

- [Şirket tarihçesi](https://example.com/hakkimizda.md)
Notlar önemlidir: Ajan hangi linki açacağına yalnızca ada ve nota bakarak karar verir. Bu yüzden "ülkelere göre teslim süreleri, iade süresi ve masraflar" notu, tek başına "Kargo" yazmaktan çok daha işe yarar.
Gerçek bir örnek: kendi /llms.txt dosyamız
proxynet.io/llms.txt adresindeki dosyamızı kimse elle düzenlemiyor. Bir betik, sayfaları oluşturan verinin aynısından dosyayı her derlemede yeniden üretiyor; böylece yeni bir blog yazısı listede eksik kalamıyor. Dosya # Proxynet başlığıyla ve kim olduğumuzu, ne sattığımızı, faturalandırmanın nasıl işlediğini anlatan dört satırlık bir alıntı bloğuyla açılıyor. Türkçe bölüm şöyle başlıyor:
## Şirket (Türkçe)

- [Ana sayfa](https://proxynet.io/tr): tüm proxy türleri, altyapı ve panel hakkında genel bakış
Son bölümde ise Optional başlığı kullanılıyor:
## Optional

- [Proxynet (Deutsch)](https://proxynet.io/de): site home in Deutsch
- [Blog (Deutsch)](https://proxynet.io/de/blog): blog index in Deutsch; every post is also available as plain Markdown by adding .md to its URL
İngilizce ve Türkçe sayfalar tek tek listeleniyor; diğer dört dil İngilizce yapının aynısını izlediği için Optional bölümünde duruyor. Blog yazıları .md adresleriyle, yani yazının düz Markdown kopyasıyla listeleniyor. Bu kopyalar X-Robots-Tag: noindex başlığıyla gönderildiği için arama sonuçlarında asıl sayfayla yarışmıyor. Her yazı iki dilde listelendiği için dosyada birkaç yüz link var; çoğu sitede bir iki sayfalık bir dosya daha iyi sonuç verir.
Elle yazdığımız ilk sürümü PageSpeed Insights "llms.txt does not follow recommendations" (Türkçe arayüzde "llms.txt, önerilere uygun değil") uyarısıyla işaretlemişti. Bütün linkler çıplak URL olarak yazıldığı için Markdown linki arayan kontrol hiçbirini bulamıyordu. Dosyada ayrıca H3 başlıklarının altına yerleştirilmiş listeler ve 404 dönen iki şablon URL'si vardı. Dosyayı otomatik üretmeye geçmek üç sorunu birden çözdü.
llms-full.txt ve sayfaların Markdown sürümleri
llms.txt sayfaları gösteren bir dizindir. Yanında sık sık iki yardımcı dosya görülür.
Markdown sürümleri. Öneri, sitelerden faydalı sayfaların temiz bir Markdown kopyasını aynı adresin sonuna .md ekleyerek sunmalarını ister (/rehber.html.md; adreste dosya adı yoksa /rehber/index.html.md). Markdown başlıkları, listeleri, tabloları ve linkleri korur, menüleri ve betikleri atar; böylece aynı içerik bağlam penceresinde çok daha az yer kaplar. İkinci sürüm bu kopyaları bulmanın bir yolunu da ekliyor: sayfanın HTML'inde ya da HTTP Link başlığında, türü text/markdown olan bir rel="alternate" linki. Blog yazılarımızda bu etiket var.
Site Cloudflare arkasındaysa Markdown for Agents özelliği ayrı dosya gerektirmeden benzer bir iş yapar: İstemci Accept: text/markdown gönderdiğinde Cloudflare HTML sayfayı Markdown'a çevirir. Pro, Business ve Enterprise planlarında AI Crawl Control (yapay zekâ tarama denetimi) altındaki bir anahtarla açılır.
llms-full.txt. Bu dosya önerinin parçası değildir; dokümantasyon platformlarının yaygınlaştırdığı bir uygulamadır ve dokümantasyonun tam metnini tek dosyada toplar. Anthropic'in geliştirici dokümantasyonu ikisini birden yayımlıyor; llms.txt dosyası da llms-full.txt'ye giden bir linkle bitiyor. llms-full.txt, bir kodlama asistanının baştan sona okuduğu API referansları için uygundur; bir mağazaya dizin yeterlidir.
llms.txt, robots.txt ve sitemap.xml farkı
Üç dosya sitenin kök dizininde yan yana durur ama farklı sorulara cevap verir:
| robots.txt | sitemap.xml | llms.txt | |
|---|---|---|---|
| Soru | Botlar hangi yolları tarayabilir? | Hangi URL'ler var? | Yapay zekâ önce neyi okumalı? |
| Asıl okur | Arama ve yapay zekâ botları | Arama motorları | Yapay zekâ asistanları ve ajanları |
| Biçim | Düz metin kurallar | XML | Markdown |
| Durum | Standart (RFC 9309) | Sitemaps protokolü | Topluluk önerisi |
| Erişimi denetler mi? | Botlardan uzak durmalarını ister | Hayır | Hayır |
| Kapsam | Yalnız kurallar | Dizine girecek her sayfa | Kısa bir seçki |
robots.txt RFC 9309 ile tanımlanır. RFC, bu kuralların bir erişim yetkilendirmesi olmadığını açıkça yazar: Kurallara saygılı botlar onlara uyar, ama hiçbir şey botları buna zorlamaz. Her kuralı robots.txt rehberimizde anlattık.
Site haritası (sitemap), arama motorlarının bulmasını istediğiniz her URL'yi listeler; Sitemaps protokolü dosya başına 50.000 URL'ye izin verir. Bir sitenin haritasını nerede arayacağınızı Sitemap Nasıl Bulunur? yazımızda gösterdik. Site haritası eksiksiz olmayı hedefler ve not taşımaz; llms.txt ise bilerek seçicidir.
llms.txt işe yarar mı?
Bu, dosyayı kimin okumasını beklediğinize bağlı. Her şirketin ne söylediğini ya da ne yayına aldığını 5 Ekim 2026'da kontrol ettik.
Google Arama: etkisi yok. Google'ın 15 Mayıs 2026'da yayımladığı yapay zekâ optimizasyonu rehberi, üretken yapay zekâ özellikleri dahil Arama'da görünmek için makinelerin okuyacağı yeni dosyalara ya da Markdown'a gerek olmadığını söylüyor. 15 Haziran 2026'da eklenen not daha da açık: llms.txt görünürlüğü ve sıralamayı ne iyileştirir ne de kötüleştirir, çünkü Google Arama bu dosyaları yok sayar.
Chrome Lighthouse: biçim kontrolü. Chrome DevTools'taki ve PageSpeed Insights'taki denetim aracı Lighthouse'ta yeni bir Ajan Tabanlı Tarama (Agentic Browsing) kategorisi var. Chrome'un puanlama sayfası bu kategoriyi deneysel olarak tanımlıyor: Chrome 150 ya da sonrası gerekiyor ve 0-100 arası bir puan verilmiyor. llms.txt denetim sayfası 5 Mayıs 2026 tarihli; denetimin kaynak kodu da testin tamamını gösteriyor: # ile başlayan bir satır, en az bir Markdown linki ve en az 50 karakter. Dosya isteğe bağlı olduğu için 404 yanıtında denetim uygulanmaz; sunucu hata verirse denetim başarısız olur. Lighthouse biçime bakar, dosyayı herhangi bir yapay zekânın kullanıp kullanmadığına bakmaz.
OpenAI: botlar için robots.txt. OpenAI'ın crawler dokümantasyonu, OAI-SearchBot (ChatGPT araması), GPTBot (model eğitimi), OAI-AdsBot ve ChatGPT-User (kullanıcının başlattığı işlemler) botlarını ve bunların robots.txt ile nasıl yönetileceğini anlatıyor. OpenAI kendi geliştirici dokümantasyonu için bir llms.txt yayımlıyor, ama botlarının başka sitelerin dosyasını okuduğunu söylemiyor.
Anthropic: botlar için robots.txt. Anthropic'in 7 Nisan 2026'da güncellenen tarama hakkındaki yardım makalesi, ClaudeBot (eğitim), Claude-User (kullanıcı istediğinde sayfa getirme) ve Claude-SearchBot (arama kalitesi) botlarını sayıyor; üçü de robots.txt ile yönetiliyor. Makalede llms.txt geçmiyor, ama Anthropic'in geliştirici dokümantasyonu bir llms.txt yayımlıyor.
Kısacası bu şirketlerin hiçbiri llms.txt'yi tarama, sıralama ya da kaynak gösterme için bir sinyal olarak kullanmıyor; yapay zekâ laboratuvarları ise dosyayı kendi dokümantasyonları için yayımlıyor. Geriye kalan gerçek kullanım, ihtiyaç anında okumadır: Bir kodlama asistanı doğru sayfayı bulmak için bir kütüphanenin llms.txt dosyasını açar ya da kullanıcının sitenize gönderdiği bir ajan menüden tahmin yürütmek yerine bu dosyayı okur. Bir metin dosyası izleme betiği çalıştırmadığı için /llms.txt isteklerini analitik aracınızda değil, sunucu loglarında arayın.
Yapay zekâ botlarını llms.txt değil, robots.txt yönetir
llms.txt yapay zekâ şirketlerine neyi kullanabileceklerini söyleyemez. Bir sayfayı dosyaya koymamak onu gizlemez, dosyaya eklemek de izin anlamına gelmez. Botlar robots.txt'ye bakar; her kullanıcı aracısı (user agent) için ayrı bir grup yazılır:
User-agent: GPTBot
Disallow: /

User-agent: ClaudeBot
Disallow: /

User-agent: Google-Extended
Disallow: /
İlk iki grup, OpenAI'ın ve Anthropic'in eğitim botlarının siteden uzak durmasını ister. Google-Extended, Google'ın içeriğinizi Gemini modellerini eğitmek ve cevapları kaynağa dayandırmak (grounding) için kullanıp kullanamayacağını belirler; Google'ın crawler dokümantasyonu, bunun Arama'ya dahil edilmeyi ya da sıralamayı etkilemediğini söylüyor. OAI-SearchBot ve Claude-SearchBot gibi arama botlarının kendi adları vardır; böylece bir site içeriğini model eğitimine kapatırken yapay zekâ aramasında görünmeye devam edebilir. Bizim robots.txt dosyamız GPTBot, ClaudeBot ve Google-Extended'a açıkça izin veriyor; hangi yönde karar verirseniz verin, kararın yeri robots.txt'dir.
llms.txt dosyası nasıl oluşturulur?
- Bir müşterinin bir asistana sizin hakkınızda soracağı sorulara cevap veren sayfaları seçin: ürünler ya da hizmetler, fiyatlar, dokümantasyon, politikalar, iletişim.
- H1 başlığını ve alıntı bloğunu yazın. Modelin başka türlü tahmin etmek zorunda kalacağı bilgileri verin: ne sunduğunuz, kime ve nerede.
- Linkleri H2 başlıkları altında gruplayın:
- [Ad](url): notbiçiminde, tam URL'lerle. İkincil sayfaları## Optionalaltına taşıyın. - Sunabiliyorsanız sayfaların Markdown sürümlerine link verin.
- Dosyayı kök dizine yükleyin.
https://alanadiniz.com/llms.txtadresi 200 durum koduyla, düz metin olarak açılmalı. Ardından Chrome DevTools'ta ya da PageSpeed Insights'ta Lighthouse'u çalıştırın ve Ajan Tabanlı Tarama altındaki llms.txt satırına bakın. - Dosyayı güncel tutun ya da otomatik üretin. Eskimiş bir link ajanı 404 sayfasına gönderir.
Oluşturucular, eklentiler ve platformlar
- WordPress. Bazı SEO eklentileri dosyayı oluşturup güncelliyor. Yoast SEO'da bu, Yoast SEO › Settings (Ayarlar) › Site özellikleri sayfasında, YZ araçları grubundaki bir anahtardır (Yoast'un yardım sayfası); çoklu site (multisite) kurulumlarında kullanılamıyor. llmstxt.org, AIOSEO'yu da listeliyor.
- Shopify. 28 Mayıs 2026 tarihli değişiklik kaydından bu yana her mağaza varsayılan bir
/agents.mddosyası sunuyor;/llms.txtve/llms-full.txtde aynı içeriği gösteriyor. Bunu değiştirmek için tema kod düzenleyicisinde birtemplates/agents.md.liquidşablonu ya da ayrı birllms.txt.liquideklenir. - Dokümantasyon platformları ve site oluşturucular. llmstxt.org, dosyayı üreten platformlar arasında Mintlify, GitBook ve Wix'i, ayrıca VitePress, Docusaurus ve Drupal eklentilerini sayıyor.
- Online oluşturucular sitenizi tarayıp bir taslak çıkarır. Taslağı bir başlangıç olarak görün: Bir crawler, müşterileriniz için hangi sayfaların önemli olduğunu bilemez.
- Kendi derlemeniz. Siteniz bizimki gibi yapılandırılmış veriden üretiliyorsa dosyayı derleme sırasında oluşturun; böylece dosya sayfaların gerisinde kalmaz.
llms.txt'yi kimler okur, ajanlar onu nasıl okumalı?
- API ve yazılım dokümantasyonu. Kodlama asistanları dokümantasyonu ihtiyaç anında, çoğu zaman MCP (Model Context Protocol) üzerinden bağlanan araçlarla okur. llms.txt bu alanda doğdu.
- Mağazalar ve rezervasyon siteleri. Ürün karşılaştıran ajanlar sayfalarınızdaki bilgiye ihtiyaç duyar; sitelerin bu ajanlara bugün nasıl davrandığını AI Alışveriş Ajanları Neden Sitelerde Engelleniyor? yazımızda anlattık.
- İnsanların yapay zekâ tarayıcılarıyla ziyaret ettiği siteler. Bu tarayıcılar sayfaları bir ajan gibi okur; ayrıntısı Yapay Zekâ Tarayıcısı (AI Browser) Nedir, Güvenli mi? yazısında.
- Ajan geliştiren ekipler. Bir sitenin llms.txt dosyası, sıradaki adımı gösteren ucuz bir ilk istektir; bu isteğin yer aldığı döngüyü AI Ajanları Nasıl Çalışır? yazısı anlatıyor.
Ajanı siz geliştiriyorsanız önce robots.txt'yi okuyun: llms.txt'deki bir link, robots.txt'nin sizin kullanıcı aracınız için koyduğu Disallow kuralını geçersiz kılmaz. Dosyayı güvenilmeyen girdi olarak ele alın; içinde prompt injection, yani içeriğe gizlenmiş talimatlar olabilir. İzin listesini ve hız sınırını LLM'e Güvenli Web Erişimi yazımızda anlattık. Botunuzu, adını açıkça söyleyen bir kullanıcı aracısıyla tanıtın. Herkese açık sayfaları büyük ölçekte topluyorsanız web crawler ve veri kazıma sayfalarımız, bu kurallara uyan bir crawler'da proxy'nin yerini anlatıyor.
Sık yapılan hatalar
- Markdown linki yerine çıplak URL. Lighthouse "Dosyada bağlantı yok." uyarısı verir; bizim ilk sürümümüz de bu yüzden takılmıştı.
- Dosyayla yapay zekâ eğitimini engellemeye çalışmak. Bu isteği yalnızca robots.txt grupları taşır.
- Site haritasını olduğu gibi dosyaya yapıştırmak. Notsuz binlerce URL, ajana bir sayfayı diğerine tercih etmesi için hiçbir neden vermez.
- Şablon ya da ölü linkler, örneğin
{slug}gibi doldurulmamış değişkenler ya da artık 404 dönen sayfalar. - HTML ile cevap veren sunucu. Bazı kurulumlar bilinmeyen her adreste ana sayfayı döndürür; yanıtta Markdown başlığı olmadığı için Lighthouse eksik H1 uyarısı verir.
- Dosyayı bir kez yazıp unutmak. Asistanın tekrarlayacağı şey, tam da eskimiş özettir.
Karar rehberi
| Durumunuz | Ne yapmalı |
|---|---|
| Google trafiğini artırmak istiyorsunuz (AI Overviews dahil) | Bu hedef için llms.txt'ye gerek yok; içerik, tarama ve dizine eklemeye odaklanın |
| API ya da ürün dokümantasyonu yayımlıyorsunuz | Markdown sürümleriyle birlikte llms.txt yayımlayın; llms-full.txt'yi değerlendirin |
| WordPress siteniz var | SEO eklentinizde özelliği açın, sonra link listesini elle sadeleştirin |
| Shopify mağazanız var | Varsayılan agents.md'yi bir tema şablonuyla düzenleyin |
| Yapay zekâ eğitim botlarını uzak tutmak istiyorsunuz | robots.txt'ye GPTBot, ClaudeBot ve Google-Extended grupları ekleyin |
| Lighthouse "llms.txt, önerilere uygun değil" diyor | H1 ekleyin, Markdown linki kullanın, dosyayı 200 koduyla düz metin olarak sunun |
Sıkça sorulan sorular
llms.txt SEO'ya yardımcı olur mu?
Google Arama'da olmaz. Google'ın yapay zekâ optimizasyonu rehberi, Arama'nın llms.txt dosyalarını yok saydığını söylüyor; dosyanın sıralamaya da yapay zekâ özelliklerine de ne faydası ne zararı olur. Bir faydası olacaksa, dosyayı ihtiyaç anında okuyan yapay zekâ araçlarından gelir.
ChatGPT ve Claude llms.txt okur mu?
Ne OpenAI ne de Anthropic botlarının llms.txt kullandığını söyledi; ikisi de denetim aracı olarak robots.txt'yi gösteriyor. Yine de bir kullanıcı ya da bir araç istediğinde asistan bu adresi açıp dosyayı okuyabilir.
llms.txt yapay zekâ botlarını ya da eğitimi engelleyebilir mi?
Hayır, dosyada hiçbir kural yoktur. Bir botun uzak durmasını istiyorsanız robots.txt'ye onun kullanıcı aracısı adıyla bir grup ekleyin.
llms.txt nereye konur?
Alan adının kök dizinine; dosya https://example.com/llms.txt adresinde açılmalıdır. Öneri, yalnızca altındaki sayfaları kapsayan /docs/llms.txt gibi bir alt klasöre de izin verir. Bu, bir alan adının yalnızca bir bölümünü yönettiğinizde işe yarar.
llms.txt ile llms-full.txt arasındaki fark nedir?
llms.txt kısa bir link dizinidir. llms-full.txt ise sayfaların tam metnini tek dosyada toplar; önerinin parçası değil, dokümantasyon platformlarından çıkmış bir uygulamadır.
llms.txt doğrulayıcı ya da kontrol aracı var mı?
Resmî bir kontrole en yakın araç, Lighthouse'taki llms.txt denetimidir. Yalnızca H1 başlığını, en az bir Markdown linkini, asgari uzunluğu ve sunucunun düzgün cevap verip vermediğini sınar; linklerinizin doğru seçilip seçilmediğine bakmaz.
Özet
llms.txt yapay zekâ araçları için Markdown ile yazılmış bir dizindir: bir ad, bir özet ve seçilmiş linkler. Standart değil bir öneridir ve hiçbir şeyi denetlemez; yapay zekâ botlarına neyi alabileceklerini hâlâ robots.txt söyler. Google Arama onu yok sayar, Lighthouse yalnızca biçimine bakar; bu yüzden değeri, ajanların kullanıcı adına okuduğu dokümantasyon, mağaza ve hizmet sitelerinde ortaya çıkar. Kendi dosyanızı kısa tutun ve sitenizin verisinden üretin. Herkese açık sayfaları okuyan ajanlar ya da crawler'lar geliştiriyorsanız proxy hizmetlerimize göz atın.