


































Na maioria dos exemplos de C# para extrair dados ainda aparecem WebClient e quinze linhas que baixam uma única página. Esse exemplo funciona na primeira tentativa e depois quebra em três pontos diferentes quando o trabalho cresce: os sockets se esgotam porque um novo objeto de cliente é criado a cada requisição, o site passa a responder 429 ao ver dezenas de requisições por segundo vindas do mesmo endereço, e o código de análise estoura com uma referência nula assim que a estrutura da página muda. Nenhum dos três problemas vem da biblioteca escolhida: os três vêm de como o cliente foi montado.
Neste artigo montamos um trabalho de extração sobre o .NET atual: o ciclo de vida da instância de HttpClient, a escolha entre HtmlAgilityPack e AngleSharp para analisar o HTML, a definição do proxy por HttpClientHandler ou SocketsHttpHandler, a autenticação com usuário e senha, os endereços SOCKS5, o tempo limite e o cancelamento, o limite de concorrência e as novas tentativas. O alvo de exemplo é books.toscrape.com, um site de treino publicado justamente para esse tipo de trabalho.
De quais etapas é feito um trabalho de scraping em C#?
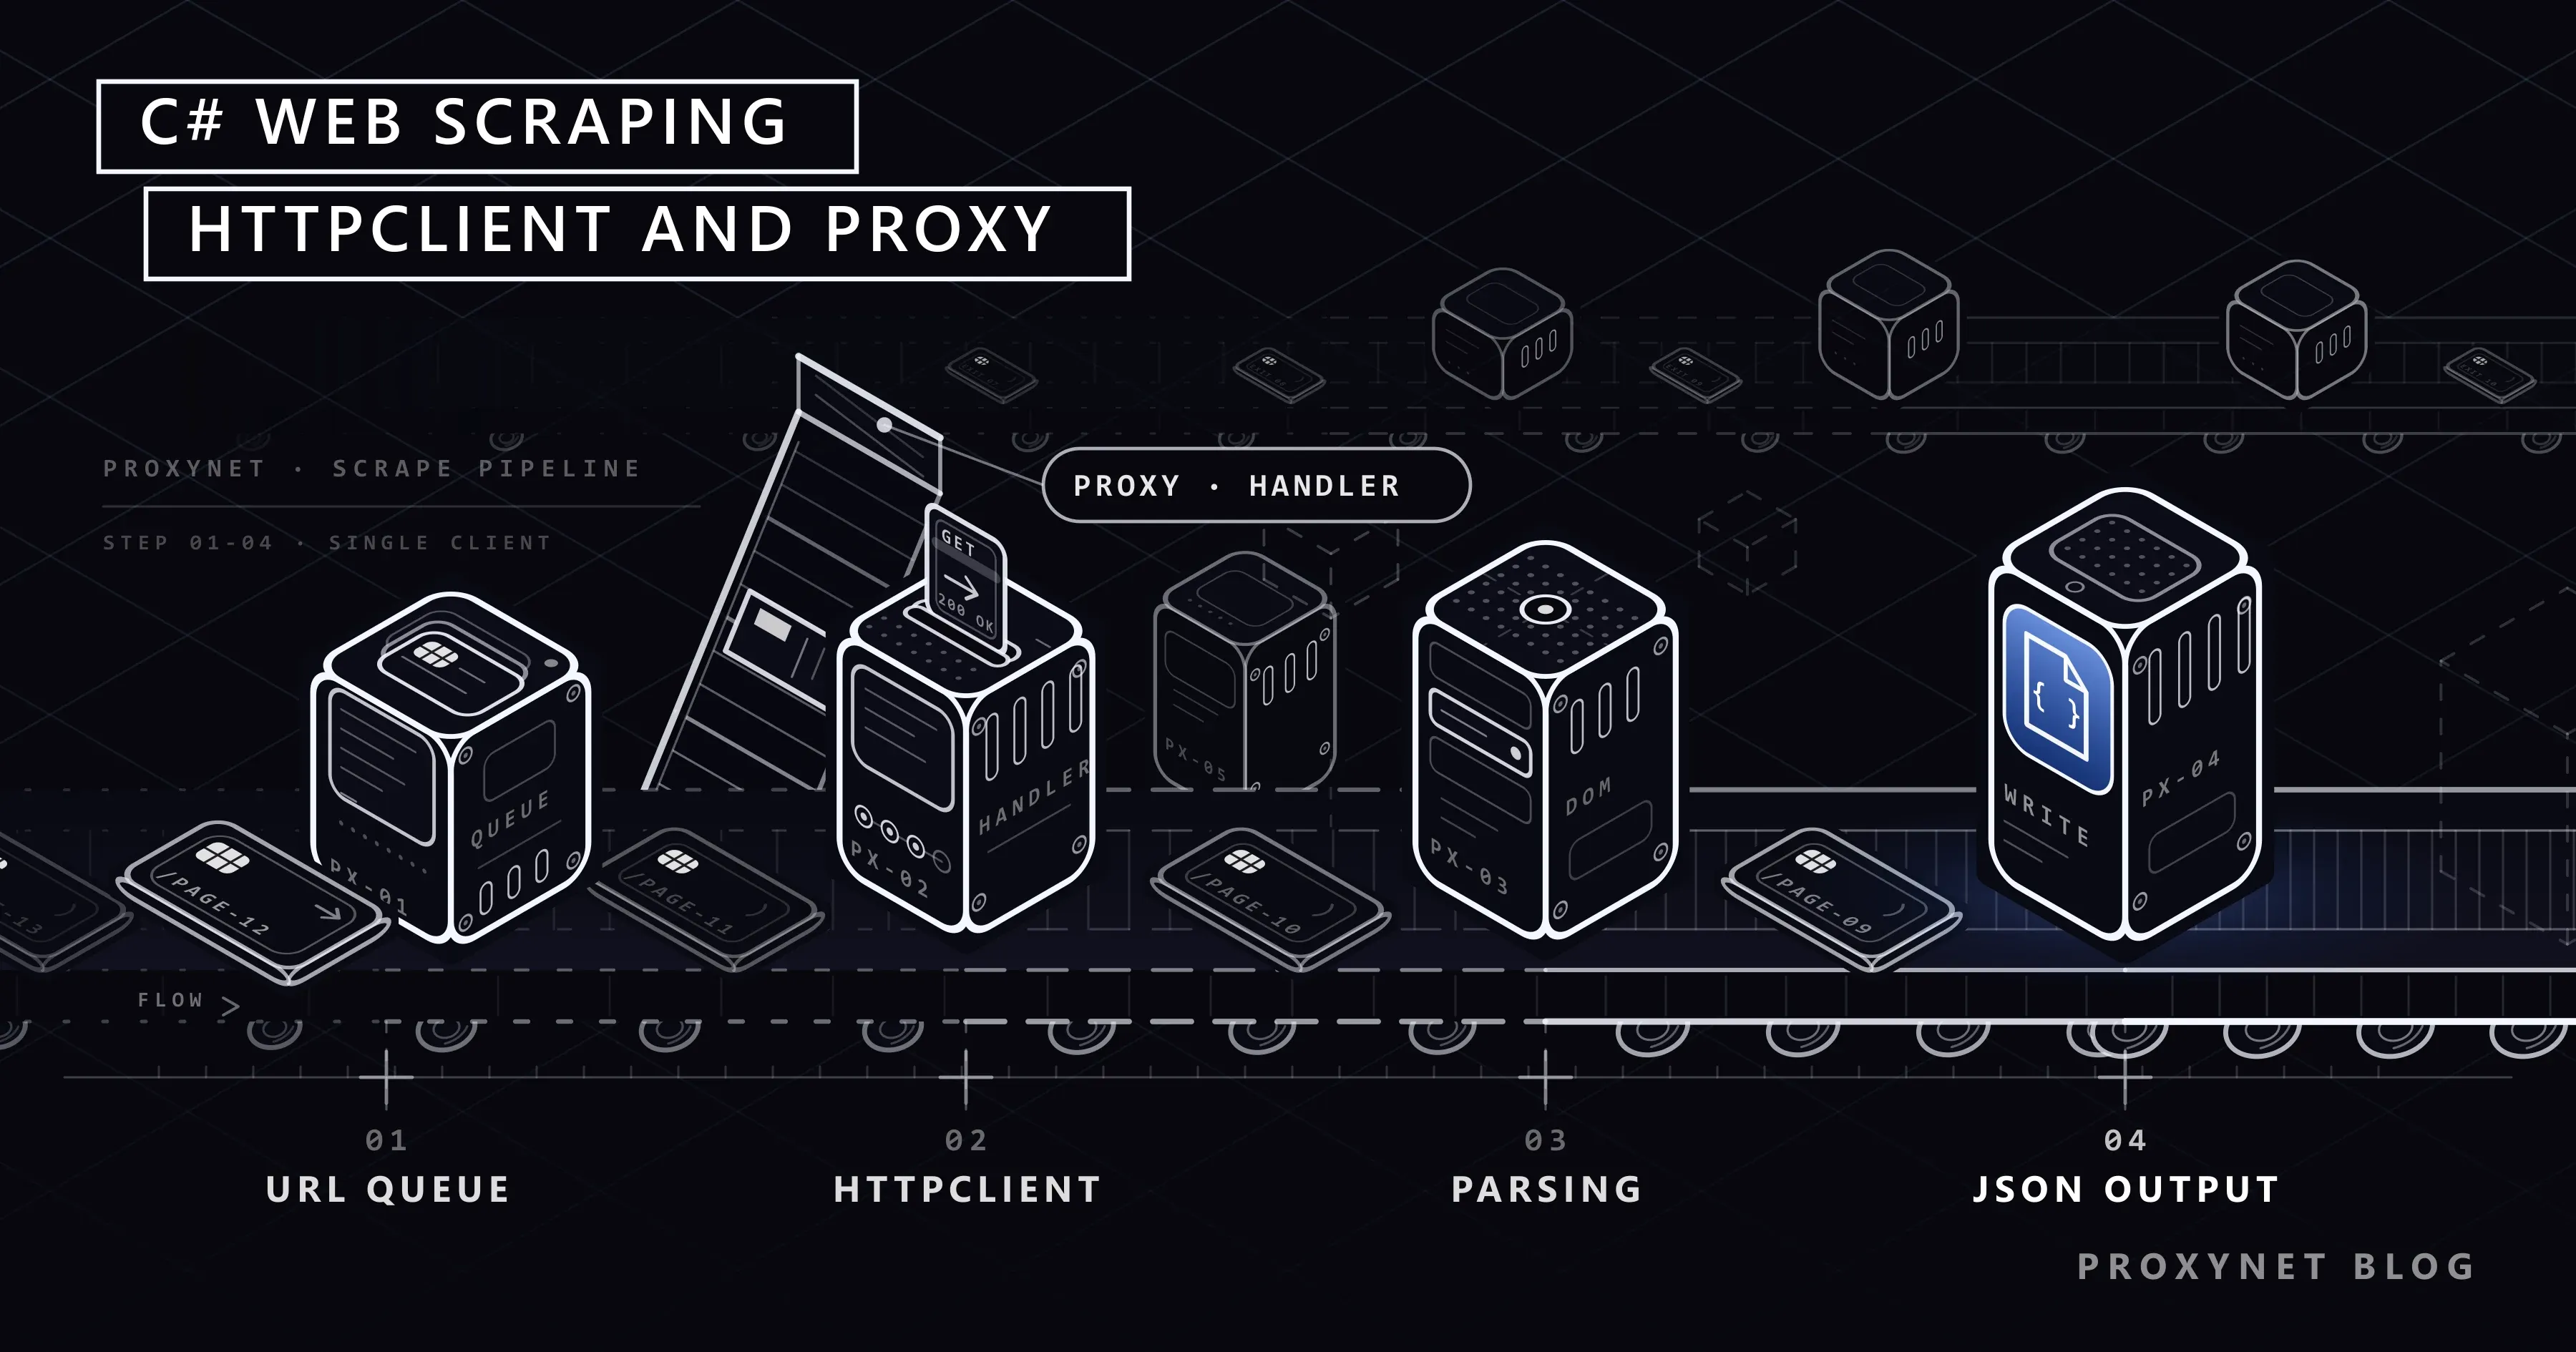
Independentemente da linguagem, todo trabalho de scraping segue as mesmas cinco etapas. No lado do C#, cada etapa corresponde a isto:
- Gerar a lista de endereços. Páginas de categoria, links de paginação ou o sitemap. Guarde a lista como uma fila, assim um trabalho interrompido continua de onde parou.
- Enviar a requisição.
GetAsyncpeloHttpClient. O código de status da resposta é conferido e o corpo é lido como texto. - Analisar o HTML. O texto recebido vira um objeto de documento e os campos que você procura são localizados com um seletor XPath ou CSS.
- Normalizar os dados. O símbolo de moeda no preço, os espaços sobrando em uma linha e os campos vazios são limpos aqui.
- Gravar. JSON, CSV ou uma tabela de banco de dados. Se a etapa de gravação ficar separada, você não precisa baixar os dados de novo toda vez que mudar o código de análise.
Entre essas etapas entram mais duas coisas: a espera entre as requisições e o que fazer diante de um erro. Nenhuma das duas é enfeite acrescentado depois: as duas precisam estar na primeira versão do trabalho. As seções a seguir montam as duas.
Antes de começar: robots.txt, ritmo e uma identidade de cliente honesta
Antes de enviar uma requisição a qualquer site, veja o arquivo robots.txt dele. O formato do arquivo e as regras de interpretação foram padronizados na RFC 9309. O padrão diz que, se o arquivo não puder ser obtido do servidor, o rastreador pode acessar os recursos; ou seja, um endereço que responde 404 não significa proibição. O alvo de exemplo deste artigo é um caso típico: books.toscrape.com é um site vitrine publicado para treino, por isso não tem arquivo robots.txt e o endereço responde 404. Explicamos como ler as regras em O que é robots.txt e como ler o arquivo?.
O robots.txt não é um documento de permissão, é apenas o que o site diz aos clientes automáticos. Acima dele há mais duas responsabilidades. A primeira é o ritmo: pedir a mesma página várias vezes por segundo coloca você na mesma fila dos usuários reais no servidor do site. Coloque uma espera proposital entre as requisições e limite quantas requisições ficam abertas ao mesmo tempo. A segunda é a identidade: o valor de User-Agent que você envia é a única pista para um administrador que queira entrar em contato. Escrever o nome da sua própria aplicação e um endereço de contato é mais honesto e mais prático do que copiar a string de um navegador popular. Contamos para que serve esse cabeçalho em O que é User-Agent? Como ver e como alterar.
Há um terceiro limite, e ele é jurídico. Páginas com dados pessoais, conteúdo atrás de um login e usos que os termos do site proíbem expressamente não são uma questão técnica. Reunimos esse enquadramento em Web scraping é legal? Um panorama.
Por que o HttpClient não é criado de novo a cada requisição?
É aqui que mora o erro mais comum no lado do C#. Como o objeto HttpClient é IDisposable, muitos exemplos o criam dentro de um bloco using e o fecham a cada requisição. O guia de uso do HttpClient da Microsoft explica com todas as letras por que isso está errado: o pool de conexões vive dentro do objeto handler que fica abaixo do cliente, e criar e descartar o cliente a cada requisição leva o pool junto. Como as portas das conexões TCP fechadas não são liberadas na hora, ao subir o ritmo de requisições você esbarra no limite de portas disponíveis do sistema operacional. O sintoma parece mais uma falha de rede do que um erro no código: o trabalho roda bem por um tempo e depois os erros de conexão começam a chegar em sequência.
O certo é usar um único cliente que viva enquanto a aplicação viver. A única desvantagem de um cliente de vida longa é o DNS: o HttpClient resolve o nome de domínio apenas quando a conexão é criada e não acompanha mudanças no registro DNS. O guia também dá a solução: quando você atribui uma duração à propriedade PooledConnectionLifetime de um objeto SocketsHttpHandler, a conexão do pool é fechada ao fim desse prazo e, ao montar a nova, o DNS é consultado outra vez. No exemplo de código do guia esse valor é de quinze minutos, mas o texto diz que ele foi escolhido só para ilustrar e que a duração deve seguir a frequência esperada de mudanças de DNS; o intervalo citado na seção de uso recomendado é de dois minutos.
O outro caminho é o IHttpClientFactory. A fábrica mantém os objetos handler em um pool próprio e entrega a clientes novos um handler cuja vida útil ainda não venceu, então o problema de sockets também não aparece. Se você trabalha em uma aplicação ASP.NET Core ou dentro de um host genérico com injeção de dependência, a fábrica cai melhor. Em um script de console isolado bastam um cliente único static e PooledConnectionLifetime, com menos peças envolvidas.
Mais um ponto: as configurações de conexão do handler não podem ser alteradas depois que a primeira requisição foi enviada. Se você precisa trabalhar com proxies diferentes ou com contêineres de cookies diferentes, monta um objeto de cliente separado para cada configuração. A regra do «cliente único» não quer dizer «um objeto na aplicação», quer dizer «nenhum objeto novo por requisição».
Como escolher entre HtmlAgilityPack e AngleSharp?
No .NET existem duas opções consolidadas para analisar HTML. As duas são pacotes NuGet, as duas lidam com HTML quebrado, e a diferença está na linguagem de seletores e no modelo de trabalho.
| HtmlAgilityPack | AngleSharp | |
|---|---|---|
| Linguagem de seletores | XPath (SelectNodes, SelectSingleNode) | Seletores CSS (QuerySelector, QuerySelectorAll) |
| Modelo DOM | Modelo de árvore próprio | Próximo da API DOM do W3C |
| Analisar texto diretamente | HtmlDocument.LoadHtml(html) | Por um contexto de navegação |
| Baixar a página sozinho | Não, o HTML vem de você | Sim, com o carregador padrão |
| Uso típico | Analisar o HTML baixado com HttpClient | Abrir a página e percorrê-la com seletores CSS |
O exemplo de carga a partir de uma string na documentação do próprio HtmlAgilityPack mostra o padrão: cria-se um HtmlDocument, entrega-se a string HTML com LoadHtml e roda-se uma consulta XPath sobre o DocumentNode (a chamada da documentação é SelectSingleNode; o equivalente para vários nós é SelectNodes). Já o AngleSharp, no exemplo do repositório dele, abre o endereço sozinho por um contexto montado com o carregador padrão e aplica um seletor CSS com QuerySelectorAll.
A escolha costuma ser questão de hábito. Se você já envia a requisição com HttpClient, tem uma string HTML em mãos e o caminho do LoadHtml do HtmlAgilityPack é o mais curto; os exemplos deste artigo usam ele. Se quer levar para o código exatamente o seletor CSS que testou no console do navegador, o AngleSharp é mais confortável. Comparamos as duas linguagens de seletores em Seletor CSS ou XPath: qual usar no web scraping? e não repetimos isso aqui.
Nenhuma das duas bibliotecas executa JavaScript. Se o dado só chega por um script que roda no navegador, você não precisa de um analisador e sim de automação de navegador: Páginas estáticas e dinâmicas explica a diferença e Playwright e Selenium comparados coloca as duas ferramentas lado a lado.
Primeiro exemplo: baixar e analisar uma única página
O exemplo abaixo baixa uma única página do catálogo e imprime os títulos dos livros com os preços. O código segue o modelo de console do .NET 8 e posteriores, com instruções de nível superior e diretivas using implícitas; por isso System, System.Linq e System.Net.Http não aparecem escritos.
using HtmlAgilityPack;

// O pool de conexões vive dentro do handler; montamos o cliente uma vez e reaproveitamos.
var handler = new SocketsHttpHandler
{
    PooledConnectionLifetime = TimeSpan.FromMinutes(2) // vida da conexão, por causa das mudanças de DNS
};

using var client = new HttpClient(handler)
{
    Timeout = TimeSpan.FromSeconds(30)
};

// Uma identidade honesta: quem somos e como falar com a gente.
client.DefaultRequestHeaders.UserAgent.ParseAdd("BookTracker/1.0 (+https://ornek.com/bot)");

var url = "https://books.toscrape.com/catalogue/page-1.html";

using var response = await client.GetAsync(url);
response.EnsureSuccessStatusCode(); // lança HttpRequestException em códigos fora da faixa 2xx

var html = await response.Content.ReadAsStringAsync();

var document = new HtmlDocument();
document.LoadHtml(html);

// SelectNodes devolve null quando nenhum nó casa, por isso conferimos antes.
var cards = document.DocumentNode.SelectNodes("//article[contains(@class,'product_pod')]");
if (cards is null)
{
    Console.WriteLine("Estrutura da página diferente do esperado: nenhum cartão de produto.");
    return;
}

foreach (var card in cards)
{
    var title = card.SelectSingleNode(".//h3/a")?.GetAttributeValue("title", "");
    var price = card.SelectSingleNode(".//p[@class='price_color']")?.InnerText.Trim();
    Console.WriteLine($"{title} | {price}");
}
Repare em três detalhes. O EnsureSuccessStatusCode lança uma HttpRequestException quando o código de status fica fora da faixa 200-299; se preferir ler o código por conta própria, olhe a propriedade IsSuccessStatusCode. O SelectNodes devolve null, e não uma coleção vazia, quando não encontra correspondência, e esse comportamento volta como NullReferenceException no código que joga o resultado direto em um foreach. Por fim, o ? no final das chamadas a SelectSingleNode impede que um campo ausente em um único cartão derrube o trabalho inteiro.
Como adicionar um proxy ao HttpClient?
A configuração de proxy não fica sobre o cliente, e sim sobre o handler que está abaixo dele. A propriedade HttpClientHandler.Proxy recebe um objeto do tipo IWebProxy e o valor padrão dela é null; ou seja, se você não passar nada, o .NET usa a configuração de proxy do sistema operacional ou das variáveis de ambiente. Para um proxy que funciona com usuário e senha, monta-se um objeto WebProxy e as credenciais vão para a propriedade Credentials desse objeto como um NetworkCredential.
using System.Net;

var proxy = new WebProxy("http://pr.proxynet.io:8000")
{
    // Usuário e senha do painel; não deixe fixos no código, leia das configurações.
    Credentials = new NetworkCredential("user", "pass")
};

var handler = new SocketsHttpHandler
{
    Proxy = proxy,
    UseProxy = true,
    PooledConnectionLifetime = TimeSpan.FromMinutes(2),
    MaxConnectionsPerServer = 4 // conexões simultâneas abertas para o mesmo servidor
};

using var client = new HttpClient(handler) { Timeout = TimeSpan.FromSeconds(30) };

using var response = await client.GetAsync("https://books.toscrape.com/");
Console.WriteLine((int)response.StatusCode);
Além de Proxy e UseProxy, a classe SocketsHttpHandler carrega configurações como PooledConnectionLifetime, MaxConnectionsPerServer, ConnectTimeout e AutomaticDecompression; por isso o código que quer configurar o proxy junto com o pool de conexões costuma escolher ela em vez do HttpClientHandler.
Dois avisos. O primeiro: se a senha tiver caracteres como @ ou :, não os embuta dentro da string do endereço; entregues ao NetworkCredential como campos separados, o problema de codificação some. O segundo: quando a autenticação do proxy falha, a resposta 407 vem do proxy e não do site de destino, ou seja, o problema não está nas regras do site e sim na sua configuração. Contamos os dois métodos de autenticação e o diagnóstico desse erro em Autenticação de proxy: user:pass ou whitelist de IP.
Com qual tipo de proxy você vai trabalhar depende do trabalho em si. Em trabalhos de alto volume contra o seu próprio ambiente de teste ou contra fontes sem restrição de acesso, Proxies de datacenter leva vantagem em velocidade. Em alvos fechados às faixas de data center, prefere-se o Proxies residenciais, cujo ponto de saída pertence a um provedor de internet; explicamos a diferença entre os dois grupos no nível de ASN em Proxy ISP ou residencial: diferenças e qual escolher.
Como informar um proxy SOCKS5 no lado do C#?
Além do proxy HTTP, o SOCKS também pode ser usado. A documentação de HttpClient.DefaultProxy da Microsoft lista um a um os esquemas suportados: http, https, socks4, socks4a e socks5. A mesma página traz os formatos de endereço; o padrão do socks5 é socks5://[usuario:senha@]host[:porta]. Nas linhas de socks4 e socks4a está escrito que a senha é ignorada, porque esses protocolos não têm autenticação por senha.
O DefaultProxy é a propriedade estática que vale para todos os clientes cujo handler não recebeu um proxy explícito. A instância padrão dele é montada primeiro a partir das variáveis de ambiente; se elas não estiverem definidas, Windows e macOS recorrem à configuração de proxy do sistema operacional, enquanto no Linux sai uma instância que não usa proxy. As variáveis da documentação são HTTP_PROXY, HTTPS_PROXY, ALL_PROXY e NO_PROXY, que guarda os domínios a deixar de fora. Assim, dá para rodar o código sem alterar nada nele:
# Antes de iniciar a aplicação (Windows PowerShell)
$env:ALL_PROXY = "socks5://user:pass@pr.proxynet.io:1080"
dotnet run
Reunimos os detalhes de informar o proxy por variáveis de ambiente, e os equivalentes em outras ferramentas, em Uso de proxy com o wget. O protocolo em si, as diferenças dele para o proxy HTTP e qual trabalho combina com qual estão na nossa página de Proxies SOCKS5.
Como montar tempo limite, cancelamento e nova tentativa?
O valor padrão da propriedade HttpClient.Timeout é de 100 segundos e vale para todas as requisições que saem daquele cliente. Para um trabalho de scraping esse prazo é longo demais: um único endereço que não responde segura o fluxo do trabalho por um minuto e meio. Um valor perto de trinta segundos basta para a maioria das páginas.
Se alguma requisição específica precisar de outra duração, usa-se um CancellationTokenSource. A documentação da Microsoft diz que os dois mecanismos funcionam juntos e que vale o mais curto dos dois. O mesmo token ainda serve para colocar um teto no trabalho inteiro: quando o usuário interrompe ou o tempo total estoura, todas as requisições pendentes são canceladas de um único ponto.
Você não precisa escrever a lógica de nova tentativa do zero. O pacote NuGet Microsoft.Extensions.Http.Resilience da Microsoft oferece um handler de resiliência pronto para o HttpClient; ao chamar AddStandardResilienceHandler sobre um IHttpClientBuilder, entram em cena, nesta ordem, as camadas de limitador de ritmo, tempo limite total, nova tentativa, disjuntor e tempo limite por tentativa. A estratégia padrão faz no máximo três novas tentativas e usa recuo exponencial com um componente aleatório; entre as respostas tratadas estão 408, 429 e os códigos de 500 para cima. Como montar o pacote com clientes únicos que não usam injeção de dependência também aparece com um exemplo no guia de uso.
Em qual código de status a nova tentativa faz sentido é outro assunto, e quem decide não é a biblioteca e sim você: 429 e 503 melhoram com espera, 403 e 407 não. A leitura do cabeçalho Retry-After, a montagem correta do recuo exponencial e um exemplo completo de um laço que decide pelo código estão em Códigos de status HTTP no web scraping; esse código não repetimos aqui.
Exemplo completo: um trabalho que percorre as páginas em ordem
O exemplo abaixo percorre as dez primeiras páginas do catálogo por um proxy, limita as requisições simultâneas a duas, espera antes de cada requisição e grava o resultado em um arquivo JSON.
using System.Collections.Concurrent;
using System.Net;
using System.Text.Json;
using HtmlAgilityPack;

var proxy = new WebProxy("http://pr.proxynet.io:8000")
{
    Credentials = new NetworkCredential("user", "pass")
};

var handler = new SocketsHttpHandler
{
    Proxy = proxy,
    UseProxy = true,
    PooledConnectionLifetime = TimeSpan.FromMinutes(2),
    MaxConnectionsPerServer = 4
};

using var client = new HttpClient(handler) { Timeout = TimeSpan.FromSeconds(30) };
client.DefaultRequestHeaders.UserAgent.ParseAdd("BookTracker/1.0 (+https://ornek.com/bot)");

// Teto para o trabalho inteiro: se o prazo acabar, todas as requisições pendentes são canceladas.
using var cts = new CancellationTokenSource(TimeSpan.FromMinutes(5));
var token = cts.Token;

var gate = new SemaphoreSlim(2); // no máximo duas requisições ao mesmo tempo
var results = new ConcurrentBag<Book>();

var tasks = Enumerable.Range(1, 10).Select(async page =>
{
    await gate.WaitAsync(token);
    try
    {
        // Colocamos uma espera proposital entre as requisições.
        await Task.Delay(TimeSpan.FromMilliseconds(500), token);

        var url = $"https://books.toscrape.com/catalogue/page-{page}.html";
        using var response = await client.GetAsync(url, token);

        if (!response.IsSuccessStatusCode)
        {
            Console.WriteLine($"{url}: HTTP {(int)response.StatusCode}");
            return;
        }

        var html = await response.Content.ReadAsStringAsync(token);
        foreach (var book in ParseBooks(html, page))
        {
            results.Add(book);
        }
    }
    finally
    {
        gate.Release();
    }
}).ToList();

await Task.WhenAll(tasks);

var options = new JsonSerializerOptions { WriteIndented = true };
var json = JsonSerializer.Serialize(results.OrderBy(book => book.Page), options);
await File.WriteAllTextAsync("books.json", json, token);

Console.WriteLine($"{results.Count} registros gravados.");

// A análise fica em uma função separada: se a estrutura da página mudar, só isto muda.
static IEnumerable<Book> ParseBooks(string html, int page)
{
    var document = new HtmlDocument();
    document.LoadHtml(html);

    var cards = document.DocumentNode.SelectNodes("//article[contains(@class,'product_pod')]");
    if (cards is null)
    {
        yield break;
    }

    foreach (var card in cards)
    {
        var title = card.SelectSingleNode(".//h3/a")?.GetAttributeValue("title", "") ?? "";
        var price = card.SelectSingleNode(".//p[@class='price_color']")?.InnerText.Trim() ?? "";
        yield return new Book(title, price, page);
    }
}

record Book(string Title, string Price, int Page);
O SemaphoreSlim define quantas requisições estão no ar ao mesmo tempo; mesmo que o Task.WhenAll dispare todas as tarefas da lista, o semáforo não deixa mais de duas avançarem juntas. Não confunda isso com a configuração MaxConnectionsPerServer do handler: uma limita o número de conexões TCP que serão abertas, a outra limita o número de trabalhos simultâneos que o seu código produz. Tratamos a diferença conceitual entre as duas em Concorrência e paralelismo.
O exemplo percorre uma faixa fixa de páginas. Em um trabalho real a quantidade de páginas não é conhecida de antemão, o link «próxima» é seguido e os endereços percorridos ficam em uma fila. Montamos esse arranjo em Paginação no web scraping.
Casos de uso
- Acompanhamento de preço e estoque. Varredura periódica dos seus produtos e dos equivalentes em catálogos abertos. O arranjo geral está descrito em nossa solução de monitoramento de preços.
- Trabalhos corporativos de coleta de dados. Times de banco, seguros e ERP que trabalham com C# já gravam o que coletam em um banco do lado .NET; ficar na mesma solução em vez de somar outra linguagem reduz o custo de manutenção. Para trabalhos amplos, nossa solução de extração de dados é o ponto de partida.
- Varredura periódica de muitas fontes. Para que a carga não se acumule em um único ponto de saída, usa-se Proxies rotativos.
- Um painel seu que exige sessão. Se o IP mudar no meio de uma sessão logada, a sessão cai; nesse tipo de trabalho prefere-se Proxies de sessão fixa.
- Verificação de conteúdo que muda por região. Comparar como a mesma página aparece a partir de países diferentes é possível trocando a localização de saída.
Erros comuns
- Criar um
HttpClientnovo a cada requisição. A primeira metade do trabalho corre bem e depois começam os erros de conexão. Como o sintoma parece uma falha de rede, o diagnóstico costuma ser procurado no lugar errado. - Montar o cliente único sem
PooledConnectionLifetime. Em um serviço de longa duração, quando o registro DNS do alvo ou do proxy muda, o cliente continua indo ao endereço antigo. - Não conferir o resultado de
SelectNodes. Sem correspondência, o valor devolvido énull; oforeachnão pula esse valor em silêncio, ele lança uma exceção. - Tomar um
200como sucesso sem olhar o corpo da resposta. Páginas de verificação também chegam com200. Confirme que um elemento esperado está na página. - Disparar todos os endereços ao mesmo tempo sem espera. O
Task.WhenAlldispara sem reclamar as centenas de tarefas da lista; quem precisa colocar o limite é você. - Escrever as credenciais dentro do código. O usuário e a senha do proxy são lidos de um arquivo de configuração ou de uma variável de ambiente, e não entram no repositório.
- Embutir a senha na string do endereço e esquecer a codificação. Uma senha com
@quebra o resto do endereço; oNetworkCredentialelimina esse problema.
Guia de decisão
| Necessidade | Recomendação |
|---|---|
| Trabalho de console isolado | Um HttpClient único static mais PooledConnectionLifetime |
| Aplicação com injeção de dependência | IHttpClientFactory, de preferência com cliente tipado |
| Análise com XPath | HtmlAgilityPack, LoadHtml mais SelectNodes |
| Seletor CSS testado no navegador | AngleSharp, QuerySelectorAll |
| Conteúdo que chega por JavaScript | Automação de navegador, e não um analisador |
| Proxy com usuário e senha | WebProxy mais NetworkCredential |
| Saída SOCKS5 | Endereço socks5://, variável de ambiente ou DefaultProxy |
| Nova tentativa e disjuntor | Microsoft.Extensions.Http.Resilience |
| Limite de concorrência | SemaphoreSlim mais MaxConnectionsPerServer |
Perguntas frequentes
Quais pacotes preciso instalar para extrair dados com C#?
No lado HTTP não é preciso pacote extra, o System.Net.Http faz parte do runtime. Para analisar HTML você adiciona um pacote NuGet: HtmlAgilityPack se for trabalhar com XPath, AngleSharp se for trabalhar com seletores CSS. Se quiser nova tentativa e disjuntor, acrescenta-se o Microsoft.Extensions.Http.Resilience. Para gravar os dados como JSON, o System.Text.Json já vem junto.
Por que não devo usar o objeto HttpClient dentro de um bloco using?
Porque o pool de conexões está dentro do handler que fica abaixo do cliente. Criar e fechar um cliente novo a cada requisição fecha o pool também e, como as portas das conexões TCP fechadas não são liberadas na hora, em um trabalho pesado você esbarra no limite de portas disponíveis. O certo é usar um único cliente que viva enquanto a aplicação viver, ou gerenciá-lo com o IHttpClientFactory.
Configurei o proxy mas recebo erro 407, onde devo procurar?
O 407 não vem do site de destino e sim do servidor proxy, e diz que a sua identidade não foi verificada. Confira primeiro se a propriedade Credentials do objeto WebProxy está preenchida e depois se o usuário e a senha estão escritos corretamente. Se você trabalha com autorização por IP, o IP público de onde a requisição sai precisa estar na lista. Tentar de novo não resolve esse erro.
Dá para usar proxy SOCKS5 no lado do C#?
Dá. A documentação de HttpClient.DefaultProxy da Microsoft lista http, https, socks4, socks4a e socks5 como formatos de endereço suportados. O padrão do socks5 é socks5://usuario:senha@host:porta. Na mesma página está escrito que a senha informada com socks4 ou socks4a é ignorada, porque esses protocolos não têm autenticação por senha.
Meu código quebra quando a estrutura da página muda, o que faço?
Você não consegue impedir a quebra, mas consegue perceber cedo. Mantenha a análise em uma função separada, registre como erro um null vindo do SelectNodes e anote em cada execução quantos registros foram encontrados. Um número de registros bem abaixo do esperado é o primeiro sinal de que a estrutura mudou. Manter os seletores o mais curtos e significativos possível também reduz a fragilidade.
Quando devo migrar para o Selenium ou o Playwright?
Quando o dado que você procura não está de jeito nenhum no HTML baixado. Abra a página nas ferramentas de desenvolvedor do navegador e veja o código-fonte: se o dado está no fonte, o HttpClient basta e a automação de navegador só traz lentidão. Se o dado chega depois por outra requisição, quase sempre o mais limpo é chamar direto o endereço dessa requisição. Se nenhum dos dois resolver, passa-se ao caminho de Selenium com proxy.
Em resumo
A parte difícil de extrair dados com C# não é a análise, é a montagem do cliente. Uma única instância de HttpClient que viva enquanto a aplicação viver, uma vida de conexão limitada por PooledConnectionLifetime e um tempo limite perto de trinta segundos mantêm o trabalho de pé enquanto ele cresce. O proxy você entrega à propriedade Proxy do handler como um WebProxy e as credenciais você mantém em campos separados com o NetworkCredential. O limite de ritmo você monta com SemaphoreSlim no seu próprio código e a nova tentativa você deixa para um handler de resiliência pronto. Manter a análise em uma função separada faz com que, quando a estrutura da página mudar, você corrija um lugar só. Os tipos de proxy adequados aos seus trabalhos de coleta de dados estão em nossos serviços de proxy.


