O seu log de acesso mostra 40.000 requisições de ontem, todas dizendo ExampleBot/1.0 (+https://bot.example/about). Algumas vêm das faixas que o operador do bot publica, muitas de uma faixa compartilhada de um provedor de nuvem e algumas de conexões residenciais. Quais são do crawler verdadeiro e quais são de alguém usando o nome dele emprestado? A linha User-Agent não responde isso: qualquer cliente pode digitá-la.
O Web Bot Auth é a resposta que o IETF, o órgão por trás de muitos protocolos da internet, está padronizando agora: o bot assina cada requisição com uma chave privada, e o seu site confere a assinatura com uma chave pública que o operador publica. Este artigo mostra o que ele é e em que ponto está o padrão, por que as verificações antigas não bastam, como é uma requisição assinada, quem dá suporte, o que muda para donos de sites e para quem cria bots, e o que uma assinatura não prova.
O que é Web Bot Auth?
O Web Bot Auth é um protocolo em que um cliente automatizado assina as suas requisições HTTP para que o site que as recebe possa verificar qual operador as enviou. Ele se apoia no HTTP Message Signatures, um padrão do IETF publicado como RFC 9421 em fevereiro de 2024 para assinar partes selecionadas de uma mensagem HTTP. O Web Bot Auth acrescenta as regras específicas para bots: quais partes precisam ser assinadas, um valor fixo de tag, um cabeçalho que aponta para as chaves do operador e um formato para publicá-las.
O nome também é o de um grupo de trabalho do IETF, o webbotauth. O escopo dele (charter) cobre crawlers de busca, arquivadores da web, verificadores de links, crawlers de treinamento de IA e agentes de IA que agem em nome de um usuário, em sites voltados principalmente a pessoas; a autenticação de API entre serviços e o login de pessoas ficam de fora.
Em 19 de novembro de 2026, o único documento adotado pelo grupo é o Internet-Draft HTTP Message Signatures for automated traffic (draft-ietf-webbotauth-httpsig-protocol-01, 29 de outubro de 2026), escrito por autores da Cloudflare e do Google e voltado ao Standards Track, o caminho para virar padrão oficial. Ele substitui dois rascunhos anteriores, um sobre a arquitetura e outro sobre o diretório de chaves. Um Internet-Draft é um trabalho em andamento, então nomes de campos e regras ainda podem mudar.
Por que User-Agent e listas de IP não bastam?
O cabeçalho User-Agent e as listas de IPs permitidos identificam um bot por dados que outros clientes podem copiar ou compartilhar, então nenhum dos dois prova quem enviou uma requisição. O User-Agent é uma linha de texto que o próprio cliente escreve; explicamos como ela é montada em O que é User-Agent? Como ver e como alterar. Um crawler bem-comportado coloca ali o nome dele e uma URL de informações, mas nada impede outro cliente de escrever exatamente a mesma linha.
Na nossa máquina de testes, subimos um pequeno servidor em 127.0.0.1 que devolve os cabeçalhos recebidos e enviamos a ele curl -A "ExampleBot/1.0 (+https://example.com/bot)". O servidor recebeu essa string exata como User-Agent, sem nada na requisição que a ligasse a example.com.
As listas de IP são mais sólidas, mas falham em três casos comuns. Bots em infraestrutura de nuvem compartilhada saem por endereços que outros clientes também usam. Agentes de IA que agem por um usuário podem rodar no navegador dessa pessoa e, por isso, saem por uma conexão residencial ou de escritório. E os operadores mudam as suas faixas, então a lista do mês passado pode estar errada hoje.
A verificação clássica para grandes crawlers é o DNS reverso confirmado no sentido direto: o site consulta o nome de host por trás do IP, confere se ele pertence ao domínio do operador e depois resolve esse nome para confirmar que ele retorna o mesmo IP. Isso funciona para operadores que têm o próprio espaço de endereços, mas não para um agente num endereço de nuvem compartilhado ou no notebook de um usuário.
Como o Web Bot Auth funciona?
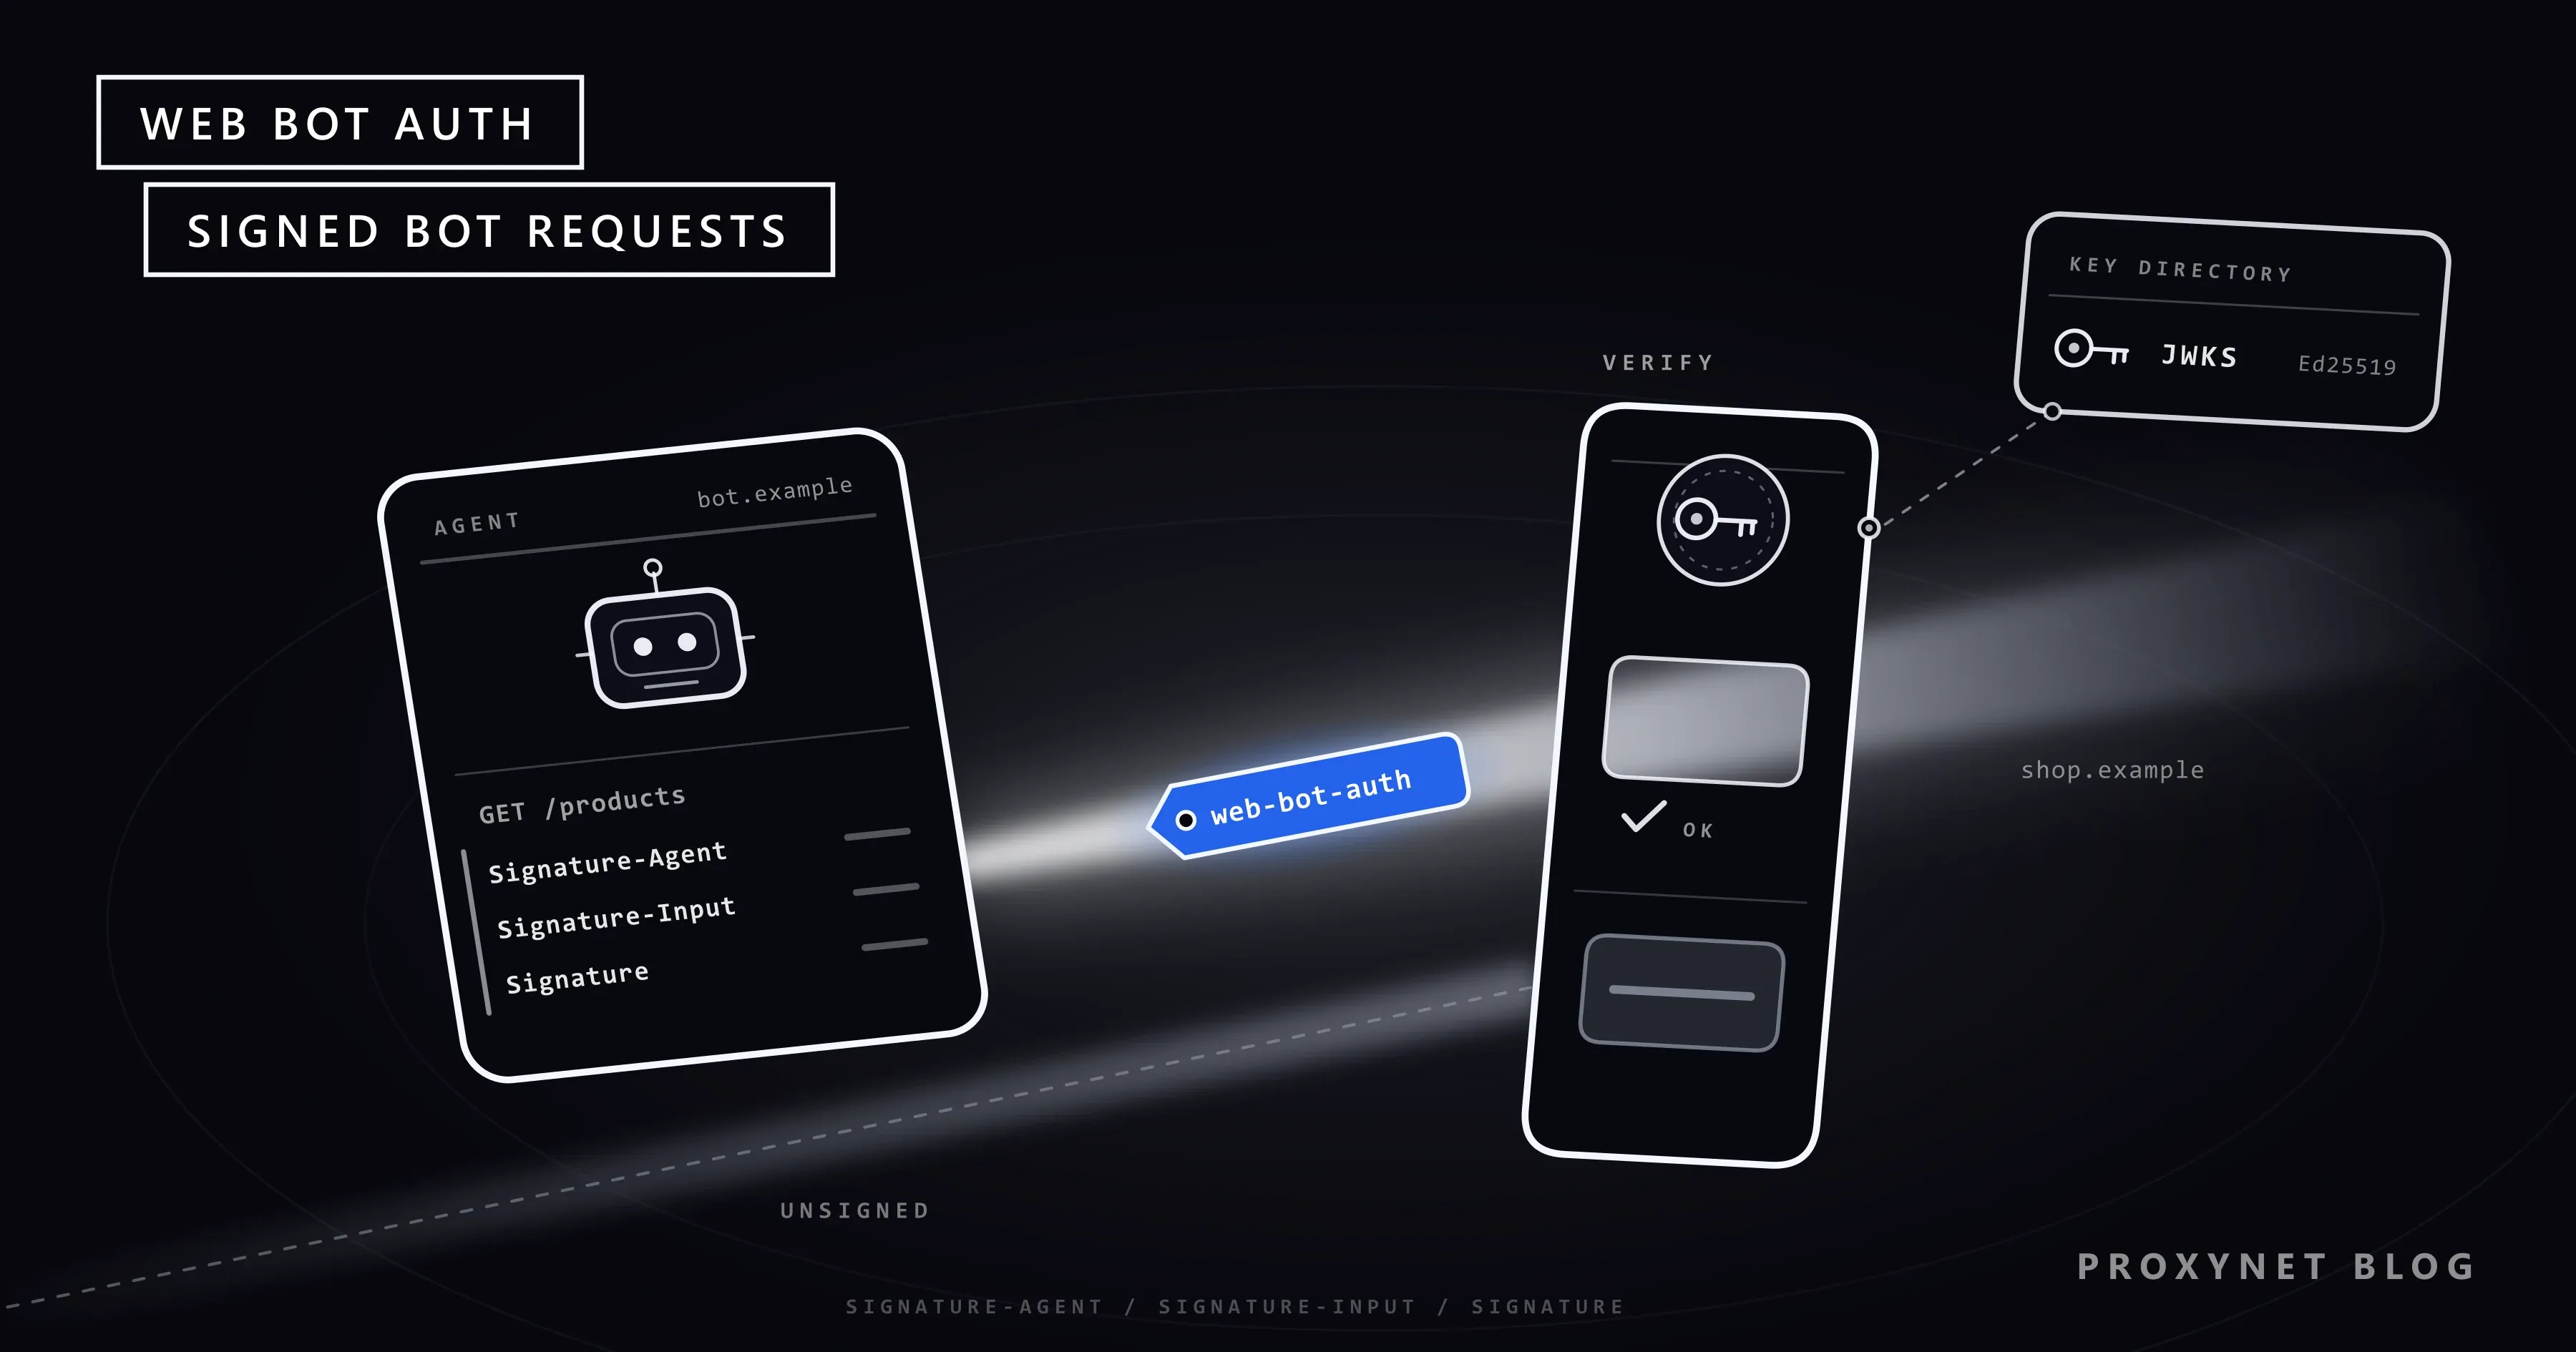
O Web Bot Auth funciona como uma etapa de assinatura do lado do bot e uma etapa de consulta e verificação do lado do site:
- O operador cria um par de chaves. A chave privada fica com o bot. O Ed25519, um algoritmo de assinatura moderno com chaves curtas, é o usado nos exemplos do rascunho e o aceito pela Cloudflare.
- O operador publica a chave pública. Ela vai para um diretório de chaves, um JSON Web Key Set (JWKS) servido por HTTPS; o rascunho também define um caminho conhecido para ele,
/.well-known/http-message-signatures-directory. - O bot assina cada requisição. Ele cobre pelo menos o host (
@authority) ou a URI de destino completa, mais o cabeçalhoSignature-Agent, adiciona um horário de criação, um horário de expiração, um ID de chave e a tagweb-bot-auth, e então assina. - O bot envia três cabeçalhos extras.
Signature-Inputlista o que foi assinado,Signaturetraz a assinatura eSignature-Agentinforma o endereço do diretório de chaves. - O site busca a chave. O verificador, muitas vezes uma CDN ou um firewall de aplicação web (WAF), baixa o diretório, guarda em cache e escolhe a chave que corresponde ao
keyid. - O site verifica e decide. Ele remonta os dados assinados a partir da requisição recebida, confere a assinatura e a janela de tempo e aplica a própria política: permitir, limitar a taxa ou bloquear.
Como a assinatura cobre o host, uma assinatura feita para um site não é válida em outro, e o rascunho recomenda que ela expire em até 24 horas.
Como é uma requisição assinada?
Uma requisição assinada é uma requisição HTTP comum com mais três cabeçalhos. O exemplo usa valores inventados e encurtados para um bot fictício em bot.example que busca uma página de shop.example.
GET /products HTTP/1.1
Host: shop.example
User-Agent: ExampleBot/1.0 (+https://bot.example/about)
Signature-Agent: sig1="https://bot.example/.well-known/http-message-signatures-directory"
Signature-Input: sig1=("@authority" "signature-agent";key="sig1");created=1795046400;expires=1795050000;keyid="x7Qp…3kLa";tag="web-bot-auth"
Signature: sig1=:jR3x…Q2Bw==:
O rótulo sig1 amarra os três cabeçalhos, de modo que uma requisição pode levar mais de uma assinatura. created e expires são timestamps Unix, aqui com uma hora de diferença.
| Cabeçalho | O que leva | Quem lê |
|---|---|---|
Signature-Agent | Endereço do diretório de chaves | O verificador, para buscar as chaves |
Signature-Input | Partes assinadas, horários, ID da chave, tag | O verificador, para remontar os dados |
Signature | A própria assinatura | O verificador, para conferi-la |
User-Agent | Nome do bot e URL de informações | Logs e pessoas |
O keyid é o thumbprint JWK da chave (a impressão digital), um hash SHA-256 da chave pública. Na nossa máquina de testes, uma chave Ed25519 descartável gerada no Node.js resultou num ID de chave de 43 caracteres e numa assinatura de 64 bytes, 88 caracteres em base64. Quando trocamos o host assinado de shop.example para shop.example.net, a verificação falhou.
Como as verificações antigas se comparam à nova?
O Web Bot Auth leva a prova de identidade do endereço de rede para uma chave que o operador controla.
| Verificação | O que o site olha | Onde falha |
|---|---|---|
| User-Agent | Um cabeçalho de texto | Qualquer um pode copiar |
| Lista de IPs permitidos | O endereço de origem | Nuvem compartilhada, aparelhos de usuários |
| DNS reverso | Nome de host do IP | Exige espaço de IP próprio |
| Web Bot Auth | Uma assinatura e uma chave | Os sites precisam verificar |
Na prática, essas verificações se somam em camadas, e não se substituem: o Google recomenda manter as checagens de IP, DNS reverso e user-agent ao lado das assinaturas, porque nem toda requisição é assinada ainda.
O que uma assinatura válida prova, e o que não prova?
Uma assinatura válida prova que a requisição foi assinada com uma chave listada no diretório do endereço Signature-Agent, e nada além disso. O rascunho diz isso com clareza: a assinatura não informa quem opera o agente, se ele é inofensivo nem se a requisição está autorizada.
- Identidade não é permissão. Um bot verificado ainda pode ter a taxa limitada, ser barrado em certos caminhos ou ser bloqueado; o robots.txt e os termos do site continuam valendo.
- Quem controla o diretório é a identidade. Se uma chave for roubada, as requisições assinadas com ela passam na verificação até o operador removê-la do diretório.
- Requisições assinadas podem ser relacionadas. Os sites conseguem correlacionar requisições que trazem o mesmo identificador, então o protocolo não serve para agentes que precisam permanecer anônimos.
Ele também não cobre o que um agente faz com o conteúdo que busca: um agente verificado ainda pode ser enganado por instruções escondidas numa página, um risco à parte chamado injeção de prompt.
Quem dá suporte ao Web Bot Auth hoje?
Em 19 de novembro de 2026, a Cloudflare e o AWS WAF verificam assinaturas do Web Bot Auth, o Google assina parte do tráfego de um agente e a Shopify pede que os bots assinem. Os detalhes mudam junto com o rascunho, então confira a página atual de cada fornecedor.
- Cloudflare. Segundo a sua documentação do Web Bot Auth, a Cloudflare usa o método para verificar bots no programa Verified bots: os operadores hospedam um diretório de chaves, fazem o cadastro dele e assinam com Ed25519. Desde 1º de julho de 2026, os agentes assinados também entram em Verified bots.
- AWS WAF. O grupo de regras AWS WAF Bot Control verifica assinaturas a partir da versão 4.0 e marca cada requisição como
verified,invalid,expiredouunknown_bot, para que os donos de sites criem regras com base no resultado. - Google. A página do Google sobre Web Bot Auth chama a implementação de experimental: um subconjunto das requisições do
Google-Agenté assinado comohttps://agent.bot.goog. - Shopify. Um changelog para desenvolvedores de maio de 2026 pede que bots e agentes em lojas da Shopify assinem com Web Bot Auth; o tráfego sem assinatura recebe os limites de taxa mais rígidos.
O que o Web Bot Auth significa para donos de sites?
Para quem administra um site, o Web Bot Auth transforma a pergunta "é mesmo aquele bot?" de um palpite em uma verificação, e a maior parte do trabalho acontece na CDN ou no firewall, não na sua aplicação.
Uma política inicial sensata: deixe os crawlers verificados que você quer receber passarem em ritmo normal e dê à automação sem assinatura um limite de taxa mais baixo em vez de um bloqueio geral, porque a maioria dos bots ainda não assina. Acompanhe os resultados invalid e expired, que indicam configurações quebradas ou cabeçalhos copiados. Se você mesmo verifica as assinaturas, guarde os diretórios de chaves em cache, não siga redirecionamentos ao buscá-los e responda a requisições sem assinatura para caminhos protegidos com um 403 e um cabeçalho Accept-Signature, como o rascunho recomenda.
A identidade assinada também facilita fazer valer as preferências que você publica. O robots.txt diz quais caminhos cada bot pode rastrear, como mostramos em O que é robots.txt e como ler o arquivo?, e o Web Bot Auth permite conferir se um bot que diz seguir essas regras é mesmo quem afirma ser.
O que muda para quem cria bots e agentes?
Para operadores de crawlers e agentes, o Web Bot Auth é um jeito de ser reconhecido sem que cada site precise manter uma lista de IPs para você, ao custo de gerenciar chaves.
- Use identidades separadas. O rascunho diz que um crawler e um agente que age por um usuário devem usar URLs de
Signature-Agent, chaves e diretórios diferentes. - Mantenha as assinaturas de vida curta. Defina
expiresperto decreated. - Faça a rotação das chaves. Publique a chave nova antes de usá-la e depois remova a antiga.
- Proteja a chave privada. Guarde-a como qualquer credencial; chaves secretas compartilhadas (HMAC) não são permitidas.
- Mantenha as boas maneiras. Um
User-Agentclaro, o robots.txt e um ritmo de requisições educado continuam importando.
Para agentes que compram ou pagam por um usuário, a assinatura é só metade da história; o lado do pagamento está em Por que os sites bloqueiam agentes de compras com IA?
Um proxy muda a identidade de um bot no Web Bot Auth?
Não. No Web Bot Auth, a identidade de um bot está na chave dele, não no endereço IP de onde o tráfego sai; então um proxy decide por onde uma requisição sai, mas não quem o bot é. O rascunho afirma que a assinatura não depende do IP e que um proxy não deve remover os cabeçalhos de assinatura. Com HTTPS, o proxy apenas faz o túnel da conexão criptografada, então os cabeçalhos assinados chegam como o bot os enviou.
Essa separação é útil para equipes de crawlers: a assinatura responde "quem é?", enquanto o local de saída responde "o que esta página mostra para visitantes na Alemanha ou no Brasil?", por exemplo ao conferir preços localizados. A nossa página de proxy para web crawler descreve a segmentação geográfica e as pausas ajustáveis entre requisições para esse tipo de rastreamento educado.
Quando um crawler precisa de um endereço de saída fixo e conhecido, por exemplo para bater com uma regra de firewall nos seus próprios sites, os Proxies de datacenter oferecem endereços IPv4 dedicados. De qualquer forma, uma requisição assinada que passa por um proxy continua sujeita à política do próprio site.
Onde você vai encontrar o Web Bot Auth?
- Painéis de CDN e firewall: categorias de bots verificados, resultados de assinatura e regras baseadas neles.
- Crawlers de busca e de IA: operadores que publicam diretórios de chaves junto à documentação do crawler.
- Agentes de IA que agem por usuários: agentes de navegação e de compras que assinam algumas ou todas as requisições.
- Plataformas de lojas: lojas virtuais que dão limites de taxa maiores aos bots assinados.
- Monitoramento e verificação de links: monitores de disponibilidade que querem ser diferenciados de ataques.
Erros comuns
- Chamar de RFC. O Web Bot Auth é um rascunho de grupo de trabalho baseado no RFC 9421; ainda pode mudar.
- Tratar uma assinatura válida como permissão. Ela prova a chave, não boa intenção nem direito de rastrear.
- Bloquear todos os bots sem assinatura. A maior parte do tráfego automatizado ainda não é assinada; limites de taxa são um primeiro passo mais brando.
- Abandonar as verificações antigas. O próprio Google recomenda manter as checagens de IP, DNS reverso e user-agent durante a adoção.
- Assinaturas de longa duração. Uma assinatura válida por dias prolonga a vida de cabeçalhos copiados.
- Uma chave para tudo. Um crawler e um agente guiado pelo usuário não devem compartilhar identidade.
Guia de decisão
| A sua situação | O que fazer |
|---|---|
| O seu site fica atrás de uma CDN ou de um WAF | Ative a verificação de assinaturas e crie regras com o resultado |
| Tráfego de crawlers falsos lota os seus logs | Permita bots verificados, limite a taxa dos não verificados |
| Você opera um crawler | Publique um diretório de chaves, assine cada requisição |
| Você opera um agente de IA para usuários | Use chave e diretório separados dos do crawler |
| Você mesmo verifica as assinaturas | Cache de diretórios, sem redirecionamentos, janelas de tempo curtas |
| Você precisa de um IP de saída fixo ou local | Use um proxy; a assinatura continua a mesma |
Perguntas frequentes
O Web Bot Auth é um padrão oficial?
Ainda não. É um Internet-Draft do grupo de trabalho Web Bot Auth do IETF, voltado ao Standards Track. O método de assinatura por baixo dele, o HTTP Message Signatures, já é um padrão: o RFC 9421.
O Web Bot Auth é o mesmo que os bots verificados da Cloudflare?
Não. O Web Bot Auth é um protocolo aberto que qualquer site, CDN ou firewall pode verificar. O programa Verified bots da Cloudflare é um dos lugares que o usam, ao lado de outras verificações, como listas de IP publicadas e DNS reverso.
O AWS WAF dá suporte ao Web Bot Auth?
Sim. O AWS WAF Bot Control verifica assinaturas a partir da versão 4.0 do grupo de regras e adiciona um rótulo com o resultado, como verified ou unknown_bot, que as suas próprias regras podem usar.
Preciso da Cloudflare para assinar requisições com Web Bot Auth?
Não. Você precisa de um par de chaves, de um diretório de chaves num endereço HTTPS que você controla e de código de assinatura no seu bot. A Shopify, por exemplo, diz que os bots não precisam se cadastrar na Cloudflare para assinar requisições às lojas dela.
O Web Bot Auth substitui o robots.txt?
Não. O robots.txt diz aos bots quais caminhos eles podem rastrear; o Web Bot Auth diz ao site qual bot está pedindo. Os dois funcionam juntos.
Alguém pode copiar uma requisição assinada e reutilizá-la?
Só dentro de limites estreitos. A assinatura cobre o host, então falha em outro site, e traz um horário de expiração. Sites que precisam de proteção mais rígida podem exigir um nonce, um valor de uso único, e recusar assinaturas que já viram.
Em resumo
O Web Bot Auth dá a bots e agentes de IA uma identidade verificável: o operador publica uma chave pública, o bot assina cada requisição com HTTP Message Signatures e o site confere a assinatura em vez de confiar numa string User-Agent ou numa lista de IPs. Ainda é um rascunho do IETF, mas a Cloudflare e o AWS WAF já fazem a verificação e o Google está testando. Uma assinatura prova quem está pedindo, não o que ele pode fazer, então o robots.txt, os limites de taxa e as políticas do site continuam decidindo. Por onde saem as requisições do seu crawler é outra questão, e os nossos serviços de proxy cuidam desse lado.