Uma loja online atrasa um lote de entregas e, na segunda de manhã, a caixa de entrada do suporte tem 3.000 e-mails novos. Ninguém lê todos. Primeiro, um software faz a triagem: estes pedem reembolso, estes falam de uma caixa danificada, estes estão irritados o bastante para ir a um atendente mais experiente. O software nunca "lê" como uma pessoa, mas transforma texto livre em rótulos com os quais uma equipe consegue trabalhar. Isso é processamento de linguagem natural, ou NLP.
Este artigo explica o que é NLP, como ele evoluiu das regras escritas à mão para os modelos transformer, como um sistema transforma texto em significado, quais são suas principais tarefas, como ele se diferencia de NLU, NLG e dos modelos de linguagem grandes, por que a linguagem é difícil para os computadores e onde as empresas o usam.
O que é processamento de linguagem natural?
Processamento de linguagem natural é a área que ensina computadores a analisar, entender e gerar linguagem humana. "Natural" separa os idiomas que as pessoas falam e escrevem, como português, inglês ou turco, das linguagens formais criadas para os computadores, como Python ou SQL, que têm regras rígidas e nenhuma ambiguidade.
O NLP fica no ponto de encontro entre ciência da computação, inteligência artificial e linguística. A linguística descreve como a língua se organiza: palavras, gramática, significado e contexto. A ciência da computação e o aprendizado de máquina fornecem os métodos que permitem a um programa aprender esses padrões a partir de exemplos, em vez de receber cada regra pronta.
A maioria das pessoas usa NLP várias vezes por dia sem dar nome a isso. O teclado que sugere a próxima palavra, o botão de traduzir embaixo de uma postagem em outro idioma e a caixa de busca que entende "passagens baratas para Roma em maio" funcionam com ele.
Como o NLP evoluiu?
O NLP passou por quatro grandes fases: regras escritas à mão, estatística aprendida com texto, redes neurais e, desde 2017, modelos transformer pré-treinados com enormes volumes de texto.
Regras (anos 1950 a 1980). Em janeiro de 1954, a IBM e a Universidade de Georgetown demonstraram em público um sistema que traduzia frases do russo para o inglês. Segundo a história do experimento Georgetown-IBM escrita por W. John Hutchins, ele funcionava com apenas 250 palavras e seis regras gramaticais, mas fez crer que a tradução automática de qualidade estava a poucos anos de distância. Em 1966, Joseph Weizenbaum descreveu o ELIZA, um programa do MIT que analisava frases com regras de decomposição acionadas por palavras-chave e montava as respostas com as regras de remontagem correspondentes. Sistemas assim eram tão bons quanto suas regras, e cada nova forma de dizer algo exigia mais uma.
Estatística (fim dos anos 1980 aos anos 2000). Em vez de escrever regras, os pesquisadores deixaram os programas contarem padrões em grandes coleções de texto. Uma equipe do T.J. Watson Research Center da IBM publicou em 1993 cinco modelos estatísticos de tradução, aprendidos com pares de frases em francês e inglês tirados dos registros do Parlamento do Canadá. Os autores observaram que seus algoritmos tinham conteúdo linguístico mínimo: o conhecimento vinha dos dados, não dos livros de gramática.
Redes neurais (anos 2010). Em 2013, Tomas Mikolov e colegas do Google descreveram o word2vec, uma forma rápida de transformar cada palavra em uma lista de números aprendida com coleções de texto muito grandes, de modo que palavras usadas de maneira parecida ficam próximas umas das outras. Nos anos seguintes, redes neurais baseadas em vetores de palavras viraram a abordagem padrão para tradução, marcação e classificação.
Transformers (desde 2017). A arquitetura transformer, apresentada no artigo Attention Is All You Need e testada primeiro em tradução, abandona a leitura passo a passo das redes neurais anteriores e deixa cada palavra olhar para todas as outras ao mesmo tempo.
Em 2018, pesquisadores do Google lançaram o BERT, um transformer pré-treinado com texto sem rótulos e depois ajustado com uma única camada de saída extra, que estabeleceu novos melhores resultados em onze tarefas de NLP. Os modelos de linguagem grandes de hoje nasceram dessa mesma arquitetura.
Como o NLP funciona?
Um sistema de NLP transforma o texto bruto, passo a passo, em números com os quais um modelo consegue trabalhar e depois usa um modelo para produzir um rótulo, uma estrutura ou um texto novo. O pipeline clássico é assim:
- Limpar e segmentar. O texto perde as marcações de formatação e é dividido em frases e palavras. Parece trivial e não é: um ponto pode encerrar uma frase, fechar uma abreviação ou ficar dentro de um número.
- Tokenizar. O texto é cortado em tokens, as unidades que o modelo lê. Sistemas antigos usavam palavras inteiras; modelos modernos usam pedaços de palavras, para que uma palavra rara ou nova também possa ser representada. O que são tokens em IA? mostra como essa divisão funciona.
- Normalizar. As diferentes formas de uma palavra são reduzidas a uma só: "correu", "corre" e "correndo" viram o lema "correr", a forma que você procuraria no dicionário.
- Marcar. A marcação de classes gramaticais (part-of-speech tagging) identifica cada palavra como substantivo, verbo, adjetivo e assim por diante, e assim separa "eu canto no coral" (verbo) de "o canto do pássaro" (substantivo).
- Analisar a sintaxe. A análise de dependências (dependency parsing) descobre como as palavras se relacionam: quem fez o quê com quem. Em "o entregador deixou o pacote com um vizinho", a análise liga "deixou" ao sujeito "entregador" e ao objeto "pacote".
- Representar como vetores. Cada palavra, frase ou documento vira um embedding, uma longa lista de números que o coloca em um espaço onde significados parecidos ficam próximos.
- Rodar o modelo da tarefa. Um classificador, um rotulador de sequências ou um gerador de texto usa esses vetores para produzir o resultado: uma categoria, um conjunto de nomes marcados, uma tradução ou um resumo.
Os modelos transformer modernos reúnem a maior parte dessas etapas em uma única rede, que aprende internamente a marcação, a estrutura e o significado. Ainda assim, vale conhecer o pipeline, porque quando um sistema de NLP erra, a causa costuma estar em uma das primeiras etapas.
Na nossa máquina de teste, rodamos o segmentador de frases embutido no Node.js (Intl.Segmenter, que usa a biblioteca ICU) na frase em inglês Dr. Smith ordered 2.5 kg at 9 a.m. It arrived late. Ele tratou corretamente "2.5" e "a.m.", mas devolveu três frases em vez de duas, porque separou "Dr." como uma frase própria. Erros pequenos como esse seguem pelo pipeline e viram rótulos errados mais adiante.
Quais são as principais tarefas do NLP?
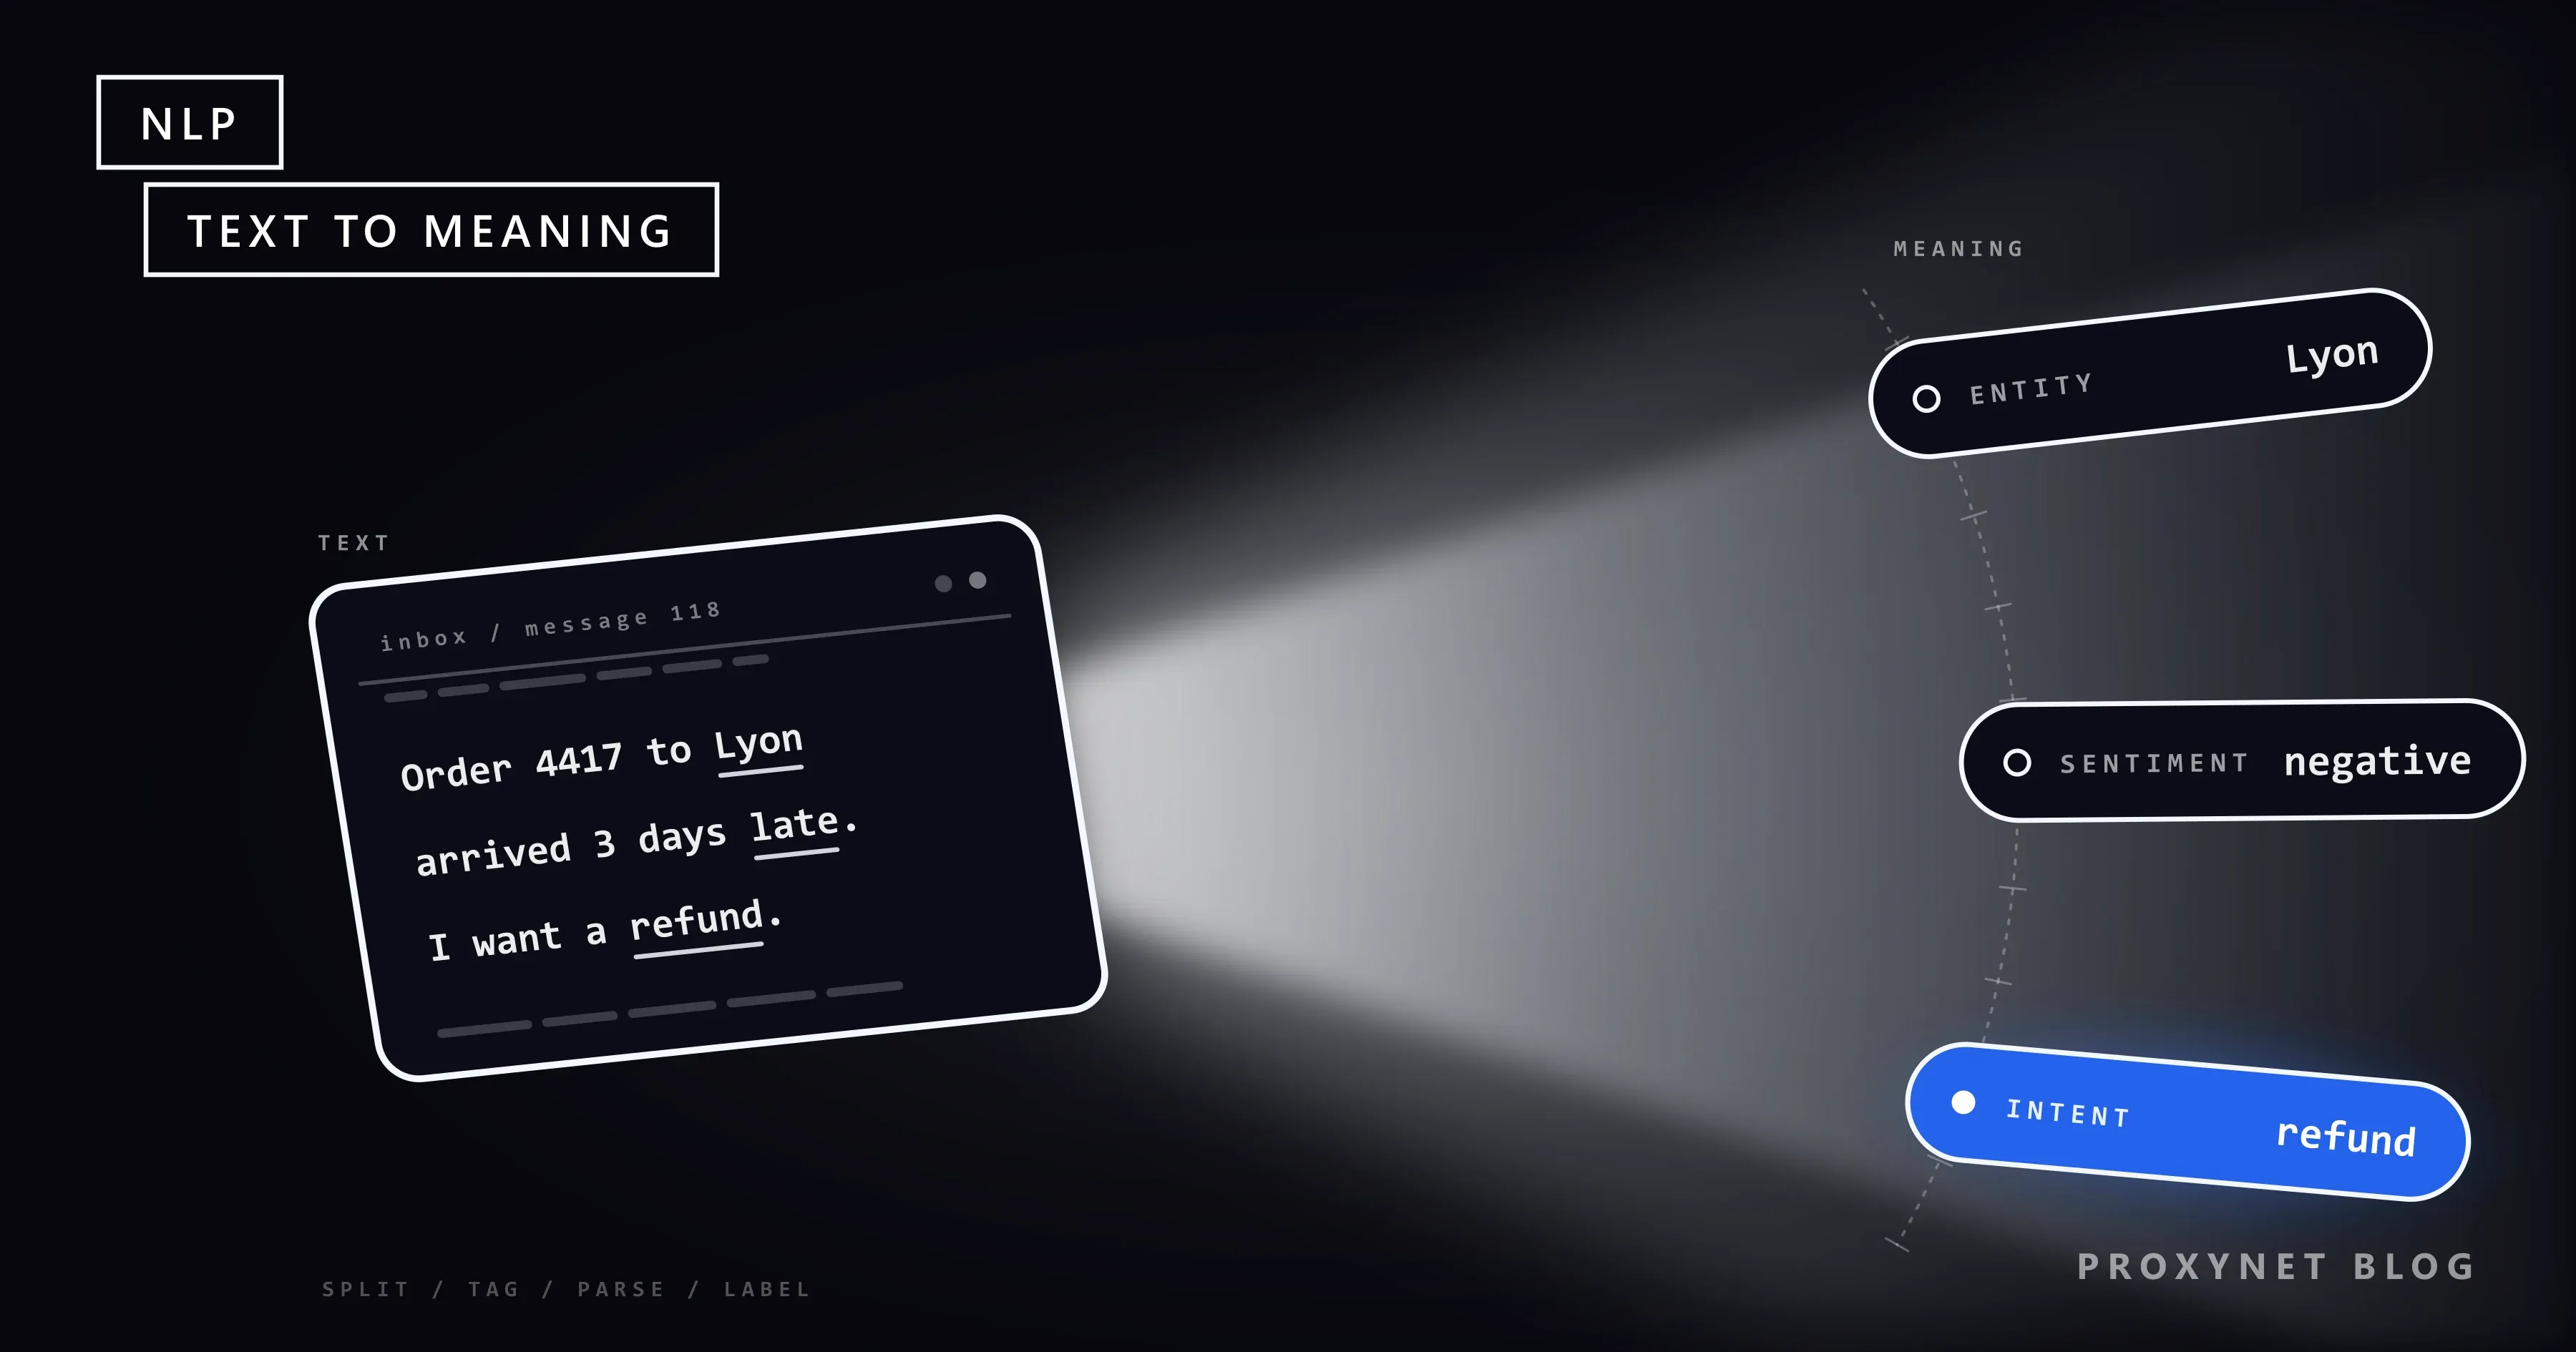
Quase todo trabalho de NLP se encaixa em poucas tarefas, e cada uma responde a uma pergunta diferente sobre um texto. Pegue uma única mensagem de cliente: "O pedido 4417 para Lyon chegou três dias atrasado e a caixa veio amassada, quero meu dinheiro de volta."
- A classificação de texto coloca a mensagem inteira em uma categoria: reclamação de entrega. Filtrar spam e separar por assunto são a mesma tarefa.
- A análise de sentimento decide se o tom é positivo, neutro ou negativo: aqui, claramente negativo. Análise de sentimento em Python compara dois jeitos de pontuar avaliações de produtos.
- O reconhecimento de entidades nomeadas (NER) encontra e rotula nomes no texto: "Lyon" como local, "4417" como número do pedido, "três dias" como duração.
- A detecção de intenção descobre o que quem escreveu quer: um reembolso. Chatbots e assistentes de voz dependem dela.
- A extração de informações preenche um registro estruturado a partir de texto livre, com número do pedido, tipo de problema e ação solicitada, pronto para um banco de dados.
- A tradução automática passa a mensagem para outro idioma, para uma equipe de suporte no exterior.
- A sumarização encurta um texto longo, seja escolhendo as frases principais (extrativa), seja escrevendo uma versão nova e mais curta (abstrativa).
- A resposta a perguntas encontra ou escreve a resposta a uma pergunta com base em um documento ou em uma base de conhecimento.
A fala acrescenta mais duas tarefas nas pontas: o reconhecimento de fala transforma palavras faladas em texto antes que o NLP comece, e a síntese de voz (text-to-speech) transforma o resultado de novo em voz.
Qual é a diferença entre NLP, NLU, NLG e um LLM?
NLP é a área inteira; a compreensão de linguagem natural (NLU) é a parte que descobre o significado, a geração de linguagem natural (NLG) é a parte que escreve texto, e um modelo de linguagem grande (LLM) é um tipo de modelo que faz as duas coisas.
| Termo | O que abrange | Exemplo de saída |
|---|---|---|
| NLP | A área inteira de computadores e linguagem | Todas as tarefas deste artigo |
| NLU | Ler: significado, intenção, entidades | "Intenção: reembolso, pedido 4417" |
| NLG | Escrever: texto a partir de dados ou de um prompt | "Seu reembolso já foi emitido." |
| LLM | Um tipo de modelo que faz as duas coisas | Uma resposta completa já redigida |
NLU e NLG são duas direções do mesmo trabalho: um bot de suporte usa NLU para ler a mensagem e NLG para escrever a resposta.
Um LLM é a mesma coisa que NLP?
Não: um LLM é uma ferramenta dentro do NLP, não um substituto da área. Um modelo de linguagem grande é uma rede neural treinada com uma quantidade muito grande de texto para prever o próximo token, e essa única habilidade permite que ele classifique, traduza, resuma e responda perguntas quando você descreve a tarefa em um prompt. O que é um LLM? explica como esses modelos são construídos e treinados.
Muitas tarefas que antes precisavam de um modelo próprio hoje funcionam pedindo a um LLM em linguagem comum. Modelos menores e específicos ainda têm seu lugar: um classificador compacto treinado com os seus próprios e-mails rotulados custa menos por mensagem, dá o mesmo rótulo para a mesma entrada toda vez e pode rodar nos seus próprios servidores, o que pesa quando o volume é alto ou há dados pessoais.
Por que a linguagem humana é difícil para os computadores?
A linguagem humana é difícil porque as mesmas palavras podem significar coisas diferentes, e o significado muitas vezes depende do contexto, do tom e de conhecimentos que o texto nunca diz.
- Ambiguidade. "A manga está suja" pode falar de uma fruta ou de uma parte da camisa; "Vi o homem com o binóculo" deixa em aberto quem está com o binóculo. As pessoas resolvem isso pelo contexto sem perceber; um modelo precisa aprender.
- Sarcasmo e tom. "Ótimo, mais uma entrega atrasada" usa uma palavra positiva para reclamar. Modelos de sentimento simples, que contam palavras positivas e negativas, erram aqui.
- Linguagem de cada área. "Positivo" é boa notícia em uma avaliação e má notícia no resultado de um exame médico. Um modelo treinado com notícias tropeça em contratos, anotações médicas ou gírias de redes sociais.
- Idiomas com menos recursos. Os modelos aprendem com o texto que têm disponível, por isso costumam ser mais fracos em idiomas com menos texto digital que o inglês. Idiomas que formam palavras longas com sufixos acrescentam mais uma camada: a palavra turca "evlerinizden" (das suas casas) junta uma raiz e três sufixos em uma só palavra, onde o português usa três.
- Viés. Os modelos aprendem com textos escritos por pessoas, estereótipos incluídos, e podem repeti-los em seus rótulos ou respostas.
- Grafia e mistura de idiomas. Erros de digitação, emojis e mensagens que trocam de idioma no meio da frase são entradas do dia a dia e ainda atrapalham os modelos.
Onde o NLP é usado?
O NLP é usado onde quer que uma organização tenha mais texto do que pessoas para lê-lo. Equipes de atendimento encaminham chamados e sinalizam mensagens urgentes. Equipes de e-commerce analisam avaliações em busca de reclamações recorrentes e fazem a busca do site entender perguntas, e não só palavras-chave exatas.
Equipes jurídicas procuram cláusulas específicas em contratos, hospitais transformam anotações livres dos médicos em registros estruturados, equipes financeiras acompanham notícias que citam uma empresa e recrutadores desmembram vagas de emprego em campos comparáveis. Fora das empresas, o NLP está por trás de legendas ao vivo, aplicativos de tradução e assistentes de voz.
Onde os proxies entram em projetos de NLP?
Os proxies importam quando um projeto de NLP precisa de texto público da web do jeito que ele aparece em um país específico. Avaliações, cobertura jornalística, vagas de emprego e descrições de produtos mudam entre mercados e idiomas, e um site muitas vezes mostra uma versão local diferente conforme o lugar de onde o visitante se conecta.
Com os Proxies residenciais, cada requisição passa por uma conexão residencial no país e na cidade que você escolher, e assim uma equipe que analisa o sentimento de avaliações alemãs ou a redação de vagas de emprego no Brasil coleta as mesmas páginas públicas que um visitante local vê.
Nossa página de pesquisa de mercado explica como as equipes usam proxies para ver preços, promoções e sortimentos como os compradores de um mercado-alvo os veem.
Para coletas maiores, nossa página de soluções de extração de dados apresenta os pools de proxies feitos para elas, e nossa equipe de vendas pode conversar com você sobre a extração gerenciada de páginas. Seja qual for o caminho, colete só páginas públicas, siga o robots.txt e os termos de cada site, mantenha baixa a taxa de requisições, use uma API oficial quando houver e deixe de fora os dados pessoais de que a análise não precisa.
Erros comuns
- Começar pelo modelo em vez de pela pergunta. Defina de qual rótulo ou resposta você precisa do texto antes de escolher um método.
- Pular a avaliação com seus próprios dados. Um modelo que pontua bem em benchmarks públicos ainda pode rotular errado o jeito de escrever dos seus clientes; rotule algumas centenas de exemplos seus e teste com eles.
- Supor que os resultados em inglês valem para outros idiomas. Confira a qualidade separadamente em cada idioma que você processa.
- Ignorar as primeiras etapas do pipeline. Codificação quebrada, restos de HTML e divisões de frase ruins causam muitos erros que parecem ser "do modelo".
- Usar um LLM para tudo. Para uma classificação fixa e de alto volume, um modelo pequeno treinado costuma ser mais barato e mais consistente.
- Colocar dados pessoais em ferramentas de terceiros sem ler os termos. Nomes, e-mails e dados de pedidos em um texto são dados pessoais segundo leis como o GDPR e a LGPD; remova o que a tarefa não exige.
Guia de decisão
| Necessidade | O que usar |
|---|---|
| Classificar grandes volumes de texto em rótulos fixos | Um classificador de texto treinado |
| Encontrar nomes, locais, datas e números de pedido | Reconhecimento de entidades nomeadas |
| Medir o tom de avaliações ou postagens | Análise de sentimento, conferida com seus dados |
| Redigir respostas, resumos ou traduções | Um LLM, com uma pessoa revisando o resultado |
| Respostas a partir dos seus próprios documentos | Busca nesses documentos mais um LLM |
| Texto que precisa ficar nos seus servidores | Um modelo aberto hospedado por você |
| Texto web local de vários países | Páginas públicas coletadas com proxies locais |
Perguntas frequentes
Qual é um exemplo de processamento de linguagem natural?
O filtro de spam é um dos exemplos mais comuns: ele lê cada e-mail recebido e decide, pela redação, se é spam. Outros são a tradução automática, os assistentes de voz que transformam a fala em comandos, o preenchimento automático do teclado do celular e os chatbots que respondem perguntas de clientes.
O ChatGPT é um exemplo de NLP?
Sim: o ChatGPT é uma aplicação de NLP construída sobre modelos de linguagem grandes, que são um tipo de modelo de NLP. Ele usa a compreensão de linguagem para ler o seu prompt e a geração de linguagem para escrever a resposta, as duas metades do NLP descritas acima.
Qual é a diferença entre NLP e aprendizado de máquina?
Aprendizado de máquina é um método geral para aprender padrões a partir de dados, e o NLP é uma área que o aplica, junto com outros métodos, à linguagem humana. O aprendizado de máquina também está por trás do reconhecimento de imagens, da detecção de fraudes e das recomendações, que não têm nada a ver com linguagem, enquanto o NLP dos primeiros tempos usava regras escritas à mão, sem nenhum aprendizado de máquina.
O que significa PNL na psicologia?
Na psicologia e no coaching, a sigla PNL (em inglês, NLP) significa programação neurolinguística, um método de comunicação e autoajuda que não tem nada a ver com computadores. Em IA, ciência de dados e software, NLP sempre quer dizer processamento de linguagem natural.
Qual linguagem de programação é usada para NLP?
Python é a escolha mais comum, porque bibliotecas de NLP muito usadas, como NLTK, spaCy e Hugging Face Transformers, são feitas para ele. Muitas equipes também chamam um LLM por uma API a partir da linguagem que a aplicação já usa.
O NLP funciona em outros idiomas além do inglês?
Sim, mas a qualidade varia conforme o idioma. Os modelos costumam ser mais fortes em inglês e em outros idiomas com muito texto digital, e mais fracos em idiomas com menos dados de treinamento ou com estrutura de palavras complexa; por isso, teste qualquer modelo com texto real em cada idioma de que você precisa.
Em resumo
Processamento de linguagem natural é a área que permite aos computadores ler, entender e escrever linguagem humana. Ela passou das regras escritas à mão nos anos 1950 para a estatística por volta de 1990, depois para as redes neurais e, desde 2017, para os transformers e os modelos de linguagem grandes construídos sobre eles. Um sistema divide o texto em frases e tokens, representa essas partes como números e roda um modelo para uma tarefa como classificação, reconhecimento de entidades ou tradução. A linguagem continua difícil por causa da ambiguidade, do sarcasmo e da distribuição desigual de dados entre idiomas; por isso, teste qualquer sistema de NLP com o seu próprio texto e escolha a ferramenta conforme a tarefa: um modelo pequeno para rótulos em alto volume e um LLM para redigir e para perguntas abertas.