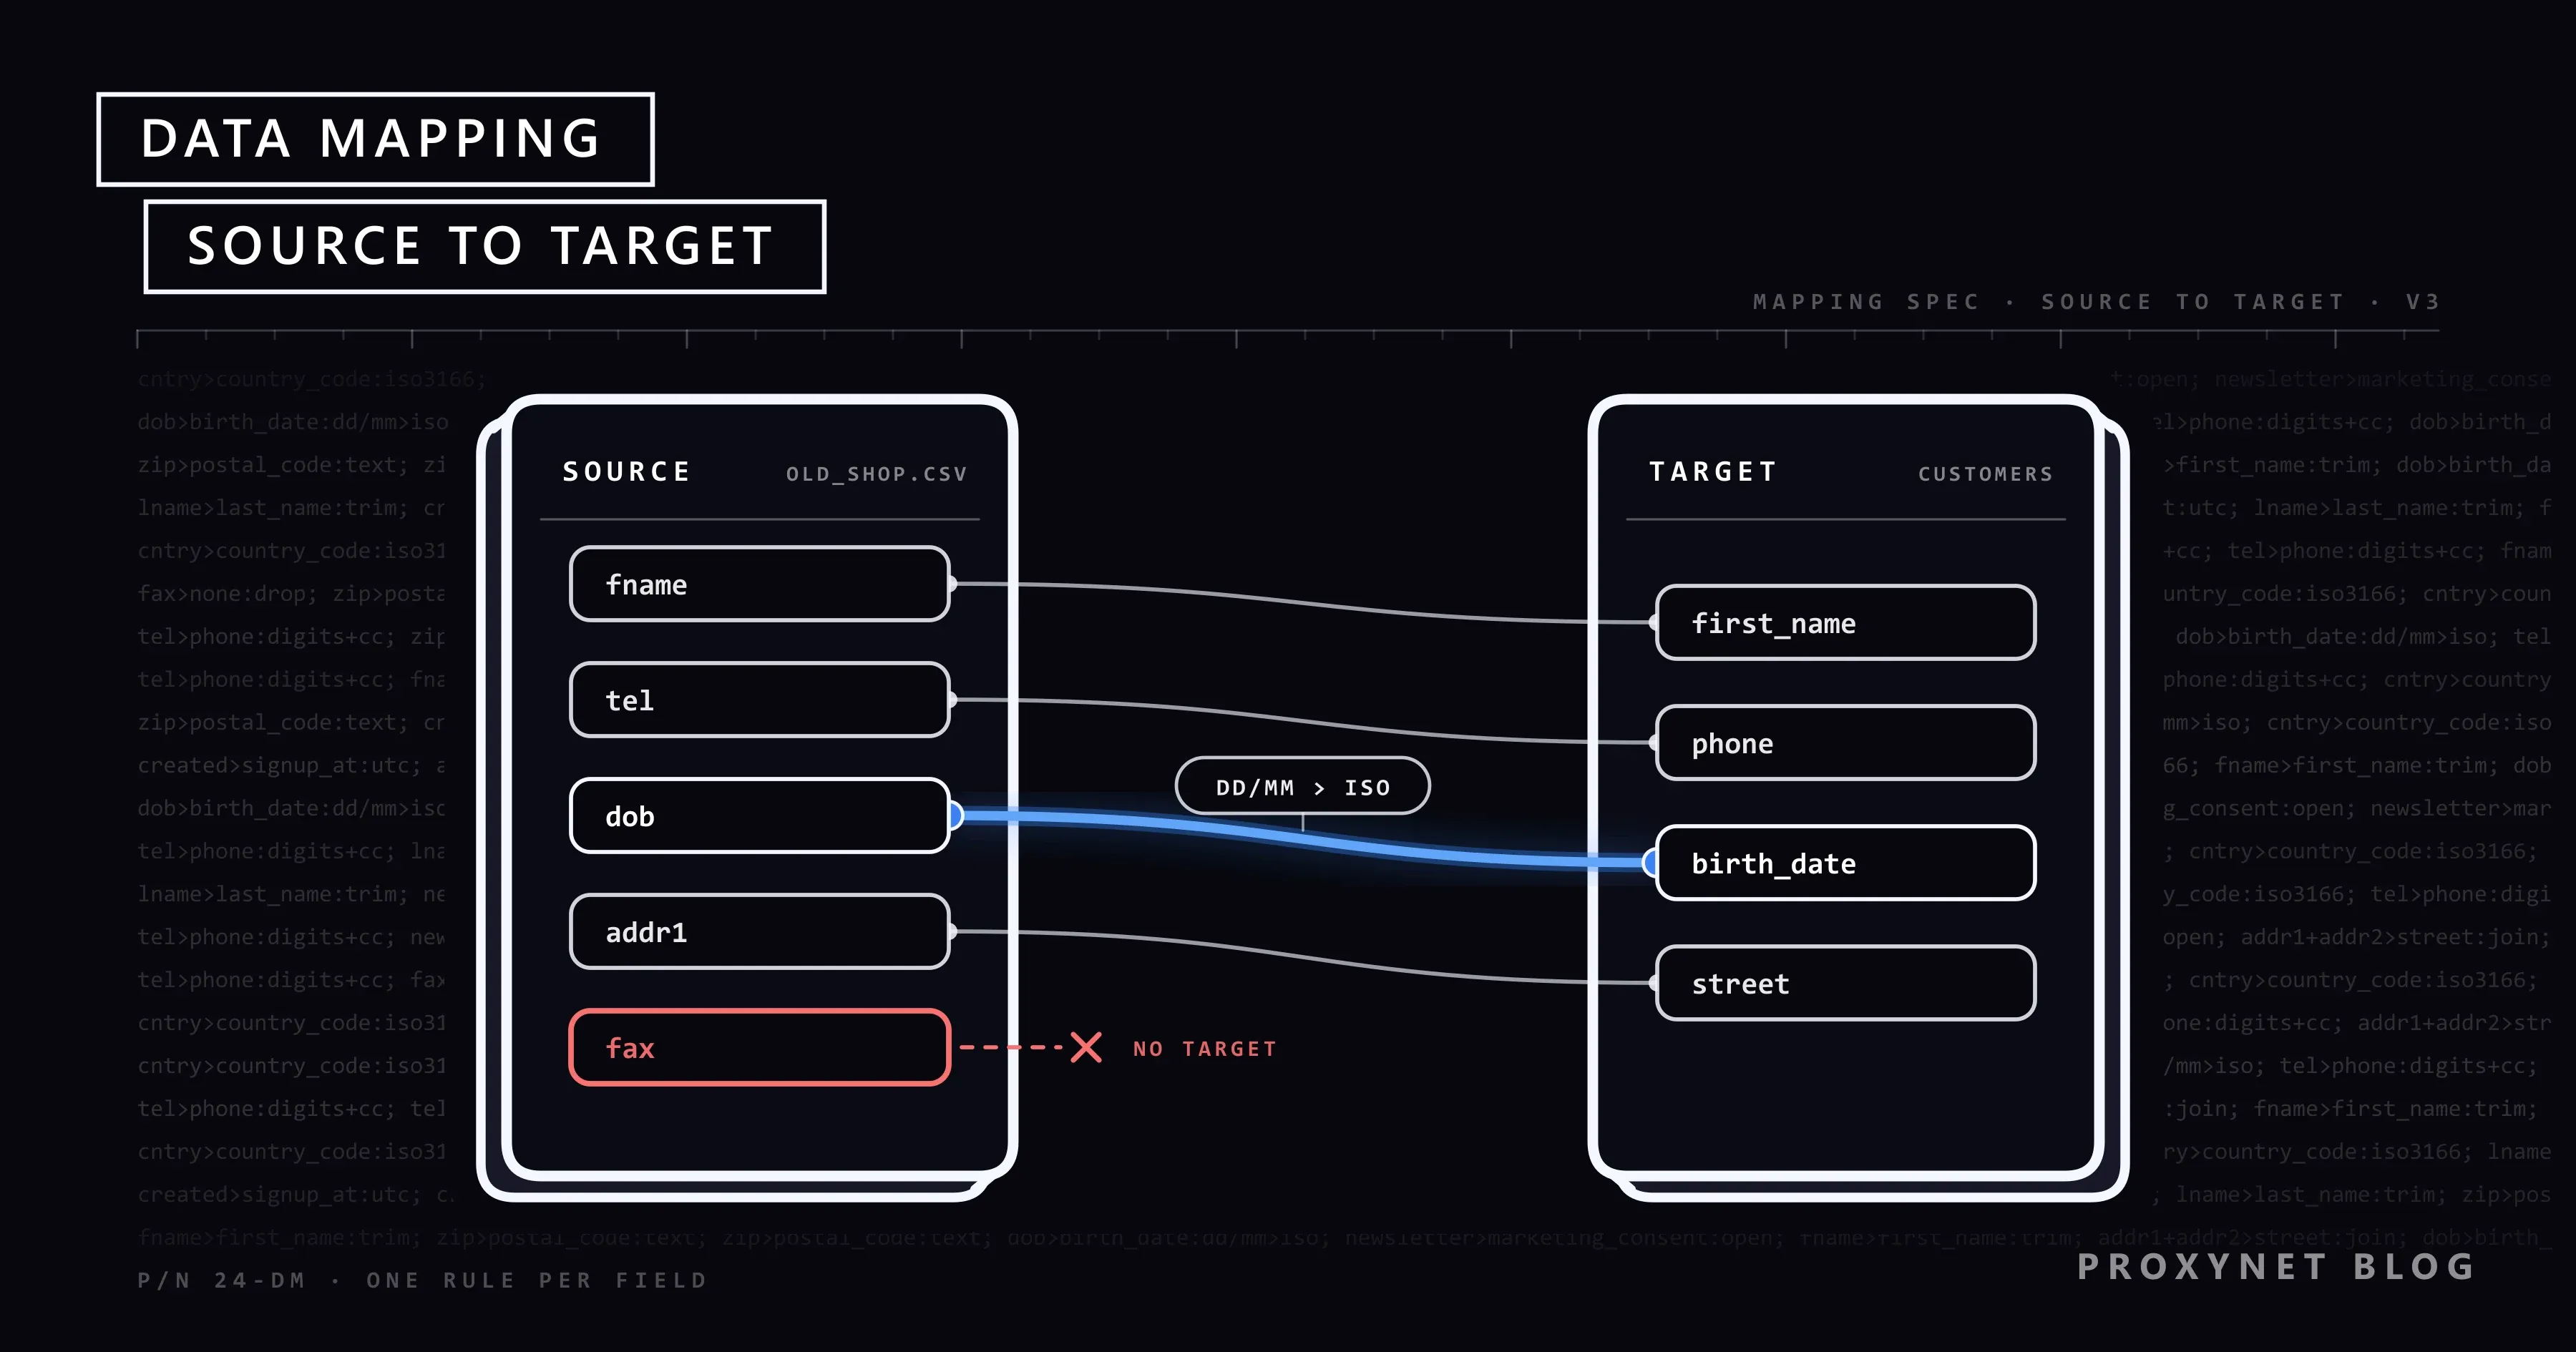
Uma pequena loja virtual está migrando para uma nova plataforma de e-commerce. O sistema antigo exporta 38.000 clientes com colunas chamadas fname, tel e dob, e as datas de nascimento aparecem como 03/04/1990; a nova plataforma espera first_name, um telefone com código do país e datas escritas como 1990-04-03. Antes de importar qualquer coisa, alguém precisa decidir, coluna por coluna, para onde vai cada valor e como ele muda no caminho. Essa tabela de decisões é um mapa de dados, e criá-la é o mapeamento de dados (data mapping).
Uma semana depois, a responsável pela privacidade da loja faz uma pergunta diferente com o mesmo nome: quais sistemas guardam dados de clientes, por quê e quem os recebe. Este artigo cobre os dois significados: o mapeamento de campos e seu documento, as principais abordagens e como as equipes de privacidade mapeiam dados pessoais para o GDPR e para a lei de proteção de dados da Türkiye (KVKK, Lei nº 6698).
O que é mapeamento de dados?
Mapeamento de dados é o trabalho de descrever como os dados de um lugar correspondem aos dados de outro. O resultado é um mapa: uma lista de pares (este campo de origem vira aquele campo de destino) com uma regra para cada par ou, no trabalho de privacidade, uma lista de onde os dados pessoais estão e para onde vão.
O termo abrange duas tarefas que compartilham um método, mas atendem leitores diferentes:
| Significado | Pergunta que responde | Responsável habitual | Entregável |
|---|---|---|---|
| Mapeamento de integração | Para onde vai cada campo e como ele muda? | Engenheiro ou analista de dados | Documento de mapeamento de origem para destino |
| Mapeamento de privacidade | Que dados pessoais temos, por quê e para onde fluem? | Responsável pela privacidade ou encarregado de dados | Inventário de dados, mapa de fluxos, registro de tratamento |
Como funciona o mapeamento campo a campo?
O mapeamento campo a campo funciona listando os campos dos dois lados, formando pares e escrevendo uma regra de conversão para cada par antes que qualquer dado seja movido. Uma sequência típica tem sete etapas:
- Faça o perfil da origem. Liste cada campo com o tipo, alguns valores de exemplo, a frequência com que fica vazio e o formato usado. Uma coluna chamada
phonepode conter fixos, celulares e as palavras "perguntar na recepção". - Defina o esquema de destino. Um esquema é a descrição formal de uma estrutura de dados: quais campos existem, de que tipo são, quais são obrigatórios e quais valores são permitidos.
- Forme os pares. Associe cada campo de origem a um campo de destino. Alguns pares são de um para um; outros dividem um campo em dois ou juntam vários em um.
- Escreva as regras de transformação. Diga como cada valor muda: formatos de data, separadores decimais, unidades, moedas, listas de códigos (
MeFparamaleefemale), remoção de espaços e valores padrão para campos vazios. - Decida o que não será mapeado. Todo campo de origem termina mapeado, descartado de propósito ou marcado como questão em aberto. Descartes silenciosos são o caminho pelo qual dados desaparecem.
- Teste com amostras reais. Passe algumas centenas de registros pelas regras e compare o resultado com a origem manualmente, incluindo campos vazios, nomes com acento e valores extremos.
- Execute, monitore e versione. Conte os registros que entram e saem a cada execução, registre as linhas rejeitadas e versione o mapa, para que uma mudança em qualquer um dos sistemas leve a uma mudança no mapa.
A etapa 4 é onde a maioria dos bugs se esconde. Na nossa máquina de teste, o Node.js 24 interpretou a string "03/04/1990" como 4 de março de 1990, e não 3 de abril; convertida para UTC, virou 3 de março, porque o relógio da máquina estava duas horas à frente do UTC naquela data, e "13/04/1990" foi rejeitada como data inválida. Uma regra que diz apenas "data de nascimento para data ISO", sem informar a ordem da origem (dia primeiro ou mês primeiro), deixa essa escolha para o parser que estiver rodando.
Como é um documento de mapeamento de dados?
Um documento de mapeamento de dados é uma tabela com uma linha por campo, mostrando de onde vem cada valor, para onde vai e qual regra o altera. Para a migração da loja do exemplo:
| Campo de origem | Campo de destino | Regra |
|---|---|---|
fname | first_name | Remover espaços nas pontas |
tel | phone | Só dígitos, incluir código do país |
dob | birth_date | Ler DD/MM/YYYY, gravar YYYY-MM-DD |
addr1 + addr2 | street | Unir com um espaço |
cntry | country_code | Nome para código ISO 3166 de duas letras |
fax | (nenhum) | Descartado: não é mais usado |
newsletter | marketing_consent | Em aberto: verificar registros de consentimento |
Documentos reais acrescentam colunas de tipo de dado, responsável e status de teste; a maioria dos "modelos de mapeamento de dados" é esta tabela com essas colunas extras. As duas últimas linhas são as que mais importam. Um campo descartado é uma decisão que alguém aprovou, e uma flag de consentimento não pode ser presumida: se o sistema antigo nunca registrou como o consentimento foi dado, o novo não deve exibi-lo como dado.
Quais são os tipos de mapeamento de dados?
O mapeamento de dados é feito de três formas: manual, baseado em esquemas com apoio de ferramentas e automatizado com sugestões de pares. A maioria dos projetos reais mistura as três.
| Abordagem | Como funciona | Indicada para | Principal risco |
|---|---|---|---|
| Manual | Pessoas formam pares de campos numa planilha | Migrações pequenas ou pontuais | Erros de digitação, nenhum teste |
| Baseada em esquemas | Os dois esquemas carregados numa ferramenta; regras num editor ou em código | Integrações recorrentes, ETL | Código e documento se distanciam |
| Automatizada | A ferramenta sugere pares por nomes, tipos e valores de exemplo | Muitas fontes parecidas | Pares errados com aparência confiável |
As sugestões automáticas poupam tempo em pares óbvios, como email para email_address, mas um nome diz pouco sobre o significado: date é a data do pedido numa fonte e a data de entrega em outra. Trate cada par sugerido como uma proposta que uma pessoa confirma.
As relações entre campos são de vários tipos, e cada uma precisa da própria regra: um para um, vários para um (duas linhas de endereço unidas), um para vários (um nome completo dividido em dois, o que falha com muitos nomes reais), consultas a uma tabela de referência e constantes que a origem não tem.
Qual a diferença entre mapeamento de dados, transformação, ETL e linhagem?
O mapeamento de dados é a especificação, a transformação é a execução das suas regras, o ETL é o pipeline que as executa e a linhagem de dados (data lineage) é o registro de onde um valor realmente veio. O mapa diz "dob vira birth_date, ler com o dia primeiro"; a transformação é a etapa que faz isso. O ETL (extração, transformação, carga) puxa os dados da origem, aplica essas transformações e carrega o resultado num banco de dados, como mostra passo a passo O que é ETL?.
A linhagem olha para trás: para um número num painel, ela mostra quais tabelas, jobs e campos de origem o produziram, e um bom documento de mapeamento torna esse rastro mais fácil de seguir. Um dicionário de dados descreve os campos de um único sistema sem relacioná-los a outro.
O mapeamento também vem antes da limpeza. Depois que os campos estão alinhados, os valores errados, duplicados ou inconsistentes ficam visíveis e podem ser corrigidos; O que é limpeza de dados? trata dessa etapa.
O que é mapeamento de dados na privacidade?
Na privacidade de dados, mapeamento de dados significa descobrir quais dados pessoais uma organização tem, onde estão armazenados, por que são tratados, quem os recebe e por quanto tempo são guardados. Dado pessoal é qualquer informação sobre uma pessoa identificada ou identificável: um nome, um endereço de e-mail, um número de cliente, um endereço IP num log de servidor.
As equipes de privacidade costumam produzir duas coisas. Um inventário de dados lista as atividades de tratamento (folha de pagamento, recrutamento, processamento de pedidos, a newsletter) com os dados e sistemas que cada uma usa. Um mapa de fluxos de dados mostra como esses dados se movem: de um formulário web para o banco de dados da loja, daí para um provedor de pagamentos, toda noite para um CRM, todo mês para um contador no exterior. É nos fluxos que aparecem as surpresas, como uma ferramenta de suporte que copia cadastros completos de clientes para um servidor em outro país.
O que exige o artigo 30 do GDPR?
O artigo 30 do GDPR exige que cada responsável pelo tratamento, ou seja, a organização que decide por que e como os dados pessoais são tratados (o "controlador", no vocabulário brasileiro), mantenha um registro por escrito das suas atividades de tratamento, muitas vezes abreviado em inglês como RoPA. O registro deve conter:
- o nome e os contatos do responsável pelo tratamento e, quando houver, do seu representante e do encarregado da proteção de dados;
- as finalidades do tratamento;
- as categorias de titulares e de dados pessoais envolvidos;
- as categorias de destinatários, incluindo destinatários em outros países;
- as transferências para países fora da UE ou para organizações internacionais;
- se possível, os prazos previstos para apagar cada categoria de dados;
- se possível, uma descrição geral das medidas de segurança.
Os subcontratantes (no Brasil, operadores), empresas que tratam dados em nome de um responsável, como um provedor de hospedagem ou de folha de pagamento, mantêm um registro próprio e mais curto. Os dois registros podem ser eletrônicos e devem ser apresentados à autoridade de controle quando ela pedir (texto do GDPR no EUR-Lex).
A isenção para organizações com menos de 250 trabalhadores é mais estreita do que parece. Ela só vale se o tratamento provavelmente não implicar risco para os direitos das pessoas, for ocasional e não envolver categorias especiais de dados pessoais (como dados de saúde) nem dados sobre condenações penais. Folha de pagamento e uma base de clientes não são ocasionais, então a maioria das pequenas empresas mantém o registro de qualquer forma. A Comissão Europeia propôs mudanças nessa isenção; em 19 de novembro de 2026, o EUR-Lex ainda as lista como propostas, e não como alterações em vigor.
O guia do Comitê Europeu para a Proteção de Dados (CEPD) para pequenas empresas oferece um ponto de partida prático: identifique quais das suas atividades envolvem dados pessoais, como recrutamento, folha de pagamento ou crachás de acesso, e descreva cada uma (guia do CEPD para pequenas empresas). O mapa de dados é o material de trabalho, e o registro do artigo 30 é o documento formal construído a partir dele; o detalhe extra do mapa (nomes de tabelas, campos, servidores) é o que mantém o registro exato.
O mesmo mapa alimenta uma avaliação de impacto sobre a proteção de dados (AIPD). O artigo 35 a exige antes de um tratamento que provavelmente resulte em alto risco para as pessoas, como o tratamento em grande escala de dados de saúde, e ninguém consegue avaliar o risco de dados que ainda não localizou.
A lei de proteção de dados da Türkiye, a KVKK, tem um equivalente próximo. Pelo regulamento turco sobre o registro de responsáveis pelo tratamento, os responsáveis pelo tratamento obrigados a se inscrever no registro público, o VERBIS, preparam um inventário de tratamento de dados pessoais. Ele cobre finalidades e bases legais, categorias de dados, grupos de destinatários, grupos de pessoas, prazos máximos de conservação, transferências previstas para o exterior e medidas de segurança, e a inscrição no registro se baseia nele.
Como montar um mapa de dados pessoais?
Um mapa de dados pessoais se monta começando pelas atividades do negócio, e não pelos bancos de dados, e depois seguindo cada atividade até os seus sistemas, dados e destinatários:
- Liste as atividades. Pergunte a cada equipe o que ela faz com informações sobre pessoas: contratação, folha de pagamento, vendas, suporte, marketing, análise do site, logs de segurança.
- Encontre os sistemas. Nomeie os aplicativos, bancos de dados, planilhas, pastas compartilhadas e caixas de e-mail que cada atividade usa, incluindo softwares que fornecedores operam para você.
- Registre os dados e as pessoas. Anote quais categorias de dados (contato, pagamento, saúde) são guardadas sobre quais grupos (clientes, funcionários, candidatos, visitantes).
- Anote a finalidade e a base legal. Escreva por que os dados são tratados e em qual hipótese legal o tratamento se apoia.
- Siga os fluxos. Registre de onde os dados vêm, quais fornecedores os recebem e se eles saem do país.
- Defina retenção e segurança. Informe por quanto tempo cada categoria é guardada e o que a protege.
- Mantenha o mapa atualizado. Vincule as atualizações a eventos: uma ferramenta nova, um fornecedor novo, um formulário novo no site.
Equipes que coletam dados públicos da web também devem incluir esses conjuntos de dados, já que páginas coletadas costumam trazer nomes, links de perfil ou endereços de e-mail; o artigo sobre como tratar dados pessoais em dados de scraping explica como reduzir esses campos.
Onde os proxies entram no mapeamento de dados?
Os proxies entram antes do mapeamento, na etapa de coleta, quando os dados que você mapeia vêm de páginas web públicas de vários países. Uma página de produto na Alemanha mostra o preço com vírgula decimal, a versão dos EUA usa ponto, e um site indica o estoque com availability, enquanto outro mostra só um selo. Uma saída de proxy em cada país mostra a página que um visitante local vê, e mapear todas as versões para um único esquema (produto, preço, moeda, estoque, país, horário da coleta) é o primeiro passo antes de qualquer comparação. Equipes que preferem receber os dados já estruturados podem usar a nossa Web Scraping API, um serviço gerenciado de extração de páginas disponível pela nossa equipe comercial.
Um mapa de dados também é uma ferramenta de segurança: ele diz o que um vazamento exporia. Equipes de segurança que monitoram fontes públicas em busca de dados vazados da empresa usam proxies para segurança de dados para fazer essa pesquisa longe da própria rede, dentro dos limites legais que se aplicam a ela.
Onde o mapeamento de dados é usado?
- Migrações de dados: a mudança para um novo CRM, plataforma de loja ou sistema contábil.
- ETL e data warehouses: carregar muitos sistemas num único modelo de relatórios.
- Integrações: manter os pedidos sincronizados entre uma loja e uma ferramenta de faturamento.
- Fusões: combinar os dados de clientes e produtos de duas empresas.
- Dados da web: transformar páginas de muitos sites e países numa única tabela.
- Conformidade com a privacidade: o registro do GDPR, o inventário da KVKK, as AIPD e os pedidos de pessoas que querem uma cópia dos seus dados.
Erros comuns
- Mapear só pelo nome do campo.
date,statusetypesignificam coisas diferentes em sistemas diferentes. - Não declarar os formatos de origem. Datas, separadores decimais, unidades e codificações precisam de uma regra explícita.
- Descartar campos em silêncio. Todo campo não mapeado precisa de uma decisão registrada.
- Testar só linhas limpas. Campos vazios, nomes longos e caracteres estrangeiros quebram regras que passam em amostras arrumadas.
- Considerar o documento pronto no go-live. Uma mudança de esquema sem mudança no mapa estraga os dados silenciosamente.
- Levar flags de consentimento adiante sem prova. Elas precisam de evidência, e não de um valor padrão.
- Montar o mapa de privacidade só a partir dos sistemas de TI. Planilhas, caixas de e-mail e ferramentas de fornecedores também guardam dados pessoais.
Guia de decisão
| Necessidade | Recomendação |
|---|---|
| Passar dados para um sistema novo uma única vez | Planilha de origem para destino, testada com amostras |
| Integração recorrente | Mapeamento baseado em esquemas na ferramenta de ETL, versionado |
| Muitas fontes parecidas (feeds, sites) | Um esquema de destino; sugestões da ferramenta confirmadas por uma pessoa |
| Registro das atividades de tratamento do GDPR | Primeiro um inventário por atividades, depois o registro do artigo 30 |
| Tratamento de alto risco planejado | Primeiro o mapa de dados, depois uma AIPD |
| Responsável pelo tratamento registrado na Türkiye | Inventário de tratamento da KVKK como base para o VERBIS |
| Uma pessoa pede os próprios dados | Usar o mapa para achar cada sistema que os guarda |
Perguntas frequentes
O que é mapeamento de dados em termos simples?
Mapeamento de dados é decidir para onde vai cada dado quando ele passa de um sistema para outro e como muda no caminho. Na privacidade, é listar onde os dados pessoais ficam guardados, por quê e quem os recebe.
Qual é um exemplo de mapeamento de dados?
Uma loja que migra para uma nova plataforma associa a antiga coluna fname ao novo campo first_name e converte as datas de nascimento de 03/04/1990 para 1990-04-03. Um exemplo de privacidade é uma tabela mostrando que os e-mails dos clientes ficam no banco de dados da loja, vão para uma ferramenta de newsletter e são apagados dois anos depois do último pedido.
Dá para fazer mapeamento de dados no Excel?
Sim. Para migrações pontuais, a planilha é o formato mais comum: uma linha por campo com origem, destino, regra, tipo e status. Em integrações recorrentes, mantenha a planilha como especificação e as regras na sua ferramenta de ETL, e atualize as duas juntas.
O que é mapeamento de dados no GDPR?
É o trabalho de base para o registro do artigo 30: quais dados pessoais você trata, por quê, sobre quem, quem os recebe, para onde vão e por quanto tempo são guardados. O regulamento exige o registro, e não um diagrama, mas poucas organizações conseguem escrever um registro exato sem mapear antes.
Um mapa de dados é o mesmo que um registro das atividades de tratamento?
Não. O mapa de dados é a visão de trabalho detalhada de sistemas, campos e fluxos; o registro é a lista formal que o GDPR exige, organizada por atividade. A maioria das equipes monta o registro a partir do mapa.
Quem é responsável pelo mapeamento de dados?
Nas integrações, o documento de mapeamento fica com os engenheiros de dados ou com a equipe de migração, e o responsável de negócio de cada campo confirma o seu significado. Na privacidade, a responsabilidade é do responsável pelo tratamento, em geral por meio de uma pessoa encarregada da privacidade ou do encarregado da proteção de dados, que reúne as informações de cada equipe.
Em resumo
Mapeamento de dados significa formar pares de campos entre sistemas com uma regra escrita para cada um, e localizar os dados pessoais, suas finalidades e seus fluxos para a conformidade com a privacidade. O mapeamento de campos falha com formatos não declarados e descartes silenciosos; o mapeamento de privacidade começa pelas atividades e se torna o registro do artigo 30 do GDPR ou, na Türkiye, o inventário da KVKK. Se as suas fontes são páginas web públicas de vários países, mapeie-as para um único esquema desde o início e colete cada página a partir do país que ela descreve, por exemplo com os Proxies residenciais com segmentação por país.