Uma linha no log do seu servidor mostra CCBot/2.0 (https://commoncrawl.org/faq/). Ou a seção de dados do artigo de um modelo de IA diz que a maior parte do texto de treinamento veio do "Common Crawl filtrado". As duas pistas levam ao mesmo lugar: uma organização sem fins lucrativos que copia a web pública desde 2008 e entrega essas cópias a quem quiser.
Este artigo mostra o que um rastreamento contém, como o crawler se comporta, qual é o tamanho e a atualidade dos dados (com a lista oficial de rastreamentos como a lemos em 17 de novembro de 2026), quem os usa, onde eles ficam aquém, como os donos de sites podem ficar de fora e como o Common Crawl se compara à Wayback Machine.
O que é o Common Crawl?
O Common Crawl é uma organização sem fins lucrativos 501(c)(3), uma categoria fiscal dos EUA, que rastreia a web e publica as páginas coletadas como um conjunto de dados aberto. O site da organização descreve um corpus de mais de 300 bilhões de páginas, livre e aberto desde 2007 e citado em mais de 10.000 trabalhos de pesquisa (consultado em 17 de novembro de 2026).
A lógica é prática: rastrear bilhões de páginas exige servidores e engenheiros que só grandes empresas conseguem bancar, então um grupo faz o trabalho e compartilha o resultado. Os dados ficam no Amazon S3, na região US East (N. Virginia), e também podem ser baixados por HTTPS em data.commoncrawl.org. Não é um buscador: não há resultados ranqueados, só um índice que localiza endereços.
O que há dentro de um rastreamento do Common Crawl?
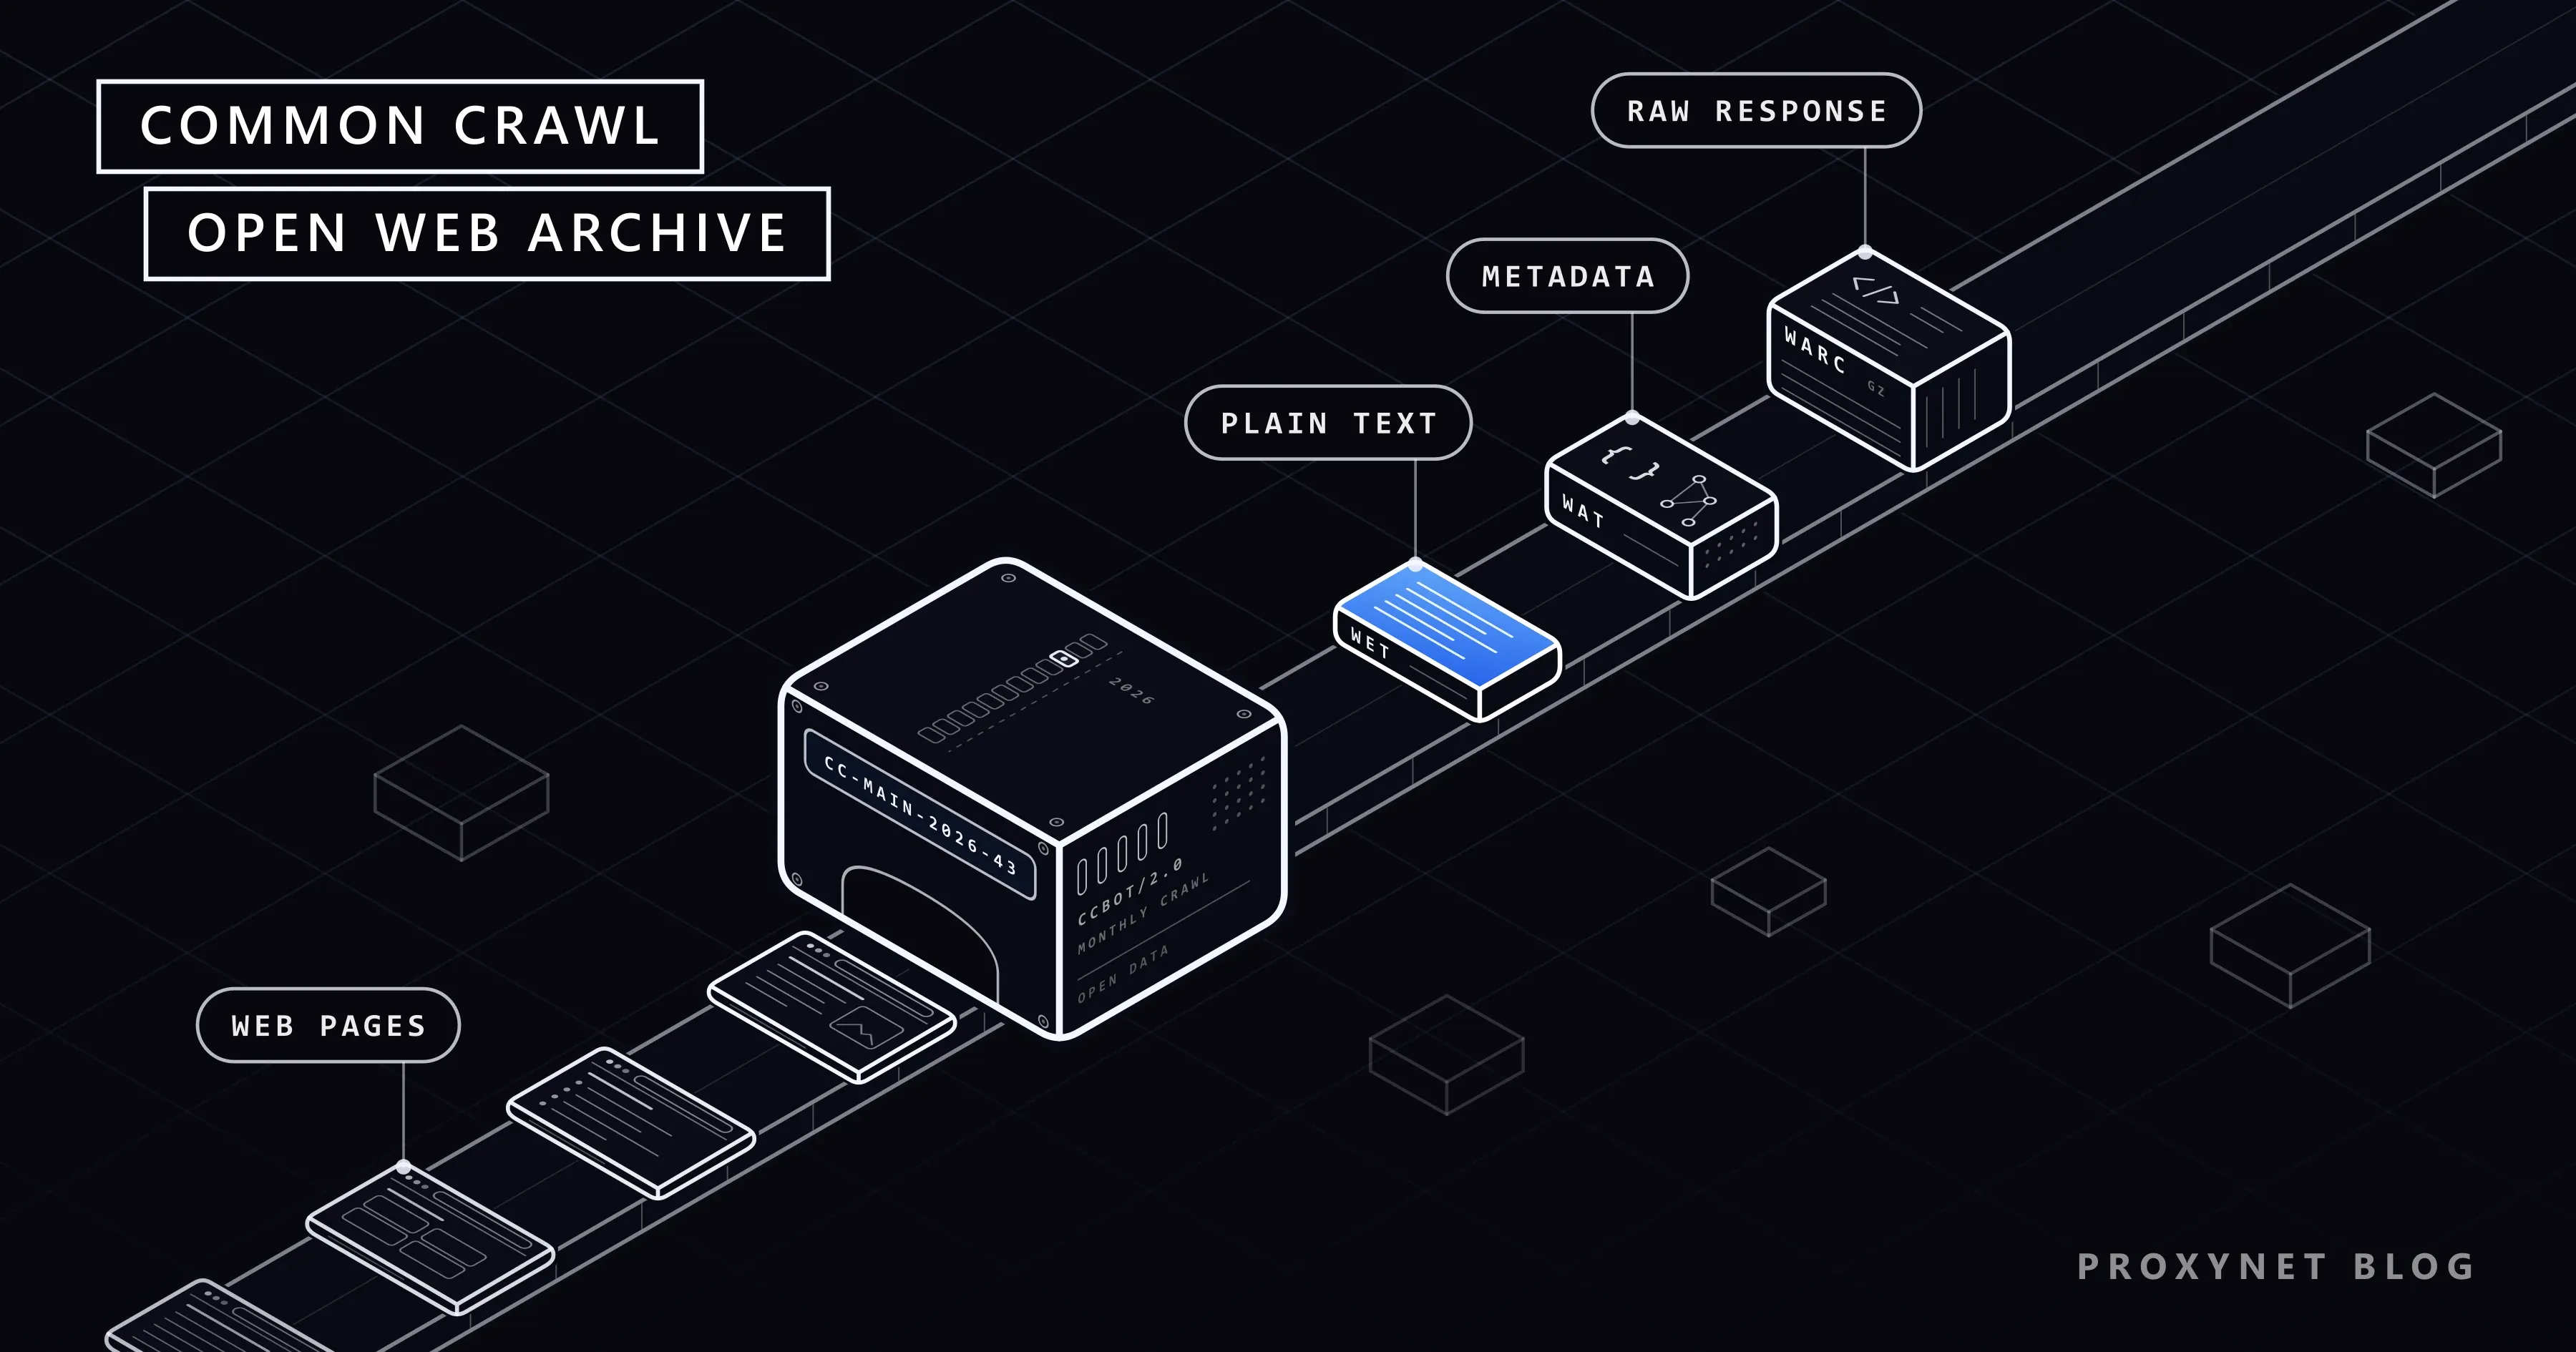
Cada rastreamento é publicado como arquivos em três formatos, mais índices que dizem onde cada página está guardada.
- WARC (Web ARChive) é o registro bruto: para cada página, a requisição HTTP que o CCBot enviou e a resposta completa, incluindo cabeçalhos e HTML.
- Os arquivos WAT guardam metadados calculados a partir de cada registro WARC, em JSON: cabeçalhos de resposta, os links encontrados na página e outros detalhes.
- Os arquivos WET (WARC Encapsulated Text) guardam só o texto simples extraído de cada página.
- O índice de URLs responde a "este endereço foi capturado, e onde ele está?". Uma consulta retorna o horário da captura, o status HTTP e o arquivo, o deslocamento (offset) e o tamanho do registro. Uma segunda forma, o URL Index em formato Parquet, serve para filtrar milhões de linhas com ferramentas de banco de dados.
Os arquivos robots.txt e as respostas diferentes de 200, como redirecionamentos e erros, são publicados em conjuntos separados. As partes principais do rastreamento de outubro de 2026, com os tamanhos compactados do anúncio do Common Crawl:
| Arquivo | O que contém | Tamanho (compactado) | Uso típico |
|---|---|---|---|
| WARC | Requisições, respostas, HTML bruto | 86,19 TiB | Reler as páginas do seu jeito |
| WAT | Cabeçalhos e links em JSON | 14,06 TiB | Grafos de links, estudo de sites |
| WET | Texto simples extraído | 5,85 TiB | Dados linguísticos, análise de texto |
| Índice de URLs | Endereços capturados e sua localização | 0,43 TiB | Achar páginas antes de baixar |
Um tebibyte (TiB) equivale a cerca de 1,1 terabyte. O texto é umas quinze vezes menor que o arquivo bruto, então uma equipe que só precisa de palavras começa pelos arquivos WET, e uma que precisa da estrutura da página ou de um extrator de texto melhor começa pelo WARC.
Como o CCBot coleta as páginas?
O crawler do Common Crawl, o CCBot, lê primeiro o robots.txt, busca HTML puro e desacelera quando um servidor está com dificuldades. Os detalhes abaixo vêm das perguntas frequentes (FAQ) do Common Crawl, consultadas em 17 de novembro de 2026.
- Ele verifica o robots.txt. Se o arquivo bloqueia o CCBot, a página não é buscada; o Common Crawl volta a verificar o arquivo de tempos em tempos.
- Ele se identifica. As requisições levam o user agent
CCBot/2.0 (https://commoncrawl.org/faq/)e saem de algumas faixas de IP dedicadas listadas no FAQ. Uma consulta de DNS reverso em um endereço IPv4 real do CCBot retorna um nome terminado emcrawl.commoncrawl.org, o que o diferencia de bots que só pegam o nome emprestado. - Ele encontra páginas por links e sitemaps. O CCBot segue links de outros sites, então pode chegar a páginas que você mesmo nunca linkou, e lê qualquer sitemap listado no robots.txt. Ele respeita links
nofollow. - Ele busca HTML sem executar scripts. Sem JavaScript e sem cookies: uma página cujo conteúdo é montado no navegador pode ficar quase vazia no arquivo.
- Ele controla o próprio ritmo. Espera alguns segundos entre requisições ao mesmo site, recua diante de erros 429 (requisições demais) e 5xx e obedece ao
Crawl-delay. - Ele faz amostragem. O Common Crawl não arquiva sites inteiros; guarda um subconjunto escolhido aleatoriamente das páginas de cada site.
- Ele publica. As capturas são gravadas em arquivos WARC; WAT, WET e os índices são derivados deles, e o rastreamento é lançado com um ID como
CC-MAIN-2026-43.
Qual é o tamanho do Common Crawl e com que frequência ele é atualizado?
O Common Crawl publica um novo rastreamento todo mês; em 2025 e 2026 saiu um para cada mês. A lista oficial de rastreamentos é um arquivo JSON em https://index.commoncrawl.org/collinfo.json. Nós a lemos uma vez, em 17 de novembro de 2026, às 02:02 UTC; estas são as duas primeiras entradas, sem alterações:
[
  {
    "id": "CC-MAIN-2026-43",
    "name": "October 2026 Index",
    "timegate": "https://index.commoncrawl.org/CC-MAIN-2026-43/",
    "cdx-api": "https://index.commoncrawl.org/CC-MAIN-2026-43-index",
    "from": "2026-10-05T10:56:23",
    "to": "2026-10-18T05:34:47"
  },
  {
    "id": "CC-MAIN-2026-39",
    "name": "September 2026 Index",
    "timegate": "https://index.commoncrawl.org/CC-MAIN-2026-39/",
    "cdx-api": "https://index.commoncrawl.org/CC-MAIN-2026-39-index",
    "from": "2026-09-04T13:16:03",
    "to": "2026-09-17T05:59:21"
  },
A lista tinha 129 entradas. A mais recente, CC-MAIN-2026-43, foi rastreada entre 5 e 18 de outubro de 2026; a mais antiga cobre de 2008 a 2009 em ARC, o formato usado antes do WARC. Cada entrada tem um endereço cdx-api, o índice daquele rastreamento, e as datas mostram o ritmo: cerca de duas semanas de rastreamento e depois uma pausa até o mês seguinte.
O anúncio do rastreamento de outubro de 2026, publicado pelo Common Crawl em 21 de outubro, informa o tamanho: 2,16 bilhões de páginas, ou 371,19 TiB sem compactação, de 41,4 milhões de hosts e 34,3 milhões de domínios registrados. Entre elas, havia 830,1 milhões de páginas em endereços que nenhum rastreamento anterior tinha visitado; o restante permite que pesquisadores comparem a mesma URL ao longo dos meses.
Um conjunto de dados de notícias separado, o CC-NEWS, foi lançado em 2016 para publicar artigos de sites de notícias logo depois da captura, em vez de esperar o lançamento mensal.
Quem usa o Common Crawl?
O Common Crawl é usado principalmente por quem precisa de páginas web em grande volume e não consegue rastrear bilhões delas por conta própria:
- Treinamento de modelos de linguagem. Um grande modelo de linguagem (LLM) aprende prevendo texto e precisa de centenas de bilhões de palavras; o Common Crawl é a maior fonte gratuita.
- Pesquisa acadêmica. Linguistas e pesquisadores da web estudam como a web é construída, quais idiomas ela usa e como as páginas mudam.
- SEO e análise de links. Os arquivos WAT listam os links de cada página, e o Common Crawl monta a partir deles grafos da web em nível de host e de domínio, com pontuações como harmonic centrality e PageRank; o grafo de hosts de maio a julho de 2026 tinha 240,4 milhões de nós e 3,7 bilhões de arestas.
O uso mais bem documentado está nos artigos sobre modelos. O artigo do GPT-3, da OpenAI, descreve 41 lotes mensais (shards) do Common Crawl de 2016 a 2019: 45 TB de texto simples compactado antes da filtragem e 570 GB depois, o que correspondia a 60% da mistura de treinamento. Os autores mantiveram as páginas parecidas com textos de qualidade mais alta e removeram documentos quase duplicados.
O artigo do T5, do Google, criou o C4, o Colossal Clean Crawled Corpus, a partir de um único mês do Common Crawl, abril de 2019, e ficou com cerca de 750 GB de texto em inglês depois da limpeza. Conjuntos limpos como o C4 permitem que as equipes usem texto do Common Crawl sem processar elas mesmas um rastreamento bruto.
Treinar é um trabalho diferente de responder perguntas sobre o presente. Um modelo treinado com um instantâneo de 2019 não sabe nada mais recente, por isso muitas ferramentas de IA buscam páginas atuais no momento da pergunta, um padrão chamado RAG (geração aumentada por recuperação). Nosso guia de web scraping para RAG mostra como essas páginas viram texto limpo.
Quais são os limites do Common Crawl?
O Common Crawl é uma grande amostra da web pública, tirada uma vez por mês a partir de um só lugar, e cada parte dessa frase impõe um limite.
- Uma amostra, não a web. Cada site é representado por um subconjunto aleatório das suas páginas. Os sites que bloqueiam o CCBot ficam de fora, as páginas atrás de login nunca são buscadas e o conteúdo montado por JavaScript fica ralo.
- Instantâneos, não dados ao vivo. Uma página que mudou ontem aparece na versão antiga, ou não aparece, até o próximo rastreamento. O que acontece entre dois rastreamentos não está no conjunto de dados principal.
- Idiomas desiguais. O Common Crawl detecta o idioma de cada página com o CLD2, um detector de código aberto. As estatísticas de idiomas do rastreamento de outubro de 2026 mostram 42,56% de inglês, seguido de russo (6,30%) e alemão (5,77%); o turco ficou em 1,14%.
- Ruído e duplicatas. Os autores do T5 escreveram que a maior parte do texto extraído do Common Crawl não é linguagem natural, e sim menus, mensagens de erro e texto repetido. Usos sérios filtram e removem duplicatas primeiro.
- Um só ponto de vista. O CCBot trabalha a partir de um punhado de faixas de IP. Um site que muda preços, idioma ou conteúdo conforme a localização do visitante responde ao CCBot com a versão pensada para esses endereços.
Os dados do Common Crawl são de uso livre?
Os dados do Common Crawl são gratuitos para baixar, mas as páginas continuam pertencendo a quem as publicou. Os termos de uso (atualizados pela última vez em 7 de março de 2024) dizem que o Common Crawl não é dono do conteúdo rastreado, que os usuários devem respeitar os direitos autorais de terceiros e que assumem o risco do próprio uso. Os termos não proíbem o treinamento de IA, mas os usuários precisam indenizar o Common Crawl por reclamações decorrentes dele.
Usar páginas rastreadas para treinar IA é algo contestado. Em abril de 2026, a News/Media Alliance, uma associação de editores dos EUA, escreveu ao Common Crawl pedindo que removesse o conteúdo dos editores mediante solicitação e proibisse o uso para IA nos seus termos. Se treinar com páginas copiadas é legal ainda está em discussão em tribunais e parlamentos e varia de país para país; para um projeto comercial, consulte um advogado no seu mercado.
As páginas também podem conter dados pessoais, como nomes e endereços de e-mail. O tratamento desses dados está sujeito a leis de privacidade como o GDPR, na União Europeia, ou a KVKK, na Türkiye, não importa quem coletou a página primeiro.
Como os donos de sites podem ficar de fora do Common Crawl?
Para manter o CCBot fora do seu site, adicione um grupo para ele no robots.txt. O FAQ do Common Crawl traz estas duas linhas:
User-agent: CCBot
Disallow: /
Para apenas desacelerá-lo, defina um intervalo em segundos entre as requisições:
User-agent: CCBot
Crawl-delay: 2
Nosso guia de robots.txt explica como os grupos e as regras são lidos. Bloquear o CCBot não impede o GPTBot, o ClaudeBot nem qualquer outro bot; cada um precisa do próprio grupo.
Uma regra no robots.txt vale para visitas futuras; as páginas capturadas antes de você adicioná-la já estão em rastreamentos publicados. Para pedidos legais de remoção, o Common Crawl mantém uma lista pública chamada Opt-Out Ledger.
Common Crawl, Wayback Machine ou um rastreamento próprio
O Common Crawl, a Wayback Machine e um rastreamento próprio guardam cópias de páginas web, mas respondem a perguntas diferentes.
| Common Crawl | Wayback Machine | Seu próprio rastreamento | |
|---|---|---|---|
| Feito para | Análise em massa por programas | Ver páginas antigas | A sua pergunta específica |
| Como usar | Baixar arquivos, consultar o índice | Digitar um endereço, escolher uma data | Coletar as páginas que você escolher |
| Atualidade | Instantâneos mensais | Quando a página foi salva | Com a frequência que você agendar |
| Cobertura | Uma amostra de muitos sites | Páginas que foram salvas | Só os sites que você quer |
| Custo | Dados grátis, processamento por sua conta | Consulta grátis | Sua estrutura e manutenção |
A Wayback Machine, mantida pelo Internet Archive, é feita para pessoas: você digita um endereço, escolhe uma captura em um calendário e vê a página como ela era, e qualquer pessoa pode pedir que ela salve uma página com o Save Page Now. Nosso guia da Wayback Machine trata dessa parte. O Common Crawl não tem um visualizador assim; os arquivos dele são feitos para código que lê milhões de páginas de uma vez.
Por que o Common Crawl não entrega dados atuais e locais
O Common Crawl não consegue mostrar o preço de hoje de um produto em Madri nem como uma página aparece para visitantes em Seul, porque os dados são coletados uma vez por mês a partir de poucas faixas de IP. Dados assim precisam ser coletados para a sua pergunta, no momento e a partir do lugar que importam.
As equipes que acompanham preços ou verificam páginas localizadas coletam elas mesmas essas páginas públicas: com agenda, em ritmo educado, dentro do robots.txt e dos termos do site. Para ver uma página como um visitante de determinado país ou cidade a vê, a requisição precisa sair de lá; os Proxies residenciais com segmentação por país e cidade a enviam por uma conexão residencial nesse lugar.
Nossa página de solução de web crawler mostra onde os proxies entram em um crawler assim. Eles não têm lugar na frente do próprio Common Crawl: o FAQ pede que ninguém consulte o índice por redes de proxies, que se envie uma requisição por vez com um user agent claro e que se desacelere diante de erros 503.
Erros comuns
- Tratá-lo como a web inteira. É uma amostra; a ausência de uma página em um rastreamento não prova nada.
- Treinar com texto WET bruto. A maior parte são menus, avisos e duplicatas; filtre e remova duplicatas primeiro.
- Sobrecarregar o servidor do índice. Ele tem um limite de taxa rígido, e um IP que envia requisições demais pode ser bloqueado por 24 horas. Para filtragens amplas, use o URL Index em Parquet com uma ferramenta como Amazon Athena ou Apache Spark.
- Esperar que o robots.txt limpe rastreamentos antigos. Uma regra nova só afeta visitas futuras.
Guia de decisão
| Sua necessidade | Opção indicada |
|---|---|
| Texto amplo da web para pesquisa ou treinamento de modelos | Arquivos WET ou um conjunto filtrado como o C4 |
| Como uma página era em uma data passada | A Wayback Machine |
| Quais sites linkam para quais | Arquivos WAT ou os grafos da web do Common Crawl |
| Se o seu site está no Common Crawl | Uma consulta sem pressa no índice de URLs |
| Manter o seu site fora de rastreamentos futuros | Um grupo CCBot no robots.txt |
| Preços de hoje, ou páginas vistas de um país | Um rastreamento próprio e educado ou um serviço gerenciado |
Perguntas frequentes
O Common Crawl é gratuito?
Sim. Qualquer pessoa pode baixar os dados por HTTPS ou do Amazon S3 sem pagar nada ao Common Crawl; você paga só o seu próprio armazenamento e processamento, e o Common Crawl recomenda processar os dados em us-east-1, a região da AWS onde eles ficam. As páginas mantêm os direitos autorais.
O Common Crawl respeita o robots.txt?
Sim. O CCBot lê o robots.txt antes de buscar, pula o que está bloqueado para o CCBot, obedece ao Crawl-delay e respeita links nofollow. O FAQ lista as faixas de IP dele, então você pode verificar se um visitante que se diz CCBot é real.
O Common Crawl inclui imagens?
Praticamente não. No rastreamento de outubro de 2026, 98,31% das capturas eram páginas HTML e 1,00% arquivos PDF, enquanto as imagens ficaram em torno de 0,001%. O HTML contém os endereços das imagens, mas não os arquivos de imagem.
Qual é a diferença entre o Common Crawl e o C4?
O Common Crawl é o rastreamento mensal bruto. O C4 é um conjunto de dados em inglês já limpo que pesquisadores do Google criaram a partir de um mês dele, abril de 2019, removendo linhas de texto padrão (boilerplate), páginas muito curtas, código, palavras ofensivas e texto repetido, o que deixou cerca de 750 GB.
Dá para pesquisar no Common Crawl como em um buscador?
Não. Não há busca de texto completo nem ranking; o índice só encontra capturas por endereço ou padrão de endereço. Para pesquisar no texto, é preciso processar os arquivos WET com as suas próprias ferramentas.
Como verificar se o meu site está no Common Crawl?
Abra index.commoncrawl.org, escolha um rastreamento e pesquise o seu domínio com um curinga, como example.com/*. Os resultados listam cada URL capturada com o horário da captura e o status HTTP. Envie uma consulta por vez, porque o servidor tem limite de taxa.
Em resumo
O Common Crawl é uma cópia gratuita e aberta de uma grande amostra da web pública, capturada mais ou menos uma vez por mês pelo CCBot e publicada como páginas brutas (WARC), metadados (WAT), texto simples (WET) e índices de URLs. Ele está por trás de boa parte do treinamento de IA e da pesquisa sobre a web, mas é uma amostra periódica, de um só ponto de vista, exige muita filtragem, e as páginas mantêm os direitos autorais. Os donos de sites controlam o CCBot pelo robots.txt. Quando os seus dados precisam ser atuais ou locais, colete-os em ritmo educado ou fale com a nossa equipe de vendas sobre a extração gerenciada de páginas.