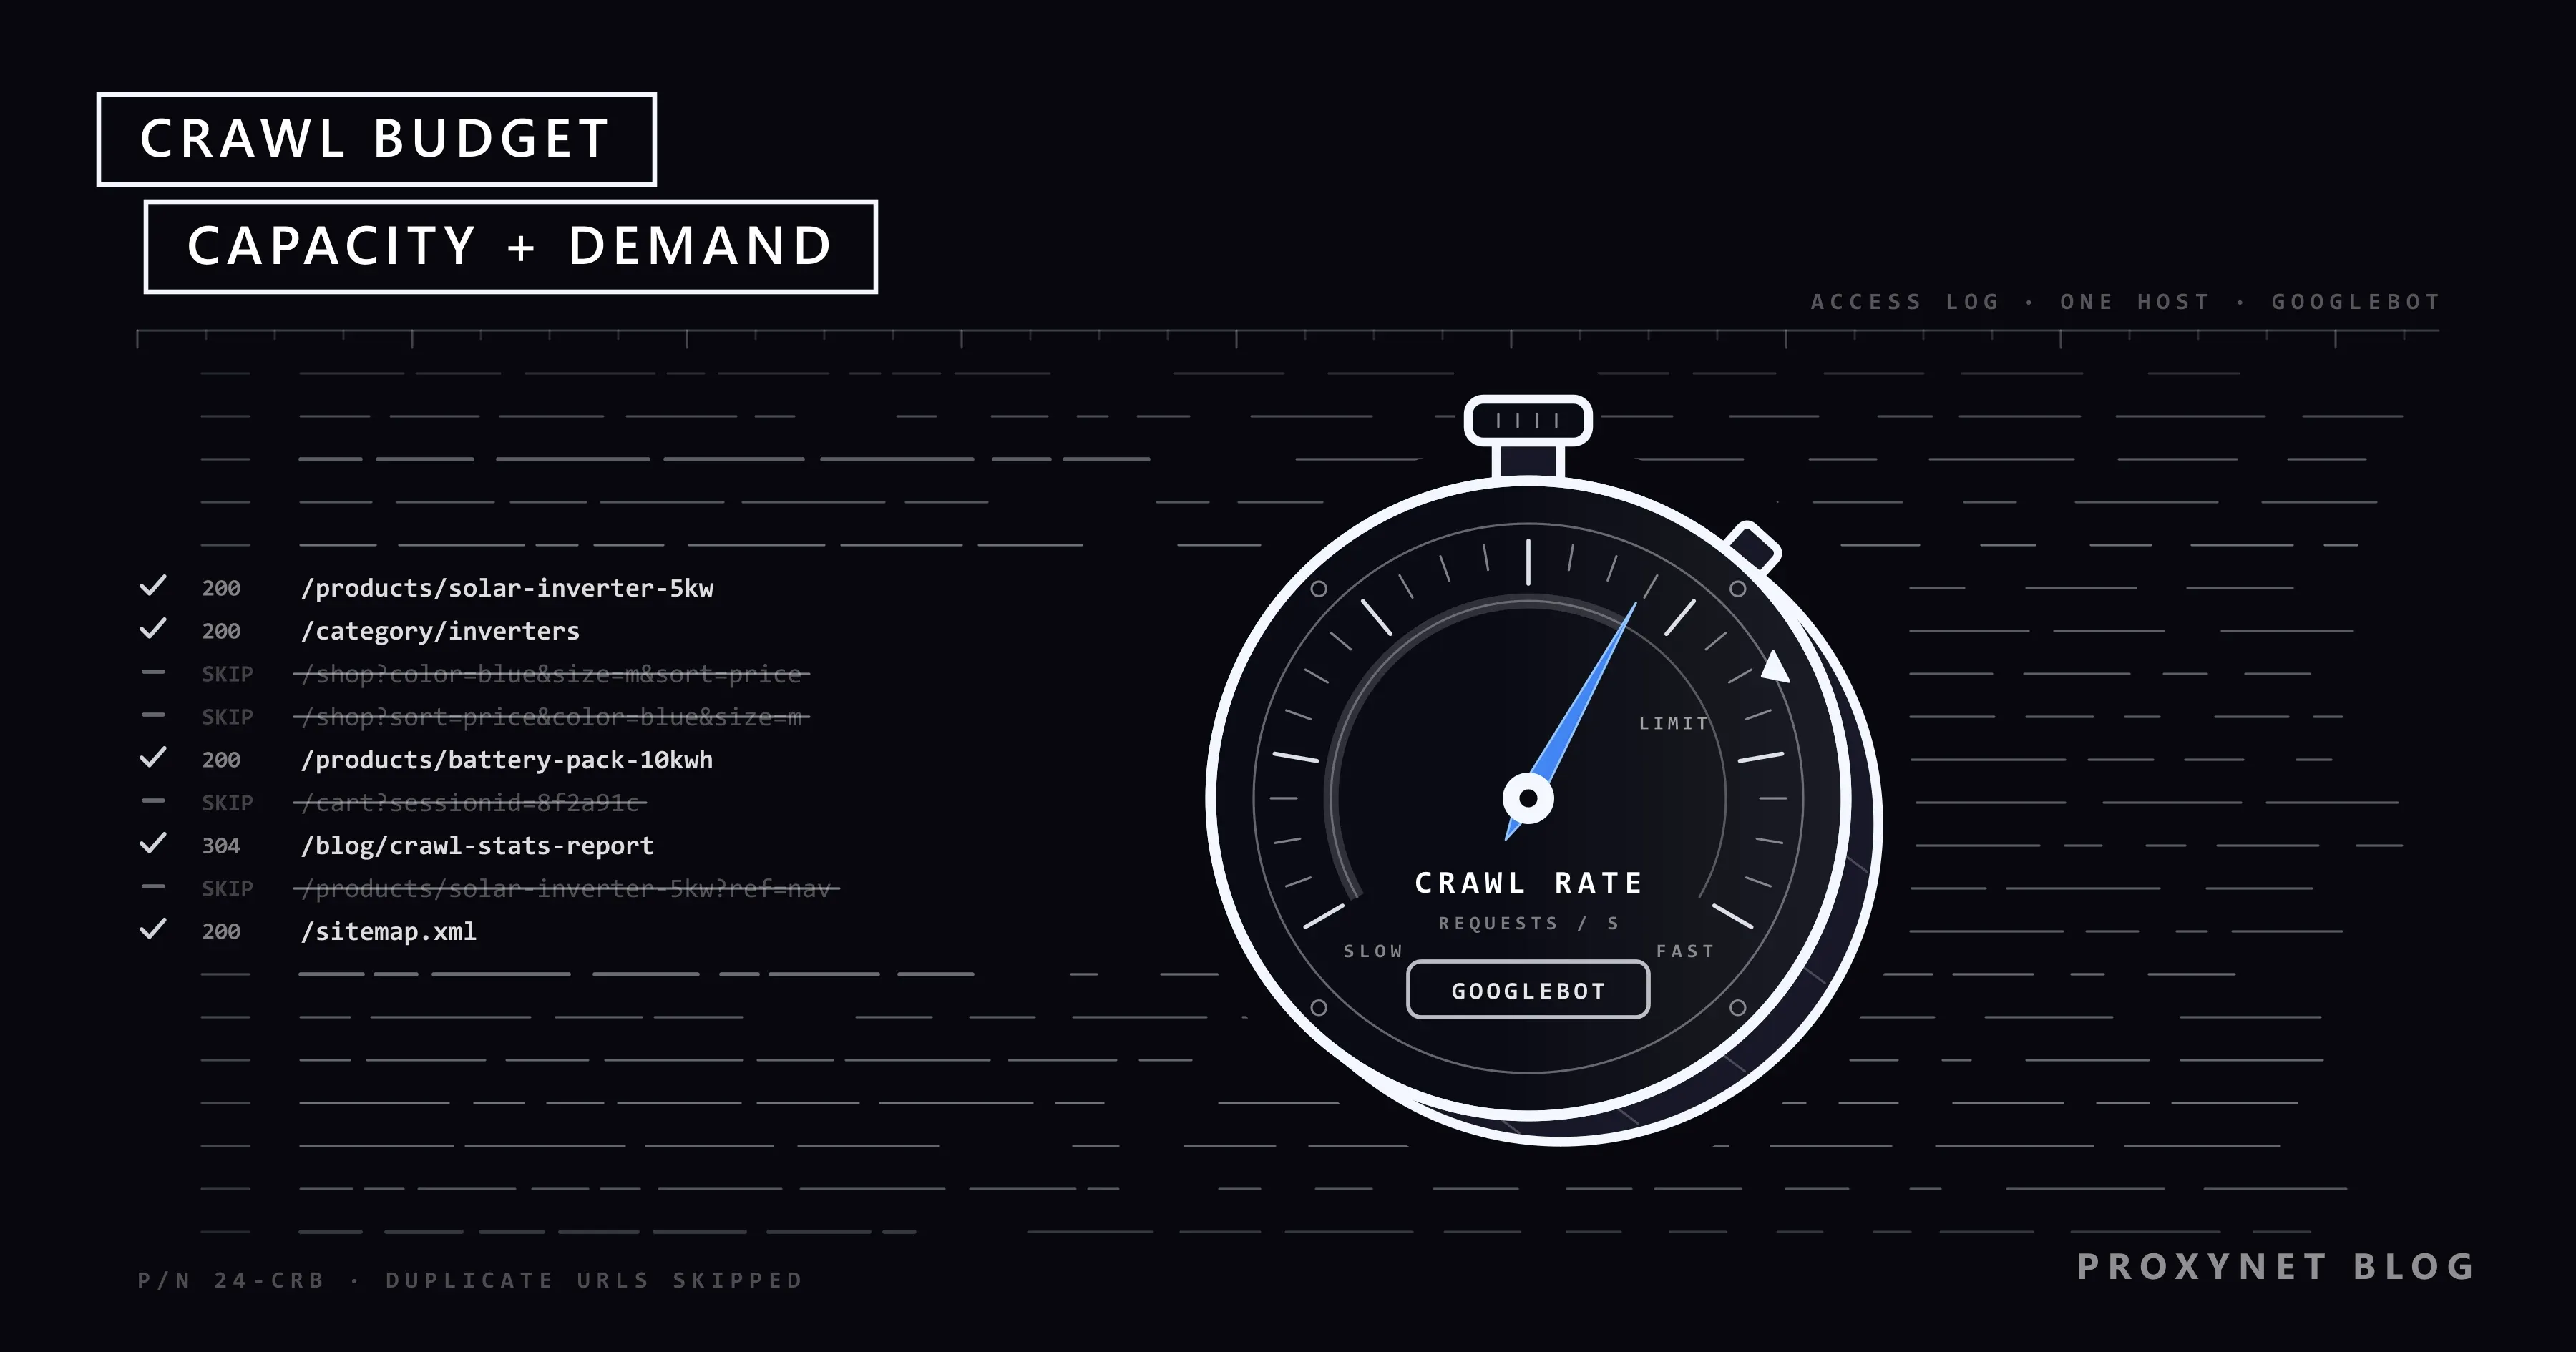
Você adiciona 20.000 páginas de produto a uma loja online, envia o sitemap e, três semanas depois, o Search Console mostra a maioria delas como "Detectada, mas não indexada no momento". Os logs do servidor contam a outra metade da história: o Googlebot andou ocupado, mas principalmente com endereços de filtro como ?color=blue&size=m&sort=price. As páginas que importam para você esperam em uma fila que anda a uma velocidade limitada. Os profissionais de SEO chamam esse limite de orçamento de rastreamento (crawl budget).
Este artigo explica o orçamento de rastreamento nos termos do próprio Google, quais sites precisam se preocupar com ele e como o Googlebot vai de encontrar uma URL até indexá-la. Depois, mostra o que desperdiça rastreamentos, como verificá-los, o que significam os dois status de página não indexada e como identificar um Googlebot falso.
O que é orçamento de rastreamento?
O orçamento de rastreamento é o número de URLs que o Google consegue e quer rastrear no seu site, e o conceito é do próprio Google, que em português o chama de cota de rastreamento: o guia Otimizar sua cota de rastreamento o define como o conjunto de URLs que o Google pode e quer rastrear. Rastrear significa que um programa, aqui o Googlebot, solicita uma URL e baixa o que o servidor devolve. Nada entra no índice do Google sem ter sido rastreado antes.
O orçamento é definido por nome de host, então www.example.com e shop.example.com têm cada um o seu. Não existe um número que você possa consultar ou aumentar em uma configuração; o orçamento é o resultado de duas coisas que o Google mede o tempo todo.
O que são limite de capacidade de rastreamento e demanda de rastreamento?
O limite de capacidade de rastreamento é quanto o Googlebot consegue rastrear sem sobrecarregar seu servidor, e a demanda de rastreamento é quanto ele quer rastrear. Na prática, o menor dos dois define seu orçamento.
O limite de capacidade de rastreamento, que o Google também chama de carga do host, limita o tempo total que seu servidor passa mantendo conexões abertas para o Google, considerando tanto o número de conexões em paralelo quanto a duração de cada uma. Todo site começa com o mesmo limite conservador. Se o seu servidor responde rápido e de forma consistente, o Google o aumenta com o tempo; respostas lentas, erros 5xx ou 429 Too Many Requests o reduzem. O limite é compartilhado por todos os crawlers do Google, então o rastreamento intenso de um crawler de imagens ou de anúncios deixa menos espaço para o Googlebot.
A demanda de rastreamento depende de três fatores que o Google cita. O inventário percebido é toda URL que o Google conhece no seu site; ele tenta rastrear a maioria delas, então milhares de URLs inúteis incham a fila. URLs populares são rastreadas com mais frequência, e as desatualizadas são rastreadas de novo para captar mudanças. Uma mudança de endereço do site aumenta a demanda por um tempo. Mesmo com capacidade sobrando, demanda baixa significa menos rastreamento; um servidor rápido, sozinho, não faz páginas com pouco conteúdo serem rastreadas mais vezes.
O orçamento de rastreamento importa para o seu site?
Para a maioria dos sites, não. O guia do Google foi escrito para três tipos de site:
- Sites com cerca de 1 milhão de páginas únicas ou mais cujo conteúdo muda mais ou menos uma vez por semana.
- Sites com cerca de 10.000 ou mais páginas únicas cujo conteúdo muda todos os dias.
- Sites em que grande parte das URLs aparece como "Detectada, mas não indexada no momento".
O Google chama esses números de estimativas aproximadas. Se suas páginas novas costumam ser rastreadas no mesmo dia em que você as publica, um sitemap atualizado e uma olhada de vez em quando no relatório de indexação de páginas bastam. Um site de 300 páginas com um post de blog não indexado tem outro problema, geralmente qualidade, duplicação ou links internos fracos.
Como o Googlebot rastreia um site, passo a passo?
O Googlebot trabalha com uma fila: encontra URLs, agenda o rastreamento, busca cada uma dentro dos limites do seu servidor, renderiza as páginas e as encaminha para a decisão de indexação.
- Descobrir. O Google conhece URLs a partir de páginas rastreadas, dos links delas e de sitemaps.
- Agendar. Um algoritmo decide quais URLs buscar, com que frequência e quantas por visita.
- Verificar o robots.txt. O Googlebot lê o robots.txt, o arquivo de texto na raiz do site que lista os caminhos que os crawlers devem evitar; O que é robots.txt e como ler o arquivo? explica como as regras dele são aplicadas.
- Buscar no ritmo que o servidor aguenta. Respostas lentas, erros 5xx e 429 fazem o Googlebot desacelerar.
- Renderizar. O Google executa o JavaScript da página em uma versão recente do Chrome; scripts, folhas de estilo e imagens também são solicitações de rastreamento.
- Decidir a indexação. O Google agrupa páginas quase idênticas, escolhe uma URL canônica por grupo (a versão que ele pode mostrar nos resultados) e decide se a indexa.
- Rastrear de novo. Páginas conhecidas voltam para a fila para um rastreamento de atualização.
O orçamento de rastreamento atua nas etapas 2 a 4. URLs inúteis na etapa 1 ou uma etapa 4 lenta reduzem o que sobra para as páginas que importam para você.
O que desperdiça o orçamento de rastreamento?
URLs que não geram conteúdo único e indexável desperdiçam o orçamento de rastreamento, e um servidor que obriga o Googlebot a desacelerar também.
| Causa | Exemplo típico | Correção |
|---|---|---|
| Filtros facetados | ?color=red&size=m&sort=price | Bloquear parâmetros de filtro com Disallow |
| Calendários infinitos | /events?month=2031-07 em diante | Parar os links depois das datas reais |
| IDs de sessão na URL | ?sessionid=8f3a9c | Manter a sessão em cookies |
| Cadeias de redirecionamento | De A para B, C e D | Linkar direto para a URL final |
| Soft 404 | Página "Nenhum resultado" com status 200 | Retornar 404 ou 410 |
| Parâmetros de acompanhamento | ?utm_source= em links internos | Usar links internos limpos |
| Servidor lento, 5xx, 429 | Timeouts nos horários de pico | Aumentar a capacidade, corrigir erros |
A navegação facetada, ou seja, as opções de filtro das páginas de categoria, é a maior dessas causas em lojas: três cores, cinco tamanhos e quatro ordenações já geram 60 URLs para uma única categoria. O Google recomenda bloquear no robots.txt as URLs de filtro indesejadas e retornar 404 para combinações de filtro vazias, já que rel="canonical" e nofollow resolvem isso de forma menos confiável. Poucas linhas bastam; * representa qualquer sequência de caracteres:
User-agent: *
Disallow: /*?*sort=
Disallow: /*?*color=
Disallow: /*?*sessionid=
Como verificar seu orçamento de rastreamento?
O Google não mostra nenhum número de orçamento, então o que você verifica é como o Googlebot realmente gasta as visitas, no relatório "Estatísticas de rastreamento" do Search Console e nos logs do servidor.
O relatório fica em Configurações > Estatísticas de rastreamento e só funciona em uma propriedade no nível raiz: uma propriedade de domínio ou uma propriedade de prefixo de URL da raiz do site. Os gráficos mostram Total de solicitações de rastreamento, Tamanho total do download e Tempo médio de resposta, com detalhamento por resposta, tipo de arquivo, finalidade (Descoberta para URLs novas, Atualização para novos rastreamentos) e tipo do Googlebot. A página de ajuda do relatório de estatísticas de rastreamento explica cada parte e observa que sites com menos de 1.000 páginas raramente precisam dele.
O que observar:
- Status do host: busca de robots.txt, resolução de DNS e conectividade do servidor nos últimos 90 dias. Problemas aqui são os primeiros a limitar o rastreamento.
- Tempo médio de resposta: uma linha em alta empurra o limite de capacidade para baixo.
- Respostas de rastreamento: muitas respostas 3xx, 404 ou 5xx significam visitas desperdiçadas.
- Finalidade do rastreamento: poucas solicitações de descoberta em um site que publica todos os dias indicam que as URLs novas estão sendo encontradas devagar.
Os logs do servidor mostram cada solicitação com horário, URL, código de status e user agent. Mantenha apenas as solicitações verificadas do Googlebot, agrupe as URLs por padrão (produtos, filtros, campanhas antigas) e compare os números com as páginas que você quer ver rastreadas. Com, por exemplo, 5.000 solicitações do Googlebot por dia e 600.000 URLs para atualizar, uma passada completa leva cerca de 120 dias.
Como melhorar o orçamento de rastreamento?
Você melhora o orçamento de rastreamento tirando URLs inúteis da vista do Google e deixando seu servidor mais rápido e confiável.
- Bloqueie no robots.txt os espaços de URL inúteis. Filtros, busca interna e ordenações são os casos típicos. Não use
noindex: o Google precisa buscar a página para ver a tag. - Consolide duplicatas. Redirecionamentos e
rel="canonical"são sinais fortes de qual URL é a principal. - Retorne 404 ou 410 para páginas removidas. Um 404 é um sinal forte para não rastrear a URL de novo. Corrija os soft 404, páginas de "não encontrado" enviadas com status 200, que o Google continua rastreando.
- Mantenha os sitemaps atualizados, com datas
lastmodhonestas. Altere olastmodsó quando o conteúdo mudar; Como encontrar o sitemap de um site e ver todas as páginas mostra como são os arquivos de sitemap. - Encurte os caminhos de redirecionamento. Aponte os links internos para as URLs finais.
- Deixe o servidor rápido. Tempos de resposta menores elevam o limite de capacidade, e respostas
304 Not Modifiedevitam reenviar páginas que não mudaram. - Use 503 ou 429 só em emergências. O Google avisa que URLs que os retornam por mais de um ou dois dias podem sair do índice.
Bloquear seções no robots.txt não transfere o orçamento delas para outras páginas, a menos que o site já estivesse no limite de capacidade. E se o teste ao vivo da Ferramenta de inspeção de URL mostrar Carga do host excedida, a solução é mais capacidade de servidor.
O que significam "Rastreada, mas ainda não indexada" e "Detectada, mas não indexada no momento"?
"Detectada, mas não indexada no momento" significa que o Google conhece a URL, mas ainda não a buscou; "Rastreada, mas ainda não indexada" significa que o Google a buscou e decidiu não indexá-la por enquanto. Os dois status aparecem no relatório de indexação de páginas do Search Console, e normalmente só o primeiro aponta para o orçamento de rastreamento.
| Status | O que aconteceu | O que fazer |
|---|---|---|
| Detectada, mas não indexada no momento | Encontrada, rastreamento adiado | Acelerar o servidor, cortar URLs inúteis |
| Rastreada, mas ainda não indexada | Buscada, não indexada | Melhorar ou mesclar a página |
Para "Detectada", a ajuda do relatório de indexação de páginas dá o motivo típico: o Google previu que a visita sobrecarregaria o site e, por isso, remarcou o rastreamento. Verifique primeiro o status do host e os tempos de resposta e depois confirme que as páginas recebem links de páginas rastreadas, e não apenas aparecem no sitemap.
"Rastreada" é comum e, nas palavras do Google, não indica necessariamente um problema que exija atenção, porque o Google indexa páginas canônicas que valem a pena mostrar, não todas as URLs. Examine uma amostra na Ferramenta de inspeção de URL, melhore ou mescle as páginas importantes e deixe o resto. Depois de uma correção, Validar a correção inicia uma nova verificação que pode levar cerca de duas semanas.
Como verificar se um visitante é mesmo o Googlebot?
Você verifica o Googlebot pelo endereço IP, nunca pelo user agent. Qualquer cliente pode escrever "Googlebot" no cabeçalho User-Agent, e essas entradas falsas distorcem qualquer análise de rastreamento.
A página do Google sobre como verificar os crawlers dele traz dois métodos. O manual exige duas consultas de DNS: uma busca DNS reversa do IP deve retornar um nome terminado em googlebot.com, google.com ou googleusercontent.com, e uma busca DNS direta desse nome deve retornar o mesmo IP. Fizemos isso em 17 de novembro de 2026 com o endereço do próprio exemplo do Google (saída resumida; host faz o mesmo no Linux e no macOS):
> nslookup 66.249.66.1
Name:    crawl-66-249-66-1.googlebot.com
Address:  66.249.66.1

> nslookup crawl-66-249-66-1.googlebot.com
Name:    crawl-66-249-66-1.googlebot.com
Address:  66.249.66.1
O método automático compara o IP com os arquivos JSON de intervalos de endereços que o Google publica; common-crawlers.json cobre o Googlebot. Nossa cópia, gerada em 16 de novembro de 2026, continha 66.249.66.0/27, o intervalo que inclui o endereço acima.
Os sistemas de gerenciamento de bots fazem essa mesma verificação para deixar passar os crawlers reais dos buscadores e barrar os impostores; Como funciona a detecção de bots: a lógica anti-bot mostra onde ela fica entre as outras camadas.
Como seus próprios crawlers de SEO devem se comportar?
Seus próprios crawlers de auditoria e suas ferramentas de monitoramento devem rastrear com a mesma cortesia do Googlebot, porque no seu site eles usam a mesma capacidade do servidor. Uma auditoria em velocidade máxima no horário de pico pode aumentar os tempos de resposta e gerar erros 5xx, justamente os sinais que fazem o Googlebot baixar o limite. Defina um ritmo que o servidor aguente com folga, rode auditorias grandes fora do pico, respeite o robots.txt e envie um user agent identificável com uma URL de contato; nossa página de solução de web crawler trata do rastreamento em grande escala.
Nunca envie um user agent do Googlebot a partir do seu próprio crawler. Os sites verificam o Googlebot por DNS e bloqueiam impostores, e se passar pelo crawler de outra empresa é enganação, não um truque de teste.
Um proxy tem uma única função honesta em uma auditoria de rastreamento: mostrar a página que os visitantes de outro país recebem. O Google observa que os endereços IP padrão do Googlebot parecem estar nos EUA, um dos motivos pelos quais recomenda URLs separadas por idioma ou região com hreflang em vez de páginas que mudam conforme a localização do visitante. Os Proxies residenciais no país e na cidade de destino solicitam essas versões como um visitante local faria; não são uma forma de contornar os limites de taxa de um site.
Onde o orçamento de rastreamento aparece?
- Lojas online: páginas de categoria se multiplicam em milhares de combinações de filtro e ordenação.
- Sites de notícias: artigos novos precisam ser rastreados em poucas horas enquanto o arquivo continua crescendo.
- Classificados e marketplaces: anúncios expiram todos os dias, então páginas removidas precisam de respostas 404 ou 410 reais.
- Migrações de site: cada URL é rastreada de novo no endereço novo, e cadeias de redirecionamento deixam isso mais lento.
- Sites com muito JavaScript: cada página precisa de várias solicitações de scripts e dados antes que o Google veja o conteúdo.
Erros comuns
- Usar
noindexpara economizar orçamento de rastreamento. O Google precisa buscar a página para ler a tag. - Tratar toda URL em "Rastreada, mas ainda não indexada" como problema de orçamento. Geralmente a questão é qualidade ou duplicação.
- Definir o
lastmodde todas as URLs com o horário do build. O Google só usa a data quando ela é consistentemente precisa. - Servir 503 por dias durante uma queda ou migração. As páginas podem sair do índice.
- Confiar no user agent dos seus logs. Conte apenas solicitações verificadas do Googlebot.
- Fazer links internos para URLs redirecionadas ou com parâmetros. Cada link interno é uma solicitação de rastreamento que você escolhe gastar.
Guia de decisão
| Sua situação | O que fazer |
|---|---|
| Páginas novas são rastreadas no dia em que entram no ar | Manter o sitemap atualizado; nada mais |
| Muitas URLs em "Detectada, mas não indexada no momento" | Verificar status do host e tempos de resposta; cortar URLs inúteis |
| Muitas URLs em "Rastreada, mas ainda não indexada" | Melhorar, mesclar ou remover páginas fracas |
| Estatísticas de rastreamento cheias de URLs com parâmetros | Bloquear esses padrões no robots.txt |
| Muitas respostas 3xx nas Estatísticas de rastreamento | Linkar direto para as URLs finais |
| A inspeção de URL mostra "Carga do host excedida" | Aumentar a capacidade do servidor |
| Solicitações de "Googlebot" vindas de IPs desconhecidos | Verificar por DNS ou intervalos de IP; bloquear impostores |
| O Googlebot está sobrecarregando o servidor agora | Retornar 503 ou 429 por horas, não por dias |
Perguntas frequentes
Como verifico meu orçamento de rastreamento no Google Search Console?
Abra Configurações > Estatísticas de rastreamento em uma propriedade no nível raiz e acesse o relatório. Não há um número de orçamento, mas o relatório mostra o total de solicitações de rastreamento, o tamanho do download, o tempo médio de resposta e o status do host. Compare as solicitações de rastreamento diárias com o número de URLs que você quer ver rastreadas.
O orçamento de rastreamento afeta o ranking?
Não diretamente. O Google escreveu em 2017 que uma taxa de rastreamento maior não leva necessariamente a posições melhores e que o rastreamento não é um sinal de ranking. Indiretamente, importa: uma página que nunca é rastreada não pode ranquear.
O orçamento de rastreamento é um problema para sites pequenos?
Geralmente não. O guia do Google é voltado a sites com cerca de um milhão de páginas, ou com mais de 10.000 páginas que mudam todos os dias. Em um site pequeno, uma página não indexada quase sempre tem a ver com qualidade, duplicação ou links internos.
Como posso aumentar meu orçamento de rastreamento?
Trabalhe nos dois lados. A capacidade cresce quando o servidor responde rápido e sem erros. A demanda cresce quando o Google encontra menos URLs inúteis e mais páginas que valem a pena buscar; por isso, bloqueie espaços de parâmetros, mescle duplicatas e faça links internos para as páginas importantes.
Onde encontro os intervalos de IP do Googlebot?
O Google os publica como arquivos JSON com link na página de verificação de crawlers; common-crawlers.json cobre o Googlebot. Os intervalos mudam, então recarregue o arquivo regularmente em vez de copiar os endereços uma única vez para uma regra de firewall.
Arquivos CSS, JavaScript e imagens consomem orçamento de rastreamento?
Sim. Toda URL que o Googlebot busca conta, incluindo as folhas de estilo, os scripts, as imagens e as respostas de API de que uma página precisa para ser renderizada. O detalhamento por tipo de arquivo nas Estatísticas de rastreamento mostra essa parcela no seu site.
Em resumo
O orçamento de rastreamento é o conjunto de URLs que o Googlebot pode e quer rastrear em um nome de host: o limite de capacidade acompanha a saúde do seu servidor, e a demanda acompanha quantas URLs o Google conhece, quão populares elas são e com que frequência mudam. Ele importa para sites muito grandes ou que mudam rápido. Mantenha URLs inúteis longe da vista do Google, responda rápido e corretamente, e trate "Detectada" e "Rastreada, mas ainda não indexada" como problemas diferentes. Para ver como suas páginas aparecem a partir de outros países durante uma auditoria, conheça nossa solução de proxy para SEO.