Um analista quer saber se os preços pedidos nos distritos centrais de uma cidade começaram a cair antes de o índice oficial dizer isso. O índice chega todo mês, com atraso e para a cidade inteira; os portais de imóveis mudam todos os dias, à medida que apartamentos recebem reduções de preço, somem e voltam em anúncios novos. Essa distância entre números oficiais lentos e anúncios públicos rápidos é o motivo pelo qual as empresas coletam dados imobiliários da web.
Este artigo explica o que são esses dados, quais campos e sinais importam, quem os usa e de onde eles devem vir; depois, o pipeline, as armadilhas de qualidade, os limites legais e onde entram os proxies e as APIs de scraping gerenciadas. Sem código e sem receitas para portais específicos.
O que é scraping de dados imobiliários?
Scraping de dados imobiliários é a coleta automatizada e repetida de anúncios de imóveis visíveis publicamente e sua transformação em uma única tabela limpa de registros. Uma página de anúncio é escrita para o comprador; um conjunto de dados precisa da mesma informação como campos tipados com unidades, então o trabalho é menos baixar páginas e mais transformar texto em números comparáveis e acompanhar o mesmo imóvel ao longo do tempo.
Quais campos do anúncio e quais sinais derivados importam?
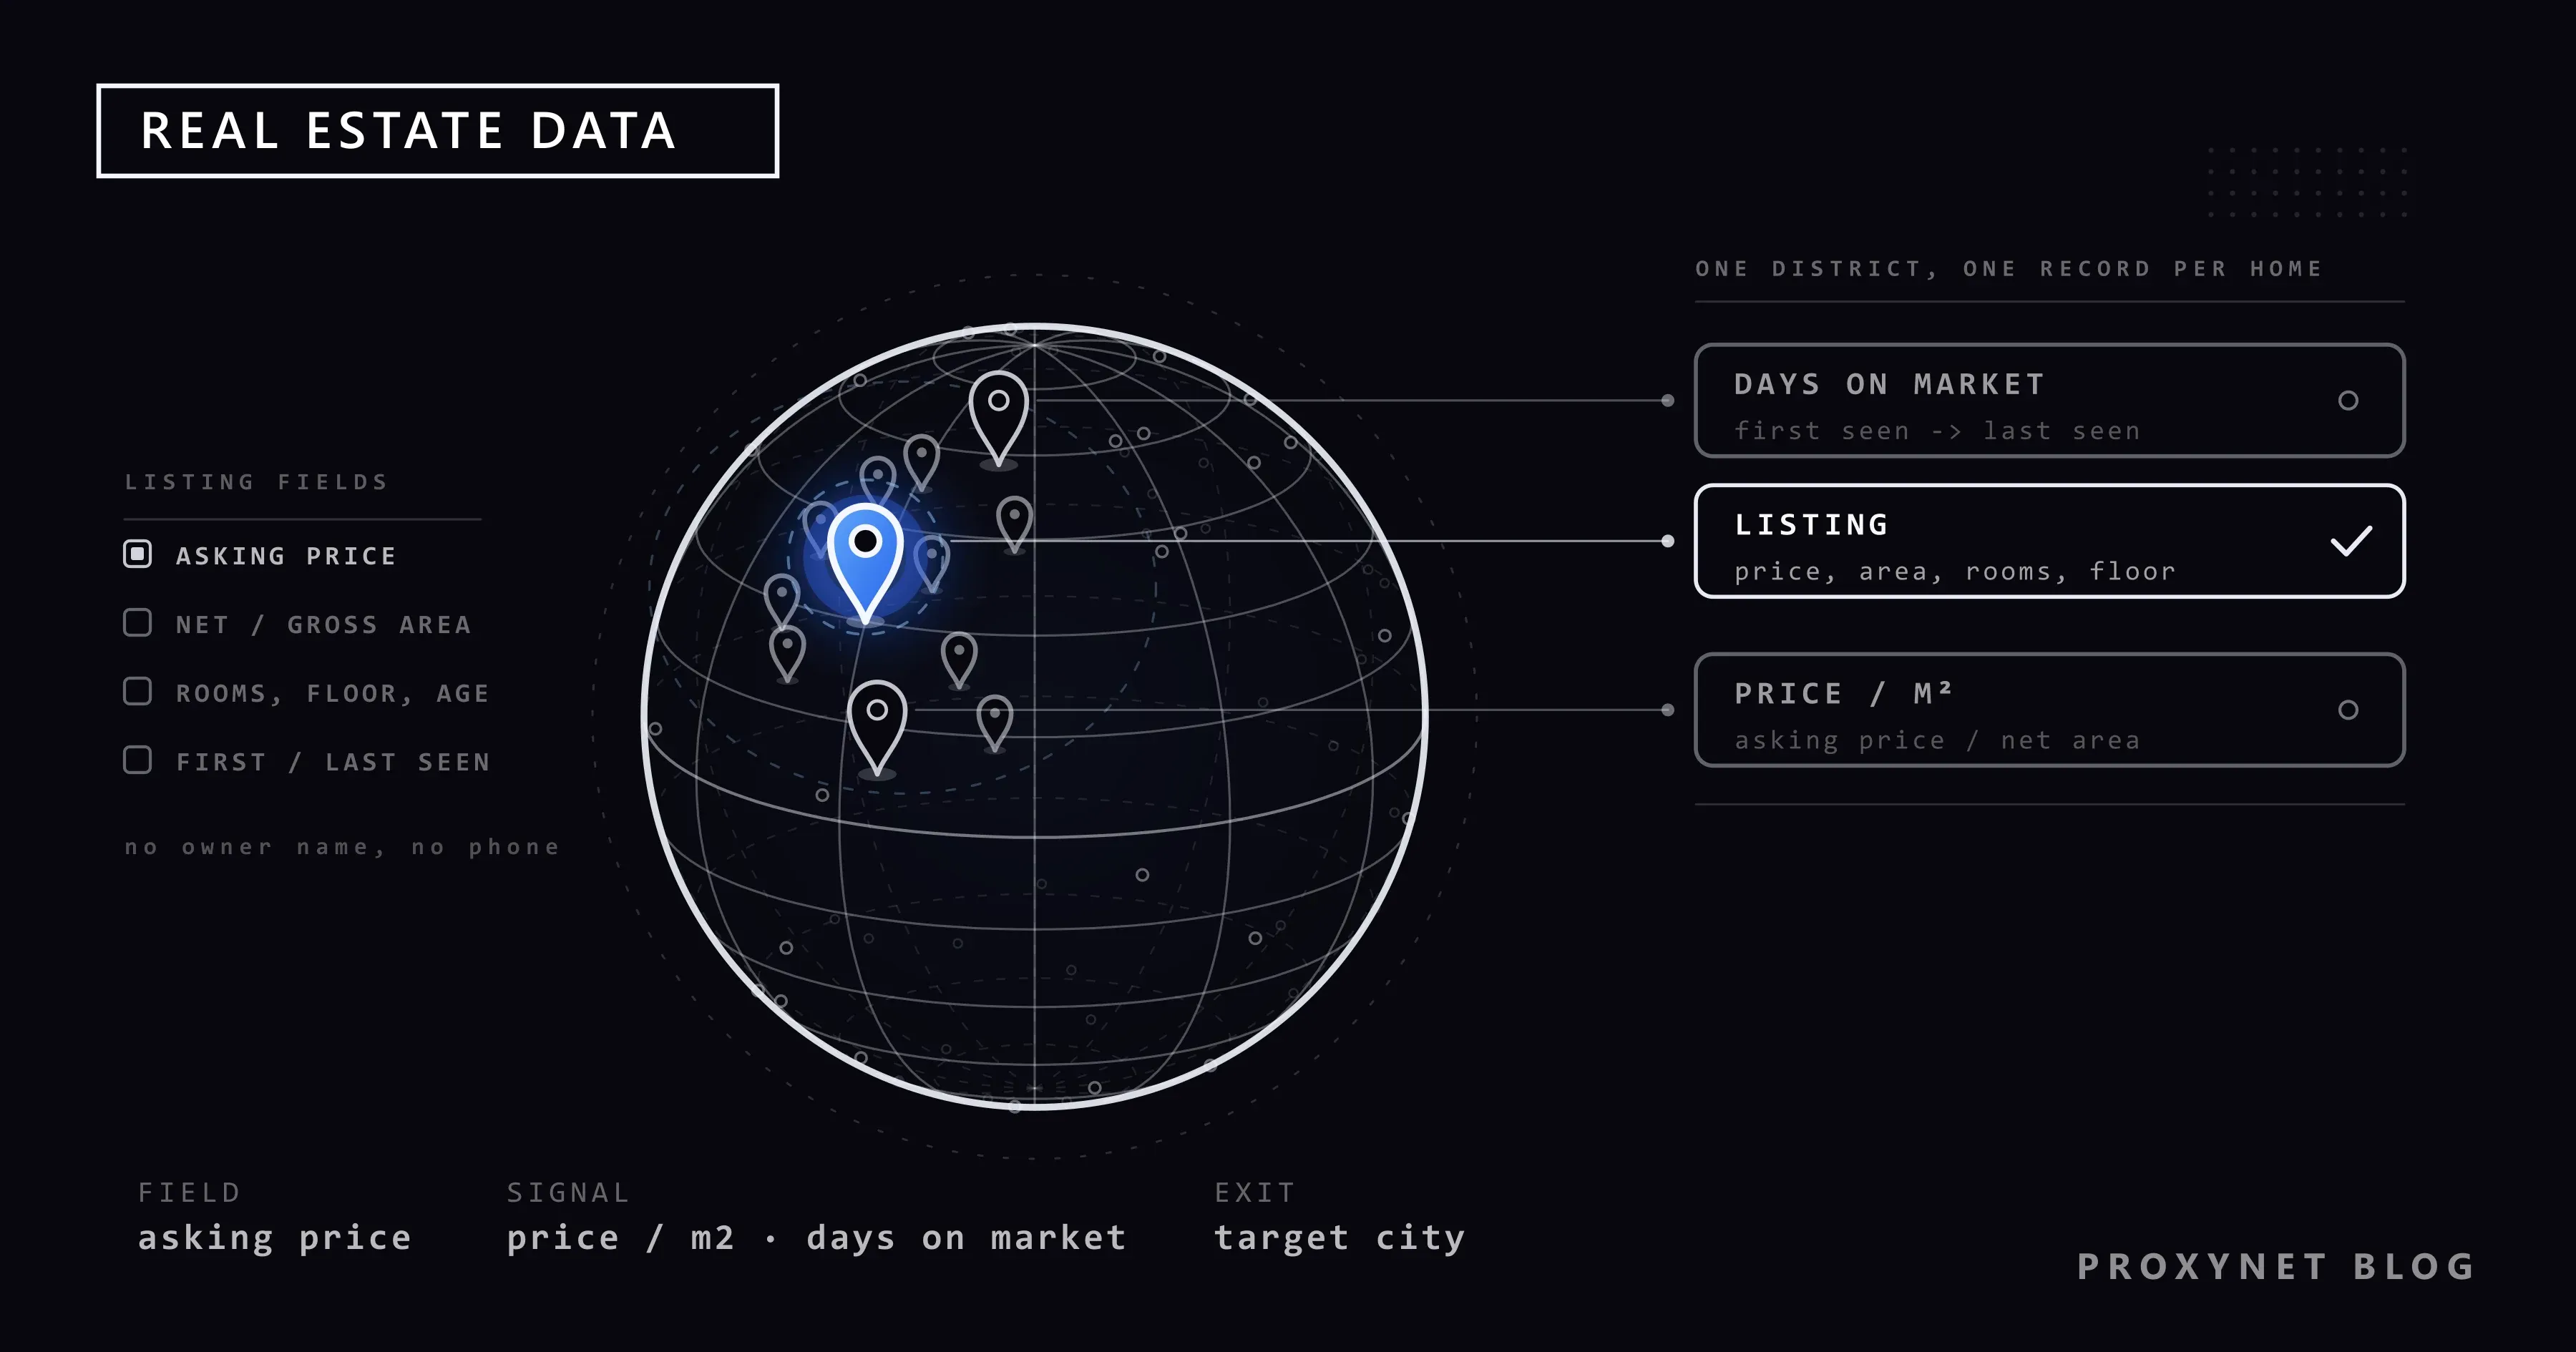
Os campos úteis são os que tornam um imóvel comparável a outro e permitem acompanhá-lo no tempo:
- Preço pedido e moeda, aluguel ou venda.
- Área útil ou total, em metros quadrados ou pés quadrados.
- Quartos na notação local: "2+1" em Türkiye, "3 Zimmer" na Alemanha, bedrooms (dormitórios) nos Estados Unidos.
- Andar, número de andares do prédio e idade do prédio.
- Localização no nível que o portal mostra: cidade, distrito, bairro.
- Data do anúncio, tipo de anunciante (proprietário, imobiliária, construtora) e número de fotos.
A partir deles, um modelo deriva o que a página nunca diz: o preço por metro quadrado; os dias no mercado, do primeiro ao último dia em que você viu o anúncio; as reduções de preço, a partir do histórico de preços pedidos que você registrou; a retirada, que pode significar vendido, alugado ou desistência, sem que a página diga qual; e a republicação, o mesmo imóvel com um ID novo, muitas vezes para zerar sua idade.
Um registro normalizado (valores fictícios):
{
  "listing_id": "example.com:48213977",
  "first_seen": "2026-10-02",
  "last_seen": "2026-11-09",
  "asking_price": 4250000,
  "currency": "TRY",
  "area_net_m2": 95,
  "area_gross_m2": 118,
  "price_per_m2_net": 44737,
  "rooms": "2+1",
  "floor": 3,
  "building_age_years": 12,
  "district": "Bornova",
  "seller_type": "agency",
  "photo_count": 14,
  "price_history": [
    { "date": "2026-10-02", "price": 4450000 },
    { "date": "2026-10-24", "price": 4250000 }
  ],
  "days_on_market": 38,
  "duplicate_group": "dg_7f3a"
}
Ele não traz nome, telefone nem e-mail do proprietário, e isso é proposital; a seção legal explica por quê.
Quem usa dados imobiliários e para quê?
Investidores e fundos leem os dados de anúncios como indicador antecedente: estoque, reduções de preço e dias no mercado se movem semanas antes de um índice de transações. Para eles, é mais um tipo de dado alternativo, com a mesma exigência de histórico limpo e origem documentada.
Empresas de proptech alimentam modelos de avaliação automatizada com os registros, bancos conferem garantias de financiamento imobiliário contra eles, imobiliárias e construtoras precificam novos imóveis pelo distrito, e pesquisadores e prefeituras estudam aluguéis, oferta e a transformação dos bairros.
De onde os dados imobiliários devem vir?
Primeiro as estatísticas oficiais, depois os feeds licenciados e, por último, as páginas públicas de anúncios. A ordem segue a confiabilidade e a clareza jurídica, e conjuntos de dados sérios combinam os três.
Estatísticas oficiais. Para Türkiye, o Banco Central da República de Türkiye publica o Konut Fiyat Endeksi (índice de preços de imóveis residenciais) como série temporal mensal, e o Instituto de Estatística de Türkiye (TurkStat) publica um boletim mensal de vendas de residências e imóveis comerciais com contagens de primeira e segunda mão por província. São esses os números contra os quais um modelo é testado.
Para a UE, o índice de preços de imóveis residenciais da Eurostat acompanha a cada trimestre os preços de transação das moradias compradas por famílias, novas e usadas, ao lado de um indicador de vendas de imóveis. Construído a partir de transações reais, ele mostra por quanto os imóveis foram vendidos, não o que os vendedores pediam.
Para os Estados Unidos, o FHFA House Price Index é um índice de vendas repetidas construído a partir de transações hipotecárias de casas unifamiliares compradas ou securitizadas pela Fannie Mae ou pela Freddie Mac, publicado mensal e trimestralmente até o nível de CEP (ZIP code).
Feeds e APIs licenciados. Nos Estados Unidos, os anúncios ficam em serviços de listagem múltipla (MLS) e chegam a usuários licenciados pela RESO Web API, um padrão da Real Estate Standards Organization; cada MLS local concede acesso sob sua própria licença de dados. Alguns portais mantêm programas de dados ou publicam séries agregadas. O caminho licenciado entrega registros estruturados com mudanças de status.
Páginas públicas de anúncios. A camada do scraping tem dois portões: os termos de uso do portal e o robots.txt. A maioria dos grandes portais proíbe o acesso automatizado em seus termos, então essa camada é para os casos em que há permissão ou os termos permitem. É também a única camada com preços pedidos e detalhe no nível do anúncio em todos os portais ao mesmo tempo.
| Fonte | O que você obtém | Atualização | Restrição |
|---|---|---|---|
| Estatísticas oficiais | Índices de preços, contagens de vendas por região | Mensal ou trimestral, com atraso | Só agregados, sem anúncios individuais |
| Feeds licenciados (MLS, programas de portais) | Anúncios estruturados com mudanças de status | Quase em tempo real | Licença, taxas, restrições de uso |
| Páginas públicas de anúncios | Preços pedidos, atributos, datas, número de fotos | Com a frequência que você coletar | Termos de uso, robots.txt, dados pessoais, mudanças de layout |
| API de scraping gerenciada | Registros normalizados entregues a você | No seu cronograma | Termos do fornecedor; o compliance continua seu |
Como funciona um pipeline de dados imobiliários?
Sete etapas, e a primeira é a que a maioria das equipes pula:
- Defina o esquema. Cada campo, tipo e unidade antes de coletar qualquer coisa. O registro acima é um esquema; uma pasta de arquivos HTML não é.
- Escolha a geografia. Uma cidade, um conjunto de distritos ou um país; isso decide quais páginas de resultados você precisa.
- Colete com um cronograma. Diariamente em mercados de venda ativos, semanalmente nos lentos. Cada execução registra o que viu e quando; dias no mercado e histórico de preços vêm desses carimbos de tempo.
- Normalize. Pés quadrados para metros quadrados, área útil e total em campos separados, moeda guardada junto com o preço, notação de quartos convertida em número.
- Deduplique. O mesmo apartamento aparece por duas imobiliárias, em três portais ou com um ID novo. Cruze localização, área, andar, idade e número de fotos e agrupe as correspondências para que cada imóvel conte uma vez.
- Derive os sinais. Reduções de preço a partir do histórico, dias no mercado a partir da primeira e da última vez em que foi visto, retirada depois de um número definido de execuções sem aparecer, republicação quando um imóvel agrupado reaparece.
- Controle a qualidade. Contagem de linhas por execução, proporção de campos vazios, distribuição do preço por metro quadrado. Uma queda repentina de linhas costuma significar mudança de layout, não colapso do mercado.
Quais armadilhas de qualidade distorcem os dados de imóveis?
Preços pedidos não são preços de transação: vendedores ancoram alto, compradores negociam e a diferença varia conforme o mercado e a estação. As outras armadilhas são mecânicas:
- Republicar para zerar a idade. Sem agrupamento de duplicatas, os dias no mercado saem curtos demais.
- Preços de preenchimento. Um preço de 1, 0 ou um número redondo muito distante do mercado significa "consulte"; filtre pelo preço por metro quadrado.
- Duplicatas entre portais e imobiliárias, que inflam o estoque e enviesam as médias.
- Aluguéis mobiliados e não mobiliados misturados, o que desloca o aluguel por metro quadrado de um distrito.
- Unidades misturadas: área útil versus total, pés quadrados versus metros, preços com ou sem taxas e impostos.
- Retirada lida como venda, quando pode ser um aluguel, uma desistência ou a troca para outra imobiliária.
Scraping de dados imobiliários é legal?
Coletar dados públicos de anúncios não é ilegal por si só, mas três regras valem para todo projeto: dados pessoais, os termos de uso do portal e os direitos sobre bases de dados.
Dados pessoais. Nome, telefone e e-mail do proprietário em um anúncio são dados pessoais segundo o GDPR e a KVKK de Türkiye; publicá-los em um portal não elimina a necessidade de uma base legal. Nunca colete esses campos; nosso guia sobre dados pessoais em conjuntos de dados de scraping mostra como filtrá-los no momento da coleta.
Termos de uso. A maioria dos grandes portais proíbe o acesso automatizado em seus termos, muitas vezes ao lado de uma proibição de reproduzir as informações dos anúncios em outro lugar; até que ponto esses termos vinculam um visitante que nunca se cadastrou varia de país para país.
Direitos sobre bases de dados. Na UE, a Diretiva 96/9/CE dá ao fabricante de uma base de dados que demonstre um investimento substancial na obtenção, verificação ou apresentação do conteúdo o direito de impedir a extração ou reutilização da totalidade ou de uma parte substancial dela por quinze anos, e proíbe a extração repetida e sistemática de partes não substanciais que contrarie a exploração normal da base. A coleta diária de uma grande parcela dos anúncios de um portal é exatamente o ato para o qual esse direito foi escrito. Fora da UE, as regras são diferentes.
Onde um proxy entra na coleta de dados imobiliários?
Alguns portais adaptam a página à localização do visitante: região padrão, moeda, idioma e, às vezes, quais anúncios aparecem primeiro, então um coletor em uma região de nuvem no exterior pode registrar uma página diferente da que um comprador local vê. Os Proxies residenciais permitem escolher o país e a cidade de onde a requisição sai, para que a página registrada corresponda ao mercado que você mede.
Percorrer as páginas de uma lista de resultados é uma sequência de requisições cuja ordenação, filtros e número de página um portal pode vincular ao visitante. Com os Proxies de sessão fixa, a sessão mantém o mesmo endereço de saída por um número definido de minutos, de modo que uma varredura de um distrito roda a partir de uma única identidade consistente.
Um proxy muda de onde a requisição vem e nada mais: termos, robots.txt e limites de requisições valem para todo endereço, e uma página de verificação é uma resposta a respeitar, não um obstáculo a contornar.
Quando uma API de scraping gerenciada faz mais sentido?
Quando o trabalho da equipe é o modelo, não o parser. Uma API de scraping gerenciada devolve registros normalizados em vez de páginas, então esquema, conversão de unidades e mudanças de layout ficam do lado do fornecedor e seus analistas começam na etapa cinco. Ela também serve a equipes que precisam de vários países e portais ao mesmo tempo.
As questões de compliance continuam com você: termos, regras de dados pessoais e direitos sobre bases de dados valem para os registros que você recebe. A Proxynet oferece uma Web Scraping API para extração gerenciada de páginas pela equipe de vendas; pergunte a qualquer fornecedor sobre o esquema de campos, o cronograma de atualização e as fontes.
Erros comuns em projetos de dados imobiliários
- Coletar antes de definir o esquema. Páginas salvas não respondem, no próximo trimestre, a uma pergunta sobre preço por metro quadrado.
- Guardar o telefone dos proprietários "por via das dúvidas". Acrescenta risco e nenhum sinal.
- Coletar em um ritmo que o portal perceberia. Retratos diários em ritmo moderado bastam.
- Armazenar só o preço atual. Sem histórico, as reduções de preço ficam invisíveis.
Guia de decisão
| Necessidade | Caminho |
|---|---|
| Tendência mensal de preços de um país ou região | Estatísticas oficiais: TCMB, Eurostat, FHFA ou o equivalente nacional |
| Preços no nível da transação para avaliação | Feeds licenciados ou os registros públicos de transações de um país |
| Preços pedidos de uma cidade nesta semana | Páginas do portal, depois de checar termos e robots.txt, em ritmo baixo |
| Anúncios de muitos países e portais | API de scraping gerenciada que devolve registros normalizados |
| Scraper próprio, páginas diferentes conforme a localização do visitante | Saídas residenciais na cidade-alvo, uma sessão fixa por varredura |
| Qualquer conjunto de dados com nomes ou telefones de proprietários | Descarte os campos na coleta; são dados pessoais |
Perguntas frequentes
É legal fazer scraping de portais de imóveis?
Depende dos termos do portal, dos campos que você coleta e do país. A maioria dos grandes portais proíbe o acesso automatizado em seus termos; dados sobre um imóvel não são dados pessoais, mas os dados de contato do proprietário são; e, na UE, um portal pode invocar os direitos sobre bases de dados contra a extração de uma parte substancial de seus anúncios. As estatísticas oficiais cobrem as tendências de preços sem nenhum scraping.
Fazer scraping do Zillow é legal?
Os termos de uso do Zillow, atualizados em 28 de outubro de 2025, listam entre as coisas que os usuários concordam em não fazer qualquer consulta automatizada, incluindo scraping de tela e de banco de dados, spiders, robôs e crawlers, além de contornar CAPTCHA ou precauções semelhantes; e proíbem separadamente reproduzir as informações dos anúncios em outros sites, exceto onde explicitamente permitido. Para tendências de preços nos Estados Unidos, o índice FHFA e os feeds MLS licenciados não levantam nenhuma dessas questões.
Qual é a diferença entre preço pedido e preço de venda?
O preço pedido é o que o vendedor publica; o preço de venda é o que o comprador paga, geralmente menor depois da negociação. Dados de portais só contêm preços pedidos, então medem as expectativas dos vendedores e como elas mudam. Os índices de transações dos institutos de estatística medem por quanto os imóveis foram de fato vendidos.
Com que frequência os dados imobiliários devem ser atualizados?
Diariamente para anúncios de venda e aluguel em mercados ativos, semanalmente onde os anúncios ficam meses no ar. Dias no mercado e a detecção de reduções de preço dependem do intervalo entre as execuções: um cronograma semanal não enxerga uma redução revertida depois de três dias.
Como detectar anúncios de imóveis duplicados?
Cruze anúncios que compartilham o distrito, uma área dentro de uma tolerância pequena, o andar, a idade do prédio e o número de quartos, depois compare o número de fotos e as primeiras palavras da descrição. As correspondências são agrupadas como um único imóvel. Um ID de anúncio novo que corresponde a um grupo antigo é uma republicação, e seus dias no mercado continuam a contar desde a primeira aparição.
Quais campos de um anúncio importam mais?
Preço pedido com a moeda, área com a unidade e a base útil ou total, número de quartos, andar, idade do prédio, distrito e as datas em que você viu o anúncio pela primeira e pela última vez. Esses oito campos produzem o preço por metro quadrado, os dias no mercado e o histórico de preços. Número de fotos e tipo de anunciante ajudam na deduplicação.
Em resumo
O scraping de dados imobiliários transforma anúncios públicos em uma tabela normalizada e com carimbo de tempo, da qual se derivam preço por metro quadrado, dias no mercado, reduções de preço e republicações. As estatísticas oficiais vêm primeiro e continuam sendo a referência, os feeds licenciados em seguida e as páginas de anúncios por último, atrás dos termos do portal, do robots.txt e da regra de nunca coletar os dados de contato dos proprietários. Se a sua equipe está dimensionando um mercado dessa forma, nossa página de pesquisa de mercado mostra como o lado da coleta é montado.