Uma analista de RH precisa responder se a empresa paga seus engenheiros de dados em linha com o mercado. A pesquisa salarial que ela tem é de um ano atrás e dilui o cargo em uma família ampla de funções; os sites de vagas, por outro lado, trazem centenas de faixas anunciadas para exatamente esse título, publicadas neste mês. Quais concorrentes contratam as mesmas habilidades se responde no mesmo lugar: nas vagas de emprego espalhadas por páginas de carreiras, sites de vagas e agregadores.
Este artigo explica o que são dados de vagas de emprego, quem os constrói ou compra e de onde eles vêm, em ordem das estatísticas oficiais e dos endpoints públicos de páginas de carreiras até as páginas de sites de vagas obtidas por scraping; depois trata da normalização, das armadilhas de qualidade, do quadro legal, de onde entram os proxies e de seis respostas curtas.
O que são dados de vagas de emprego?
Dados de vagas de emprego são o conteúdo dos anúncios de emprego online capturado como campos estruturados. Um anúncio é escrito para o candidato; o conjunto de dados o reescreve para uma consulta, de modo que "engenheiro de dados sênior, Berlim, híbrido" vira uma linha que pode ser contada, comparada e acompanhada.
Os campos principais são os mesmos, seja qual for a fonte:
- Título como está escrito, mais uma ocupação normalizada
- Empregador: nome, e se quem publica é o empregador ou uma agência
- Local: cidade, país e um marcador de remoto ou híbrido
- Salário: mínimo, máximo, moeda e período, quando divulgado
- Senioridade e tipo de contrato
- Habilidades e requisitos extraídos da descrição
- Datas: primeira vez visto, última vez visto, encerramento ou remoção
- Fonte: site de vagas ou página de carreiras, e uma URL estável
Dois campos concentram a maior parte do valor e são os mais difíceis de acertar: as datas, que transformam uma pilha de anúncios em uma série temporal, e o título normalizado, que conta "Growth Hacker" e "Digital Marketing Specialist" como uma única ocupação.
Quem usa dados de vagas de emprego, e para quê?
Quatro grupos constroem ou compram esses dados, cada um com uma pergunta diferente.
Equipes de remuneração e RH comparam salários. Onde os empregadores publicam faixas, os salários anunciados dão uma leitura atual do mercado por título, cidade e senioridade e mostram quais habilidades os concorrentes pedem.
Pesquisadores do mercado de trabalho leem os anúncios como indicador de demanda. O Hiring Lab, braço de pesquisa do site de vagas Indeed, publica análises construídas sobre os próprios anúncios do Indeed; a Lightcast vende inteligência de mercado de trabalho construída sobre um arquivo de anúncios muito grande.
Equipes de estratégia e vendas tratam a contratação como sinal de roadmap. Um concorrente que abre vinte vagas mencionando uma nova plataforma de nuvem, um novo mercado ou um novo idioma anuncia um plano sem comunicado à imprensa, e uma equipe de vendas lê o mesmo sinal para encontrar empresas que contratam em uma função para a qual ela vende.
Recrutadores, agregadores e investidores. Agregadores coletam anúncios para listá-los, empresas de recrutamento observam onde as vagas se abrem, e analistas de investimento contam os volumes de contratação como um dos tipos de dados alternativos vindos da web.
De onde vêm os dados de vagas de emprego?
As fontes se ordenam por confiabilidade e permissão, o inverso de como a maioria das equipes começa.
1. Estatísticas oficiais de vagas. Os institutos nacionais de estatística medem a demanda por trabalho diretamente. Nos Estados Unidos, a pesquisa JOLTS do Bureau of Labor Statistics produz estimativas mensais de vagas abertas, contratações e desligamentos; a divulgação de 3 de novembro de 2026 apontou 7,5 milhões de vagas abertas em setembro. As estatísticas de vagas do Eurostat informam a cada trimestre a proporção de postos vagos (2,1% na zona do euro no segundo trimestre de 2026). Na Türkiye, o TurkStat publica estatísticas mensais da força de trabalho, e o boletim mensal do ISKUR, a agência pública de emprego, conta as vagas que os empregadores registram nela, por ocupação e setor. São gratuitas e citáveis, mas agregadas: sem títulos, habilidades ou empregadores.
2. Páginas de carreiras dos empregadores via ATS. Muitas empresas hospedam a página de carreiras em um sistema de rastreamento de candidatos (ATS), que publica as vagas como JSON público. O Greenhouse documenta uma Job Board API cujos endpoints GET não exigem autenticação: https://boards-api.greenhouse.io/v1/boards/{board_token}/jobs?content=true retorna todas as vagas abertas com título, local, updated_at, descrição, departamentos e escritórios, e pay_transparency=true acrescenta as faixas salariais divulgadas.
A Postings API do Lever funciona do mesmo jeito: https://api.lever.co/v0/postings/{site}?mode=json lista as vagas publicadas com categories (local, equipe, regime), workplaceType, descriptionPlain e um salaryRange opcional. Para empregadores conhecidos pelo nome, esses endpoints são a fonte mais limpa que existe.
3. APIs de agregadores. A API da Adzuna, por exemplo, expõe busca de vagas, categorias e histogramas salariais por país atrás de um app_id e um app_key obtidos no cadastro. Os dados de um agregador cobrem muitos empregadores de uma vez, mas herdam a cobertura, a deduplicação e os termos de licença do agregador. O LinkedIn é a exceção sobre a qual mais se pergunta: seu Contrato do Usuário (seção 8.2, "Don'ts", o que não fazer) proíbe fazer scraping ou copiar o serviço, inclusive com crawlers e plugins de navegador, então suas vagas são lidas pela própria busca de vagas, não coletadas.
4. Páginas públicas de sites de vagas. Todo o resto é uma página da web sem feed. Coletá-las é web scraping, limitado pelos termos de uso do site e pelo seu robots.txt; onde os dois permitem, os dados são atuais e detalhados, mas não estruturados, então o trabalho de normalização abaixo fica com você.
Como os dados de vagas de emprego são coletados e normalizados?
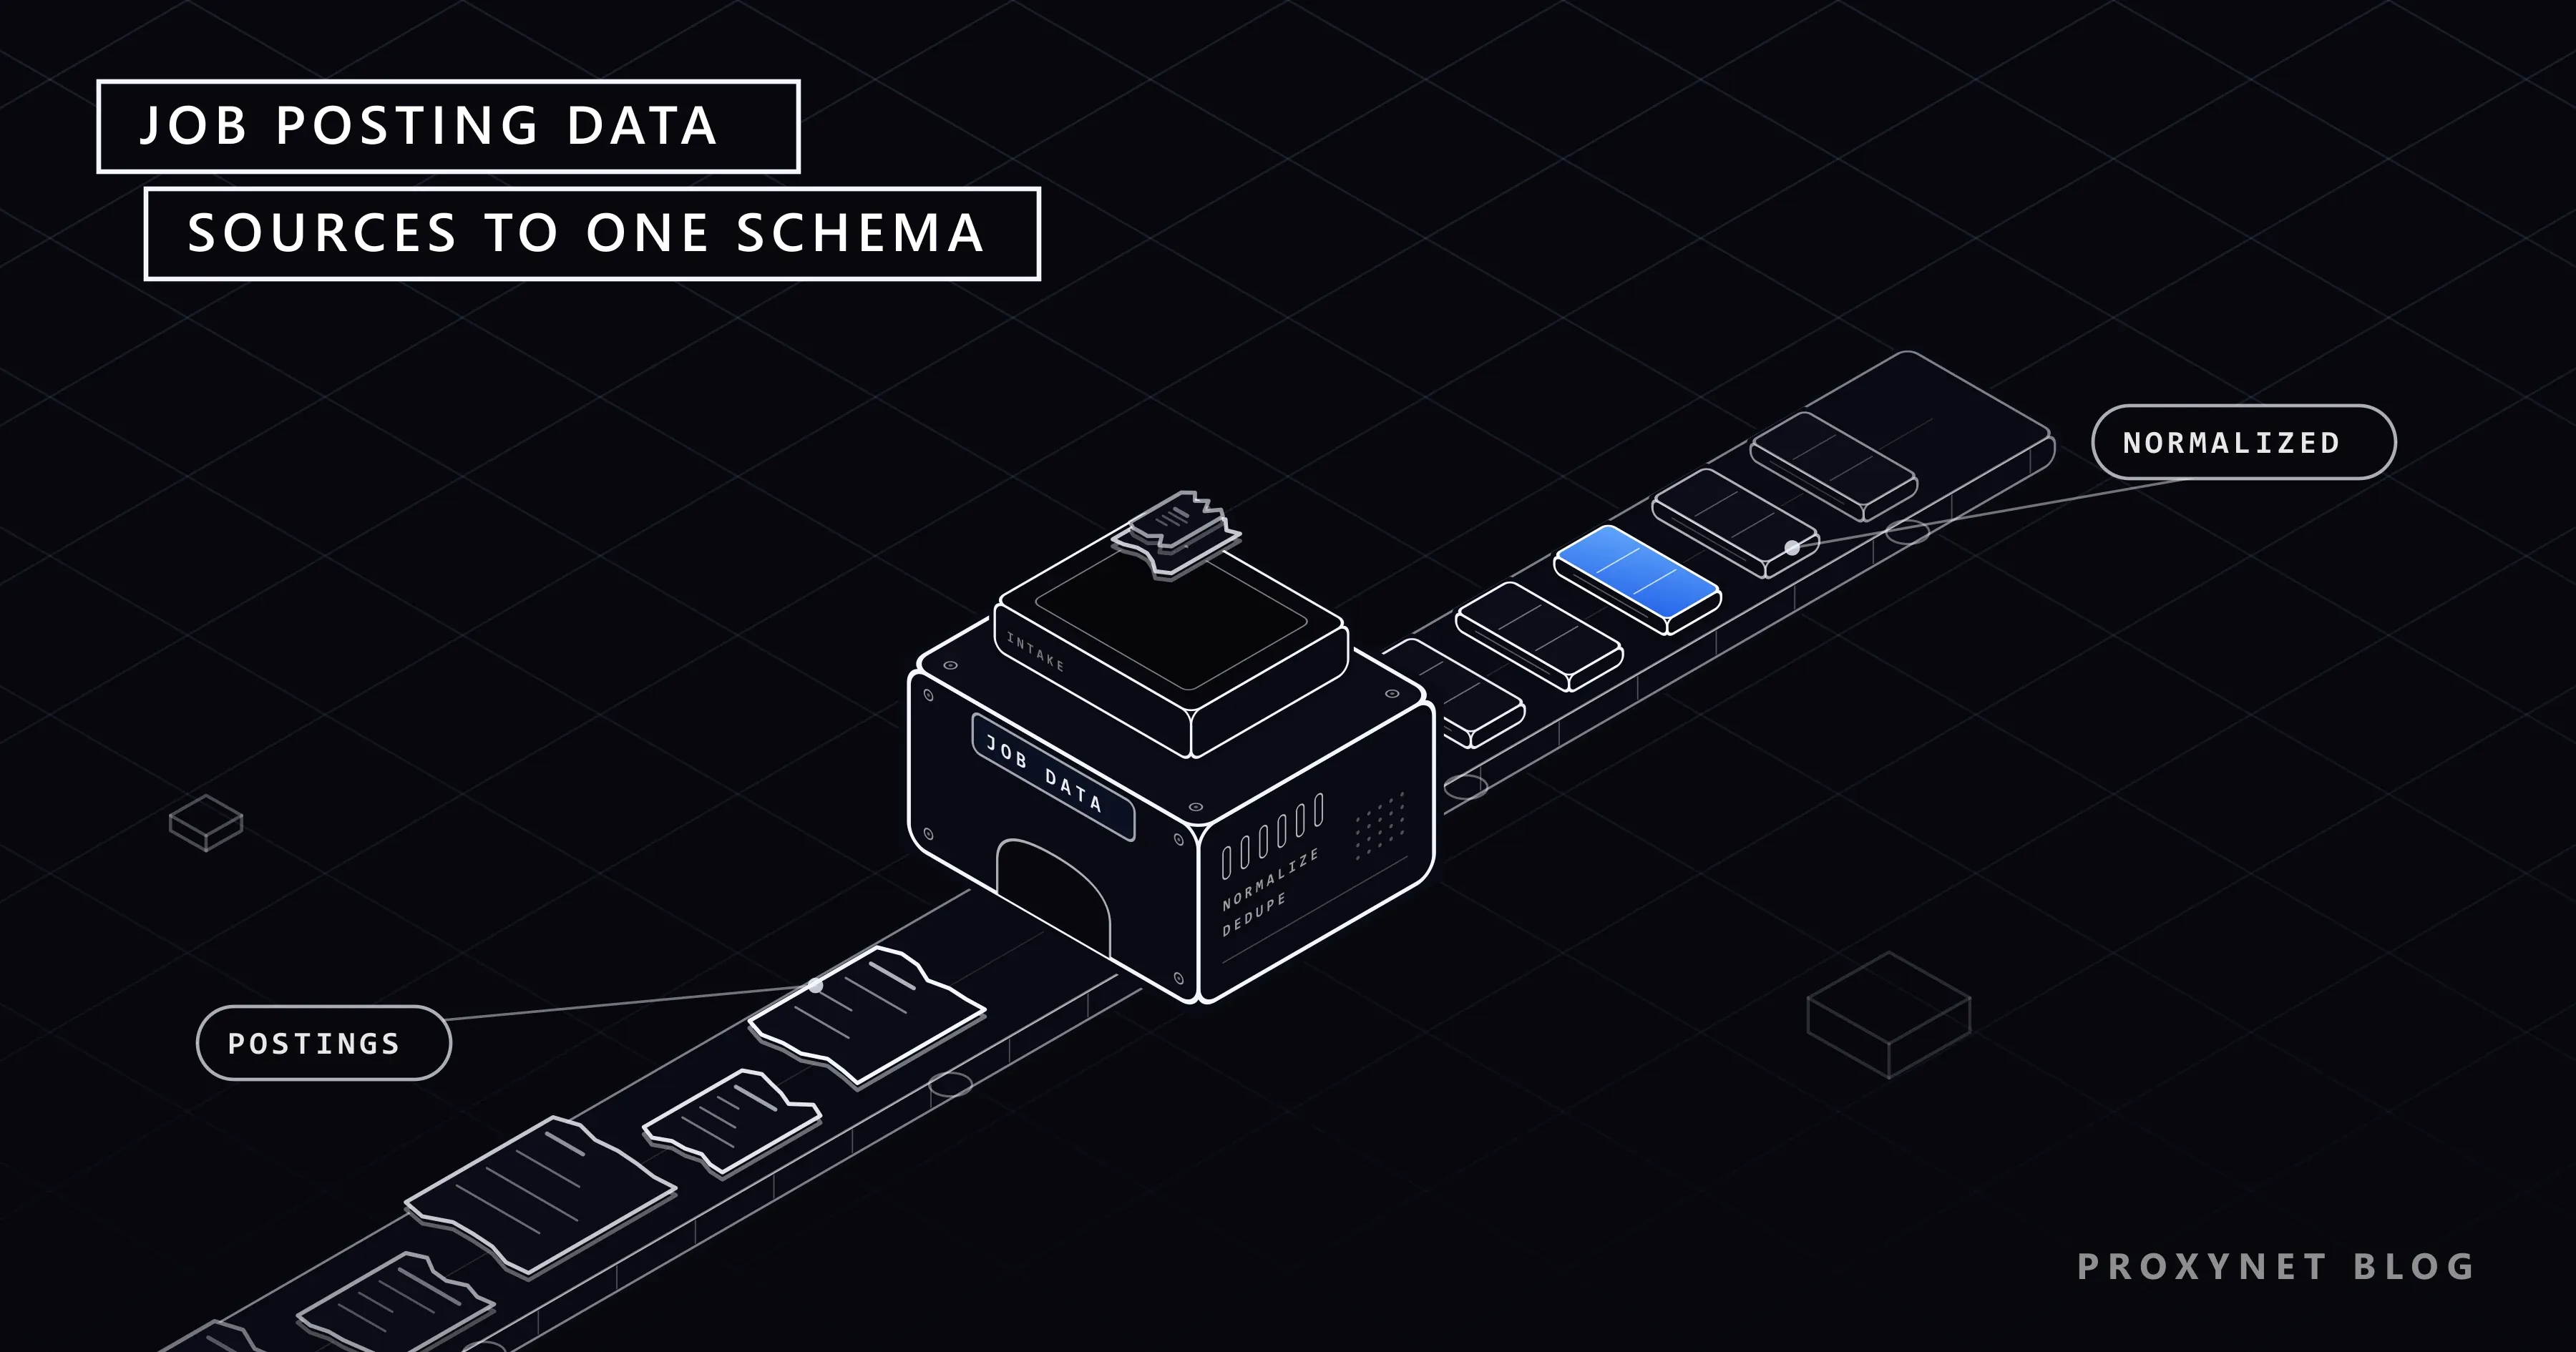
Um pipeline que funciona tem oito etapas; a coleta é a menor delas.
- Defina o esquema primeiro. Fixe os campos e os tipos antes de tocar em uma fonte; acrescente
source,source_url,first_seenelast_seena cada registro. - Liste as fontes e a via de acesso. Série oficial, endpoint de ATS, API licenciada ou página pública; os termos que se aplicam e a frequência de consulta.
- Defina a cadência. Anúncios ficam online por semanas, alguns são renovados, poucos somem em dias; uma passagem diária captura as datas, uma semanal basta para tendências de volume.
- Normalize os títulos para uma classificação de ocupações. Mapeie os títulos em texto livre para a ESCO, a classificação da Comissão Europeia com 3.039 ocupações e 13.939 habilidades em 28 idiomas, gratuita e com API; para a O*NET, base de dados do Departamento do Trabalho dos EUA com mais de 900 ocupações; ou para a ISCO-08 da OIT, com seus dez grandes grupos. Um dicionário de títulos conhecidos resolve a primeira passagem; um classificador de texto, o resto.
- Extraia o salário. Separe mínimo, máximo, moeda e período, converta valores por hora e por mês em uma faixa anual e guarde "não divulgado" como valor, porque a frequência dele é um sinal por si só.
- Deduplique. A mesma vaga aparece na página de carreiras, em dois sites de vagas e em um agregador, muitas vezes com títulos diferentes; cruze por empregador, título normalizado, local e uma impressão digital da descrição, e mantenha um único registro com todas as URLs de origem.
- Derive sinais. Novas vagas por semana por empregador e ocupação, mediana de dias online (um substituto para o tempo de preenchimento), proporção com salário divulgado, frequência de habilidades.
- Faça QA em toda execução. Contagem de linhas por fonte, proporção de registros sem salário ou local, dez registros aleatórios conferidos com a página ao vivo.
Um registro normalizado de um empregador fictício fica assim:
{
  "posting_id": "example-ltd-2026-11-0417",
  "title_raw": "Sr. Data Engineer (Hybrid)",
  "occupation": "Data engineer",
  "employer": "Example Ltd",
  "poster_type": "employer",
  "location": { "city": "Berlin", "country": "DE", "workplace": "hybrid" },
  "salary": { "min": 85000, "max": 100000, "currency": "EUR", "period": "year", "disclosed": true },
  "seniority": "senior",
  "contract": "full-time",
  "skills": ["Spark", "Airflow", "SQL", "Python"],
  "first_seen": "2026-11-02",
  "last_seen": "2026-11-09",
  "closed_at": null,
  "sources": ["https://example.com/careers/417", "https://jobs.example.net/view/88213"]
}
Fontes de dados de vagas comparadas
| Fonte | Cobertura | Atualização | Restrição |
|---|---|---|---|
| Estatísticas oficiais (JOLTS, Eurostat, ISKUR) | Economia inteira, agregada | Mensal ou trimestral | Sem títulos, habilidades ou empregadores |
| Endpoints públicos de ATS (Greenhouse, Lever) | Empregadores conhecidos, todas as vagas abertas | Ao vivo | Um board por empresa; a lista é você que monta |
| APIs de agregadores | Muitos empregadores por país | De horas a dias | Termos de licença, deduplicação do fornecedor |
| Páginas públicas de sites de vagas | Tudo o que é publicado | Na frequência em que você consulta | Termos de uso, robots.txt, trabalho de parsing |
O que dá errado com dados de vagas de emprego?
Anúncios são publicidade, não vagas; a análise falha na lacuna entre os dois.
Vagas fantasma e permanentes. Um resumo de 2025 do Congressional Research Service dos EUA define vagas "fantasma" como anúncios de posições que não existem ou que o empregador não pretende preencher de imediato, observa que nenhuma estatística oficial as mede e alerta que as pesquisas que citam percentuais vêm em grande parte de empresas que vendem ferramentas de recrutamento. Nos dados, elas aparecem como anúncios abertos por meses, que reaparecem em ciclo fixo ou que são publicados em todo lugar ao mesmo tempo.
Republicações e duplicatas de agências. Os sites zeram a data quando o empregador renova um anúncio, então "publicado há 2 dias" pode ser uma vaga de três meses; agências publicam a mesma vaga do cliente em nome próprio, às vezes várias ao mesmo tempo. Mantenha o seu próprio first_seen, marque os anunciantes que são agências e conte cada vaga uma vez.
Salário ausente. Muitos anúncios não divulgam salário, e os que divulgam não são uma amostra aleatória. Informe a taxa de divulgação ao lado de cada estatística salarial.
Inflação e deriva de títulos. O mesmo trabalho é anunciado como engenheiro, desenvolvedor, arquiteto ou consultor conforme o mercado e o ano; sem uma classificação, uma empresa que renomeou seus desenvolvedores parece uma que parou de contratá-los.
Coletar dados de vagas de emprego é legal?
Três camadas se aplicam: dados pessoais, termos de uso e a lei do país em que você opera. Nada disto é aconselhamento jurídico.
Dados pessoais. Um anúncio é sobre uma vaga, mas muitas vezes traz o nome, o e-mail ou o telefone de um recrutador. Esses são dados pessoais, e tanto o GDPR (artigo 6) quanto a LGPD no Brasil e a KVKK da Türkiye só permitem o tratamento com uma base legal; um conjunto de dados de mercado de trabalho não precisa deles, então nunca os colete e remova-os das descrições já na ingestão. Como tratar dados pessoais (PII) em dados de scraping mostra como mascarar o que escapa.
Termos de uso. Muitos sites de vagas proíbem o acesso automatizado em seus termos, o LinkedIn de forma explícita. A decisão hiQ Labs contra LinkedIn (Tribunal de Apelações do Nono Circuito dos EUA, 2022) concluiu que o conceito de acesso "sem autorização" da Computer Fraud and Abuse Act não se aplica a sites públicos; ela tratava de uma lei penal dos EUA, não dos termos de um site, que continuam sendo uma questão à parte.
Lei local. Direitos sobre bases de dados, regras de concorrência desleal e a legislação sobre anúncios de emprego variam de país para país. Antes de lançar um produto de dados de vagas, peça a um advogado que revise as fontes e os termos que se aplicam a cada uma.
Onde entra um proxy na coleta de dados de vagas?
Um proxy decide de qual endereço de rede uma requisição sai; nos dados de vagas, duas situações tornam isso importante.
Primeiro, os sites se localizam: muitos mostram por padrão o país do visitante, e alguns mudam moeda, idioma ou exibição do salário conforme o local. Para registrar o que um candidato vê em cada mercado, a requisição precisa sair daquele mercado; os endereços de Proxies residenciais permitem escolher país e cidade a cada requisição, de modo que uma série da Alemanha não se mistura com uma da Türkiye.
Segundo, o volume é bem espalhado: mil páginas de carreiras significam mil trabalhos pequenos e educados, não um pesado. Endpoints JSON estáticos, como os feeds de ATS acima, combinam com os endereços de Proxies de datacenter, com tráfego sem cota; sites que variam conforme o país do visitante ficam em endereços residenciais. Um proxy não muda quais fontes você pode ler, com que frequência um site permite consultas nem o que dizem os termos dele.
Se você prefere receber linhas normalizadas em vez de operar o pipeline, um serviço de extração gerenciado faz o parsing e a deduplicação por você.
Erros comuns com dados de vagas de emprego
- Contar anúncios como contratações ou vagas; calibre os volumes com as séries oficiais.
- Começar pelo scraping quando endpoints de ATS e APIs licenciadas cobrem os mesmos empregadores.
- Confiar na data de publicação do site em vez dos seus próprios
first_seenelast_seen. - Pular a deduplicação, de modo que uma vaga conta três vezes.
- Guardar só os títulos brutos, de modo que as tendências somem nas renomeações.
- Coletar os contatos dos recrutadores porque estavam na página.
Guia de decisão
| Necessidade | Caminho |
|---|---|
| Demanda por trabalho em um país ou setor | Estatísticas oficiais (JOLTS, Eurostat, ISKUR) |
| Planos de contratação de cinquenta concorrentes conhecidos | Os endpoints de ATS deles, consultados diariamente |
| Faixas salariais por título e cidade | API de agregador licenciada mais os campos salariais do ATS |
| Um site de vagas como os candidatos o veem em cada país | Proxies residenciais por país, dentro dos termos do site |
| Milhares de páginas de carreiras pequenas sem feed | Proxies de datacenter em ritmo educado, ou um feed gerenciado |
| Linhas hoje, sem equipe de pipeline | Extração gerenciada com esquema normalizado |
Perguntas frequentes
Fazer scraping de vagas é legal?
Coletar vagas de emprego públicas não é ilegal em si na maioria dos países, mas um projeto passa a ser quando trata dados pessoais sem base legal, viola os termos de uso de um site ou ignora regras locais como os direitos sobre bases de dados. Estatísticas oficiais e endpoints públicos de ATS não carregam nenhum desses riscos.
Onde consigo dados de vagas de emprego de graça?
Nas estatísticas oficiais (BLS JOLTS, estatísticas de vagas do Eurostat, boletim mensal do ISKUR) para os agregados, e nos endpoints públicos de ATS dos empregadores, como a Job Board API do Greenhouse e a Postings API do Lever, para anúncios individuais; nenhum deles exige chave de API. Conjuntos de dados gratuitos em plataformas de ciência de dados são retratos de um momento: bons para praticar, não para uma série temporal.
Como detectar vagas fantasma?
Pelo comportamento ao longo do tempo, não pelo texto: um anúncio aberto por meses, o mesmo anúncio recriado em ciclo fixo, uma vaga anunciada em todos os locais ao mesmo tempo e empregadores cuja contagem de anúncios nunca se move enquanto o quadro de pessoal muda. Nenhum deles é prova sozinho; combine-os em uma pontuação e informe-a ao lado das contagens.
Com que frequência as vagas de emprego mudam?
Diariamente, se você conta anúncios individuais: novos aparecem todo dia e outros fecham ou são renovados. A coleta semanal basta para volumes por ocupação ou empregador; a consulta diária é necessária para datas precisas de primeira e última aparição, que alimentam o sinal de tempo de preenchimento.
Posso fazer scraping das vagas do LinkedIn?
Não. O Contrato do Usuário do LinkedIn proíbe fazer scraping ou copiar o serviço, inclusive com crawlers e extensões de navegador, então um conjunto de dados construído assim viola os termos desde a primeira requisição. Para ver como as vagas mudam por país, use os filtros da própria busca; Como procurar vagas no LinkedIn em outro país mostra como.
Conjunto de dados de vagas ou scraping ao vivo: qual é melhor?
Um conjunto de dados comprado traz histórico e a deduplicação de um fornecedor desde o primeiro dia; a coleta ao vivo traz os campos, as fontes e a cadência que você escolhe, a partir de hoje. Equipes que precisam de histórico retroativo compram; equipes que precisam de um esquema ou país específico constroem.
Em resumo
Dados de vagas de emprego transformam anúncios em um registro estruturado e datado da demanda por trabalho: quem contrata, para qual ocupação, onde, por qual salário e desde quando. Suas melhores fontes são também as mais legítimas: as estatísticas oficiais de vagas para o quadro agregado e os endpoints públicos de ATS dos empregadores para o detalhe. Quando a coleta precisa ver cada mercado como um candidato local vê, a página de proxies para pesquisa de mercado da Proxynet cobre as saídas residenciais e de datacenter, e a Web Scraping API, disponível pela equipe de vendas, é o caminho gerenciado para equipes que querem as linhas, não o pipeline.