Um desenvolvedor precisa de dez mil registros de clientes para testar um novo sistema de faturamento, mas os registros reais não podem sair do banco de dados de produção. Uma equipe de aprendizado de máquina tem só algumas dezenas de exemplos do padrão de fraude que quer detectar. Uma equipe de IA se pergunta se ainda precisa coletar páginas web quando um modelo de linguagem consegue escrever exemplos de treinamento sob demanda. Os três estão olhando para a mesma opção: dados sintéticos, ou seja, dados que um programa produz em vez de dados que alguém coletou.
Este post explica o que são dados sintéticos, como eles são gerados e verificados, seus principais tipos e usos, o que eles não conseguem fazer (incluindo o colapso de modelo), como se comparam com dados reais da web e o que significam para a privacidade.
O que são dados sintéticos?
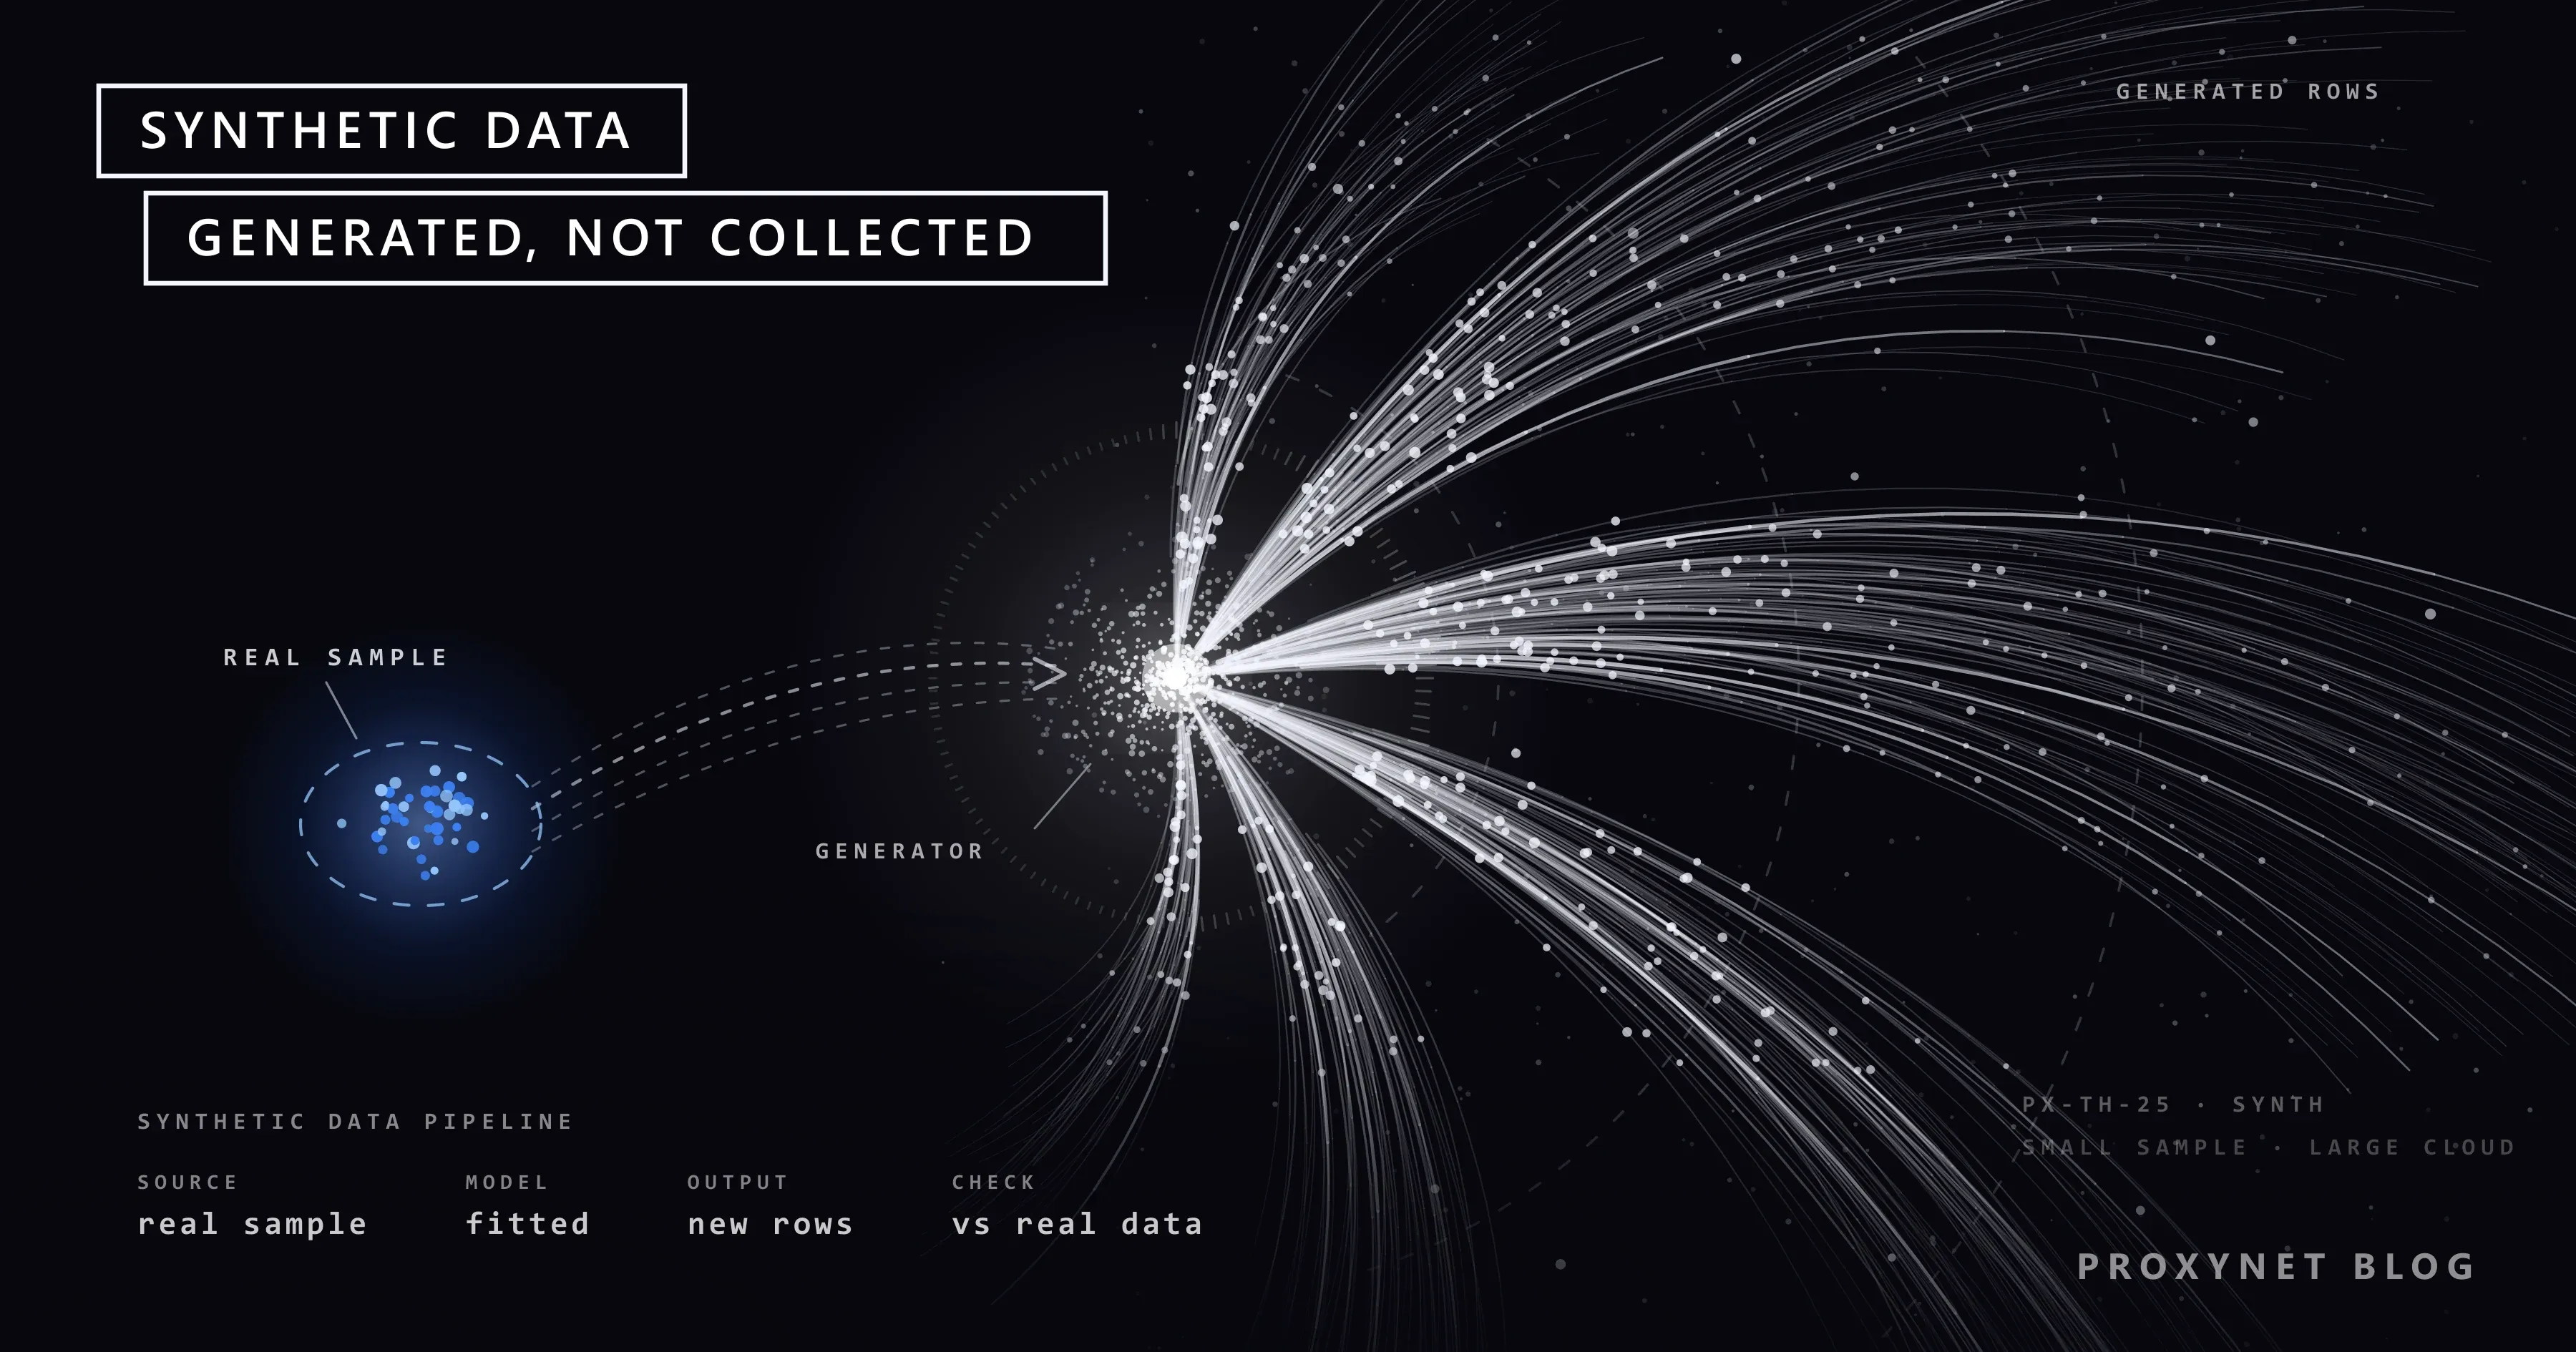
Dados sintéticos são dados gerados por um programa para se parecerem com dados reais, em vez de serem capturados de transações, sensores, pessoas ou páginas web reais. O NIST, o instituto de padrões dos EUA, descreve o processo no seu guia de desidentificação SP 800-188: dados-semente (seed data) são usados para criar dados artificiais que mantêm algumas características estatísticas desses dados-semente.
Não existe uma definição única aceita por todos. Uma revisão encomendada pela Royal Society propõe uma definição ampla: dados gerados com um modelo matemático ou algoritmo criado especificamente para resolver uma tarefa de ciência de dados. Isso inclui tabelas de clientes inventados, avaliações escritas por um modelo de linguagem e cenas de rua renderizadas por um simulador 3D. A ideia remonta à simulação de Monte Carlo dos anos 1940; a IA generativa a tornou muito mais comum.
O guia do NIST também separa graus de "sintético":
- Dados parcialmente sintéticos mantêm os registros reais, mas trocam as células de risco, como uma renda incomum, por valores modelados ou ruído.
- Dados totalmente sintéticos são gerados por inteiro a partir de um modelo, então nenhuma linha equivale diretamente a um registro real.
- Dados de teste copiam só a estrutura e as faixas de valores de um conjunto de dados. Servem para testes de software e não tentam reproduzir a estatística dele.
Como os dados sintéticos são gerados?
Dados sintéticos são gerados ajustando um modelo, escrevendo regras ou montando uma simulação, amostrando novos registros a partir disso e depois conferindo esses registros com dados reais. Um projeto típico segue sete etapas:
- Defina a tarefa. Decida para que os dados precisam servir: testar um formulário, treinar um classificador, compartilhar uma tabela com um parceiro. Isso define quais propriedades precisam sobreviver e quais podem ser descartadas.
- Escolha o ponto de partida. Pode ser uma amostra real (os dados-semente), um conjunto de regras do domínio, como CEPs válidos e faixas de preço, ou uma simulação do próprio processo, que não precisa de nenhum registro real.
- Escolha o gerador. As opções vão de regras simples e valores aleatórios, passando por modelos estatísticos que aprendem distribuições e correlações, até geradores de aprendizado de máquina: redes adversárias generativas (GANs), autoencoders variacionais (VAEs), modelos de difusão para imagens e grandes modelos de linguagem (LLMs) para texto.
- Gere. Amostre quantas linhas, textos ou imagens precisar e marque-os como sintéticos dentro dos próprios dados. O NIST sugere valores obviamente artificiais, como "FIRSTNAME1 LASTNAME1", para que ninguém confunda um arquivo de teste com dados reais de clientes.
- Valide com dados reais. Compare distribuições e correlações com a fonte (fidelidade) e verifique se um modelo treinado com o conjunto sintético ainda funciona com dados reais separados para teste (utilidade).
- Verifique a privacidade. Procure registros gerados que fiquem próximos demais dos reais e teste se valores atípicos podem ser rastreados até uma pessoa.
- Documente e mantenha um conjunto de teste real. Registre como os dados foram criados e guarde dados reais para a avaliação final.
A validação é a etapa que decide se os dados merecem confiança. O Census Bureau, o órgão de censo dos EUA, publica o SIPP Synthetic Beta, uma versão sintética de uma pesquisa domiciliar vinculada a registros fiscais e de benefícios sociais. Os pesquisadores desenvolvem a análise no arquivo sintético; depois, a equipe do órgão roda os mesmos programas nos dados confidenciais e revisa os resultados antes de liberá-los.
Quais são os tipos de dados sintéticos?
Os principais tipos se diferenciam pelo formato dos dados e pela forma como são gerados:
| Tipo | Como é criado | Uso típico | Ponto de atenção |
|---|---|---|---|
| Registros tabulares | Modelo estatístico, GAN ou VAE ajustado a uma tabela | Compartilhamento de dados, análises, modelos de fraude | Correlações quebradas, valores atípicos copiados |
| Texto | Um modelo de linguagem escreve exemplos a partir de prompts | Treinar e testar chatbots, classificadores | Erros factuais, redação repetitiva |
| Imagens e vídeo | Simulação 3D ou geradores de imagem | Direção autônoma, robótica, detecção de defeitos | Distância entre cenas simuladas e reais |
| Dados de teste de software | Regras e geradores de valores fictícios | Controle de qualidade, demos, testes de carga | Ser confundido com dados reais |
A pergunta "isso substitui dados reais da web?" aparece mais com texto. Nos trabalhos publicados, o texto gerado costuma ser somado a texto real filtrado, e não usado no lugar dele. No artigo "Textbooks Are All You Need", da Microsoft Research (2023), um pequeno modelo de código, o phi-1, foi treinado com cerca de 6 bilhões de tokens (pedaços de palavras) de dados da web com "qualidade de livro didático", mais cerca de 1 bilhão de tokens de livros didáticos e exercícios gerados com o GPT-3.5.
Por que as empresas usam dados sintéticos?
As empresas recorrem a dados sintéticos quando os dados reais são escassos, sensíveis, caros de rotular ou ainda não existem:
- Privacidade. Um banco ou um hospital pode entregar a desenvolvedores e fornecedores uma cópia sintética de uma tabela em vez de registros de clientes ou pacientes, com as ressalvas explicadas mais abaixo.
- Casos raros. Fraudes, falhas de máquinas e situações perigosas no trânsito são raras nos dados reais; gerar mais exemplos ajuda um modelo a aprendê-las.
- Testes de software. Um app novo precisa de contas e pedidos com aparência realista antes de ter usuários. Dados de teste só precisam ser válidos, com os formatos e faixas certos, e não estatisticamente fiéis.
- Custo de rotulagem. Um simulador já sabe onde está cada carro e cada pedestre da cena, então os rótulos saem de graça; rotular fotos reais à mão é lento.
- Balanceamento. Exemplos gerados podem completar classes sub-representadas, o que só ajuda se o próprio gerador não for enviesado.
Quais são os limites dos dados sintéticos?
Dados sintéticos não conseguem acrescentar informação que a fonte nunca teve: um gerador reproduz padrões dos seus dados de treinamento, regras ou simulação, e nada além disso. O guia do NIST diz isso diretamente: dados totalmente sintéticos não podem dar ao usuário mais informação do que o modelo de onde vieram.
Isso aparece de várias formas:
- Nenhum fato novo. Um gerador treinado com os preços do ano passado produz preços plausíveis do ano passado; não sabe nada da redução de preço desta semana nem do produto lançado ontem.
- Valores atípicos perdidos. Um gerador ou suaviza os valores raros e extremos até sumirem, deixando os dados mais "médios" do que a realidade, ou os copia tão de perto que expõe o registro real.
- Viés copiado. Se um grupo está sub-representado ou é tratado de forma injusta na fonte, os dados sintéticos herdam isso e podem fazer o viés passar por dado neutro.
- Erros fluentes. Exemplos gerados por LLMs podem soar confiantes e estar errados. Um texto que se lê bem ainda precisa de checagem de fatos.
- Descobertas falsas. Um padrão encontrado em dados sintéticos pode ser um artefato do gerador, e é por isso que o NIST recomenda aos analistas confirmar os achados nos dados originais.
O que é colapso de modelo?
Colapso de modelo (model collapse) é a perda de qualidade que surge quando modelos generativos são treinados, geração após geração, com conteúdo produzido por modelos anteriores. Shumailov e colegas o descreveram em um artigo da Nature de 2024. Segundo o artigo, o uso indiscriminado de conteúdo gerado por modelos no treinamento causa defeitos irreversíveis nos modelos resultantes, e as caudas da distribuição original do conteúdo desaparecem. Os autores mostraram o efeito em modelos de linguagem e em outros dois tipos de modelo generativo.
No experimento com modelos de linguagem, cada geração de um modelo pequeno passou por ajuste fino (fine-tuning) com texto escrito pela geração anterior. Sem manter nenhum dado original, o desempenho na tarefa original caiu; em uma configuração que manteve 10% dos dados originais escritos por pessoas, a degradação foi pequena. A lição não é que todo exemplo sintético seja prejudicial, mas que os casos raros, as caudas, são os primeiros a sumir quando os modelos se alimentam só da própria produção.
Os autores também alertam que treinar novos modelos pode ficar mais difícil sem acesso a dados coletados da internet antes de o conteúdo gerado por IA se espalhar em massa. Arquivos abertos de rastreamento como o Common Crawl guardam cópias datadas de páginas públicas, e esse é um dos motivos pelos quais eles importam.
Como os dados sintéticos se comparam com dados reais da web?
Dados reais da web registram o que uma página pública de fato mostrava em um determinado momento; dados sintéticos registram o que um modelo espera. A diferença pesa mais na atualidade e na verdade de referência (ground truth), ou seja, os valores reais verificados com os quais um modelo é medido:
| Pergunta | Dados sintéticos | Dados públicos reais da web |
|---|---|---|
| Quão atuais são? | Tão antigos quanto a fonte | Tão novos quanto a última coleta |
| São verdade de referência? | Não, refletem um modelo | Sim, para o que a página mostrava |
| Novos preços, produtos, eventos | Não incluídos | Incluídos depois de publicados |
| Casos raros sob demanda | Sim | Só se aconteceram |
| Risco de dados pessoais | Menor se bem feito, não zero | Presente; minimize na coleta |
| Detalhes por localização | Só se a fonte tinha | Depende de onde você coleta |
Por que as equipes de IA ainda coletam dados reais da web?
As equipes de IA ainda coletam dados públicos reais da web porque avaliação, grounding e atualidade precisam de fatos que um gerador não consegue inventar.
Avaliação. A revisão encomendada pela Royal Society recomenda que ferramentas feitas para o mundo real sejam avaliadas com dados reais e, se necessário, ajustadas com eles. Um conjunto de teste sintético mede sobretudo o quanto um modelo imita o gerador.
Grounding. Muitos produtos de IA ancoram as respostas em fontes (grounding) com RAG (geração aumentada por recuperação): buscam documentos atuais no momento da pergunta e deixam o modelo responder com base neles. Isso só funciona se os documentos forem reais e recentes, que é o pipeline descrito em Web scraping para RAG: de HTML a chunks de Markdown limpos.
Atualidade e dados-semente. Novos produtos, preços e regulamentações aparecem primeiro na web, e até os pipelines de texto sintético costumam começar com exemplos reais. A pesquisa sobre colapso de modelo mostra por que uma parte de dados reais precisa continuar na mistura.
Dados sintéticos são anônimos?
Dados sintéticos não são anônimos automaticamente: se foram gerados a partir de dados pessoais, ainda podem revelar informações sobre as pessoas desses dados. A revisão encomendada pela Royal Society chama de "um equívoco comum" a crença de que dados sintéticos são privados por natureza e observa que geradores podem memorizar e reproduzir seus registros de treinamento.
O NIST faz a mesma observação: tanto os modelos quanto os dados sintéticos que eles produzem podem vazar informações pessoais passíveis de reidentificação. Uma solução comum é a privacidade diferencial, um método matemático que limita o quanto o registro de uma única pessoa pode alterar o resultado, ao custo de alguma precisão.
A visão jurídica segue a mesma lógica. Pelo GDPR na UE e pela KVKK da Türkiye, os dados só contam como anônimos quando não podem mais ser vinculados a uma pessoa identificável, e construir um gerador a partir de registros de clientes já é, por si só, tratamento de dados pessoais. Se os seus dados de origem vieram de páginas coletadas por web scraping, Como tratar dados pessoais (PII) em dados de scraping explica a diferença entre mascaramento, pseudonimização e anonimização.
Onde entram os proxies quando você precisa de dados reais?
Quando um modelo precisa se basear em dados públicos reais e atuais que variam conforme a localização, como preços, anúncios ou vagas de emprego, ou ser testado com eles, os dados sintéticos não conseguem fornecê-los, e a coleta tem de ser feita a partir do lugar certo. Muitos sites mostram preços, moedas, estoque e idiomas diferentes conforme o país do endereço IP do visitante, então uma coleta feita de um único escritório vê só uma versão.
Com os Proxies residenciais, cada requisição passa por uma conexão residencial no país e na cidade que você escolher, e a página devolve o que os visitantes locais veem. Colete apenas páginas públicas, siga o robots.txt e os termos do site, mantenha um ritmo baixo de requisições, use uma API oficial quando houver e deixe de fora os dados pessoais de que você não precisa.
Equipes que preferem não cuidar da coleta podem falar com o nosso time de vendas sobre a extração gerenciada de páginas da nossa Web Scraping API.
Erros comuns
- Considerar dados sintéticos anônimos por padrão. Teste se há vazamento ou use um método com garantia formal.
- Validar no olho. "Parece real" não diz nada sobre correlações, casos raros ou utilidade.
- Testar o modelo final só com dados sintéticos. Mantenha um conjunto de teste real e separado.
- Deixar registros sem marcação. Linhas sintéticas que parecem reais acabam em relatórios como se fossem reais.
- Treinar em loop com a saída do modelo. Cada geração sem dados reais novos perde mais casos raros.
- Esperar que um gerador conheça eventos recentes. Tudo o que aconteceu depois da coleta da fonte fica de fora.
- Ignorar o viés da fonte. O gerador o copia e depois o apresenta como dado limpo.
Guia de decisão
| Necessidade | Use |
|---|---|
| Testar um app antes do lançamento | Dados de teste baseados em regras, claramente marcados |
| Compartilhar uma tabela de clientes com um fornecedor | Dados sintéticos com teste de privacidade, mais revisão jurídica |
| Mais exemplos de casos raros | Aumento sintético de dados, avaliado em casos reais |
| Ensinar a um chatbot o formato de uma tarefa | Exemplos gerados por LLM, revisados por pessoas |
| Preços, anúncios ou vagas de emprego atuais | Dados públicos reais da web, coletados com moderação |
| Respostas sobre eventos recentes | Recuperação a partir de fontes reais atuais |
| Avaliação final do modelo | Um conjunto de teste real e separado |
Perguntas frequentes
Qual é um exemplo de dados sintéticos?
Uma tabela com 10.000 clientes inventados, cujas idades, cidades e valores de compra seguem os mesmos padrões de um banco de dados de clientes real, é um conjunto de dados sintéticos. Também são dados sintéticos as avaliações de produtos escritas por um modelo de linguagem para treinar um classificador e as cenas de estrada renderizadas por um simulador de direção com cada carro já rotulado.
Dados sintéticos são confiáveis?
São confiáveis para a tarefa em que foram validados, e não além dela. Dados que passam nos testes de fidelidade e utilidade para uma tarefa, como treinar um modelo de fraude, ainda podem enganar em outra, como estimar eventos raros. Trate as descobertas feitas com dados sintéticos como hipóteses e confirme-as com dados reais.
Qual é a diferença entre dados sintéticos e dados mock?
Dados mock ou dummy (fictícios) só precisam parecer válidos: formatos certos, faixas plausíveis, nenhuma pessoa real. Dados sintéticos no sentido mais estrito também mantêm os padrões estatísticos de um conjunto de dados real, de modo que análises ou treinamento de modelos feitos com eles dão resultados parecidos. Dados mock servem para testes de software; dados sintéticos estatisticamente fiéis servem para análises e aprendizado de máquina.
É possível treinar modelos de IA só com dados sintéticos?
Alguns modelos de escopo restrito, sim, sobretudo em áreas muito baseadas em simulação, como a robótica, mas os grandes modelos de linguagem ainda dependem de texto real. Os trabalhos publicados misturam os dois, como fez o phi-1, e a pesquisa sobre colapso de modelo mostra que treinar só com texto gerado, geração após geração, piora a qualidade.
O que são dados sintéticos em pesquisa de mercado?
Em pesquisa de mercado, dados sintéticos costumam significar "respondentes sintéticos": um modelo de linguagem responde perguntas de pesquisa do jeito que prevê que um tipo de cliente responderia. Isso pode ajudar a rascunhar e testar um questionário, mas não diz o que pessoas reais pensam hoje nem como reagem a algo novo, então as decisões continuam apoiadas em pesquisas reais e em dados de mercado reais, como preços e anúncios da concorrência.
Como medir a qualidade de dados sintéticos?
A qualidade é medida em três eixos: fidelidade (quanto as distribuições e correlações se aproximam das dos dados reais), utilidade (se um modelo treinado com eles funciona bem em dados reais) e privacidade (se é possível deduzir registros reais a partir deles). Um resultado forte em um eixo costuma custar algo em outro, então defina as metas a partir do caso de uso.
Em resumo
Dados sintéticos são gerados por um modelo, por regras ou por uma simulação para se parecerem com dados reais sem registrar eventos ou pessoas reais. Eles ajudam em testes de software, no compartilhamento mais seguro de dados, em casos raros e na criação de exemplos de treinamento, desde que sejam validados com dados reais e verificados quanto a vazamentos de privacidade. Não substituem dados reais: não contêm nada que faltasse na fonte, ignoram tudo o que aconteceu depois, copiam vieses e degradam modelos que se alimentam da própria produção. Para fatos atuais e específicos de cada localização, como preços, anúncios e vagas de emprego, a fonte continua sendo a web pública real, coletada em ritmo moderado e a partir do país certo.