Küçük bir internet kitapçısının sahibi her pazartesi, sattığı 150 kitabın üç başka mağazadaki fiyatına bakıyor. Elle yapıldığında bu, 450 sayfa ziyareti ve bir sabahın büyük kısmı demek; üstelik çarşambaya kadar bazı rakamlar çoktan eskimiş oluyor. Kısa bir program aynı sayfaları açıp her kitabın yanındaki fiyatı okuyabilir ve tabloyu kendi kendine doldurabilir. Bu programa web scraper, yaptığı işe de web scraping (veri kazıma) denir.
Bu yazıda gerçek bir fiyatı ilk istekten hazır tabloya kadar adım adım izliyoruz. Yol boyunca scraping'i tarama (crawling) ve API ile karşılaştırıyor, araçları gerektirdikleri beceriye göre sıralıyoruz. Ardından yasal çerçeveye değiniyor, sitelerin scraper'ları neden engellediğini ve proxy'nin nerede devreye girdiğini anlatıyoruz. Sonda bir alıştırma sitesinde çalıştırdığımız kısa bir Python örneği var.
Web scraping nedir?
Web scraping, web sayfalarını bir yazılımla okuyup içlerindeki belirli bilgileri düzenli bir biçime aktarmaktır. Bir ürün sayfasına bakan kişi bir görsel, bir başlık ve bir fiyat görür. Scraper ise sayfanın arkasındaki metni, yani HTML kodunu görür ve yalnızca bulmasını söylediğiniz parçaları alır: ürün adları, fiyatlar, tarihler, tablo hücreleri, bağlantılar.
Türkçede "veri kazıma" ve "web kazıma" adları da kullanılır. Data scraping daha geniş bir terimdir; dosyalardan, PDF'lerden ya da eski program ekranlarından veri çekmeyi de kapsar. Web scraping bunun web sitelerinde çalışan kısmıdır. Veri çıkarma (extraction) ise scraping'in içinde alanların ayıklandığı adımın adıdır. Scraper bir saldırı aracı da değildir: herhangi bir ziyaretçinin açabildiği sayfaları okur, yalnızca daha hızlı okur. Scraping'in kuralları da bu hızdan doğar.
Kod yazmadan önce hangi alanlara ihtiyacınız olduğuna karar verin. Scraper her ürün ya da haber için bu alanlarla bir satır doldurur. "Ne olur ne olmaz, sayfadaki her şeyi alalım" yaklaşımı veriyi temizlemeyi zorlaştırır ve saklamamanız gereken kişisel bilgilerin araya karışma ihtimalini artırır.
Web scraping nasıl çalışır?
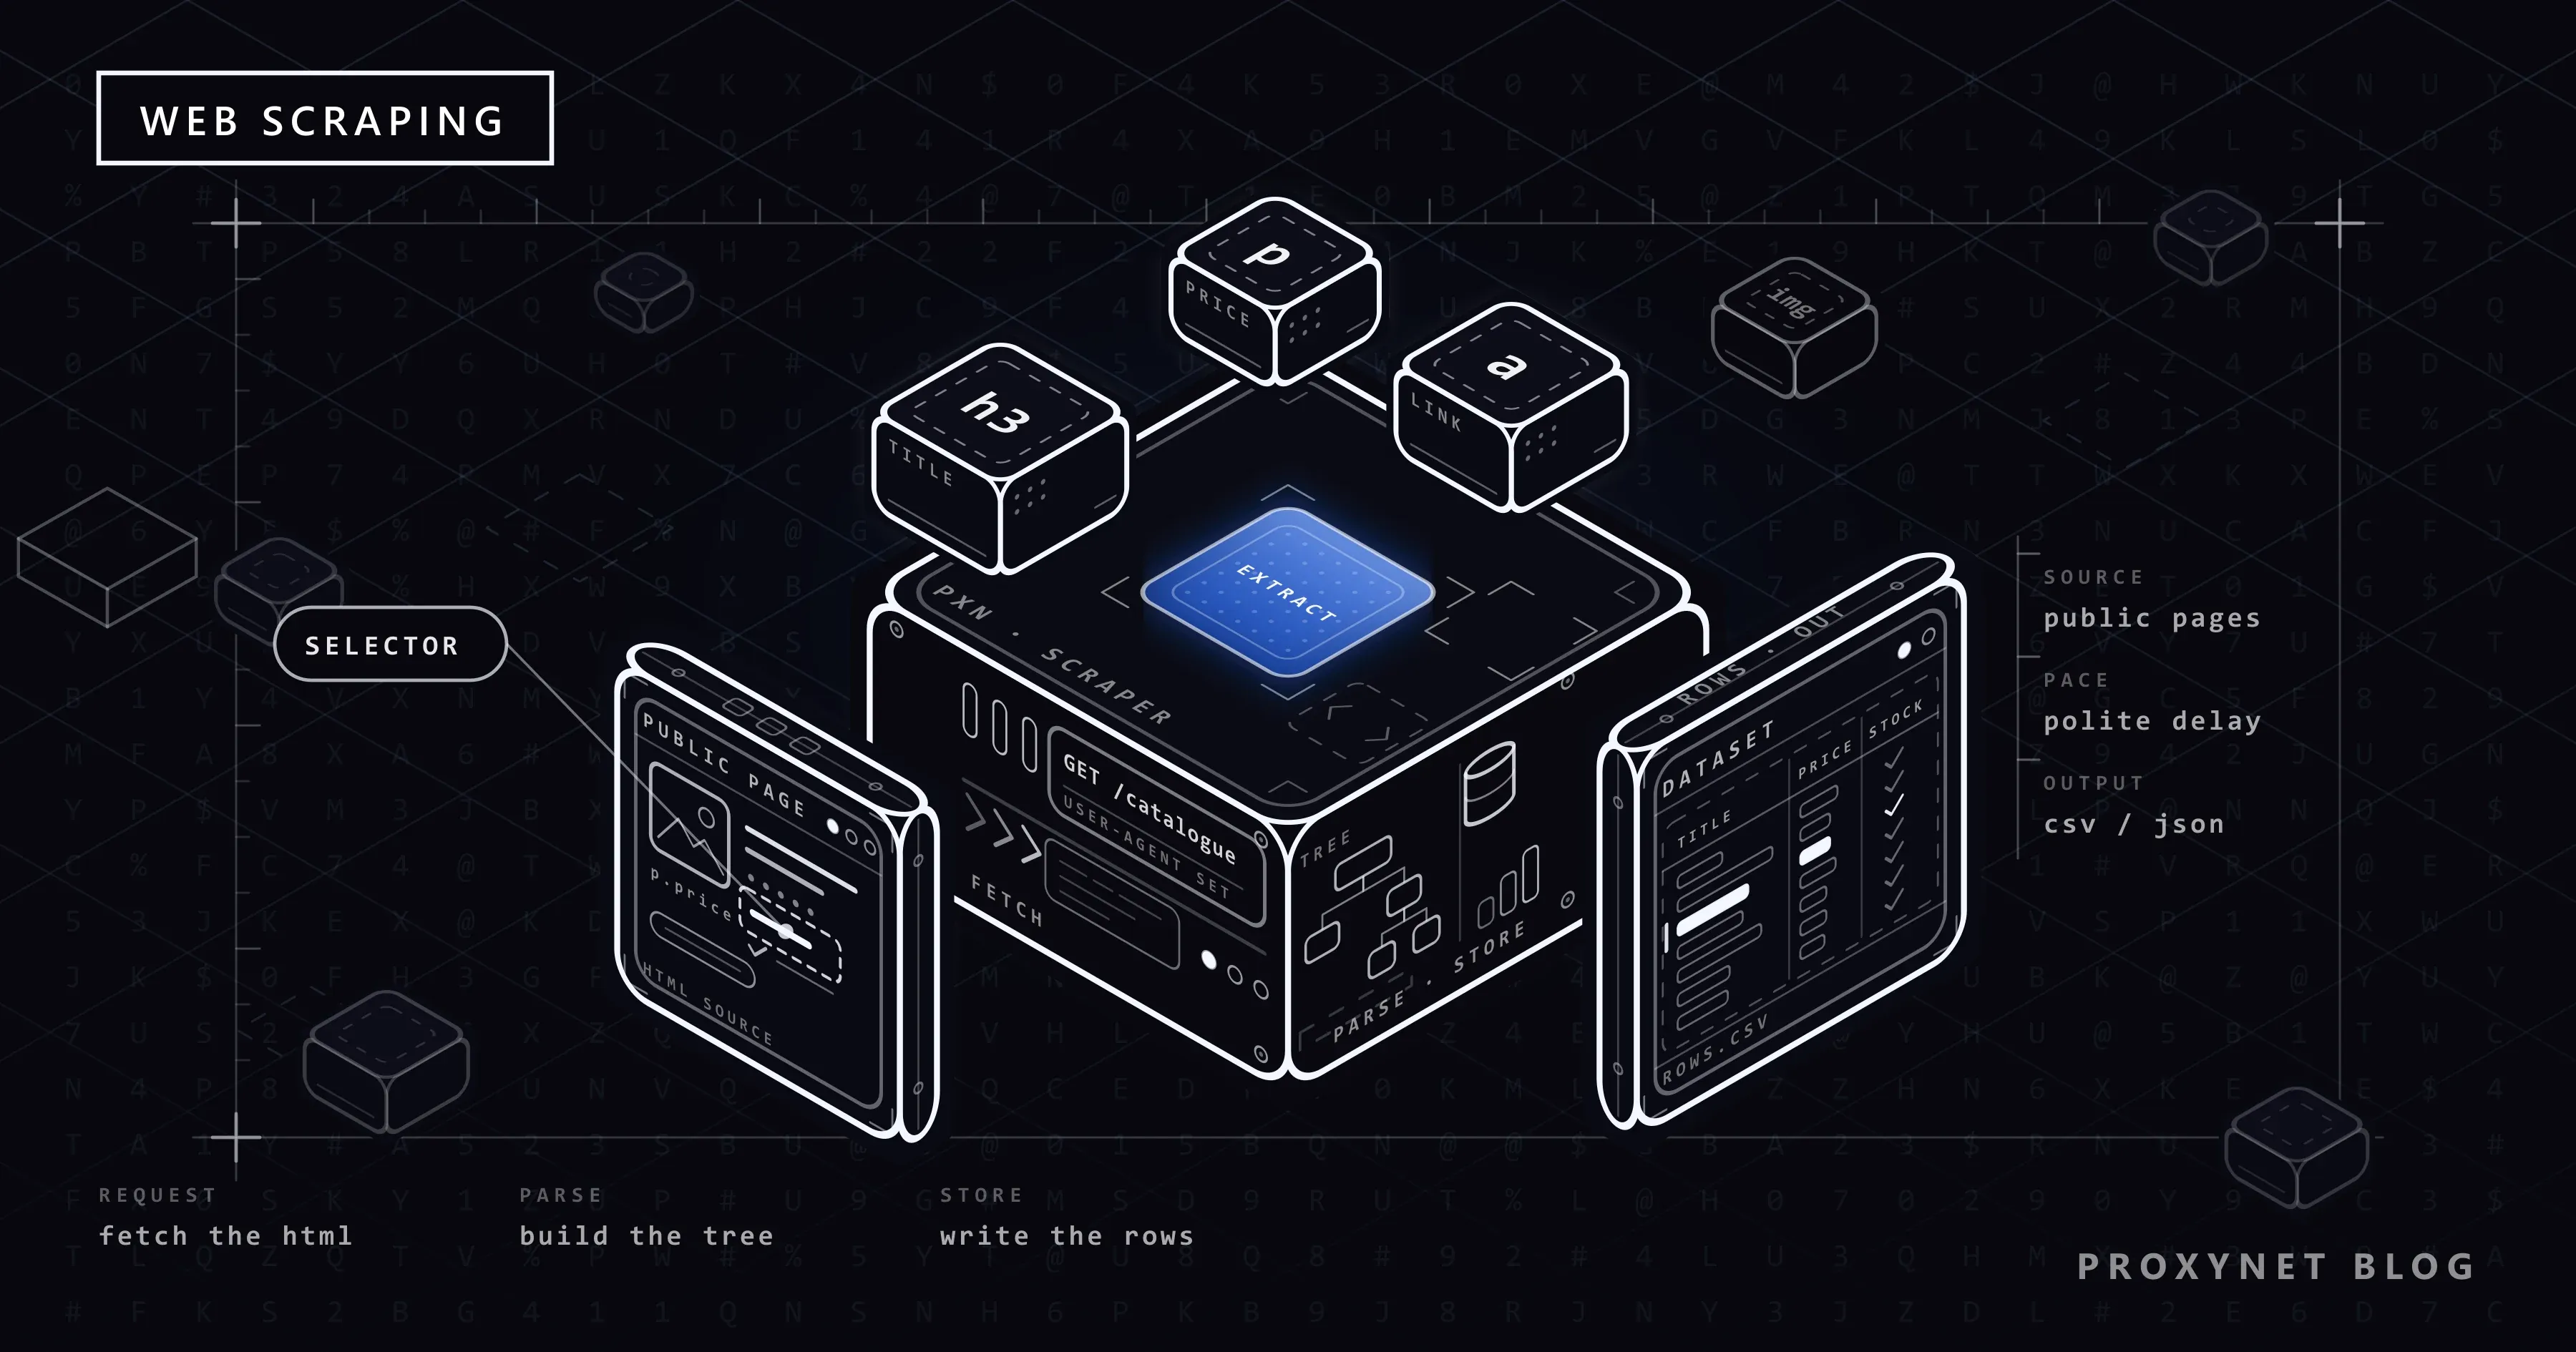
Tarayıcı eklentisinden milyonlarca sayfa gezen sistemlere kadar her scraper aynı döngüyü çalıştırır. Bu döngüde gerçek bir fiyatı izleyelim: scraping alıştırması için kurulmuş books.toscrape.com sitesindeki Travel kategorisinin ilk kitabı. Site kendini "web scraping amaçlı bir demo site" diye tanıtıyor; fiyatlar rastgele atanmış.
- Sayfalar seçilir. Scraper bir adres listesiyle başlar. Listeyi siz yazarsınız ya da bağlantıları izleyen bir crawler çıkarır. Bizim listemizde tek adres var: Travel kategorisi sayfası.
- Kurallara bakılır. Resmî bir API ya da indirme bağlantısı olup olmadığı kontrol edilir, kullanım şartları okunur ve sitenin robots.txt dosyası açılır. Alıştırma sitesinde bu adres 404 hatası döner; site zaten kazınmak için kurulmuş.
- İstek gönderilir. Program sayfayı sunucudan bir HTTP isteğiyle ister; tarayıcının gönderdiği mesaj da budur. Kurallara uyan bir scraper, kendini tanıtan bir User-Agent başlığı ekler.
- HTML gelir. Sunucu bir durum kodu (200, sayfanın teslim edildiği anlamına gelir) ve HTML ile cevap verir. Fiyatımız
<p class="price_color">£45.17</p>biçiminde gelir: henüz bir sayı değil, etiketlere sarılmış bir metin. - HTML ayrıştırılır. Ayrıştırıcı (parser) bu metni, programın içinde arama yapabileceği iç içe öğelerden oluşan bir ağaca çevirir. Bu adımı veri ayrıştırma yazımızda ayrıntılı anlattık.
- Alanlar ayıklanır. Bir CSS seçici (selector) tam öğeyi gösterir: her ürün kartının içinde,
price_colorsınıfını taşıyan paragraf. Sonuç küçük bir kayıttır: "It's Only the Himalayas",£45.17, "In stock". - Temizlenir ve kaydedilir. Boşluklar kırpılır, hesap yapılacaksa para birimi işareti ayrılır ve kayıt bir dosyada ya da veritabanında satır olur. Biçimleri Kazınan Veri CSV, JSON ve SQLite'a Nasıl Kaydedilir? yazımızda karşılaştırdık.
- Düzenli aralıklarla tekrarlanır. Scraper sonraki sayfaya geçer ya da ertesi gün aynı saatte yeniden çalışır. Bir fiyat değişikliği, bugünkü satır dünküyle karşılaştırıldığında görünür hâle gelir.
3-7 arası adımlar sayfa başına bir saniyeden çok daha kısa sürer. Asıl özen isteyen iş 1, 2 ve 8. adımlardadır.
Web scraping, web crawling ve API farkı
| Web scraping | Web crawling (tarama) | Resmî API | |
|---|---|---|---|
| Ne yapar? | Bilinen sayfalardan belirli alanları alır | Bağlantıları izleyerek sayfaları bulur | Sitenin zaten yapılandırdığı veriyi sunar |
| Ne verir? | Satırlar: başlık, fiyat, tarih | Sayfa adreslerinden oluşan bir liste | Belgelenmiş biçimde JSON ya da CSV |
| Biçimi kim belirler? | Siz, seçicilerle | Kimse; çıktı bir URL listesidir | Site |
| Ne zaman bozulur? | Sayfa tasarımı değişince | Sitenin bağlantıları değişince | Nadiren; yeni sürümler duyurulur |
| Neye tabidir? | robots.txt, kullanım şartları, yasalar | robots.txt ve tarama hızı | API anahtarı ve API şartları |
Uygulamada ilk ikisi birlikte çalışır: crawler ürün sayfalarını bulur, scraper her birini okur. İkisini Scrapy koduyla Web Scraping ve Web Crawling Farkı Nedir? yazımızda karşılaştırdık; büyük taramalar için proxy kurulumu web crawler sayfamızda. Site ihtiyacınız olan alanları bir API ile sunuyorsa o yol neredeyse her zaman daha iyidir, çünkü bir tasarımcı sınıf adını değiştirdiğinde bozulmaz. Bu kararı web scraping ve API karşılaştırmamızda ele aldık.
Veri kazıma programları: hangi araç kime uygun?
Araç türleri, temelde döngünün ne kadarını sizin yerinize yaptıkları ve size ne kadar kontrol bıraktıklarıyla birbirinden ayrılır.
| Araç türü | Gereken beceri | Neye uygun? | Nerede yetersiz kalır? |
|---|---|---|---|
| Tarayıcı eklentisi | Yok | Tek siteden, bir kerelik birkaç yüz satır | Sayfa düzeni değişince sessizce bozulur |
| Kodsuz masaüstü ya da bulut aracı | Az | Programlama bilmeden zamanlanmış işler | Veriniz üçüncü bir şirketten geçer; ücretsiz sürümler sınırlıdır |
| Python ya da Node.js kütüphaneleri | Orta | Düzenli işler, binlerce sayfa, kendi dosya biçiminiz | Kodu siz yazar, bakımını siz yaparsınız |
| Headless tarayıcı | Orta-ileri | İçeriğini JavaScript ile dolduran sayfalar | Yavaştır, çok bellek kullanır |
| AI scraper | Az-orta | Düzeni sık değişen sayfalar | Sayfa başına maliyet; yanlış bir değer doğru görünebilir |
| Barındırılan scraping API'si | Az-orta | Sunucu işletmeden adres verip HTML ya da JSON almak | Aylık maliyet; hedef sitenin kuralları size yine uygulanır |
Headless tarayıcı, penceresi olmayan gerçek bir tarayıcıdır ve sayfanın JavaScript'ini sizin kodunuz için çalıştırır; ne zaman gerektiğini Statik ve Dinamik Sayfalar yazımızda anlattık. AI scraper, "alanı bul" adımını bir dil modeline bırakır; artılarını ve eksilerini AI web scraper yazımızda bulabilirsiniz. Kod yazmıyorsanız web sitesinden veri çekme rehberimizle başlayın; kod yazıyorsanız BeautifulSoup rehberi aşağıdaki örnekten daha ileri gider.
Web kazıma yasal mı?
Herkese açık ve kişisel olmayan veriyi makul bir hızla toplamak, çoğu hukuk sisteminde kendi başına yasak değildir. Cevabı değiştiren, neyi ve nasıl topladığınızdır. Kişisel veriler sayfada açıkta dursa bile KVKK ve AB'deki GDPR gibi yasaların kapsamındadır; telif hakkıyla korunan metinlerin ve veritabanlarının kendi koruması vardır; kullanım şartları da otomatik toplamayı yasaklayabilir. Giriş gerektiren sayfaları kazımak ya da teknik bir engeli dolanmak sizi hukuken çok daha zayıf bir konuma düşürür. Ülkelere göre kuralları Web Scraping (Web Kazıma) Yasal mı? yazımızda topladık; bu yazı hukuki tavsiye değildir.
Siteler scraper'ları neden engeller?
Bir insan bir sayfayı bir dakikada okur; özensiz bir betik aynı dakikada yüz sayfa isteyip siteyi herkes için yavaşlatabilir. Bir scraper'ın cevap almaya devam edip etmeyeceğini üç mekanizma belirler.
- Hız sınırı (rate limit). Sunucu, belli bir süre içinde adres ya da hesap başına gelen istekleri sayar. Sınır aşıldığında
429 Too Many Requestskodu döner. Bu kod RFC 6585 ile tanımlanmıştır ve ne kadar beklenmesi gerektiğini söyleyen birRetry-Afterbaşlığı da içerebilir. RFC, sunucunun istekleri nasıl saydığını tanımlamaz; bu yüzden her site kendi eşiğini belirler. Ayrıntısı 429 Too Many Requests ve Rate Limit Hatası Nedir? yazımızda. - IP itibarı. Adreslerin bir geçmişi vardır. Veri merkezlerine ait adres blokları, spam'de görülmüş adresler ve saatte binlerce istek gönderen adresler, bir ev bağlantısından daha az güven görür.
- Bot skorları. Bot koruma servisleri istek hızını, başlıkları, TLS el sıkışmasını ve JavaScript'in çalışıp çalışmadığını birleştirerek her ziyaretçiye bir skor verir. Skor eşiğin altında kalırsa ziyaretçi bir doğrulama sayfasıyla ya da engelle karşılaşır. Katmanları Bot Tespiti Nasıl Yapılır? yazımızda tek tek anlattık.
Proxy nerede devreye girer?
Proxy sunucusu isteklerinizi hedefe iletir ve site sizin yerinize proxy'nin IP adresini görür. Bu, iki meşru durumda önem taşır. Birincisi konumdur: Almanya'daki ziyaretçiye bir fiyat, Türkiye'deki ziyaretçiye başka bir fiyat gösteren bir mağaza ancak iki ülkeden de bakılarak kontrol edilebilir. Konum hedeflemeli Residential Proxy ile ülke ve şehir seçebilirsiniz. İkincisi hacimdir: büyük bir iş tek bir adrese yığılmamalıdır. Rotating Proxy her isteğe ya da birkaç dakikalık her oturuma havuzdan farklı bir IP verir. Hangi işe hangi proxy türünün uyduğunu veri kazıma sayfamızda eşleştirdik.
Proxy, hız sınırını ya da engeli aşmanın yolu değildir. Bir site 429 döndüğünde ya da durmanızı istediğinde yapılacak şey yavaşlamak, API'ye geçmek ya da izin istemektir. Aynı hızı korumak için IP değiştirmek, tam da sınırın önlemek istediği davranıştır. Engellenmenin nedenlerini adım adım kontrol etmek için Web Scraping'de Engellenmeden Veri Toplama Yöntemleri yazımıza bakın.
Sorumlu scraping için kontrol listesi
- Önce API. Tek bir sayfayı ayrıştırmadan önce resmî API, indirme bağlantısı ya da veri akışı arayın.
- robots.txt kurallarına uyun. RFC 9309 dosyanın yerini sitenin en üst dizinindeki
/robots.txtolarak belirler ve bu kuralların bir erişim yetkilendirmesi olmadığını açıkça yazar. Dosya bir kilit değil, bir ricadır: onu görmezden gelen bir scraper'ı hiçbir şey durdurmaz, bu yüzden uymak sizin sorumluluğunuzdadır. Dosyanın nasıl okunacağını robots.txt rehberimizde anlattık. - Kullanım şartlarını okuyun. Otomatik toplamayı yasaklayan bir site hedef değildir.
- Yalnızca herkese açık sayfaları kazıyın; başkasına ait bir hesabın arkasında duran sayfalar hedef değildir.
- Kişisel veriyi dışarıda bırakın. Araya karışırsa ne yapacağınızı Kazınan Verilerde Kişisel Veri (PII) Nasıl Yönetilir? yazımızda anlattık.
- Yavaş ve düzenli bir hız tutun: küçük bir sitede istekler arasında saniyeler bırakın,
429ya da503gördüğünüzde tamamen durun. - Kendinizi tanıtın: sahte bir tarayıcı kimliği yerine dürüst bir User-Agent kullanın.
Python ile web kazıma: kısa bir örnek
Python yaygın bir başlangıç noktasıdır, çünkü işin zor kısmını iki kütüphane üstlenir. Requests HTTP isteğini gönderir. Beautiful Soup ise kendi belgelerindeki tanımıyla HTML ve XML dosyalarından veri çekmeye yarayan bir Python kütüphanesidir; kendisi hiçbir şey indirmez.
pip install requests beautifulsoup4Aşağıdaki betik alıştırma sitesinin Travel kategorisini okur, her kitabın başlığını, fiyatını ve stok durumunu alır ve bunları bir CSV dosyasına yazar. Numaralı yorumlar yukarıdaki döngünün 3-7 arası adımlarına karşılık gelir.
import csv
import os

import requests
from bs4 import BeautifulSoup

URL = "https://books.toscrape.com/catalogue/category/books/travel_2/index.html"

# İsteğe bağlı: PROXY_URL=http://user:pass@pr.proxynet.io:8000
proxy = os.environ.get("PROXY_URL")
proxies = {"http": proxy, "https": proxy} if proxy else None

# 1. İstek: sayfayı indir
response = requests.get(
    URL,
    headers={"User-Agent": "scraping-intro/1.0 (contact: you@example.com)"},
    proxies=proxies,
    timeout=20,
)
response.raise_for_status()
response.encoding = "utf-8"

# 2. Ayrıştırma: HTML metnini içinde arama yapılabilen bir ağaca çevir
soup = BeautifulSoup(response.text, "html.parser")

# 3. Ayıklama: her ürün kartından aynı üç alan
rows = []
for card in soup.select("article.product_pod"):
    rows.append({
        "title": card.h3.a["title"],
        "price": card.select_one("p.price_color").get_text(strip=True),
        "stock": card.select_one("p.availability").get_text(strip=True),
    })

# 4. Kayıt: satırları bir CSV dosyasına yaz
with open("travel_books.csv", "w", newline="", encoding="utf-8-sig") as f:
    writer = csv.DictWriter(f, fieldnames=["title", "price", "stock"])
    writer.writeheader()
    writer.writerows(rows)

print(len(rows), "kitap travel_books.csv dosyasına kaydedildi")
for row in rows[:3]:
    print(row["price"], "|", row["stock"], "|", row["title"])
Python 3.13, Requests 2.34 ve Beautiful Soup 4.15 ile çalıştırdığımızda çıktı şöyle oldu:
11 kitap travel_books.csv dosyasına kaydedildi
£45.17 | In stock | It's Only the Himalayas
£49.43 | In stock | Full Moon over Noah’s Ark: An Odyssey to Mount Ararat and Beyond
£48.87 | In stock | See America: A Celebration of Our National Parks & Treasured Sites
Betikteki üç satır bilerek eklendi. timeout=20 olmadan Requests, belgelerinin de uyardığı gibi, cevap vermeyen bir sunucuyu hiç vazgeçmeden bekler ve betik takılı kalır. Alıştırma sitesi Content-Type: text/html başlığını karakter kümesi belirtmeden gönderiyor; Requests bu durumda ISO-8859-1 varsayıyor. response.encoding = "utf-8" satırını kaldırdığımızda bütün fiyatlar £45.17 olarak geldi. raise_for_status() ise 4xx ya da 5xx cevabında betiği durdurur; böylece bir hata sayfası veri gibi kaydedilmez.
Proxy üzerinden gitmek için betiği çalıştırmadan önce PROXY_URL değişkenine http://user:pass@pr.proxynet.io:8000 biçiminde bir adres verin; başka hiçbir şey değişmez. Bunu yerel bir test proxy'siyle denedik: doğru kimlik bilgileriyle aynı 11 satır geldi, yanlış parolayla Requests, içinde 407 Proxy Authentication Required yazan bir ProxyError verdi. Sayfalama, yeniden deneme ve dönen IP havuzu için Python ile Web Scraping ve Rotating Proxy Kullanımı yazımızla devam edebilirsiniz.
Web scraping ne işe yarar?
- Fiyat ve stok takibi: rakiplerin herkese açık fiyatlarını ve stok durumlarını izlemek. Kurulumu fiyat takibi sayfamızda.
- Pazar araştırması: mağazalar arasındaki ürün sayısı, fiyat aralığı ve marka dağılımı, bir pazarın nasıl hareket ettiğini gösterir. Ayrıntısı pazar araştırması sayfamızda.
- SEO verisi: kendi sıralamalarınız resmî Search Console API'sinden gelir, lisanslı SERP verisi eksik kalanı tamamlar. Google'ın spam politikaları, sıralama kontrolü için arama sonuçlarını açık izin olmadan toplamayı ihlal sayar; resmî yol SEO Sıra Takibi Nasıl Otomatikleştirilir? yazımızda.
- Araştırma ve veri bilimi: zaman içinde toplanan ilanlar ve istatistikler, analiz için bir veri setine dönüşür. Toplanan verinin nasıl analiz edildiği Veri Madenciliği Nedir? yazımızın konusu.
- Yapay zekâ araçları ve RAG: RAG (retrieval-augmented generation), bir yapay zekâ modelinin cevap vermeden önce güncel belgelere bakmasıdır; bu belgeleri çoğu zaman scraper'lar getirir. Sınırlar için LLM'e Güvenli Web Erişimi yazımıza bakabilirsiniz.
- Kendi sitenizin denetimi: binlerce sayfadaki eksik açıklamalar, yanlış fiyatlar ve kırık bağlantılar. Dönen cevapları okumak için Scraping'de HTTP Hata Kodları yazımız işinize yarar.
Sık yapılan hatalar
- API varken kazımak. İş her tasarım değişikliğinde bozulur.
- Zaman aşımı koymamak. Cevap vermeyen tek bir sunucu, betiği bütün gece takılı bırakabilir.
- Karakter kodlamasını atlamak.
£yerine£görmek ya da Türkçe harflerin bozuk gelmesi, karakter kümesinin yanlış tahmin edildiğini gösterir. - Boş sonucu veri sanmak. Eşleşmeyi bırakan bir seçici çoğu zaman hata değil, boş bir sütun üretir. Her çalıştırmada satır sayısını kontrol edin.
- Sınırı aşmak için proxy kullanmak.
429yavaşlamanızı ister; aynı hızı korumak için IP döndürmek sorunu yalnızca büyütür. - İşe headless tarayıcıyla başlamak. Veri zaten HTML'in içindeyse gerçek bir tarayıcı yalnızca zaman ve bellek harcatır.
Karar rehberi
| İhtiyaç | Öneri |
|---|---|
| Site ihtiyacınız olan alanları bir API ile sunuyor | Kazımak yerine API'yi kullanın |
| Tek sayfadan, bir kerelik tek tablo | Tablo programının içe aktarma özelliği ya da tarayıcı eklentisi |
| Her gün aynı sayfalar | Bekleme süresi, zaman aşımı ve satır sayısı kontrolü olan bir Python betiği |
| İçerik ancak JavaScript çalışınca görünüyor | Önce sayfanın JSON kaynağı, sonra headless tarayıcı |
| Fiyatlar ülkeye göre değişiyor | O ülkeye hedeflenmiş residential proxy |
| Ölçülü bir hızla binlerce sayfa | Yükü dağıtan rotating proxy ile çalışan bir crawler |
| Site 429 dönüyor | Yavaşlayın ve Retry-After değerine uyun |
| Kişisel veri ya da başkasına ait bir hesabın arkasındaki sayfa | Kazımayın; site sahibinden izin isteyin |
Sıkça sorulan sorular
Veri biliminde web scraping ne için kullanılır?
Hazır hâlde bulunmayan veri setlerini oluşturmak için: mağazalar arasında zaman içindeki fiyatlar, şehirlere göre iş ilanları, metin analizi için yorumlar. Değer çoğu zaman toplamanın haftalarca tekrarlanmasından gelir; bu yüzden düzenli bir takvim, hızdan daha önemlidir.
Kod yazmadan veri kazıma yapılabilir mi?
Evet. Tablo programlarının içe aktarma özellikleri, tarayıcı eklentileri ve kodsuz araçlar bir kerelik işleri ve basit sayfa düzenlerini halleder. Hacim büyüdüğünde, iş her gün tekrarlandığında ve sayfalar sık değiştiğinde hata kontrolü olan kısa bir betik daha az emek ister.
Web kazımada Python neden bu kadar sık kullanılır?
Çünkü parçalar hazırdır: indirme için Requests, ayrıştırma için Beautiful Soup, büyük taramalar için Scrapy, tarayıcı gerektiren sayfalar için Playwright. Node.js de yaygın bir seçenektir; ikisini Web Kazıma: JavaScript mi Python mu? yazımızda karşılaştırdık.
Bir site kazındığını anlayabilir mi?
Çoğu zaman evet. İstek hızı, User-Agent başlığı, JavaScript'in çalışmaması ve IP itibarı otomasyonu ele verir. Kendini tanıtan ve düşük hızda çalışan bir scraper genellikle hoş görülür; kendini tarayıcı gibi gösterip dakikada yüzlerce istek gönderen bir scraper ise genellikle engellenir.
Web scraping her sitede çalışır mı?
Hayır. Giriş gerektiren sayfalar, görselin içine çizilmiş metinler ve yalnızca mobil uygulamada bulunan veriler basit bir scraper'ın erişemeyeceği yerlerdir; çoğunun da öyle kalması gerekir. İçeriğini JavaScript ile yükleyen sayfalar okunabilir, ama bunun için headless tarayıcı ya da sayfanın kendi veri kaynağı gerekir.
Web scraping için proxy gerekir mi?
Tek ülkeden yapılan küçük ve yavaş bir iş için gerekmez. İçerik ülkeye göre değişiyorsa, büyük bir işin yükü birçok adrese dağıtılmalıysa ya da kendi hesabınızla açtığınız bir oturum aynı IP'de kalmalıysa gerekir. Proxy, bir sitenin hız sınırını ya da kullanım şartlarını ortadan kaldırmaz.
Özet
Web scraping, bir sayfayı okuyup ihtiyacınız olanı tabloya kopyalamanın otomatik hâlidir: sayfa istenir, HTML ayrıştırılır, alanlar ayıklanır, satırlar kaydedilir ve iş düzenli aralıklarla tekrarlanır. Crawling sayfaları bulur, scraping onları okur; resmî bir API varsa ikisine de gerek kalmaz. İşi gören en basit aracı seçin, ilk istekten önce robots.txt dosyasına ve kullanım şartlarına bakın, kişisel veriyi dışarıda bırakın ve hızı düşük tutun. Ülkeye özgü sonuçlar isteyen ya da yükünü birçok adrese dağıtması gereken işler için uygun proxy türünü proxy hizmetlerimiz arasında bulabilirsiniz.