


































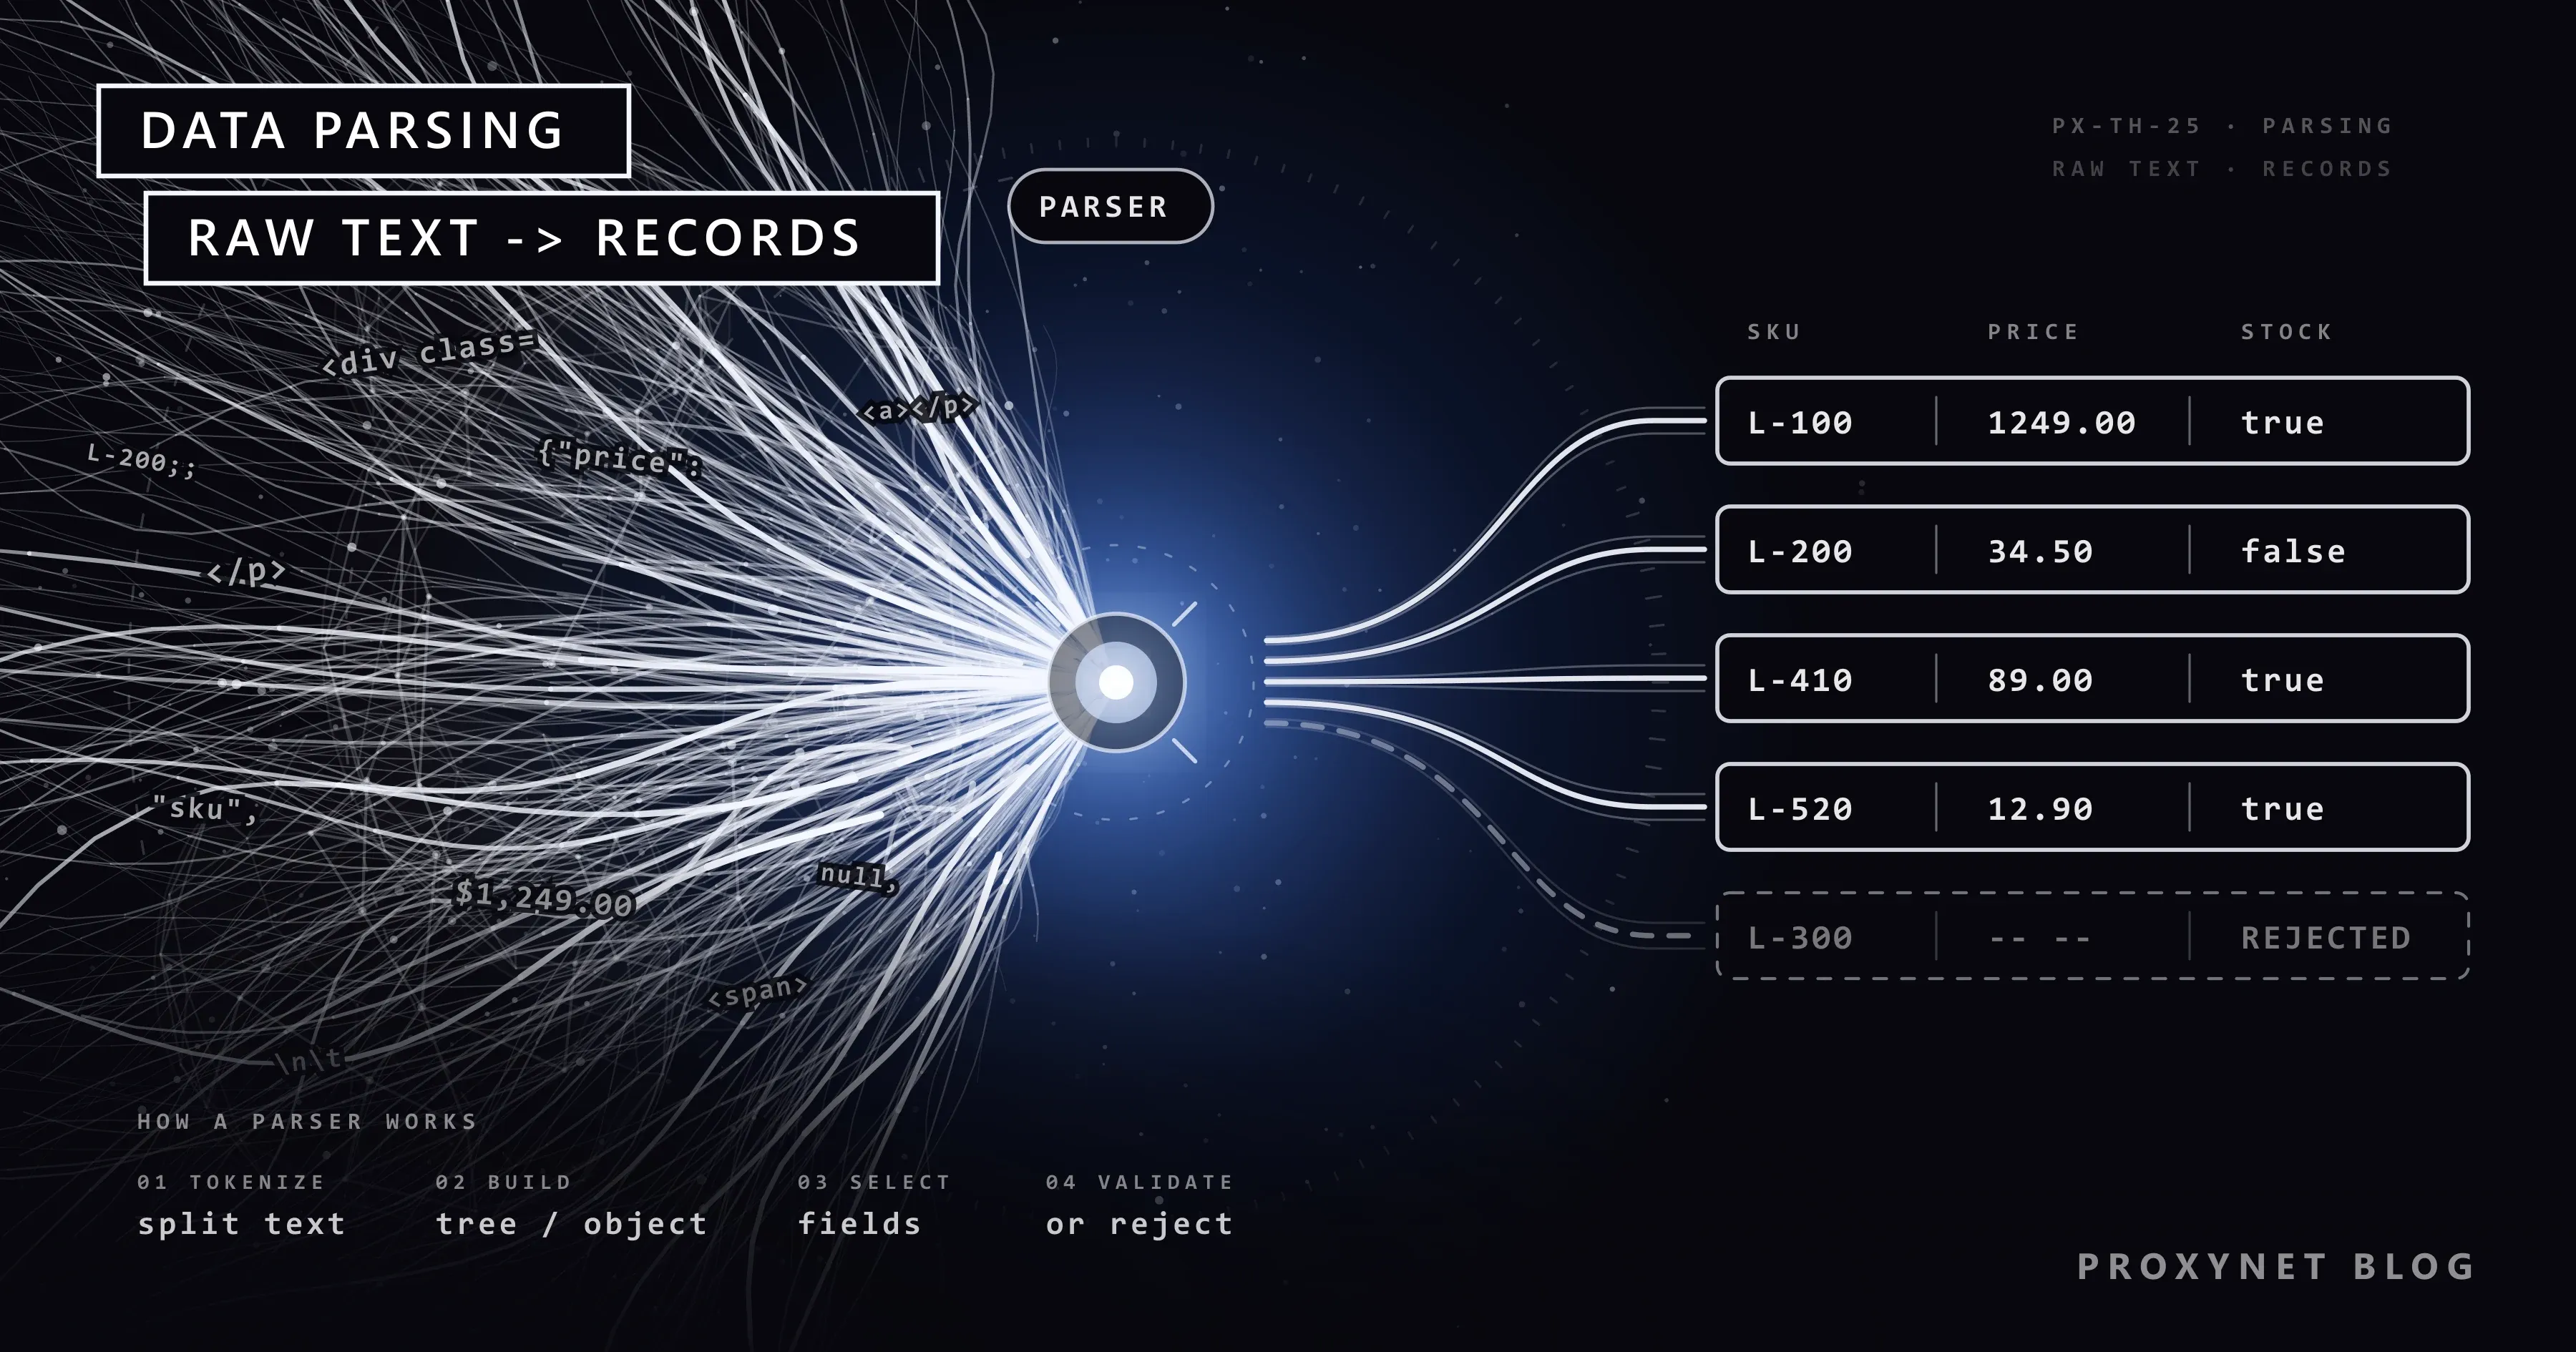
یک اسکرپر صفحه یک محصول را دانلود میکند و روی دیسک ذخیره میکند. حجم فایل 180 KB کد HTML است و جایی در آن چهار چیزی قرار دارد که واقعاً میخواستید: نام محصول، قیمت، وضعیت موجودی و SKU. تا وقتی برنامهای این مقدارها را پیدا نکند، بررسی نکند و در فیلدهای نامدار ننویسد، فایل دانلودشده فقط متن است. همین گام، یعنی رسیدن از متن خام به فیلدها، تجزیه داده (parsing) نام دارد.
این نوشته توضیح میدهد تجزیه یعنی چه، تجزیهگر چگونه کار میکند (دو مرحله اصلی و گامهای پیش و پس از آنها) و چه نوع تجزیهگری برای HTML، JSON، CSV، لاگها و قالبهای اختصاصی مناسب است. تجزیه را از اسکرپینگ و استخراج جدا میکند، یک نمونه کوتاه و آزموده در Python با BeautifulSoup و ماژول json نشان میدهد، خطاهایی را که در پروژههای واقعی تجزیهگرها را از کار میاندازند (HTML ناقص، JSON نامعتبر، رانش ساختار) مرور میکند و در پایان راهنمایی برای انتخاب میان ساختن و خریدن ارائه میدهد.
تجزیه داده چیست؟
تجزیه یعنی تحلیل یک ورودی بر اساس مجموعهای از قواعد و تولید ساختاری که محتوای آن ورودی را نشان دهد. ورودی معمولاً یک رشته متنی یا جریانی از بایتهاست. خروجی چیزی است که نام و نوع دارد: درختی از عنصرهای HTML، یک دیکشنری Python، فهرستی از ردیفها، یا رکوردی با فیلد price که بهجای متن "$1,249.00" یک عدد در خود دارد.
مرورگر شما HTML را برای ساختن صفحه تجزیه میکند، کلاینت API شما JSON را به شیء تبدیل میکند و صفحهگسترده شما CSV را به سلولها میشکند. تجزیه را فقط وقتی میبینید که ورودی با انتظار تجزیهگر جور نباشد؛ آن وقت برنامه یا با خطا متوقف میشود یا، بدتر از آن، با مقدارهای نادرست ادامه میدهد.
در کار با داده، این واژه در دو لایه به کار میرود:
- تجزیه قالب. تبدیل بایتها به ساختار خود قالب: HTML به درخت DOM، JSON به شیء، CSV به ردیف. این کار را کتابخانهها انجام میدهند.
- تجزیه داده به معنای دقیق. برداشتن مقدارهای مورد نیاز از آن ساختار با نوع درست: قیمت بهصورت عدد اعشاری، تاریخ بهصورت تاریخ، وضعیت موجودی بهصورت درست یا نادرست. این بخش را معمولاً خودتان مینویسید.
تجزیهگر چگونه کار میکند؟
تقریباً هر تجزیهگری، از یک کتابخانه JSON تا موتور HTML مرورگر، از همان دو مرحله اصلی پیروی میکند، یعنی تحلیل واژگانی و تحلیل نحوی، با یک گام خواندن پیش از آنها و انتخاب مقدارها و اعتبارسنجی پس از آنها.
- خواندن ورودی بهصورت متن. بایتها با یک کدگذاری، معمولاً
UTF-8، به نویسه تبدیل میشوند. حدس اشتباه در این مرحله پیش از شروع تجزیه نویسههای درهمریخته تولید میکند؛ خطاهای کدگذاری Unicode در Python به همین مشکل میپردازد. - توکنسازی (تحلیل واژگانی). تجزیهگر جریان نویسهها را به توکنها، یعنی کوچکترین تکههای معنادار، میبُرد: یک تگ آغازین، یک ویژگی، یک رشته، یک عدد، یک ویرگول، یک آکولاد بسته.
- ساختن ساختار (تحلیل نحوی). توکنها طبق دستور زبان قالب مرتب میشوند. برای HTML نتیجه درختی از عنصرهای تودرتوست؛ برای JSON شیءها و آرایههای تودرتو؛ برای CSV ردیفهایی از فیلدها.
- انتخاب مقدارها. کد شما ساختار را پیمایش میکند و فیلدهای لازم را برمیدارد، مثلاً با انتخابگر CSS یا XPath روی درخت HTML. انتخابگر CSS یا XPath این دو روش اشاره به یک عنصر را مقایسه میکند.
- تبدیل و اعتبارسنجی. متن به داده نوعدار تبدیل میشود:
"$34.50"به34.50و"In stock"بهtrue. رکوردهایی که یک فیلد الزامی ندارند علامتگذاری میشوند و بیصدا ذخیره نمیشوند.
استاندارد HTML تجزیهگر مرورگر را دقیقاً با همین مرحلهها توصیف میکند. فصل تجزیه در مشخصات WHATWG آن را به توکنسازی و ساخت درخت تقسیم میکند و همچنین تعریف میکند تجزیهگر چگونه باید از خطا بازیابی شود؛ به همین دلیل مرورگرها صفحههای خراب را نمایش میدهند و آنها را رد نمیکنند.
تفاوت تجزیه، اسکرپینگ و استخراج
این سه واژه اغلب مترادف به کار میروند، اما نام گامهای متفاوتی از یک زنجیرهاند.
| اصطلاح | چه میکند | ورودی | خروجی |
|---|---|---|---|
| خزیدن (crawling) | با دنبال کردن لینکها صفحه پیدا میکند | یک URL آغازین | فهرستی از URLها |
| اسکرپینگ | محتوای آن صفحهها را دانلود میکند | URLها | HTML، JSON یا فایل خام |
| تجزیه | محتوای خام را به ساختار تبدیل میکند | متن خام | درخت، شیء، ردیف |
| استخراج | مقدارهای لازم را از ساختار برمیدارد | یک درخت یا شیء | فیلدهای نامدار |
| اعتبارسنجی و پاکسازی | نوعها را بررسی، تکراریها را حذف و قالبها را اصلاح میکند | فیلدها | رکوردهای قابل اعتماد |
| ذخیرهسازی | رکوردها را جایی مینویسد | رکوردها | CSV، JSON Lines، یک پایگاه داده |
در گفتار روزمره، «تجزیه» هم تجزیه، هم استخراج و هم بخشی از اعتبارسنجی را با هم در بر میگیرد و در ادامه این نوشته هم به همین معنا به کار رفته است. خزیدن و اسکرپینگ بخش دریافت دادهاند؛ وب اسکرپینگ در برابر وب کراولینگ این تقسیم را توضیح میدهد. مقصد رکوردها در ذخیره دادههای اسکرپینگ در CSV، JSON و SQLite آمده است و کل زنجیره بهعنوان یک کار تکرارپذیر موضوع ETL چیست؟ است.
انواع تجزیهگر
ورودیهای مختلف تجزیهگرهای مختلفی میخواهند. استفاده از نوع نادرست، مثلاً عبارت باقاعده (regex) روی HTML تودرتو، ریشه بسیاری از اسکرپرهای شکننده است.
| نوع تجزیهگر | مناسب برای | نمونهها | نقطه ضعف |
|---|---|---|---|
| تجزیهگر HTML / DOM | صفحههای وب، حتی با نشانهگذاری خراب | BeautifulSoup با html.parser، lxml یا html5lib؛ Cheerio در Node.js | به انتخابگرهایی وابسته است که با تغییر چیدمان صفحه عوض میشوند |
| تجزیهگر JSON | پاسخهای API، داده جاسازیشده در صفحه | ماژول json در Python، JSON.parse در JavaScript | سختگیر: یک ویرگول اضافه کل سند را نامعتبر میکند |
| تجزیهگر CSV / جداشده | خروجیها، صفحهگستردهها، گزارشها | ماژول csv در Python، read_csv در pandas | نقلقول، جداکننده و کدگذاری بسته به تولیدکننده فرق میکند |
| تجزیهگر XML | فیدها، نقشههای سایت، APIهای سازمانی قدیمی | lxml، xml.etree.ElementTree | فضاهای نام انتخابگرها را طولانی میکنند |
| عبارتهای باقاعده | الگوهای کوچک و تخت درون یک فیلد مشخص: قیمت، تاریخ، شناسه | ماژول re در Python | تودرتویی را دنبال نمیکنند؛ با تغییر چیدمان میشکنند |
| تجزیهگر مبتنی بر دستور زبان | قالبهای اختصاصی، زبانهای پرسوجو، فایلهای پیکربندی | مولدهای تجزیهگر مثل ANTLR و Lark | نوشتن دستور زبان زمان میبرد |
| تجزیهگر مبتنی بر مدل | متن نامرتب بدون چیدمان ثابت | مدلهای زبانی که JSON برمیگردانند | خروجی باید اعتبارسنجی شود؛ نتیجه ممکن است بین اجراها فرق کند |
دو ردیف نیاز به توضیح دارند. تجزیهگرهای HTML یکسان نیستند: BeautifulSoup روی تجزیهگری که خودتان انتخاب میکنید کار میکند و مستندات آن نشان میدهد که تکه خراب <a></p> در html.parser، lxml و html5lib سه درخت متفاوت میسازد. تجزیهگر را صریحاً نام ببرید، وگرنه خروجی شما روی ماشینی که تجزیهگر دیگری نصب دارد ممکن است تغییر کند. تجزیه مبتنی بر مدل روشی است که اسکرپرهای هوش مصنوعی با آن صفحههایی را میخوانند که چیدمانشان مدام عوض میشود؛ این روش قواعد دقیق را با انعطاف عوض میکند، پس اعتبارسنجی اهمیت بیشتری پیدا میکند، همانطور که اسکرپرهای وب هوش مصنوعی چگونه کار میکنند توضیح میدهد.
یک نمونه کوتاه تجزیه در Python
این نمونه یک صفحه کوچک محصولات را با یک تجزیهگر HTML، انتخابگرهای CSS، یک عبارت باقاعده برای فیلد قیمت، یک بررسی فیلدهای الزامی و یک تجزیه JSON جداگانه برای داده جاسازیشده در صفحه تجزیه میکند. این را با نام page.html ذخیره کنید؛ کارت دوم یک <span> بستهنشده دارد و کارت سوم قیمت ندارد:
<!doctype html>
<html lang="en">
<head>
  <title>Desk lamps</title>
  <script type="application/ld+json">
  {"@context": "https://schema.org", "@type": "ItemList",
   "itemListElement": [
     {"@type": "ListItem", "position": 1, "url": "/p/arc-lamp"},
     {"@type": "ListItem", "position": 2, "url": "/p/clip-lamp"}
   ]}
  </script>
</head>
<body>
  <div class="product" data-sku="L-100">
    <h2 class="name">Arc Desk Lamp</h2>
    <span class="price">$1,249.00</span>
    <span class="stock">In stock</span>
  </div>
  <div class="product" data-sku="L-200">
    <h2 class="name">  Clip Lamp </h2>
    <span class="price">$34.50</span>
    <span class="stock">Out of stock
  </div>
  <div class="product" data-sku="L-300">
    <h2 class="name">Floor Lamp</h2>
    <span class="stock">In stock</span>
  </div>
</body>
</html>
دو کتابخانه را با pip install beautifulsoup4 lxml نصب کنید و سپس این را با نام parse_products.py کنار صفحه ذخیره کنید:
import json
import re
from decimal import Decimal
from pathlib import Path

from bs4 import BeautifulSoup

PRICE_RE = re.compile(r"[\d.,]+")


def parse_price(text):
    """'$1,249.00' -> Decimal('1249.00'); None if there is no number."""
    match = PRICE_RE.search(text or "")
    if not match:
        return None
    return Decimal(match.group().replace(",", ""))


def parse_products(html):
    soup = BeautifulSoup(html, "lxml")
    rows, problems = [], []

    for card in soup.select("div.product"):
        name = card.select_one(".name")
        price = card.select_one(".price")
        stock = card.select_one(".stock")
        row = {
            "sku": card.get("data-sku"),
            "name": name.get_text(strip=True) if name else None,
            "price": parse_price(price.get_text()) if price else None,
            "in_stock": stock is not None and stock.get_text(strip=True) == "In stock",
        }
        missing = [key for key in ("sku", "name", "price") if row[key] is None]
        if missing:
            problems.append({"sku": row["sku"], "missing": missing})
            continue
        rows.append(row)

    # Structured data embedded in the page: parse it as JSON, not as HTML.
    urls = []
    for tag in soup.select('script[type="application/ld+json"]'):
        try:
            data = json.loads(tag.string or "")
        except json.JSONDecodeError as err:
            problems.append({"json_ld": f"line {err.lineno}, col {err.colno}: {err.msg}"})
            continue
        urls += [item.get("url") for item in data.get("itemListElement", [])]

    return rows, urls, problems


if __name__ == "__main__":
    html = Path("page.html").read_text(encoding="utf-8")
    rows, urls, problems = parse_products(html)
    print(json.dumps(rows, indent=2, default=str))
    print("urls:", urls)
    print("problems:", problems)
اجرای python parse_products.py با BeautifulSoup 4.15.0، lxml 6.1.3 و Python 3.13 این خروجی را چاپ میکند:
[
  {
    "sku": "L-100",
    "name": "Arc Desk Lamp",
    "price": "1249.00",
    "in_stock": true
  },
  {
    "sku": "L-200",
    "name": "Clip Lamp",
    "price": "34.50",
    "in_stock": false
  }
]
urls: ['/p/arc-lamp', '/p/clip-lamp']
problems: [{'sku': 'L-300', 'missing': ['price']}]
<span> بستهنشده چیزی را خراب نکرد، چون lxml درخت را ترمیم کرد؛ نام با فاصلههای اضافه تمیز بیرون آمد و چراغی که قیمت نداشت بهجای ذخیرهشدن با مقدار خالی به problems رفت. وقتی برای آزمایش یک ویرگول پایانی به بلوک JSON-LD اضافه کردیم، اسکریپت به کار ادامه داد و پیام line 5, col 64: Illegal trailing comma before end of object را گزارش کرد که مستقیم به محل خطا اشاره میکند. JSONDecodeError: Expecting Value پیامهای دیگر این تجزیهگر و علت هرکدام را فهرست میکند.
همین تجزیهگر در Node.js بهجای BeautifulSoup از Cheerio استفاده میکند؛ وب اسکرپینگ با Cheerio را ببینید. برای یک اسکرپر کامل با درخواست، صفحهبندی و ذخیرهسازی، از آموزش BeautifulSoup شروع کنید.
خطاهای رایج تجزیه و علت آنها
- HTML ناقص. تگهای بستهنشده، تگهای بسته سرگردان و تگهای نابهجا در وب عادیاند. مرورگرها و تجزیهگرهای HTML آنها را ترمیم میکنند، اما هر تجزیهگر به روش خودش؛ بنابراین انتخابگری که با
html5libکار میکند ممکن است باhtml.parserچیزی پیدا نکند. تجزیهگر را ثابت کنید و با صفحههای ذخیرهشده آزمایش کنید. - JSON نامعتبر. JSON سختگیر است. RFC 8259 دستور زبان آن را تعریف میکند و ویرگول پایانی، نقلقول تکی و توضیحات جزو آن نیستند. علت رایج اصلاً JSON نیست: سرور یک صفحه خطای HTML یا بدنه خالی برگردانده و تجزیهگر JSON روی نخستین نویسه شکست میخورد.
- کلیدهای تکراری. RFC 8259 میگوید وقتی نامها در یک شیء تکرار شوند، رفتار گیرنده پیشبینیپذیر نیست. ماژول json در Python بدون هیچ خطایی آخرین مقدار را نگه میدارد، پس
{"price": 10, "price": 12}بیصدا به12تبدیل میشود. - نقلقول و جداکننده در CSV. ویرگولی که درون نام محصول باشد، اگر در نقلقول نباشد، یک فیلد را دو تکه میکند. RFC 4180 قرارداد رایج نقلقول را توصیف میکند، اما فقط جنبه اطلاعرسانی دارد و بسیاری از خروجیها از نقطهویرگول یا تب استفاده میکنند. از یک کتابخانه CSV استفاده کنید، هرگز از
line.split(","). - عدد و تاریخ وابسته به منطقه.
1.249,00در آلمان بیش از هزار است و برای یک تجزیهگر ساده حدود یک؛03/04/2026بسته به کشور مارس یا آوریل است. برای هر منبع با قالبی صریح تجزیه کنید. - رانش ساختار (schema drift). سایت نام یک کلاس را عوض میکند یا قیمت را به عنصر تازهای منتقل میکند و تجزیهگر همچنان کار میکند، اما
Noneیا مقدار نادرست برمیگرداند. هیچ چیز از کار نمیافتد و همین آن را پرهزینهترین خطا میکند. بررسی فیلدهای الزامی، مثل فهرستproblemsدر بالا، رانش بیصدا را به شماری قابل مشاهده تبدیل میکند. - محتوایی که در HTML نیست. برخی صفحهها محتوای خود را پس از بارگذاری با JavaScript میسازند، بنابراین داده هرگز در فایل دانلودشده نبوده است. صفحههای ایستا در برابر پویا نشان میدهد چگونه این را تشخیص دهید.
تجزیهگر را بسازیم یا بخریم؟
برای قالبهای استاندارد هرگز تجزیهگر سطح پایین را نمینویسید؛ کتابخانهها پختهاند. تصمیم درباره لایه استخراجِ روی آن است: انتخابگرها، تبدیلها و بررسیهای مخصوص هر سایت.
خودتان بسازید وقتی تعداد منبعها محدود است و بهندرت تغییر میکنند. کد خودتان شفاف است، به ازای هر صفحه هزینهای ندارد و آزمودنش با نمونههای ذخیرهشده آسان است.
از ابزار یا سرویس آماده استفاده کنید وقتی صدها سایت را دنبال میکنید که چیدمانشان زیاد عوض میشود، یا ورودی اصلاً چیدمان ثابتی ندارد، مثل ایمیل و PDF. بر اساس حجم یا تعداد کاربر پرداخت میکنید و کنترل کمتری بر خروجی میپذیرید.
ترکیب هر دو رایج است: API رسمی یا JSON جاسازیشده هر جا که وجود دارد، تجزیهگرهای دستنویس برای منبعهای کلیدی، یک پشتیبان مبتنی بر مدل برای منبعهای پراکنده و همان گام اعتبارسنجی پیش از ذخیرهسازی برای هر سه.
تجزیه کجا به کار میرود
- گردآوری داده در مقیاس بزرگ. هر زنجیره اسکرپینگ میان دانلود و پایگاه داده تجزیه انجام میدهد؛ جمعآوری داده را ببینید.
- خزندهها و ممیزی سایت. خزنده هر صفحه را برای یافتن لینکها و فراداده تجزیه میکند؛ خزنده وب را ببینید.
- پایش قیمت. قیمتهایی که به عدد تبدیل شدهاند در طول زمان مقایسهپذیرند، مثل پایش قیمت رقبا.
- پایش تغییرات. مقایسه فیلدهای تجزیهشده بهجای HTML خام از هشدارهای نادرست ناشی از تبلیغات و مُهرهای زمانی جلوگیری میکند؛ پایش تغییرات وبسایت را ببینید.
- تحلیل داده. رکوردهای نوعدار نقطه شروع الگویابیاند؛ دادهکاوی را ببینید.
- لاگ و امنیت. خطهای لاگ پیش از آنکه کسی بتواند خطاها را بشمارد به مُهر زمانی، نشانی IP، وضعیت و مسیر تجزیه میشوند.
اشتباهات رایج
- تجزیه سایت زنده در حین توسعه. چند صفحه واقعی را روی دیسک ذخیره کنید و تجزیهگر را روی آنها بنویسید: درخواست کمتر به سایت و آزمونهای تکرارپذیر.
- استفاده از regex روی کل سند HTML. اول درخت را تجزیه کنید و regex را فقط درون متن یک فیلد به کار ببرید.
- ذخیره قیمت بهصورت متن یا float. زود به
Decimalیا سنت صحیح تبدیل کنید و رشته خام را برای اشکالزدایی نگه دارید. - بلعیدن همه استثناها. یک
try/except: passخالی رانش ساختار را پنهان میکند. خطاها را همراه شناسه رکورد جمع کنید و پس از هر اجرا شمار آنها را بررسی کنید. - نادیده گرفتن JSON جاسازیشده. بسیاری از صفحههای محصول JSON-LD دارند که همان مقدارها را تمیزتر از HTML قابل مشاهده در خود دارد.
- مقصر دانستن تجزیهگر برای درخواستهای مسدودشده. وقتی «HTML» در واقع صفحه مسدودسازی یا خطای 429 است، هیچ انتخابگری جور نمیشود. پیش از تجزیه کد وضعیت را بررسی کنید و اگر سایت خواست، سرعت را کم کنید.
راهنمای انتخاب
| ورودی شما | رویکرد پیشنهادی |
|---|---|
| یک API که JSON برمیگرداند | از API استفاده کنید؛ با کتابخانه استاندارد JSON تجزیه و فیلدهای الزامی را اعتبارسنجی کنید |
| صفحههای HTML ایستا از چند سایت | BeautifulSoup با lxml یا Cheerio در Node.js، همراه انتخابگرهای CSS |
| صفحههایی که محتوا را با JavaScript میسازند | اول دنبال JSON جاسازیشده یا API سایت بگردید؛ مرورگر headless را فقط در صورت نیاز به کار ببرید |
| خروجیهای CSV یا صفحهگسترده | یک کتابخانه CSV یا pandas، با جداکننده و کدگذاری صریح |
| لاگهای سرور با چیدمان ثابت | regex برای هر خط یا یک تجزیهگر لاگ، سپس تبدیل فیلدها به نوع مناسب |
| قالب متنی اختصاصی که در اختیار شماست | تجزیهگر مبتنی بر دستور زبان (ANTLR، Lark) |
| ایمیل، PDF و متن آزاد بدون چیدمان | استخراجگر مبتنی بر مدل با اعتبارسنجی سختگیرانه خروجی |
| صدها سایت با چیدمانهای متغیر | سرویس تجاری تجزیه یا ترکیبی از هر دو |
پرسشهای متداول
تجزیه داده به زبان ساده چیست؟
یعنی خواندن متن خام و تبدیل آن به تکههای برچسبدار که برنامه بتواند از آنها استفاده کند. یک صفحه وب وارد میشود و رکوردی با نام، قیمت و وضعیت موجودی بیرون میآید.
تفاوت تجزیه و اسکرپینگ چیست؟
اسکرپینگ محتوا را از وبسایت دانلود میکند؛ تجزیه آن محتوا را به داده ساختاریافته تبدیل میکند. اسکرپر بدون تجزیهگر فقط فایلهای HTML خام به شما میدهد.
برای تجزیه HTML از کدام کتابخانه Python استفاده میشود؟
BeautifulSoup پرکاربردترین است و روی html.parser، lxml یا html5lib کار میکند. lxml را میتوان مستقیم هم به کار برد و از XPath پشتیبانی میکند. برای JSON، ماژول داخلی json کافی است.
آیا میتوان HTML را با عبارت باقاعده تجزیه کرد؟
فقط برای تکههای بسیار کوچک و تخت متن. HTML تودرتو و اغلب خراب است و عبارت باقاعده نمیتواند تودرتویی را دنبال کند. صفحه را با تجزیهگر HTML تجزیه کنید و در صورت نیاز regex را درون یک فیلد به کار ببرید.
چرا تجزیهگر من ناگهان مقدارهای خالی برمیگرداند؟
معمولاً سایت نشانهگذاریاش را تغییر داده و انتخابگرهای شما دیگر جور نمیشوند. علتهای دیگر: صفحه خطا بهجای محتوا، یا محتوایی که بعداً با JavaScript بارگذاری میشود.
آیا برای تجزیه داده به پروکسی نیاز دارم؟
خود تجزیه روی ماشین شما اجرا میشود و به پروکسی نیازی ندارد. پروکسی در بخش دریافت اهمیت دارد، وقتی اسکرپر صفحههای عمومی را در حجم زیاد جمع میکند یا باید صفحه را همانطور ببیند که بازدیدکنندگان کشوری دیگر میبینند. نشانیهای پروکسی مسکونی امکان انتخاب کشور و شهر را میدهند و پروکسی چرخشی درخواستها را میان چند نشانی پخش میکند؛ در هر حال شرایط و محدودیت نرخ هر سایت را رعایت کنید.
خلاصه
تجزیه داده ورودی خام را به رکوردهای ساختاریافته و نوعدار تبدیل میکند: توکنساز متن را به تکهها میبُرد، تجزیهگر آنها را طبق قواعد قالب مرتب میکند و کد شما مقدارهای لازم را انتخاب، تبدیل و بررسی میکند. تجزیهگر را بر اساس ورودی انتخاب کنید و regex را درون فیلدهای تکی نگه دارید. بیشتر کار در یک پروژه واقعی صرف خطاها میشود، بهویژه رانش ساختاری که هیچ پیام خطایی آن را اعلام نمیکند؛ پس هر رکورد را اعتبارسنجی کنید و پس از هر اجرا خطاها را بشمارید. اگر بخش دریافت به نشانیهایی در کشورهای مشخص نیاز دارد، سرویسهای پروکسی ما را ببینید.


