اسکریپت شما هر شب 2,000 صفحه محصول را میخواند. 300 صفحه اول درست برمیگردد، بعد پاسخها به 429 Too Many Requests تبدیل میشوند و چند دقیقه بعد هر درخواست 403 میگیرد. در کد چیزی عوض نشده است؛ سایت درخواستهای آدرس شما را شمرده و نتیجه گرفته که هیچ بازدیدکنندهای اینطور رفتار نمیکند. پاسخ رایج پروکسی چرخشی است، اما اگر بد وصل شود مشکلهای تازه میسازد: IP آنجایی که انتظار دارید عوض نمیشود، یک ورود به حساب وسط کار میشکند، یا بیست ورکر یک اسکرپر مؤدب را به سیل درخواست تبدیل میکنند.
این آموزش ساختار را در Python از ابتدا تا انتها میسازد: چرا یک IP به محدودیت نرخ میخورد، گیتوی چرخشی چطور خروجیها را تخصیص میدهد، دیکشنری proxies در requests، استفاده دوباره از نشست و اینکه چرا بیسروصدا چرخش را متوقف میکند، تلاشهای دوبارهای که Retry-After را رعایت میکنند، یک استخر نخ (thread pool) و یک نسخه با httpx و asyncio، انتخاب میان بهازای هر درخواست و نشست ثابت، بررسی IP خروجی و محدودیتهایی که خودتان نگه میدارید. همه قطعهکدها در 29 سپتامبر 2026 با Python 3.13.9، requests 2.34.2، httpx 0.28.1 و tenacity 9.1.4 اجرا شدهاند. بخش مفهومی در چرخش IP چیست و وب اسکرپینگ بدون مسدود شدن آمده است؛ این نوشته کد است.
چرا یک IP تنها 429 یا 403 میگیرد؟
سایتها درخواستها را بهازای هر کلاینت میشمارند و سادهترین شناسه کلاینت، IP مبدأ است. محدودکننده نرخ برای هر آدرس در یک بازه زمانی شمارندهای نگه میدارد و وقتی شمارنده از آستانه بگذرد، با 429 Too Many Requests پاسخ میدهد. RFC 6585، بخش 4 این کد را برای همین حالت تعریف میکند و میگوید پاسخ میتواند هدر Retry-After داشته باشد که مدت انتظار را اعلام میکند. الگوریتمهای شمارش در توضیح خطای 429 Too Many Requests آمده است.
403 بعد از چند 429 لایه دیگری است: محدودکننده گفته آهستهتر بروید، نرفتهاید و یک قاعده آدرس شما را به فهرست مسدودی برده که بعد از پایان اسکریپت هم میماند. چرخش خروجیها درخواستها را روی آدرسهای زیادی پخش میکند تا هیچکدام از آستانه نگذرد، اما جای آهسته رفتن را نمیگیرد: اگر از ده آدرس در دقیقه 600 درخواست به سایتی بفرستید که 60 تا را مجاز میداند، به جای یک آدرس مسدود، ده آدرس مسدود خواهید داشت.
گیتوی پروکسی چرخشی چگونه کار میکند؟
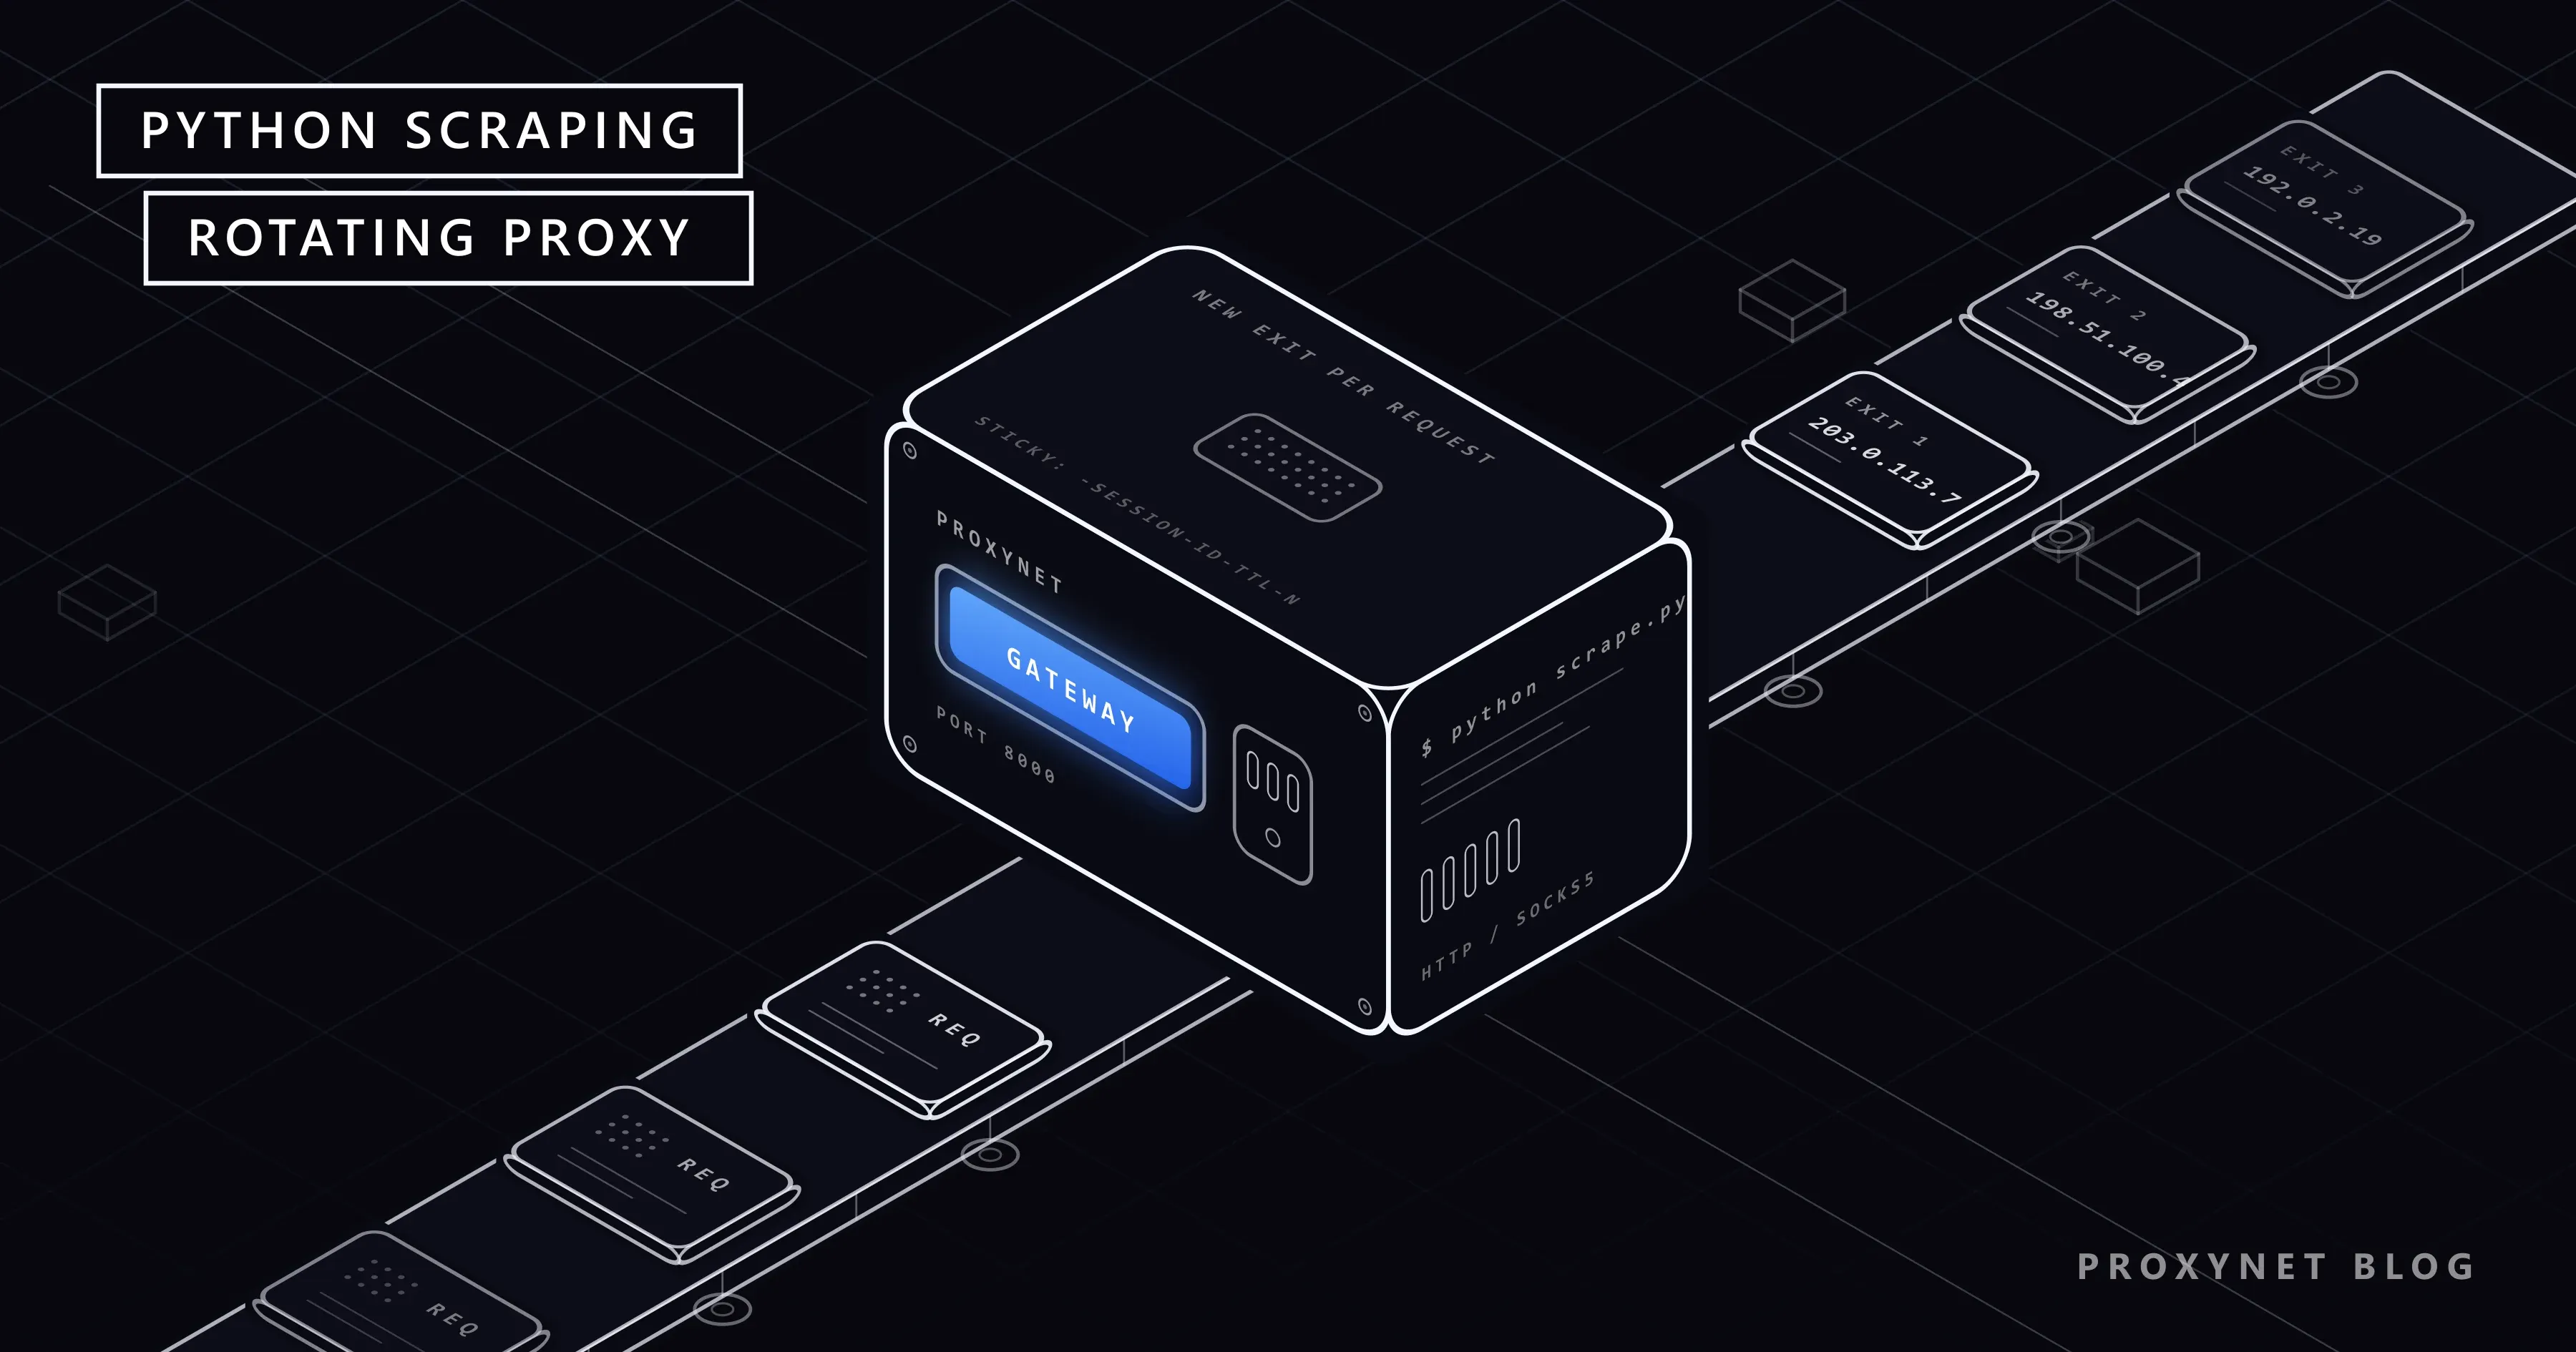
در مدل گیتوی (backconnect) کد شما فقط یک آدرس را میشناسد، در مثالها pr.proxynet.io:8000، و استخر پشت آن را ارائهدهنده مدیریت میکند. یک درخواست HTTPS این مسیر را طی میکند:
- کلاینت شما یک اتصال TCP به گیتوی باز میکند و
CONNECT target:443را همراه با هدرProxy-Authorization: Basic ...که ازuser:passساخته شده میفرستد. - گیتوی نام کاربری را میخواند. هر چیزی بعد از بخش حساب شما یک پارامتر است:
-country-trاستخر را به یک کشور محدود میکند و-session-<id>-ttl-<seconds>نشست ثابت میخواهد. - گیتوی از استخر فیلترشده یک خروجی انتخاب میکند: در حالت بهازای هر درخواست، برای هر تونل تازه یک خروجی تازه؛ در حالت ثابت، خروجیای که از قبل به شناسه نشست شما بسته شده است.
- تونل برقرار میشود، TLS میان کلاینت شما و مقصد اجرا میشود و مقصد IP خروجی را میبیند.
- با بسته شدن تونل، این پیوند از بین میرود. اتصال بعدی خروجی تازهای میگیرد، مگر اینکه یک شناسه نشست خروجی را نگه داشته باشد.
گام 3 تمام داستان این آموزش است. واحد چرخش تونل است، نه درخواست HTTP: تا وقتی یک تونل CONNECT باز بماند، هر درخواستی که از آن میگذرد از همان خروجی بیرون میرود. به همین دلیل keep-alive، که هر کلاینت امروزی بهصورت پیشفرض روشن میکند، معنای «بهازای هر درخواست» را در عمل عوض میکند. سمت محصول در صفحه پروکسی چرخشی است؛ خروجیهای اینجا از استخر پروکسی مسکونی میآیند، یعنی پروکسی مسکونی (رزیدنتال)، پس مقصد یک آدرس خانگی معمولی میبیند. پنل نام کاربری واقعی را میسازد (proxynet-xxxxxxxx-country-tr-session-…-ttl-1800)؛ در ادامه به user کوتاه شده است.
چرخش بهازای هر درخواست، نشست ثابت و IP ایستا
| چرخش بهازای هر درخواست | نشست ثابت | IP ایستا | |
|---|---|---|---|
| چه چیزی IP را عوض میکند | هر اتصال تازه | تغییر شناسه نشست یا پایان TTL (1 تا 60 دقیقه) | هیچچیز؛ آدرس مال شماست |
| نام کاربری | user | user-session-<id>-ttl-<seconds> | محصول جداگانه، host:port ثابت |
| کوکیها و ورود به حساب | میشکند؛ سایت یک کوکی را از شهرهای مختلف میبیند | تا پایان TTL حفظ میشود | بدون محدودیت حفظ میشود |
| هزینه هر درخواست | هر بار handshake تازه TCP و TLS | یک بار handshake، سپس keep-alive | یک بار handshake، سپس keep-alive |
| ورکرهای موازی | هر اتصال خروجی خودش را میگیرد | یک شناسه برای هر ورکر، یک خروجی برای هر شناسه | به تعداد آدرسهایی که اجاره میکنید |
| کار معمول | صفحههای محصول یا فهرستهای مستقل | ورود به حساب، سبد خرید، صفحهبندی چندصفحهای | فهرست مجاز API، حسابهای بلندمدت |
نشست ثابت درخواستِ نگه داشتن خروجی است، نه تضمین آن؛ یک دستگاه خانگی میتواند آفلاین شود و گیتوی نشست را زودتر جابهجا میکند. رفتار محصول در صفحه پروکسی با نشست ثابت آمده است.
راهاندازی requests: دیکشنری proxies
مستندات requests درباره پروکسی توصیه میکند proxies را در هر درخواست بهصورت صریح بدهید، چون مقدارهای session.proxies ممکن است با متغیرهای محیطی HTTP_PROXY و HTTPS_PROXY بازنویسی شوند. کلیدها طرح (scheme) آدرس مقصد هستند و هر دو به همان آدرس http:// گیتوی اشاره میکنند، چون ترافیک HTTPS تونل میشود:
import os
import requests

# The panel generates this string; keep it in an environment variable, not in git.
GATEWAY = os.environ.get("PROXY_URL", "http://user:pass@pr.proxynet.io:8000")
PROXIES = {"http": GATEWAY, "https": GATEWAY}
HEADERS = {"User-Agent": "price-monitor/1.0 (+mailto:you@example.com)"}

resp = requests.get("https://httpbin.org/ip", proxies=PROXIES, headers=HEADERS, timeout=(5, 30))
print(resp.status_code, resp.json())
تاپل timeout مهلت 5 ثانیه برای اتصال و 30 ثانیه برای خواندن تعیین میکند؛ بدون آن یک خروجی گیرکرده، ورکر را برای همیشه معطل میگذارد. User-Agent نام اسکریپت شما را میگوید و به صاحب سایت راهی برای تماس میدهد، کاری که User Agent چیست آن را به وانمود کردن به مرورگر ترجیح میدهد. اطلاعات ورود در متغیر محیطی است چون همان مستندات درباره فایلهای داخل کنترل نسخه هشدار میدهد. برای SOCKS5 بسته requests[socks] را نصب کنید و socks5h://user:pass@pr.proxynet.io:1080 را به کار ببرید؛ حرف h باعث میشود پروکسی DNS را حل کند و پورت SOCKS5 هم به همین شکل میچرخد.
استفاده دوباره از نشست: چرا IP عوض نشد
یک requests.Session اتصال TCP را دوباره به کار میبرد، که پشت پروکسی یعنی تونل و در نتیجه خروجی را دوباره به کار میبرد. این را با یک پروکسی آزمایشی محلی که هر CONNECT را ثبت میکند اندازه گرفتیم:
سه GET به یک میزبان | تونل بازشده | خروجی تخصیصیافته (یکی برای هر تونل) |
|---|---|---|
سه بار requests.get(...)، بدون نشست | 3 | 3 |
یک Session، سه بار s.get(...) | 1 | 1 |
یک Session، با headers={"Connection": "close"} | 3 | 3 |
یک httpx.AsyncClient، سه بار پشت سر هم await client.get(...) | 1 | 1 |
قاعده از همینجا درمیآید: برای چرخش بهازای هر درخواست، requests.get را بدون نشست صدا بزنید یا Connection: close بفرستید؛ برای کار با نشست ثابت، Session و شناسه نشست را با هم به کار ببرید، چون در غیر این صورت یک اتصال قطعشده خروجی را دوباره تخصیص میدهد.
تلاش دوباره با backoff که Retry-After را رعایت میکند
پشت گیتوی چرخشی دو چیز خراب میشود: شبکه (یک خروجی میافتد، تونل رد میشود، خواندن از مهلت میگذرد) و مقصد (یک 429 یا یک 5xx). هر دو تلاش دوباره میخواهند، اما نه با انتظار یکسان. 429 میتواند عدد خود سایت را در Retry-After بیاورد و آن عدد برنده است. بقیه موارد backoff نمایی همراه با jitter میگیرند تا چهار ورکری که با هم شکست خوردهاند، با هم تلاش دوباره نکنند:
import logging
import random
import time

import requests

MAX_ATTEMPTS = 4         # first try + 3 retries
RETRY_STATUS = {429, 500, 502, 503, 504}
TIMEOUT = (5, 30)        # connect, read - seconds
log = logging.getLogger("scraper")


def backoff(attempt: int) -> float:
    """1, 2, 4, 8 s ... plus jitter so that workers do not retry in lockstep."""
    return min(2 ** (attempt - 1), 30) + random.uniform(0, 1)


def fetch(url: str) -> requests.Response:
    """GET one URL with retries. Raises after the last failed attempt."""
    for attempt in range(1, MAX_ATTEMPTS + 1):
        try:
            resp = requests.get(url, proxies=PROXIES, headers=HEADERS, timeout=TIMEOUT)
        except (requests.ConnectionError, requests.Timeout) as exc:
            # Includes ProxyError: the gateway refused or dropped the tunnel.
            log.warning("attempt %d/%d %s: %s", attempt, MAX_ATTEMPTS, url, exc.__class__.__name__)
            if attempt == MAX_ATTEMPTS:
                raise
            time.sleep(backoff(attempt))
            continue

        if resp.status_code not in RETRY_STATUS:
            return resp  # 200, 404, 301 ... let the caller decide

        # The site asked us to slow down. Its own number wins over our schedule.
        retry_after = resp.headers.get("Retry-After")
        wait = float(retry_after) if retry_after and retry_after.isdigit() else backoff(attempt)
        log.warning("attempt %d/%d %s: HTTP %d, sleeping %.1fs", attempt, MAX_ATTEMPTS, url, resp.status_code, wait)
        if attempt == MAX_ATTEMPTS:
            resp.raise_for_status()
        time.sleep(wait)
    raise RuntimeError("unreachable")
requests.ProxyError زیرکلاس ConnectionError است، پس گیتویای که به CONNECT با خطا پاسخ میدهد روی یک تونل تازه دوباره امتحان میشود، که در حالت بهازای هر درخواست یعنی یک خروجی تازه. 404 همانطور که هست برگردانده میشود: صفحه رفته است و آدرس دیگری آن را برنمیگرداند.
همین سیاست به شکل دکوراتور tenacity کوتاهتر است، به این قیمت که Retry-After به یک استثنا تبدیل میشود و به جای هدر، زمانبندی tenacity اعمال میشود:
from tenacity import retry, retry_if_exception_type, stop_after_attempt, wait_exponential_jitter


class RetryableStatus(Exception):
    """Raised for 429 and 5xx so that tenacity retries them like a network error."""


@retry(
    stop=stop_after_attempt(4),
    wait=wait_exponential_jitter(initial=1, max=20),
    retry=retry_if_exception_type((requests.ConnectionError, requests.Timeout, RetryableStatus)),
    reraise=True,
)
def fetch_with_tenacity(url: str) -> requests.Response:
    resp = requests.get(url, proxies=PROXIES, headers=HEADERS, timeout=TIMEOUT)
    if resp.status_code in RETRY_STATUS:
        raise RetryableStatus(f"HTTP {resp.status_code} for {url}")
    return resp
در برابر https://httpbin.org/status/503 بعد از 1.5، 2.8 و 4.8 ثانیه دوباره تلاش کرد و سپس RetryableStatus را بالا انداخت.
یک اسکرپر کامل: استخر نخ، تلاش دوباره و لاگ
ThreadPoolExecutor چهار فراخوانی fetch را همزمان اجرا میکند، as_completed نتیجهها را به محض آماده شدن تحویل میدهد و یک صفحه ناموفق بدون متوقف کردن اجرا در لاگ ثبت میشود. آن را با نام scrape.py ذخیره کنید:
"""scrape.py - fetch a list of pages through a rotating proxy gateway."""
import logging
import os
import random
import sys
import time
from concurrent.futures import ThreadPoolExecutor, as_completed

import requests

GATEWAY = os.environ.get("PROXY_URL", "http://user:pass@pr.proxynet.io:8000")
PROXIES = {"http": GATEWAY, "https": GATEWAY}
HEADERS = {"User-Agent": "price-monitor/1.0 (+mailto:you@example.com)"}

MAX_WORKERS = 4          # requests in flight at the same time
MAX_ATTEMPTS = 4
RETRY_STATUS = {429, 500, 502, 503, 504}
TIMEOUT = (5, 30)

log = logging.getLogger("scraper")


def backoff(attempt: int) -> float:
    return min(2 ** (attempt - 1), 30) + random.uniform(0, 1)


def fetch(url: str) -> requests.Response:
    # the retry loop from the previous section, unchanged
    ...


def scrape(url: str) -> dict:
    started = time.monotonic()
    resp = fetch(url)
    return {
        "url": url,
        "status": resp.status_code,
        "bytes": len(resp.content),
        "seconds": round(time.monotonic() - started, 2),
    }


def main(urls: list[str]) -> None:
    logging.basicConfig(level=logging.INFO, format="%(asctime)s %(levelname)s %(message)s")
    results, failed = [], []
    with ThreadPoolExecutor(max_workers=MAX_WORKERS) as pool:
        futures = {pool.submit(scrape, url): url for url in urls}
        for future in as_completed(futures):
            url = futures[future]
            try:
                row = future.result()
                results.append(row)
                log.info("ok   %s -> %d in %.1fs", url, row["status"], row["seconds"])
            except Exception as exc:  # one bad page must not stop the run
                failed.append((url, repr(exc)))
                log.error("fail %s -> %s", url, exc)
    log.info("done: %d ok, %d failed", len(results), len(failed))
    for row in results:
        print(row)


if __name__ == "__main__":
    targets = sys.argv[1:] or [f"https://httpbin.org/ip?n={i}" for i in range(8)]
    main(targets)
آن را از یک پروکسی آزمایشی محلی گذراندیم که هر تونل سوم را با 429 رد میکند تا مسیر تلاش دوباره آزموده شود. هشت آدرس، چهار ورکر، هشت تونل، سه خطای تزریقشده، صفر صفحه ازدسترفته:
03:32:27 WARNING attempt 1/4 https://httpbin.org/ip?n=2: ProxyError
03:32:28 INFO ok   https://httpbin.org/ip?n=3 -> 200 in 1.1s
03:32:28 INFO ok   https://httpbin.org/ip?n=1 -> 200 in 1.1s
03:32:28 INFO ok   https://httpbin.org/ip?n=0 -> 200 in 1.1s
03:32:28 WARNING attempt 1/4 https://httpbin.org/ip?n=5: ProxyError
03:32:29 INFO ok   https://httpbin.org/ip?n=4 -> 200 in 0.9s
03:32:29 WARNING attempt 1/4 https://httpbin.org/ip?n=7: ProxyError
03:32:29 INFO ok   https://httpbin.org/ip?n=6 -> 200 in 0.9s
03:32:30 INFO ok   https://httpbin.org/ip?n=2 -> 200 in 2.6s
03:32:31 INFO ok   https://httpbin.org/ip?n=5 -> 200 in 2.4s
03:32:31 INFO ok   https://httpbin.org/ip?n=7 -> 200 in 2.0s
03:32:31 INFO done: 8 ok, 0 failed
لاگ بخشی از طراحی است: آدرس، شماره تلاش، وضعیت یا کلاس استثنا و مدت انتظار در هر خط کافی است تا «سایت نرخ ما را محدود میکند» را از «گیتوی تونلها را قطع میکند» بدون اجرای دوباره تشخیص بدهید. چهار ورکر عمداً کم است؛ همزمانی نرخ درخواست شما را چند برابر میکند و نرخ همان چیزی است که مقصد اندازه میگیرد. سطرهای results را همانطور که ذخیره دادههای اسکرپشده در CSV، JSON و SQLite نشان میدهد بنویسید؛ مرحله تجزیه (parse) میان resp.text و یک سطر در استخراج داده از وبسایت آمده است.
همان کار با httpx و asyncio
httpx پروکسی را روی کلاینت میگیرد، طبق مستندات پروکسی httpx. یک Semaphore به جای استخر نخ سقف همزمانی میشود؛ حلقه تلاش دوباره شکل خود را نگه میدارد و فقط sleepها به await تبدیل میشوند:
import asyncio
import random

import httpx

MAX_IN_FLIGHT = 4


async def fetch(client: httpx.AsyncClient, url: str) -> httpx.Response:
    for attempt in range(1, MAX_ATTEMPTS + 1):
        try:
            resp = await client.get(url)
        except (httpx.TransportError, httpx.ProxyError) as exc:
            log.warning("attempt %d/%d %s: %s", attempt, MAX_ATTEMPTS, url, exc.__class__.__name__)
            if attempt == MAX_ATTEMPTS:
                raise
            await asyncio.sleep(2 ** (attempt - 1) + random.uniform(0, 1))
            continue
        if resp.status_code not in RETRY_STATUS:
            return resp
        retry_after = resp.headers.get("Retry-After")
        wait = float(retry_after) if retry_after and retry_after.isdigit() else 2 ** (attempt - 1) + random.uniform(0, 1)
        log.warning("attempt %d/%d %s: HTTP %d, sleeping %.1fs", attempt, MAX_ATTEMPTS, url, resp.status_code, wait)
        if attempt == MAX_ATTEMPTS:
            resp.raise_for_status()
        await asyncio.sleep(wait)
    raise RuntimeError("unreachable")


async def main(urls: list[str]) -> None:
    gate = asyncio.Semaphore(MAX_IN_FLIGHT)
    async with httpx.AsyncClient(proxy=GATEWAY, headers=HEADERS, timeout=httpx.Timeout(30, connect=5)) as client:

        async def one(url: str):
            async with gate:
                resp = await fetch(client, url)
                return {"url": url, "status": resp.status_code}

        rows = await asyncio.gather(*(one(u) for u in urls), return_exceptions=True)
    for url, row in zip(urls, rows):
        print("FAIL" if isinstance(row, Exception) else "ok  ", url, row)


asyncio.run(main([f"https://httpbin.org/ip?n={i}" for i in range(8)]))
یک کلاینت یعنی یک استخر اتصال، و اتصالهای استخر تونلها را دوباره به کار میبرند: با چهار درخواست همزمان و هشت آدرس، اجرای ما چهار تونل باز کرد، پس جفتهای صفحه یک خروجی مشترک داشتند. اگر هر صفحه باید از آدرس خودش بیرون برود، headers={"Connection": "close"} بفرستید؛ اگر گروهی از صفحهها باید یک آدرس مشترک داشته باشند، آن یک نشست ثابت است، نه اتفاقی از استخر اتصال. اینکه کدام کتابخانه به کدام کار میخورد در مقایسه HTTPX، Requests و AIOHTTP آمده است.
انتخاب میان بهازای هر درخواست و نشست ثابت، و بررسی IP خروجی
برای هر کار جداگانه تصمیم بگیرید. صفحههای محصول، فهرستهای جستوجو و پروفایلهای عمومی مستقلاند: چرخش بهازای هر درخواست، بدون شیء نشست. یک ورود به حساب و بعد بیست صفحه صفحهبندیشده یک گفتوگوی واحد است: یک Session برای کوکیها، یک شناسه نشست برای خروجی، یک ورکر. کوکیهایی که میمانند در حالی که IP عوض میشود، رایجترین راه خارج شدن از حساب وسط اجراست؛ سمت ورود به حساب در نشست و کوکی در Python ساخته شده است.
پیش از اعتماد به هر یک از دو حالت، از یک سرویس اکو بپرسید چه آدرسی میبیند: سه فراخوانی بدون نشست باید سه آدرس متفاوت برگرداند و سه فراخوانی با یک شناسه نشست باید همان آدرس را:
import uuid
import requests

HOST = "pr.proxynet.io:8000"
USER, PASSWORD = "user", "pass"
ECHO = "https://httpbin.org/ip"


def proxies_for(username: str) -> dict:
    url = f"http://{username}:{PASSWORD}@{HOST}"
    return {"http": url, "https": url}


print("per request:")
for _ in range(3):  # no Session, so every call opens a new tunnel
    print("  ", requests.get(ECHO, proxies=proxies_for(USER), timeout=20).json()["origin"])

sid = uuid.uuid4().hex[:8]
sticky = proxies_for(f"{USER}-session-{sid}-ttl-600")  # same exit for up to 600 s
print(f"sticky {sid}:")
with requests.Session() as s:
    for _ in range(3):
        print("  ", s.get(ECHO, proxies=sticky, timeout=20).json()["origin"])
این را در آغاز هر کار اجرا کنید و نتیجه را ثبت کنید. اگر «per request» سه بار یک آدرس چاپ کرد، اول سراغ استفاده دوباره از اتصال بروید؛ اگر «sticky» سه آدرس متفاوت چاپ کرد، شناسه نشست به گیتوی نمیرسد، معمولاً چون یک مرحله کدگذاری URL نام کاربری را خراب کرده است.
محدودیت نرخ، robots.txt و محدودیتهایی که خودتان نگه میدارید
پروکسی چرخشی این را عوض میکند که سایت کدام آدرس را میبیند، نه اینکه سایت چه چیزی را مجاز میداند:
- اول robots.txt را بخوانید.
urllib.robotparserدر سه خط بهcan_fetch(user_agent, url)پاسخ میدهد؛ مسیر غیرمجاز از فهرست آدرسها بیرون میماند. اینکه این فایل چه چیزهایی را میتواند بیان کند در robots.txt چیست آمده است. Retry-Afterرا عیناً رعایت کنید. حلقه تلاش دوباره به اندازه عدد سایت صبر میکند، حتی وقتی چرخش اجازه میداد از خروجی دیگری ادامه بدهید.- نرخ را محدود کنید، نه فقط ورکرها را. چهار ورکر بدون تأخیر روی یک سایت سریع باز هم میتوانند 40 درخواست در ثانیه بفرستند؛ اگر سایت محدودیتی اعلام کرده، برای هر ورکر یک
time.sleepکوتاه اضافه کنید. - API رسمی را ترجیح بدهید اگر وجود دارد؛ برای هر دو طرف ارزانتر از تجزیه HTML از پشت پروکسی است.
- از سرویسهای حل CAPTCHA و افزونههای فرار از شناسایی استفاده نکنید. CAPTCHA یعنی سایت یک انسان میخواهد؛ پاسخ، نرخ پایینتر، API یا درخواست دسترسی است.
این ساختار کجا به کار میرود
- پایش قیمت. هزاران صفحه محصول مستقل در روز، چرخش بهازای هر درخواست، چهار تا هشت ورکر؛ اندازهگیری استخر در صفحه استخراج داده آمده است.
- داشبوردهای خودتان با ورود به حساب. یک نشست ثابت برای هر حساب، یک ورکر، کوکیها میان اجراها ذخیره شوند، مثل نشست و کوکی در Python.
- جایگزینی فهرست پروکسی دستی. چرخاندن فهرست در کد، مثل چرخاندن پروکسی در Python، روش قدیمیتر است؛ گیتوی فهرست و حسابداری آدرسهای مرده را حذف میکند.
اشتباههای رایج
- استفاده دوباره از
Sessionو انتظار IP تازه برای هر صفحه. یک تونل، یک خروجی. نشست را کنار بگذارید یاConnection: closeبفرستید. - شناسه ثابت بدون
Session. خروجی ثابت میماند، اما هر فراخوانی هزینه handshake تازه میدهد و کوکیها از دست میروند. هر دو را با هم به کار ببرید. - تلاش دوباره برای
404. صفحه رفته است؛ خروجی دیگری آن را پیدا نمیکند. فقط برای429،5xxو خطاهای شبکه دوباره تلاش کنید. - بدون timeout. یک خروجی گیرکرده، ورکر را تا کشته شدن فرایند مسدود میکند. همیشه
timeout=(5, 30)بدهید. - اطلاعات ورود داخل اسکریپت. به تاریخچه git راه پیدا میکنند. آنها را از محیط بخوانید.
راهنمای انتخاب
| نیاز | پیشنهاد |
|---|---|
| صفحههای مستقل زیاد، بدون ورود به حساب | چرخش بهازای هر درخواست، requests.get بدون نشست، برای شروع 4 ورکر |
| ورود به حساب و سپس صفحههای زیاد | نشست ثابت (-session-<id>-ttl-<seconds>) به همراه یک requests.Session، یک ورکر برای هر حساب |
هزاران درخواست کوچک، وابسته به I/O | AsyncClient در httpx با یک Semaphore؛ اگر هر کدام باید خروجی خودش را داشته باشد Connection: close |
| سایت محدودیت نرخ اعلام کرده است | اول ورکرها و تأخیرها را زیر آن محدودیت تنظیم کنید، بعد چرخش |
| قیمتهای مخصوص هر کشور | -country-xx در نام کاربری، چرخش بهازای هر درخواست داخل همان کشور |
| آدرس هرگز نباید عوض شود (فهرست مجاز API) | محصول چرخشی نیست؛ از IP ایستا استفاده کنید |
پرسشهای متداول
چرا IP در هر درخواست عوض نمیشود؟
چون کلاینت شما اتصال را دوباره به کار میبرد. Session در requests و Client در httpx اتصال TCP و در نتیجه تونل پروکسی را میان درخواستها باز نگه میدارند؛ خروجی هنگام باز شدن تونل انتخاب میشود. برای خروجی تازه در هر درخواست، از فراخوانی ساده requests.get یا هدر Connection: close استفاده کنید.
نشست ثابت را در Python چطور به کار ببرم؟
-session-<id>-ttl-<seconds> را به انتهای نام کاربری در آدرس پروکسی اضافه کنید، در کل گفتوگو همان شناسه را نگه دارید و فراخوانیها را از یک requests.Session انجام دهید تا کوکیها و تونل دوباره به کار بروند. TTL میتواند بین 1 تا 60 دقیقه باشد؛ مقداری بلندتر از طول کار انتخاب کنید.
برای اسکرپینگ با پروکسی از requests استفاده کنم یا httpx؟
برای چند صد صفحه در شب، requests با استخر نخ کافی است و اشکالزدایی آن سادهتر است. برای دهها هزار درخواست کوچک، کلاینت ناهمگام httpx با یک Semaphore منابع کمتری مصرف میکند. هر دو همان آدرس گیتوی و همان منطق تلاش دوباره را میگیرند.
چند ورکر همزمان امن است؟
با چهار شروع کنید و پاسخها را زیر نظر بگیرید. آنچه اهمیت دارد تعداد درخواست در دقیقه از دید مقصد است، پس پاسخ به محدودیت سایت بستگی دارد، نه به اندازه استخر. اگر با چهار ورکر 429 ظاهر شد، عدد را کم کنید یا تأخیر اضافه کنید.
آیا پروکسی چرخشی 429 را دور میزند؟
درخواستها را روی آدرسهای بیشتری پخش میکند تا هر کدام زیر آستانه بماند؛ آستانه را حذف نمیکند. اگر سایت محدودیتی گذاشته، Retry-After را رعایت کنید، نرخ را پایین بیاورید یا از API استفاده کنید. چرخش سریعتر برای عبور از 429 همان راهی است که آدرسها را به فهرست مسدودی میبرد.
چطور بررسی کنم که پروکسی کار میکند؟
یک نقطه پایانی اکوی IP مثل https://httpbin.org/ip را از پشت پروکسی درخواست کنید و پاسخ را با آدرس خودتان مقایسه کنید: سه بار بدون نشست برای دیدن چرخش، سه بار با شناسه نشست برای دیدن ثابت ماندن.
خلاصه
پروکسی چرخشی در Python یعنی یک آدرس گیتوی در دیکشنری proxies، یک حلقه تلاش دوباره که Retry-After را رعایت میکند، سقفی از چند ورکر و یک قاعده روشن برای اینکه چه زمانی یک صفحه میتواند با صفحه قبلی خروجی مشترک داشته باشد. برای کار با ورود به حساب، شیء نشست و شناسه نشست را با هم نگه دارید، هر دو را از صفحههای مستقل دور نگه دارید و پیش از اولین اجرای واقعی IP خروجی را بررسی کنید. استخر پشت گیتوی در صفحه پروکسی آمده است.