هر روز صبح به یک فهرست ثابت نیاز دارید: issueهای باز یک مخزن GitHub، قیمتهای صفحه یک دسته در یک فروشگاه اینترنتی یا نقلقولهای یک وبسایت. GitHub برای issueهایش یک API مستند دارد؛ پس اسکریپت میتواند آنها را درخواست کند و JSON تحویل بگیرد. فروشگاه شاید چیزی جز صفحههایش ارائه نکند؛ در این حالت اسکریپت باید HTML را دانلود کند و قیمتها را از دل آن بیرون بکشد. تفاوت وب اسکرپینگ و API در اصل همین است و در بیشتر پروژهها انتخاب را سلیقه شما تعیین نمیکند، بلکه چیزی تعیین میکند که طرف مقابل ارائه میدهد.
در این نوشته توضیح میدهیم API چیست و اسکرپینگ چیست، این دو را در ده مورد مقایسه میکنیم و سپس همان 100 رکورد را با Python از هر دو راه جمع میکنیم: یک بار از صفحههای HTML و یک بار از نقطه اتصال (endpoint) JSON که خود صفحه سایت آن را فرا میخواند. پس از آن به نقطههای اتصال پنهان JSON، سرویسهای API اسکرپینگ، محدودیت نرخ (rate limit)، لیست سفید IP، هزینه هر راه و زمان ترکیب آنها میرسیم. همه نمونهکدها در 29 سپتامبر 2026 با Python 3.13، Requests 2.34.2 و beautifulsoup4 4.15.0 اجرا شدهاند.
API چیست؟
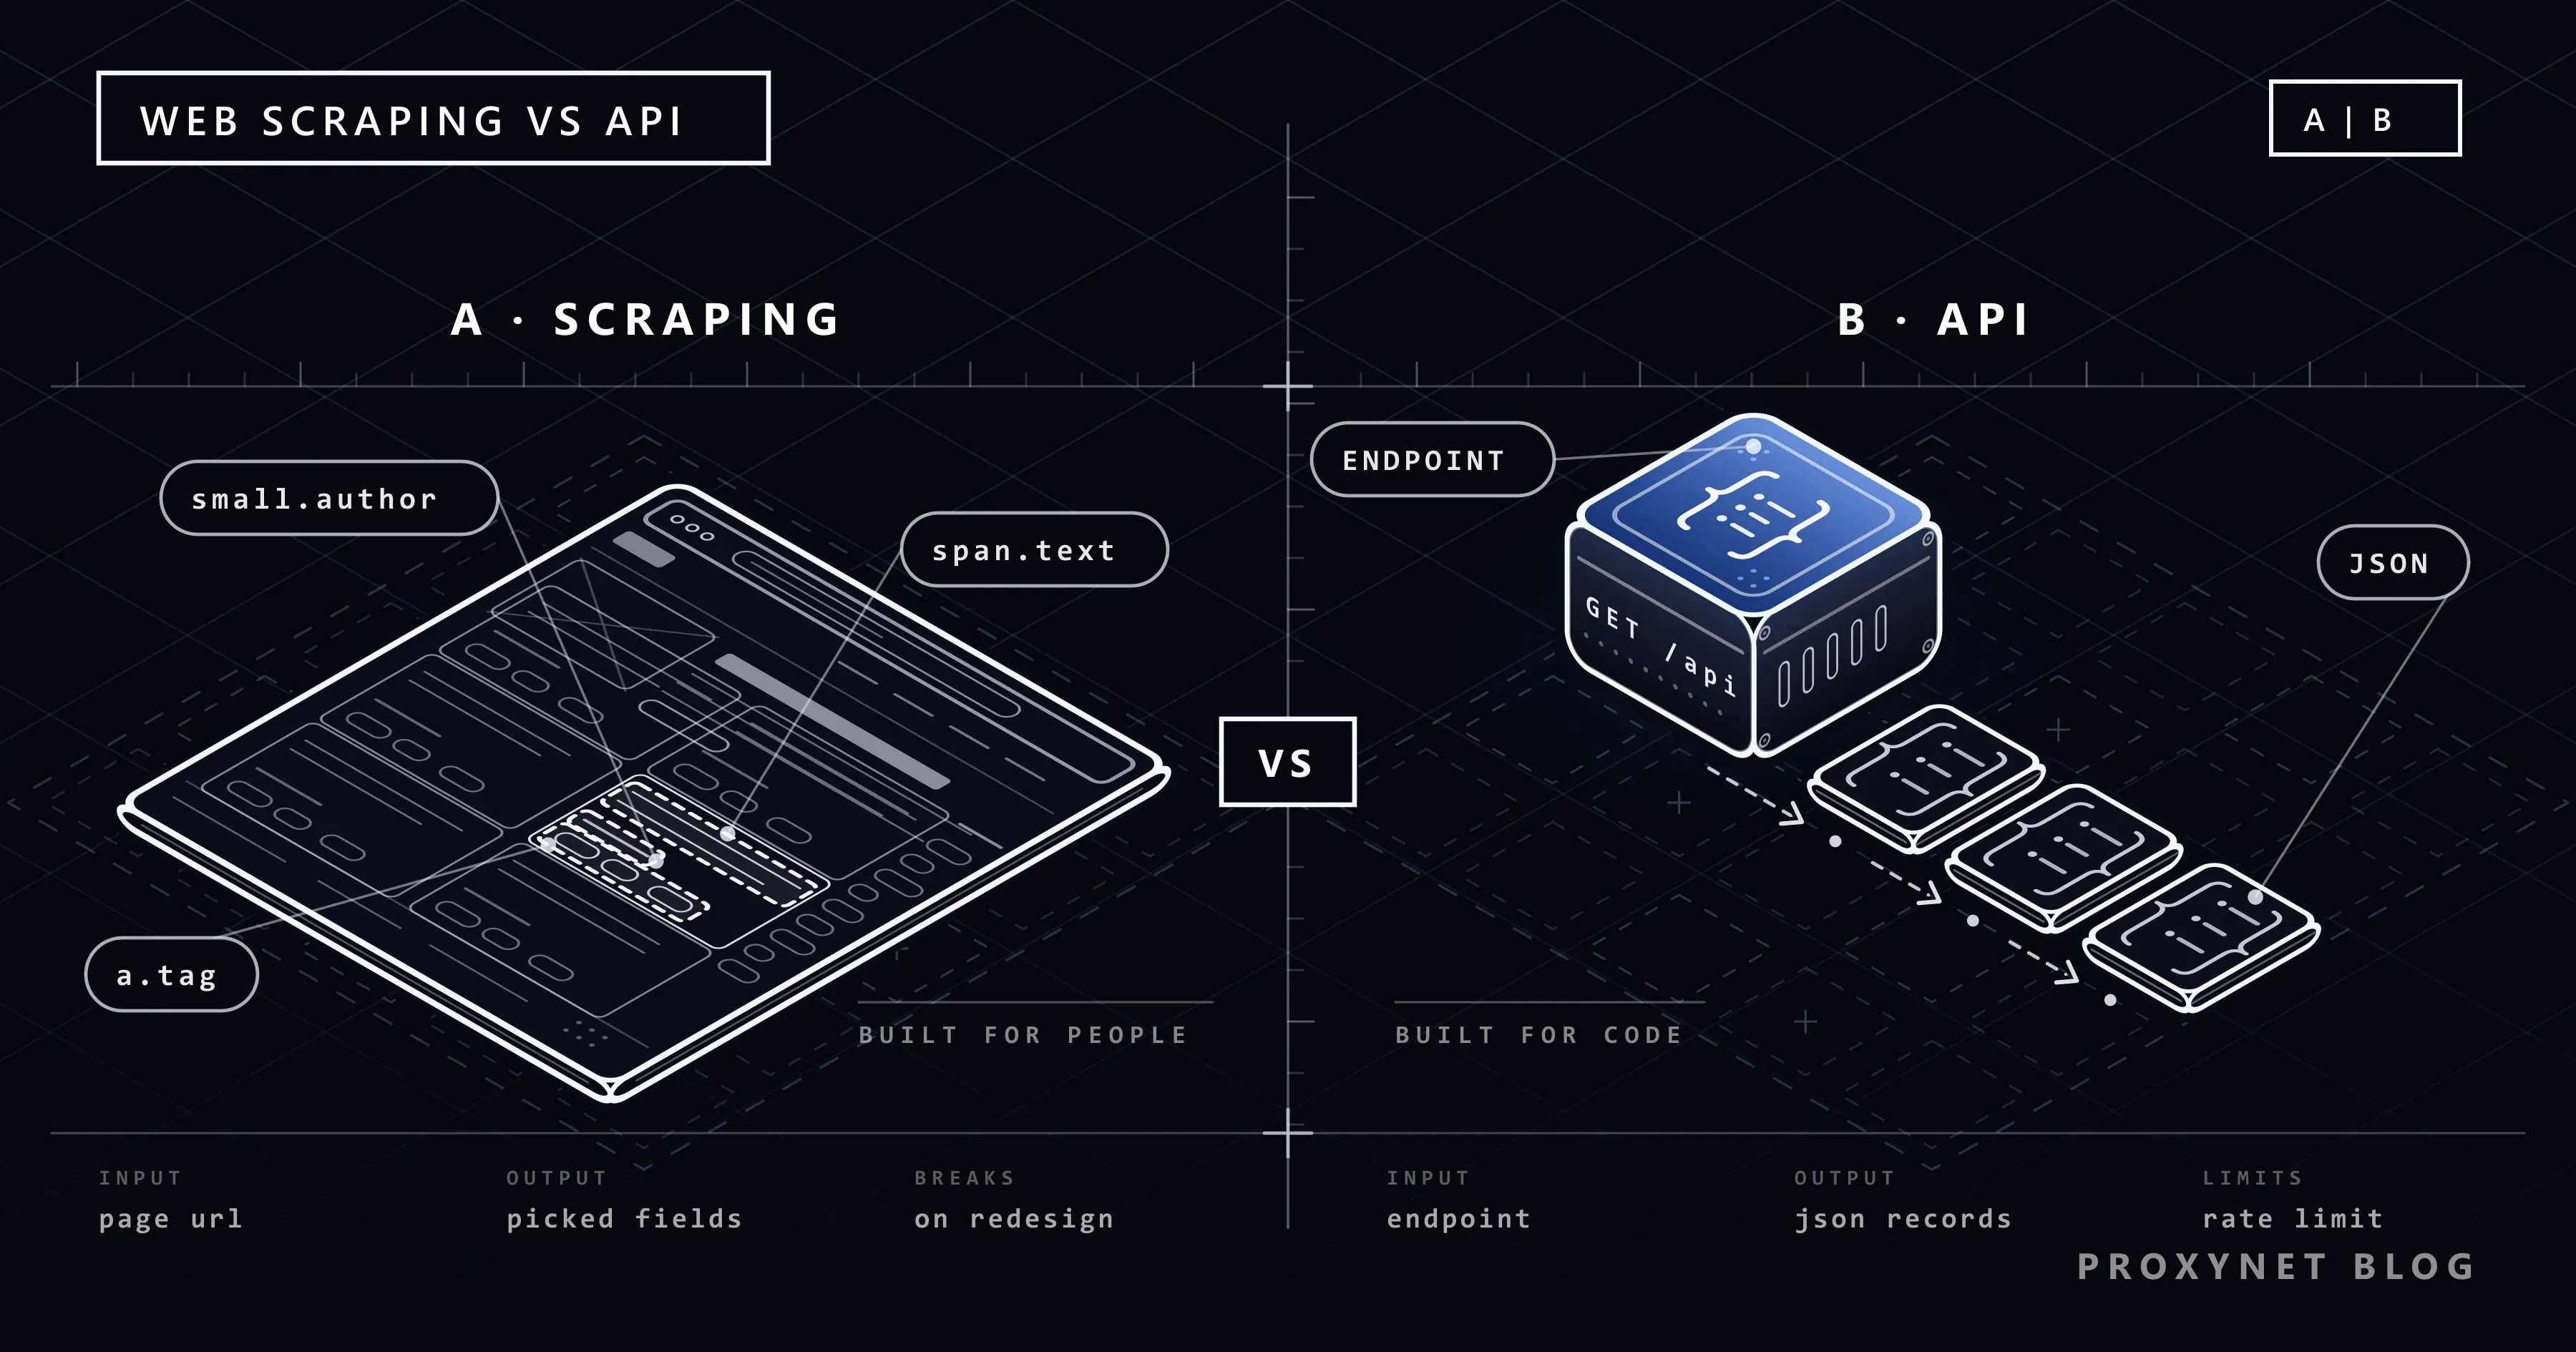
API (مخفف application programming interface، رابط برنامهنویسی نرمافزار کاربردی) مجموعهای از درخواستهای ثابت است که یک برنامه میتواند به برنامه دیگری بفرستد، همراه با قاعدههایی که میگویند چه باید فرستاد و چه برمیگردد. در وب این معمولاً یعنی یک درخواست HTTP به آدرسی مانند https://api.github.com/repos/python/cpython/issues و یک پاسخ JSON. صفحه وب برای خواندن انسان نوشته میشود؛ پاسخ API برای این نوشته میشود که برنامه آن را تجزیه کند.
یک API وب از چند بخش ساخته میشود:
- نقطه اتصال (endpoint): آدرس یک عملیات، مانند «فهرست issueها» یا «دریافت یک محصول».
- پارامترها: آنچه درخواست میکنید، برای نمونه
state=openیاpage=2. - احراز هویت: کلید API، توکن یا OAuth که به سرویس میگوید چه کسی درخواست میفرستد. بسیاری از APIها به درخواستهای ناشناس هم پاسخ میدهند، اما با سقف پایینتر.
- قالب پاسخ: معمولاً JSON، با نام فیلدهایی که از یک فراخوانی به فراخوانی دیگر ثابت میمانند.
- محدودیتها و شرایط: در هر ساعت چند فراخوانی مجاز است و با داده چه کارهایی میتوانید بکنید.
- مستندات: بسیاری از APIها توصیفی ماشینخوان در قالب OpenAPI منتشر میکنند. مشخصات OpenAPI (OpenAPI Specification) که از 10 سپتامبر 2026 در نسخه 3.2.1 است، خود را توصیف رابطی استاندارد و مستقل از زبان برنامهنویسی برای APIهای HTTP میداند، تا انسانها و ابزارها بدون خواندن کد منبع یک سرویس بفهمند آن سرویس چه چیزی ارائه میدهد.
همه APIها به روی همه باز نیستند. بانکها، صرافیها و بسیاری از سرویسهای تجاری فقط به صاحبان حساب کلید میدهند و برخی فقط درخواستهایی را میپذیرند که از آدرسهای IP از پیش ثبتشده بیایند؛ در ادامه به این موضوع برمیگردیم.
وب اسکرپینگ چیست؟
وب اسکرپینگ یعنی برنامهای همان کاری را بکند که مرورگر شما میکند و در پایان فقط داده را نگه دارد: صفحه را دانلود میکند، HTML را میخواند و مقدارها را با انتخابگرهای CSS یا XPath از آن بیرون میکشد. سایت با هیچچیز موافقت نکرده است. چیدمان صفحه تنها «قرارداد» است و سایت میتواند هر روز که بخواهد، به دلایل خودش، آن را تغییر دهد. کل این زنجیره را در وب اسکرپینگ چیست و چگونه کار میکند؟ مرور کردهایم و تفاوت دنبال کردن پیوندها با استخراج فیلدها را در وب اسکرپینگ و خزش وب: تفاوت در چیست؟.
نقطه قوت اسکرپینگ دامنه دسترسی آن است: هر چیزی که بازدیدکننده بدون ورود به حساب میبیند در دسترس است. بهایش این است که هر مقدار باید دوباره در میان کد HTML صفحه پیدا شود، کدی که برای طراحی ساخته شده است، نه برای داده.
هر راه چگونه به داده میرسد؟
از دور، گامها شبیه هم به نظر میرسند. تفاوت در این است که شکل پاسخ را چه کسی تعیین میکند.
با API:
- مستندات را میخوانید و نقطه اتصال، پارامترها و محدودیتها را پیدا میکنید.
- اگر API کلید بخواهد، کلید میگیرید و آن را به جای کد، در یک متغیر محیطی نگه میدارید.
- درخواستی با پارامترها میفرستید، برای نمونه
?page=2. - سرویس JSON برمیگرداند با فیلدهای نامدار، و معمولاً یک فیلد یا هدر که به صفحه بعد اشاره میکند.
- فیلدها را با نامشان میخوانید. بازطراحی وبسایت به آنها دست نمیزند.
با اسکرپینگ:
- صفحه و HTML پشت آن را بررسی میکنید تا جای هر مقدار را پیدا کنید.
robots.txtو شرایط استفاده سایت را بررسی میکنید (راهنمای خواندن robots.txt).- صفحه را همانطور که مرورگر دانلود میکند دانلود میکنید، یا اگر محتوا را JavaScript میسازد، آن را در یک مرورگر headless رندر میکنید.
- HTML را تجزیه میکنید و هر مقدار را با انتخابگری مانند
span.textبرمیدارید (تجزیه داده (parsing) چیست). - مقدارها را پاکسازی و ذخیره میکنید و هر بار که چیدمان عوض شود کار را تکرار میکنید.
تفاوت وب اسکرپینگ و API: جدول مقایسه
| API رسمی | نقطه اتصال JSON خود سایت | وب اسکرپینگ (HTML) | |
|---|---|---|---|
| پوشش داده | فقط فیلدهایی که ارائهدهنده در اختیار میگذارد | آنچه صفحه برای ساختن خودش لازم دارد | هر چیزی که بازدیدکننده میبیند |
| قالب | JSON یا XML مستند | JSON، بدون مستندات | HTMLای که خودتان تجزیه میکنید |
| پایداری | نسخهدار؛ تغییرها اعلام میشوند | ممکن است با هر انتشار تازه فرانتاند سایت عوض شود | با تغییر چیدمان از کار میافتد |
| محدودیت نرخ | منتشر میشود، اغلب در هدرهای پاسخ | منتشر نمیشود؛ آهنگ را خودتان تعیین میکنید | منتشر نمیشود؛ آهنگ را خودتان تعیین میکنید |
| احراز هویت | کلید، توکن یا OAuth؛ گاهی لیست سفید IP | گاهی کوکیها یا توکنهای نشست صفحه | برای صفحههای عمومی معمولاً هیچ |
| شرایط استفاده | شرایط API میگوید چه چیزی مجاز است | شرایط سایت حاکم است؛ سایت قولی نداده است | شرایط سایت و robots.txt حاکماند |
| هزینه | سهمیه رایگان یا پلن پولی | بدون کارمزد؛ وقت و ترافیک شما | بدون کارمزد؛ توسعه، نگهداری، پروکسی، رندر |
| نگهداری | کم؛ وقتی نسخهای بازنشسته شود بهروزرسانی میکنید | متوسط؛ مراقب تغییر نام فیلدها باشید | زیاد؛ انتخابگرها پس از بازطراحی از کار میافتند |
| اندازه هر پاسخ | کوچک، فقط داده | کوچک، فقط داده | کل صفحه با چیدمان و نشانهگذاری |
| محتوایی که JavaScript میسازد | مشکلی نیست | مشکلی نیست | مرورگر headless یا راه JSON لازم است |
نمونه REST API در GitHub نشان میدهد «نسخهدار» در عمل یعنی چه. هر درخواست میتواند نسخه مورد نظرش را در هدر X-GitHub-Api-Version نام ببرد و وقتی نسخه تازهای منتشر میشود، نسخه قبلی دستکم 24 ماه دیگر پشتیبانی میشود (نسخههای REST API در GitHub). حذف یا تغییر نام یک فیلد پاسخ در آنجا تغییری ناسازگار (breaking change) به شمار میآید و باید تا نسخه بعدی صبر کند. درخواستهایی که این هدر را ندارند هنوز نسخه 2022-11-28 را میگیرند که تا 10 مارس 2028 پشتیبانی میشود. هیچ وبسایتی چنین قولی درباره کلاسهای CSS خود نمیدهد.
یک داده از دو راه: نمونه آزمودهشده با Python
سایت تمرینی quotes.toscrape.com محیطی آزمایشی است که برای تمرین اسکرپینگ ساخته شده و در پانویس آن نام Zyte آمده است. این سایت 100 نقلقول را در ده صفحه HTML، از /page/1/ تا /page/10/، فهرست میکند. نسخه اسکرول بیپایان آن در /scroll همان نقلقولها را از یک نقطه اتصال JSON، یعنی /api/quotes?page=N، بارگذاری میکند و هر پاسخ یک فیلد has_next دارد. سایت برای /robots.txt کد 404 برمیگرداند که طبق استاندارد robots.txt یعنی هیچ قاعده خزشی وجود ندارد؛ با این حال اسکریپت میان صفحهها یک ثانیه صبر میکند.
اسکریپت هر 100 نقلقول را با یک نشست مشترک از هر دو راه جمع میکند. هر درخواست یک مهلت زمانی (timeout) دارد، نشست در User-Agent خودش را معرفی میکند و در پاسخهای 429 و 5xx درخواست را دوباره میفرستد:
"""The same quotes twice: parsed from the HTML pages and read from the JSON endpoint."""
import os
import time

import requests
from bs4 import BeautifulSoup
from requests.adapters import HTTPAdapter
from urllib3.util import Retry

BASE = "https://quotes.toscrape.com"
DELAY = 1.0  # pause between pages


def make_session():
    retry = Retry(
        total=4,
        backoff_factor=1,  # waits 0, 2, 4, 8 s between attempts
        status_forcelist=[429, 500, 502, 503, 504],
        allowed_methods=["GET"],
        respect_retry_after_header=True,  # a Retry-After header replaces the backoff
    )
    session = requests.Session()
    session.mount("https://", HTTPAdapter(max_retries=retry))
    session.mount("http://", HTTPAdapter(max_retries=retry))
    session.headers["User-Agent"] = "quotes-compare/1.0 (contact: you@example.com)"
    proxy = os.environ.get("PROXY_URL")  # e.g. http://user:pass@pr.proxynet.io:8000
    if proxy:
        session.proxies = {"http": proxy, "https": proxy}
    return session


def scrape_html(session):
    """Route 1: download each HTML page and pick the fields out with CSS selectors."""
    quotes, page, size = [], 1, 0
    while True:
        r = session.get(f"{BASE}/page/{page}/", timeout=(5, 20))
        r.raise_for_status()
        size += len(r.content)
        soup = BeautifulSoup(r.content, "lxml")
        for q in soup.select("div.quote"):
            quotes.append({
                "text": q.select_one("span.text").get_text(strip=True),
                "author": q.select_one("small.author").get_text(strip=True),
                "tags": [a.get_text(strip=True) for a in q.select("a.tag")],
            })
        if soup.select_one("li.next > a") is None:  # no "Next" link: last page
            return quotes, page, size
        page += 1
        time.sleep(DELAY)


def fetch_api(session):
    """Route 2: call the JSON endpoint the site's own scroll page uses."""
    quotes, page, size = [], 1, 0
    while True:
        r = session.get(f"{BASE}/api/quotes", params={"page": page}, timeout=(5, 20))
        r.raise_for_status()
        size += len(r.content)
        data = r.json()
        for q in data["quotes"]:
            quotes.append({
                "text": q["text"],
                "author": q["author"]["name"],
                "tags": q["tags"],
            })
        if not data["has_next"]:  # the API says when the list ends
            return quotes, page, size
        page += 1
        time.sleep(DELAY)


session = make_session()
results = {}
for name, collect in (("HTML", scrape_html), ("API", fetch_api)):
    quotes, pages, size = collect(session)
    results[name] = quotes
    print(f"{name}: {len(quotes)} quotes from {pages} pages, {size / 1024:.1f} KiB")

print("same data:", results["HTML"] == results["API"])
print(results["API"][0])
خروجی، که چه با اجرای مستقیم و چه از راه یک پروکسی آزمایشی محلی تعریفشده در PROXY_URL یکسان بود:
HTML: 100 quotes from 10 pages, 106.1 KiB
API: 100 quotes from 10 pages, 30.2 KiB
same data: True
{'text': '“The world as we have created it is a process of our thinking. It cannot be changed without changing our thinking.”', 'author': 'Albert Einstein', 'tags': ['change', 'deep-thoughts', 'thinking', 'world']}
100 رکورد دو راه فیلد به فیلد با هم یکی بودند. راه HTML برای آنها 106.1 KiB دانلود کرد و راه JSON برای همانها 30.2 KiB؛ هر دو عدد پس از باز شدن فشردهسازی شمرده شدهاند. صفحههای HTML چیدمان، منوی ناوبری، ستون کناری برچسبها و نشانهگذاری اطراف هر مقدار را هم با خود دارند. از راه پروکسی، همان یک Session هر 20 درخواست را از یک تونل پروکسی فرستاد.
دو حلقه نشانه توقف را در جاهای متفاوتی میجویند. راه HTML وقتی میایستد که صفحه پیوند «Next» نداشته باشد، اما API آن را صریحاً با has_next: false اعلام میکند. شمردن صفحهها تا رسیدن به خطا در این سایت جواب نمیدهد: /page/11/ با 200 و بدون هیچ نقلقولی پاسخ میدهد و /api/quotes?page=11 هم با 200 و یک فهرست خالی. شرطهای توقف دیگر در صفحهبندی چیست و چگونه همه صفحهها را اسکرپ کنیم؟ آمده است.
تنظیم تلاش دوباره به کار هر دو راه میآید. نشست را به یک سرور آزمایشی محلی فرستادیم که دو بار با 429 و هدر Retry-After: 2 پاسخ داد: نشست هر بار دو ثانیه صبر کرد، پاسخ سوم را پس از 4.0 ثانیه برگرداند و کد فراخواننده هرگز 429 را ندید. در برابر سروری که پیوسته و بدون آن هدر 503 برمیگرداند، به ترتیب 0، 2، 4 و 8 ثانیه صبر کرد و پس از 14 ثانیه requests.exceptions.RetryError را با پیام too many 503 error responses بالا انداخت. تنظیم allowed_methods=["GET"] عمدی است: RFC 9110 میگوید کلاینت نباید درخواستی را که متد آن idempotent نیست (یعنی تکرارش ممکن است اثر تازهای بگذارد)، مانند POST، خودکار دوباره بفرستد.
فیلدهایی که یک راه دارد و راه دیگر ندارد
دو راه دقیقاً فیلدهای یکسانی ندارند. هر رکورد API پیوند Goodreads نویسنده و یک slug را هم دارد که صفحه فهرست نشان نمیدهد:
{
  "author": {
    "goodreads_link": "/author/show/9810.Albert_Einstein",
    "name": "Albert Einstein",
    "slug": "Albert-Einstein"
  },
  "tags": [
    "change",
    "deep-thoughts",
    "thinking",
    "world"
  ],
  "text": "“The world as we have created it is a process of our thinking. It cannot be changed without changing our thinking.”"
}
در مقابل، صفحه فهرست HTML هر نویسنده را به یک صفحه «about» با تاریخ و محل تولد پیوند میدهد (برای اینشتین March 14, 1879 و in Ulm, Germany). این صفحه همتای JSON ندارد: /api/author/Albert-Einstein کد 404 برمیگرداند. پروژههای واقعی هم کموبیش همینطورند. API شناسههای داخلی و موجودی دقیق انبار را دارد و صفحه متن، نشانها و قیمتهایی را که بازدیدکنندگان واقعاً میبینند.
یک API هم میتواند به شکلهایی خطا بدهد که از دید کد عجیب به نظر میرسند. آدرس /api/quotes?page=abc وضعیت 500 را همراه با یک صفحه خطای HTML برمیگرداند و فراخوانی .json() روی این بدنه، خطای JSONDecodeError: Expecting value: line 1 column 1 (char 0) را بالا میاندازد. در اسکریپت بالا آداپتور تلاش دوباره زودتر 500 را میگیرد و کار به RetryError ختم میشود؛ بدون آن، raise_for_status() پیش از .json() اجرا را متوقف میکند. علتهای دیگر این خطا در رفع خطای JSONDecodeError: Expecting Value در Python آمده است.
نقطههای اتصال پنهان JSON: راه میانه
بسیاری از صفحههایی که HTML ساده به نظر میرسند دادهشان را در پسزمینه بهصورت JSON بارگذاری میکنند، درست همانطور که صفحه /scroll در بالا /api/quotes را فرا میخواند. این درخواستها را در ابزارهای توسعهدهنده مرورگر پیدا میکنید: پنل شبکه (Network) را باز کنید، فیلتر Fetch/XHR را انتخاب کنید، صفحه را دوباره بارگذاری کنید و دنبال پاسخهایی بگردید که داده شما را دارند. روش کامل در صفحههای ایستا و پویا در وب اسکرپینگ آمده است و تبدیل یک درخواست کپیشده به کد Python در ارسال JSON با POST در Python Requests.
چنین نقطه اتصالی اغلب حد وسط معقولی است: داده ساختاریافته با کسری از حجم صفحه. با این حال API عمومی نیست، پس چند قاعده برقرار است:
- فقط داده عمومی. اگر درخواست فقط با کوکی نشست حسابی کار کند که با آن وارد شدهاید، داده عمومی نیست و اسکریپت زمانبندیشدهای که با کوکی شما اجرا شود حساب خودتان را به خطر میاندازد.
- بدون قول پایداری. نام فیلدها و پارامترها ممکن است با هر انتشار فرانتاند سایت، بدون اطلاع قبلی، عوض شوند. در هر اجرا شکل پاسخ را بررسی کنید و وقتی کلیدی وجود ندارد، با خطای آشکار متوقف شوید.
- همان شرایط، همان آهنگ. شرایط استفاده سایت و
robots.txtهمانطور که بر صفحهها حاکماند، بر این نقطه اتصال هم حاکماند. درخواستهای JSON کوچکاند و همین باعث میشود بهراحتی خیلی سریعتر از یک انسان فرستاده شوند؛ فاصله میان درخواستها را نگه دارید. - در برابر پارامترهای امضاشده بایستید. اگر درخواست امضا یا توکنی کوتاهعمر دارد که اسکریپت صفحه آن را میسازد، برای استفاده دوباره ساخته نشده است. دنبال API رسمی بگردید یا با سایت تماس بگیرید.
- راه مستند را ترجیح دهید. اگر سایت برای همان داده API رسمی دارد، به جای این راه از آن استفاده کنید.
جنبه حقوقی جمعآوری داده عمومی، که از کشوری به کشور دیگر فرق میکند، در آیا اسکرپینگ وب قانونی است؟ آمده است.
API اسکرپینگ چیست؟
«API اسکرپینگ» (scraping API) نام نوعی سرویس تجاری هم هست که با API خود یک وبسایت فرق دارد. شما آدرس صفحه هدف را به سرویس میفرستید؛ سرویس صفحه را برایتان دانلود میکند، اغلب در یک مرورگر headless و از راه استخر پروکسی خودش، درخواستهای ناموفق را دوباره امتحان میکند و HTML را، یا فیلدهایی را که از آن تجزیه کرده است، بهصورت JSON برمیگرداند. آن را مثل یک API فرا میخوانید، اما داده همچنان از اسکرپ کردن صفحه هدف میآید.
این سرویسها به کار تیمهایی میآیند که از سایتهای زیادی صفحه لازم دارند اما نمیخواهند خودشان مرورگر و چرخش پروکسی را اداره کنند. هزینه را بر اساس درخواستهایی میگیرند که از راه آنها میفرستید؛ پس مقایسه میان این صورتحساب و هزینه اجرای اسکرپر خودتان است. این سرویسها تغییر نمیدهند که قاعدههای چه کسی حاکم است: شرایط استفاده سایت هدف و robots.txt همچنان برای شما الزامآورند و API اسکرپینگ دلیلی برای کنار گذاشتن API رسمیای نیست که از قبل وجود دارد.
محدودیت نرخ، خطای 429 و کلیدهای API
API رسمی محدودیتهایش را به شما میگوید، اغلب در تکتک پاسخها. REST API در GitHub بدون احراز هویت 60 درخواست در ساعت را مجاز میداند که بر اساس آدرس IP مبدأ شمرده میشود، و با توکن دسترسی شخصی (personal access token) تا 5,000 درخواست در ساعت (محدودیت نرخ REST API در GitHub). نقطه اتصال /rate_limit نشان میدهد در کجای سهمیه هستید و فراخوانی آن از محدودیت اصلی کم نمیکند:
import requests

r = requests.get(
    "https://api.github.com/rate_limit",
    headers={"Accept": "application/vnd.github+json"},
    timeout=(5, 20),
)
core = r.json()["resources"]["core"]
print(r.status_code, "limit:", core["limit"], "remaining:", core["remaining"], "reset:", core["reset"])
print({k: v for k, v in r.headers.items() if k.lower().startswith("x-ratelimit")})200 limit: 60 remaining: 58 reset: 1790650244
{'X-RateLimit-Limit': '60', 'X-RateLimit-Remaining': '58', 'X-RateLimit-Used': '2', 'X-RateLimit-Resource': 'core', 'X-RateLimit-Reset': '1790650244'}مقدار reset یک برچسب زمانی Unix بر حسب UTC است؛ در این اجرا ساعت 02:50:44 روز 29 سپتامبر 2026. در آن ساعت پیشتر دو درخواست از آدرس ما فرستاده شده بود. وقتی سهمیه تمام شود، GitHub با 403 یا 429 پاسخ میدهد و x-ratelimit-remaining صفر است؛ باید تا زمانی که در x-ratelimit-reset آمده صبر کنید. برای محدودیتهای ثانویه، هر جا بتواند retry-after را میفرستد و در غیر این صورت از شما میخواهد دستکم یک دقیقه صبر کنید.
اینجاست که تلاش دوباره عمومی کم میآورد. نشست اسکریپت ما 429 را دوباره امتحان میکند اما 403 را نه، و 14 ثانیه انتظار در برابر پنجرهای که هر ساعت یک بار صفر میشود بیفایده است. در کار با API، هدرها را بخوانید و تا زمان reset صبر کنید.
خود این کد وضعیت از RFC 6585 میآید: 429 Too Many Requests یعنی کلاینت در بازه زمانی مشخصی درخواستهای بیش از حد فرستاده است؛ پاسخ باید وضعیت را توضیح دهد و میتواند Retry-After را هم داشته باشد. این RFC عمداً باز میگذارد که سرور کلاینت را چگونه شناسایی کند و درخواستها را چگونه بشمارد؛ پس محدودیت ممکن است بهازای هر IP، هر کلید یا هر حساب باشد. در RFC 9110 هدر Retry-After یا یک تاریخ تعریف شده است یا تعدادی ثانیه، و urllib3 هر دو شکل را میخواند. وبسایتی که اسکرپ میکنید بهندرت چیزی از اینها را منتشر میکند؛ پس آهنگ را خودتان تعیین کنید و با نخستین 429 سرعت را کم کنید (توضیح خطای 429 Too Many Requests).
چرا برخی APIها آدرس IP ثابت میخواهند؟
برخی APIها علاوه بر اینکه درخواست چه کلیدی دارد، بررسی میکنند از کجا میآید. صرافیها، بازارگاهها، بانکها و بسیاری از سرویسهای داده تجاری اجازه میدهند یک یا چند آدرس IP را برای یک کلید ثبت کنید و درخواستی که از هر آدرس دیگری بیاید، حتی با کلید درست، رد میشود. این ترتیب به محض اینکه اسکریپت جایی با آدرس متغیر اجرا شود از کار میافتد: یک خط اینترنت خانگی، لپتاپی که همراه شما جابهجا میشود، یا یک تابع serverless بدون IP خروجی ثابت. پیدا کردن آدرس خروجی و چهار راه ثابت کردن آن را در IP ثابت برای API: خطای مجوز IP چگونه رفع میشود؟ توضیح دادهایم؛ مورد صرافیها در لیست سفید IP برای API صرافی رمزارز آمده است.
در یکپارچهسازیهایی که پرداخت، داده کارت یا پرونده سلامت جابهجا میکنند، آدرس ثبتشده باید سرور یا خط خودتان باشد. برای محیطهای آزمایشی و کلاینتهایی که داده حساس جابهجا نمیکنند، پروکسی با آدرس ثابت هم کار را انجام میدهد: پروکسی ISP یا پروکسی دیتاسنتر به اسکریپت شما یک IP خروجی میدهد که یک بار آن را نزد API ثبت میکنید. این محصولها که بهازای هر IP فروخته میشوند بهصورت پیشفرض به سایت هدف مشخصی محدودند؛ پس هنگام سفارش، میزبان (host) API را اعلام میکنید. دسترسی به همه وبسایتها یک افزونه پولی است.
نیاز اسکرپینگ برعکس است: صفحههای زیاد در طول زمان، گاهی همانطور که بازدیدکنندگان کشوری دیگر آنها را میبینند. پروکسی چرخشی برای همین کار ساخته شده است. هیچکدام از این دو نوع پروکسی قاعدههای بالا را تغییر نمیدهد: پروکسی آدرس را عوض میکند، نه شرایط استفاده سایت یا نرخ درخواستی را که باید رعایت کنید.
هزینه هر روش چقدر است؟
API رسمی. قیمت در صفحه تعرفههای ارائهدهنده آمده است. برخی APIها تا سقف یک سهمیه رایگاناند، برخی از نخستین فراخوانی هزینه میگیرند و برخی فقط با قرارداد تجاری در دسترساند. هزینه مهندسی کم است: کلاینت یک API مستند JSON، مانند نمونه بالا، اغلب چند ده خط است. هزینههای پنهان یکی سهمیه است، چون کاری که فراخوانیهایی بیش از سقف پلن لازم دارد یا باید منتظر بماند یا پول بدهد، و دیگری اختیار ارائهدهنده: شرایط، قیمتها و دسترسی ممکن است عوض شوند و یک API ممکن است بسته شود.
اسکرپینگ. به سایت پولی پرداخت نمیشود، اما همهچیز دیگر بر عهده شماست: نوشتن تجزیهگر (parser)، درست کردن آن پس از بازطراحیها، مرورگر headless وقتی JavaScript صفحه را میسازد (بسیار سنگینتر از یک درخواست ساده؛ بخش هزینه در صفحههای ایستا و پویا در وب اسکرپینگ را ببینید)، پروکسی وقتی حجم کار یا کشور هدف آن را لازم کند، و پایشی که بفهمد کی یک انتخابگر بیصدا چیزی برنمیگرداند. حجم داده هم روی هم انباشته میشود. در آزمون ما راه HTML برای همان رکوردها حدود 3.5 برابر بایت دانلود کرد و اگر پلن پروکسی شما بر اساس ترافیک محاسبه میشود، این نسبت در صورتحساب دیده میشود.
سرویس API اسکرپینگ. بهازای هر درخواست هزینه میپردازید و مرورگر یا پروکسی را خودتان اداره نمیکنید. اگر سرویس HTML خام برگرداند، نگهداری بخش تجزیه همچنان با شماست.
چه زمانی اسکرپینگ و API را با هم ترکیب کنید؟
به کار بردن هر دو رایج است و معمولاً از یکی از چهار الگوی زیر پیروی میکند:
- API برای فهرست، صفحهها برای جزئیات. در نمونه ما، 100 نقلقول را از نقطه اتصال JSON میگیرید و برای تاریخهای تولد، به هر یک از 50 صفحه نویسنده یک بار سر میزنید.
- API برای داده خودتان، صفحهها برای نمای عمومی. API فروشندگان آگهیهای شما را با شناسه و موجودی برمیگرداند؛ صفحه عمومی محصول نشانها و تعداد نظرهایی را نشان میدهد که مشتریان میبینند. این دو را بر اساس شناسه محصول به هم پیوند دهید.
- API برای رکورد، صفحه برای یک کشور. ممکن است API یک قیمت فهرست برگرداند، در حالی که بازدیدکنندهای در کشوری دیگر در صفحه ارز محلی، مالیات و تخفیف ویژه میبیند. این مقایسه به صفحهای نیاز دارد که از همان کشور بارگذاری شده باشد.
- صفحه بهعنوان وارسی API. یک اسکرپر کوچک که روزانه چند صفحه را نمونهبرداری میکند تأیید میکند که آنچه API برمیگرداند هنوز با آنچه بازدیدکنندگان میبینند یکی است.
کاربردها
- پایش قیمت و موجودی: آگهیهای خودتان از راه API پلتفرم، صفحههای عمومی رقبا با یک اسکرپر (رصد قیمت رقبا).
- داده مخزن، issue و انتشار: API در GitHub با صفحهبندی از راه هدر
Link(صفحهبندی در API). - داده صرافی و رباتهای معامله: کلید API وابسته به یک آدرس ثبتشده (لیست سفید IP برای API صرافی).
- یک جدول در صفحهگسترده، یک بار: یک تابع وارد کردن داده در صفحهگسترده یا چند خط Python (استخراج داده از وبسایت).
- نگه داشتن نتیجهها: همان رکوردها در CSV، JSON یا SQLite (ذخیره دادههای اسکرپینگ).
- پیدا کردن همه صفحهها پیش از استخراج: خزندهای که آدرسها را در سراسر سایت کشف میکند (خزنده وب).
- جمعآوری بزرگ و زمانبندیشده: صفها، کنترل نرخ و خروجی در چند کشور (استخراج داده).
اشتباههای رایج
- اسکرپ کردن سایتی که برای همان داده API دارد. بار نگهداری را بیدلیل به دوش میگیرید و شاید شرایط API تنها شرایطی باشد که دسترسی خودکار را مجاز میداند.
- API عمومی دانستن یک نقطه اتصال پنهان. نه نسخه دارد و نه قولی؛ در هر اجرا شکل پاسخ را بررسی کنید.
- یک قاعده تلاش دوباره برای همه خطاها. انتظار کوتاه برای یک
503گذرا مناسب است؛ سهمیه ساعتی بهx-ratelimit-resetنیاز دارد و تنظیم بالا403را اصلاً دوباره امتحان نمیکند. - تلاش دوباره خودکار برای درخواستهای POST. ممکن است یک سفارش یا پیام دو بار فرستاده شود؛ تلاش دوباره خودکار را به GET محدود کنید.
- فراخوانی
.json()روی هر چیزی که برمیگردد. اول کد وضعیت وContent-Typeرا بررسی کنید؛ صفحه خطا HTML است. - حلقه روی شماره صفحهها تا وقتی چیزی خطا بدهد. در سایت تمرینی صفحه 11 با
200و بدون محتوا پاسخ داد؛has_nextیا پیوند «Next» را دنبال کنید. - نگه داشتن کلید API در کد. آن را از یک متغیر محیطی بخوانید و بیرون از مخزن نگه دارید.
- مقصر دانستن سایت برای خطای پروکسی. آداپتور تلاش دوباره، ورود ناموفق به پروکسی را هم دوباره امتحان میکند: با رمز پروکسی نادرست، اسکریپت ما در 14 ثانیه پنج بار تلاش کرد و سپس
ProxyErrorرا با407 Proxy Authentication Requiredبالا انداخت. اول اطلاعات ورود را بررسی کنید.
راهنمای انتخاب
| نیاز | پیشنهاد |
|---|---|
| سایت API رسمی با فیلدهای مورد نیاز شما دارد | از API استفاده کنید؛ اول محدودیتها و شرایط آن را بخوانید |
| API وجود دارد اما برخی فیلدها را ندارد | API برای رکوردهای اصلی، اسکرپینگ برای بقیه، پیوندخورده با یک شناسه |
| API وجود ندارد و داده در HTML است | Requests و BeautifulSoup، با فاصله میان صفحهها |
| API وجود ندارد و داده را JavaScript بارگذاری میکند | اول درخواست JSON را پیدا کنید؛ مرورگر headless فقط اگر نتوان آن را دوباره به کار برد |
| API فقط درخواستهای IPهای ثبتشده را میپذیرد | یک آدرس خروجی ثابت: سرور خودتان، یا برای کلاینتهای بدون داده حساس پروکسی ISP یا دیتاسنتر |
| سهمیه API هر ساعت تمام میشود | هدرهای محدودیت نرخ را بخوانید، فراخوانیها را پخش کنید، پلن بالاتری بخواهید |
| صفحه از سایتهای زیاد بدون زیرساخت خودتان | سرویس API اسکرپینگ، اگر شرایط سایتهای هدف اجازه جمعآوری بدهد |
| هزاران صفحه در روز از سایتهایی که بررسیشان کردهاید | اسکرپر خودتان با پروکسی چرخشی و سقف درخواست برای هر سایت |
پرسشهای متداول
تفاوت وب اسکرپینگ و API چیست؟
API راهی است که ارائهدهنده برای برنامهها ساخته است: درخواستی مستند میفرستید و داده ساختاریافته پس میگیرید، با محدودیتها و شرایطی که منتشر شدهاند. وب اسکرپینگ صفحههایی را میخواند که برای انسانها ساخته شدهاند و مقدارها را از HTML بیرون میکشد. API تعیین میکند کدام فیلدها را بگیرید؛ اسکرپینگ به هر چیز دیدهشدنی میرسد اما با تغییر صفحه از کار میافتد.
آیا وب اسکرپینگ از استفاده از API بهتر است؟
بهطور کلی نه. وقتی API رسمی فیلدهای مورد نیاز شما را برمیگرداند، اسکریپتی که بر پایه آن نوشته شود زودتر آماده میشود و با بازطراحیهای سایت هم کار میکند. اسکرپینگ وقتی انتخاب بهتری است که API وجود ندارد، دادهای را که صفحه نشان میدهد کنار میگذارد یا سهمیه یا قیمتش با کار شما جور نیست.
آیا همه وبسایتها API دارند؟
نه. بسیاری از سایتها اصلاً API عمومی ندارند و بسیاری هم APIای دارند که فقط بخشی از دادهشان را پوشش میدهد یا حساب تجاری لازم دارد. برخی سایتها صفحههایشان را از نقطههای اتصال داخلی JSON بارگذاری میکنند؛ میتوان با احتیاط از آنها برای داده عمومی استفاده کرد، اما API منتشرشده نیستند.
آیا استفاده از API پنهان یک وبسایت قانونی است؟
به داده، شرایط استفاده سایت و قانون جایی بستگی دارد که شما و سایت در آن فعالیت میکنید. خواندن داده عمومی از نقطه اتصالی که خود صفحه فرا میخواند از نظر فنی با خواندن صفحه یکی است و همان شرایط بر آن حاکم است. ورود با حساب شخص دیگر، گذشتن از سازوکارهای کنترل دسترسی یا جمعآوری داده شخصی پرسشهای دیگری پیش میکشد. نمای کلی در آیا اسکرپینگ وب قانونی است؟ آمده است.
آیا API اسکرپینگ همان API وبسایت است؟
نه. API یک وبسایت را خود سایت منتشر میکند و دادهاش را در قالبی ثابت برمیگرداند. API اسکرپینگ سرویسی از طرف سوم است که صفحه هدف را برایتان دانلود میکند و HTML یا فیلدهای تجزیهشده را برمیگرداند. داده همچنان از صفحه میآید و شرایط استفاده سایت هدف همچنان برقرار است.
برای فراخوانی API به پروکسی نیاز دارم؟
معمولاً نه. وقتی به پروکسی نیاز دارید که API فقط درخواستهای آدرسهای IP ثبتشده را بپذیرد و آدرس خودتان عوض شود، یا وقتی باید ببینید یک API یا صفحه از کشوری دیگر چه پاسخی میدهد. برای پرداخت و دیگر یکپارچهسازیهای حساس، به جای آن آدرس سرور خودتان را ثبت کنید.
خلاصه
API راهی است که ارائهدهنده برای برنامهها ساخته، با قالب نسخهدار و محدودیتهای مکتوب. اسکرپینگ چیزی را میخواند که ارائهدهنده برای انسانها ساخته است؛ به هر چیز دیدهشدنی میرسد و با تغییر صفحه از کار میافتد. اول ببینید API رسمی هست یا نه، اگر نیست با احتیاط از نقطه اتصال JSON خود سایت استفاده کنید و آنچه میماند را از HTML اسکرپ کنید. وقتی یک API آدرس ثابت میخواهد یا یک کار اسکرپینگ به حجم بالا در چند کشور نیاز دارد، پلنهای پروکسی ما را مقایسه کنید.