


































Fiyatları JavaScript ile yüklenen bir mağazadan veri topluyorsunuz. Requests ile gelen HTML boş, siz de Playwright'a geçiyorsunuz ve sayfa sorunsuz açılıyor. İş büyüyünce trafiği proxy üzerinden geçirmek gerekiyor ve ilk deneme net::ERR_TUNNEL_CONNECTION_FAILED ya da "Browser does not support socks5 proxy authentication" hatasıyla bitiyor. Playwright'ın Türkçe anlatımları aracı neredeyse hep test otomasyonu açısından ele aldığı için proxy tarafı çoğu zaman İngilizce forum başlıklarından toplanıyor.
Bu yazıda Playwright'ın ne olduğunu kısaca tanımlıyor, Python ve Node.js kurulumunu yan yana veriyor, ardından proxy'ye geçiyoruz: tarayıcı seviyesi ve context seviyesi proxy farkı, kullanıcı adı ve parolayla kimlik doğrulama, Chromium'un SOCKS5 davranışı, rotating ve sticky seçimi, görsel ve font isteklerini keserek trafik tasarrufu, IP doğrulama ve hata tablosu. Yazıdaki bütün örnekleri Playwright 1.63 ve Chromium ile, kimlik doğrulamalı yerel bir test proxy'si üzerinden çalıştırdık.
Playwright nedir?
Playwright, Microsoft'un geliştirdiği açık kaynaklı bir tarayıcı otomasyon kütüphanesidir. Gerçek bir tarayıcıyı koddan açar, adrese gider, tıklar, form doldurur, sayfadaki öğeleri okur. Chromium, Firefox ve WebKit motorlarını aynı API ile yönetir; Node.js, Python, Java ve .NET için resmî sürümleri vardır.
Aracın çıkış noktası uçtan uca testtir ve Türkçe kaynakların çoğu onu bu yüzüyle anlatır. Veri ekipleri açısından değeri başka yerdedir: JavaScript ile oluşturulan sayfayı gerçek bir tarayıcıda çalıştırır, öğe görünene kadar kendiliğinden bekler, sayfanın arka planda yaptığı API çağrılarını dinlemenize ve gereksiz istekleri kesmenize izin verir. Sayfanın gerçekten tarayıcı gerektirip gerektirmediğini anlamak için önce Statik ve Dinamik Sayfalar: Headless Tarayıcı Gerekir mi? yazımıza bakın; veri sayfa kaynağında ya da bir JSON uç noktasında duruyorsa tarayıcı açmak gereksiz maliyettir.
Playwright ile yapılan işler kabaca dört başlıkta toplanır:
- Dinamik sayfalardan veri toplama (ürün listesi, fiyat, stok, yorum sayısı).
- Kendi sitenizin ya da uygulamanızın farklı ülkelerden nasıl göründüğünü test etme.
- Ekran görüntüsü ve PDF üretimi.
- Yapay zekâ ajanlarına tarayıcı kullandırma. Bu son başlığın ayrıntısı Playwright MCP Nedir? Kurulum ve Proxy Ayarları yazımızda.
Selenium ile mimari farkları ve hangi projede hangisinin seçileceğini ayrı bir yazıda ele aldık: Playwright ve Selenium Farkı: Hangisini Seçmeli?.
Playwright kurulumu nasıl yapılır?
Kurulum iki adımdır: önce kütüphane, sonra tarayıcı ikilileri. Playwright sistemde kurulu Chrome'u değil, kendi indirdiği ve sürümünü sabitlediği tarayıcıları kullanır; "kütüphaneyi kurdum ama tarayıcı bulunamadı" hatasının nedeni ikinci adımın atlanmasıdır.
Python tarafında sanal ortam açıp kütüphaneyi kurun. Resmî Python kütüphane belgesi aynı adımları poetry ve uv için de verir.
python -m venv .venv
source .venv/bin/activate        # Windows: .venv\Scripts\activate
pip install playwright
playwright install chromium
Node.js tarafında:
npm init -y
npm install playwright
npx playwright install chromium
install komutuna tarayıcı adı vermezseniz üç motor birden iner. Scraping işlerinde genellikle yalnızca Chromium yeterlidir. Test yazacaksanız Python'da pytest-playwright, Node.js'te @playwright/test paketleri önerilir; veri toplama için yukarıdaki yalın kütüphane kurulumu yeter.
Python'da iki API vardır: sync_api ve async_api. Tek tek sayfa açan betiklerde senkron (sync) sürüm daha okunaklıdır. Aynı anda birden çok sayfa işleyecekseniz asyncio tabanlı sürümü kullanın; yazının sonundaki tam örnek öyle yazıldı.
Playwright'ta proxy nasıl tanımlanır?
Playwright'ın ağ belgesindeki HTTP Proxy bölümü iki seviye tanımlar: proxy ya bütün tarayıcı için ya da her context için ayrı verilir. İki durumda da aynı nesne kullanılır:
| Alan | Zorunlu mu? | Anlamı |
|---|---|---|
server | Evet | http://pr.proxynet.io:8000 ya da socks5://sunucu:port. Şema yazılmazsa HTTP proxy sayılır |
username | Hayır | HTTP proxy kimlik doğrulaması için kullanıcı adı |
password | Hayır | HTTP proxy kimlik doğrulaması için parola |
bypass | Hayır | Proxy'den geçmeyecek alan adları, virgülle ayrılır (.ornek.com, api.sirketiniz.com) |
Python'da tarayıcı seviyesinde tanım şöyle görünür:
from playwright.sync_api import sync_playwright

PROXY = {
    "server": "http://pr.proxynet.io:8000",
    "username": "user",
    "password": "pass",
}

with sync_playwright() as p:
    browser = p.chromium.launch(proxy=PROXY)
    page = browser.new_page()
    page.goto("https://httpbin.org/ip")
    print(page.inner_text("body"))  # proxy'nin çıkış IP'si
    browser.close()
Aynı işin Node.js karşılığı:
import { chromium } from "playwright";

const browser = await chromium.launch({
  proxy: {
    server: "http://pr.proxynet.io:8000",
    username: "user",
    password: "pass",
  },
});
const page = await browser.newPage();
await page.goto("https://httpbin.org/ip");
console.log(await page.innerText("body")); // proxy'nin çıkış IP'si
await browser.close();
Dikkat edilecek nokta kimlik bilgisinin yeridir. cURL ya da Requests alışkanlığıyla http://user:pass@pr.proxynet.io:8000 yazmak burada işe yaramaz: Playwright server değerinden yalnızca şemayı, sunucuyu ve portu alır, adresin içindeki kullanıcı adı ve parolayı tarayıcıya iletmez. Kimlik bilgisi her zaman username ve password alanlarına yazılır. Bunun bir yan faydası da vardır: parolada @ ya da : gibi karakterler varsa URL kodlamasıyla uğraşmazsınız. İki doğrulama yönteminin genel mantığı Proxy Kimlik Doğrulama: User:Pass ve IP Whitelist yazımızda.
Tarayıcı seviyesi ile context seviyesi proxy arasındaki fark nedir?
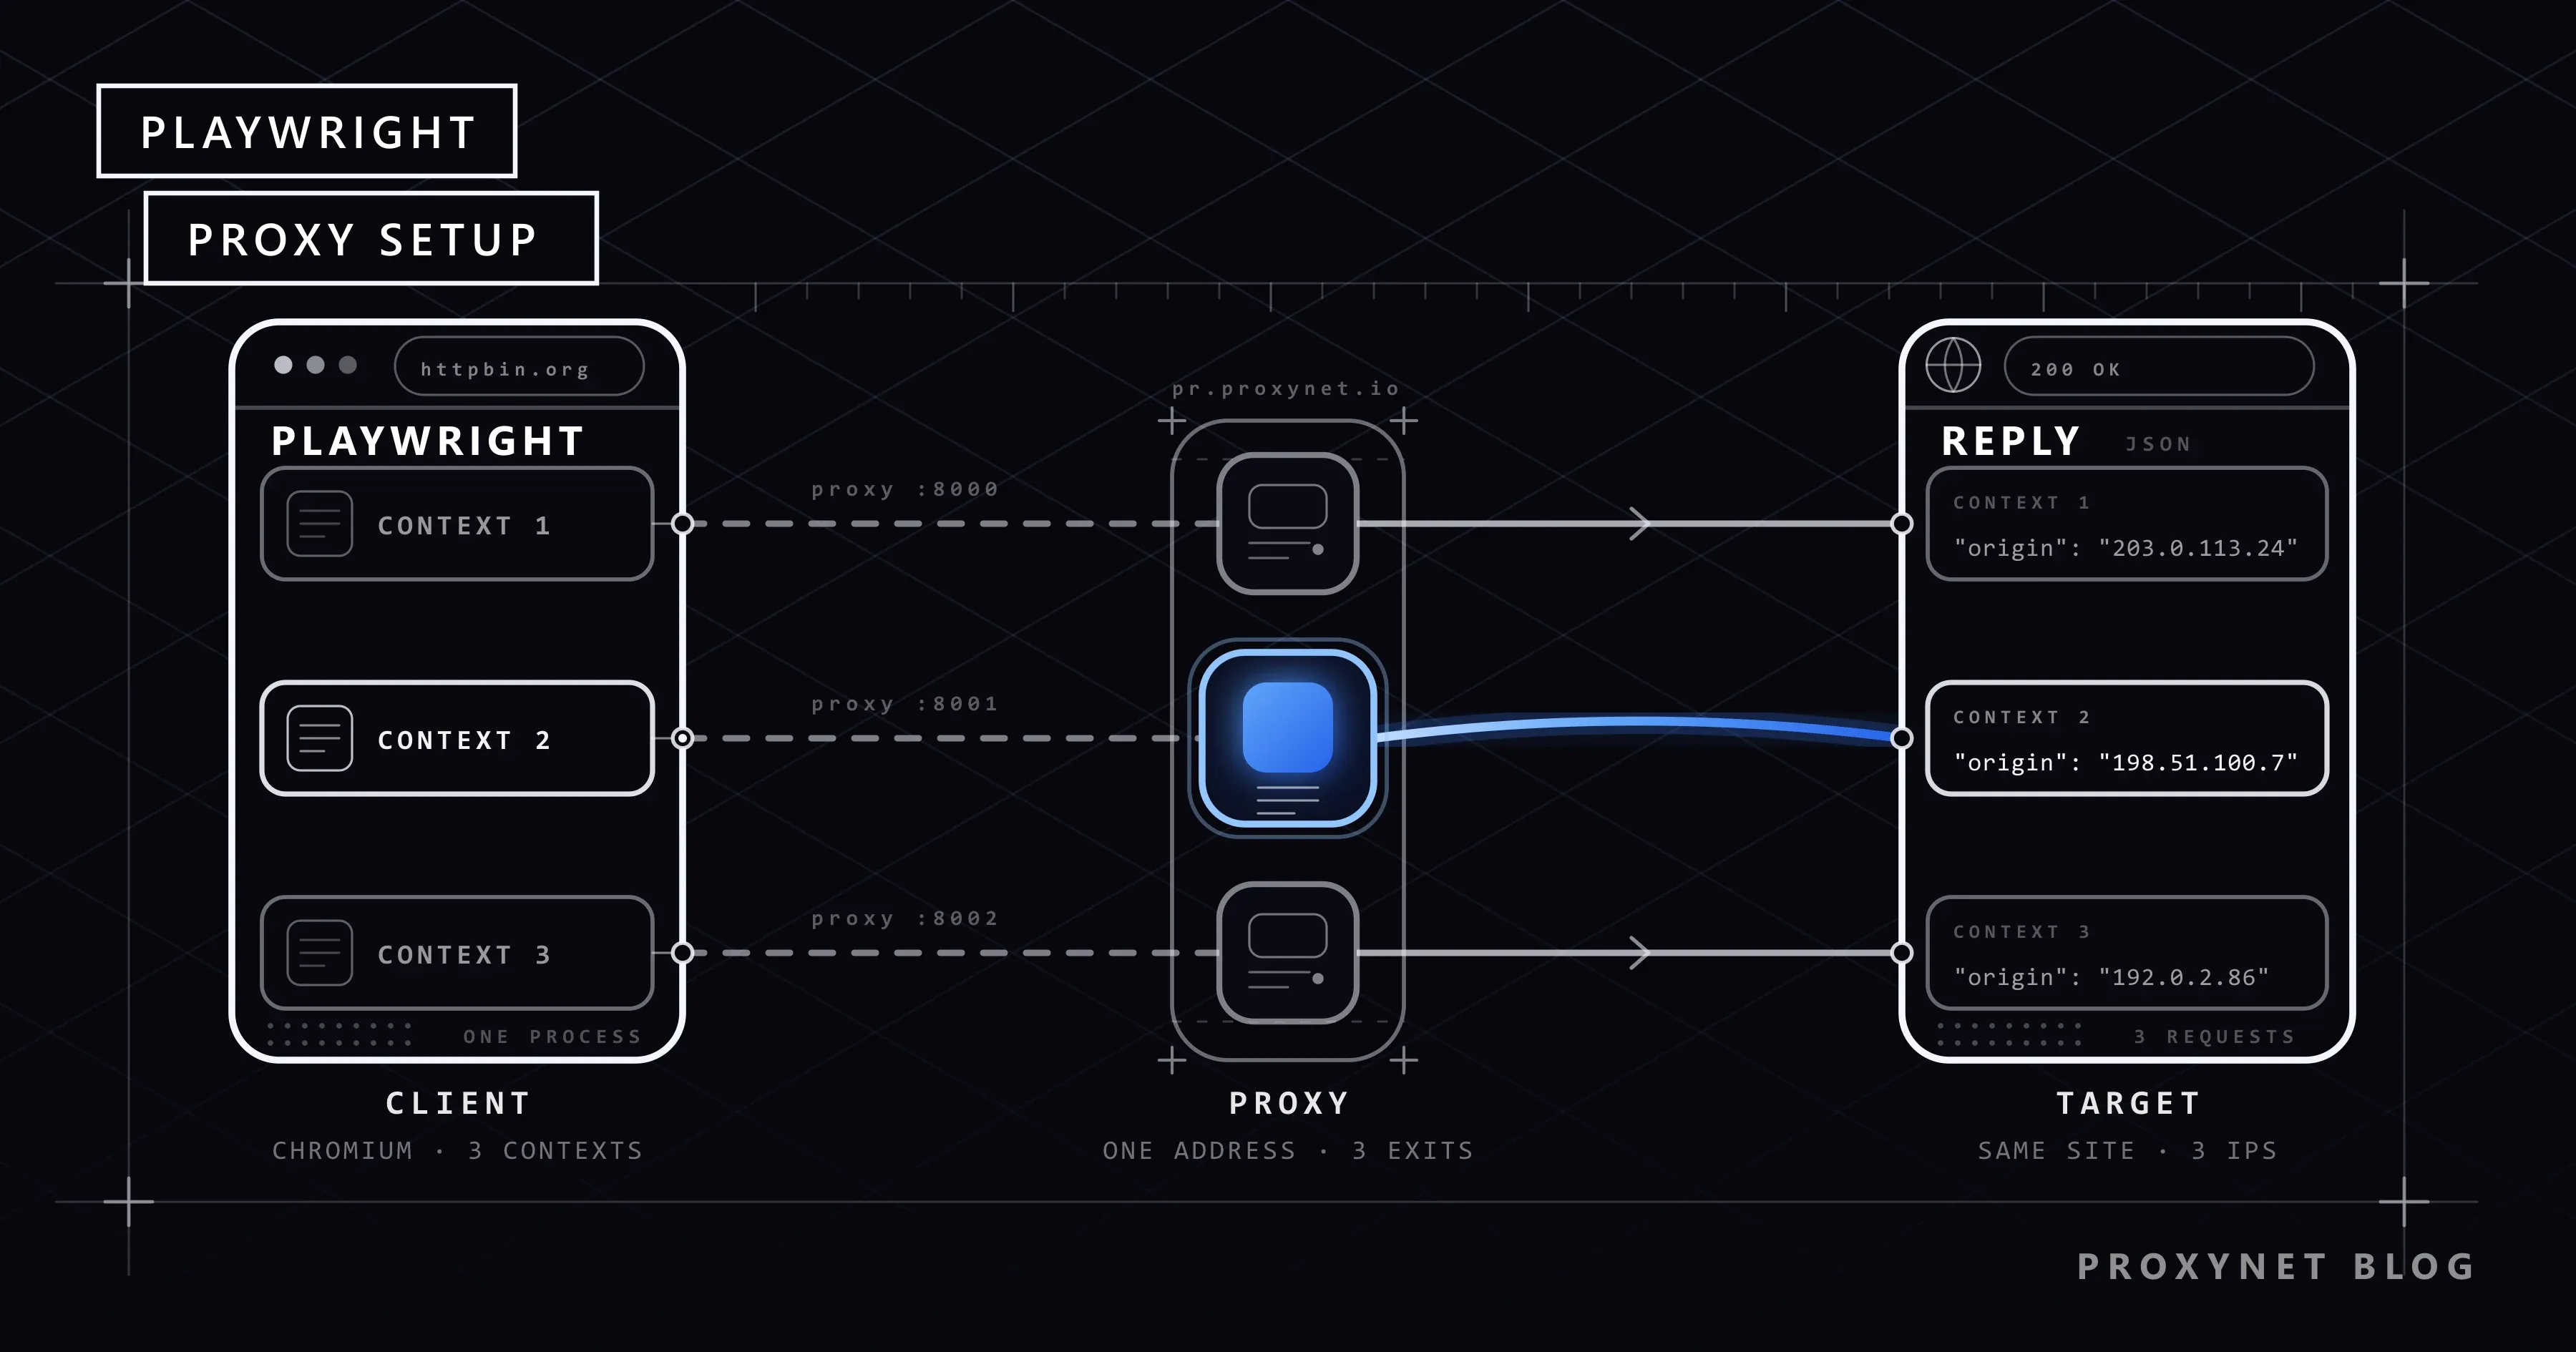
Context, Playwright'ta birbirinden yalıtılmış tarayıcı oturumudur: kendi çerezleri, kendi önbelleği, kendi yerel depolaması vardır. Gizli pencereye benzer, ama tek tarayıcı sürecinde onlarcası aynı anda açılabilir ve açılması yeni bir tarayıcı başlatmaktan çok daha ucuzdur.
Proxy'yi launch() yerine new_context() çağrısına verdiğinizde ayar yalnızca o context'i bağlar:
from playwright.sync_api import sync_playwright

PROXIES = [
    {"server": "http://pr.proxynet.io:8000", "username": "user", "password": "pass"},
    {"server": "http://pr.proxynet.io:8001", "username": "user", "password": "pass"},
]

with sync_playwright() as p:
    browser = p.chromium.launch()  # tarayıcı bir kez açılır, proxy'siz
    for proxy in PROXIES:
        context = browser.new_context(proxy=proxy)  # her context kendi proxy'siyle
        page = context.new_page()
        page.goto("https://httpbin.org/ip")
        print(proxy["server"], page.inner_text("body"))
        context.close()  # çerezler ve önbellek de context'le birlikte silinir
    browser.close()
Bu örneği iki ayrı yerel proxy ile çalıştırdığımızda her context'in isteği kendi proxy'sinin kaydına düştü; proxy verilmeyen üçüncü bir context ise doğrudan bağlandı. Eski rehberlerde Windows'ta Chromium için launch() çağrısına http://per-context gibi yer tutucu bir proxy yazmanız gerektiği söylenir. Bu, Playwright'ın eski sürümlerine ait bir kısıttı ve Ağustos 2024'te koddan çıkarıldı; güncel belgede de böyle bir not yok. Playwright 1.63 ile Windows 11 üzerinde örnek yer tutucu olmadan çalıştı.
Tarayıcı seviyesi (launch) | Context seviyesi (new_context) | |
|---|---|---|
| Kapsam | Bütün context'ler ve sayfalar | Yalnızca o context |
| Tek tarayıcıda farklı IP | Hayır | Evet, context başına ayrı proxy |
| Proxy değiştirmek için | Tarayıcıyı kapatıp yeniden açarsınız | Context'i kapatıp yenisini açarsınız |
| Çerez ve oturum | Context'ler yine ayrıdır | Proxy ile birlikte yalıtılır |
| Uygun olduğu iş | Tek çıkış noktası yeten betikler, testler | Çok sayıda bağımsız oturum, ülke karşılaştırması |
Pratik kural şudur: bir oturum, bir context, bir IP. Aynı context içinde proxy değiştirmenin yolu yoktur ve olmaması iyidir; çerezleri aynı kalıp IP'si değişen bir oturum, hedef site açısından tutarsız bir ziyaretçidir.
Playwright SOCKS5 proxy ile çalışır mı?
Çalışır, ama kullanıcı adı ve parola olmadan. server değerine socks5:// şemasıyla adres verip username eklediğinizde Playwright tarayıcıyı hiç başlatmadan şu hatayı verir:
BrowserType.launch: Browser does not support socks5 proxy authenticationAynı denetim new_context() için de geçerlidir. Nedeni Chromium'un kendisidir: Chromium'un proxy belgesi SOCKSv5 için hiçbir kimlik doğrulama yönteminin desteklenmediğini açıkça yazar. Bunu yazım günü yerel bir SOCKS5 sunucusuyla denedik. Chromium'un el sıkışma mesajında sunduğu tek yöntem 0x00, yani "kimlik doğrulama yok" oldu; RFC 1929'daki kullanıcı adı ve parola yöntemi (0x02) listede yoktu. Kimlik bilgisini adresin içine gömmek (socks5://user:pass@...) de sonucu değiştirmedi: Playwright bu kısmı attı, sunucu doğrulama istediği için bağlantı net::ERR_SOCKS_CONNECTION_FAILED ile kapandı. Kimlik doğrulama istemeyen SOCKS5 sunucusunda ise sayfa sorunsuz açıldı.
Çözüm, kimliği parolayla değil IP adresinizle kanıtlamaktır. Betiğin çalıştığı sunucunun çıkış IP'sini proxy panelinde IP whitelist'e ekler, server alanını tek başına verirsiniz:
from playwright.sync_api import sync_playwright

with sync_playwright() as p:
    # Kullanıcı adı ve parola yok: çıkış IP'niz panelde IP whitelist'e eklenmiş olmalı
    browser = p.chromium.launch(proxy={"server": "socks5://pr.proxynet.io:1080"})
    page = browser.new_page()
    page.goto("https://httpbin.org/ip")
    print(page.inner_text("body"))
    browser.close()
Test kayıtlarımızda Chromium SOCKS5 sunucusuna IP adresi değil alan adı gönderdi; yani DNS çözümlemesi proxy tarafında yapılıyor ve cURL'deki socks5h:// ayrımına burada gerek kalmıyor. Sayfa açmak için çoğu zaman HTTP proxy yeterlidir, çünkü HTTPS trafiği zaten CONNECT tüneliyle taşınır. SOCKS5'i ne zaman tercih edeceğinizi SOCKS ve HTTP Proxy Farkı: Hangisini Seçmeli? yazımızda anlattık; ürün tarafı SOCKS5 Proxy sayfasında.
Rotating mı sticky mi: hangi işte hangisi?
Tarayıcı, tek bir HTTP isteği atan betikten farklı davranır. Bir sayfa yüklenirken ana belge, betikler, stil dosyaları, görseller ve API çağrıları için farklı alan adlarına ayrı bağlantılar açılır. Her bağlantıda çıkış IP'sini değiştiren bir ağ geçidinde bu bağlantılar farklı IP'lerden çıkabilir. Birbirinden bağımsız sayfaları tararken bu bir sorun değildir. Giriş yapılan, sepet tutan ya da çok adımlı form içeren akışlarda ise oturumun ortasında IP değişmesi, sitenin oturumu sonlandırmasına yol açabilir.
- Bağımsız sayfalar (ürün listesi, kategori, arama sonucu): Rotating Proxy uygundur. Rotasyonu ağ geçidi yapar, kodunuzda proxy listesi tutmazsınız. Rotasyonun işleyişi IP Rotasyonu Nedir ve Nasıl Çalışır? yazımızda.
- Oturum gerektiren akışlar (kendi hesabınızla giriş, çok adımlı işlem): Sticky Proxy ile context'in ömrü boyunca aynı IP korunur. Sticky oturum bilgisini panelden alır, context'in
proxyalanına yazarsınız. - Ülkeye göre değişen içerik: her ülke için ayrı context açıp ilgili ülkenin çıkış noktasını verirsiniz; tek tarayıcı, yan yana karşılaştırma.
Context başına proxy vermek kendi başına bir rotasyon düzenidir: context'i kapatıp yenisini açtığınızda çerezler de IP de birlikte yenilenir.
Görsel ve fontları engelleyerek trafik nasıl azaltılır?
Residential Proxy trafiği GB üzerinden faturalanır ve tarayıcı, düz bir HTTP istemcisinin indirmediği her şeyi indirir: ürün görselleri, web fontları, videolar. İhtiyacınız olan fiyat ve başlıksa bu baytlara para ödemenin anlamı yoktur. Playwright'ın route mekanizması isteği ağa çıkmadan önce yakalar; kaynak türüne göre iptal edebilirsiniz.
from playwright.sync_api import sync_playwright

BLOCKED = {"image", "media", "font"}


def filter_resources(route):
    if route.request.resource_type in BLOCKED:
        route.abort()
    else:
        route.continue_()


with sync_playwright() as p:
    browser = p.chromium.launch(proxy={
        "server": "http://pr.proxynet.io:8000",
        "username": "user",
        "password": "pass",
    })
    page = browser.new_page()
    page.route("**/*", filter_resources)
    page.goto("https://books.toscrape.com/")
    print(page.locator("article.product_pod h3 a").first.get_attribute("title"))
    browser.close()
Kazancın büyüklüğü sayfaya göre değişir; genel bir yüzde vermek yanıltıcı olur. Kendi hedefinizde ölçmek için aynı sayfayı filtreli ve filtresiz açıp proxy panelindeki trafik sayacını karşılaştırın. İki uyarı: stil dosyalarını (stylesheet) ve betikleri (script) engellemek sayfanın içeriği oluşturmasını bozabilir, bu yüzden listeyi görsel, medya ve fontla sınırlı tutun. Bu teknik bir tasarruf yöntemidir, sitenin koruma betiklerini ayıklamak için kullanılmaz.
Daha büyük tasarruf çoğu zaman tarayıcının dinlediği trafiğin içindedir. Dinamik sayfalar veriyi genellikle bir JSON uç noktasından çeker ve Playwright bu yanıtı doğrudan okumanıza izin verir:
from playwright.sync_api import sync_playwright

with sync_playwright() as p:
    browser = p.chromium.launch(proxy={
        "server": "http://pr.proxynet.io:8000",
        "username": "user",
        "password": "pass",
    })
    page = browser.new_page()
    with page.expect_response("**/api/quotes?page=1") as info:
        page.goto("https://quotes.toscrape.com/scroll")
    data = info.value.json()
    for quote in data["quotes"][:3]:
        print(quote["author"]["name"], "-", quote["text"][:60])
    browser.close()
HTML'i seçicilerle ayrıştırmak yerine yapılandırılmış veriyi alırsınız. Uç nokta kimlik gerektirmiyorsa bir sonraki adımda tarayıcıyı tamamen bırakıp o adresi düz bir HTTP istemcisiyle çağırmak da mümkündür.
Proxy'nin çalıştığı nasıl doğrulanır?
Üç kontrol yeterlidir:
https://httpbin.org/ipadresini Playwright ile açın ve dönen IP'yi kendi IP'nizle karşılaştırın. Farklıysa trafik proxy'den geçiyordur.- Aynı adresi proxy verilmemiş bir context'le açın. İki sonuç aynıysa
proxynesnesi yanlış çağrıya verilmiş ya da alan adıbypasslistesine girmiştir. - Ülke hedefliyorsanız IP'nin konumunu bir coğrafi konum servisinde kontrol edin. Veritabanları arasındaki farkların nedenini IP Adresinden Konum Bulunur mu, Neden Yanlış Gösterir? yazımızda anlattık.
Proxy'yi Playwright'tan bağımsız sınamak, sorunun kodda mı ağda mı olduğunu ayırır. Komut satırı testleri Proxy Çalışıyor mu? Proxy Nasıl Test Edilir? yazımızda.
Tam örnek: eşzamanlı context'ler, yeniden deneme ve kaynak engelleme
Aşağıdaki betik JavaScript ile oluşturulan altı sayfayı tarar. Aynı anda en fazla üç context açık tutar, her denemede temiz bir context ve proxy bağlantısı kullanır, görsel ve fontları engeller, geçici hatalarda rastgele bileşenli üstel beklemeyle yeniden dener. Proxy'ye hiç ulaşılamadığını gösteren hatalarda ise yeniden denemez, çünkü bu durumu düzeltecek olan bekleme değil ayardır.
import asyncio
import random

from playwright.async_api import Error, async_playwright

PROXY = {
    "server": "http://pr.proxynet.io:8000",
    "username": "user",
    "password": "pass",
}
URLS = [f"https://quotes.toscrape.com/js/page/{n}/" for n in range(1, 7)]
BLOCKED = {"image", "media", "font"}
CONCURRENCY = 3  # aynı anda açık context sayısı
ATTEMPTS = 3
# Yeniden denemenin sonucu değiştirmeyeceği hatalar: önce ayar düzeltilir
FATAL = ("ERR_PROXY_CONNECTION_FAILED", "ERR_TUNNEL_CONNECTION_FAILED", "ERR_SOCKS_CONNECTION_FAILED")


async def filter_resources(route):
    if route.request.resource_type in BLOCKED:
        await route.abort()
    else:
        await route.continue_()


async def scrape(browser, url, limit):
    async with limit:
        for attempt in range(ATTEMPTS):
            context = await browser.new_context(proxy=PROXY)  # her denemede temiz oturum
            try:
                page = await context.new_page()
                await page.route("**/*", filter_resources)
                response = await page.goto(url, timeout=30_000)
                if response is None or response.status >= 400:
                    raise Error(f"HTTP {response.status if response else 'yanıt yok'}")
                quotes = page.locator("div.quote span.text")
                await quotes.first.wait_for(timeout=10_000)  # JavaScript içeriği basana kadar bekle
                return url, await quotes.all_inner_texts()
            except Error as exc:  # TimeoutError da Error'dan türer
                if any(code in str(exc) for code in FATAL):
                    raise
                if attempt == ATTEMPTS - 1:
                    raise
                await asyncio.sleep(2**attempt + random.random())
            finally:
                await context.close()


async def main():
    async with async_playwright() as p:
        browser = await p.chromium.launch()
        limit = asyncio.Semaphore(CONCURRENCY)
        results = await asyncio.gather(
            *(scrape(browser, url, limit) for url in URLS), return_exceptions=True
        )
        await browser.close()
    for url, result in zip(URLS, results):
        if isinstance(result, Exception):
            print(url, "HATA:", str(result).splitlines()[0])
        else:
            print(url, len(result[1]), "alıntı")


asyncio.run(main())
Yerel test proxy'mizde altı sayfanın hepsi onar alıntıyla döndü; proxy portunu bilerek yanlış yazdığımızda betik yeniden denemeden ERR_PROXY_CONNECTION_FAILED ile durdu. Gerçek bir işte iki ekleme yapın. 429 ve 503 yanıtlarında Retry-After başlığına uyan yeniden deneme mantığını Scraping'de HTTP Hata Kodları yazımızdaki örnekten alın; burada tekrar etmiyoruz. Eşzamanlılığı da belleğe göre ayarlayın: her context ve sayfa bellek tüketir, CONCURRENCY değerini küçük başlatıp sunucunuzu izleyerek artırın. Bekleme stratejilerinin ayrıntısı (neden networkidle yerine öğe beklenir) yukarıda andığımız statik ve dinamik sayfalar yazısında.
Hata tablosu: ERR_PROXY_CONNECTION_FAILED, ERR_TUNNEL_CONNECTION_FAILED, 407
Aşağıdaki satırların her birini yerel test proxy'sinde bilerek ürettik.
| Gördüğünüz | Ne anlama gelir | Yapılacak |
|---|---|---|
net::ERR_PROXY_CONNECTION_FAILED | Proxy sunucusuna TCP bağlantısı kurulamadı: adres ya da port yanlış, güvenlik duvarı çıkışı kesiyor | server değerini ve portu kontrol edin, aynı adresi cURL ile deneyin |
net::ERR_TUNNEL_CONNECTION_FAILED | Proxy'ye ulaşıldı ama CONNECT isteğine 200 dışında yanıt geldi: kimlik doğrulama reddedildi (407) ya da proxy hedefe ulaşamadı (502) | Önce kimlik bilgisini, sonra hedef adresi kontrol edin |
HTTPS adreste goto zaman aşımı, proxy kaydında 407 | Kullanıcı adı ya da parola yanlış ya da hiç verilmemiş. Denememizde requestfailed olayı ERR_TUNNEL_CONNECTION_FAILED bildirdi ama goto hata fırlatmak yerine zaman aşımına kadar bekledi | page.on("requestfailed") ile gerçek hatayı görün, username ve password alanlarını düzeltin |
HTTP (şifresiz) adreste yanıt kodu 407 | Aynı neden; tünel olmadığı için proxy'nin yanıtı sayfa yanıtı olarak gelir | response.status değerini kontrol edin, kimlik bilgisini düzeltin |
Browser does not support socks5 proxy authentication | socks5:// adresle birlikte username verildi | Kimlik bilgisini kaldırıp IP whitelist kullanın ya da HTTP proxy'ye geçin |
net::ERR_SOCKS_CONNECTION_FAILED | SOCKS5 sunucusu kimlik doğrulama istiyor ya da IP'niz whitelist'te değil | Çıkış IP'nizi panelde listeye ekleyin |
| Sayfa açılıyor ama IP sizin IP'niz | proxy nesnesi hiç uygulanmamış ya da alan adı bypass listesinde | Nesneyi launch ya da new_context çağrısına verdiğinizi doğrulayın |
Üçüncü satır en çok zaman kaybettiren durumdur: betik hata vermez, yalnızca otuz saniye bekleyip zaman aşımına düşer ve sorun hedef sitenin yavaşlığı sanılır. Geliştirme sırasında şu iki satırı eklemek teşhisi kısaltır:
page.on("requestfailed", lambda r: print("BAŞARISIZ:", r.url, r.failure))
page.on("response", lambda r: print(r.status, r.url) if r.status >= 400 else None)
407 kodunun genel anlamı ve diğer kütüphanelerdeki görünümü HTTP hata kodları yazımızda; tarayıcı dışındaki "proxy sunucusu yanıt vermiyor" türü hatalar için Proxy Hatası Nedir? Proxy Sunucusu Yanıt Vermiyor Çözümü yazısına bakın.
Kullanım alanları
- Dinamik mağaza ve katalog sayfaları: JavaScript ile yüklenen fiyat ve stok verisi. Genel kurgu veri kazıma çözümü sayfamızda.
- Çok sayıda sayfanın düzenli taranması: sayfa keşfi ve kuyruk yönetimi web crawler çözümü sayfasında; sayfalama kalıpları Sayfalama (Pagination) Nedir, Scraping'de Nasıl Taranır? yazısında.
- Uygulamanızın farklı ülkelerden testi: ülke başına bir context, her birinde o ülkenin çıkış noktası. Ayrıntı uygulama testi sayfasında.
- Rakip fiyat izleme: günlük çalışan, kaynak engellemeli ve hız sınırına uyan bir tarama. İş tarafı E-Ticarette Rakip Fiyat Takibi Nasıl Yapılır? yazımızda.
Hangi işte olursa olsun çerçeve aynıdır: robots.txt kurallarına ve sitenin kullanım şartlarına uyun, resmî bir API varsa onu tercih edin, istek hızınızı sitenin kaldırabileceği düzeyde tutun. robots.txt dosyasının nasıl okunacağı robots.txt Dosyası Nedir, Nasıl Okunur? yazımızda.
Sık yapılan hatalar
- Kimlik bilgisini
serveradresine gömmek. Playwright bu kısmı yok sayar; sonuç407ya da zaman aşımıdır. - SOCKS5 ile kullanıcı adı ve parola denemek. Chromium desteklemez; IP whitelist ya da HTTP proxy kullanın.
- Her sayfa için yeni tarayıcı başlatmak. Tarayıcı bir kez açılır, yalıtım ve proxy değişimi context ile yapılır.
- Oturumlu akışı rotating ağ geçidinden geçirmek. Bağlantılar farklı IP'lerden çıkar, oturum düşer. Sticky kullanın.
- Context'leri kapatmamak. Açık kalan her context bellek tutar;
finallybloğunda kapatın. - Betikleri ve stil dosyalarını engellemek. Sayfa içeriği oluşturamaz, seçiciniz boş döner.
gotozaman aşımını hedef siteye yormak. Öncerequestfailedolayına ve proxy kimlik bilgisine bakın.200yanıtını içeriğe bakmadan kabul etmek. Beklediğiniz öğenin sayfada olduğunu doğrulayın; doğrulama ekranları da200dönebilir.
Karar rehberi
| İhtiyaç | Öneri |
|---|---|
| Tek çıkış noktası yeten betik ya da test | launch(proxy=...), HTTP proxy |
| Tek tarayıcıda birden çok bağımsız oturum | new_context(proxy=...), context başına ayrı proxy |
| Bağımsız sayfaların toplu taranması | Rotating proxy, tek ağ geçidi adresi |
| Giriş gerektiren, çok adımlı akış | Sticky proxy, bir context bir IP |
| SOCKS5 zorunlu | IP whitelist, username ve password olmadan |
| GB ile faturalanan trafik | Görsel, medya ve font isteklerini route ile engelleyin; mümkünse JSON yanıtını okuyun |
| Veri sayfa kaynağında ya da JSON uç noktasında | Playwright yerine düz HTTP istemcisi |
| Yapay zekâ ajanına tarayıcı kullandırma | Playwright MCP |
Sıkça sorulan sorular
Playwright ücretsiz mi?
Evet. Apache 2.0 lisanslı açık kaynak bir projedir; kütüphane ve indirdiği tarayıcı ikilileri için ücret ödenmez. Maliyet, tarayıcıların tükettiği sunucu kaynağından ve kullandığınız proxy trafiğinden gelir.
Playwright Python mı Node.js mi tercih edilmeli?
Proxy ayarı ve tarayıcı davranışı iki dilde aynıdır, çünkü ikisi de aynı sürücüyle konuşur. Ekibinizin ve veri işleme hattınızın dili belirleyici olmalıdır. İki dilin scraping açısından karşılaştırması Web Kazıma: JavaScript mi Python mu? yazımızda.
Her sayfa için ayrı proxy kullanabilir miyim?
Proxy sayfaya değil context'e bağlanır. Her sayfa için ayrı IP istiyorsanız her sayfayı kendi context'inde açın. Rotating ağ geçidi kullanıyorsanız buna da gerek kalmaz; rotasyonu ağ geçidi yapar.
Firefox ya da WebKit ile SOCKS5 kimlik doğrulaması çalışır mı?
Playwright, socks5:// adresle birlikte kullanıcı adı verildiğinde hatayı tarayıcıyı başlatmadan, kendi doğrulama adımında verir ve bu denetim tarayıcı türüne bakmaz. Biz yalnızca Chromium ile denedik; diğer motorlar için de IP whitelist'i varsayın.
Headless modda proxy farklı davranır mı?
Hayır. proxy nesnesi pencereli ve penceresiz modda aynı biçimde uygulanır. Sorunu gözle görmek isterseniz launch(headless=False) ile pencereyi açıp aynı betiği çalıştırabilirsiniz.
Proxy kullanmak doğrulama ekranlarını ortadan kaldırır mı?
Hayır. Proxy yalnızca isteğin hangi IP'den çıktığını değiştirir; istek hızı, tarayıcı sinyalleri ve oturum tutarlılığı aynı kalır. Bu ekranların neden çıktığını Puppeteer ve CAPTCHA: Neden Çıkar, Nasıl Azalır? yazımızda anlattık; anlatılanlar Playwright için de geçerlidir. Tespit atlatma eklentileri önermiyoruz: kalıcı yol makul hız, tutarlı oturum ve varsa resmî API'dir.
Özetle
Playwright'ta proxy tek bir nesnedir: server, username, password. Onu launch() çağrısına verirseniz bütün tarayıcı, new_context() çağrısına verirseniz yalnızca o oturum proxy'den çıkar; ikinci yol tek tarayıcıda context başına ayrı IP demektir. Kimlik bilgisi adresin içine yazılmaz, SOCKS5'te parola yerine IP whitelist kullanılır, oturumlu akışta sticky, bağımsız sayfalarda rotating seçilir. Trafiği GB ile ödüyorsanız görsel ve fontları engelleyin, zaman aşımı görüyorsanız önce requestfailed olayına bakın. İşinize uygun proxy türlerini proxy hizmetlerimizde bulabilirsiniz.


