Ihr Team arbeitet bereits mit Node.js, und jemand möchte Titel, Preis und Lagerbestand jedes Buches aus einer Kategorie eines Katalogs haben. Der Seitenquelltext im Browser zeigt, dass die Daten in einfachen <article>-Tags stehen; einen Browser brauchen Sie zum Auslesen also nicht. Sie brauchen einen Weg, das HTML herunterzuladen, die richtigen Elemente auszuwählen, dem „next“-Link zu folgen und zu verhindern, dass das Skript die Website überlastet oder beim ersten Timeout abbricht. Den allgemeinen Weg von einer Seite zu einer Datei beschreibt Daten aus einer Website extrahieren; dieses Tutorial erledigt dasselbe in JavaScript mit Cheerio.
Wir behandeln, was Cheerio ist und was nicht, das Laden von HTML mit load und fromURL, Selektoren und Listen, die neuere Methode extract, Paginierung, ein Parallelitätslimit, Retries mit Backoff, das Schreiben von JSON und das Senden der Anfragen über einen Proxy mit dem ProxyAgent von undici. Der letzte Teil erklärt, wann Cheerio das falsche Werkzeug ist. Alle Beispiele liefen am 28. September 2026 mit cheerio 1.2.0, undici 8.11.2 und Node.js 24.11.1 gegen books.toscrape.com, eine Sandbox, die zum Üben von Web Scraping gebaut wurde.
Was ist Cheerio?
Cheerio ist ein HTML- und XML-Parser für Node.js mit einer an jQuery angelehnten API. Sie übergeben Markup, Cheerio baut daraus einen Dokumentbaum, und Sie fragen diesen Baum mit $("css selector") ab. Das ist schnell, weil alles wegfällt, was ein Browser nach dem Parsen tut: kein Layout, kein CSS, keine Bilder, keine Skriptausführung.
Die aktuelle Version ist 1.2.0 (cheerio auf npm) und setzt Node.js 20.18.1 oder neuer voraus. Version 1.0 erschien im August 2024 und beendete eine Release-Candidate-Phase, die 2017 begonnen hatte. Das Paket hat keinen Default-Export, deshalb schreiben Sie import * as cheerio from "cheerio". Tutorials, die require("cheerio").default aufrufen, wurden für ältere Versionen geschrieben.
Cheerio sieht nur das HTML, das der Server geschickt hat. Wird die Produktliste erst später per JavaScript gefüllt, stehen die Daten nicht in diesem HTML, und kein Selektor findet sie. Statische vs. dynamische Seiten zeigt, wie Sie vor dem ersten Code prüfen, welche Art von Seite Sie vor sich haben.
Wie funktioniert ein Cheerio-Scraper?
Ein Scraper auf Basis von Cheerio wiederholt für jede Seite dieselben fünf Schritte:
- Herunterladen. Ein HTTP-Client (hier
fetch) fordert die URL an und erhält das HTML als Text. - Parsen.
cheerio.load(html)baut den Baum und gibt eine an dieses Dokument gebundene$-Funktion zurück. - Auswählen.
$("article.product_pod")liefert alle passenden Elemente;.find(),.text()und.attr()lesen darin. - Folgen. Der Scraper liest die nächste URL aus der Seite (einen Paginierungs- oder Detail-Link) und löst sie relativ zur aktuellen URL auf.
- Speichern. Die Zeilen werden im Speicher gesammelt und am Ende in eine Datei oder Datenbank geschrieben.
Die Schritte 2 und 3 berühren das Netzwerk nie. Diese Trennung hilft beim Debuggen: Liefert ein Selektor nichts, speichern Sie das HTML in einer Datei und testen den Selektor daran, ohne eine weitere Anfrage zu senden.
Cheerio vs. jsdom vs. Playwright
Die drei Werkzeuge, die für Web Scraping in Node.js am häufigsten verglichen werden, erledigen unterschiedliche Aufgaben:
| Werkzeug | Was es tut | Führt Seiten-JavaScript aus | Kosten pro Seite | Geeignet für |
|---|---|---|---|---|
| Cheerio | Parst HTML, Abfragen im jQuery-Stil | Nein | Am niedrigsten: nur Parsen | Serverseitig gerendertes HTML, große Seitenzahlen |
| jsdom | Baut in Node.js ein browserähnliches DOM | Optional, eingeschränkt | Höher als Cheerio | Code, der document und DOM-APIs erwartet |
| Playwright | Steuert ein echtes Chromium, Firefox oder WebKit | Ja | Am höchsten: kompletter Browser | Seiten, die Inhalte per JavaScript aufbauen, Klicks, Logins |
Ein verbreitetes Setup nutzt beide Enden: Playwright für die wenigen Seiten, die einen Browser brauchen, Cheerio für alles andere. Die Wahl der Sprache ist eine eigene Frage, behandelt in Web Scraping: JavaScript oder Python?.
Cheerio installieren und die erste Seite laden
Legen Sie ein Projekt an und installieren Sie das Paket. Mit "type": "module" können Sie import und Top-Level-await verwenden:
mkdir book-scraper && cd book-scraper
npm init -y
npm pkg set type=module
npm install cheerio
Node.js 18 und neuer bringen fetch mit, das erste Skript braucht also nichts weiter:
import * as cheerio from "cheerio";

const url = "https://books.toscrape.com/";
const response = await fetch(url, {
  headers: { "user-agent": "book-research/1.0 (+mailto:you@example.com)" },
});
if (!response.ok) throw new Error(`HTTP ${response.status} for ${url}`);

const $ = cheerio.load(await response.text());

console.log($("title").text().trim());
console.log($("article.product_pod").length, "books on this page");

$("article.product_pod").slice(0, 3).each((i, el) => {
  const card = $(el);
  const title = card.find("h3 a").attr("title");
  const price = card.find(".price_color").text();
  console.log(i + 1, title, price);
});All products | Books to Scrape - Sandbox
20 books on this page
1 A Light in the Attic £51.77
2 Tipping the Velvet £53.74
3 Soumission £50.10Der Titel stammt aus dem title-Attribut des Links, nicht aus seinem Text: Auf dieser Website ist der sichtbare Linktext gekürzt („In a Dark, Dark ...“), während das Attribut den vollständigen Titel enthält. Prüfen Sie beides im Seitenquelltext, bevor Sie sich entscheiden. Der user-agent-Header benennt Ihr Skript und gibt dem Website-Betreiber eine Möglichkeit, Sie zu erreichen.
Lademethoden
Cheerio 1.x bietet fünf Wege, ein Dokument zu laden (Cheerio-Dokumentation zum Laden):
| Methode | Eingabe | Wann sinnvoll |
|---|---|---|
load(html) | Ein String | Sie haben die Seite selbst heruntergeladen (der Normalfall) |
loadBuffer(buffer) | Rohe Bytes | Die Kodierung ist unbekannt; Cheerio erkennt sie selbst |
stringStream(options, cb) | Dekodierter Textstream | Große Dateien mit bekannter Kodierung |
decodeStream(options, cb) | Roher Bytestream | Große Dateien mit unbekannter Kodierung |
fromURL(url, options) | Eine URL | Schnelle Skripte; Cheerio lädt die Seite selbst herunter |
fromURL ist bequem, öffnet aber einen eigenen undici-Client für den Origin der Seite. In unserem Test ignorierte es einen in requestOptions übergebenen dispatcher und verband sich direkt – selbst dann, wenn dieser Dispatcher auf einen Proxy zeigte, der jede Anfrage ablehnte. Für alles, was einen Proxy, Retries oder Timeouts braucht, laden Sie mit fetch herunter und verwenden load.
Elemente auswählen und Werte lesen
Der meiste Scraping-Code nutzt nur einen kleinen Teil der API:
$(selector)wählt aus dem gesamten Dokument aus;el.find(selector)sucht innerhalb eines Elements..text()liefert den zusammengefügten Text der Auswahl;.attr("href")liefert ein Attribut des ersten Elements..each((i, el) => …)iteriert;.map((i, el) => value).get()macht aus einer Auswahl ein einfaches Array..first(),.eq(n)und.slice(a, b)grenzen eine Auswahl ein.
Ein Selektor ohne Treffer wirft keinen Fehler. .text() gibt einen leeren String zurück und .attr() gibt undefined zurück; ein geänderter Klassenname erzeugt also leere Felder statt eines Fehlers. Validieren Sie die gesammelten Zeilen (mehr dazu in der Fehlerliste unten). Selektor-Syntax und der Grund, warum Cheerio kein XPath kennt, stehen in CSS-Selektor vs. XPath.
Die Methode extract
Cheerio 1.0 hat $.extract() eingeführt, das den gesamten Datensatz als ein Objekt beschreibt (Cheerio-Dokumentation zu extract). Ein String liefert den Text des ersten Treffers, eckige Klammern sammeln alle Treffer, und { selector, value } liest eine Eigenschaft oder führt eine Funktion aus:
import * as cheerio from "cheerio";

const $ = await cheerio.fromURL("https://books.toscrape.com/");

const data = $.extract({
  heading: "h1",
  books: [
    {
      selector: "article.product_pod",
      value: {
        title: { selector: "h3 a", value: "title" },
        price: ".price_color",
        link: { selector: "h3 a", value: "href" },
        rating: {
          selector: "p.star-rating",
          value: (el) => $(el).attr("class").replace("star-rating", "").trim(),
        },
      },
    },
  ],
});

console.log(data.heading, data.books.length);
console.log(data.books[0]);All products 20
{
title: 'A Light in the Attic',
price: '£51.77',
link: 'catalogue/a-light-in-the-attic_1000/index.html',
rating: 'Three'
}Selektoren innerhalb von value gelten relativ zu jedem article, sodass die Felder eines Buches zusammenbleiben. Der Link bleibt relativ; lösen Sie ihn daher mit new URL(link, pageUrl) auf, bevor Sie ihn anfordern.
Ein vollständiger Scraper: Paginierung, Parallelität, Retries und JSON
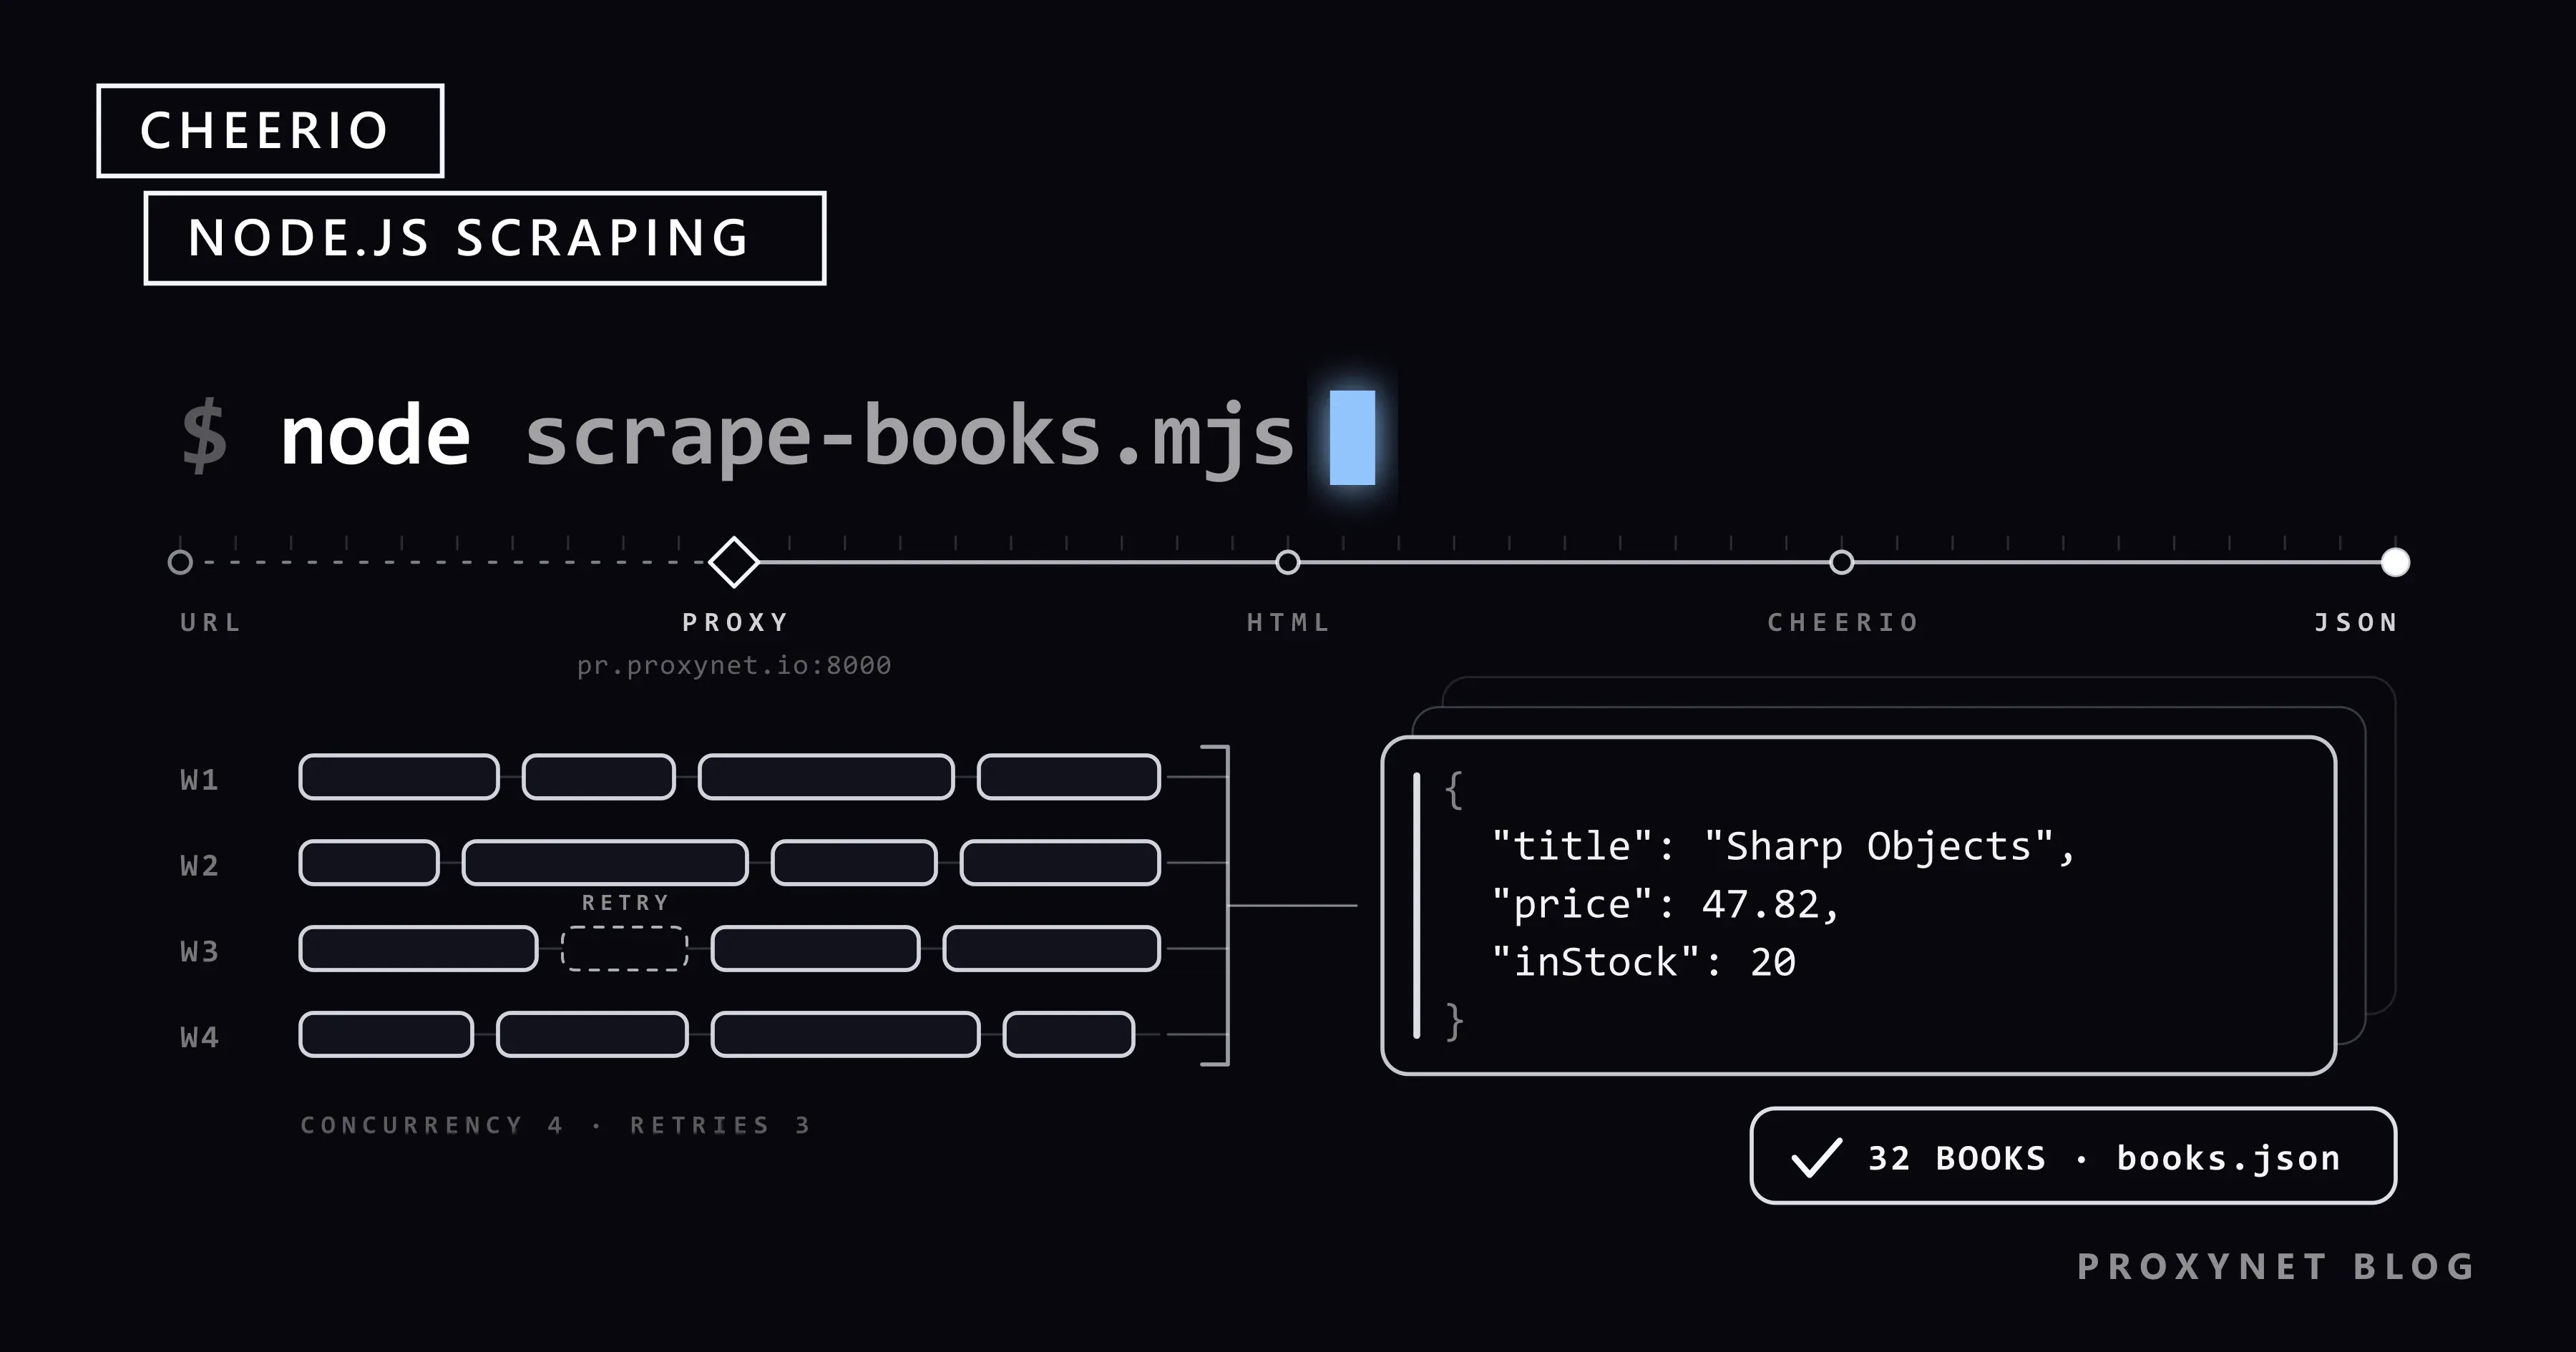
Das folgende Skript sammelt alle Bücher der Kategorie Mystery. Es durchläuft die Listenseiten, indem es dem „next“-Link folgt, öffnet die Detailseite jedes Buches mit höchstens vier gleichzeitigen Anfragen, wiederholt Netzwerkfehler, Timeouts sowie 429- und 5xx-Antworten mit exponentiellem Backoff und schreibt books.json. Es nutzt das fetch von undici, damit der optionale Proxy im nächsten Abschnitt ohne Änderungen funktioniert. Installation mit npm install cheerio undici (undici 8 setzt Node.js 22.19 oder neuer voraus).
import * as cheerio from "cheerio";
import { fetch, ProxyAgent } from "undici";
import { writeFile } from "node:fs/promises";

const START_URL =
  "https://books.toscrape.com/catalogue/category/books/mystery_3/index.html";
const CONCURRENCY = 4;   // gleichzeitig abgerufene Detailseiten
const MAX_RETRIES = 3;   // zusätzliche Versuche nach dem ersten
const HEADERS = { "user-agent": "book-research/1.0 (+mailto:you@example.com)" };

// Optionaler Proxy: PROXY_URL=http://user:pass@pr.proxynet.io:8000
const dispatcher = process.env.PROXY_URL
  ? new ProxyAgent(process.env.PROXY_URL)
  : undefined;

const sleep = (ms) => new Promise((resolve) => setTimeout(resolve, ms));
const backoff = (attempt) => 1000 * 2 ** (attempt - 1) + Math.random() * 250;

class HttpError extends Error {
  constructor(status, url) {
    super(`HTTP ${status} for ${url}`);
    this.status = status;
  }
}

async function fetchHtml(url) {
  for (let attempt = 1; ; attempt++) {
    let wait;
    try {
      const res = await fetch(url, {
        headers: HEADERS,
        dispatcher,
        signal: AbortSignal.timeout(15_000),
      });
      if (res.ok) return await res.text();
      const retryable = res.status === 429 || res.status >= 500;
      if (!retryable || attempt > MAX_RETRIES) throw new HttpError(res.status, url);
      const retryAfter = Number(res.headers.get("retry-after"));
      wait = retryAfter > 0 ? retryAfter * 1000 : backoff(attempt);
    } catch (err) {
      if (err instanceof HttpError || attempt > MAX_RETRIES) throw err;
      wait = backoff(attempt); // Netzwerkfehler oder Timeout
    }
    console.warn(`retry ${attempt}/${MAX_RETRIES} in ${Math.round(wait)} ms: ${url}`);
    await sleep(wait);
  }
}

// fn über items ausführen, mit höchstens `limit` gleichzeitig laufenden Aufrufen.
async function mapLimit(items, limit, fn) {
  const results = new Array(items.length);
  let next = 0;
  async function worker() {
    while (next < items.length) {
      const i = next++;
      results[i] = await fn(items[i], i);
    }
  }
  await Promise.all(Array.from({ length: Math.min(limit, items.length) }, worker));
  return results;
}

function parseListPage(html, pageUrl) {
  const $ = cheerio.load(html);
  const books = $("article.product_pod")
    .map((_, el) => {
      const card = $(el);
      const link = card.find("h3 a");
      return {
        title: link.attr("title"),
        price: Number(card.find(".price_color").text().replace(/[^0-9.]/g, "")),
        rating: card.find("p.star-rating").attr("class").split(" ").pop(),
        url: new URL(link.attr("href"), pageUrl).href,
      };
    })
    .get();
  const nextHref = $("li.next a").attr("href");
  return { books, nextUrl: nextHref ? new URL(nextHref, pageUrl).href : null };
}

function parseDetailPage(html) {
  const $ = cheerio.load(html);
  const info = {};
  $("table.table-striped tr").each((_, row) => {
    info[$(row).find("th").text().trim()] = $(row).find("td").text().trim();
  });
  const stock = info["Availability"]?.match(/\((\d+) available\)/);
  return {
    upc: info["UPC"],
    inStock: stock ? Number(stock[1]) : 0,
    description: $("#product_description + p").text().trim(),
  };
}

// 1. Listenseiten durchlaufen, indem wir dem "next"-Link folgen.
const listed = [];
for (let url = START_URL; url; ) {
  const { books, nextUrl } = parseListPage(await fetchHtml(url), url);
  listed.push(...books);
  console.log(`${url} -> ${books.length} books`);
  url = nextUrl;
}

// 2. Alle Detailseiten öffnen, jeweils vier gleichzeitig.
const books = await mapLimit(listed, CONCURRENCY, async (book) => {
  try {
    return { ...book, ...parseDetailPage(await fetchHtml(book.url)) };
  } catch (err) {
    console.error(`skipped ${book.url}: ${err.message}`);
    return { ...book, error: err.message };
  }
});

// 3. Ergebnis speichern.
await writeFile(
  "books.json",
  JSON.stringify({ scrapedAt: new Date().toISOString(), count: books.length, books }, null, 2),
);
console.log(`saved ${books.length} books to books.json`);https://books.toscrape.com/catalogue/category/books/mystery_3/index.html -> 20 books
https://books.toscrape.com/catalogue/category/books/mystery_3/page-2.html -> 12 books
saved 32 books to books.jsonEin Datensatz aus books.json (Beschreibung gekürzt):
{
  "title": "Sharp Objects",
  "price": 47.82,
  "rating": "Four",
  "url": "https://books.toscrape.com/catalogue/sharp-objects_997/index.html",
  "upc": "e00eb4fd7b871a48",
  "inStock": 20,
  "description": "…"
}
Was die einzelnen Teile tun:
- Paginierung. Die Schleife endet, wenn die Seite kein
li.next amehr enthält. Der Link auf Seite 1 lautetpage-2.htmlund ist relativ zum Kategorieordner; deshalb läuft jede URL durchnew URL(href, pageUrl). Andere Muster (Seitenzahlen im Query-String, Cursor, „Mehr laden“-APIs) behandelt Paginierung beim Web Scraping. - Parallelitätslimit.
mapLimitstartet vier Worker, die sich das nächste Element über einen gemeinsamen Zähler holen.Promise.allüber alle 32 URLs würde 32 Anfragen auf einmal senden; bei 1.000 URLs sähe das für den Server wie ein Ansturm aus. Vier ist ein rücksichtsvoller Startwert für eine kleine Website. - Retries. Wiederholt werden nur Fehler, die von selbst verschwinden können: Netzwerkfehler, der 15-Sekunden-Timeout, 429 und 5xx. Ein 404 schlägt sofort fehl. Ein numerischer
Retry-After-Header hat Vorrang vor der berechneten Wartezeit; der Backoff verdoppelt sich ab etwa einer Sekunde und addiert zufälligen Jitter, damit parallele Worker nicht im Gleichschritt wiederholen. Warum 429 auftritt und wie Sie den Header lesen, steht in HTTP 429 Too Many Requests. - Teilausfälle. Eine Detailseite, die auch nach drei Retries fehlschlägt, wird zu einer Zeile mit einem
error-Feld, statt den Lauf abzubrechen. Diese Zeilen können Sie später gezielt erneut abrufen. - JSON. Die Datei enthält
scrapedAtundcount, was beim Vergleich mehrerer Läufe hilft. Für CSV, JSON Lines oder SQLite mit Upserts siehe Gescrapte Daten als CSV, JSON und in SQLite speichern.
Einen Proxy mit Cheerio nutzen (undici ProxyAgent)
Cheerio öffnet in diesem Skript nie eine Verbindung, der Proxy gehört also zum HTTP-Client. Mit undici erstellen Sie einen ProxyAgent und übergeben ihn fetch als dispatcher. Das vollständige Skript oben tut das bereits, sobald PROXY_URL gesetzt ist:
PROXY_URL=http://user:pass@pr.proxynet.io:8000 node scrape-books.mjsundici bildet den Proxy-Authorization-Header aus Benutzername und Passwort in der URL und dekodiert beide vorher per URL-Decoding; Sonderzeichen im Passwort müssen daher prozentkodiert sein (undici-Dokumentation zu ProxyAgent). Für HTTPS-Ziele öffnet der Agent einen CONNECT-Tunnel, und TLS zur Website läuft innerhalb dieses Tunnels.
Wir haben das Skript über einen kleinen lokalen Proxy laufen lassen, der user:pass verlangte und jeden Tunnel protokollierte. Alle 34 Anfragen (zwei Listenseiten, 32 Detailseiten) kamen über ein einziges CONNECT books.toscrape.com:443: Der Agent hielt den Tunnel offen und nutzte ihn wieder. Mit falschem Passwort antwortete der Proxy mit 407, und undici meldete Proxy response (407) !== 200 when HTTP Tunneling. Das Skript versuchte es dreimal erneut, bevor es aufgab; ein falsches Passwort behebt sich nicht von selbst, prüfen Sie also die Zugangsdaten, statt die Zahl der Retries zu erhöhen.
Wenn Sie undici nicht als Abhängigkeit hinzufügen möchten: Node.js 24.5 und 22.21 haben eine eingebaute Proxy-Unterstützung erhalten, die HTTP_PROXY, HTTPS_PROXY und NO_PROXY ausliest, wenn Sie NODE_USE_ENV_PROXY=1 setzen (eingebaute Proxy-Unterstützung in Node.js). Die Dokumentation kennzeichnet die Funktion als in aktiver Entwicklung. In unserem Test mit Node.js 24.11.1 lief das einfache globale fetch mit dieser Einstellung über den lokalen Proxy:
NODE_USE_ENV_PROXY=1 HTTPS_PROXY=http://user:pass@pr.proxynet.io:8000 node first-page.mjsAxios und node-fetch verwenden Agents statt Dispatcher; Proxy in Node.js verwenden behandelt beide. Für wechselnde Exit-IPs pro Anfrage oder Sticky Sessions, die eine IP eine Weile beibehalten, akzeptieren Residential-Proxy und Rotierender Proxy dieselbe URL im Format user:pass@host:port.
Wann Cheerio nicht ausreicht
Cheerio kann nicht klicken, nicht scrollen und nicht auf eine Anfrage warten, die die Seite nach dem Laden stellt. Anzeichen dafür, dass Sie einen Browser brauchen:
- Im Seitenquelltext (Strg+U) fehlen die Daten, die die gerenderte Seite anzeigt.
- Das HTML enthält einen leeren Container wie
<div id="root"></div>und ein großes Skript-Bundle. - Die Daten erscheinen erst nach einem Login-Formular, einem Cookie-Banner oder einem „Infinite Scroll“.
Bevor Sie einen Browser starten, öffnen Sie in den Entwicklertools den Tab „Netzwerk“. Viele „dynamische“ Seiten laden ihre Daten von einem JSON-Endpunkt, und diesen Endpunkt mit fetch abzufragen ist leichter, als die Seite zu rendern. Brauchen Sie tatsächlich einen Browser, kann Playwright die Seite rendern und das fertige HTML mit cheerio.load(await page.content()) an Cheerio übergeben; Ihr Parsing-Code bleibt dabei unverändert.
Wo Cheerio-Scraper eingesetzt werden
- Preisbeobachtung: Preise von serverseitig gerenderten Produktseiten nach Zeitplan auslesen (Preisüberwachung).
- Katalog- und Marktdaten: Sortimente und Lagerbestände über mehrere Shops hinweg erfassen (Marktforschung).
- Sichtbarkeit in der Suche: Titel, Meta-Tags und Überschriften auf den eigenen Seiten prüfen (SEO-Proxy).
- Datenpipelines: geparste Zeilen in einen größeren Crawler oder ETL-Job einspeisen (Data Scraping, Webcrawler).
- Gespeichertes HTML parsen: archivierte Seiten in strukturierte Datensätze umwandeln; die Parsing-Seite erklärt Was ist Data Parsing?.
Häufige Fehler und ihre Diagnose
- Überall leere Strings. Der Selektor hat nichts getroffen, oder die Daten kommen per JavaScript hinzu. Speichern Sie das HTML mit
writeFile("page.html", html)und suchen Sie darin nach einem Wert, den Sie im Browser sehen. require(...).default is not a functionoderdoes not provide an export named 'default'. Veralteter Importstil. Verwenden Sieimport * as cheerio from "cheerio".TypeError: fetch failedmitinvalid onRequestStart method. Sie haben einenProxyAgentaus dem npm-Paket undici an das globalefetchvon Node.js übergeben. Node 24.11.1 bringt undici 7.16.0 mit, und die beiden Versionen teilen keine gemeinsame Dispatcher-Schnittstelle. Importieren SiefetchundProxyAgentaus demselben Paket.- Ein Proxy, der „nichts tut“. Sie haben den Agent an
cheerio.fromURLübergeben, das einen eigenen Client verwendet. Laden Sie mitfetchherunter und rufen Siecheerio.loadauf. - Relative Links schlagen fehl.
fetch("catalogue/…")wirftFailed to parse URL. Lösen Sie den Link mitnew URL(href, pageUrl)auf. - Zu viele Anfragen auf einmal.
Promise.all(urls.map(fetch))sendet alles parallel und provoziert 429-Antworten. Setzen Sie ein Limit wiemapLimitein. - Stille Datenabweichung. Die Website benennt eine Klasse um, und Preise werden zu
NaN. Prüfen Sie jeden Lauf: Zeilen zählen,NaN-Preise zählen und abbrechen, wenn die Zahlen stark einbrechen.
Bevor Sie hochskalieren, lesen Sie die robots.txt und die Nutzungsbedingungen der Website, bevorzugen Sie eine offizielle API, wenn es eine gibt, und halten Sie die Anfragerate moderat. robots.txt erklärt und Ist Web Scraping legal? behandeln die Regeln; Web Scraping ohne Blockierung behandelt rücksichtsvolles Crawling.
Entscheidungshilfe
| Bedarf | Empfehlung |
|---|---|
| Daten stehen im Seitenquelltext | fetch + cheerio.load |
| Einmaliges Skript, kein Proxy | cheerio.fromURL |
| Viele Datensätze mit gleicher Struktur | $.extract mit einem Array-Deskriptor |
| Hunderte Seiten | Ein Parallelitätslimit von 2–5 plus Retries mit Backoff |
| Anfragen über einen Proxy | undici fetch + ProxyAgent oder NODE_USE_ENV_PROXY=1 ab Node.js 24.5 |
| Daten erscheinen erst nach Ausführung von JavaScript | Zuerst den JSON-Endpunkt suchen, sonst Playwright + Cheerio |
Code erwartet ein vollständiges DOM (document, Events) | jsdom |
Häufige Fragen
Wird Cheerio 2026 noch gepflegt?
Ja. Die npm-Registry führt Version 1.2.0, veröffentlicht im Januar 2026, als aktuelle Version, und die Dokumentation deckt die 1.x-API einschließlich extract und fromURL ab.
Führt Cheerio JavaScript aus?
Nein. Cheerio parst den übergebenen HTML-String und sonst nichts. Skripte in der Seite werden als Text behandelt. Für Seiten, die ihren Inhalt im Browser aufbauen, verwenden Sie Playwright oder suchen den Datenendpunkt, den die Seite aufruft.
Brauche ich Axios zusammen mit Cheerio?
Nein. Node.js 18 und neuer enthalten fetch, und das deckt ab, was die meisten Scraper brauchen. Axios ist Geschmackssache; wenn Sie es nutzen, übergeben Sie den Antwortinhalt (response.data) an cheerio.load.
Wie scrape ich mehrere Seiten mit Cheerio?
Lesen Sie auf jeder Seite den Link zur nächsten Seite, lösen Sie ihn relativ zur aktuellen URL auf und wiederholen Sie das, bis der Link fehlt – wie im vollständigen Skript oben. Ist die Seitenzahl bekannt, können Sie die URL-Liste auch vorab erstellen und mit einem Parallelitätslimit abarbeiten.
Wie nutze ich einen Proxy mit Cheerio?
Konfigurieren Sie den Proxy im HTTP-Client, nicht in Cheerio. Mit undici: new ProxyAgent("http://user:pass@pr.proxynet.io:8000"), übergeben als dispatcher an das fetch von undici. Ab Node.js 24.5 können Sie stattdessen NODE_USE_ENV_PROXY=1 und HTTPS_PROXY setzen.
Ist Cheerio schneller als Puppeteer oder Playwright?
Bei Seiten, deren Daten im HTML stehen, ja: Cheerio parst nur Text, während ein Browser zusätzlich Ressourcen lädt, Skripte ausführt und das Layout berechnet. Wir haben den Unterschied nicht gemessen, und er hängt von der Seite ab; messen Sie also an Ihren eigenen Zielen, wenn die Zahlen wichtig sind.
Fazit
Cheerio verwandelt heruntergeladenes HTML in einen Baum, den Sie mit CSS-Selektoren abfragen, und ergänzt in Version 1.x fromURL und extract. Ein zuverlässiger Scraper hält die Netzwerkarbeit aus Cheerio heraus: fetch mit Timeout, Retries bei 429, 5xx und Netzwerkfehlern, ein kleines Parallelitätslimit und eine JSON-Datei mit Zeitstempel. Wenn Anfragen von einer anderen IP oder aus einem anderen Land kommen sollen, übergeben Sie einen undici-ProxyAgent als Dispatcher und richten ihn auf einen Proxynet-Proxy.