Ekibiniz zaten Node.js kullanıyor ve biri sizden bir kitap kataloğunun tek bir kategorisindeki bütün kitapların adını, fiyatını ve stok adedini istiyor. Tarayıcıda sayfa kaynağına baktığınızda veriler düz <article> etiketlerinin içinde duruyor; yani bunları okumak için tarayıcıya ihtiyacınız yok. Gereken şey HTML'i indirmek, doğru öğeleri seçmek, "next" bağlantısını izlemek ve betiğin siteyi yormasını ya da ilk zaman aşımında çökmesini önlemektir. Bir sayfadan dosyaya uzanan genel yol Web Sitesinden Veri Çekme yazısında anlatılıyor; bu rehber aynı işi JavaScript'te Cheerio ile yapıyor.
Cheerio'nun ne olduğunu ve ne olmadığını, load ve fromURL ile HTML yüklemeyi, seçicileri ve listeleri, yeni extract yöntemini, sayfalamayı, eşzamanlılık sınırını, artan bekleme (backoff) ile yeniden denemeyi, JSON'a yazmayı ve istekleri undici'nin ProxyAgent'ı üzerinden bir proxy'ye yönlendirmeyi ele alıyoruz. Son bölüm Cheerio'nun hangi durumlarda yanlış araç olduğunu açıklıyor. Bütün örnekler 28 Eylül 2026'da cheerio 1.2.0, undici 8.11.2 ve Node.js 24.11.1 ile, scraping alıştırması için kurulmuş bir deneme sitesi olan books.toscrape.com üzerinde çalıştırıldı.
Cheerio nedir?
Cheerio, API'si jQuery örnek alınarak tasarlanmış, Node.js için bir HTML ve XML ayrıştırıcısıdır. Ona HTML işaretlemesini verirsiniz, o bir belge ağacı kurar, siz de bu ağacı $("css selector") ile sorgularsınız. Hızlıdır, çünkü bir tarayıcının ayrıştırmadan sonra yaptığı her şeyi atlar: sayfa düzeni hesaplanmaz, CSS uygulanmaz, görseller indirilmez, betikler çalıştırılmaz.
Güncel sürüm 1.2.0'dır (npm'deki cheerio) ve Node.js 20.18.1 ya da üstünü gerektirir. Ağustos 2024'te çıkan 1.0 sürümü, 2017'de başlayan sürüm adayı (release candidate) dönemini kapattı. Paketin varsayılan dışa aktarımı yoktur; bu yüzden import * as cheerio from "cheerio" yazarsınız. require("cheerio").default çağıran rehberler eski sürümler için yazılmıştır.
Cheerio yalnızca sunucunun gönderdiği HTML'i görür. Ürün listesi sonradan JavaScript ile dolduruluyorsa veri o HTML'de yoktur ve hiçbir seçici onu bulamaz. Statik ve Dinamik Sayfalar yazısı, kod yazmaya başlamadan önce elinizdeki sayfanın hangi türde olduğunu nasıl anlayacağınızı gösteriyor.
Cheerio ile yazılmış bir scraper nasıl çalışır?
Cheerio üzerine kurulan bir scraper her sayfa için aynı beş adımı tekrarlar:
İndirme. Bir HTTP istemcisi (burada
fetch) URL'yi ister ve HTML'i metin olarak alır.Ayrıştırma.
cheerio.load(html)ağacı kurar ve o belgeye bağlı bir$fonksiyonu döndürür.Seçme.
$("article.product_pod")eşleşen bütün öğeleri döndürür;.find(),.text()ve.attr()bu öğelerin içini okur.İzleme. Scraper bir sonraki URL'yi sayfadan okur (sayfalama bağlantısı ya da ayrıntı bağlantısı) ve onu geçerli URL'ye göre çözümler.
Saklama. Satırlar bellekte toplanır ve sonunda bir dosyaya ya da veritabanına yazılır.
ve 3. adımlar ağa hiç dokunmaz. Bu ayrım hata ayıklarken işe yarar: bir seçici hiçbir şey döndürmüyorsa HTML'i bir dosyaya kaydedin ve seçiciyi yeni bir istek göndermeden o dosya üzerinde deneyin.
Cheerio, jsdom ve Playwright karşılaştırması
Node.js'te scraping için en sık karşılaştırılan üç araç farklı işler yapar:
| Araç | Ne yapar | Sayfadaki JavaScript'i çalıştırır mı | Sayfa başına maliyet | Uygun olduğu iş |
|---|---|---|---|---|
| Cheerio | HTML'i ayrıştırır, jQuery tarzı sorgular | Hayır | En düşük: yalnızca ayrıştırma | Sunucuda üretilen HTML, çok sayıda sayfa |
| jsdom | Node.js içinde tarayıcıya benzer bir DOM kurar | İsteğe bağlı, sınırlı | Cheerio'dan yüksek | document ve DOM API'leri bekleyen kod |
| Playwright | Gerçek bir Chromium, Firefox ya da WebKit tarayıcısını yönetir | Evet | En yüksek: tam tarayıcı | İçeriği JavaScript ile kuran sayfalar, tıklama, oturum açma |
Yaygın bir düzen iki ucu birlikte kullanır: tarayıcı gerektiren az sayıdaki sayfa için Playwright, geri kalan her şey için Cheerio. Dil seçimi ayrı bir sorudur ve Web Kazıma: JavaScript mi Python mı? yazısında ele alınıyor.
Cheerio'yu kurma ve ilk sayfayı yükleme
Bir proje oluşturun ve paketi kurun. "type": "module" eklemek import ve üst düzey await kullanmanızı sağlar:
mkdir book-scraper && cd book-scraper
npm init -y
npm pkg set type=module
npm install cheerio
Node.js 18 ve sonrası fetch ile birlikte gelir; bu yüzden ilk betik başka bir şeye ihtiyaç duymaz:
import * as cheerio from "cheerio";

const url = "https://books.toscrape.com/";
const response = await fetch(url, {
  headers: { "user-agent": "book-research/1.0 (+mailto:you@example.com)" },
});
if (!response.ok) throw new Error(`HTTP ${response.status} for ${url}`);

const $ = cheerio.load(await response.text());

console.log($("title").text().trim());
console.log($("article.product_pod").length, "books on this page");

$("article.product_pod").slice(0, 3).each((i, el) => {
  const card = $(el);
  const title = card.find("h3 a").attr("title");
  const price = card.find(".price_color").text();
  console.log(i + 1, title, price);
});All products | Books to Scrape - Sandbox
20 books on this page
1 A Light in the Attic £51.77
2 Tipping the Velvet £53.74
3 Soumission £50.10Kitap adı bağlantının metninden değil, title özniteliğinden alınıyor: bu sitede görünen bağlantı metni kısaltılmış ("In a Dark, Dark ..."), öznitelik ise adın tamamını taşıyor. Birini seçmeden önce ikisine de sayfa kaynağında bakın. user-agent başlığı betiğinizi tanıtır ve site sahibine size ulaşabileceği bir yol verir.
Yükleme yöntemleri
Cheerio 1.x'te bir belgeyi yüklemenin beş yolu vardır (Cheerio yükleme belgeleri):
| Yöntem | Girdi | Ne zaman kullanılır |
|---|---|---|
load(html) | Metin (string) | Sayfayı kendiniz indirdiniz (olağan durum) |
loadBuffer(buffer) | Ham baytlar | Kodlama bilinmiyor; Cheerio kodlamayı kendisi tespit eder |
stringStream(options, cb) | Çözülmüş metin akışı | Kodlaması bilinen büyük dosyalar |
decodeStream(options, cb) | Ham bayt akışı | Kodlaması bilinmeyen büyük dosyalar |
fromURL(url, options) | Bir URL | Hızlı betikler; sayfayı Cheerio kendisi indirir |
fromURL pratiktir, ancak sayfanın kaynağı (origin) için kendi undici istemcisini açar. Testimizde requestOptions içinde verilen dispatcher'ı, her isteği reddeden bir proxy'yi gösterdiği hâlde yok saydı ve siteye doğrudan bağlandı. Proxy, yeniden deneme ya da zaman aşımı gereken her işte sayfayı fetch ile indirin ve load kullanın.
Öğeleri seçme ve değerleri okuma
Scraping kodunun çoğu API'nin küçük bir bölümünü kullanır:
$(selector)bütün belgeden seçer;el.find(selector)tek bir öğenin içinde arar..text()seçimin birleşik metnini döndürür;.attr("href")ilk öğenin tek bir özniteliğini döndürür..each((i, el) => …)döngü kurar;.map((i, el) => value).get()bir seçimi düz bir diziye çevirir..first(),.eq(n)ve.slice(a, b)seçimi daraltır.
Hiçbir şeyle eşleşmeyen bir seçici hata fırlatmaz. .text() boş bir metin, .attr() ise undefined döndürür; dolayısıyla değişen bir sınıf adı hata yerine boş alanlar üretir. Topladığınız satırları doğrulayın (ayrıntısı aşağıdaki hatalar listesinde). Seçici sözdizimi ve Cheerio'da neden XPath olmadığı CSS Selector ve XPath yazısında anlatılıyor.
extract yöntemi
Cheerio 1.0, kaydın tamamını tek bir nesneyle tarif eden $.extract() yöntemini ekledi (Cheerio extract belgeleri). Bir metin (string) ilk eşleşmenin metnini verir, köşeli parantezler bütün eşleşmeleri toplar, { selector, value } ise bir özelliği okur ya da bir fonksiyon çalıştırır:
import * as cheerio from "cheerio";

const $ = await cheerio.fromURL("https://books.toscrape.com/");

const data = $.extract({
  heading: "h1",
  books: [
    {
      selector: "article.product_pod",
      value: {
        title: { selector: "h3 a", value: "title" },
        price: ".price_color",
        link: { selector: "h3 a", value: "href" },
        rating: {
          selector: "p.star-rating",
          value: (el) => $(el).attr("class").replace("star-rating", "").trim(),
        },
      },
    },
  ],
});

console.log(data.heading, data.books.length);
console.log(data.books[0]);All products 20
{
title: 'A Light in the Attic',
price: '£51.77',
link: 'catalogue/a-light-in-the-attic_1000/index.html',
rating: 'Three'
}value içindeki seçiciler her article öğesine göre çalışır; bu da bir kitabın alanlarını bir arada tutar. Bağlantı göreli kalır, bu yüzden istek göndermeden önce onu new URL(link, pageUrl) ile çözümleyin.
Eksiksiz bir scraper: sayfalama, eşzamanlılık, yeniden deneme ve JSON
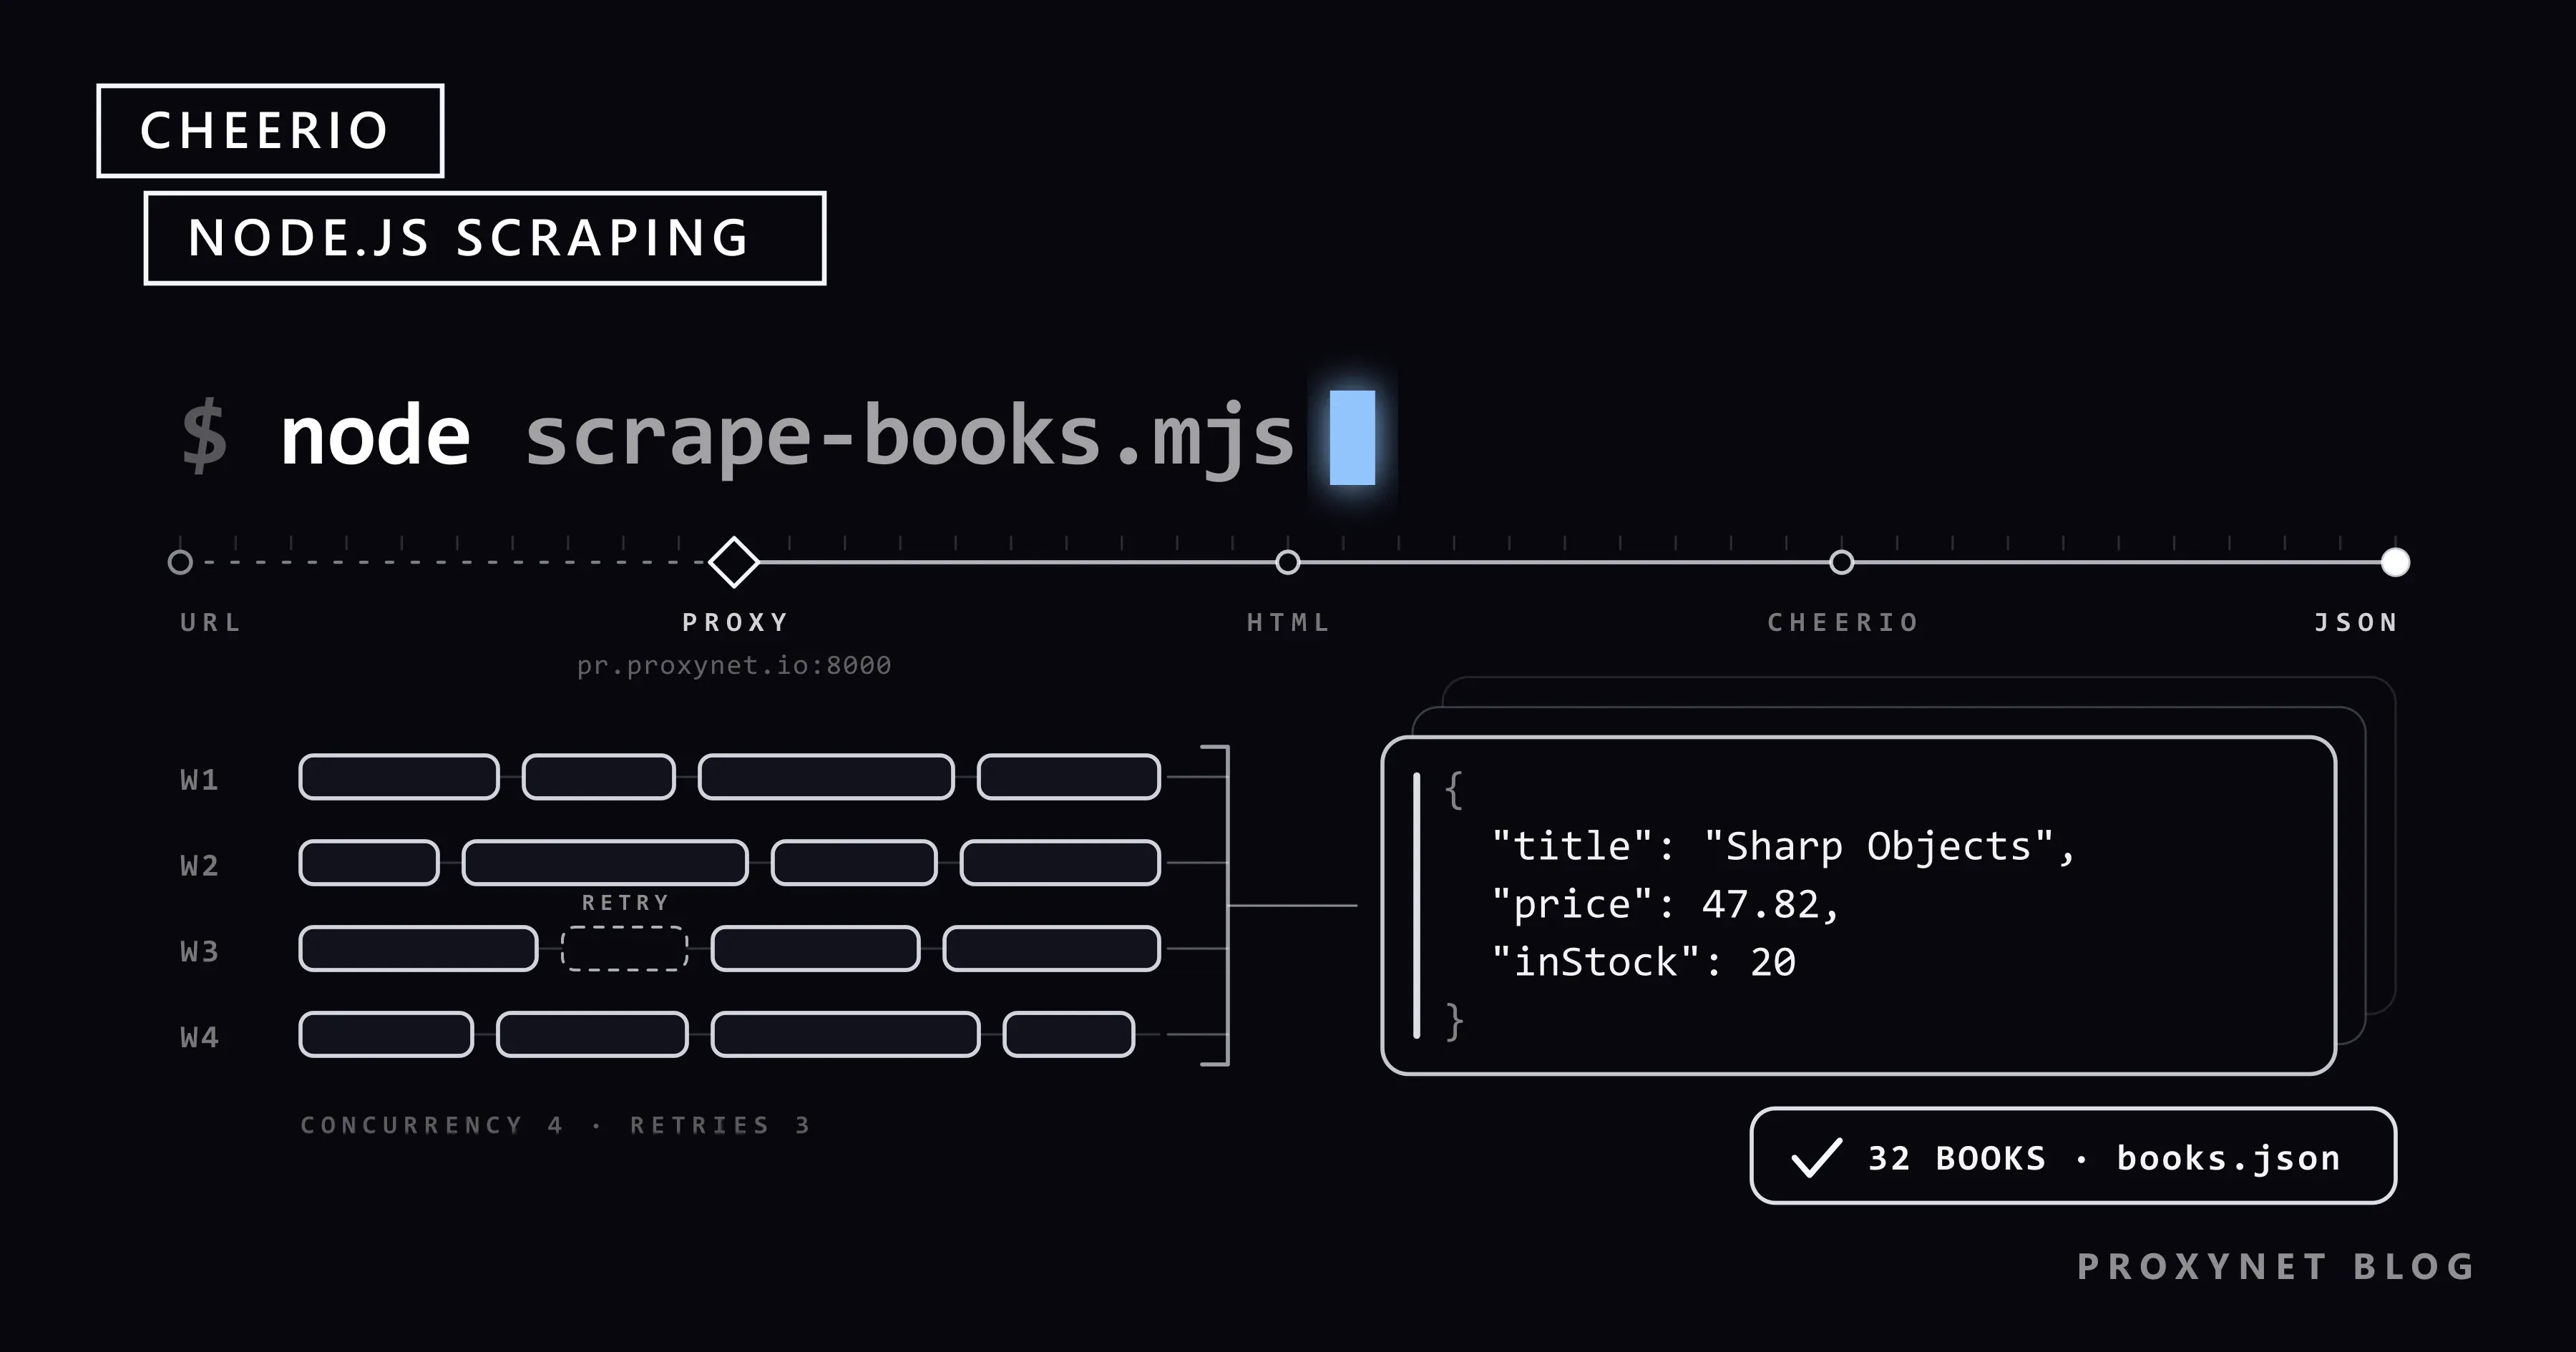
Aşağıdaki betik Mystery kategorisindeki bütün kitapları topluyor. Liste sayfalarını "next" bağlantısını izleyerek dolaşıyor, her kitabın ayrıntı sayfasını aynı anda en fazla dört istekle açıyor. Ağ hatalarını, zaman aşımlarını, 429 ve 5xx yanıtlarını üstel artan beklemeyle yeniden deniyor ve sonucu books.json dosyasına yazıyor. Bir sonraki bölümdeki isteğe bağlı proxy'nin değişiklik yapmadan çalışması için undici'nin fetch fonksiyonunu kullanıyor. Kurulum için npm install cheerio undici yeterli (undici 8, Node.js 22.19 ya da üstünü gerektirir).
import * as cheerio from "cheerio";
import { fetch, ProxyAgent } from "undici";
import { writeFile } from "node:fs/promises";

const START_URL =
  "https://books.toscrape.com/catalogue/category/books/mystery_3/index.html";
const CONCURRENCY = 4;   // aynı anda çekilen ayrıntı sayfası sayısı
const MAX_RETRIES = 3;   // ilk denemeden sonraki ek deneme sayısı
const HEADERS = { "user-agent": "book-research/1.0 (+mailto:you@example.com)" };

// İsteğe bağlı proxy: PROXY_URL=http://user:pass@pr.proxynet.io:8000
const dispatcher = process.env.PROXY_URL
  ? new ProxyAgent(process.env.PROXY_URL)
  : undefined;

const sleep = (ms) => new Promise((resolve) => setTimeout(resolve, ms));
const backoff = (attempt) => 1000 * 2 ** (attempt - 1) + Math.random() * 250;

class HttpError extends Error {
  constructor(status, url) {
    super(`HTTP ${status} for ${url}`);
    this.status = status;
  }
}

async function fetchHtml(url) {
  for (let attempt = 1; ; attempt++) {
    let wait;
    try {
      const res = await fetch(url, {
        headers: HEADERS,
        dispatcher,
        signal: AbortSignal.timeout(15_000),
      });
      if (res.ok) return await res.text();
      const retryable = res.status === 429 || res.status >= 500;
      if (!retryable || attempt > MAX_RETRIES) throw new HttpError(res.status, url);
      const retryAfter = Number(res.headers.get("retry-after"));
      wait = retryAfter > 0 ? retryAfter * 1000 : backoff(attempt);
    } catch (err) {
      if (err instanceof HttpError || attempt > MAX_RETRIES) throw err;
      wait = backoff(attempt); // ağ hatası ya da zaman aşımı
    }
    console.warn(`retry ${attempt}/${MAX_RETRIES} in ${Math.round(wait)} ms: ${url}`);
    await sleep(wait);
  }
}

// fn'yi öğeler üzerinde, aynı anda en fazla `limit` çağrı açık olacak şekilde çalıştırır.
async function mapLimit(items, limit, fn) {
  const results = new Array(items.length);
  let next = 0;
  async function worker() {
    while (next < items.length) {
      const i = next++;
      results[i] = await fn(items[i], i);
    }
  }
  await Promise.all(Array.from({ length: Math.min(limit, items.length) }, worker));
  return results;
}

function parseListPage(html, pageUrl) {
  const $ = cheerio.load(html);
  const books = $("article.product_pod")
    .map((_, el) => {
      const card = $(el);
      const link = card.find("h3 a");
      return {
        title: link.attr("title"),
        price: Number(card.find(".price_color").text().replace(/[^0-9.]/g, "")),
        rating: card.find("p.star-rating").attr("class").split(" ").pop(),
        url: new URL(link.attr("href"), pageUrl).href,
      };
    })
    .get();
  const nextHref = $("li.next a").attr("href");
  return { books, nextUrl: nextHref ? new URL(nextHref, pageUrl).href : null };
}

function parseDetailPage(html) {
  const $ = cheerio.load(html);
  const info = {};
  $("table.table-striped tr").each((_, row) => {
    info[$(row).find("th").text().trim()] = $(row).find("td").text().trim();
  });
  const stock = info["Availability"]?.match(/\((\d+) available\)/);
  return {
    upc: info["UPC"],
    inStock: stock ? Number(stock[1]) : 0,
    description: $("#product_description + p").text().trim(),
  };
}

// 1. Liste sayfalarını "next" bağlantısını izleyerek dolaş.
const listed = [];
for (let url = START_URL; url; ) {
  const { books, nextUrl } = parseListPage(await fetchHtml(url), url);
  listed.push(...books);
  console.log(`${url} -> ${books.length} books`);
  url = nextUrl;
}

// 2. Bütün ayrıntı sayfalarını dörder dörder aç.
const books = await mapLimit(listed, CONCURRENCY, async (book) => {
  try {
    return { ...book, ...parseDetailPage(await fetchHtml(book.url)) };
  } catch (err) {
    console.error(`skipped ${book.url}: ${err.message}`);
    return { ...book, error: err.message };
  }
});

// 3. Sonucu kaydet.
await writeFile(
  "books.json",
  JSON.stringify({ scrapedAt: new Date().toISOString(), count: books.length, books }, null, 2),
);
console.log(`saved ${books.length} books to books.json`);https://books.toscrape.com/catalogue/category/books/mystery_3/index.html -> 20 books
https://books.toscrape.com/catalogue/category/books/mystery_3/page-2.html -> 12 books
saved 32 books to books.jsonbooks.json dosyasından bir kayıt (açıklama kısaltıldı):
{
  "title": "Sharp Objects",
  "price": 47.82,
  "rating": "Four",
  "url": "https://books.toscrape.com/catalogue/sharp-objects_997/index.html",
  "upc": "e00eb4fd7b871a48",
  "inStock": 20,
  "description": "…"
}
Her bölümün yaptığı iş:
- Sayfalama. Sayfada
li.next akalmadığında döngü durur. 1. sayfadaki bağlantı kategori klasörüne göre göreli olanpage-2.html'dir; her URL'ninnew URL(href, pageUrl)üzerinden geçmesinin nedeni budur. Diğer kalıplar (sorgu dizesindeki sayfa numaraları, imleçler, "daha fazla yükle" API'leri) Sayfalama (Pagination) Nedir? yazısında anlatılıyor. - Eşzamanlılık sınırı.
mapLimit, bir sonraki öğeyi ortak bir sayaçtan alan dört işçi (worker) başlatır. 32 URL'nin tamamı üzerindePromise.allçalıştırmak aynı anda 32 istek gönderirdi; 1.000 URL'de bu, sunucuya ani bir istek patlaması gibi görünür. Küçük bir site için dört, siteyi yormayan makul bir başlangıçtır. - Yeniden deneme. Yalnızca kendiliğinden geçebilecek hatalar yeniden denenir: ağ hataları, 15 saniyelik zaman aşımı, 429 ve 5xx. 404 anında başarısız olur. Sayısal bir
Retry-Afterbaşlığı hesaplanan beklemenin önüne geçer; artan bekleme yaklaşık bir saniyeden başlayarak ikiye katlanır ve paralel işçiler aynı anda yeniden denemesin diye rastgele bir sapma (jitter) ekler. 429'un neden oluştuğu ve başlığın nasıl okunacağı HTTP 429 Too Many Requests yazısında anlatılıyor. - Kısmi hata. Üç yeniden denemeden sonra hâlâ başarısız olan bir ayrıntı sayfası, çalıştırmayı durdurmak yerine
erroralanı olan bir satıra dönüşür. Daha sonra yalnızca bu satırları yeniden deneyebilirsiniz. - JSON. Dosya
scrapedAtvecountalanlarını taşır; bu, çalıştırmaları karşılaştırırken işinize yarar. CSV, JSON Lines ya da upsert destekli SQLite için Kazınan Veri CSV, JSON ve SQLite'a Nasıl Kaydedilir? yazısına bakın.
Cheerio ile proxy kullanımı (undici ProxyAgent)
Bu betikte Cheerio hiçbir bağlantı açmaz; dolayısıyla proxy HTTP istemcisinin işidir. undici ile bir ProxyAgent oluşturur ve onu fetch'e dispatcher olarak verirsiniz. Yukarıdaki tam betik, PROXY_URL tanımlıysa bunu zaten yapıyor:
PROXY_URL=http://user:pass@pr.proxynet.io:8000 node scrape-books.mjsundici, Proxy-Authorization başlığını URL'deki kullanıcı adı ve paroladan oluşturur ve bu değerlerin URL kodlamasını önce çözer; bu yüzden paroladaki özel karakterlerin yüzde kodlamasıyla (percent-encoding) yazılması gerekir (undici ProxyAgent belgeleri). HTTPS hedefler için ajan bir CONNECT tüneli açar ve siteyle kurulan TLS bağlantısı bu tünelin içinden geçer.
Betiği, user:pass isteyen ve her tüneli kaydeden küçük bir yerel proxy üzerinden çalıştırdık. 34 isteğin tamamı (iki liste sayfası, 32 ayrıntı sayfası) tek bir CONNECT books.toscrape.com:443 üzerinden geldi: ajan tüneli açık tuttu ve yeniden kullandı. Parola yanlış olduğunda proxy 407 döndürdü ve undici Proxy response (407) !== 200 when HTTP Tunneling hatasını verdi. Betik vazgeçmeden önce bunu üç kez yeniden denedi; yanlış bir parola kendiliğinden düzelmez, bu yüzden yeniden deneme sayısını artırmak yerine kimlik bilgilerini kontrol edin.
undici'yi bağımlılık olarak eklemek istemiyorsanız, Node.js 24.5 ve 22.21 sürümleri NODE_USE_ENV_PROXY=1 ayarlandığında HTTP_PROXY, HTTPS_PROXY ve NO_PROXY değişkenlerini okuyan yerleşik bir proxy desteği ekledi (Node.js yerleşik proxy desteği). Belgeler bu özelliği hâlâ etkin geliştirme aşamasında (active development) gösteriyor. Node.js 24.11.1 üzerindeki testimizde bu ayarla, ek paket olmadan global fetch yerel proxy üzerinden geçti:
NODE_USE_ENV_PROXY=1 HTTPS_PROXY=http://user:pass@pr.proxynet.io:8000 node first-page.mjsAxios ve node-fetch, dispatcher yerine agent kullanır; ikisi de Node.js'te Proxy Kullanımı yazısında anlatılıyor. Her istekte çıkış IP'sini değiştirmek ya da sticky oturumla bir süre aynı IP'yi korumak için Residential Proxy ve Rotating Proxy aynı user:pass@host:port URL'sini kabul eder.
Cheerio'nun yetmediği durumlar
Cheerio tıklayamaz, kaydıramaz ve sayfanın yüklendikten sonra yaptığı bir isteği bekleyemez. Tarayıcıya ihtiyacınız olduğunu gösteren işaretler:
- Sayfa kaynağında (Ctrl+U), tarayıcıda görüntülenen sayfadaki veri yok.
- HTML'de
<div id="root"></div>gibi boş bir kapsayıcı ve büyük bir betik paketi var. - Veri ancak bir giriş formundan, çerez bildiriminden ya da "sonsuz kaydırma"dan sonra görünüyor.
Tarayıcı başlatmadan önce geliştirici araçlarında Network sekmesini açın. "Dinamik" sayfaların çoğu verisini bir JSON uç noktasından (endpoint) yükler ve bu uç noktayı fetch ile istemek, sayfayı tarayıcıda oluşturmaktan çok daha hafiftir. Tarayıcı gerçekten gerekiyorsa Playwright sayfayı oluşturup son HTML'i cheerio.load(await page.content()) ile Cheerio'ya verebilir; böylece ayrıştırma kodunuz değişmeden kalır.
Cheerio scraper'larının kullanıldığı alanlar
- Fiyat takibi: sunucuda üretilen ürün sayfalarından fiyatları düzenli aralıklarla okumak (fiyat takibi).
- Katalog ve pazar verisi: mağazalardaki ürün yelpazesini ve stok düzeylerini toplamak (pazar araştırması).
- Arama görünürlüğü: kendi sayfalarınızdaki başlıkları, meta etiketleri ve başlık hiyerarşisini kontrol etmek (SEO proxy).
- Veri hatları: ayrıştırılan satırları daha büyük bir crawler'a ya da ETL işine aktarmak (veri kazıma, web crawler).
- Kaydedilmiş HTML'i ayrıştırma: arşivlenmiş sayfaları yapılandırılmış kayıtlara dönüştürmek; ayrıştırma tarafı Veri Ayrıştırma (Parsing) Nedir? yazısında anlatılıyor.
Sık yapılan hatalar ve teşhisleri
- Her yerde boş metinler. Seçici hiçbir şeyle eşleşmedi ya da veri JavaScript ile ekleniyor. HTML'i
writeFile("page.html", html)ile kaydedin ve içinde tarayıcıda gördüğünüz bir değeri arayın. require(...).default is not a functionya dadoes not provide an export named 'default'. Eski içe aktarma biçimi.import * as cheerio from "cheerio"kullanın.invalid onRequestStart methodile birlikteTypeError: fetch failed. npm'deki undici paketinden gelen birProxyAgent'ı Node.js'in globalfetchfonksiyonuna verdiniz. Node 24.11.1 kendi içinde undici 7.16.0 taşır ve iki sürüm aynı dispatcher arayüzünü paylaşmaz.fetchileProxyAgent'ı aynı paketten içe aktarın.- "Hiçbir şey yapmayan" bir proxy. Ajanı kendi istemcisini kullanan
cheerio.fromURL'e verdiniz. Sayfayıfetchile indirin vecheerio.loadçağırın. - Göreli bağlantılar çalışmıyor.
fetch("catalogue/…"),Failed to parse URLhatası fırlatır. Bağlantıyınew URL(href, pageUrl)ile çözümleyin. - Aynı anda çok fazla istek.
Promise.all(urls.map(fetch))her şeyi paralel gönderir ve 429 yanıtlarına davetiye çıkarır.mapLimitgibi bir sınır kullanın. - Sessiz veri kayması. Site bir sınıfın adını değiştirir ve fiyatlar
NaNolur. Her çalıştırmada kontrol edin: satırları sayın,NaNfiyatları sayın ve sayılar birden düşerse durun.
Ölçeği büyütmeden önce sitenin robots.txt dosyasını ve kullanım koşullarını okuyun, varsa resmî API'yi tercih edin ve istek hızını makul tutun. Kurallar robots.txt Dosyası Nedir, Nasıl Okunur? ve Web Scraping Yasal mı? yazılarında, siteyi yormadan tarama ise Web Scraping'de Engellenmeden Veri Toplama Yöntemleri yazısında anlatılıyor.
Karar rehberi
| İhtiyaç | Öneri |
|---|---|
| Veri sayfa kaynağında | fetch + cheerio.load |
| Tek seferlik betik, proxy yok | cheerio.fromURL |
| Aynı yapıda çok sayıda kayıt | Dizi tanımlayıcısıyla $.extract |
| Yüzlerce sayfa | 2-5 arası bir eşzamanlılık sınırı ve artan bekleme ile yeniden deneme |
| Proxy üzerinden istekler | undici fetch + ProxyAgent ya da Node.js 24.5+ üzerinde NODE_USE_ENV_PROXY=1 |
| Veri yalnızca JavaScript çalıştıktan sonra görünüyor | Önce JSON uç noktasını bulun, yoksa Playwright + Cheerio |
Kod tam bir DOM bekliyor (document, olaylar) | jsdom |
Sıkça sorulan sorular
Cheerio 2026'da hâlâ geliştiriliyor mu?
Evet. npm kaydı, Ocak 2026'da yayımlanan 1.2.0 sürümünü en son sürüm olarak gösteriyor; belge sitesi de extract ve fromURL dahil 1.x API'sini kapsıyor.
Cheerio JavaScript çalıştırır mı?
Hayır. Yalnızca ona verdiğiniz HTML metnini ayrıştırır, fazlasını yapmaz. Sayfadaki betikler metin olarak ele alınır. İçeriğini tarayıcıda kuran sayfalar için Playwright kullanın ya da sayfanın çağırdığı veri uç noktasını bulun.
Cheerio ile Axios kullanmak gerekir mi?
Hayır. Node.js 18 ve sonrasında fetch yerleşik olarak gelir ve çoğu scraper'ın ihtiyacını karşılar. Axios bir tercih meselesidir; kullanıyorsanız yanıt gövdesini (response.data) cheerio.load'a verin.
Cheerio ile birden fazla sayfa nasıl kazınır?
Her sayfadan bir sonraki sayfanın bağlantısını okuyun, onu geçerli URL'ye göre çözümleyin ve yukarıdaki tam betikte olduğu gibi bağlantı kalmayana kadar döngüyü sürdürün. Sayfa sayısı biliniyorsa URL listesini baştan oluşturup bir eşzamanlılık sınırıyla da çalıştırabilirsiniz.
Cheerio ile proxy nasıl kullanılır?
Proxy'yi Cheerio'da değil, HTTP istemcisinde yapılandırın. undici ile: new ProxyAgent("http://user:pass@pr.proxynet.io:8000") oluşturup undici'nin fetch fonksiyonuna dispatcher olarak verin. Node.js 24.5 ya da üstünde bunun yerine NODE_USE_ENV_PROXY=1 ve HTTPS_PROXY değişkenlerini ayarlayabilirsiniz.
Cheerio, Puppeteer ya da Playwright'tan hızlı mı?
Verisi HTML'de bulunan sayfalar için evet; çünkü Cheerio yalnızca metni ayrıştırır, tarayıcı ise ek olarak kaynakları indirir, betikleri çalıştırır ve sayfa düzenini hesaplar. Farkı ölçmedik ve fark sayfaya göre değişir; rakamlar sizin için önemliyse kendi hedeflerinizde ölçün.
Özet
Cheerio, indirilen HTML'i CSS seçicileriyle sorgulayabileceğiniz bir ağaca çevirir ve 1.x sürümünde fromURL ile extract yöntemlerini ekler. Güvenilir bir scraper ağ işini Cheerio'nun dışında tutar: zaman aşımı tanımlı fetch, 429, 5xx ve ağ hataları için yeniden deneme, küçük bir eşzamanlılık sınırı ve zaman damgası taşıyan bir JSON dosyası. İsteklerin başka bir IP'den ya da ülkeden çıkması gerektiğinde bir undici ProxyAgent'ını dispatcher olarak verin ve onu bir Proxynet proxy'sine yönlendirin.