

































Web scraping · Blog de Proxynet – Página 2

Publicado
Please Enable JS And Disable Any Ad Blocker: qué significa
Please Enable JS And Disable Any Ad Blocker es el aviso de reserva del control anti-bot de DataDome. Permite el sitio en tu bloqueador y activa JavaScript.
Autor: Acar Diveroli
Publicado
Proxy en Puppeteer: autenticación, rotación y SOCKS5
Puppeteer usa un proxy con el flag --proxy-server de Chrome o por contexto de navegador, y page.authenticate() para el login. Ejemplos probados y errores.
Autor:Acar Diveroli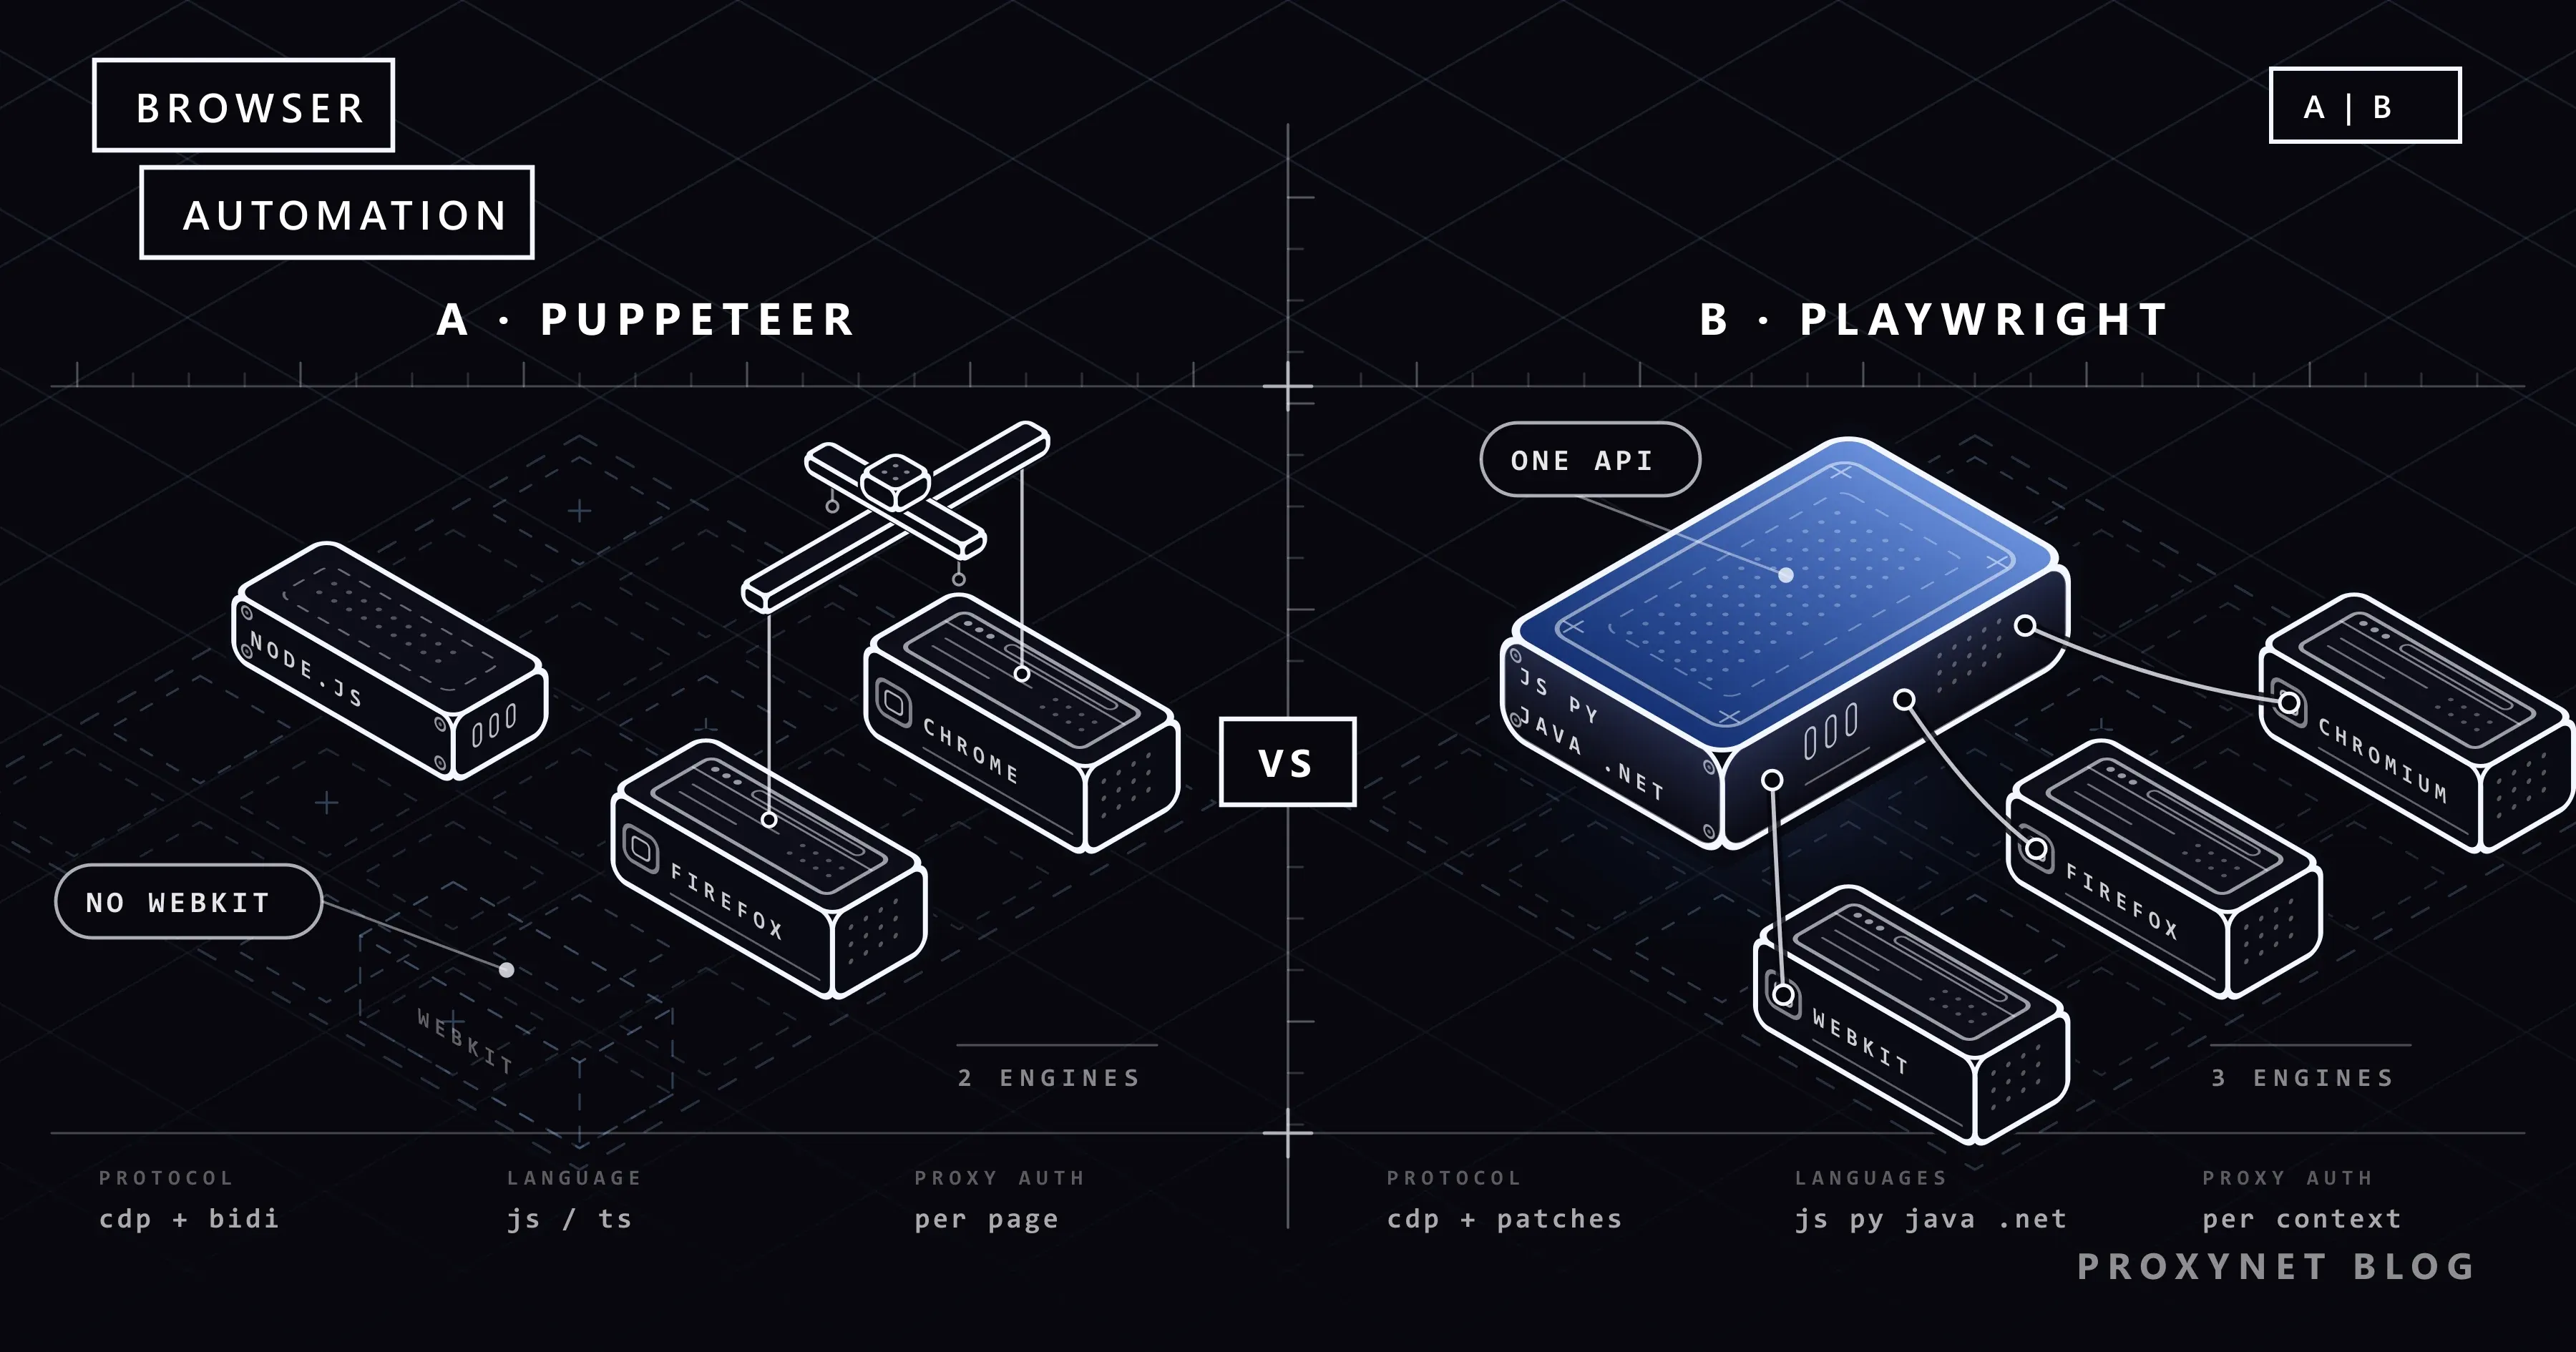
Publicado
Puppeteer vs Playwright: ¿cuál deberías elegir?
Puppeteer controla Chrome y Firefox desde Node.js; Playwright suma WebKit, cuatro lenguajes y un ejecutor de pruebas. Comparamos proxies, esperas y MCP.
Autor:Acar Diveroli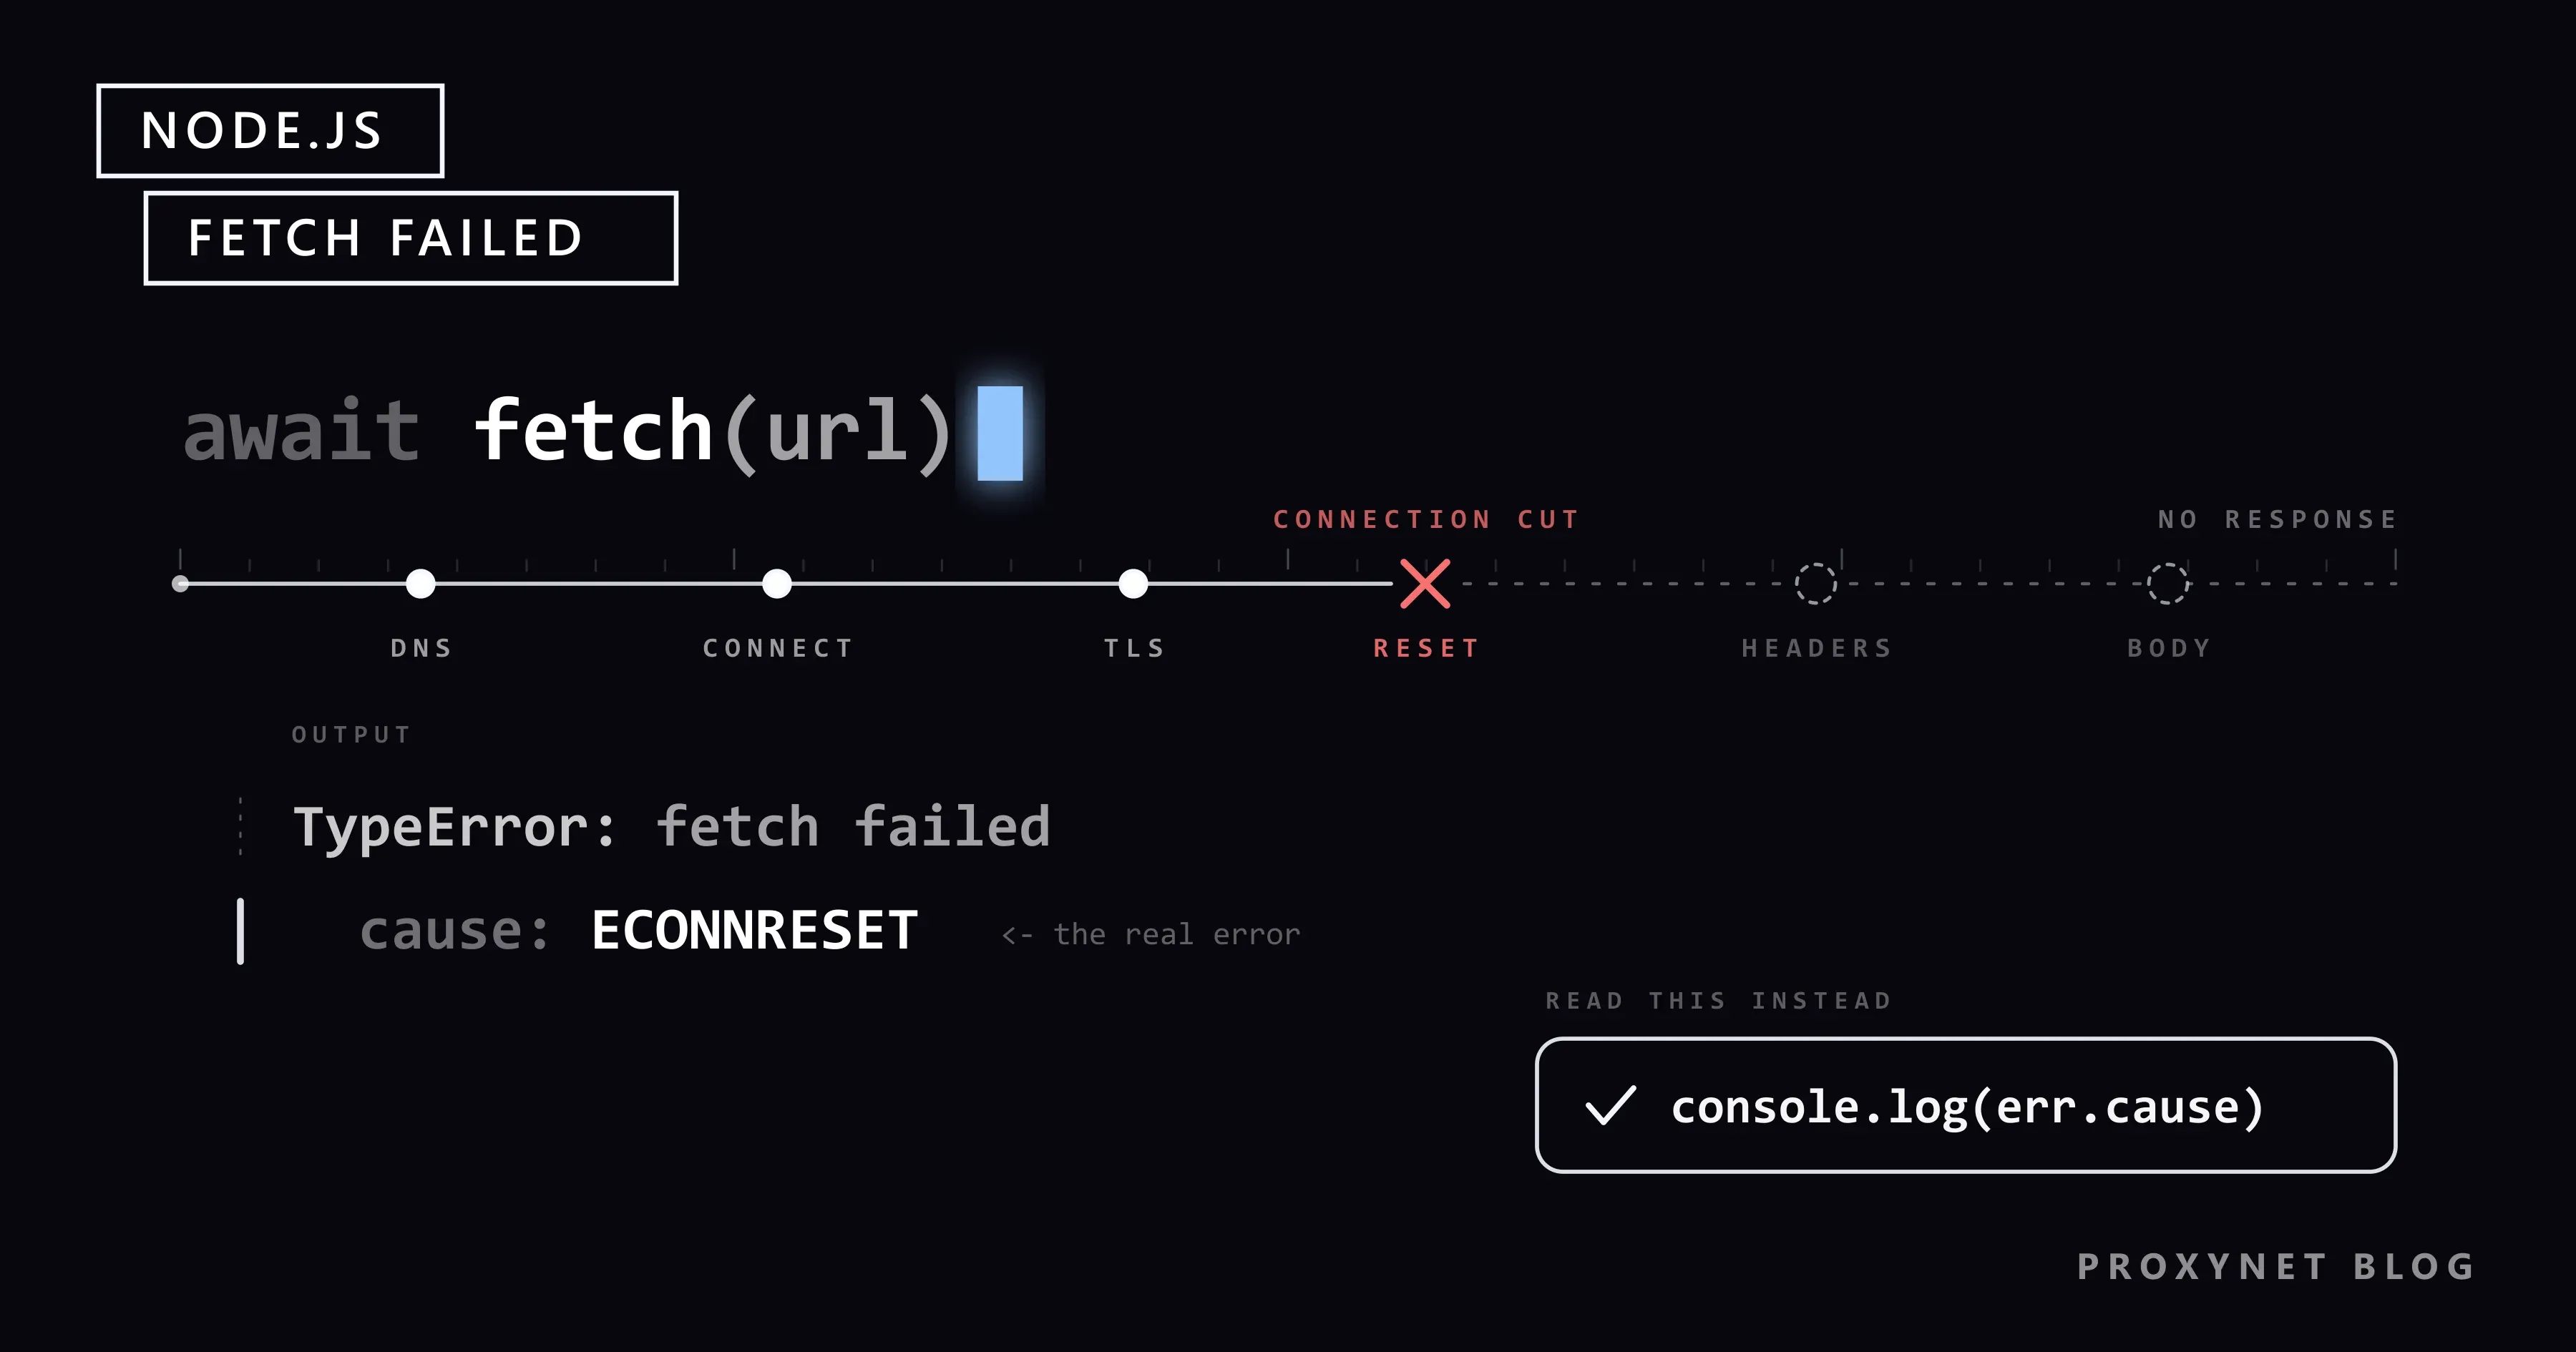
Publicado
TypeError: fetch failed en Node.js: causas y soluciones
TypeError: fetch failed en Node.js oculta el error real en err.cause. Aprende a leerlo y a corregir causas de DNS, conexión, timeout, certificado y proxy.
Autor:Acar Diveroli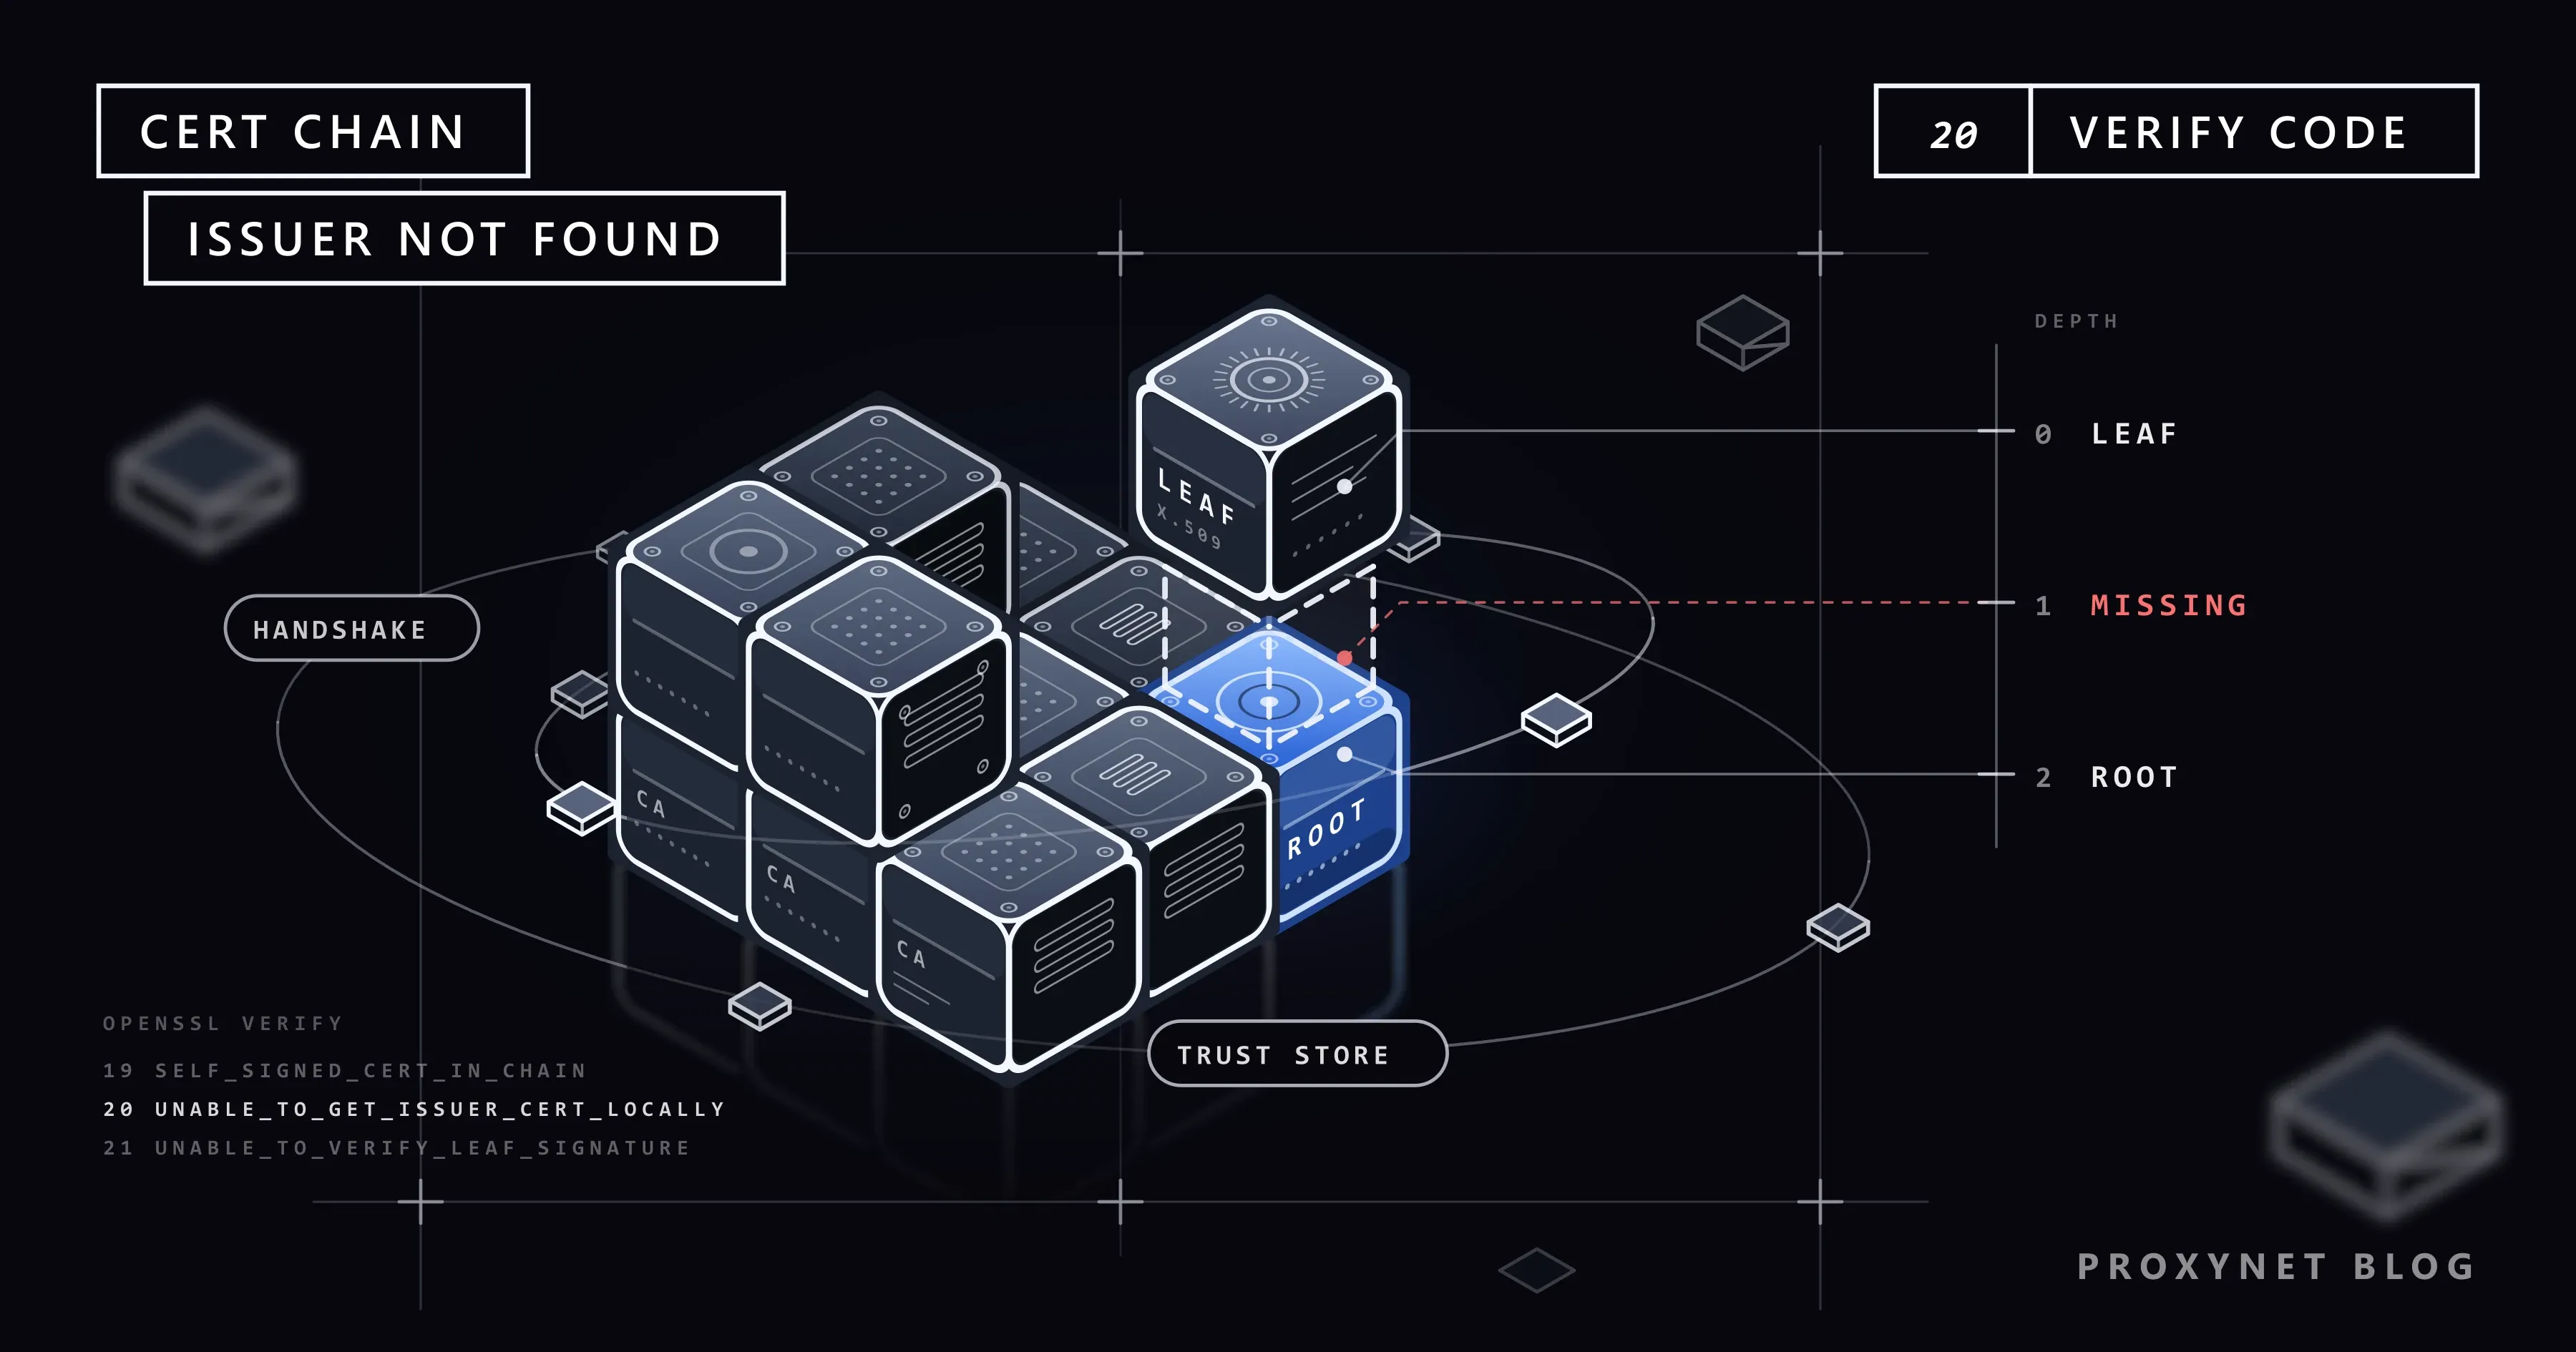
Publicado
Unable to Get Local Issuer Certificate: cómo solucionarlo
Unable to get local issuer certificate: tu herramienta no encuentra la CA que firmó la cadena del servidor. Causas y soluciones en Python, npm, Git y curl.
Autor:Acar Diveroli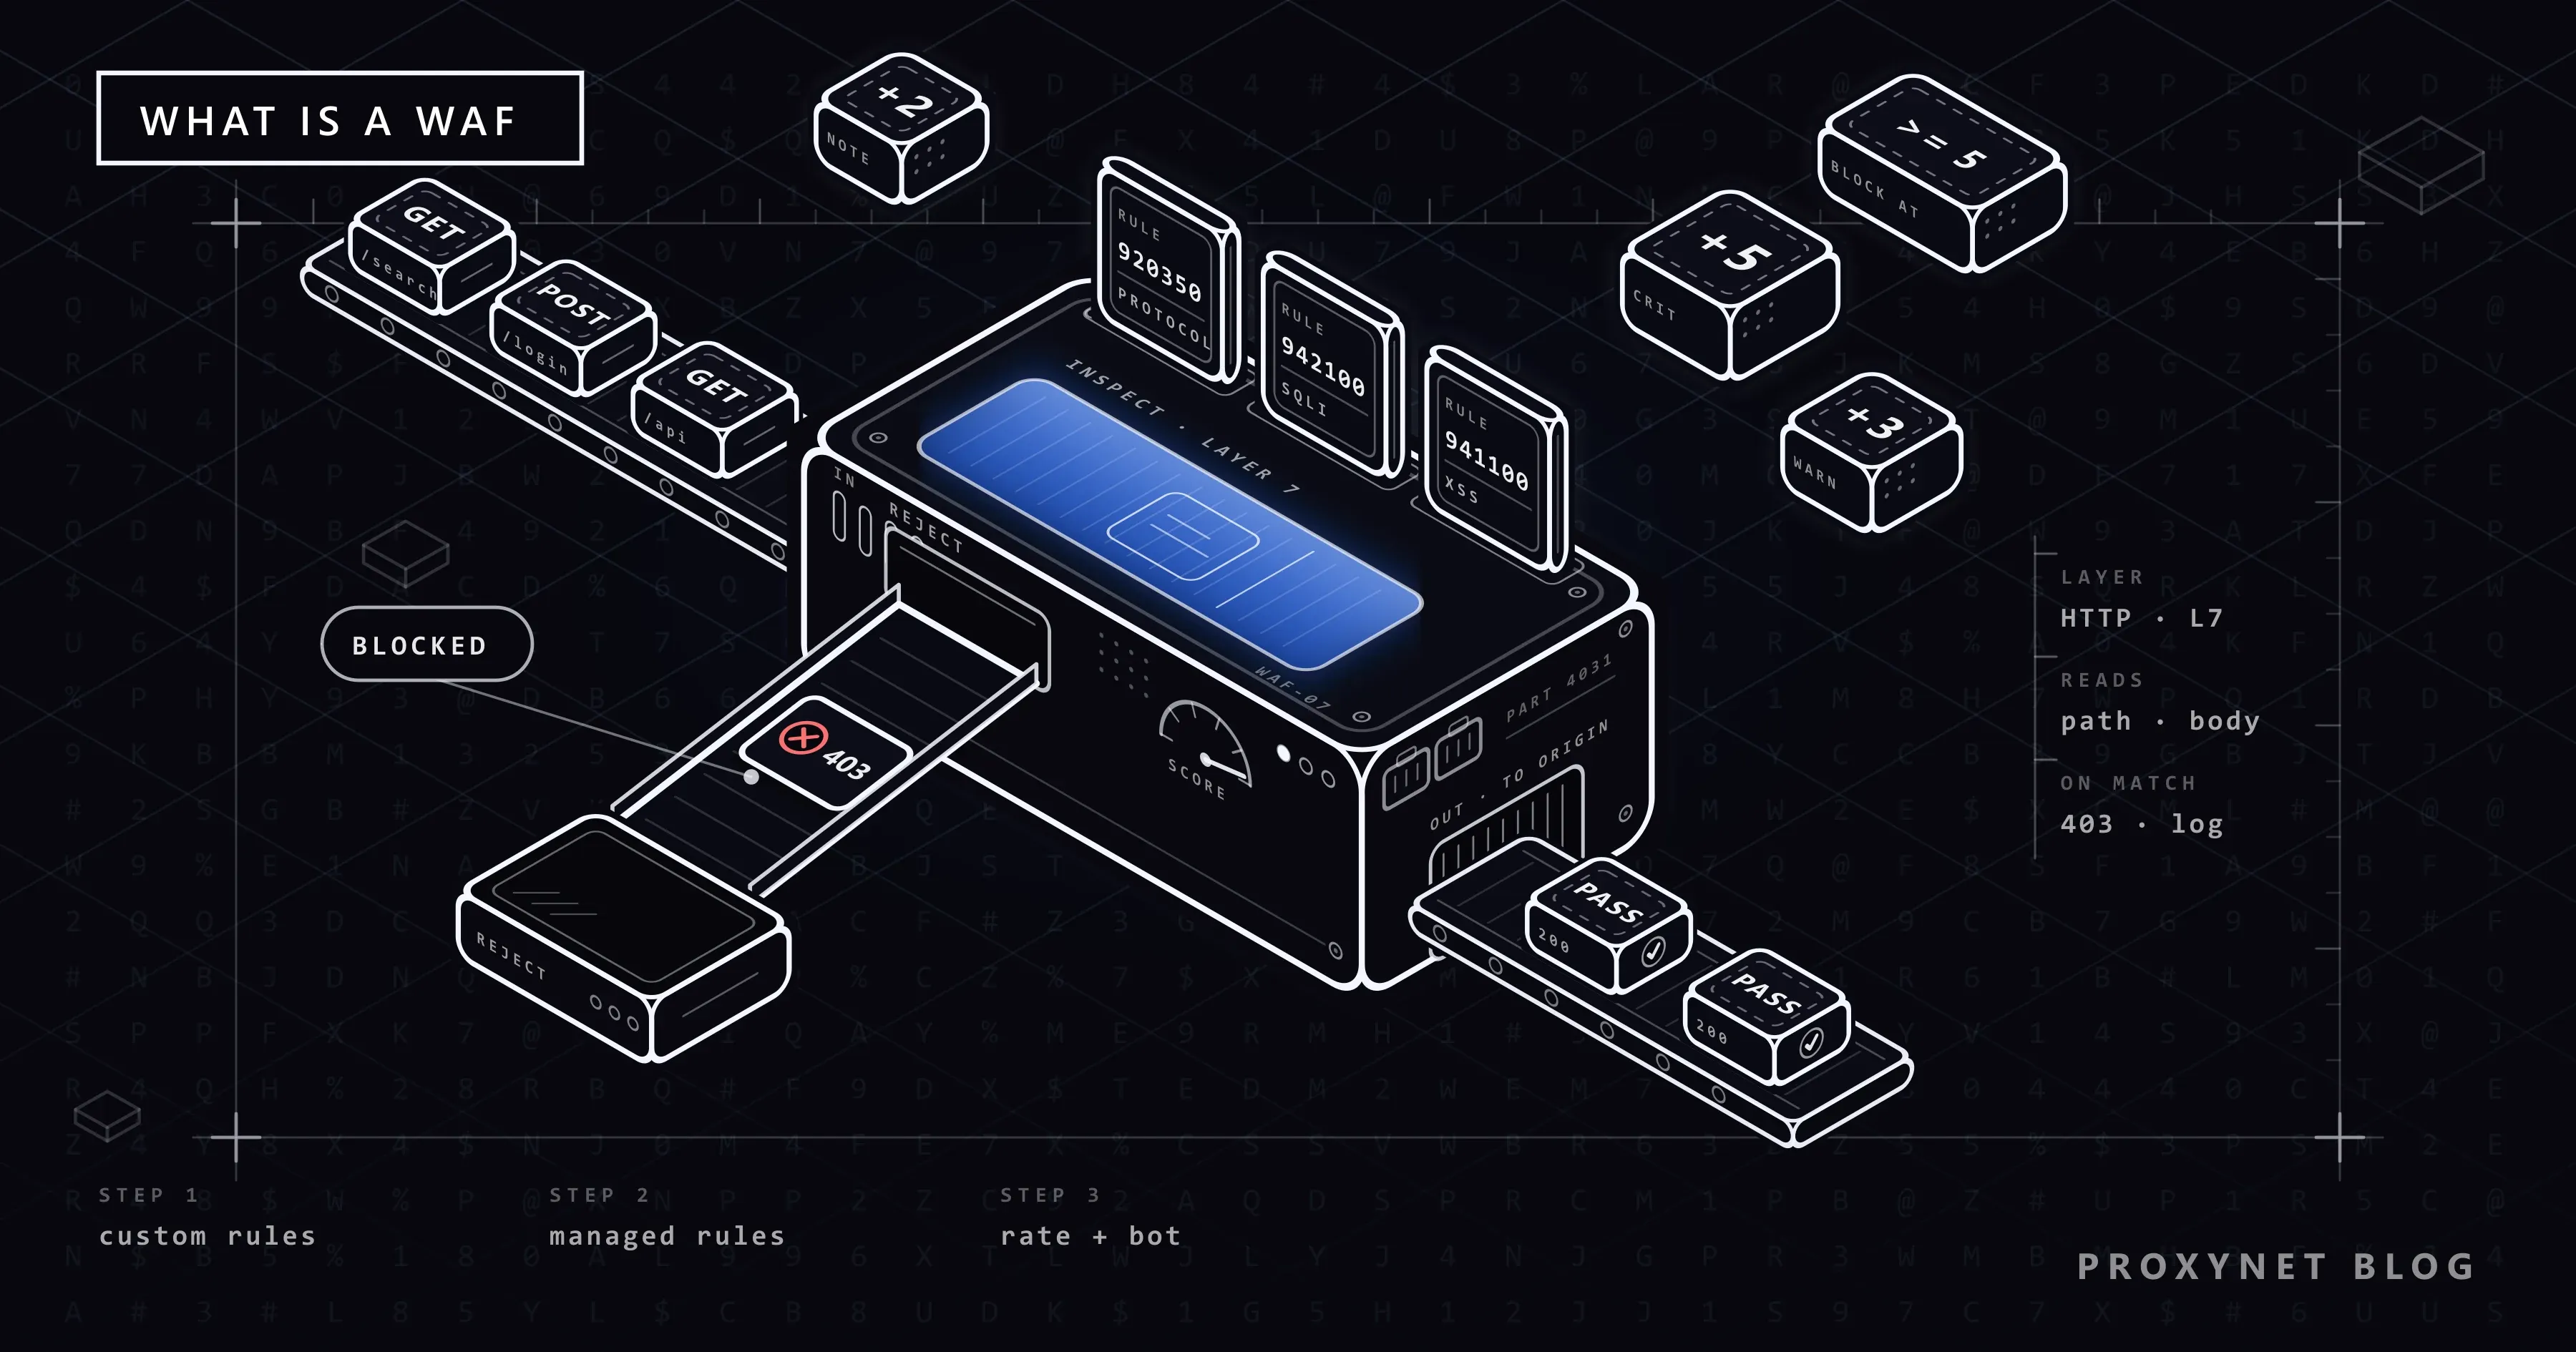
Publicado
¿Qué es un WAF (firewall de aplicaciones web)? Cómo funciona
Un WAF (firewall de aplicaciones web) revisa las solicitudes HTTP antes de que lleguen al sitio y bloquea ataques. Dónde se sitúa y cómo deciden sus reglas.
Autor:Acar Diveroli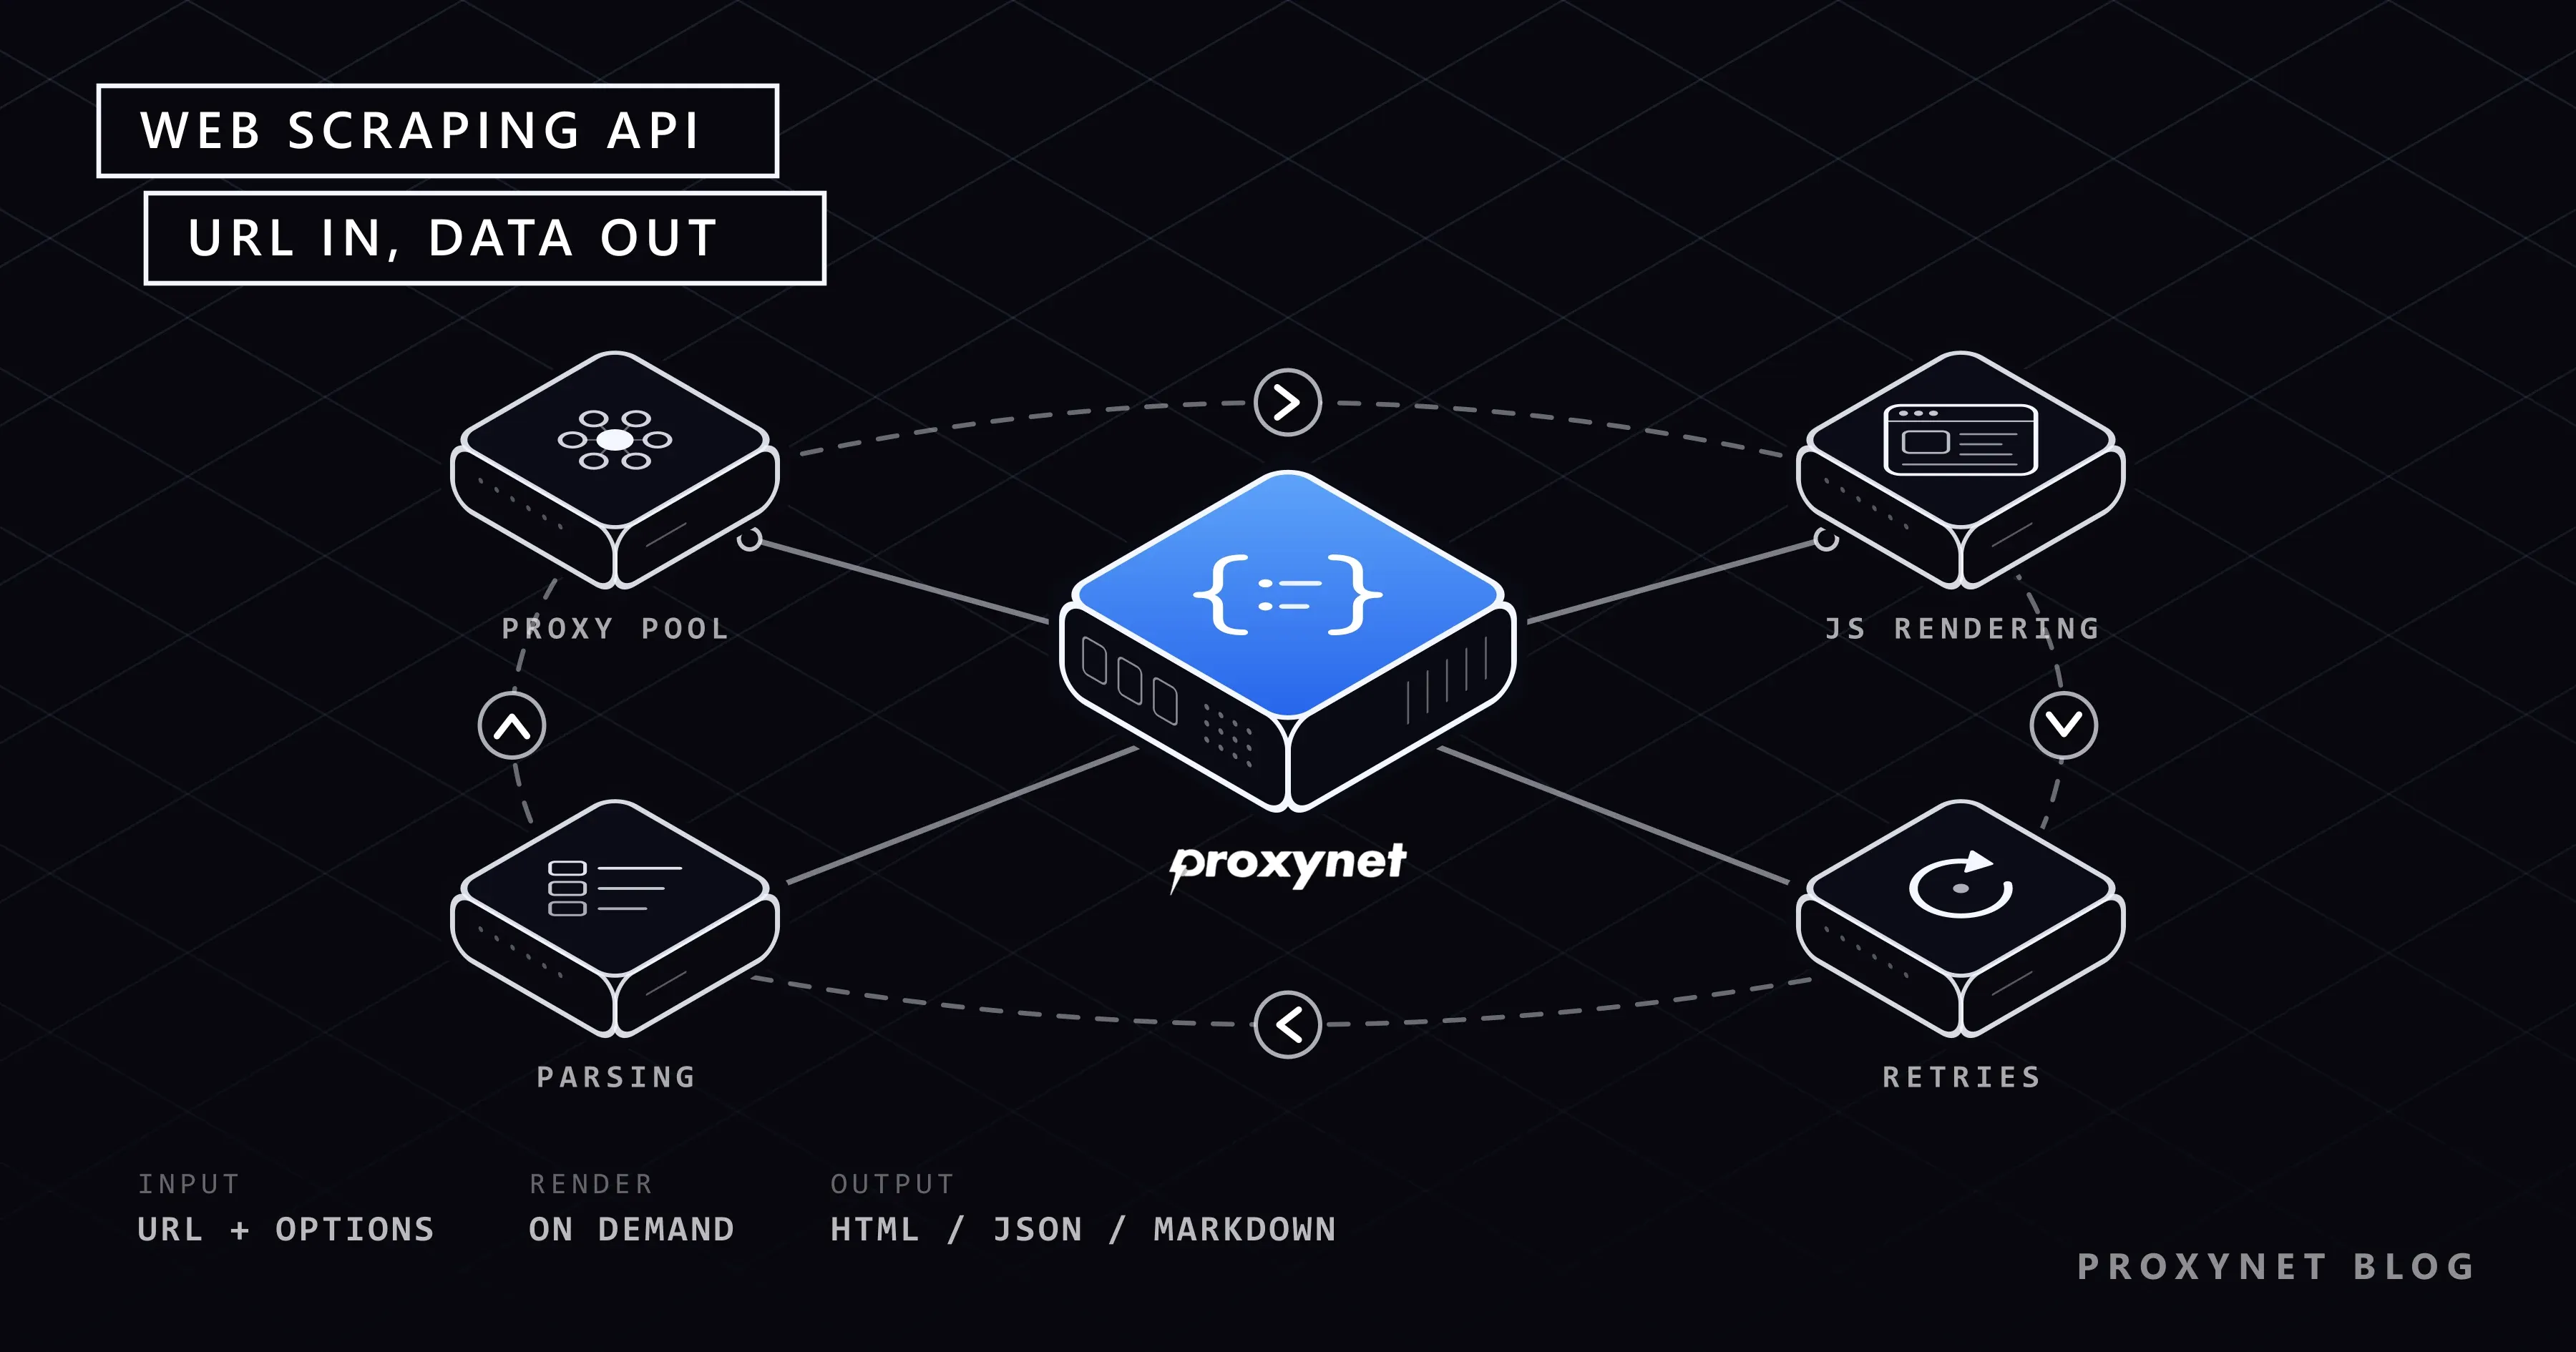
Publicado
¿Qué es una API de web scraping (scraper API)? Cómo funciona
Una API de web scraping descarga páginas por ti: envías una URL y se encarga de proxies, renderizado y reintentos; devuelve HTML, JSON o Markdown.
Autor:Acar Diveroli
Publicado
Access to this page has been denied: causas y soluciones
Access to this page has been denied es el control anti-bot de HUMAN (antes PerimeterX). Activa JavaScript y cookies, quita bloqueadores y VPN y mantén pulsado.
Autor:Acar Diveroli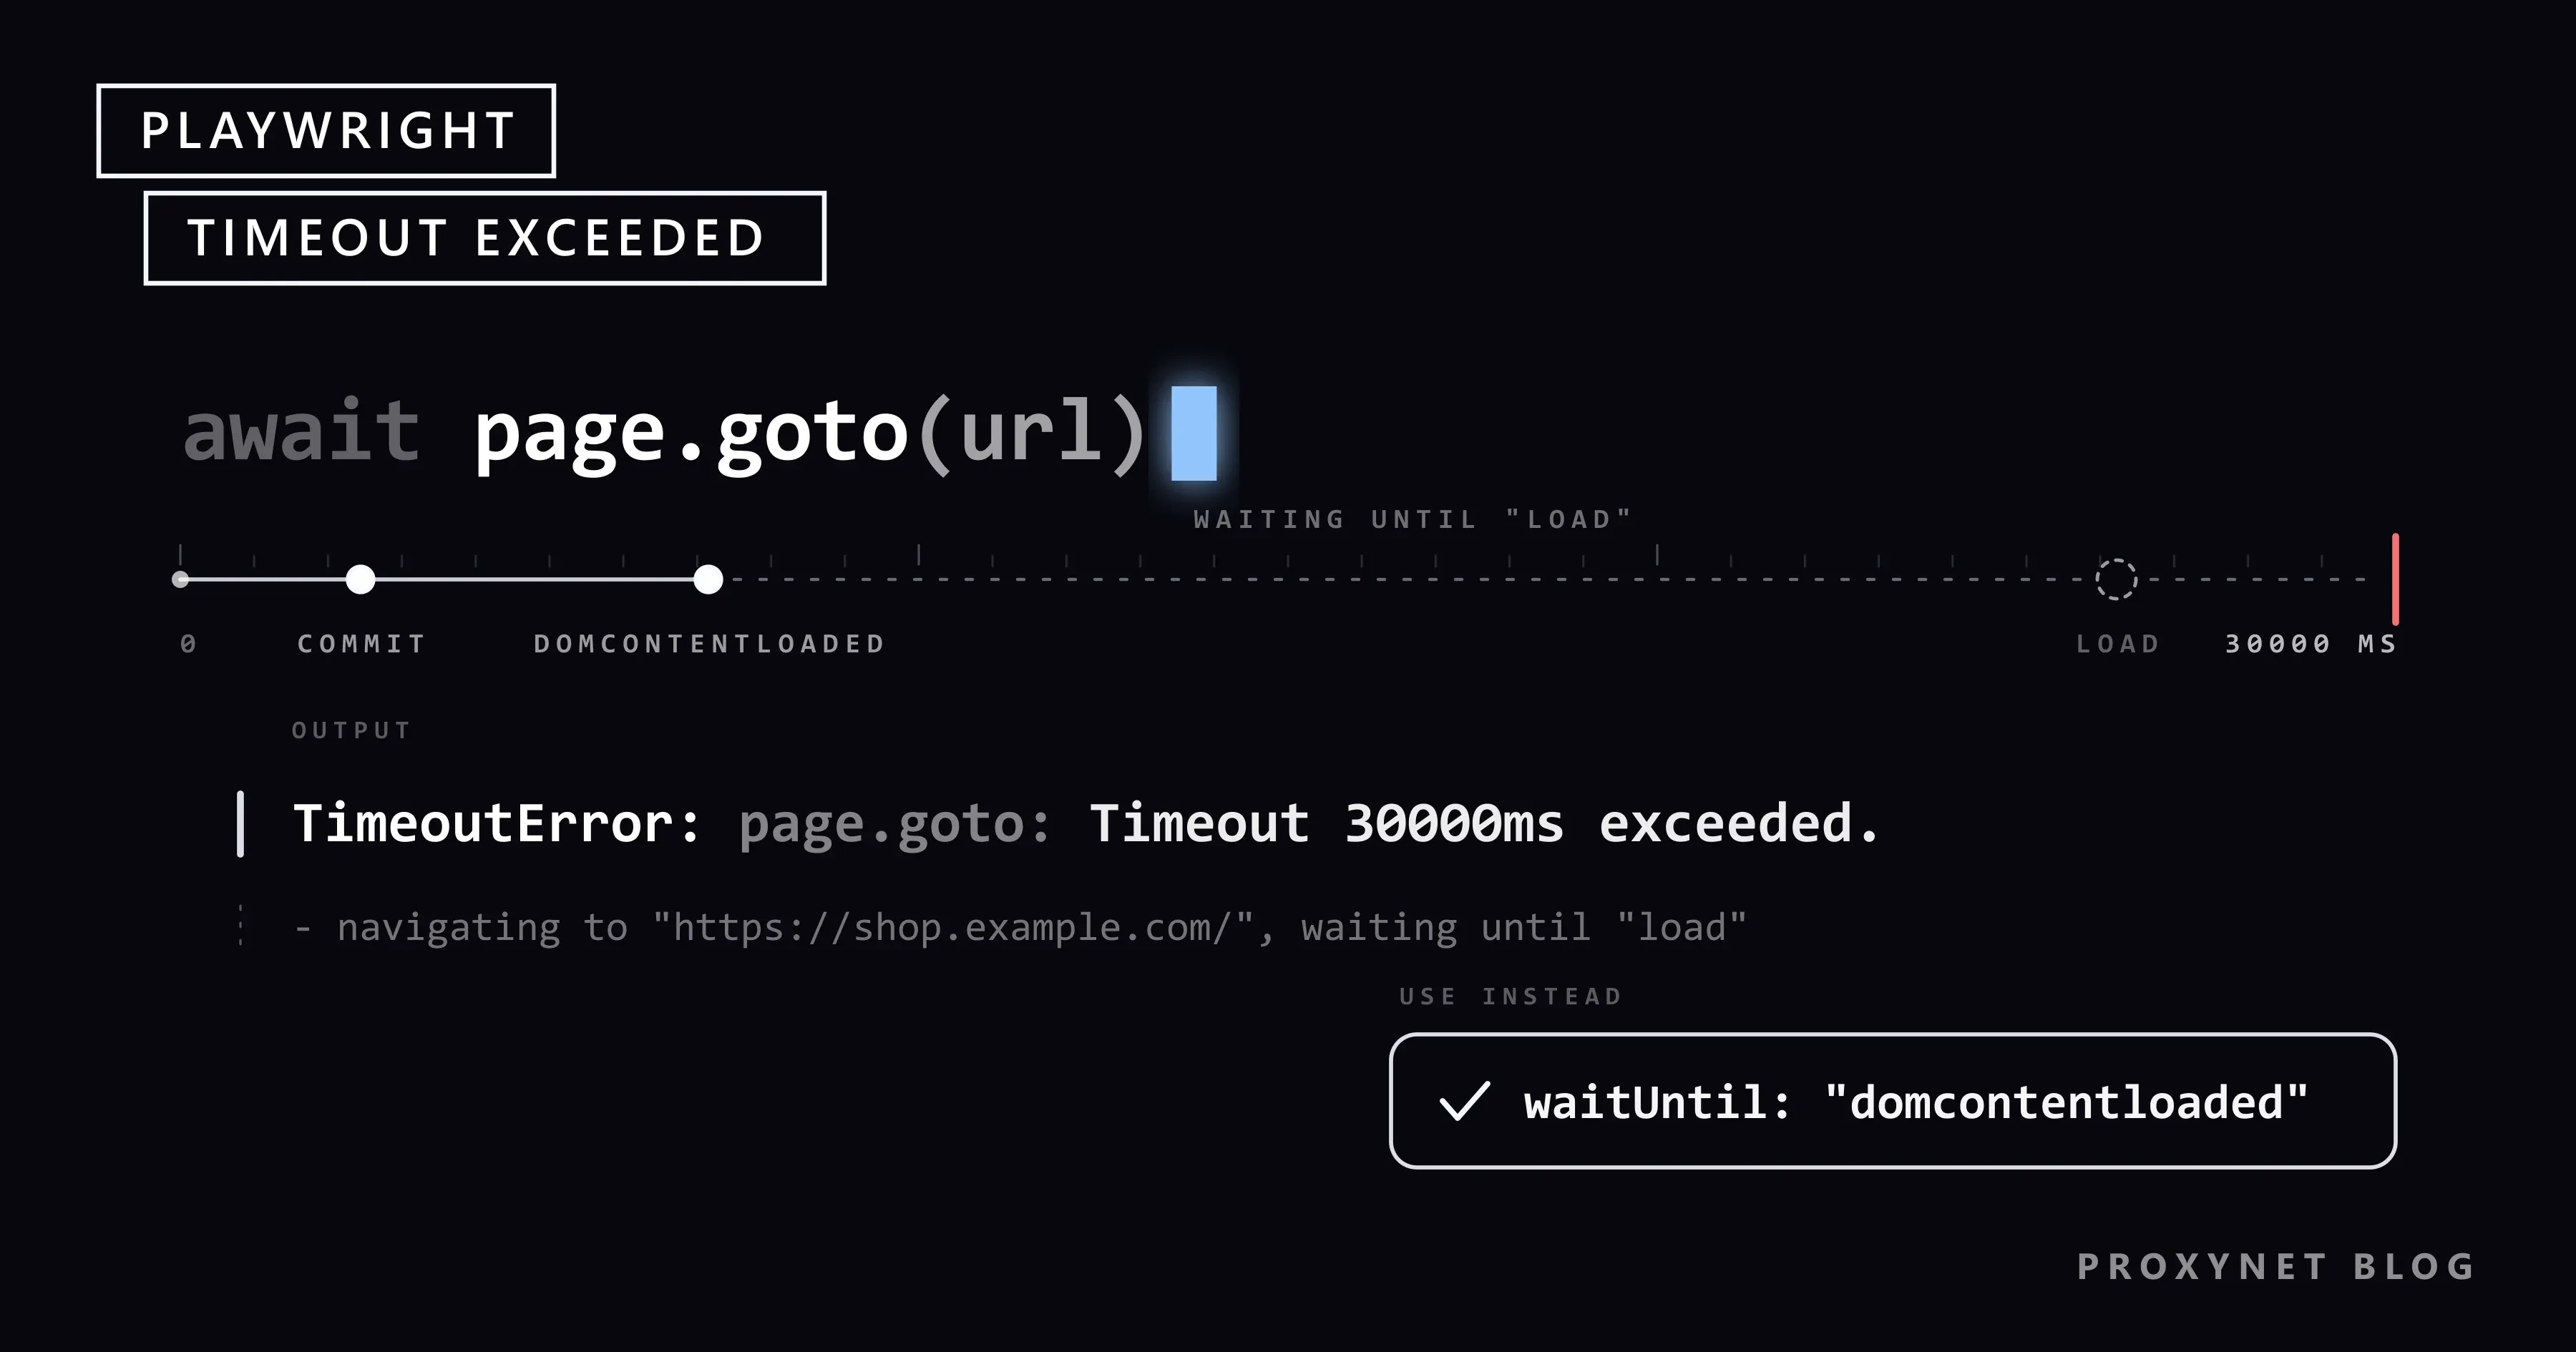
Publicado
Playwright Timeout 30000ms Exceeded: cómo solucionarlo
Playwright timeout 30000ms exceeded indica que una navegación, un locator, un expect o la prueba entera se quedó sin tiempo. Lee el call log y corrige la causa.
Autor:Acar Diveroli
Publicado
Reputación de IP: qué es y por qué bloquean tu proxy
La reputación de IP es una puntuación hecha con el historial y el tipo de red de una dirección. Qué mide, por qué bloquean los proxies y cómo se recupera.
Autor:Acar Diveroli
Publicado
Proxies para rank tracking en Google: la ubicación importa
Google arma una página de resultados distinta por país, ciudad, idioma y dispositivo: comprobar una posición es tan exacto como el lugar desde donde se hace.
Autor:Acar Diveroli
Publicado
Web scraping en Python con proxies rotativos
Apunta requests o httpx a un gateway rotativo, reintenta los 429 con backoff, limita la concurrencia y verifica la IP de salida. Código Python probado.
Autor:Acar Diveroli
Please Enable JS And Disable Any Ad Blocker: qué significa
Autor: Acar DiveroliWeb scrapingPublicado
Proxy en Puppeteer: autenticación, rotación y SOCKS5
Autor: Acar DiveroliIntegraciónPublicado
Puppeteer vs Playwright: ¿cuál deberías elegir?
Autor: Acar DiveroliComparativasPublicado
TypeError: fetch failed en Node.js: causas y soluciones
Autor: Acar DiveroliTutorialesPublicado
Unable to Get Local Issuer Certificate: cómo solucionarlo
Autor: Acar DiveroliTutorialesPublicado
¿Qué es un WAF (firewall de aplicaciones web)? Cómo funciona
Autor: Acar DiveroliWeb scrapingPublicado
¿Qué es una API de web scraping (scraper API)? Cómo funciona
Autor: Acar DiveroliWeb scrapingPublicado
Access to this page has been denied: causas y soluciones
Autor: Acar DiveroliWeb scrapingPublicado
Playwright Timeout 30000ms Exceeded: cómo solucionarlo
Autor: Acar DiveroliTutorialesPublicado
Reputación de IP: qué es y por qué bloquean tu proxy
Autor: Acar DiveroliProxy 101Publicado
Proxies para rank tracking en Google: la ubicación importa
Autor: Acar DiveroliCasos de usoPublicado
Web scraping en Python con proxies rotativos
Autor: Acar DiveroliWeb scrapingPublicado
Ningún artículo coincide
Publicado
Publicado