

































Web scraping · Blog da Proxynet – Página 2

Publicado
Please Enable JS And Disable Any Ad Blocker: o que significa
Please Enable JS And Disable Any Ad Blocker é o texto reserva do anti-bot da DataDome. Libere o site no bloqueador, ative o JavaScript e desligue a VPN.
Autor: Acar Diveroli
Publicado
Proxy no Puppeteer: autenticação, rotação e SOCKS5
O Puppeteer usa um proxy pela flag --proxy-server do Chrome ou por contexto de navegador, com page.authenticate() para o login. Exemplos testados e erros.
Autor:Acar Diveroli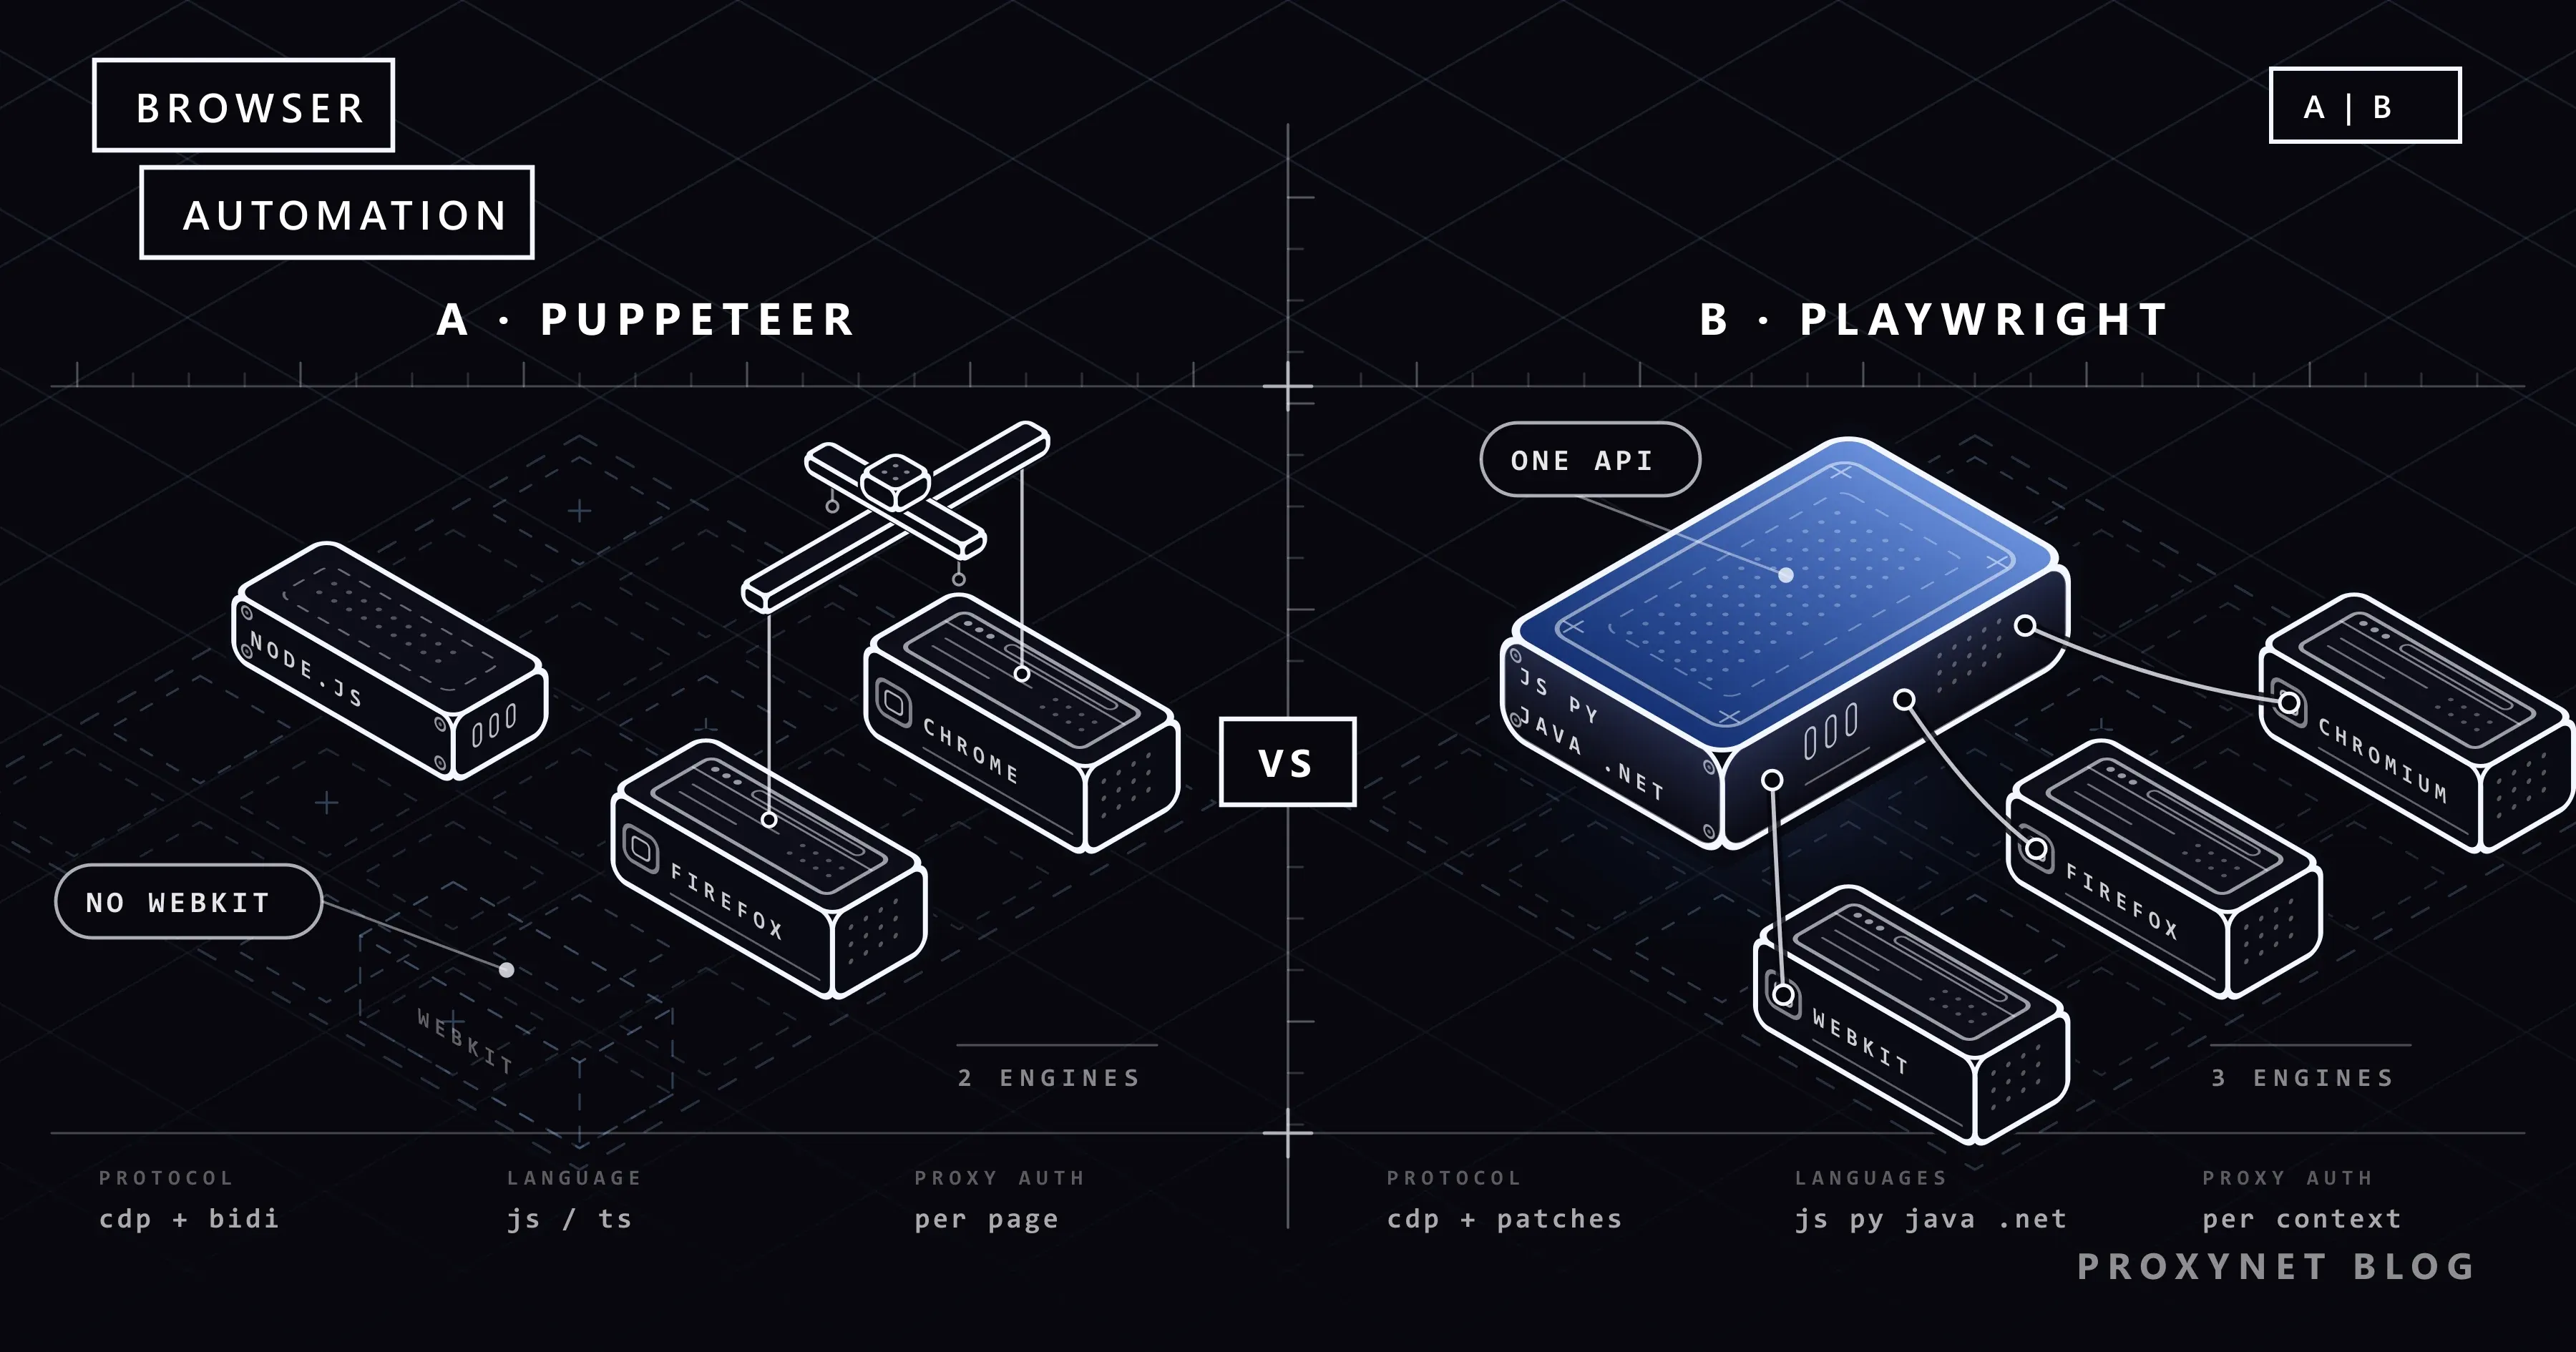
Publicado
Puppeteer vs Playwright: qual você deve escolher?
O Puppeteer controla Chrome e Firefox a partir do Node.js; o Playwright soma WebKit, quatro linguagens e um executor de testes. Comparamos proxy, espera e MCP.
Autor:Acar Diveroli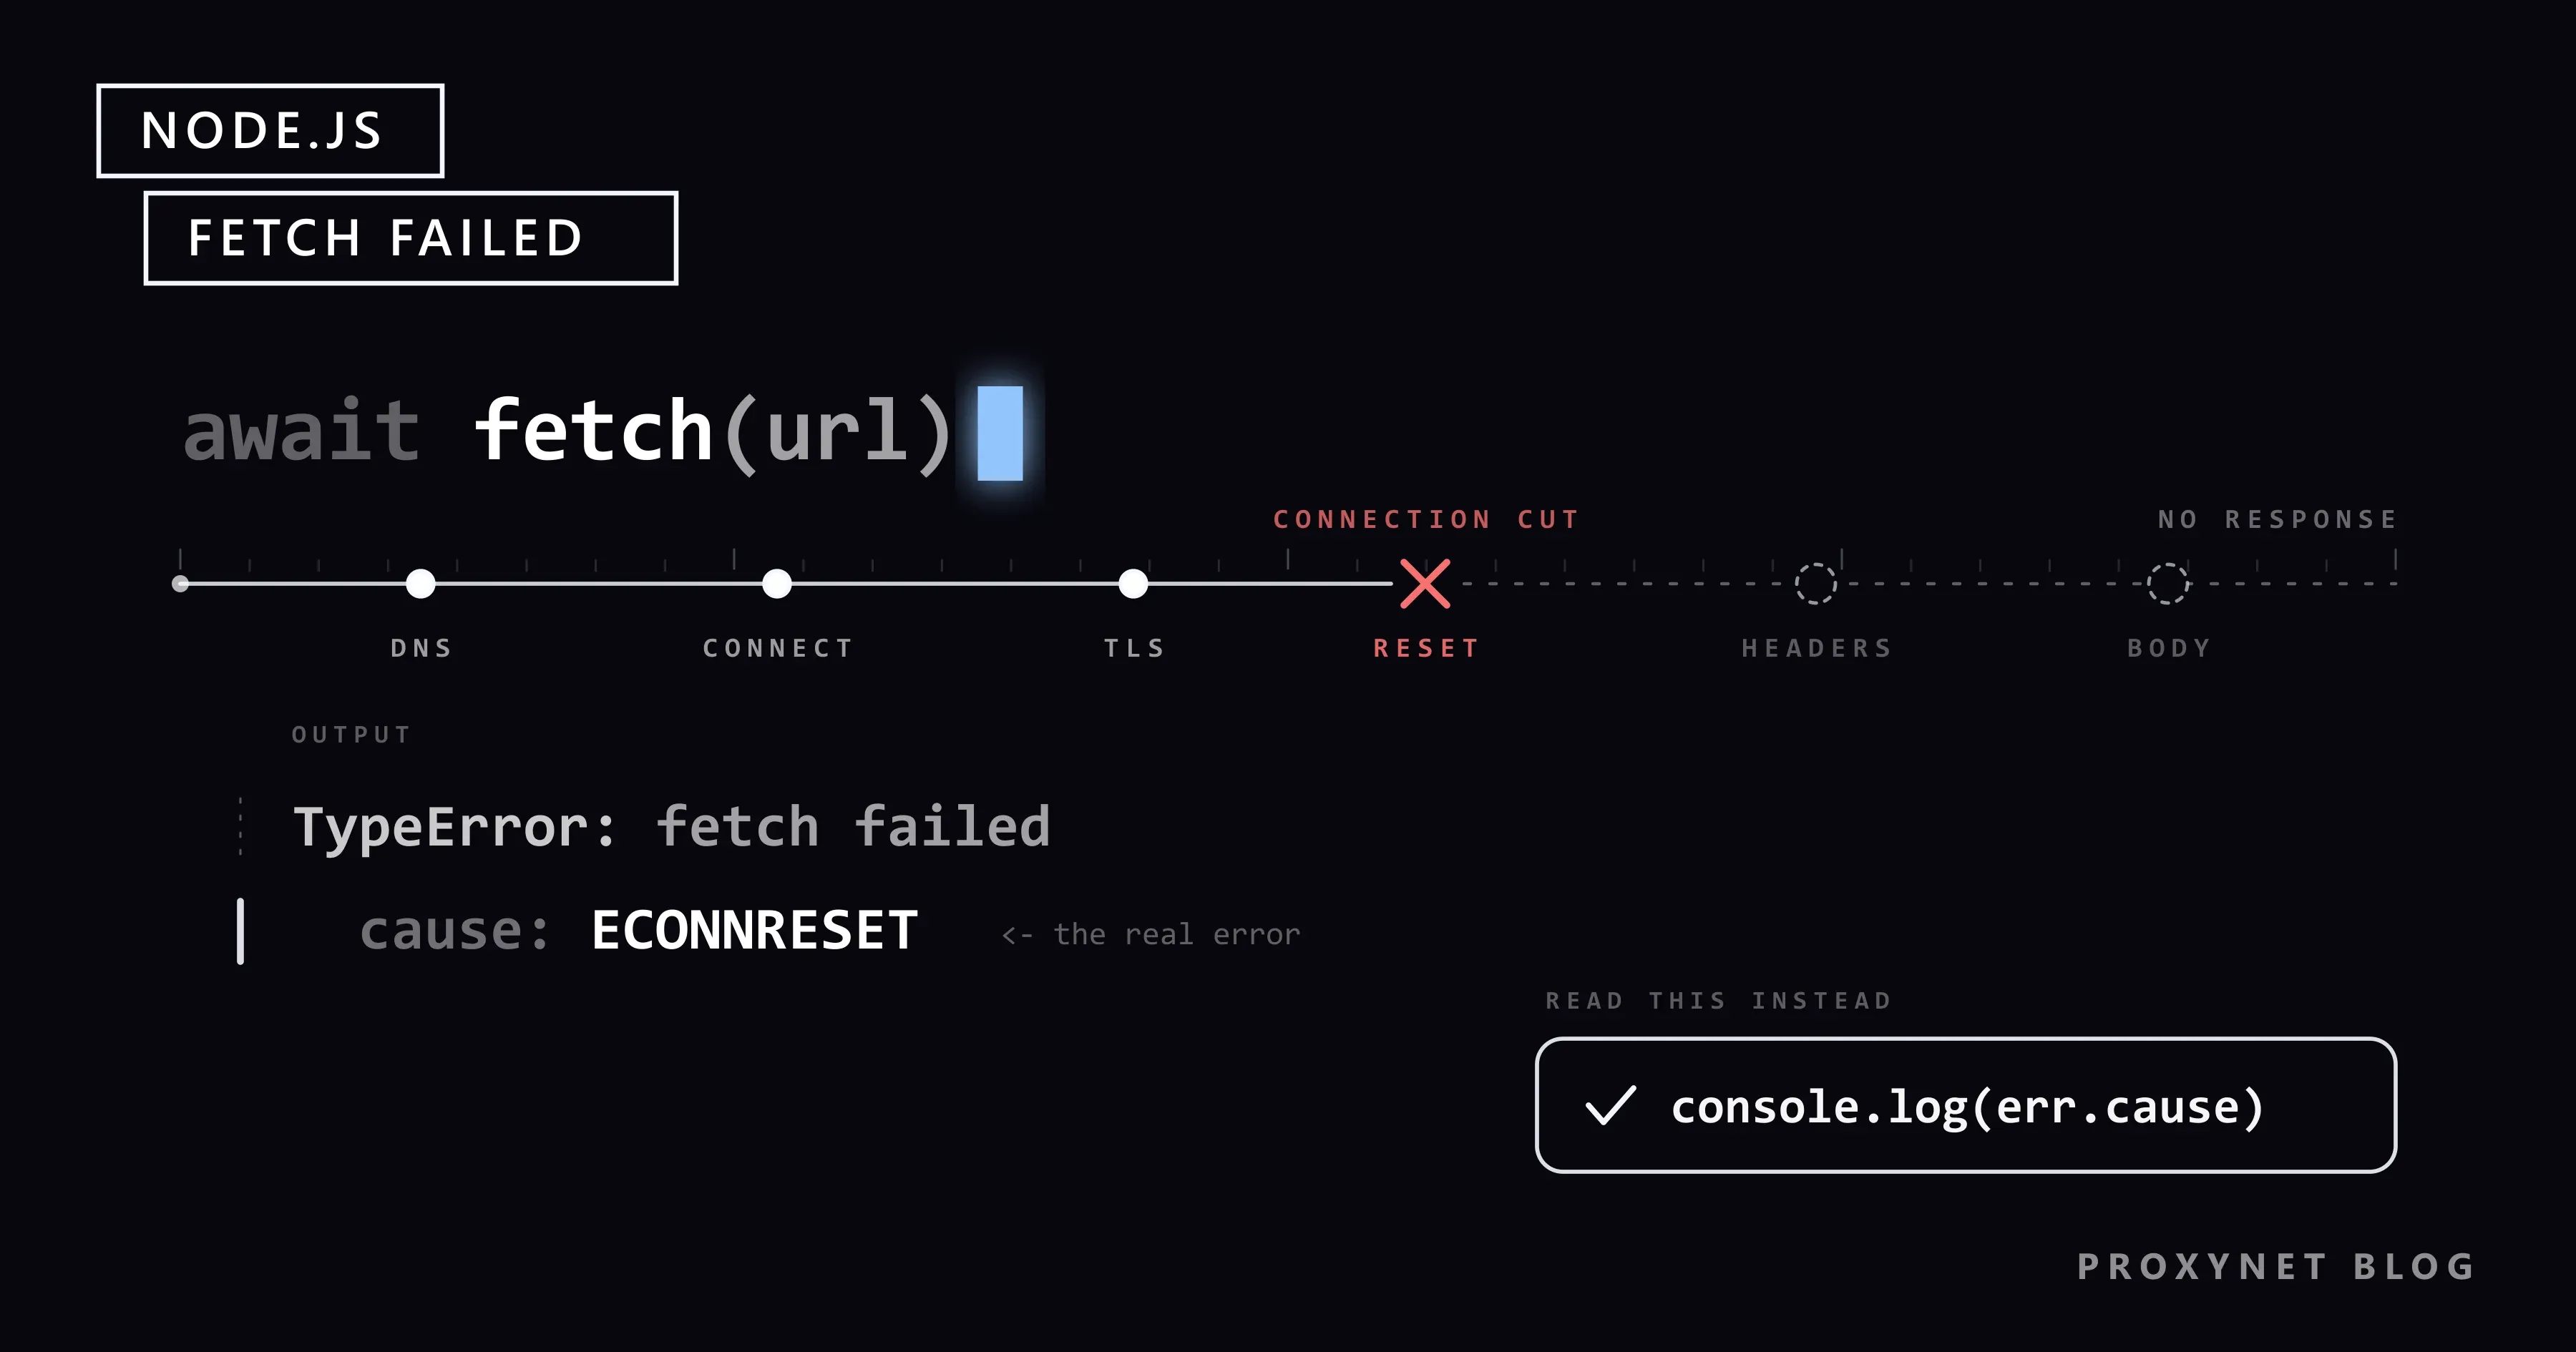
Publicado
TypeError: fetch failed no Node.js: causas e soluções
TypeError: fetch failed no Node.js esconde o erro real em err.cause. Veja como lê-lo e corrigir causas de DNS, conexão, timeout, certificado e proxy.
Autor:Acar Diveroli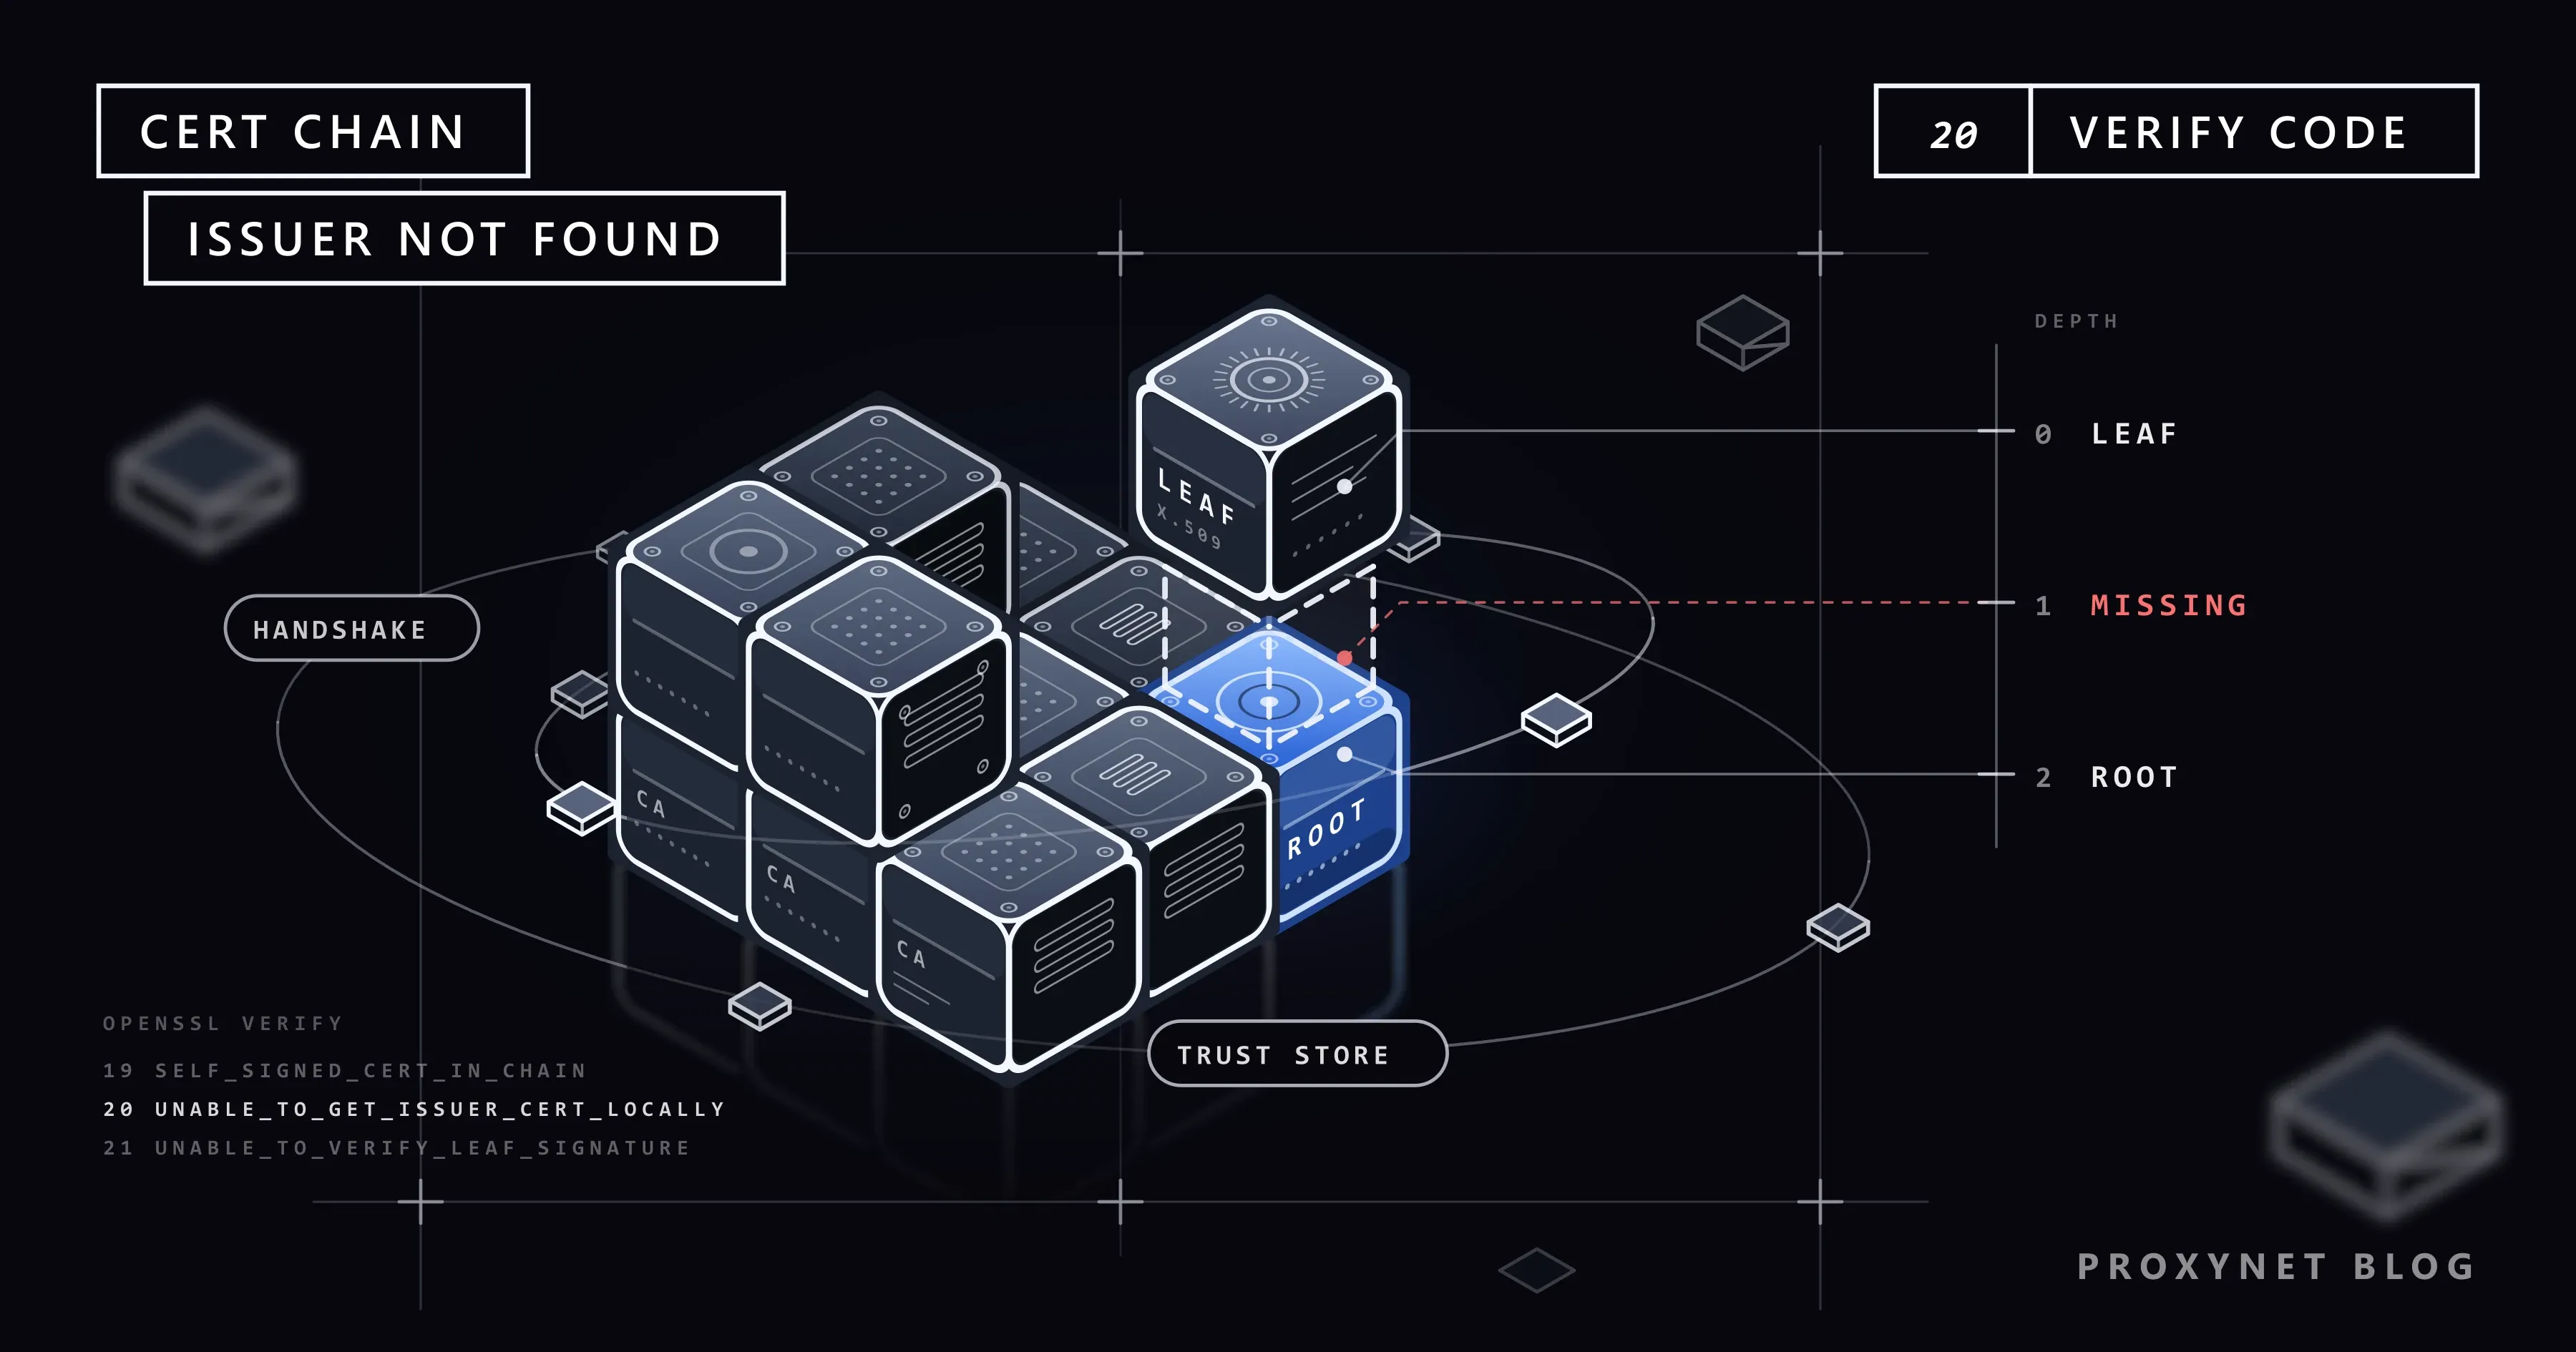
Publicado
Unable to Get Local Issuer Certificate: como resolver
Unable to get local issuer certificate: sua ferramenta não encontra a CA que assinou a cadeia do servidor. Causas e soluções no Python, npm, Git e curl.
Autor:Acar Diveroli
Publicado
O que é WAF (firewall de aplicação web) e como funciona?
Um WAF (firewall de aplicação web) analisa as requisições HTTP antes que cheguem ao site e bloqueia ataques. Veja onde ele fica e como as regras decidem.
Autor:Acar Diveroli
Publicado
Web scraping API: o que é, como funciona e quando usar
Uma API de web scraping baixa páginas por você: você envia uma URL, ela cuida de proxies, renderização e novas tentativas e devolve HTML, JSON ou Markdown.
Autor:Acar Diveroli
Publicado
Access to this page has been denied: causas e soluções
Access to this page has been denied é a verificação anti-bot da HUMAN (ex-PerimeterX). Ative JavaScript e cookies, desligue bloqueadores e VPN e segure o botão.
Autor:Acar Diveroli
Publicado
Playwright Timeout 30000ms Exceeded: como resolver o erro
Playwright timeout 30000ms exceeded indica que uma navegação, um locator, um expect ou o teste inteiro ficou sem tempo. Leia o call log e corrija a causa.
Autor:Acar Diveroli
Publicado
O que é reputação de IP e por que proxies são bloqueados
Reputação de IP é uma pontuação feita com o histórico e o tipo de rede de um endereço. Veja o que ela mede, por que proxies são bloqueados e como se recupera.
Autor:Acar Diveroli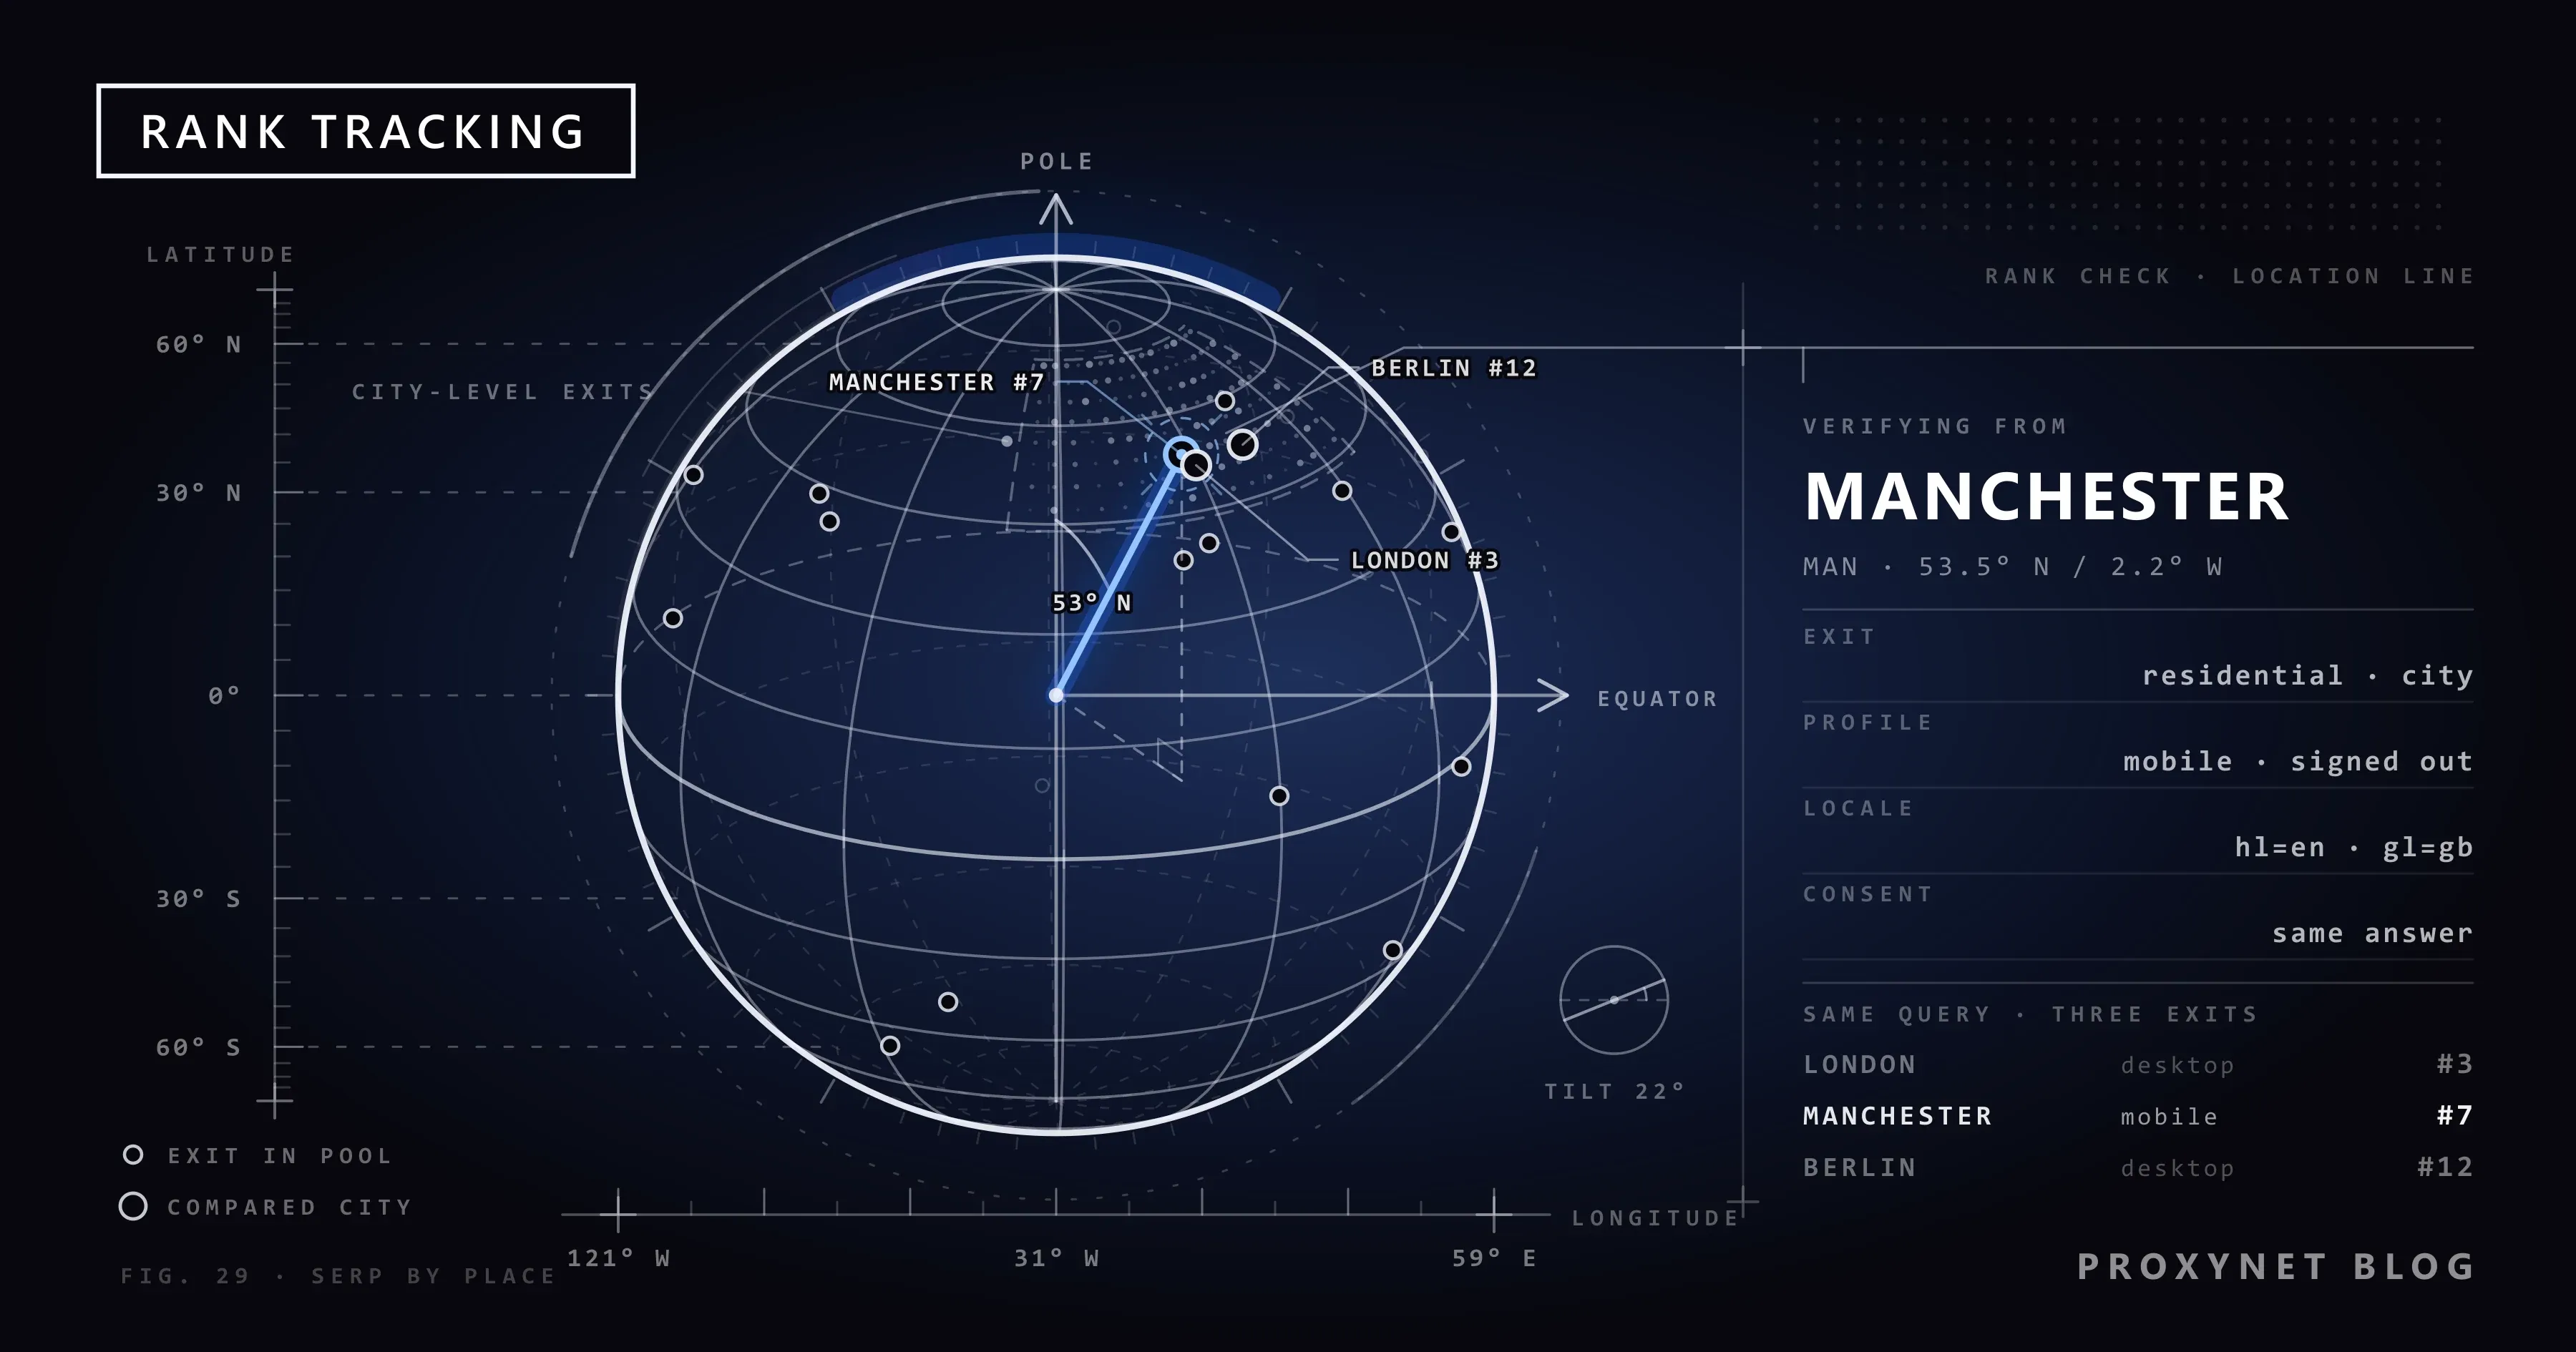
Publicado
Proxies para rank tracking no Google: a localização importa
O Google monta uma página de resultados diferente por país, cidade, idioma e dispositivo: uma verificação de posição é tão exata quanto o lugar de onde é feita.
Autor:Acar Diveroli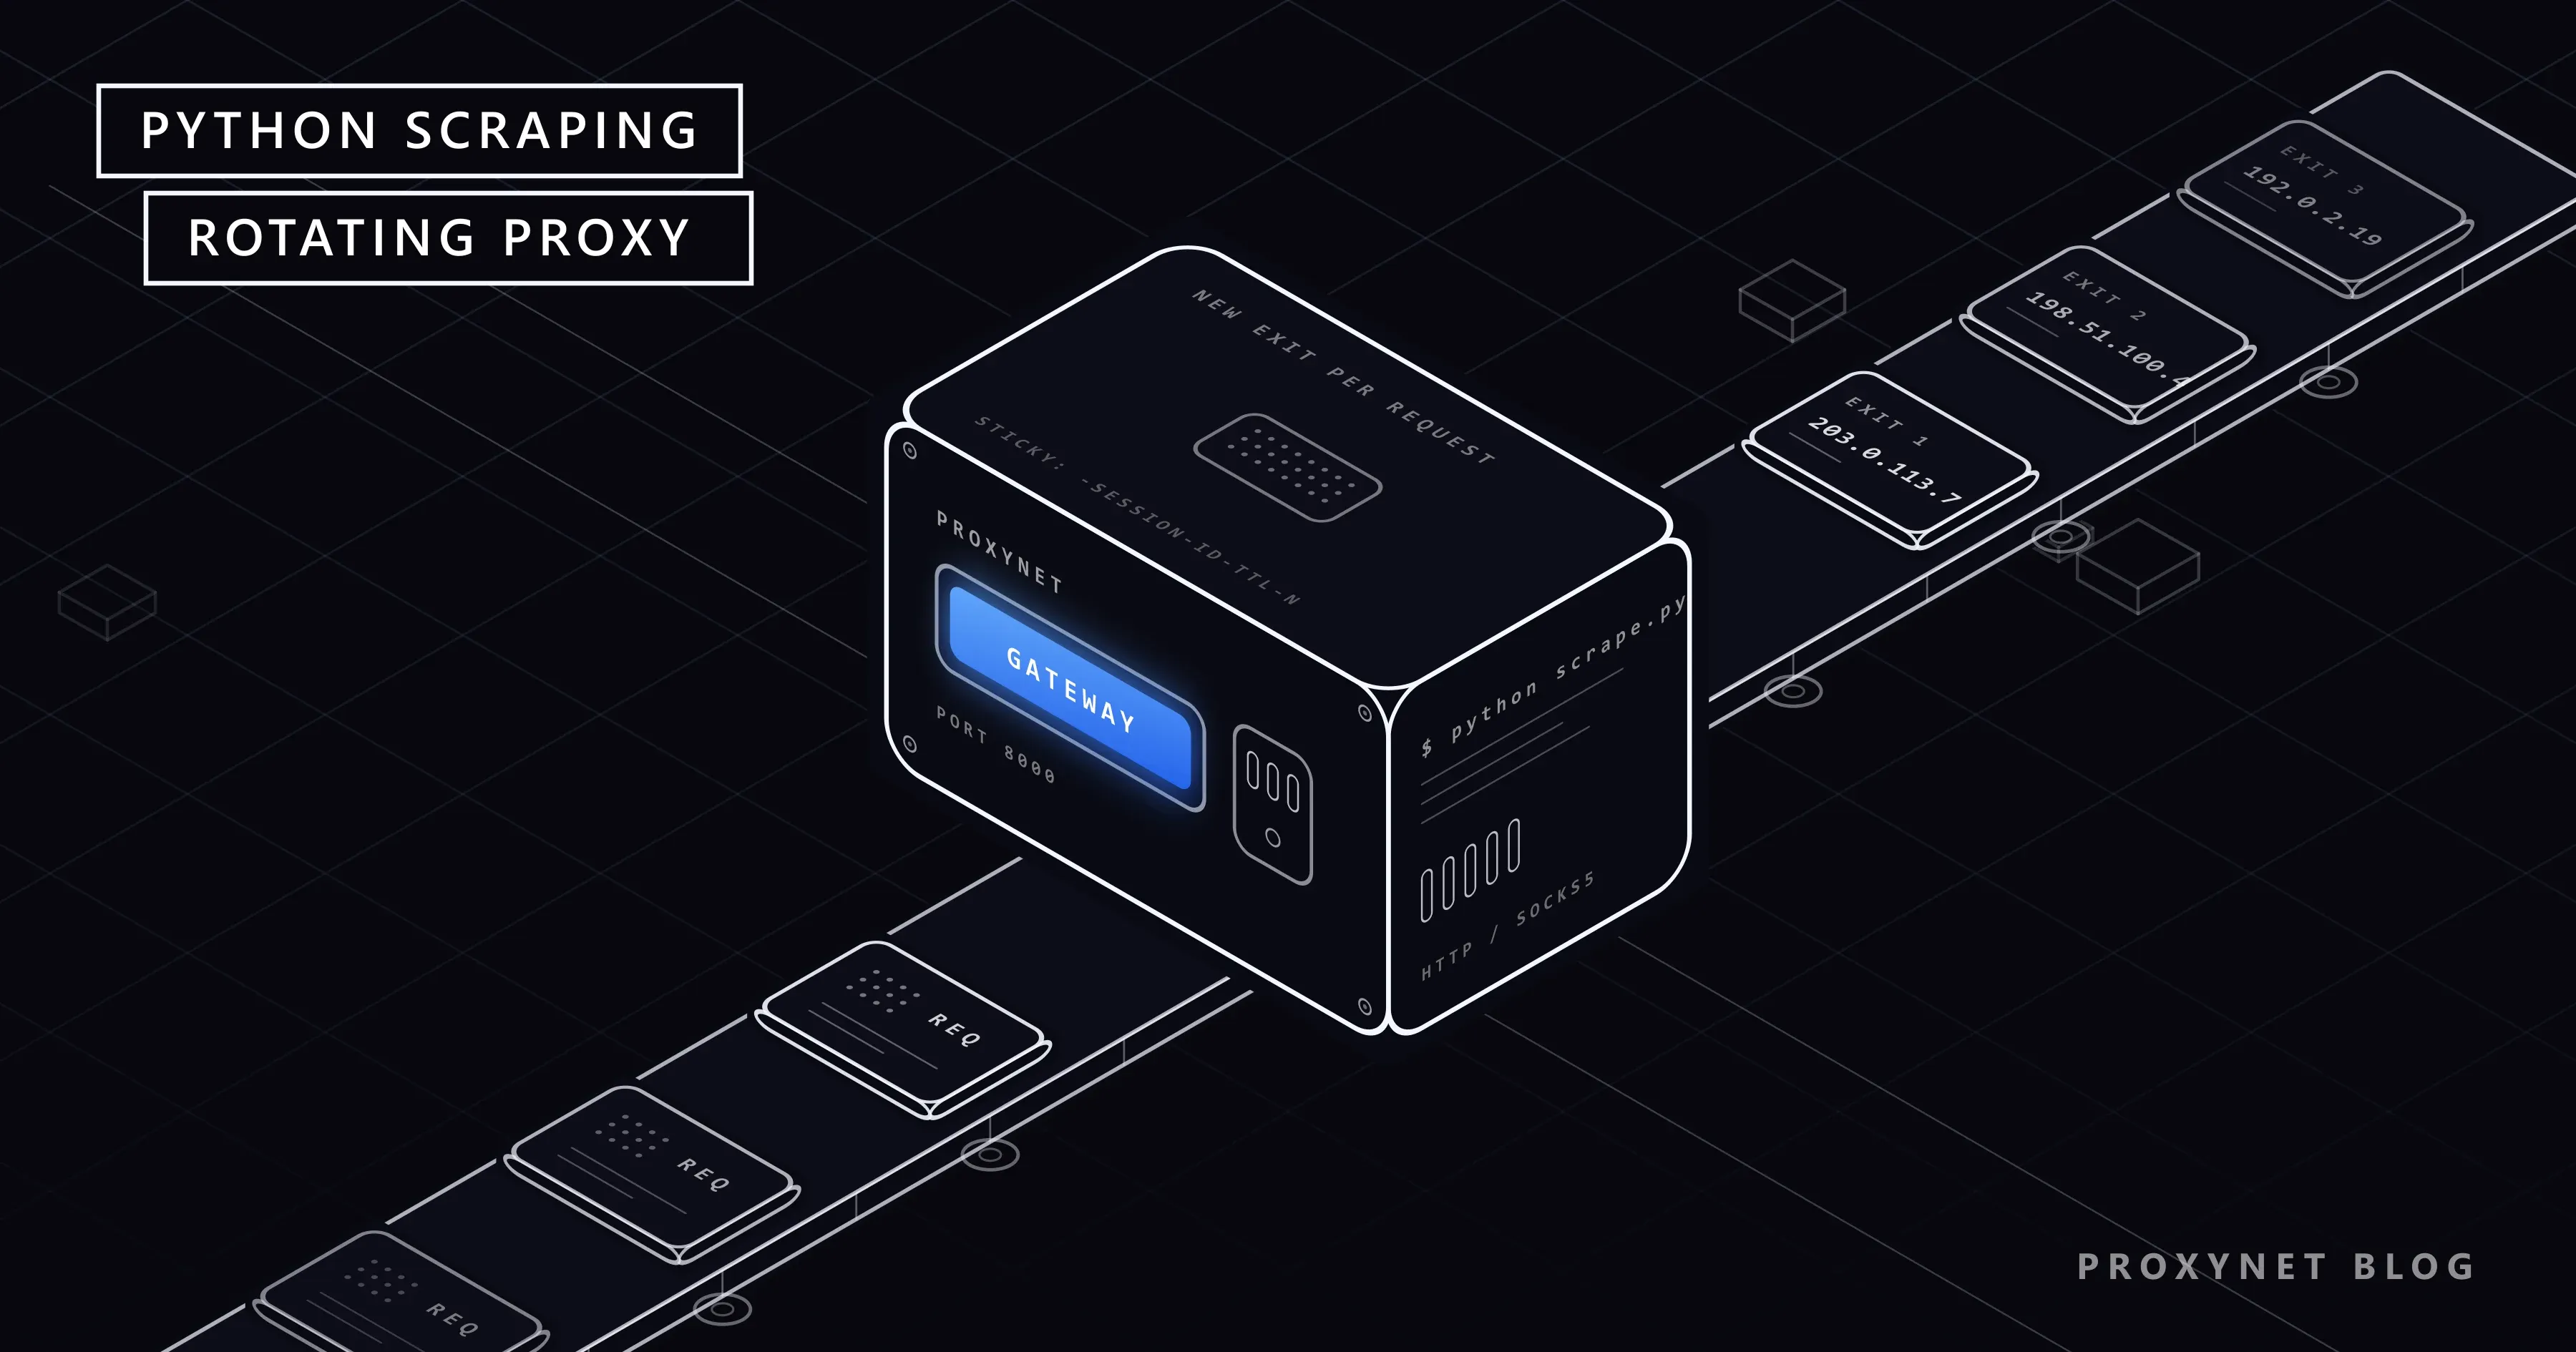
Publicado
Web scraping em Python com proxies rotativos
Aponte requests ou httpx para um gateway rotativo, repita os 429 com backoff, limite a concorrência e verifique o IP de saída. Código Python testado.
Autor:Acar Diveroli
Please Enable JS And Disable Any Ad Blocker: o que significa
Autor: Acar DiveroliWeb scrapingPublicado
Proxy no Puppeteer: autenticação, rotação e SOCKS5
Autor: Acar DiveroliIntegraçãoPublicado
Puppeteer vs Playwright: qual você deve escolher?
Autor: Acar DiveroliComparativosPublicado
TypeError: fetch failed no Node.js: causas e soluções
Autor: Acar DiveroliTutoriaisPublicado
Unable to Get Local Issuer Certificate: como resolver
Autor: Acar DiveroliTutoriaisPublicado
O que é WAF (firewall de aplicação web) e como funciona?
Autor: Acar DiveroliWeb scrapingPublicado
Web scraping API: o que é, como funciona e quando usar
Autor: Acar DiveroliWeb scrapingPublicado
Access to this page has been denied: causas e soluções
Autor: Acar DiveroliWeb scrapingPublicado
Playwright Timeout 30000ms Exceeded: como resolver o erro
Autor: Acar DiveroliTutoriaisPublicado
O que é reputação de IP e por que proxies são bloqueados
Autor: Acar DiveroliProxy 101Publicado
Proxies para rank tracking no Google: a localização importa
Autor: Acar DiveroliCasos de usoPublicado
Web scraping em Python com proxies rotativos
Autor: Acar DiveroliWeb scrapingPublicado
Nenhum artigo encontrado
Publicado
Publicado