Se você tem um site, o llms.txt provavelmente chegou até você por um de dois caminhos. Um plugin de SEO oferece gerar o arquivo "para a IA encontrar você", ou um relatório do Lighthouse mostra "O arquivo llms.txt não segue as recomendações" sob um título novo, Navegação agêntica. Depois você lê que a Pesquisa Google ignora o arquivo. As duas coisas são verdade, e deixam de parecer contraditórias quando você entende para que o arquivo serve.
Este artigo explica o formato, o llms-full.txt e as versões em Markdown das páginas, e como o arquivo se diferencia do robots.txt e do sitemap.xml. Mostramos parte do nosso próprio /llms.txt, verificamos o que Google, Chrome, OpenAI e Anthropic disseram até 5 de outubro de 2026 e terminamos com o passo a passo para criar um.
O que é llms.txt?
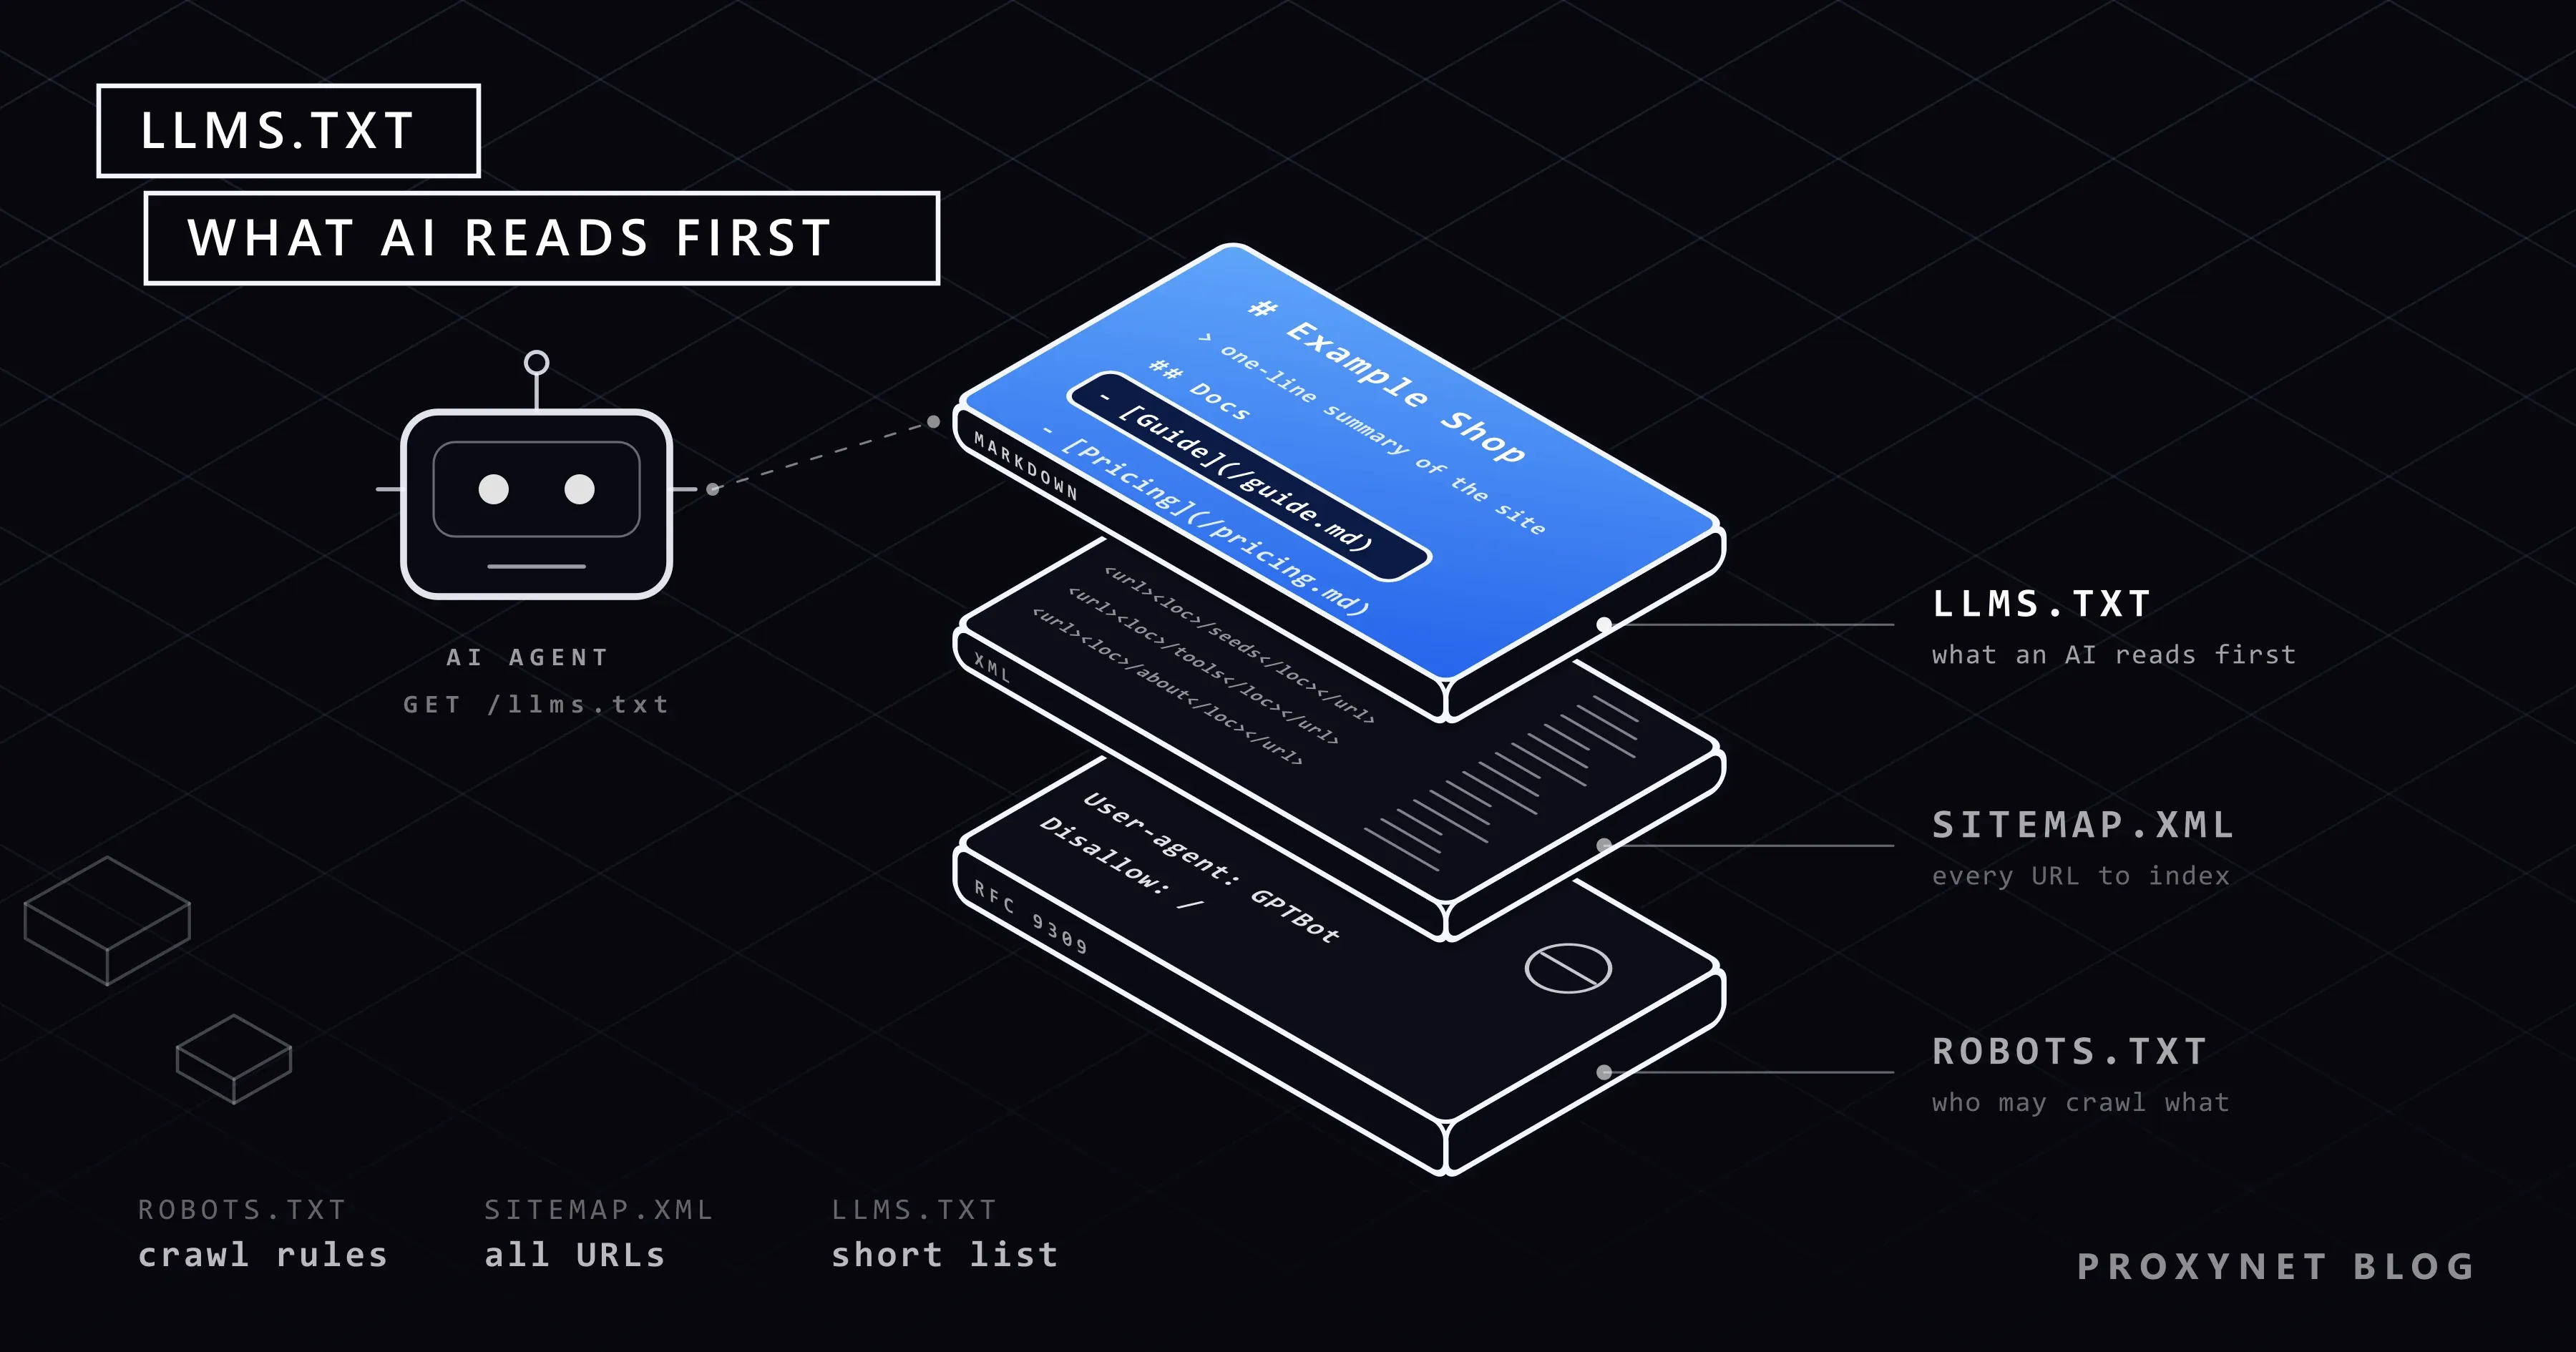
llms.txt é um arquivo de texto escrito em Markdown que um site coloca em /llms.txt. Ele diz a um modelo de linguagem grande (LLM), o tipo de IA por trás do ChatGPT, do Claude e do Gemini, o que é o site e quais páginas valem a leitura. O problema que ele resolve é o tamanho: um modelo só consegue considerar uma quantidade limitada de texto de cada vez, a sua janela de contexto, e um site inteiro, com menus e scripts, raramente cabe nela.
Jeremy Howard publicou a proposta em llmstxt.org em 3 de setembro de 2024; uma segunda versão, de 10 de agosto de 2026, reflete dois anos de adoção. O arquivo foi pensado para a inferência, ou seja, o momento em que um modelo gera uma resposta, e não para o treinamento: quem o lê é um assistente quando um usuário pergunta algo, não um crawler que coleta material para o próximo modelo.
É uma convenção, sem nenhuma RFC nem especificação do W3C por trás. Também não é um regulamento: nada no arquivo permite ou proíbe o acesso a uma página.
Como é um arquivo llms.txt?
A proposta define a ordem das partes. Só a primeira é obrigatória:
- Um H1 com o nome do site ou do projeto.
- Um bloco de citação (blockquote) com um resumo curto dos fatos principais.
- Parágrafos ou listas sem título para detalhes, como a organização do site.
- Seções H2 com listas de links, cada item um link Markdown com uma nota opcional:
- [Nome](url): nota. - Uma seção chamada
Optional, por convenção, para links que um agente pode pular quando falta espaço.
Veja como poderia ser o arquivo de uma pequena loja on-line. A loja e os endereços são fictícios:
# Jardinagem Exemplo

> A Jardinagem Exemplo vende on-line sementes, ferramentas de jardim e peças de irrigação e entrega em todos os países da UE.

Cada página de produto mostra o estoque por armazém. Os guias de cuidados são escritos pela nossa própria equipe.

## Loja

- [Sementes](https://example.com/sementes.md): sementes de hortaliças e flores, organizadas por mês de semeadura
- [Irrigação](https://example.com/irrigacao.md): kits de gotejamento, temporizadores e peças de reposição, com tabelas de compatibilidade

## Ajuda

- [Entrega e devoluções](https://example.com/entrega.md): prazos de entrega por país, prazo de devolução e custos
- [Contato](https://example.com/contato): horários de atendimento por e-mail e telefone

## Optional

- [História da empresa](https://example.com/sobre.md)
As notas fazem diferença: um agente escolhe um link só pelo nome e pela nota, então "prazos de entrega por país, prazo de devolução e custos" funciona muito melhor do que um simples "Entrega".
Um exemplo real: o nosso /llms.txt
O nosso llms.txt, em proxynet.io/llms.txt, nunca é editado à mão: um script o gera a cada build a partir dos mesmos dados que renderizam as páginas, então nenhum post novo do blog pode ficar de fora. Ele começa com # Proxynet e um blockquote de quatro linhas sobre quem somos, o que vendemos e como funciona a cobrança. A primeira seção, em inglês, começa assim:
## Company

- [Homepage](https://proxynet.io): overview of all proxy types, the network and the panel
A última seção usa a convenção Optional:
## Optional

- [Proxynet (Deutsch)](https://proxynet.io/de): site home in Deutsch
- [Blog (Deutsch)](https://proxynet.io/de/blog): blog index in Deutsch; every post is also available as plain Markdown by adding .md to its URL
As páginas em inglês e em turco são listadas uma a uma; os outros quatro idiomas seguem a estrutura em inglês, por isso ficam em Optional. Os posts do blog aparecem com o endereço .md, uma cópia em Markdown puro enviada com o cabeçalho X-Robots-Tag: noindex para nunca competir com a página real na busca. Como cada post aparece em dois idiomas, o arquivo tem várias centenas de links; para a maioria dos sites, uma ou duas páginas funcionam melhor.
A nossa primeira versão, escrita à mão, foi marcada pelo PageSpeed Insights com "O arquivo llms.txt não segue as recomendações". Todos os links eram URLs soltas, então a verificação de link Markdown não encontrou nenhum; além disso, havia listas aninhadas sob títulos H3 e duas URLs provisórias que retornavam 404. Gerar o arquivo automaticamente resolveu os três problemas.
llms-full.txt e versões em Markdown das páginas
O llms.txt é um índice que aponta para páginas. Dois companheiros costumam aparecer ao lado dele.
Versões em Markdown. A proposta pede que os sites ofereçam uma cópia limpa em Markdown das páginas úteis no mesmo endereço com .md no final (/guide.html.md, ou /guide/index.html.md quando o endereço não tem nome de arquivo). O Markdown mantém títulos, listas, tabelas e links, mas descarta a navegação e os scripts, então o conteúdo ocupa muito menos espaço na janela de contexto. A versão 2 acrescenta um jeito de encontrar as cópias: um link rel="alternate" do tipo text/markdown, no HTML da página ou em um cabeçalho HTTP Link. Os posts do nosso blog têm essa tag.
Se o site está atrás da Cloudflare, o Markdown for Agents faz algo parecido sem arquivos separados: quando um cliente envia Accept: text/markdown, a Cloudflare converte a página HTML em Markdown. É uma chave em AI Crawl Control (controle de rastreamento por IA), nos planos Pro, Business e Enterprise.
llms-full.txt. Não faz parte da proposta; é uma convenção das plataformas de documentação: o texto completo da documentação em um único arquivo. A documentação para desenvolvedores da Anthropic publica os dois, e o llms.txt dela termina com um link para o llms-full.txt. Isso faz sentido para uma referência de API que um assistente de programação lê do início ao fim; para uma loja, o índice basta.
llms.txt vs. robots.txt vs. sitemap.xml
Os três arquivos ficam lado a lado na raiz do site, mas respondem a perguntas diferentes:
| robots.txt | sitemap.xml | llms.txt | |
|---|---|---|---|
| Pergunta | Quais caminhos os bots podem rastrear? | Quais URLs existem? | O que uma IA deve ler primeiro? |
| Leitor principal | Crawlers de busca e de IA | Mecanismos de busca | Assistentes e agentes de IA |
| Formato | Regras em texto simples | XML | Markdown |
| Status | Padrão (RFC 9309) | Protocolo Sitemaps | Proposta da comunidade |
| Controla o acesso? | Pede aos crawlers que fiquem de fora | Não | Não |
| Escopo | Só regras | Todas as páginas a indexar | Uma seleção curta |
O robots.txt é definido pela RFC 9309, que deixa claro que as regras dele não são uma forma de autorização de acesso: crawlers bem-comportados as seguem, mas nada obriga ninguém a cumpri-las. O nosso guia de robots.txt explica cada regra.
Um sitemap lista todas as URLs que você quer que os mecanismos de busca encontrem, até 50.000 por arquivo segundo o protocolo Sitemaps; como encontrar o sitemap de um site mostra onde procurar. O sitemap busca ser completo e não traz notas, enquanto o llms.txt é seletivo de propósito.
O llms.txt funciona?
Depende de quem você espera que o leia. Veja o que cada empresa disse ou lançou, conferido em 5 de outubro de 2026.
Pesquisa Google: nenhum efeito. O guia de otimização para IA do Google, publicado em 15 de maio de 2026, diz que você não precisa de novos arquivos legíveis por máquina nem de Markdown para aparecer na Pesquisa, incluindo os recursos de IA generativa. Uma nota adicionada em 15 de junho de 2026 diz que o llms.txt não vai ajudar nem prejudicar a visibilidade ou o ranqueamento, porque a Pesquisa Google ignora esses arquivos.
Lighthouse do Chrome: uma verificação de formato. O Lighthouse, a ferramenta de auditoria do Chrome DevTools e do PageSpeed Insights, tem uma categoria nova, Navegação agêntica (Agentic Browsing), que a página de pontuação do Chrome chama de experimental (Chrome 150 ou posterior, sem nota de 0 a 100). A página da auditoria de llms.txt é de 5 de maio de 2026, e o código-fonte mostra o teste inteiro: uma linha que começa com # , pelo menos um link Markdown e pelo menos 50 caracteres. Um 404 torna a auditoria não aplicável; um erro de servidor a reprova. Ela verifica o formato, não se alguma IA usa o arquivo.
OpenAI: robots.txt para crawlers. A documentação de crawlers da OpenAI cobre o OAI-SearchBot (busca do ChatGPT), o GPTBot (treinamento), o OAI-AdsBot e o ChatGPT-User (ações iniciadas por um usuário) e como gerenciá-los no robots.txt. A OpenAI publica um llms.txt para a própria documentação para desenvolvedores, mas não disse que os crawlers dela leem os arquivos de outros sites.
Anthropic: robots.txt para crawlers. O artigo de ajuda da Anthropic sobre rastreamento, atualizado em 7 de abril de 2026, lista o ClaudeBot (treinamento), o Claude-User (páginas buscadas quando um usuário pede) e o Claude-SearchBot (qualidade da busca), todos controlados pelo robots.txt. O artigo não menciona o llms.txt, embora a documentação para desenvolvedores da Anthropic publique um.
Ou seja, nenhuma dessas empresas usa o llms.txt como sinal para rastrear, ranquear ou citar, enquanto os laboratórios de IA o publicam para a própria documentação. O uso que se sustenta é a leitura sob demanda: um assistente de programação abre o llms.txt de uma biblioteca para achar a página certa, ou um agente enviado ao seu site o lê em vez de adivinhar pelo menu. Um arquivo de texto não executa nenhum script de medição de audiência, então procure as requisições a /llms.txt nos logs do servidor, não na sua ferramenta de análise de tráfego.
O robots.txt controla os crawlers de IA, não o llms.txt
O llms.txt não pode dizer às empresas de IA o que elas podem usar. Deixar uma página de fora não a esconde, e listá-la não concede nenhuma permissão. Os crawlers consultam o robots.txt, com um grupo por User-Agent:
User-agent: GPTBot
Disallow: /

User-agent: ClaudeBot
Disallow: /

User-agent: Google-Extended
Disallow: /
Os dois primeiros grupos pedem aos crawlers de treinamento da OpenAI e da Anthropic que fiquem de fora. O Google-Extended controla se o Google pode usar o seu conteúdo para treinar os modelos Gemini e para grounding, ou seja, para basear respostas em fontes; a documentação de crawlers do Google diz que ele não afeta a inclusão nem o ranqueamento na Pesquisa. Crawlers de busca como o OAI-SearchBot e o Claude-SearchBot têm tokens próprios, então um site pode continuar na busca com IA e, ao mesmo tempo, ficar fora do treinamento. O nosso robots.txt permite explicitamente GPTBot, ClaudeBot e Google-Extended; seja qual for a sua decisão, o lugar dela é o robots.txt.
Como criar um arquivo llms.txt
- Escolha as páginas que respondem ao que um cliente perguntaria a um assistente sobre você: produtos ou serviços, preços, documentação, políticas, contato.
- Escreva o H1 e o blockquote com os fatos que um modelo teria de adivinhar: o que você oferece, para quem e onde.
- Agrupe os links sob títulos H2 no formato
- [Nome](url): nota, com URLs completas, e mova as páginas secundárias para## Optional. - Inclua links para versões em Markdown das páginas, se puder oferecê-las.
- Envie o arquivo para a raiz para que
https://seudominio.com.br/llms.txtresponda com status 200 como texto simples; depois rode o Lighthouse no Chrome DevTools ou no PageSpeed Insights e procure a linha do llms.txt em Navegação agêntica. - Mantenha o arquivo atualizado, ou gere-o automaticamente. Um link desatualizado manda o agente para um 404.
Geradores, plugins e plataformas
- WordPress. Alguns plugins de SEO criam e atualizam o arquivo. No Yoast SEO, é uma chave em Yoast SEO › Settings (Configurações) › Recursos do site, no grupo Ferramentas de IA (página de ajuda do Yoast), indisponível em multisite. O llmstxt.org também lista o AIOSEO.
- Shopify. Desde uma entrada do changelog de 28 de maio de 2026, toda loja serve um
/agents.mdpadrão, e/llms.txte/llms-full.txtapontam para o mesmo conteúdo. Para mudar esse conteúdo, adicione no editor de código do tema um templatetemplates/agents.md.liquidou umllms.txt.liquidseparado. - Plataformas de documentação e criadores de sites. O llmstxt.org lista Mintlify, GitBook e Wix entre as plataformas que geram o arquivo, além de plugins para VitePress, Docusaurus e Drupal.
- Geradores on-line rastreiam o seu site e montam um rascunho. Trate o rascunho como ponto de partida: um crawler não tem como saber quais páginas importam para os seus clientes.
- O seu próprio build. Se o site é gerado a partir de dados estruturados, como o nosso, gere o arquivo no build para que ele não fique defasado.
Quem lê o llms.txt e como os agentes devem lê-lo
- Documentação de APIs e de software. Assistentes de programação leem a documentação sob demanda, muitas vezes por meio de ferramentas conectadas via MCP (Model Context Protocol). Foi aqui que o llms.txt começou.
- Lojas e sites de reservas. Agentes que comparam produtos precisam dos fatos das suas páginas; por que os sites bloqueiam agentes de compras com IA mostra como os sites os tratam.
- Sites que as pessoas visitam com navegadores com IA, que leem as páginas de um jeito muito parecido com o dos agentes; veja O que é um navegador com IA?.
- Equipes que criam agentes. O llms.txt de um site é uma primeira requisição barata que diz para onde ir em seguida; como funcionam os agentes de IA explica o ciclo.
Se você está criando o agente, leia o robots.txt primeiro: um link no llms.txt não anula um Disallow para o seu User-Agent. Trate o arquivo como entrada não confiável, que pode trazer injeção de prompt, ou seja, instruções escondidas no conteúdo; acesso seguro à web para LLMs trata de listas de permitidos e limites de taxa. Identifique o seu bot com um User-Agent claro. Para coletar páginas públicas em grande escala, as nossas páginas de web crawler e extração de dados mostram onde os proxies entram em um crawler que segue essas regras.
Erros comuns
- URLs soltas em vez de links Markdown. O Lighthouse informa "O arquivo não parece conter links.", como aconteceu com a nossa primeira versão.
- Usar o arquivo para bloquear o treinamento de IA. Só os grupos do robots.txt levam esse pedido.
- Colar o sitemap dentro dele. Milhares de URLs sem notas não dão ao agente nenhum motivo para preferir uma página.
- Links provisórios ou quebrados, como variáveis de template do tipo
{slug}ou páginas que agora retornam 404. - Um servidor que responde com HTML. Algumas configurações devolvem a página inicial para qualquer caminho desconhecido; a resposta não tem título Markdown, e o Lighthouse aponta a falta do H1.
- Escrever uma vez e esquecer. Um resumo desatualizado é exatamente o que um assistente vai repetir.
Guia de decisão
| A sua situação | O que fazer |
|---|---|
| Você quer mais tráfego do Google, incluindo os AI Overviews | Para esse objetivo, deixe o llms.txt de lado; trabalhe conteúdo, rastreamento e indexação |
| Você mantém documentação de API ou de produto | Publique o llms.txt com versões em Markdown; considere o llms-full.txt |
| Você tem um site WordPress | Ative o recurso no plugin de SEO e depois enxugue a lista de links à mão |
| Você tem uma loja Shopify | Edite o agents.md padrão com um template do tema |
| Você quer manter os crawlers de treinamento de IA de fora | Adicione ao robots.txt grupos para GPTBot, ClaudeBot e Google-Extended |
| O Lighthouse diz "O arquivo llms.txt não segue as recomendações" | Adicione um H1, use links Markdown e sirva o arquivo como texto com status 200 |
Perguntas frequentes
O llms.txt ajuda no SEO?
Não na Pesquisa Google. O guia de otimização para IA do Google diz que a Pesquisa ignora os arquivos llms.txt, então eles não ajudam nem prejudicam o ranqueamento ou os recursos de IA. Qualquer benefício vem das ferramentas de IA que leem o arquivo sob demanda.
O ChatGPT e o Claude leem o llms.txt?
Nem a OpenAI nem a Anthropic disseram que os seus crawlers usam o llms.txt; as duas documentam o robots.txt como forma de controle. Mesmo assim, um assistente pode abrir o arquivo quando um usuário ou uma ferramenta pede que ele acesse esse endereço.
O llms.txt pode bloquear crawlers de IA ou o treinamento de IA?
Não, o arquivo não contém regras. Para pedir que um crawler fique de fora, adicione ao robots.txt um grupo com o token de User-Agent dele.
Onde coloco o llms.txt?
Na raiz do domínio, para que ele abra em https://example.com/llms.txt. A proposta também permite uma subpasta como /docs/llms.txt, que cobre só as páginas abaixo dela; isso é útil quando você controla apenas uma parte de um domínio.
Qual é a diferença entre llms.txt e llms-full.txt?
O llms.txt é um índice curto de links. O llms-full.txt reúne o texto completo das páginas em um único arquivo; é uma convenção das plataformas de documentação, não parte da proposta.
Existe um validador ou verificador de llms.txt?
O mais próximo de uma verificação oficial é a auditoria de llms.txt do Lighthouse. Ela testa só um H1, pelo menos um link Markdown, um tamanho mínimo e uma resposta válida do servidor, não se os seus links são os certos.
Em resumo
O llms.txt é um índice em Markdown para ferramentas de IA: um nome, um resumo e links selecionados. É uma proposta, não um padrão, e não controla nada; quem continua dizendo aos crawlers de IA o que eles podem buscar é o robots.txt. A Pesquisa Google o ignora e o Lighthouse verifica só o formato, então o valor dele está em documentações, lojas e serviços que agentes leem em nome de um usuário. Mantenha o seu curto e gere-o a partir dos dados do seu site. Se você cria agentes ou crawlers que leem páginas públicas, veja os nossos serviços de proxy.