Você baixa air-quality-2025.zip do portal de dados abertos de uma cidade. Dentro há três arquivos: um CSV com uma linha por estação de monitoramento por hora, um PDF curto chamado "dicionário de dados" e um arquivo de texto com uma licença. O CSV guarda os números, mas sozinho não diz se pm25 é uma média horária ou diária, se os horários estão no fuso local ou em UTC, nem se você pode publicar um gráfico feito com ele. Os três arquivos juntos formam o conjunto de dados; o CSV sozinho contém apenas dados.
Este artigo explica o que é um conjunto de dados (em inglês, dataset), como funcionam suas linhas, colunas e tipos, como ele é montado e dividido para aprendizado de máquina, e passa por exemplos famosos, fontes, formatos de arquivo, licenças, documentação e dados pessoais.
O que é um conjunto de dados?
Um conjunto de dados é um grupo de dados sobre um assunto, registrados em um único nível de detalhe e mantidos juntos para serem analisados como um todo. O histórico de pedidos de uma loja, as leituras horárias de uma estação meteorológica e 10.000 fotos rotuladas de placas de trânsito são conjuntos de dados, porque cada registro de cada um descreve o mesmo tipo de coisa da mesma forma.
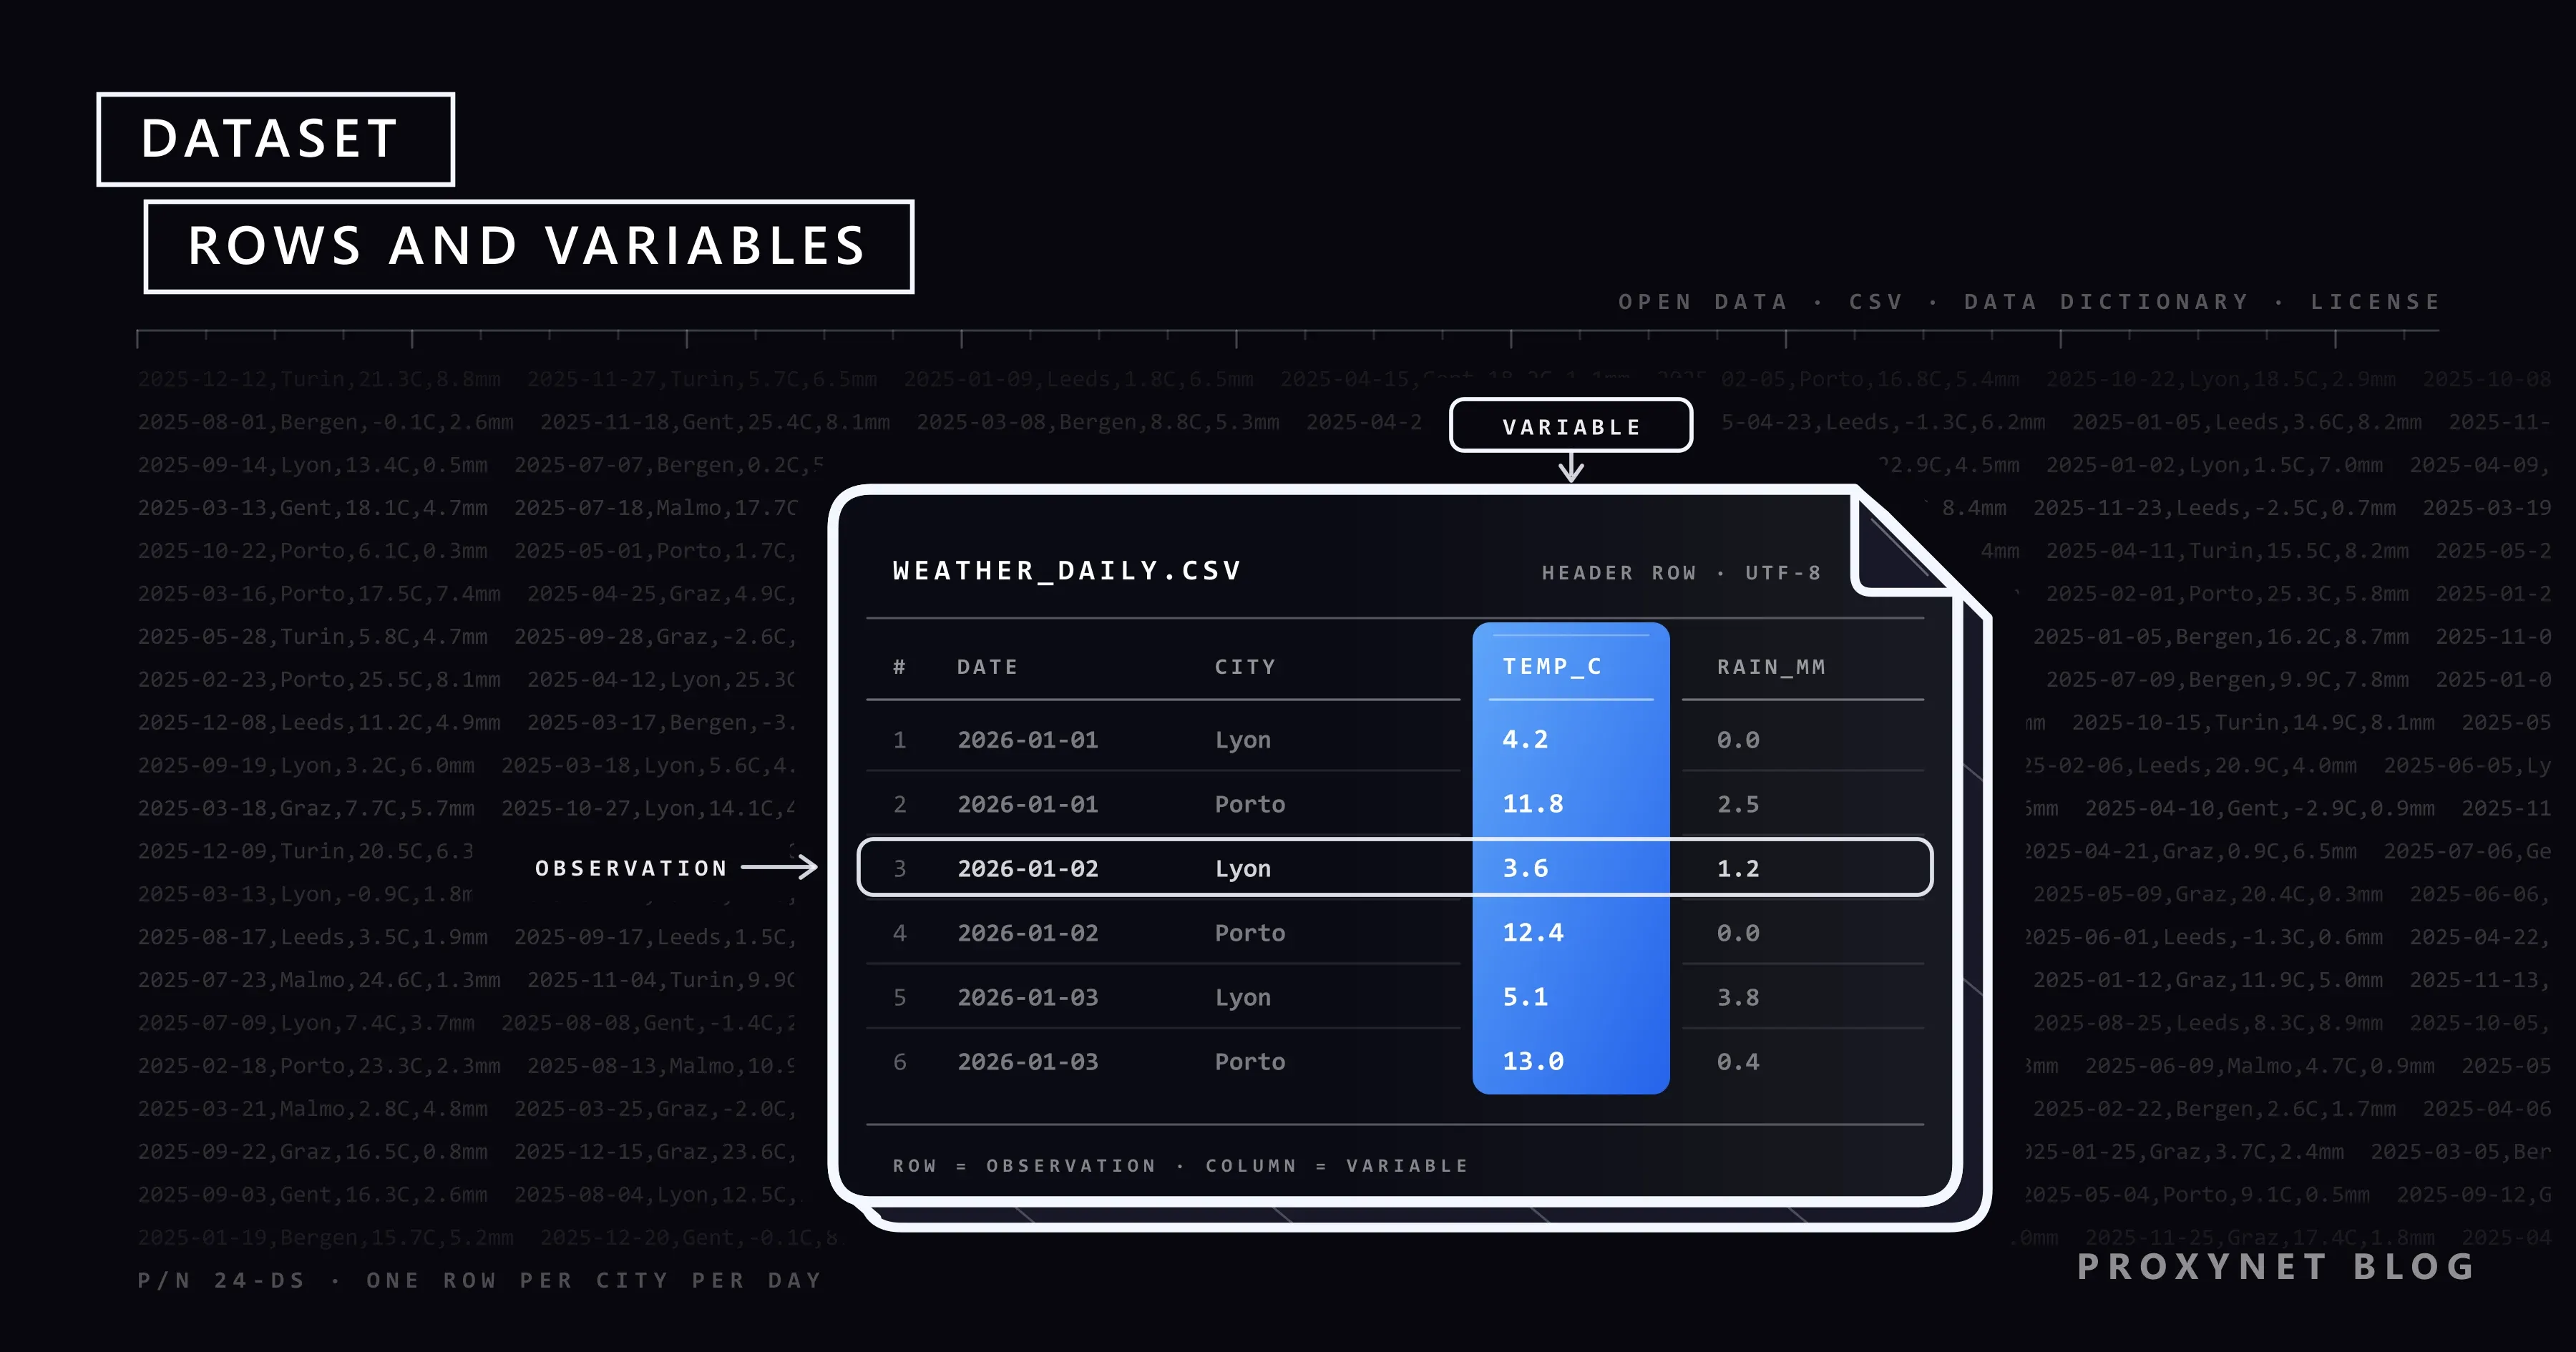
A maioria dos conjuntos de dados que você encontra no trabalho são tabelas. Veja as primeiras linhas de um pequeno conjunto de dados meteorológicos em formato CSV, em que vírgulas separam os valores:
date,city,temp_c,rain_mm
2026-01-01,Lyon,4.2,0.0
2026-01-01,Porto,11.8,2.5
2026-01-02,Lyon,3.6,1.2
Cada linha depois do cabeçalho é uma observação: uma cidade em um dia. Cada coluna é uma variável, registrada para todas as observações, e onde uma linha e uma coluna se cruzam fica um valor, como 4,2 graus. Aquilo que uma linha descreve se chama unidade de observação; defini-la primeiro (uma linha por cidade por dia, não uma por leitura do sensor) molda todo o resto.
O que são linhas, colunas e valores em um conjunto de dados?
Linhas são observações, colunas são variáveis e cada célula guarda exatamente um valor. Essa organização, muitas vezes chamada de "tidy data" (dados organizados), torna um conjunto de dados fácil de filtrar, somar e combinar com outra tabela, porque quase toda ferramenta de análise espera uma observação por linha. Uma planilha com células mescladas e subtotais no meio parece uma tabela, mas quebra a regra.
O tipo da variável decide o que você pode calcular com ela:
- Numérica: medições (4,2 graus) ou contagens (3 pedidos). Médias fazem sentido.
- Categórica: rótulos de um conjunto fixo, como a cidade. Você conta; uma "cidade média" não significa nada.
- Data e hora: só são comparáveis quando o formato e o fuso horário são conhecidos.
- Texto: texto livre, como avaliações, que precisa ser processado antes da análise.
- Identificador: um número de pedido ou ID de produto que liga uma linha a outras tabelas. Parece numérico, mas nunca entra em uma média.
Um dicionário de dados lista cada variável com seu tipo, unidade e valores permitidos. Sem ele, uma coluna chamada temp pode estar em Celsius ou Fahrenheit, e uma célula vazia pode significar zero, desconhecido ou não se aplica.
O que significa conjunto de dados em estatística?
Em estatística e na matemática escolar, um conjunto de dados é simplesmente a lista de valores que você analisa, muitas vezes uma única variável. As notas 4, 7, 7, 9 e 13 formam um conjunto de cinco valores: a amplitude é 13 − 4 = 9, a mediana (o valor do meio depois de ordenar) é 7, a moda (o valor mais frequente) é 7 e a média é 40 ÷ 5 = 8.
Uma tabela com 12 colunas é formada por doze listas assim, registradas lado a lado para as mesmas observações, o que permite compará-las, por exemplo para ver se os dias de chuva são mais frios.
Quais são os tipos de conjunto de dados?
Os conjuntos de dados se agrupam pelo grau de estrutura dos dados e pela forma de um registro. Dados estruturados cabem em colunas fixas, como uma planilha. Dados semiestruturados carregam os próprios rótulos sem uma tabela fixa, como o JSON de uma API ou linhas de log com pares key=value. Dados não estruturados, como texto livre, imagens e áudio, não têm campos predefinidos e costumam precisar de rótulos ou de características extraídas antes da análise.
Pela forma de um registro, estes são os tipos mais comuns:
| Tipo | Um registro é | Exemplo | Formato típico |
|---|---|---|---|
| Tabular | Uma observação, campos fixos | Pedidos, respostas de pesquisa | CSV, Excel, Parquet |
| Série temporal | Um valor em um momento | Temperatura por hora | CSV, Parquet |
| Dados em painel | Uma unidade em um momento | Preços diários de 500 produtos | CSV, Parquet |
| Texto | Um documento | Avaliações, notícias | JSON Lines, TXT |
| Imagem ou áudio | Um arquivo mais seu rótulo | Fotos rotuladas "gato" | Pastas + arquivo de rótulos |
| Grafo | Um nó ou uma ligação | Links entre páginas web | Listas de arestas, JSON |
Uma série temporal acompanha uma coisa ao longo do tempo, um conjunto de dados em corte transversal é um retrato de muitas coisas em um momento, e os dados em painel combinam os dois. Em uma série temporal cada valor depende dos anteriores, por isso as linhas não podem ser embaralhadas como respostas de uma pesquisa.
Como se monta um conjunto de dados?
Um conjunto de dados é montado decidindo o que uma linha significa, coletando todas as linhas da mesma forma e registrando como isso foi feito:
- Defina a pergunta. "Como nossos preços se comparam aos de três concorrentes a cada semana?" define o escopo.
- Escolha a unidade de observação. Aqui: uma linha por produto, por concorrente, por dia.
- Escolha as variáveis. ID do produto, concorrente, preço, moeda, estoque e horário da coleta, cada uma com tipo e unidade.
- Colete. Dos seus próprios sistemas, de uma API, de um download oficial ou de páginas web públicas, com o mesmo método para todas as linhas.
- Verifique e limpe. Remova duplicatas, corrija os tipos e marque os valores ausentes; O que é qualidade dos dados? transforma essas verificações em regras que rodam a cada lote.
- Documente. Escreva o dicionário de dados, a fonte, as datas de coleta e as lacunas conhecidas.
- Versione e armazene. Dê a cada versão publicada uma data ou um número, para que um gráfico feito em março possa ser reproduzido em junho.
Como os conjuntos de dados são usados no aprendizado de máquina?
No aprendizado de máquina, um conjunto de dados é o grupo de exemplos com que um modelo aprende: cada linha traz características (features, as entradas) e, no aprendizado supervisionado, um rótulo (a resposta que o modelo deve aprender a prever). Um filtro de spam, por exemplo, aprende com milhares de e-mails que pessoas marcaram como spam ou não spam.
Antes do treinamento, o conjunto de dados é dividido em três partes que nunca se sobrepõem:
- Conjunto de treinamento: os exemplos com que o modelo aprende, normalmente a maior parte.
- Conjunto de validação: usado durante o desenvolvimento para comparar configurações e decidir quando parar o treinamento.
- Conjunto de teste: guardado à parte e usado uma única vez no fim, para estimar como o modelo se sai com dados que nunca viu.
Se linhas quase idênticas, como duas fotos do mesmo objeto, caem tanto no conjunto de treinamento quanto no de teste, a pontuação parece melhor do que é; isso se chama vazamento de dados (data leakage). Séries temporais são divididas por data, treinando com o passado e testando com um período posterior, para que o modelo não espie o futuro.
Quais são alguns conjuntos de dados famosos?
Três conjuntos de dados públicos mostram o quanto a palavra abrange:
- Iris: 150 flores de três espécies, com quatro medidas cada, publicado pelo estatístico R. A. Fisher em 1936. O UCI Machine Learning Repository o distribui sob a licença CC BY 4.0.
- MNIST: 70.000 imagens em tons de cinza de dígitos escritos à mão, com 28 × 28 pixels cada, divididas em 60.000 imagens de treinamento e 10.000 de teste, cada uma rotulada de 0 a 9. É um primeiro exercício clássico de classificação de imagens.
- Common Crawl: petabytes de páginas web coletadas regularmente desde 2008 e disponibilizadas gratuitamente. Muitos conjuntos de texto para treinar modelos de linguagem são filtrados a partir dele; O que é o Common Crawl? explica o que um rastreamento contém.
De onde vêm os conjuntos de dados?
Os conjuntos de dados vêm de poucos lugares, e a fonte decide o quanto você pode confiar neles e reutilizá-los:
- Estatísticas oficiais: institutos nacionais de estatística e organismos internacionais publicam dados de população, preços e comércio com métodos documentados.
- Portais de dados abertos: governos e cidades publicam orçamentos, horários de transporte e leituras de qualidade do ar, normalmente sob uma licença aberta.
- Repositórios de pesquisa: universidades e periódicos hospedam os dados por trás dos artigos publicados.
- APIs: serviços expõem dados por meio de endpoints documentados, com limites e termos próprios.
- Seus próprios sistemas: pedidos, logs de servidor e registros de CRM; muitas vezes a fonte mais valiosa e a que mais provavelmente contém dados pessoais.
- Páginas web públicas: preços, anúncios, vagas de emprego e avaliações, coletados dentro dos termos e dos limites de taxa de cada site.
Para encontrar um conjunto de dados que já existe, comece pela organização que o coletaria: dados de desemprego começam no instituto de estatística; atrasos de ônibus, no portal de dados abertos da cidade.
Quais formatos de arquivo os conjuntos de dados usam?
A maioria dos conjuntos de dados tabulares é compartilhada em CSV, registros aninhados em JSON ou JSON Lines, e grandes tabelas analíticas em Parquet. CSV é texto simples com uma linha por registro e vírgulas entre os valores; o RFC 4180 documenta sua forma comum, incluindo aspas duplas em torno de qualquer valor que contenha vírgula, aspas ou quebra de linha.
Na nossa máquina de teste (Node.js 24), salvamos a mesma tabela de 1.000 linhas e 4 colunas nos dois formatos: o arquivo CSV ficou com 25.492 bytes e o array JSON com 68.468 bytes, cerca de 2,7 vezes maior, porque o JSON repete o nome de cada coluna em cada registro. Dividir a linha 2026-01-01,"Washington, D.C.",4.2,0.0 nas vírgulas gerou cinco campos em vez de quatro, enquanto um parser que respeita as aspas devolveu os quatro corretos. Por isso, leia CSV sempre com um parser de CSV de verdade.
Parquet é um formato de código aberto orientado a colunas que armazena e comprime juntos os valores de cada coluna, de modo que uma consulta que precisa de 2 entre 50 colunas lê só essas 2. JSON Lines coloca um registro em cada linha, o que combina com logs e textos que crescem sem parar.
Qual licença acompanha um conjunto de dados?
A licença de um conjunto de dados diz o que você pode fazer com ele; sem uma, você não tem permissão clara para reutilizá-lo, porque direitos autorais ou direitos sobre bases de dados ainda podem valer. As licenças abertas mais comuns são:
- CC BY 4.0: compartilhar e adaptar para qualquer finalidade, inclusive comercial, desde que você dê crédito ao criador, coloque um link para a licença e informe se fez alterações. O resumo da Creative Commons traz as condições exatas.
- ODbL 1.0 (Open Database License): feita para bases de dados. Dê crédito à fonte, ofereça sob a mesma licença qualquer base adaptada que você use publicamente e, se acrescentar restrições técnicas, distribua também uma versão sem elas.
- CC0: quem publica renuncia aos seus direitos na medida em que a lei permite, então nenhuma condição se aplica.
- Termos de uso: dados de uma API ou de um site seguem os termos desse serviço, que podem ser mais rígidos que qualquer licença aberta.
Uma licença cobre os direitos de quem publica, não os direitos das pessoas que estão nos dados. Um conjunto de dados CC BY com nomes e endereços de e-mail continua contendo dados pessoais.
Como documentar um conjunto de dados?
Um conjunto de dados deve vir com documentação suficiente para que um desconhecido o use corretamente sem perguntar ao autor. O artigo Datasheets for Datasets (Gebru e outros, publicado pela primeira vez em 2018) propõe que todo conjunto de dados acompanhe uma folha de dados (datasheet) que cubra sua motivação, composição, processo de coleta e usos recomendados, assim como componentes eletrônicos vêm com folhas de dados.
Mesmo um README curto ajuda muito: o que é uma linha, a fonte e o método, o período coberto, as unidades e o fuso horário, as lacunas conhecidas, a licença, a versão e um contato.
E se um conjunto de dados contiver dados pessoais?
Se qualquer linha se refere a uma pessoa que pode ser identificada, o conjunto contém dados pessoais e a lei de proteção de dados se aplica. O GDPR define dados pessoais no artigo 4.º, ponto 1 como qualquer informação relativa a uma pessoa singular identificada ou identificável, de forma direta ou por meio de elementos como um nome, um número de identificação, dados de localização ou um identificador por via eletrônica. A Lei nº 6698 de Proteção de Dados Pessoais (KVKK) da Türkiye usa a mesma ideia no artigo 3.
Remover os nomes não basta: dados pseudonimizados, em que os nomes são trocados por códigos e a chave fica guardada em outro lugar, continuam sendo dados pessoais para o GDPR. Colete só as colunas de que precisa, mascare os identificadores diretos, limite o acesso e defina uma data de exclusão; Como tratar dados pessoais (PII) em dados de scraping percorre esses passos para dados da web.
Como montar um conjunto de dados a partir de páginas web públicas?
Quando não existe download nem API, a parte difícil de usar páginas web públicas é coletar todas as linhas nas mesmas condições. Muitos sites mostram preços, moedas, estoque e idioma diferentes conforme o país do visitante, então um conjunto de dados coletado de um único local descreve, sem avisar, apenas aquele local. Os Proxies residenciais com segmentação por país e cidade permitem coletar as linhas de cada mercado como um visitante local as veria, e uma sessão fixa mantém o mesmo endereço IP por 1 a 60 minutos durante uma verificação de várias páginas.
Registre o país e o horário da coleta em cada linha, respeite o robots.txt, os termos e os limites de taxa de cada site, e use uma API oficial ou um download sempre que houver. Equipes que preferem não operar a coleta por conta própria podem usar a extração gerenciada de páginas da nossa Web Scraping API, disponível por meio do nosso time de vendas.
Onde os conjuntos de dados são usados?
- Análise de negócios: tabelas de vendas e custos por trás de painéis e relatórios.
- Aprendizado de máquina e IA: dados de treinamento e de teste, de filtros de spam a modelos de linguagem.
- Pesquisa: questionários, experimentos e estatísticas oficiais por trás de estudos publicados.
- Preços e e-commerce: preços e estoque da concorrência acompanhados ao longo do tempo.
- Setor público e jornalismo: orçamentos e dados de transporte que tornam afirmações verificáveis.
Erros comuns
- Sem unidade de observação. Misturar uma linha por pedido com uma linha por cliente deixa todos os totais errados.
- Dois valores em uma célula. "12 kg / 26 lb" não pode ser somado nem filtrado.
- Unidades e fusos horários ausentes. Um preço sem moeda é um palpite.
- Dividir CSV nas vírgulas. Valores entre aspas que contêm vírgulas deslocam as colunas.
- Ignorar a licença. "Achei na internet" não é uma licença.
- Deixar dados de teste vazarem para o treinamento. Duplicatas dos dois lados da divisão inflam todas as pontuações.
- Sem versão nem data de coleta. Resultados que ninguém consegue reproduzir não merecem confiança.
Guia de decisão
| Necessidade | Recomendação |
|---|---|
| Uma tabela pequena editada à mão | Excel ou CSV com dicionário de dados |
| Compartilhar uma tabela com outras ferramentas | CSV com linha de cabeçalho, UTF-8, valores entre aspas |
| Tabelas grandes para análise | Parquet, particionado por data |
| Registros aninhados de uma API | JSON Lines |
| Treinar um modelo | Conjuntos separados de treinamento, validação e teste |
| Dados ordenados no tempo | Dividir por data, nunca ao acaso |
| Reutilizar dados de terceiros | Verificar antes a licença e suas condições |
| Dados sobre pessoas | Coletar só o necessário; mascarar identificadores |
| Preços ou anúncios em vários países | Coletar cada mercado a partir desse mercado |
Perguntas frequentes
O que é um conjunto de dados, em termos simples?
Um conjunto de dados é uma coleção de dados relacionados mantidos juntos para um propósito, quase sempre uma tabela. Cada linha descreve uma coisa, como uma venda ou um dia, e cada coluna registra uma propriedade dela, como o preço ou a temperatura.
Qual é a diferença entre conjunto de dados e banco de dados?
Um conjunto de dados são os próprios dados, coletados para um propósito; um banco de dados é o software que armazena dados e responde a consultas. Um banco de dados pode guardar muitos conjuntos de dados, e um conjunto de dados pode estar em um banco de dados, em um arquivo CSV ou em uma planilha.
Qual é um exemplo de conjunto de dados?
A lista de pedidos de uma loja é um conjunto de dados: uma linha por pedido, com colunas de data, produto, quantidade e preço. Exemplos públicos conhecidos são Iris, MNIST e Common Crawl.
O que é um conjunto de dados no aprendizado de máquina?
É o grupo de exemplos com que um modelo aprende e com que é testado. Cada exemplo traz características (as entradas) e normalmente um rótulo (a resposta correta), e o todo é dividido em conjuntos de treinamento, validação e teste.
Onde encontrar conjuntos de dados gratuitos?
Comece pela organização que coletaria os dados: institutos nacionais de estatística, portais de dados abertos de governos e cidades, repositórios de pesquisa como o UCI Machine Learning Repository e organismos internacionais. Verifique a licença de cada conjunto antes de reutilizá-lo, mesmo quando o download é gratuito.
Como criar seu próprio conjunto de dados?
Defina a pergunta, decida o que uma linha representa e escolha as variáveis com seus tipos e unidades. Colete todas as linhas da mesma forma, verifique e limpe o resultado, depois escreva um README curto com a fonte, as datas e a licença, e dê uma versão a cada publicação.
Em resumo
Um conjunto de dados é um grupo de dados relacionados, organizados para um propósito, normalmente uma tabela de observações e variáveis, mais a documentação e a licença que o tornam utilizável. Decida o que uma linha significa antes de coletar qualquer coisa, mantenha um valor por célula e registre unidades, fusos horários e datas de coleta. Verifique a licença antes de reutilizar, trate dados pessoais como um dever legal e, quando as páginas web mudam conforme o país, colete cada mercado a partir desse mercado.