Uma equipe de suporte transforma 100.000 respostas da sua central de atendimento em embeddings e cria um botão de "encontrar tickets parecidos". O protótipo compara cada ticket novo com todos os vetores guardados, e a resposta parece instantânea. Depois o arquivo cresce para 20 milhões de trechos, cada busca lê os 20 milhões de vetores e o botão fica mais lento a cada importação. Fechar essa distância entre "comparar com tudo" e "achar os poucos mais próximos em milissegundos" é o trabalho de um banco de dados vetorial.
Este artigo explica o que um banco de dados vetorial guarda, como uma busca acontece, quais medidas de similaridade e tipos de índice ele usa (HNSW, IVF e quantização de produto em palavras simples), como os filtros e a busca híbrida se encaixam, quando uma extensão no banco de dados que você já usa é suficiente e quanto isso custa em memória.
O que é um banco de dados vetorial?
Um banco de dados vetorial é um banco de dados feito para guardar vetores e responder rápido a um único tipo de pergunta: quais itens guardados estão mais próximos deste? Um banco de dados relacional responde "quais linhas atendem a esta condição"; um banco de dados vetorial responde "quais itens são os mais parecidos", e sempre devolve os mais próximos, mesmo quando nenhum deles combina de verdade.
Cada registro costuma ter quatro coisas:
- Um ID, para que o resultado possa ser rastreado até um documento, um produto ou uma imagem.
- O vetor, uma lista de números de tamanho fixo gerada por um modelo de embeddings.
- Metadados, como idioma, data, país, endereço de origem ou quem pode ver o item, usados para filtrar os resultados.
- O conteúdo ou uma referência a ele, para que a aplicação possa mostrar o trecho ou o produto que o vetor representa.
{
  "id": "faq-0412#2",
  "vector": [0.021, -0.113, 0.087, "... mais 381 números"],
  "metadata": { "lang": "pt-br", "country": "DE", "updated": "2026-11-02" },
  "text": "Os pedidos para a Alemanha costumam chegar em até três dias úteis."
}
O que é um embedding vetorial?
Um embedding vetorial é uma lista de números que um modelo de embeddings, uma rede neural treinada para essa tarefa, gera para um dado de forma que significados parecidos fiquem próximos. "Passagens baratas para Roma" e "bilhetes aéreos de baixo custo com destino a Roma" recebem vetores vizinhos, embora quase não compartilhem palavras; como essa correspondência pelo significado funciona na busca é explicado em O que é busca semântica?.
Embeddings reais têm de centenas a alguns milhares de números, chamados dimensões, e o modelo define essa quantidade. Daí saem duas regras: todos os vetores de um índice têm o mesmo número de dimensões, e as consultas precisam ser convertidas em embeddings com o mesmo modelo e a mesma versão usados nos itens guardados. Vetores de dois modelos diferentes não são comparáveis, mesmo quando têm o mesmo tamanho.
Como funciona um banco de dados vetorial?
Um banco de dados vetorial trabalha em duas fases: antes, ele recebe e indexa os itens; depois, responde a cada consulta buscando nesse índice.
- Prepare os itens. Documentos longos são divididos em trechos, cada um com seu endereço de origem e outros metadados.
- Gere os embeddings. O modelo de embeddings transforma cada trecho, imagem ou produto em um vetor, normalmente na sua aplicação ou no seu pipeline, e não dentro do banco de dados.
- Guarde os registros. O banco de dados grava ID, vetor, metadados e conteúdo.
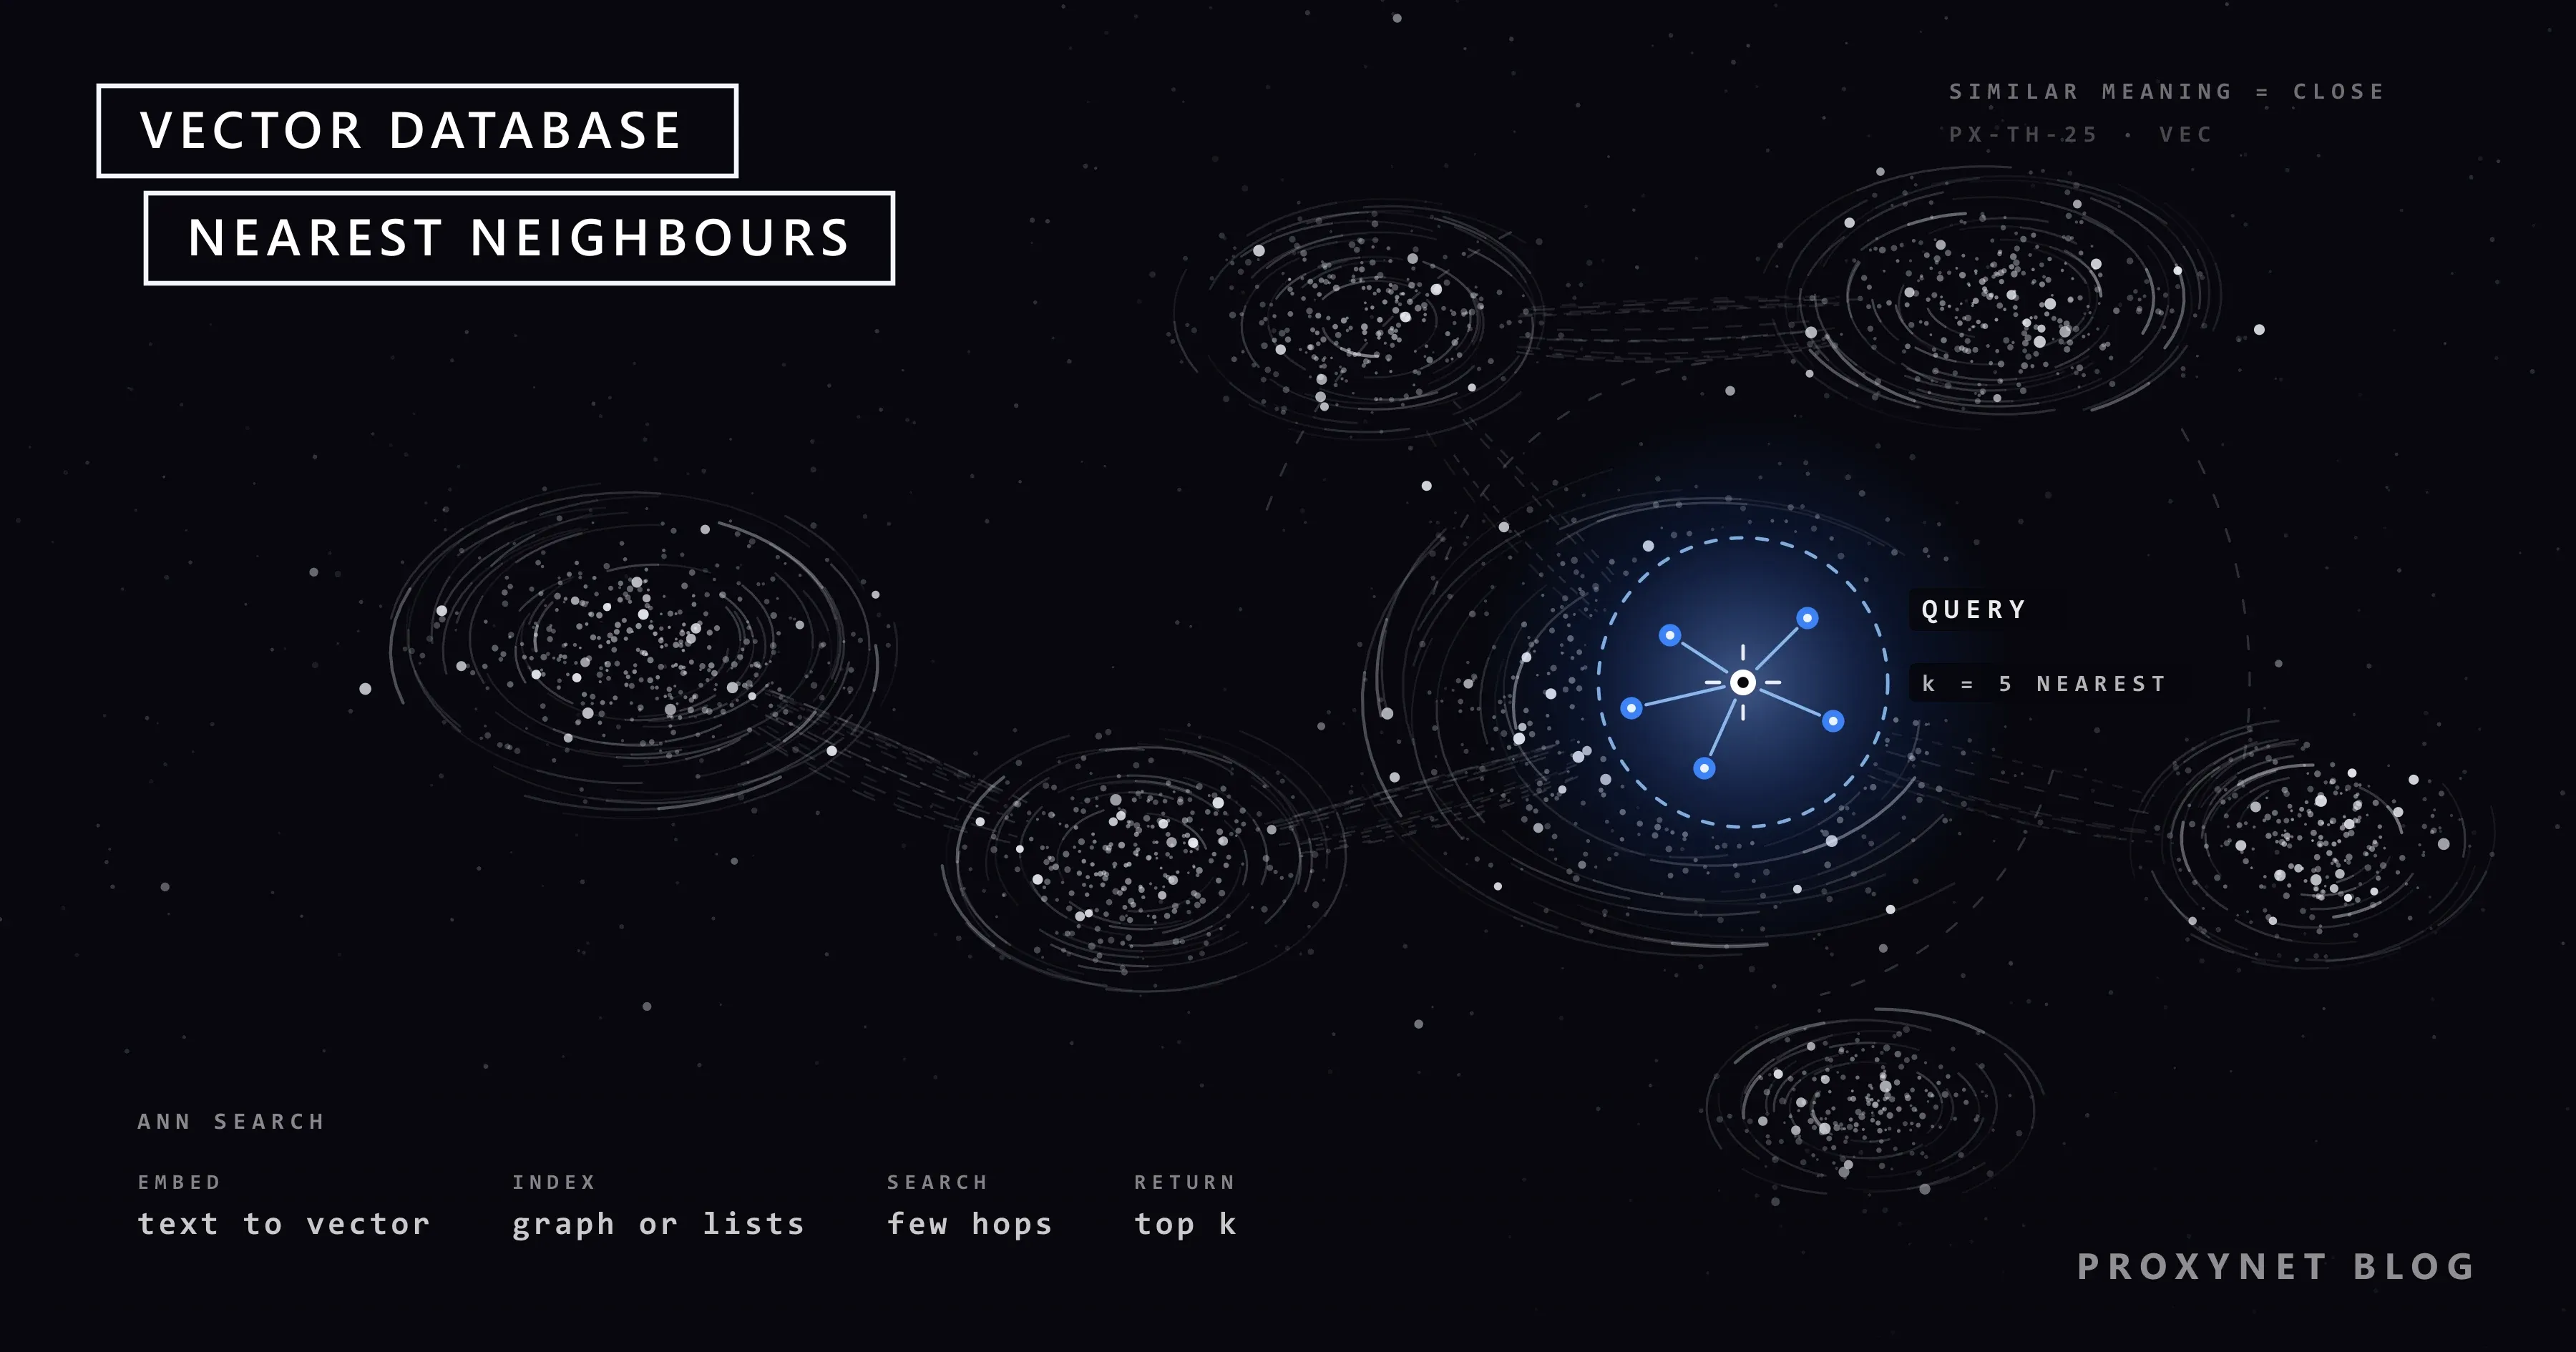
- Monte o índice. Um índice ANN organiza os vetores em um grafo ou em clusters para que uma busca possa pular a maioria deles.
- Converta a consulta. A pergunta do usuário passa pelo mesmo modelo e vira um vetor de consulta.
- Busque e filtre. O índice devolve candidatos próximos da consulta, e condições de metadados como "o idioma é alemão" removem os que não se qualificam.
- Devolva os k primeiros. Os k itens mais próximos voltam com suas pontuações de similaridade, prontos para serem exibidos, reordenados ou entregues a um modelo de linguagem.
As atualizações seguem o mesmo caminho: um documento alterado vira um novo embedding e seu vetor antigo é substituído; caso contrário, o índice continua respondendo com um texto que já não existe.
Quais medidas de similaridade um banco de dados vetorial usa?
Os bancos de dados vetoriais ordenam os resultados com uma de três medidas comuns: similaridade de cosseno, produto escalar ou distância euclidiana. A certa é a medida para a qual o modelo de embeddings foi treinado, e a documentação dele informa qual é.
| Medida | O que compara | Valor maior significa |
|---|---|---|
| Similaridade de cosseno | O ângulo entre dois vetores | Mais parecido |
| Produto escalar | Ângulo e comprimento juntos | Mais parecido |
| Distância euclidiana (L2) | A distância em linha reta | Menos parecido |
Quando todos os vetores estão normalizados para comprimento 1, o que muitos modelos de embeddings fazem, as três medidas colocam os resultados na mesma ordem: o cosseno é igual ao produto escalar, e uma distância menor significa um produto escalar maior. Por isso a documentação do pgvector recomenda o produto interno para vetores normalizados: a mesma ordem com o menor cálculo. Com vetores não normalizados, indexar com uma medida e consultar com outra muda a ordem sem nenhum aviso.
Qual é a diferença entre a busca exata e a aproximada de vizinhos mais próximos?
A busca exata compara a consulta com cada vetor guardado e sempre encontra os vizinhos de fato mais próximos; a aproximada verifica só uma parte pequena e bem escolhida da coleção e costuma encontrar quase todos eles. A busca exata, também chamada de força bruta ou busca plana (flat), custa um tempo diretamente proporcional ao número de vetores.
A busca aproximada de vizinhos mais próximos (ANN) troca um pouco de precisão por muita velocidade. Essa precisão é medida como recall (revocação), a parcela dos verdadeiros vizinhos mais próximos que é encontrada: se o índice devolve 9 dos 10 verdadeiros mais próximos, o recall em 10 é 0,9. Todo índice ANN tem ajustes que se movem ao longo dessa linha, então calibre-o com os seus dados em vez de confiar nos valores padrão.
Nós mesmos testamos uma versão pequena desse equilíbrio, em JavaScript puro e com dados sintéticos. Na nossa máquina de teste, percorrer 100.000 vetores de 384 números levou cerca de 40 milissegundos por consulta; um índice IVF mínimo com 256 clusters respondeu em cerca de meio milissegundo ao buscar em um único cluster, mas encontrou só uns 7 dos 10 vizinhos de fato mais próximos, e buscar em 32 clusters levou cerca de 10 milissegundos e encontrou uns 8,5. Índices reais são muito mais refinados, mas o padrão se repete: mais trabalho por consulta, mais recall.
Quais são os principais tipos de índice vetorial?
Os principais tipos de índice são o plano (sem índice), os índices de grafo como o HNSW, os índices de clusters como o IVF e a compressão com quantização de produto, muitas vezes combinada com o IVF. Cada um equilibra velocidade, memória e recall de um jeito diferente.
| Índice | Como uma busca acontece | Custo principal |
|---|---|---|
| Plano (flat) | Compara a consulta com cada vetor | Lento em conjuntos grandes |
| HNSW | Salta por um grafo de vizinhos em camadas | Memória, construção lenta |
| IVF | Percorre só os clusters mais próximos | Menos recall na mesma velocidade |
| PQ | Compara códigos curtos comprimidos | Distâncias aproximadas |
HNSW (hierarchical navigable small world, um grafo hierárquico e navegável de "mundo pequeno") foi descrito por Yury Malkov e Dmitry Yashunin em um artigo de 2016. Cada vetor fica ligado a alguns de seus vizinhos, e alguns vetores escolhidos ao acaso aparecem também em camadas superiores mais esparsas. Uma busca começa no topo, dá saltos longos pela coleção e depois desce camada por camada até vizinhanças mais finas, de modo que o trabalho cresce mais ou menos com o logaritmo do tamanho da coleção, e não com o próprio tamanho. O preço é a memória de todas essas ligações e uma construção mais lenta.
IVF (inverted file index, índice de arquivo invertido) agrupa os vetores em clusters com k-means quando o índice é montado, como descreve o artigo sobre a biblioteca Faiss. Uma consulta é comparada primeiro com os centros dos clusters e depois só com os vetores dos poucos clusters mais próximos; o número de clusters percorridos, muitas vezes chamado de nprobe, é o principal controle do recall.
A quantização de produto (product quantization, PQ), apresentada por Hervé Jégou, Matthijs Douze e Cordelia Schmid em um artigo de 2011, comprime os próprios vetores. Ela divide cada vetor em subvetores curtos e substitui cada subvetor pelo número da entrada mais próxima em um pequeno livro de códigos aprendido. Um vetor de 768 números guardados como pontos flutuantes de 4 bytes ocupa 3.072 bytes; como 64 códigos de um byte, ocupa 64 bytes, ao custo de distâncias aproximadas. Muitos sistemas mantêm os vetores completos em disco e os usam para reordenar a lista curta.
Como funciona a filtragem por metadados em um banco de dados vetorial?
A filtragem por metadados limita uma busca vetorial aos itens que atendem a condições exatas, como idioma, país, data, preço ou permissões de acesso. Ela transforma "os 10 trechos mais próximos" em "os 10 trechos mais próximos em alemão, atualizados neste ano, que este usuário pode ler".
O ponto em que o filtro é aplicado faz diferença. Se o banco de dados primeiro encontra os candidatos mais próximos e depois remove os que não passam pelo filtro, um filtro rigoroso pode deixar pouquíssimos resultados: a documentação do pgvector mostra uma busca HNSW com as configurações padrão e uma condição atendida por 10% das linhas devolvendo, em média, só cerca de 4 linhas. A versão 0.8.0 trouxe as varreduras iterativas do índice (iterative index scans), que continuam buscando até que linhas suficientes passem; outros sistemas filtram durante a própria busca no grafo ou nos clusters. Seja como for, teste os seus filtros reais mais rigorosos.
O que é busca híbrida em um banco de dados vetorial?
A busca híbrida executa uma busca por palavras-chave e uma busca vetorial na mesma coleção e junta as duas listas de resultados. Os vetores encontram paráfrases; as palavras-chave encontram sequências exatas como números de pedido, códigos de erro e nomes de produto, que os embeddings tendem a borrar. Muitos bancos de dados vetoriais guardam um índice de palavras-chave ou vetores esparsos (vetores longos quase todos de zeros, uma posição por palavra) ao lado dos embeddings para que uma única consulta use os dois; se não, a própria aplicação junta as duas listas.
Você precisa de um banco de dados vetorial dedicado ou de uma extensão vetorial?
Você precisa de um banco de dados vetorial dedicado quando os vetores são uma parte central, grande e muito usada do seu sistema; quando são só mais uma coluna ao lado de dados que você já guarda, uma extensão vetorial ou uma biblioteca costuma bastar. A escolha depende da operação do sistema, não de um ranking de produtos.
- Uma extensão vetorial no seu banco de dados atual. O pgvector, por exemplo, adiciona ao PostgreSQL um tipo vetorial, operadores de distância e índices HNSW e IVFFlat. A busca dele é exata por padrão, uma coluna
vectorsimples guarda até 16.000 dimensões e pode ser indexada até 2.000, e os filtros, joins, backups e regras de acesso continuam sendo os que você já tem. - Um banco de dados vetorial dedicado. Um sistema separado construído em torno da busca ANN, com escalonamento, replicação, filtragem e recursos híbridos próprios. Ele compensa com coleções muito grandes, muitas consultas por segundo, atualizações frequentes ou várias aplicações compartilhando um mesmo índice.
- Uma biblioteca dentro do seu programa. O Faiss, por exemplo, monta índices e busca neles em memória, sem servidor. Serve para trabalhos em lote e para a detecção de duplicatas offline, mas o armazenamento, as atualizações e a filtragem ficam por sua conta.
Às vezes você não precisa de nenhum deles. Até algumas centenas de milhares de vetores podem ser buscados de forma exata; a nossa varredura de 100.000 vetores levou cerca de 40 milissegundos em JavaScript puro. Uma busca por SKU ou número de pedido, ou "pedidos acima de 500 unidades no mês passado", é uma consulta por palavra-chave ou SQL e nunca deveria ser "quase certa". Comece onde os seus dados já estão e só mude quando o recall e a latência medidos indicarem.
De quanta memória um banco de dados vetorial precisa?
Os vetores brutos precisam de número de vetores × dimensões × bytes por número, antes de qualquer índice. Com os comuns pontos flutuantes de 4 bytes, um milhão de vetores de 768 dimensões ocupa cerca de 3,1 GB, e um milhão de vetores de 1.536 dimensões, cerca de 6,1 GB; dez milhões de vetores desse último tipo ocupam cerca de 61 GB.
O índice se soma a isso: um grafo HNSW guarda uma lista de IDs de vizinhos para cada vetor, e uma busca rápida espera que o grafo, e normalmente também os vetores, estejam na RAM. Números de meia precisão (2 bytes em vez de 4), códigos de quantização de produto e um modelo com menos dimensões reduzem a conta, e cada um pode custar um pouco de recall, então meça antes e depois.
Gerar todos os embeddings de novo é o custo escondido. Um novo modelo de embeddings torna cada vetor guardado incomparável com as novas consultas, então a coleção inteira precisa ser convertida de novo e o índice, reconstruído.
Onde os bancos de dados vetoriais são usados?
Os bancos de dados vetoriais são usados sempre que uma aplicação precisa encontrar "coisas como esta" entre muitos itens.
RAG e assistentes de IA. Na geração aumentada por recuperação (RAG), o banco de dados vetorial encontra os trechos mais relacionados à pergunta de um usuário e os entrega a um modelo de linguagem grande, que escreve a resposta a partir deles e pode citar as fontes.
Busca, recomendações e duplicatas. A busca de uma central de ajuda ou de uma loja encontra páginas pelo significado; os "produtos parecidos" são os vizinhos mais próximos do item que acabou de ser visto; dois tickets ou anúncios que dizem a mesma coisa com outras palavras ficam tão próximos que um limite de distância os marca como duplicatas. Modelos que convertem imagens e texto para o mesmo espaço também permitem que uma consulta em texto encontre fotos correspondentes.
De onde vêm as páginas de origem dos vetores?
Um índice vetorial só é tão bom quanto o conteúdo por trás dele. Quando um assistente responde a partir de páginas web públicas, como documentação de produtos, preços ou normas locais, essas páginas precisam ser coletadas, limpas e buscadas de novo quando mudam; como transformar HTML em chunks limpos e marcados com a fonte é o tema de Web scraping para RAG.
Muitas páginas públicas também mudam conforme o país do visitante: preços, estoque, prazos de entrega e até o idioma do texto. Se os seus usuários estão na Alemanha e o índice guarda a versão que um servidor em outro país viu, os vizinhos mais próximos estarão errados com toda a convicção. Coletar as páginas públicas pelos Proxies residenciais, com IPs no país de destino e segmentação por país e cidade, mantém a cópia indexada próxima do que os visitantes locais veem.
As equipes que preferem não cuidar dessa coleta podem perguntar pela nossa Web Scraping API, um serviço gerenciado de extração de páginas disponível pela equipe de vendas e descrito na página de extração de dados. Seja qual for o jeito de coletar, respeite o robots.txt, os termos e os limites de taxa de cada site, e deixe os dados pessoais fora do índice, a menos que você tenha uma base legal para tratá-los.
Erros comuns
- Misturar modelos ou versões de embeddings. Vetores de modelos diferentes não podem ser comparados; trocar de modelo significa gerar todos os embeddings de novo.
- Usar a medida de similaridade errada. Use aquela para a qual o modelo foi treinado, e a mesma para indexar e para consultar.
- Confiar nas configurações padrão do índice. Meça o recall em 10 contra uma busca exata em uma amostra de consultas reais e depois ajuste os parâmetros do grafo ou dos clusters.
- Testar sem filtros. Um filtro de metadados rigoroso pode reduzir a lista de resultados a um punhado de itens; teste os filtros que os usuários realmente aplicam.
- Não ter limite de similaridade. Vizinhos mais próximos sempre existem, então sem uma pontuação mínima um assistente responde a partir de trechos que são apenas os menos irrelevantes.
- Esquecer exclusões e permissões de acesso. Documentos excluídos ou restritos continuam aparecendo nas buscas até que seus vetores sejam removidos ou filtrados.
Guia de decisão
| A sua situação | O que usar |
|---|---|
| Menos de algumas centenas de milhares de vetores | Busca exata ou uma extensão vetorial |
| Dados já no PostgreSQL | pgvector, com índice HNSW quando necessário |
| Milhões de vetores, muitas consultas | Um banco de dados vetorial dedicado |
| Trabalhos em lote offline ou pesquisa | Uma biblioteca em memória como o Faiss |
| Usuários também buscam códigos e nomes | Busca híbrida, palavras-chave mais vetores |
| Filtros rigorosos na maioria das consultas | Um sistema que filtre durante a busca |
| A memória é o limite | Meia precisão ou quantização de produto |
| Respostas tiradas de páginas web públicas | Coletar e atualizar as páginas por mercado |
Perguntas frequentes
Qual é a diferença entre um banco de dados vetorial e um vector store?
"Vector store" (repositório de vetores) é um termo mais solto para qualquer coisa que guarde embeddings e devolva os mais próximos, de uma lista em memória a um banco de dados completo. Um banco de dados vetorial acrescenta o lado de banco de dados: persistência, atualizações e exclusões, filtros, controle de acesso, backups e escalonamento. Muitos frameworks de IA chamam de "vector store" a interface que fica na frente de qualquer um dos dois.
Preciso de um banco de dados vetorial para RAG?
Nem sempre. O RAG precisa de uma etapa de recuperação, e para uma coleção modesta ela pode ser uma busca exata em memória, uma extensão vetorial no banco de dados que você já tem ou um índice de palavras-chave. Um banco de dados vetorial dedicado passa a ser útil quando a coleção é grande, muda com frequência ou atende muitos usuários com filtros rigorosos.
HNSW ou IVF: qual índice é melhor?
Nenhum é melhor em todos os casos. O HNSW costuma dar mais recall na mesma velocidade, mas usa mais memória e é montado mais devagar; o IVF é montado mais rápido e usa menos memória, e combinado com a quantização de produto permite colocar coleções muito grandes em uma RAM limitada. Teste os dois com os seus próprios dados e filtros.
Qual é a diferença entre um banco de dados vetorial e um banco de dados de grafos?
Um banco de dados de grafos guarda relações explícitas, como "este cliente comprou este produto", e as percorre. Um banco de dados vetorial guarda similaridade implícita: os itens estão "relacionados" porque seus vetores estão próximos. Alguns sistemas combinam as duas coisas e usam os vetores para achar um ponto de partida e o grafo para seguir conexões conhecidas.
Qual é um exemplo de banco de dados vetorial?
O pgvector é um exemplo de código aberto do caminho da extensão: ele adiciona busca vetorial ao PostgreSQL. O Faiss é um exemplo do caminho da biblioteca, e vários sistemas de código aberto e gerenciados são bancos de dados vetoriais dedicados. Qual deles serve depende do tamanho dos seus dados, dos seus filtros e do que você já mantém.
Quantas dimensões meus vetores devem ter?
O modelo de embeddings define o número de dimensões, em geral de algumas centenas a alguns milhares. Mais dimensões podem guardar mais detalhes, mas custam proporcionalmente mais memória, então compare um modelo menor com um maior nas suas próprias consultas de teste antes de pagar pelo índice maior.
Em resumo
Um banco de dados vetorial guarda embeddings com um ID e metadados e encontra os itens mais parecidos com um vetor de consulta. A busca exata serve para coleções pequenas; em grande escala, grafos HNSW, clusters IVF e quantização de produto trocam um pouco de recall por respostas muito mais rápidas, então ajuste-os com as suas próprias consultas e filtros. Comece pelo banco de dados que você já usa, acrescente busca híbrida para as sequências exatas e calcule a memória como vetores × dimensões × bytes. Quando o índice é montado a partir de páginas web públicas, manter essas páginas atualizadas e na versão certa de cada país é metade do trabalho.