


































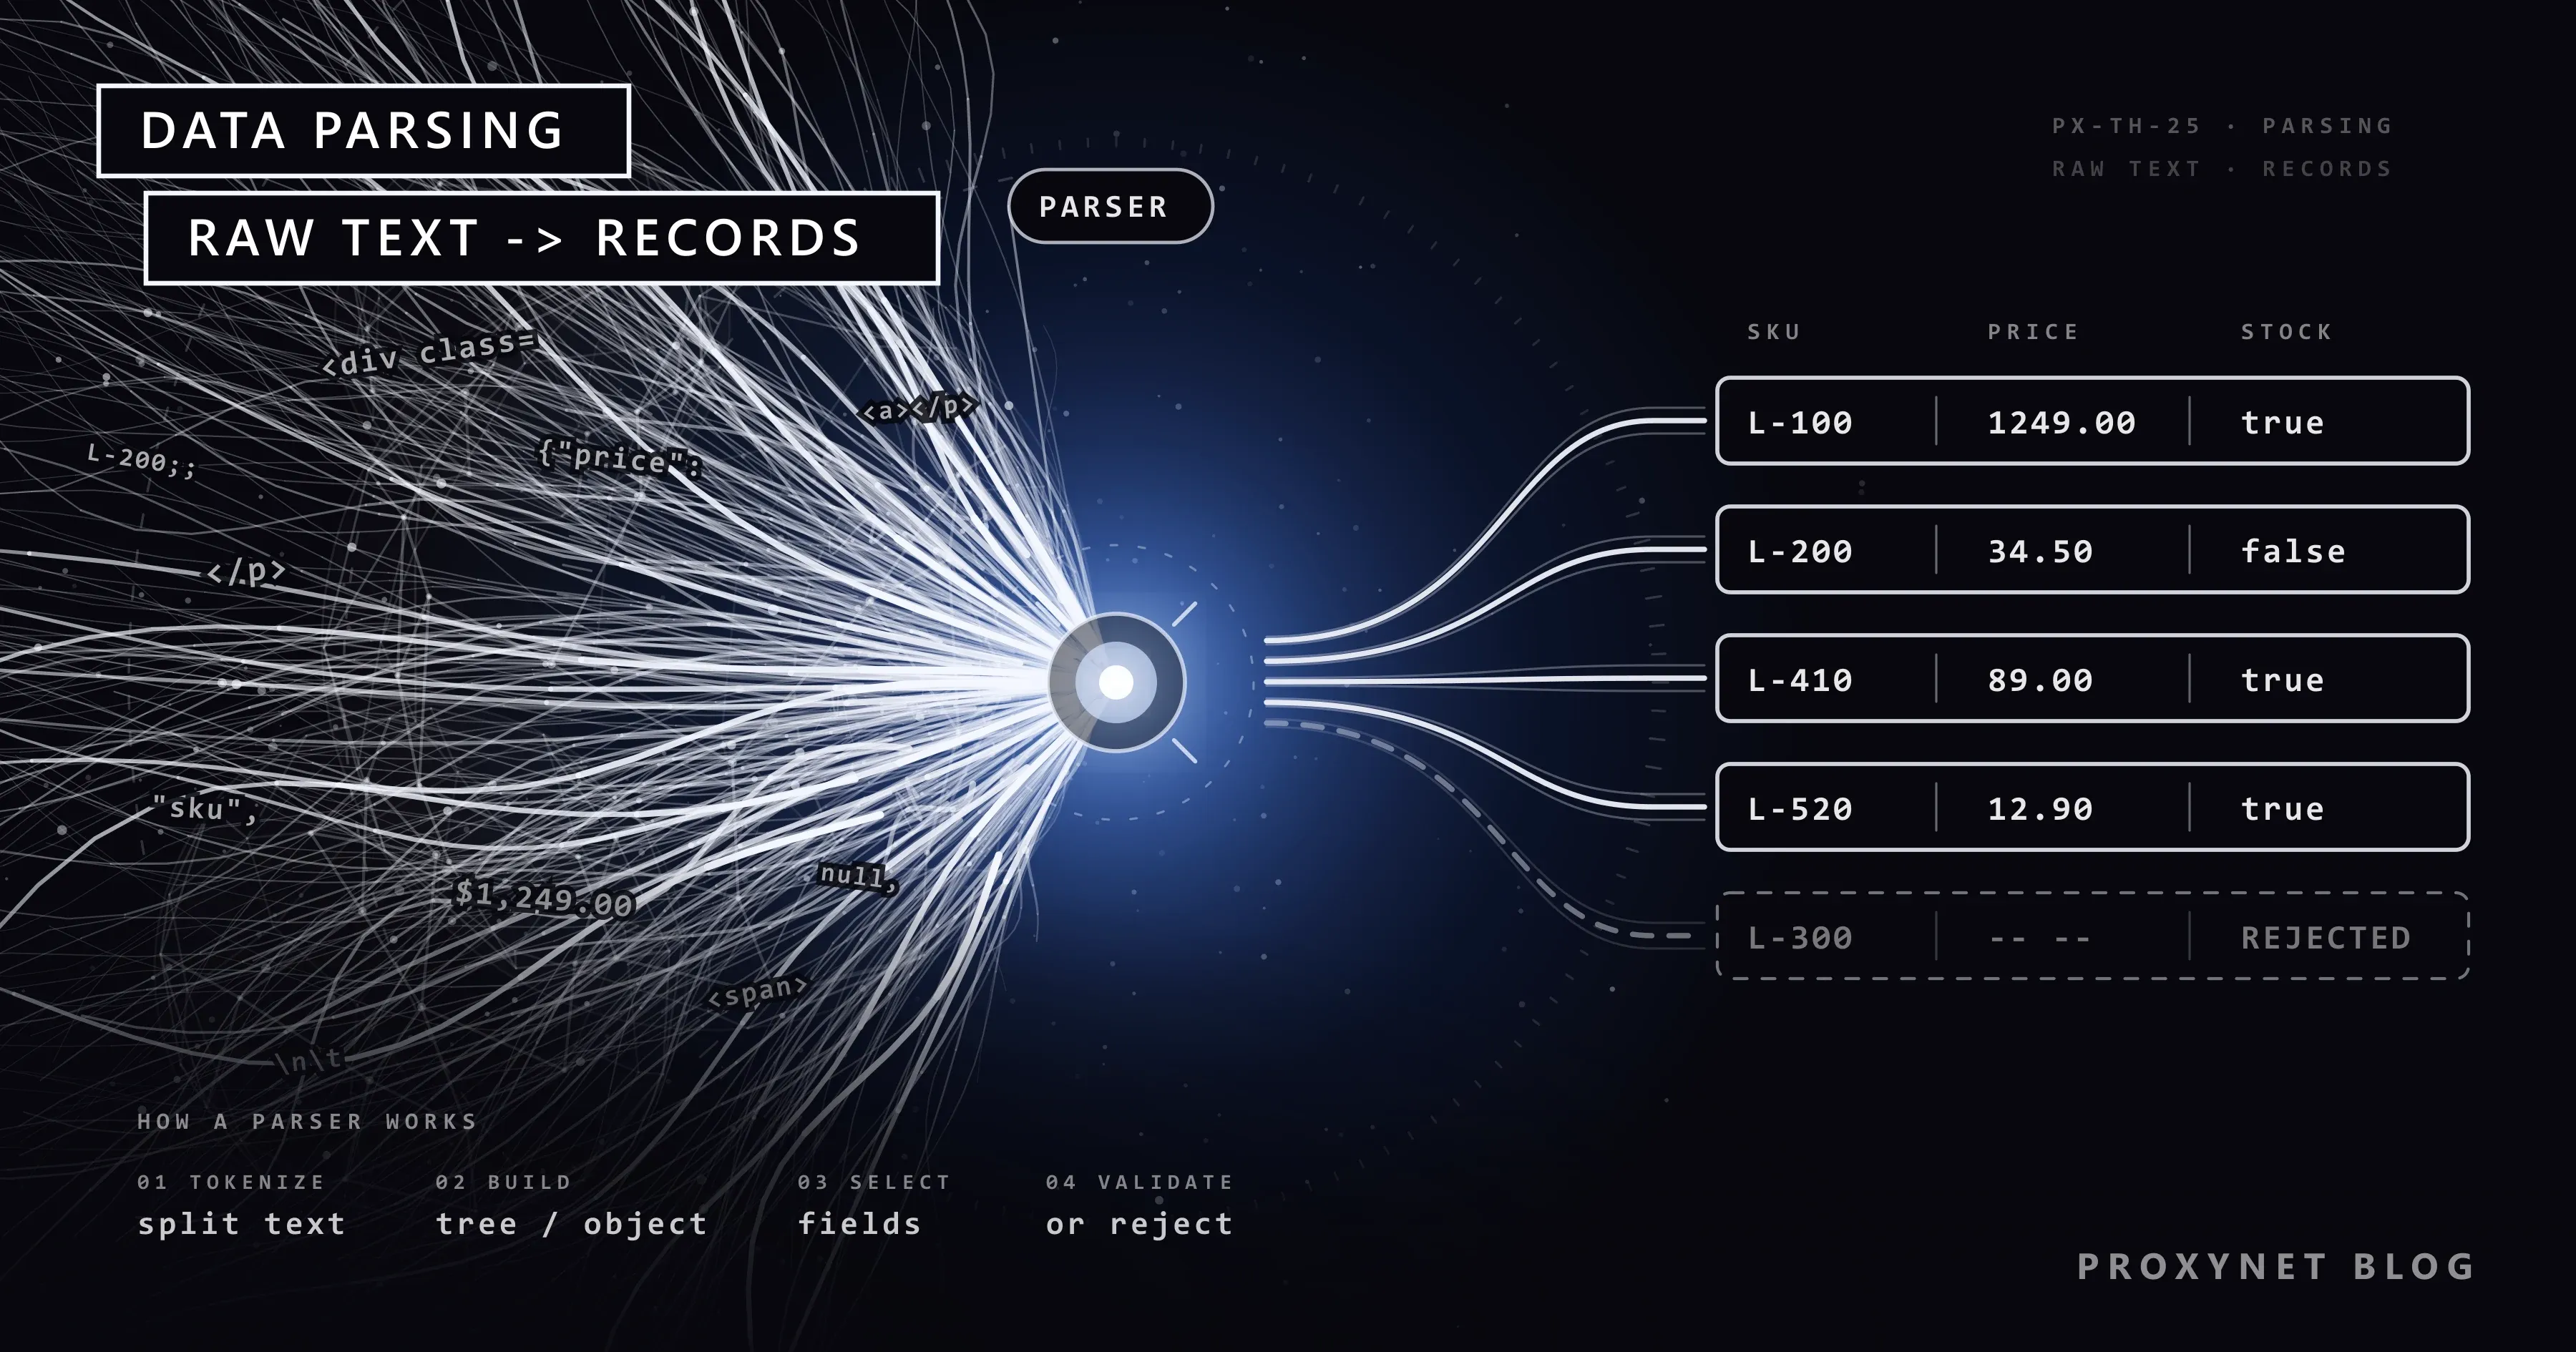
Um scraper baixa a página de um produto e a salva em disco. O arquivo tem 180 KB de HTML e, em algum lugar dentro dele, estão as quatro coisas que você realmente queria: o nome do produto, o preço, a disponibilidade em estoque e o SKU. Até que um programa encontre esses valores, confira-os e grave-os em campos com nome, o download é só texto. Essa etapa, do texto bruto aos campos, é a análise sintática de dados (parsing).
Este artigo explica o que significa parsing, como um parser trabalha (duas etapas centrais e os passos em volta delas) e que tipo de parser serve para HTML, JSON, CSV, logs e formatos próprios. Ele separa o parsing do scraping e da extração, mostra um exemplo curto e testado em Python com BeautifulSoup e o módulo json, cobre os erros que quebram parsers em projetos reais (HTML malformado, JSON inválido, desvio de esquema) e termina com um guia para decidir entre construir ou comprar.
O que é parsing de dados?
Fazer parsing significa analisar uma entrada segundo um conjunto de regras e produzir uma estrutura que represente o que essa entrada diz. A entrada costuma ser uma string ou um fluxo de bytes. A saída é algo com nomes e tipos: uma árvore de elementos HTML, um dicionário Python, uma lista de linhas, um registro com um campo price que guarda um número em vez do texto "$1,249.00".
O seu navegador faz o parsing do HTML para montar a página, o seu cliente de API faz o parsing do JSON em objetos, a sua planilha faz o parsing do CSV em células. Você só percebe o parsing quando a entrada não corresponde ao que o parser esperava, e o programa para com um erro ou, pior, segue em frente com valores errados.
No trabalho com dados, a palavra é usada em duas camadas:
- Parsing do formato. Transformar bytes na estrutura própria do formato: HTML em uma árvore DOM, JSON em objetos, CSV em linhas. As bibliotecas fazem isso.
- Parsing de dados no sentido estrito. Pegar essa estrutura e tirar dela os valores de que você precisa, com os tipos certos: o preço como decimal, a data como data, o estoque como verdadeiro ou falso. Essa parte normalmente é você quem escreve.
Como um parser funciona?
Quase todo parser, de uma biblioteca JSON ao motor HTML de um navegador, segue as mesmas duas etapas centrais, a análise léxica e a análise sintática, com um passo de leitura antes e a seleção de valores e a validação depois.
- Ler a entrada como texto. Os bytes são decodificados em caracteres com uma codificação, normalmente UTF-8. Um palpite errado aqui produz caracteres embaralhados antes mesmo de o parsing começar; erros de codificação Unicode em Python trata dessa falha.
- Tokenizar (análise léxica). O parser corta o fluxo de caracteres em tokens, as menores partes com significado: uma tag de abertura, um atributo, uma string, um número, uma vírgula, uma chave de fechamento.
- Montar a estrutura (análise sintática). Os tokens são organizados segundo a gramática do formato. No HTML, o resultado é uma árvore de elementos aninhados; no JSON, objetos e arrays aninhados; no CSV, linhas de campos.
- Selecionar os valores. O seu código percorre a estrutura e escolhe os campos de que precisa, por exemplo com um seletor CSS ou XPath sobre uma árvore HTML. Seletor CSS vs XPath compara as duas formas de apontar para um elemento.
- Converter e validar. O texto vira dado tipado:
"$34.50"vira34.50,"In stock"viratrue. Registros sem um campo obrigatório são sinalizados em vez de salvos em silêncio.
O padrão HTML descreve o parser de um navegador exatamente com essas etapas. O capítulo de parsing do WHATWG o divide em tokenização e construção da árvore, e também define como um parser deve se recuperar de erros; é por isso que os navegadores mostram páginas quebradas em vez de recusá-las.
Parsing, scraping e extração: qual a diferença
As três palavras são usadas muitas vezes como sinônimos, mas nomeiam etapas diferentes de um mesmo pipeline.
| Termo | O que faz | Entrada | Saída |
|---|---|---|---|
| Crawling | Encontra páginas seguindo links | Uma URL inicial | Uma lista de URLs |
| Scraping | Baixa o conteúdo dessas páginas | URLs | HTML, JSON ou arquivos brutos |
| Parsing | Transforma conteúdo bruto em estrutura | Texto bruto | Árvores, objetos, linhas |
| Extração | Escolhe os valores necessários dentro da estrutura | Uma árvore ou objeto | Campos com nome |
| Validação e limpeza | Confere tipos, remove duplicatas, corrige formatos | Campos | Registros confiáveis |
| Armazenamento | Grava os registros em algum lugar | Registros | CSV, JSON Lines, um banco de dados |
No dia a dia, "parsing" cobre parsing, extração e parte da validação ao mesmo tempo, e é nesse sentido que o termo aparece no restante do artigo. Crawling e scraping são o lado da coleta; web scraping vs web crawling explica essa divisão. Onde os registros vão parar é o tema de como salvar dados de scraping em CSV, JSON e SQLite, e a cadeia inteira como um processo repetível é o assunto de O que é ETL?.
Tipos de parsers
Entradas diferentes pedem parsers diferentes. Usar o tipo errado, por exemplo uma expressão regular sobre HTML aninhado, é a origem de muitos scrapers frágeis.
| Tipo de parser | Melhor para | Exemplos | Ponto fraco |
|---|---|---|---|
| Parser HTML / DOM | Páginas web, inclusive com marcação quebrada | BeautifulSoup com html.parser, lxml ou html5lib; Cheerio no Node.js | Depende de seletores que mudam quando o layout da página muda |
| Parser JSON | Respostas de API, dados embutidos na página | json do Python, JSON.parse no JavaScript | Rígido: uma vírgula a mais derruba o documento inteiro |
| Parser CSV / delimitado | Exportações, planilhas, relatórios | csv do Python, read_csv do pandas | Aspas, delimitadores e codificações variam conforme quem gera o arquivo |
| Parser XML | Feeds, sitemaps, APIs corporativas antigas | lxml, xml.etree.ElementTree | Namespaces deixam os seletores prolixos |
| Expressões regulares | Padrões pequenos e planos dentro de um campo conhecido: preços, datas, IDs | re do Python | Não acompanham aninhamento; quebram com mudanças de layout |
| Parser baseado em gramática | Formatos próprios, linguagens de consulta, arquivos de configuração | Geradores de parser como ANTLR, Lark | Escrever a gramática leva tempo |
| Parser baseado em modelos | Texto bagunçado sem layout fixo | Modelos de linguagem que retornam JSON | A saída precisa ser validada; os resultados podem variar entre execuções |
Duas linhas merecem um comentário. Parsers HTML não são iguais: o BeautifulSoup funciona sobre um parser que você escolhe, e a sua documentação mostra o trecho quebrado <a></p> gerando três árvores diferentes em html.parser, lxml e html5lib. Indique o parser de forma explícita, ou a sua saída pode mudar em uma máquina que tenha outro instalado. O parsing baseado em modelos é o modo como os scrapers com IA leem páginas cujo layout muda o tempo todo; ele troca regras exatas por flexibilidade, então a validação importa ainda mais, como explica como funcionam os web scrapers com IA.
Um exemplo curto de parsing em Python
O exemplo faz o parsing de uma pequena página de produtos com um parser HTML, seletores CSS, uma expressão regular para o campo de preço, uma checagem de campos obrigatórios e um parsing JSON separado para os dados embutidos na página. Salve isto como page.html; o segundo card tem um <span> sem fechamento e o terceiro não tem preço:
<!doctype html>
<html lang="en">
<head>
  <title>Desk lamps</title>
  <script type="application/ld+json">
  {"@context": "https://schema.org", "@type": "ItemList",
   "itemListElement": [
     {"@type": "ListItem", "position": 1, "url": "/p/arc-lamp"},
     {"@type": "ListItem", "position": 2, "url": "/p/clip-lamp"}
   ]}
  </script>
</head>
<body>
  <div class="product" data-sku="L-100">
    <h2 class="name">Arc Desk Lamp</h2>
    <span class="price">$1,249.00</span>
    <span class="stock">In stock</span>
  </div>
  <div class="product" data-sku="L-200">
    <h2 class="name">  Clip Lamp </h2>
    <span class="price">$34.50</span>
    <span class="stock">Out of stock
  </div>
  <div class="product" data-sku="L-300">
    <h2 class="name">Floor Lamp</h2>
    <span class="stock">In stock</span>
  </div>
</body>
</html>
Instale as duas bibliotecas com pip install beautifulsoup4 lxml e salve isto como parse_products.py ao lado da página:
import json
import re
from decimal import Decimal
from pathlib import Path

from bs4 import BeautifulSoup

PRICE_RE = re.compile(r"[\d.,]+")


def parse_price(text):
    """'$1,249.00' -> Decimal('1249.00'); None se não houver número."""
    match = PRICE_RE.search(text or "")
    if not match:
        return None
    return Decimal(match.group().replace(",", ""))


def parse_products(html):
    soup = BeautifulSoup(html, "lxml")
    rows, problems = [], []

    for card in soup.select("div.product"):
        name = card.select_one(".name")
        price = card.select_one(".price")
        stock = card.select_one(".stock")
        row = {
            "sku": card.get("data-sku"),
            "name": name.get_text(strip=True) if name else None,
            "price": parse_price(price.get_text()) if price else None,
            "in_stock": stock is not None and stock.get_text(strip=True) == "In stock",
        }
        missing = [key for key in ("sku", "name", "price") if row[key] is None]
        if missing:
            problems.append({"sku": row["sku"], "missing": missing})
            continue
        rows.append(row)

    # Dados estruturados embutidos na página: faça o parsing como JSON, não como HTML.
    urls = []
    for tag in soup.select('script[type="application/ld+json"]'):
        try:
            data = json.loads(tag.string or "")
        except json.JSONDecodeError as err:
            problems.append({"json_ld": f"line {err.lineno}, col {err.colno}: {err.msg}"})
            continue
        urls += [item.get("url") for item in data.get("itemListElement", [])]

    return rows, urls, problems


if __name__ == "__main__":
    html = Path("page.html").read_text(encoding="utf-8")
    rows, urls, problems = parse_products(html)
    print(json.dumps(rows, indent=2, default=str))
    print("urls:", urls)
    print("problems:", problems)
Rodar python parse_products.py com BeautifulSoup 4.15.0, lxml 6.1.3 e Python 3.13 imprime:
[
  {
    "sku": "L-100",
    "name": "Arc Desk Lamp",
    "price": "1249.00",
    "in_stock": true
  },
  {
    "sku": "L-200",
    "name": "Clip Lamp",
    "price": "34.50",
    "in_stock": false
  }
]
urls: ['/p/arc-lamp', '/p/clip-lamp']
problems: [{'sku': 'L-300', 'missing': ['price']}]
O <span> sem fechamento não quebrou nada porque o lxml consertou a árvore, o nome com espaços saiu limpo e a luminária sem preço foi para problems em vez de ser salva vazia. Quando, como teste, acrescentamos uma vírgula final ao bloco JSON-LD, o script continuou rodando e informou line 5, col 64: Illegal trailing comma before end of object, o que aponta direto para o defeito. JSONDecodeError: Expecting Value lista as outras mensagens que esse parser gera e o que causa cada uma.
O mesmo parser escrito para Node.js usa Cheerio em vez de BeautifulSoup; veja web scraping com Cheerio. Para um scraper completo com requisições, paginação e gravação, comece pelo tutorial de BeautifulSoup.
Erros comuns de parsing e suas causas
- HTML malformado. Tags sem fechamento, tags de fechamento soltas e tags no lugar errado são normais na web. Navegadores e parsers HTML as consertam, mas cada parser do seu jeito, então um seletor que funciona com
html5libpode falhar comhtml.parser. Fixe a escolha do parser e teste com páginas salvas. - JSON inválido. JSON é rígido. A RFC 8259 define a gramática, e vírgulas finais, aspas simples e comentários não fazem parte dela. Uma causa frequente nem é JSON: o servidor devolveu uma página de erro HTML ou um corpo vazio, e o parser JSON falha no primeiro caractere.
- Chaves duplicadas. A RFC 8259 diz que, quando nomes se repetem em um objeto, o comportamento de quem recebe é imprevisível. O módulo json do Python fica com o último valor sem gerar erro, então
{"price": 10, "price": 12}vira12em silêncio. - Aspas e delimitadores no CSV. Uma vírgula dentro do nome de um produto divide um campo em dois se ele não estiver entre aspas. A RFC 4180 descreve a convenção de aspas mais comum, mas é apenas informativa, e muitas exportações usam ponto e vírgula ou tabulação. Use uma biblioteca CSV, nunca
line.split(","). - Números e datas conforme a região.
1.249,00passa de mil na Alemanha e dá pouco mais de um em um parser ingênuo;03/04/2026é março ou abril dependendo do país. Faça o parsing com um formato explícito para cada fonte. - Desvio de esquema (schema drift). O site renomeia uma classe ou move o preço para um novo elemento, e o parser continua rodando, mas retorna
Noneou o valor errado. Nada quebra, e é isso que torna essa a falha mais cara. Checagens de campos obrigatórios, como a listaproblemsacima, transformam o desvio silencioso em uma contagem visível. - Conteúdo que não está no HTML. Algumas páginas montam o conteúdo com JavaScript depois de carregar, então os dados nunca estiveram no arquivo baixado. Páginas estáticas vs dinâmicas mostra como diferenciar.
Construir ou comprar um parser?
Para formatos padrão, você nunca escreve o parser de baixo nível; as bibliotecas estão maduras. A decisão é sobre a camada de extração que fica em cima: seletores, conversões e checagens por site.
Construa você mesmo quando tiver um número limitado de fontes que mudam pouco. O seu próprio código é transparente, não custa nada por página e é fácil de testar com amostras salvas.
Use uma ferramenta ou um serviço pronto quando acompanhar centenas de sites cujo layout muda com frequência, ou quando a entrada não tiver layout fixo nenhum, como e-mails e PDFs. Você paga por volume ou por usuário e aceita menos controle sobre a saída.
Um modelo híbrido é comum: APIs oficiais ou JSON embutido onde existirem, parsers escritos à mão para as fontes principais, uma alternativa baseada em modelos para a cauda longa e a mesma etapa de validação antes do armazenamento para os três.
Onde o parsing é usado
- Coleta de dados em escala. Todo pipeline de scraping faz parsing entre o download e o banco de dados; veja data scraping.
- Crawlers e auditorias de sites. Um crawler faz o parsing de cada página em busca de links e metadados; veja web crawler.
- Monitoramento de preços. Preços convertidos em números podem ser comparados ao longo do tempo, como no monitoramento de preços da concorrência.
- Monitoramento de mudanças. Comparar campos já processados em vez do HTML bruto evita alarmes falsos causados por anúncios e carimbos de data e hora; veja monitoramento de mudanças em sites.
- Análise de dados. Registros tipados são o ponto de partida para encontrar padrões; veja O que é mineração de dados?.
- Logs e segurança. As linhas de log passam por parsing em carimbo de data e hora, endereço IP, status e caminho antes que alguém consiga contar os erros.
Erros frequentes
- Fazer parsing do site ao vivo enquanto desenvolve. Salve algumas páginas reais em disco e escreva o parser em cima delas: menos requisições ao site e testes repetíveis.
- Usar regex em documentos HTML inteiros. Faça primeiro o parsing da árvore e use regex só dentro do texto de um único campo.
- Guardar preços como texto ou float. Converta cedo para
Decimalou para centavos inteiros e mantenha a string original para depuração. - Engolir todas as exceções. Um
try/except: passsem nada oculta o desvio de esquema. Registre as falhas com o ID do registro e confira a contagem depois de cada execução. - Ignorar o JSON embutido. Muitas páginas de produto trazem JSON-LD com os mesmos valores em uma forma mais limpa que o HTML visível.
- Culpar o parser por requisições bloqueadas. Quando o "HTML" é uma página de bloqueio ou um erro 429, nenhum seletor vai corresponder. Verifique o código de status antes do parsing e diminua o ritmo se o site pedir.
Guia de decisão
| A sua entrada | Abordagem recomendada |
|---|---|
| Uma API que retorna JSON | Use a API; faça o parsing com a biblioteca JSON padrão e valide os campos obrigatórios |
| Páginas HTML estáticas de poucos sites | BeautifulSoup com lxml, ou Cheerio no Node.js, mais seletores CSS |
| Páginas que renderizam o conteúdo com JavaScript | Procure primeiro JSON embutido ou a API do site; use um navegador headless só se for preciso |
| Exportações CSV ou planilhas | Uma biblioteca CSV ou pandas, com delimitador e codificação definidos de forma explícita |
| Logs de servidor em formato fixo | Regex por linha ou um parser de logs, e depois converter os campos para os tipos certos |
| Um formato de texto próprio que você controla | Um parser baseado em gramática (ANTLR, Lark) |
| E-mails, PDFs, texto livre sem layout | Um extrator baseado em modelos com validação rígida da saída |
| Centenas de sites com layouts que mudam | Um serviço comercial de parsing ou uma configuração híbrida |
Perguntas frequentes
O que é parsing de dados em termos simples?
É ler texto bruto e transformá-lo em partes rotuladas que um programa pode usar. Entra uma página web e sai um registro com nome, preço e disponibilidade em estoque.
Qual a diferença entre parsing e scraping?
O scraping baixa conteúdo de um site; o parsing transforma esse conteúdo em dados estruturados. Um scraper sem parser deixa você com arquivos HTML brutos.
Qual biblioteca Python é usada para fazer parsing de HTML?
O BeautifulSoup é a mais usada e funciona sobre html.parser, lxml ou html5lib. O lxml também pode ser usado diretamente e suporta XPath. Para JSON, o módulo nativo json basta.
Posso fazer parsing de HTML com expressões regulares?
Só para trechos de texto muito pequenos e planos. O HTML é aninhado e muitas vezes quebrado, e uma expressão regular não consegue acompanhar o aninhamento. Faça o parsing da página com um parser HTML e, se precisar, use regex dentro de um único campo.
Por que o meu parser de repente retorna valores vazios?
Geralmente o site mudou a marcação e os seus seletores não correspondem mais. Outras causas: uma página de erro no lugar do conteúdo, ou conteúdo carregado depois por JavaScript.
Preciso de proxy para fazer parsing de dados?
O parsing em si roda na sua própria máquina e não precisa de proxy. Os proxies importam no lado da coleta, quando um scraper reúne páginas públicas em volume ou precisa ver uma página como os visitantes de outro país a veem. Os endereços de Proxies residenciais permitem escolher país e cidade, e o Proxies rotativos distribui as requisições entre vários endereços; em qualquer caso, respeite os termos e os limites de taxa de cada site.
Em resumo
O parsing de dados transforma uma entrada bruta em registros estruturados e tipados: um tokenizador corta o texto em partes, um parser as organiza segundo as regras do formato e o seu código escolhe, converte e confere os valores de que precisa. Escolha o parser pela entrada e mantenha a regex dentro de campos individuais. A maior parte do trabalho em um projeto real vai para as falhas, principalmente o desvio de esquema que nenhuma mensagem de erro anuncia; por isso, valide cada registro e conte as falhas depois de cada execução. Quando o lado da coleta precisar de endereços em países específicos, veja os nossos serviços de proxy.


