


































از فروشگاهی داده جمع میکنید که قیمتها را با JavaScript بارگذاری میکند. HTML دریافتی با Requests خالی است، پس سراغ Playwright میروید و صفحه بدون مشکل باز میشود. وقتی کار بزرگتر میشود باید ترافیک را از پروکسی عبور دهید و نخستین تلاش با net::ERR_TUNNEL_CONNECTION_FAILED یا پیام "Browser does not support socks5 proxy authentication" تمام میشود. بیشتر راهنماها Playwright را ابزار خودکارسازی آزمون معرفی میکنند و به همین دلیل بخش پروکسی معمولاً از رشتهبحثهای انجمنها و گزارشهای خطا در GitHub جمع میشود.
در این نوشته Playwright را کوتاه تعریف میکنیم، نصب در Python و Node.js را کنار هم میآوریم و سپس به پروکسی میرسیم: تفاوت پروکسی در سطح مرورگر و در سطح context، احراز هویت با نام کاربری و رمز عبور، رفتار Chromium با SOCKS5، انتخاب میان چرخشی و sticky، صرفهجویی در ترافیک با قطع درخواستهای تصویر و فونت، راستیآزمایی IP و جدول خطاها. همه نمونههای این نوشته را با Playwright 1.63 و Chromium و از طریق یک پروکسی آزمایشی محلی دارای احراز هویت اجرا کردهایم.
Playwright چیست؟
Playwright کتابخانهای متنباز برای خودکارسازی مرورگر است که Microsoft آن را توسعه داده است. یک مرورگر واقعی را از درون کد باز میکند، به نشانی میرود، کلیک میکند، فرم پر میکند و عناصر صفحه را میخواند. موتورهای Chromium، Firefox و WebKit را با یک API مدیریت میکند و برای Node.js، Python، Java و .NET نسخه رسمی دارد.
خاستگاه این ابزار آزمون سرتاسری است و بیشتر راهنماها آن را از همین زاویه معرفی میکنند. ارزش آن برای تیمهای داده جای دیگری است: صفحهای را که با JavaScript ساخته میشود در مرورگر واقعی اجرا میکند، خودش تا پدیدار شدن عنصر صبر میکند و اجازه میدهد فراخوانیهای API را که صفحه در پسزمینه انجام میدهد گوش کنید و درخواستهای غیرضروری را قطع کنید. برای اینکه بدانید صفحه واقعاً به مرورگر نیاز دارد یا نه، ابتدا نوشته صفحههای ایستا و پویا در وب اسکرپینگ را ببینید؛ اگر داده در کد منبع صفحه یا در یک نقطه پایانی JSON قرار دارد، باز کردن مرورگر هزینه اضافی است.
کارهایی که با Playwright انجام میشود را میتوان در چهار دسته جا داد:
- جمعآوری داده از صفحههای پویا (فهرست محصول، قیمت، موجودی، تعداد نظرها).
- آزمودن اینکه سایت یا برنامه خودتان از کشورهای مختلف چگونه دیده میشود.
- تولید تصویر صفحه و PDF.
- واداشتن عاملهای هوش مصنوعی به استفاده از مرورگر. جزئیات این مورد آخر در نوشته ما درباره Playwright MCP، نصب آن و تنظیمات پروکسی آمده است.
تفاوتهای معماری با Selenium و اینکه در هر پروژه کدام را انتخاب کنید در نوشتهای جداگانه آمده است: تفاوت Playwright و Selenium.
Playwright چگونه نصب میشود؟
نصب دو گام دارد: نخست کتابخانه و سپس فایلهای اجرایی مرورگرها. Playwright از Chrome نصبشده روی سیستم استفاده نمیکند، بلکه مرورگرهایی را به کار میگیرد که خودش دانلود و نسخه آنها را ثابت میکند. علت خطای «کتابخانه را نصب کردم اما مرورگر پیدا نشد» جا انداختن گام دوم است.
در Python یک محیط مجازی بسازید و کتابخانه را نصب کنید. مستندات رسمی کتابخانه Python همین گامها را برای poetry و uv هم آورده است.
python -m venv .venv
source .venv/bin/activate        # Windows: .venv\Scripts\activate
pip install playwright
playwright install chromium
در Node.js:
npm init -y
npm install playwright
npx playwright install chromium
اگر به فرمان install نام مرورگر ندهید، هر سه موتور دانلود میشوند. در کارهای اسکرپینگ معمولاً Chromium کافی است. اگر میخواهید آزمون بنویسید، در Python بسته pytest-playwright و در Node.js بسته @playwright/test توصیه میشود؛ برای جمعآوری داده همان نصب ساده کتابخانه در بالا کافی است.
در Python دو API وجود دارد: sync_api و async_api. در اسکریپتهایی که صفحهها را یکییکی باز میکنند نسخه همگام خواناتر است. اگر میخواهید چند صفحه را همزمان پردازش کنید، نسخه مبتنی بر asyncio را به کار ببرید؛ نمونه کامل پایان نوشته به همین شکل نوشته شده است.
پروکسی در Playwright چگونه تعریف میشود؟
بخش HTTP Proxy در مستندات شبکه Playwright دو سطح تعریف میکند: پروکسی یا برای کل مرورگر یا جداگانه برای هر context داده میشود. در هر دو حالت همان شیء به کار میرود:
| فیلد | الزامی است؟ | معنا |
|---|---|---|
server | بله | http://pr.proxynet.io:8000 یا socks5://host:port. اگر طرحواره نوشته نشود، پروکسی HTTP در نظر گرفته میشود |
username | خیر | نام کاربری برای احراز هویت پروکسی HTTP |
password | خیر | رمز عبور برای احراز هویت پروکسی HTTP |
bypass | خیر | دامنههایی که از پروکسی عبور نمیکنند و با ویرگول جدا میشوند (.example.com, api.yourcompany.com) |
تعریف در سطح مرورگر در Python به این شکل است:
from playwright.sync_api import sync_playwright

PROXY = {
    "server": "http://pr.proxynet.io:8000",
    "username": "user",
    "password": "pass",
}

with sync_playwright() as p:
    browser = p.chromium.launch(proxy=PROXY)
    page = browser.new_page()
    page.goto("https://httpbin.org/ip")
    print(page.inner_text("body"))  # the proxy's exit IP
    browser.close()
معادل همین کار در Node.js:
import { chromium } from "playwright";

const browser = await chromium.launch({
  proxy: {
    server: "http://pr.proxynet.io:8000",
    username: "user",
    password: "pass",
  },
});
const page = await browser.newPage();
await page.goto("https://httpbin.org/ip");
console.log(await page.innerText("body")); // the proxy's exit IP
await browser.close();نکتهای که باید به آن توجه کنید جای اطلاعات ورود است. نوشتن http://user:pass@pr.proxynet.io:8000 به عادت cURL یا Requests در اینجا کار نمیکند: Playwright از مقدار server فقط طرحواره، میزبان و پورت را برمیدارد و نام کاربری و رمز عبور درون نشانی را به مرورگر نمیرساند. اطلاعات ورود همیشه در فیلدهای username و password نوشته میشود. این کار یک فایده جانبی هم دارد: اگر در رمز عبور نویسههایی مانند @ یا : باشد، درگیر کدگذاری URL نمیشوید. منطق کلی این دو روش در نوشته احراز هویت پروکسی: نام کاربری و رمز یا لیست سفید IP آمده است.
تفاوت پروکسی در سطح مرورگر و در سطح context چیست؟
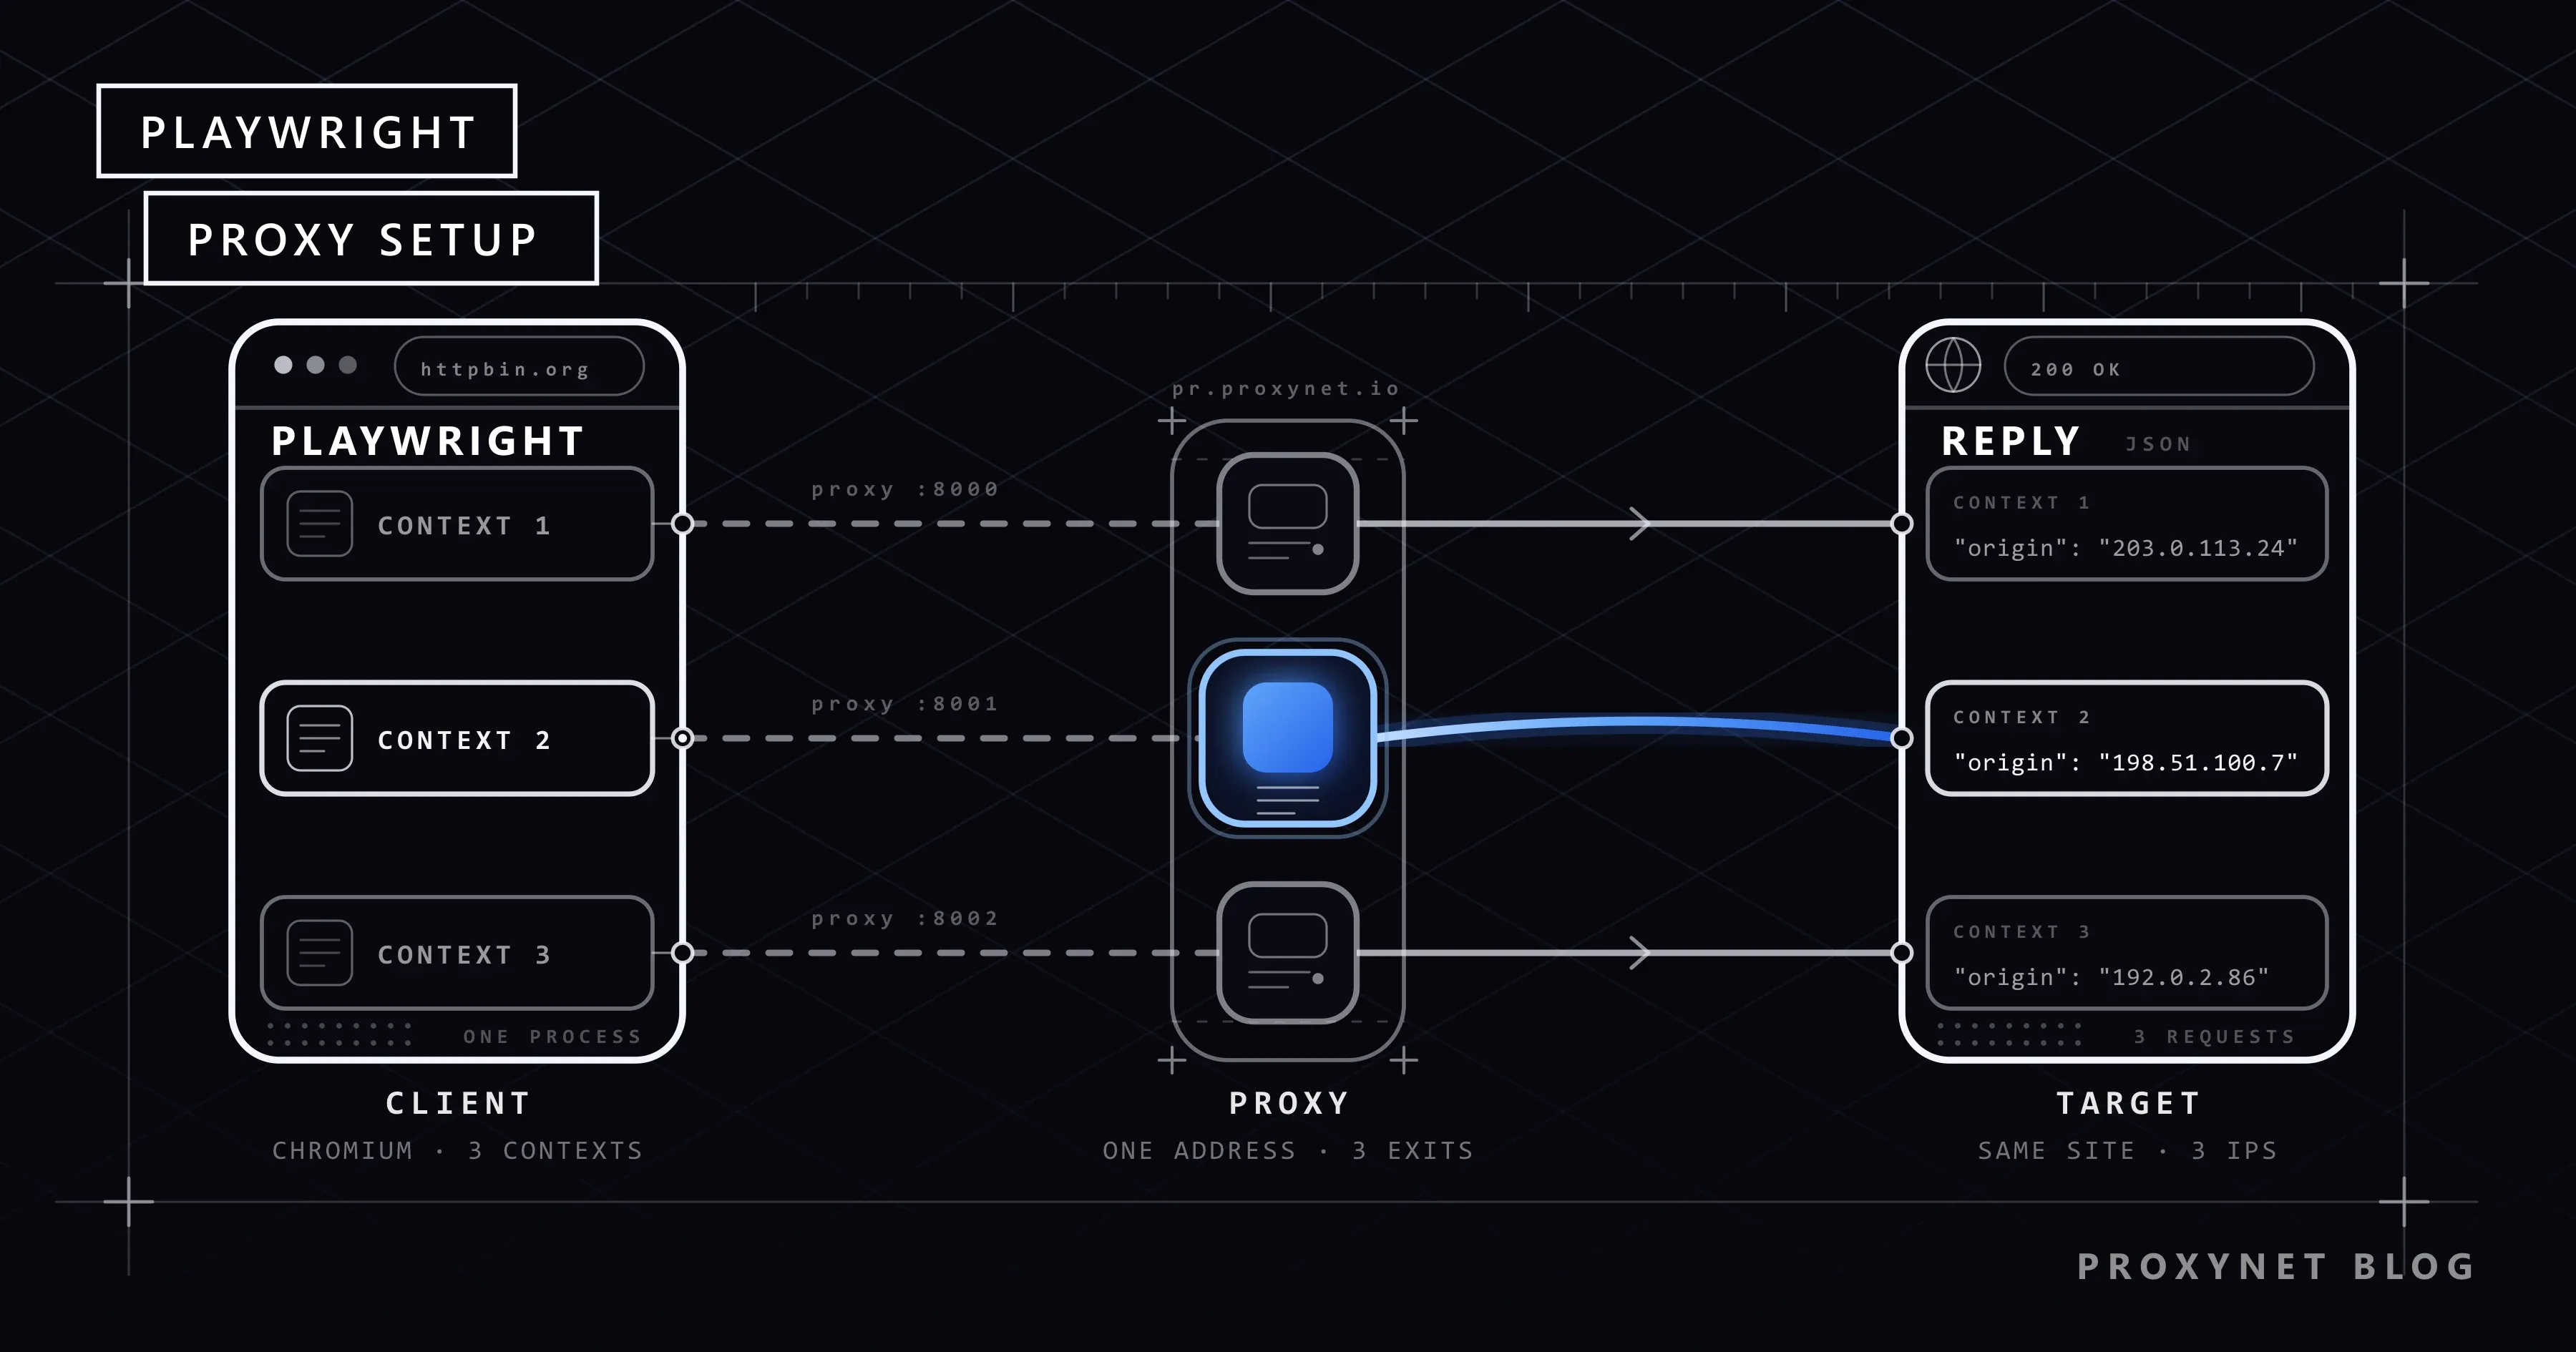
context در Playwright یک نشست مرورگر جدا از دیگر نشستها است: کوکیها، حافظه نهان و فضای ذخیرهسازی محلی خودش را دارد. به پنجره ناشناس شباهت دارد، اما در یک فرایند مرورگر دهها context میتوانند همزمان باز باشند و باز کردن هر کدام بسیار ارزانتر از اجرای یک مرورگر تازه است.
وقتی پروکسی را به جای launch() به فراخوانی new_context() بدهید، تنظیم فقط همان context را در بر میگیرد:
from playwright.sync_api import sync_playwright

PROXIES = [
    {"server": "http://pr.proxynet.io:8000", "username": "user", "password": "pass"},
    {"server": "http://pr.proxynet.io:8001", "username": "user", "password": "pass"},
]

with sync_playwright() as p:
    browser = p.chromium.launch()  # the browser opens once, without a proxy
    for proxy in PROXIES:
        context = browser.new_context(proxy=proxy)  # each context with its own proxy
        page = context.new_page()
        page.goto("https://httpbin.org/ip")
        print(proxy["server"], page.inner_text("body"))
        context.close()  # cookies and cache are deleted together with the context
    browser.close()
وقتی این نمونه را با دو پروکسی محلی جداگانه اجرا کردیم، درخواست هر context در گزارش پروکسی خودش ثبت شد و context سومی که پروکسی نداشت مستقیم وصل شد. در راهنماهای قدیمی گفته میشود که در Windows برای Chromium باید در فراخوانی launch() یک پروکسی جاینگهدار مانند http://per-context بنویسید. این محدودیت به نسخههای قدیمی Playwright مربوط بود و در اوت 2024 از کد حذف شد؛ در مستندات کنونی هم چنین یادداشتی نیست. با Playwright 1.63 روی Windows 11 نمونه بدون جاینگهدار کار کرد.
سطح مرورگر (launch) | سطح context (new_context) | |
|---|---|---|
| دامنه اثر | همه contextها و صفحهها | فقط همان context |
| IP متفاوت در یک مرورگر | خیر | بله، برای هر context پروکسی جداگانه |
| برای عوض کردن پروکسی | مرورگر را میبندید و دوباره باز میکنید | context را میبندید و یکی تازه باز میکنید |
| کوکی و نشست | contextها همچنان جدا هستند | همراه با پروکسی جدا میشود |
| کار مناسب | اسکریپتها و آزمونهایی که یک نقطه خروج برایشان کافی است | نشستهای مستقل پرشمار، مقایسه میان کشورها |
قاعده عملی این است: یک نشست، یک context، یک IP. راهی برای عوض کردن پروکسی درون همان context وجود ندارد و نبودنش خوب است؛ نشستی که کوکیهایش ثابت میماند و IP آن عوض میشود از دید سایت مقصد بازدیدکنندهای ناسازگار است.
آیا Playwright با پروکسی SOCKS5 کار میکند؟
کار میکند، اما بدون نام کاربری و رمز عبور. اگر به server نشانی با طرحواره socks5:// بدهید و username هم اضافه کنید، Playwright بدون اینکه مرورگر را اجرا کند این خطا را میدهد:
BrowserType.launch: Browser does not support socks5 proxy authenticationهمین بررسی برای new_context() هم انجام میشود. علت خود Chromium است: مستندات پروکسی Chromium آشکارا میگوید که برای SOCKSv5 هیچ روش احراز هویتی پشتیبانی نمیشود. این را در روز نگارش با یک سرور SOCKS5 محلی آزمودیم. تنها روشی که Chromium در پیام دستدهی پیشنهاد داد 0x00 یعنی «بدون احراز هویت» بود؛ روش نام کاربری و رمز عبور (0x02) که در RFC 1929 آمده در فهرست نبود. جاسازی اطلاعات ورود در نشانی (socks5://user:pass@...) هم نتیجه را عوض نکرد: Playwright این بخش را دور ریخت و چون سرور احراز هویت میخواست، اتصال با net::ERR_SOCKS_CONNECTION_FAILED بسته شد. در سرور SOCKS5 بدون احراز هویت صفحه بدون مشکل باز شد.
راهحل این است که هویت خود را نه با رمز عبور، بلکه با نشانی IP ثابت کنید. IP خروجی سروری را که اسکریپت روی آن اجرا میشود در پنل کاربری پروکسی به لیست سفید IP اضافه میکنید و فقط فیلد server را میدهید:
from playwright.sync_api import sync_playwright

with sync_playwright() as p:
    # No username or password: your exit IP must be on the IP whitelist in the dashboard
    browser = p.chromium.launch(proxy={"server": "socks5://pr.proxynet.io:1080"})
    page = browser.new_page()
    page.goto("https://httpbin.org/ip")
    print(page.inner_text("body"))
    browser.close()
در گزارشهای آزمایش ما Chromium به سرور SOCKS5 نام دامنه فرستاد، نه نشانی IP؛ یعنی تحلیل DNS در سمت پروکسی انجام میشود و تمایز socks5h:// که در cURL میشناسید در اینجا لازم نیست. برای باز کردن صفحه بیشتر وقتها پروکسی HTTP کافی است، چون ترافیک HTTPS در هر حال با تونل CONNECT جابهجا میشود. اینکه چه زمانی SOCKS5 را ترجیح دهید در نوشته تفاوت پروکسی SOCKS و HTTP: کدام را انتخاب کنیم؟ توضیح داده شده است؛ بخش محصول در صفحه پروکسی SOCKS5 است.
چرخشی یا sticky: کدام برای چه کاری؟
مرورگر مانند اسکریپتی که یک درخواست HTTP میفرستد رفتار نمیکند. هنگام بارگذاری یک صفحه برای سند اصلی، اسکریپتها، فایلهای سبک، تصویرها و فراخوانیهای API اتصالهای جداگانهای به دامنههای مختلف باز میشود. در گیتویای که در هر اتصال IP خروجی را عوض میکند، این اتصالها ممکن است از IPهای متفاوت خارج شوند. هنگام پیمایش صفحههای مستقل از هم این مشکلی نیست. اما در روندهایی که ورود به حساب، سبد خرید یا فرم چندمرحلهای دارند، عوض شدن IP در میانه نشست میتواند باعث شود سایت نشست را پایان دهد.
- صفحههای مستقل (فهرست محصول، دستهبندی، نتیجه جستوجو): پروکسی چرخشی مناسب است. چرخش را گیتوی انجام میدهد و در کدتان فهرست پروکسی نگه نمیدارید. سازوکار چرخش در نوشته ما درباره چرخش IP و شیوه کار آن آمده است.
- روندهایی که نشست میخواهند (ورود با حساب خودتان، عملیات چندمرحلهای): با پروکسی با نشست ثابت همان IP در تمام عمر context حفظ میشود. اطلاعات نشست ثابت را از پنل کاربری میگیرید و در فیلد
proxyمربوط به context مینویسید. - محتوایی که بسته به کشور عوض میشود: برای هر کشور یک context جداگانه باز میکنید و نقطه خروج همان کشور را به آن میدهید؛ یک مرورگر و مقایسه کنار هم.
دادن پروکسی به هر context خودش نوعی الگوی چرخش است: وقتی context را میبندید و یکی تازه باز میکنید، کوکیها و IP با هم نو میشوند.
چگونه با مسدود کردن تصویر و فونت ترافیک را کم کنیم؟
ترافیک پروکسی مسکونی بر پایه GB صورتحساب میشود و مرورگر هر چیزی را که یک کلاینت ساده HTTP دانلود نمیکند دانلود میکند: تصویر محصول، فونتهای وب، ویدئو. اگر آنچه نیاز دارید قیمت و عنوان است، پرداخت برای این بایتها معنایی ندارد. سازوکار route در Playwright درخواست را پیش از رفتن به شبکه میگیرد و میتوانید آن را بر اساس نوع منبع لغو کنید.
from playwright.sync_api import sync_playwright

BLOCKED = {"image", "media", "font"}


def filter_resources(route):
    if route.request.resource_type in BLOCKED:
        route.abort()
    else:
        route.continue_()


with sync_playwright() as p:
    browser = p.chromium.launch(proxy={
        "server": "http://pr.proxynet.io:8000",
        "username": "user",
        "password": "pass",
    })
    page = browser.new_page()
    page.route("**/*", filter_resources)
    page.goto("https://books.toscrape.com/")
    print(page.locator("article.product_pod h3 a").first.get_attribute("title"))
    browser.close()
اندازه صرفهجویی به صفحه بستگی دارد و دادن یک درصد کلی گمراهکننده است. برای سنجش در مقصد خودتان همان صفحه را با فیلتر و بدون فیلتر باز کنید و شمارنده ترافیک پنل کاربری پروکسی را مقایسه کنید. دو هشدار: مسدود کردن فایلهای سبک (stylesheet) و اسکریپتها (script) میتواند ساخته شدن محتوای صفحه را مختل کند، پس فهرست را به تصویر، رسانه و فونت محدود نگه دارید. این روش یک شیوه صرفهجویی است و برای جدا کردن اسکریپتهای حفاظتی سایت به کار نمیرود.
صرفهجویی بزرگتر بیشتر وقتها درون ترافیکی است که مرورگر به آن گوش میدهد. صفحههای پویا معمولاً داده را از یک نقطه پایانی JSON میگیرند و Playwright اجازه میدهد این پاسخ را مستقیم بخوانید:
from playwright.sync_api import sync_playwright

with sync_playwright() as p:
    browser = p.chromium.launch(proxy={
        "server": "http://pr.proxynet.io:8000",
        "username": "user",
        "password": "pass",
    })
    page = browser.new_page()
    with page.expect_response("**/api/quotes?page=1") as info:
        page.goto("https://quotes.toscrape.com/scroll")
    data = info.value.json()
    for quote in data["quotes"][:3]:
        print(quote["author"]["name"], "-", quote["text"][:60])
    browser.close()
به جای تجزیه HTML با انتخابگرها داده ساختیافته میگیرید. اگر نقطه پایانی به اطلاعات ورود نیاز ندارد، در گام بعد میتوانید مرورگر را کاملاً کنار بگذارید و همان نشانی را با یک کلاینت ساده HTTP فراخوانی کنید.
چگونه مطمئن شویم پروکسی کار میکند؟
سه بررسی کافی است:
- نشانی
https://httpbin.org/ipرا با Playwright باز کنید و IP برگشتی را با IP خودتان مقایسه کنید. اگر متفاوت است، ترافیک از پروکسی عبور میکند. - همان نشانی را با یک context بدون پروکسی باز کنید. اگر دو نتیجه یکسان باشد، شیء
proxyبه فراخوانی نادرست داده شده یا دامنه وارد فهرستbypassشده است. - اگر کشور خاصی را هدف گرفتهاید، مکان IP را در یک سرویس موقعیتیابی جغرافیایی بررسی کنید. علت تفاوت میان پایگاههای داده را در نوشته آیا از آدرس IP میتوان موقعیت را یافت و چرا اشتباه است؟ توضیح دادهایم.
آزمودن پروکسی جدا از Playwright نشان میدهد مشکل در کد است یا در شبکه. آزمونهای خط فرمان در نوشته آیا پروکسی کار میکند؟ چگونه پروکسی را آزمایش کنیم آمده است.
نمونه کامل: contextهای همزمان، تلاش مجدد و مسدود کردن منابع
اسکریپت زیر شش صفحه را که با JavaScript ساخته میشوند پیمایش میکند. همزمان حداکثر سه context را باز نگه میدارد، در هر تلاش از یک context و اتصال پروکسی تازه استفاده میکند، تصویر و فونت را مسدود میکند و در خطاهای گذرا با انتظار نمایی همراه با یک جزء تصادفی دوباره تلاش میکند. در خطاهایی که نشان میدهند اصلاً به پروکسی دسترسی نیست دوباره تلاش نمیکند، چون چیزی که این وضعیت را درست میکند انتظار نیست، تنظیمات است.
import asyncio
import random

from playwright.async_api import Error, async_playwright

PROXY = {
    "server": "http://pr.proxynet.io:8000",
    "username": "user",
    "password": "pass",
}
URLS = [f"https://quotes.toscrape.com/js/page/{n}/" for n in range(1, 7)]
BLOCKED = {"image", "media", "font"}
CONCURRENCY = 3  # number of contexts open at the same time
ATTEMPTS = 3
# Errors a retry will not change: fix the configuration first
FATAL = ("ERR_PROXY_CONNECTION_FAILED", "ERR_TUNNEL_CONNECTION_FAILED", "ERR_SOCKS_CONNECTION_FAILED")


async def filter_resources(route):
    if route.request.resource_type in BLOCKED:
        await route.abort()
    else:
        await route.continue_()


async def scrape(browser, url, limit):
    async with limit:
        for attempt in range(ATTEMPTS):
            context = await browser.new_context(proxy=PROXY)  # clean session on every attempt
            try:
                page = await context.new_page()
                await page.route("**/*", filter_resources)
                response = await page.goto(url, timeout=30_000)
                if response is None or response.status >= 400:
                    raise Error(f"HTTP {response.status if response else 'no response'}")
                quotes = page.locator("div.quote span.text")
                await quotes.first.wait_for(timeout=10_000)  # wait until JavaScript renders the content
                return url, await quotes.all_inner_texts()
            except Error as exc:  # TimeoutError also derives from Error
                if any(code in str(exc) for code in FATAL):
                    raise
                if attempt == ATTEMPTS - 1:
                    raise
                await asyncio.sleep(2**attempt + random.random())
            finally:
                await context.close()


async def main():
    async with async_playwright() as p:
        browser = await p.chromium.launch()
        limit = asyncio.Semaphore(CONCURRENCY)
        results = await asyncio.gather(
            *(scrape(browser, url, limit) for url in URLS), return_exceptions=True
        )
        await browser.close()
    for url, result in zip(URLS, results):
        if isinstance(result, Exception):
            print(url, "ERROR:", str(result).splitlines()[0])
        else:
            print(url, len(result[1]), "quotes")


asyncio.run(main())
در پروکسی آزمایشی محلی ما هر شش صفحه با ده نقلقول برگشتند؛ وقتی پورت پروکسی را عمداً نادرست نوشتیم، اسکریپت بدون تلاش مجدد با ERR_PROXY_CONNECTION_FAILED ایستاد. در یک کار واقعی دو چیز اضافه کنید. منطق تلاش مجددی را که در پاسخهای 429 و 503 از سرآیند Retry-After پیروی میکند از نمونه نوشته کدهای وضعیت HTTP در وب اسکرپینگ: 403، 407، 429، 503 بردارید؛ اینجا تکرارش نمیکنیم. همزمانی را هم با حافظه تنظیم کنید: هر context و هر صفحه حافظه مصرف میکند، پس مقدار CONCURRENCY را کوچک آغاز کنید و با زیر نظر گرفتن سرورتان بالا ببرید. جزئیات راهبردهای انتظار (چرا به جای networkidle منتظر عنصر میمانیم) در همان نوشته صفحههای ایستا و پویا است که بالاتر به آن اشاره کردیم.
جدول خطاها: ERR_PROXY_CONNECTION_FAILED, ERR_TUNNEL_CONNECTION_FAILED, 407
هر یک از سطرهای زیر را عمداً در پروکسی آزمایشی محلی پدید آوردیم.
| آنچه میبینید | چه معنایی دارد | چه باید کرد |
|---|---|---|
net::ERR_PROXY_CONNECTION_FAILED | اتصال TCP به سرور پروکسی برقرار نشد: نشانی یا پورت نادرست است یا دیوار آتش خروجی را میبندد | مقدار server و پورت را بررسی کنید و همان نشانی را با cURL بیازمایید |
net::ERR_TUNNEL_CONNECTION_FAILED | به پروکسی رسیدیم اما به درخواست CONNECT پاسخی غیر از 200 آمد: احراز هویت رد شد (407) یا پروکسی به مقصد نرسید (502) | نخست اطلاعات ورود و سپس نشانی مقصد را بررسی کنید |
پایان مهلت goto در نشانی HTTPS و 407 در گزارش پروکسی | نام کاربری یا رمز عبور نادرست است یا اصلاً داده نشده. در آزمایش ما رویداد requestfailed خطای ERR_TUNNEL_CONNECTION_FAILED را گزارش کرد اما goto به جای پرتاب خطا تا پایان مهلت منتظر ماند | خطای واقعی را با page.on("requestfailed") ببینید و فیلدهای username و password را درست کنید |
کد پاسخ 407 در نشانی HTTP (بدون رمزنگاری) | همان علت؛ چون تونلی نیست، پاسخ پروکسی به شکل پاسخ صفحه میرسد | مقدار response.status را بررسی و اطلاعات ورود را درست کنید |
Browser does not support socks5 proxy authentication | همراه با نشانی socks5:// مقدار username داده شده است | اطلاعات ورود را بردارید و از لیست سفید IP استفاده کنید یا به پروکسی HTTP بروید |
net::ERR_SOCKS_CONNECTION_FAILED | سرور SOCKS5 احراز هویت میخواهد یا IP شما در لیست سفید نیست | IP خروجی خود را در پنل کاربری به فهرست اضافه کنید |
| صفحه باز میشود اما IP همان IP شما است | شیء proxy اصلاً اعمال نشده یا دامنه در فهرست bypass است | مطمئن شوید شیء را به فراخوانی launch یا new_context دادهاید |
سطر سوم بیش از همه وقت میگیرد: اسکریپت خطا نمیدهد، فقط سی ثانیه صبر میکند و مهلتش تمام میشود و مشکل به کندی سایت مقصد نسبت داده میشود. افزودن این دو خط در زمان توسعه عیبیابی را کوتاه میکند:
page.on("requestfailed", lambda r: print("FAILED:", r.url, r.failure))
page.on("response", lambda r: print(r.status, r.url) if r.status >= 400 else None)
معنای کلی کد 407 و شکل آن در کتابخانههای دیگر در نوشته کدهای وضعیت HTTP آمده است؛ برای خطاهایی از نوع «سرور پروکسی پاسخ نمیدهد» در بیرون از خودکارسازی مرورگر، نوشته ما درباره خطای پروکسی و پیام «سرور پروکسی پاسخ نمیدهد» را ببینید.
کاربردها
- صفحههای پویای فروشگاه و کاتالوگ: داده قیمت و موجودی که با JavaScript بارگذاری میشود. چارچوب کلی در صفحه راهحل استخراج داده آمده است.
- پیمایش منظم صفحههای پرشمار: کشف صفحه و مدیریت صف در صفحه راهحل وب کراولر است؛ الگوهای صفحهبندی در نوشته ما درباره صفحهبندی در وب اسکرپینگ.
- آزمودن برنامه شما از کشورهای مختلف: برای هر کشور یک context و در هر کدام نقطه خروج همان کشور. جزئیات در صفحه آزمون برنامه است.
- پایش قیمت رقبا: پیمایشی روزانه با مسدود کردن منابع که به محدودیت نرخ درخواست پایبند است. جنبه کسبوکاری آن در نوشته ما درباره پایش قیمت رقبا در تجارت الکترونیک آمده است.
کار هر چه باشد چارچوب یکی است: به قواعد robots.txt و شرایط استفاده سایت پایبند باشید، اگر API رسمی هست آن را ترجیح دهید و سرعت درخواستها را در سطحی نگه دارید که سایت تاب بیاورد. شیوه خواندن فایل robots.txt در نوشته فایل robots.txt چیست و چگونه آن را بخوانیم؟ آمده است.
اشتباهات رایج
- جاسازی اطلاعات ورود در نشانی
server. Playwright این بخش را نادیده میگیرد؛ نتیجه407یا پایان مهلت است. - آزمودن نام کاربری و رمز عبور با SOCKS5. Chromium پشتیبانی نمیکند؛ از لیست سفید IP یا پروکسی HTTP استفاده کنید.
- اجرای یک مرورگر تازه برای هر صفحه. مرورگر یک بار باز میشود؛ جداسازی و عوض کردن پروکسی با context انجام میشود.
- عبور دادن روند دارای نشست از گیتوی چرخشی. اتصالها از IPهای متفاوت خارج میشوند و نشست میافتد. از sticky استفاده کنید.
- نبستن contextها. هر context باز حافظه نگه میدارد؛ آن را در بلوک
finallyببندید. - مسدود کردن اسکریپتها و فایلهای سبک. صفحه نمیتواند محتوا بسازد و انتخابگر شما خالی برمیگردد.
- نسبت دادن پایان مهلت
gotoبه سایت مقصد. نخست رویدادrequestfailedو اطلاعات ورود پروکسی را ببینید. - پذیرفتن پاسخ
200بدون نگاه به محتوا. مطمئن شوید عنصر مورد انتظار در صفحه هست؛ صفحههای تأیید هم میتوانند200برگردانند.
راهنمای انتخاب
| نیاز | پیشنهاد |
|---|---|
| اسکریپت یا آزمونی که یک نقطه خروج برایش کافی است | launch(proxy=...)، پروکسی HTTP |
| چند نشست مستقل در یک مرورگر | new_context(proxy=...)، برای هر context پروکسی جداگانه |
| پیمایش انبوه صفحههای مستقل | پروکسی چرخشی، یک نشانی گیتوی |
| روند چندمرحلهای نیازمند ورود | پروکسی sticky، یک context یک IP |
| SOCKS5 الزامی است | لیست سفید IP، بدون username و password |
| ترافیکی که بر پایه GB صورتحساب میشود | درخواستهای تصویر، رسانه و فونت را با route مسدود کنید؛ اگر شدنی است پاسخ JSON را بخوانید |
| داده در کد منبع صفحه یا در نقطه پایانی JSON است | کلاینت ساده HTTP به جای Playwright |
| واداشتن عامل هوش مصنوعی به استفاده از مرورگر | Playwright MCP |
پرسشهای متداول
آیا Playwright رایگان است؟
بله. پروژهای متنباز با مجوز Apache 2.0 است و برای کتابخانه و فایلهای اجرایی مرورگری که دانلود میکند هزینهای پرداخت نمیشود. هزینه از منابع سروری که مرورگرها مصرف میکنند و از ترافیک پروکسی مورد استفاده شما میآید.
Playwright را با Python به کار ببریم یا با Node.js؟
تنظیم پروکسی و رفتار مرورگر در هر دو زبان یکسان است، چون هر دو با همان درایور گفتوگو میکنند. زبان تیم شما و زبان خط پردازش دادهتان باید تعیینکننده باشد. مقایسه این دو زبان از دید اسکرپینگ در نوشته اسکرپینگ وب: JavaScript یا Python؟ آمده است.
آیا میتوانم برای هر صفحه پروکسی جداگانه به کار ببرم؟
پروکسی به context بسته میشود، نه به صفحه. اگر برای هر صفحه IP جداگانه میخواهید، هر صفحه را در context خودش باز کنید. اگر از گیتوی چرخشی استفاده میکنید به این هم نیازی نیست؛ چرخش را گیتوی انجام میدهد.
آیا احراز هویت SOCKS5 با Firefox یا WebKit کار میکند؟
وقتی همراه با نشانی socks5:// نام کاربری داده شود، Playwright خطا را در گام اعتبارسنجی خودش و پیش از اجرای مرورگر میدهد و این بررسی به نوع مرورگر نگاه نمیکند. ما فقط با Chromium آزمودهایم؛ برای موتورهای دیگر هم لیست سفید IP را مبنا بگیرید.
آیا پروکسی در حالت headless رفتار دیگری دارد؟
خیر. شیء proxy در حالت با پنجره و بدون پنجره به یک شکل اعمال میشود. اگر میخواهید مشکل را با چشم ببینید، میتوانید با launch(headless=False) پنجره را باز کنید و همان اسکریپت را اجرا کنید.
آیا استفاده از پروکسی صفحههای تأیید را از میان میبرد؟
خیر. پروکسی فقط عوض میکند که درخواست از کدام IP خارج شود؛ سرعت درخواستها، نشانههای مرورگر و سازگاری نشست همان میماند. اینکه چرا این صفحهها ظاهر میشوند در نوشته Puppeteer و CAPTCHA: چرا ظاهر میشود و چگونه کم میشود؟ توضیح داده شده و آنچه در آنجا آمده برای Playwright هم درست است. افزونههای دور زدن تشخیص را توصیه نمیکنیم: راه ماندگار سرعت معقول، نشست سازگار و در صورت وجود API رسمی است.
خلاصه
پروکسی در Playwright یک شیء است: server، username، password. اگر آن را به فراخوانی launch() بدهید کل مرورگر و اگر به new_context() بدهید فقط همان نشست از پروکسی خارج میشود؛ راه دوم یعنی IP جداگانه برای هر context در یک مرورگر. اطلاعات ورود درون نشانی نوشته نمیشود، در SOCKS5 به جای رمز عبور از لیست سفید IP استفاده میشود، در روند دارای نشست sticky و در صفحههای مستقل چرخشی انتخاب میشود. اگر ترافیک را بر پایه GB میپردازید تصویر و فونت را مسدود کنید و اگر پایان مهلت میبینید نخست رویداد requestfailed را نگاه کنید. انواع پروکسی مناسب کارتان را در خدمات پروکسی ما مییابید.


