پروژه تازهای برای جمعآوری داده یا آزمون آغاز میکنید و چون صفحه با JavaScript ساخته میشود به مرورگر واقعی نیاز دارید. در تیم کسی هست که سالهاست Selenium مینویسد و توسعهدهنده تازهوارد Playwright را پیشنهاد میکند. هر دو مرورگر را از درون کد باز میکنند و کلیک میکنند، هر دو رایگاناند؛ همین شباهت است که انتخاب را دشوار میکند. بیشتر مقایسهها موضوع را با نگاه آزمون نرمافزار میبینند و سرفصلهایی را که در جمعآوری داده تعیینکنندهاند، مانند پروکسی و انتظار، جا میاندازند.
در این نوشته دو ابزار را روی هفت محور مقایسه میکنیم: معماری، انتظار خودکار، مدیریت پروکسی، پشتیبانی از زبانها، نصب مرورگر، موازیسازی و اشکالزدایی. کدی را که یک کار کوچک یکسان را با هر دو ابزار انجام میدهد با Playwright 1.63، Selenium 4.49 و Chrome 153 روی Windows 11 اجرا کردیم و آنچه دیدیم را در بخشهای مربوط میآوریم. «کدام کمتر دیده میشود» موضوع این نوشته نیست: هر دو ابزار مرورگری واقعی باز میکنند و در هر دو، رعایت قواعد سایت کار شماست.
Playwright و Selenium چه هستند؟
Selenium پروژهای متنباز برای خودکارسازی مرورگر است که از سال 2004 توسعه مییابد. بخشی که امروز به کار میرود Selenium WebDriver است: کد شما فرمانها را به یک درایور مرورگر میفرستد و درایور مرورگر را اداره میکند. نصب آن در نوشته Selenium با پروکسی آمده است؛ دانلود درایور و احراز هویت همانجا توضیح داده شدهاند.
Playwright کتابخانهای متنباز برای خودکارسازی مرورگر است که Microsoft در سال 2020 منتشر کرد. موتورهای Chromium، Firefox و WebKit را با یک API اداره میکند. نصب و تنظیم پروکسی آن در نوشته Playwright چیست و چگونه با پروکسی استفاده میشود؟ آمده است؛ اینجا تنها نقطههایی را میآوریم که از Selenium جدا میشود.
هر دو به یک نیاز پاسخ میدهند: محتوایی که با یک درخواست ساده HTTP نمیآید و تنها وقتی JavaScript در مرورگر اجرا شود پدید میآید. اینکه صفحه واقعاً به مرورگر نیاز دارد یا نه با بررسی نوشته صفحههای ایستا و پویا در وب اسکرپینگ روشن میشود. اگر داده در کد منبع صفحه باشد، یک کلاینت ساده HTTP یا Scrapy از هر دو ابزار ارزانتر است.
تفاوت معماری چیست: WebDriver و BiDi و CDP
تقریباً همه تفاوتهای رفتاری این دو ابزار از شیوه گفتوگوی آنها با مرورگر برمیخیزد.
در Selenium مسیر یک فرمان چنین است:
- کد شما
driver.find_element(...)را فرا میخواند. - کتابخانه Selenium آن را به یک درخواست HTTP در استاندارد W3C WebDriver تبدیل میکند.
- درخواست به برنامه درایوری میرسد که سازنده مرورگر نوشته است: ChromeDriver برای Chrome و GeckoDriver برای Firefox.
- درایور فرمان را روی مرورگر اجرا میکند و نتیجه را در قالب پاسخ HTTP بازمیگرداند.
هر فرمان یک درخواست و یک پاسخ جداگانه است؛ مرورگر از پیش خود چیزی به شما نمیگوید. خطایی که در کنسول میافتد یا درخواست شبکهای که در پسزمینه میرود، تا نپرسید دیده نمیشود. برای پر کردن همین کاستی، پروژه Selenium همراه با سازندگان مرورگر استاندارد WebDriver BiDi را مینویسد: پروتکلی دوسویه روی WebSocket. در Selenium 4 با options.enable_bidi = True روشن میشود؛ چون گذار هنوز ادامه دارد، امروز دو دنیا در Selenium کنار هم زندگی میکنند.
در Playwright مسیر دیگری در کار است:
- کد شما
page.locator(...).click()را فرا میخواند. - کتابخانه Python یا Java یا .NET این فراخوانی را به درایور Playwright که در بسته جاسازی شده است میرساند. درایور یک فرایند Node.js است؛ در محیط مجازی به صورت
playwright/driver/node.exeقرار دارد. - درایور از راه یک اتصال پایدار با مرورگر گفتوگو میکند. در Chromium این همان Chrome DevTools Protocol یا CDP است. در Firefox و WebKit، Playwright از ساختهای وصلهخورده خودش استفاده میکند.
- چون اتصال دوسویه است، رویدادهای مرورگر (درخواست، پاسخ، پیام کنسول، دانلود) بدون آنکه بپرسید به کد شما سرازیر میشوند.
این انتخاب بهایی هم دارد. سند مرورگرهای Playwright آشکارا میگوید: چون بر وصلهها تکیه دارد، با Firefox و Safari نسخه برند کار نمیکند. Chrome و Edge را میتوانید با گزینه channel به کار بگیرید، اما نیاز «آزمون روی Safari واقعی» را ساخت WebKit برآورده نمیکند؛ Selenium با درایور خود Apple سراغ Safari نصبشده میرود.
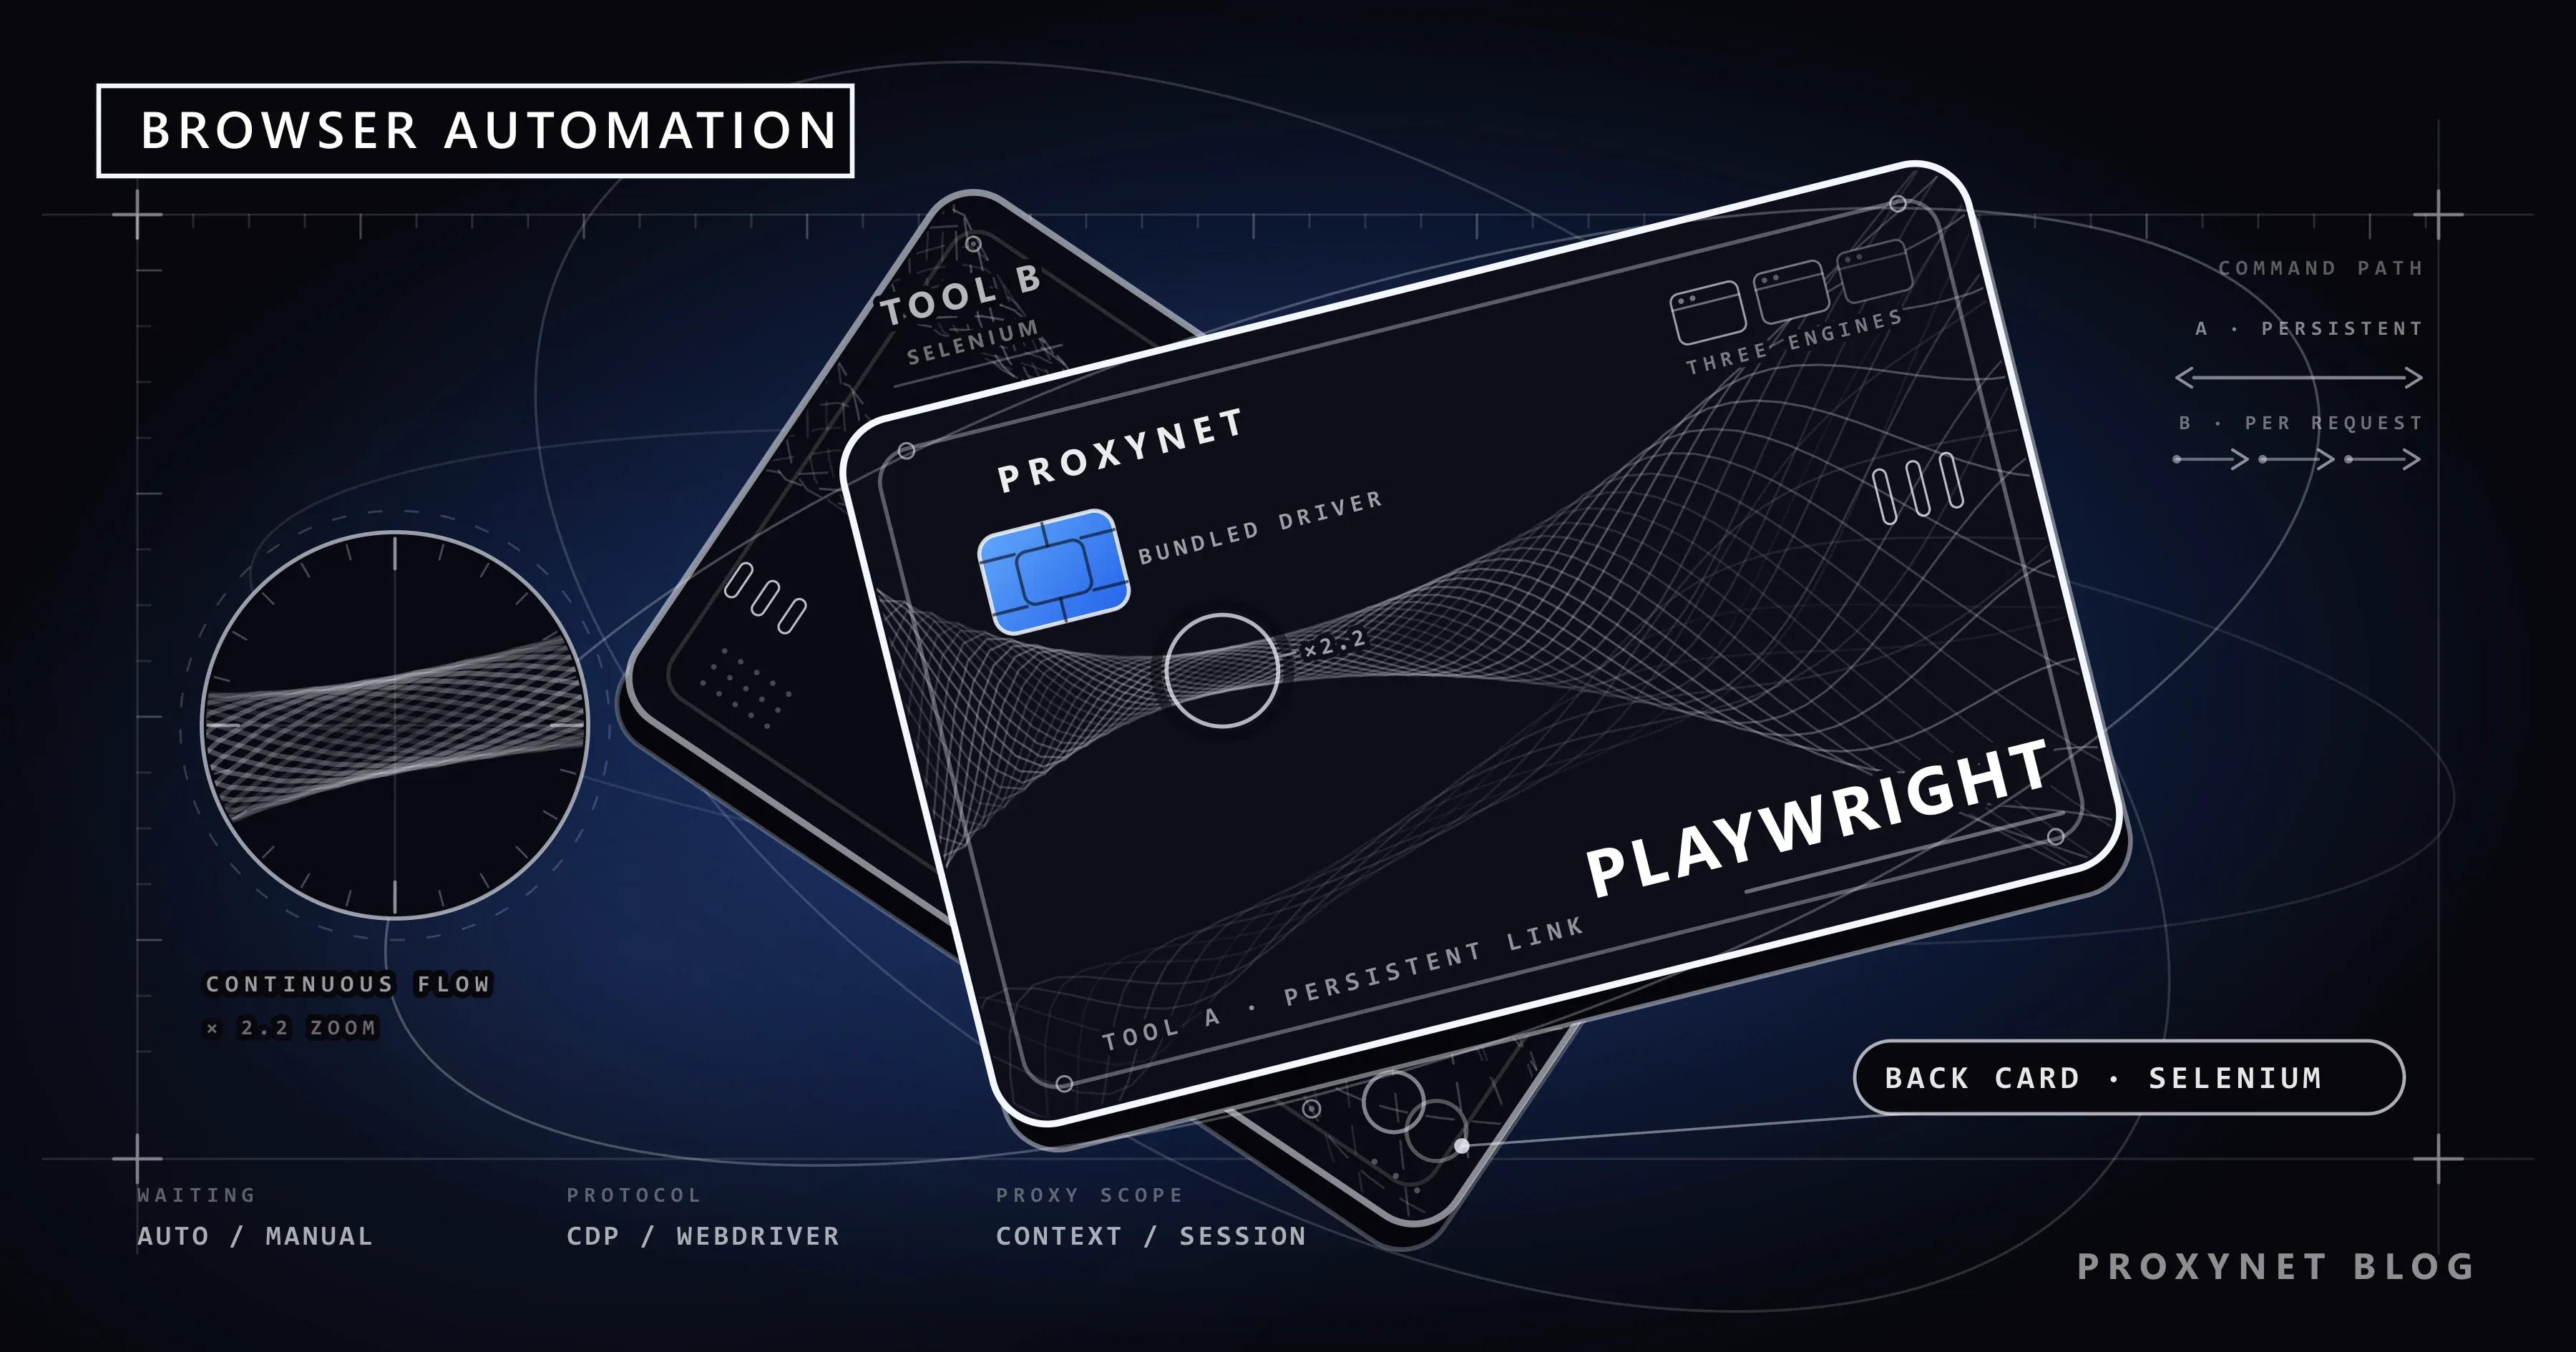
جدول مقایسه
| Playwright | Selenium | |
|---|---|---|
| پروتکل | اتصال پایدار؛ در Chromium همان CDP و در Firefox و WebKit ساختهای وصلهخورده | W3C WebDriver روی HTTP و در کنار آن WebDriver BiDi در حال شکلگیری روی WebSocket |
| لایه میانی | درایور Playwright جاسازیشده در بسته | درایور سازنده مرورگر (ChromeDriver و GeckoDriver) |
| مرورگرها | Chromium و Firefox و WebKit؛ با channel هم Chrome و Edge | Chrome و Edge و Firefox و Safari |
| زبانهای رسمی | JavaScript و TypeScript و Python و Java و .NET | Java و Python و C# و Ruby و JavaScript |
| انتظار | پیش از هر کنش، خودکار | خودتان مینویسید: WebDriverWait |
| دامنه پروکسی | برای هر مرورگر یا هر context | برای هر نشست مرورگر |
| نام کاربری و رمز پروکسی | فیلدهای جداگانه در شیء proxy | در استاندارد فیلدی نیست؛ راه عملی لیست سفید IP است |
| شنیدن و مسدود کردن درخواست | درونساخت (route و expect_response) | با BiDi میآید؛ در WebDriver کلاسیک نیست |
| نصب مرورگر | playwright install و ساختهای قفلشده به نسخه | Selenium Manager خودش درایور را دانلود و از مرورگر نصبشده استفاده میکند |
| موازیسازی | چند context در یک مرورگر | یک مرورگر برای هر کار؛ میان ماشینها Selenium Grid |
| اشکالزدایی | Trace Viewer و Inspector و codegen | تصویر صفحه، گزارش مرورگر، Selenium IDE |
یک کار یکسان با دو ابزار چگونه نوشته میشود؟
صفحه آزمایشی ما quotes.toscrape.com/js-delayed/ است: سایتی تمرینی که نقلقولها را با JavaScript و ده ثانیه تأخیر چاپ میکند. کار این است: صفحه را از راه پروکسی باز کن، نقلقولها را بخوان، روی پیوند «Next» کلیک کن و صفحه دوم را راستیآزمایی کن.
با Playwright:
from playwright.sync_api import sync_playwright

URL = "https://quotes.toscrape.com/js-delayed/"
PROXY = {
    "server": "http://pr.proxynet.io:8000",
    "username": "user",
    "password": "pass",
}

with sync_playwright() as p:
    browser = p.chromium.launch(proxy=PROXY)
    page = browser.new_page()
    page.goto(URL)
    quotes = page.locator("div.quote")
    print("immediately:", quotes.count())  # 0: count() does not wait
    quotes.first.wait_for()  # waits until the first quote is rendered
    for quote in quotes.all():
        text = quote.locator("span.text").inner_text()
        author = quote.locator("small.author").inner_text()
        print(author, "-", text[:50])
    page.get_by_role("link", name="Next").click()  # waits on its own before the click
    page.wait_for_url("**/page/2/")
    print(page.url)
    browser.close()
با Selenium:
from selenium import webdriver
from selenium.webdriver.common.by import By
from selenium.webdriver.support import expected_conditions as EC
from selenium.webdriver.support.ui import WebDriverWait

URL = "https://quotes.toscrape.com/js-delayed/"

options = webdriver.ChromeOptions()
options.add_argument("--headless=new")
# No username or password: your exit IP must be on the IP whitelist in the panel
options.add_argument("--proxy-server=http://pr.proxynet.io:8000")

driver = webdriver.Chrome(options=options)  # Selenium Manager finds the driver
try:
    driver.get(URL)
    print("immediately:", len(driver.find_elements(By.CSS_SELECTOR, "div.quote")))  # 0
    wait = WebDriverWait(driver, 15)
    quotes = wait.until(EC.presence_of_all_elements_located((By.CSS_SELECTOR, "div.quote")))
    for quote in quotes:
        text = quote.find_element(By.CSS_SELECTOR, "span.text").text
        author = quote.find_element(By.CSS_SELECTOR, "small.author").text
        print(author, "-", text[:50])
    wait.until(EC.element_to_be_clickable((By.PARTIAL_LINK_TEXT, "Next"))).click()
    wait.until(EC.url_contains("/page/2/"))
    print(driver.current_url)
finally:
    driver.quit()
هر دو اسکریپت از راه پروکسیهای آزمایشی محلی ما همان ده نقلقول را چاپ کردند و به نشانی /js-delayed/page/2/ رفتند. شمار سطرها به هم نزدیک است؛ تفاوت در جزئیات است. در Playwright اطلاعات ورود پروکسی درون کد است و در Selenium نیست؛ کلیک در Playwright یک سطر است و در Selenium شرط قابل کلیک بودن را دستی مینویسید. در هر دو اسکریپت سطر «immediately» مقدار 0 داد: صفحه بارگذاریشده به حساب میآید اما محتوا هنوز نیست. موضوع بخش بعدی همین است.
تفاوت انتظار خودکار با WebDriverWait چیست؟
در صفحههای پویا بیشتر خطاها از زمانبندی بیرون میآیند: کد سراغ عنصری میرود که JavaScript هنوز آن را چاپ نکرده است. سند انتظار Selenium این را وضعیت رقابتی مینامد؛ گاهی مرورگر زودتر آماده میشود و کد کار میکند، گاهی کد جلو میافتد و خطا میگیرید.
در Selenium راهحل در دست شماست. فراخوانی driver.get() منتظر رویداد load صفحه میماند، اما از محتوایی که بعداً با JavaScript افزوده میشود خبر ندارد. مقدار پیشفرض انتظار ضمنی صفر است؛ اگر عنصر نباشد خطا بیدرنگ برمیگردد. راه توصیهشده انتظار صریح است: WebDriverWait صفحه را میکاود تا شرطی درست شود. سند یک هشدار دیگر هم میدهد: این دو را با هم به کار نبرید، چون زمانها پیشبینیناپذیر میشوند.
Playwright همین کار را درون خود کنش میگذارد. بنا بر سند actionability، فراخوانی click() صبر میکند تا عنصر دیده شود، جای آن ثابت باشد، بتواند کلیک را بگیرد و فعال باشد؛ اگر این شرطها در مهلت مقرر برآورده نشوند، TimeoutError پرتاب میشود. فراخوانیهایی مانند fill() و inner_text() که با یک عنصر کار میکنند هم منتظر پدیدار شدن عنصر میمانند.
این کار مرزی دارد: انتظار خودکار برای کنشهاست، نه برای شمارش. در نمونه بالا quotes.count() بدون انتظار 0 برگرداند. سند API مربوط به Playwright همین یادداشت را برای locator.all() هم میگذارد: منتظر عنصرهای منطبق نمیماند و هرچه در آن لحظه روی صفحه باشد میدهد. اگر میخواهید فهرستی بخوانید، نخست با first.wait_for() منتظر عنصر اول بمانید. به همین دلیل جمله «در Playwright انتظار نوشته نمیشود» تنها نیمهدرست است.
تفاوت دوم در ارجاع به عنصر است. در Selenium فراخوانی find_element ارجاعی به گره DOM در همان لحظه برمیگرداند؛ اگر صفحه آن بخش را دوباره بکشد، ارجاع کهنه میشود و StaleElementReferenceException میگیرید. در Playwright یک locator توصیف است و در هر بار استفاده دوباره حل میشود؛ همان خطا کمتر دیده میشود. زبان انتخابگر در هر دو ابزار به خودتان واگذار شده است: انتخابگر CSS یا XPath: کدام برای اسکرپینگ؟.
مدیریت پروکسی چگونه تفاوت پیدا میکند؟
سمت Playwright را در نوشته خواهر شرح دادیم، اینجا خلاصه میکنیم: شیء proxy به فراخوانی launch() یا new_context() داده میشود، username و password فیلدهای جداگانهاند و در یک مرورگر هر context میتواند از IP دیگری بیرون برود. context کوکیها و حافظه و پروکسی را جدا میکند. چون مرورگر و ماشین همان میمانند، اثر انگشت مرورگر میان contextها تغییر نمیکند؛ context جداکننده نشست است، نه دستگاهی جداگانه.
در Selenium پروکسی یک قابلیت نشست است: هنگام آغاز مرورگر داده میشود و همه زبانههای آن مرورگر را میبندد؛ برای پروکسی دیگر با driver.quit() آن را میبندید و مرورگر تازهای باز میکنید. سمت احراز هویت اما در خود استاندارد کم است. تعریف پروکسی در W3C WebDriver کلیدهای httpProxy و sslProxy و socksProxy و socksVersion و noProxy را برمیشمارد؛ کلیدی برای نام کاربری یا رمز عبور وجود ندارد. نمونه رسمی Selenium هم تنها قالب <HOST:PORT> را نشان میدهد. استاندارد میگوید نشانی سرور میتواند اطلاعات ورود را حمل کند، اما سند پروکسی Chromium مینویسد که Chrome اطلاعات ورود جاسازیشده در تنظیم پروکسی را به کار نمیبرد.
اینکه این موضوع در عمل به چه میانجامد را با یک پروکسی محلی که احراز هویت میخواهد آزمودیم. نتیجهها به اجراهای یگانه روی همین دستگاه مربوطاند (Selenium 4.49 و Chrome 153):
| آنچه آزمودیم | آنچه رخ داد |
|---|---|
--proxy-server=http://server:port بدون اطلاعات ورود | پروکسی 407 برگرداند. driver.get() خطا پرتاب نکرد؛ صفحه خالی بود و driver.title خالی آمد |
--proxy-server=http://user:pass@server:port | Chrome صفحه خطای ERR_NO_SUPPORTED_PROXIES را باز کرد، باز هم بدون استثنا |
user:pass@server:port در شیء Proxy | صفحه باز شد، اما در گزارش پروکسی حتی یک درخواست ثبت نشد: مرورگر مستقیم و با IP خودمان وصل شد |
| درگاهی که احراز هویت نمیخواهد (معادل لیست سفید IP) | بدون مشکل کار کرد |
سطر سوم خطرناکترین است: اسکریپت به نظر کار میکند، حال آنکه ترافیک از پروکسی نمیگذرد. آرگومانی به نام --proxy-auth هم در Chrome وجود ندارد، هرچند در نوشتههای قدیمی دیده میشود. فراخوانی add_auth_handler در سمت BiDi مربوط به Selenium در مستندات برای احراز هویت Basic خود سایت توضیح داده شده است؛ برای پروکسی راه مستندی نیست و آزمون ما با پروکسی تعریفشده با پایان مهلت بارگذاری صفحه تمام شد.
به همین دلیل راهی که در Selenium پیشنهاد میکنیم لیست سفید IP است: IP خروجی سروری را که اسکریپت روی آن اجرا میشود در پنل به فهرست میافزایید و مقدار --proxy-server را بدون اطلاعات ورود میدهید. مقایسه این دو روش در نوشته احراز هویت پروکسی: نام کاربری و رمز یا لیست سفید IP و نحو پروکسی در SeleniumBase در نوشته پروکسی با SeleniumBase: احراز هویت و چرخش آمده است.
در همان اجراها مشاهده دیگری هم داشتیم: Chrome نصبشدهای که Selenium باز کرد، در کنار سایت مقصد به سرویسهای بهروزرسانی و حساب Google هم از راه پروکسی وصل شد؛ در ساخت Chromium خود Playwright تنها درخواستهای صفحه در گزارش پروکسی ثبت شدند. وقتی ترافیک را گیگابایتی میپردازید، مثلاً در پروکسی مسکونی، پی گرفتن این ترافیک پسزمینه از پنل ارزش دارد.
پشتیبانی از زبانها و زیستبوم
کتابخانههای رسمی Selenium برای Java و Python و C# و Ruby و JavaScript هستند. کتابخانههای Playwright برای JavaScript و TypeScript و Python و Java و .NET. اگر تیم Ruby باشید، انتخاب خودبهخود انجام شده است.
هرچند زبانها روی کاغذ همپوشانی دارند، مرکز ثقلها تفاوت میکند. Selenium پروژهای بیستساله است؛ بخش بزرگی از تیمهای آزمون سازمانی Selenium را با Java یا C# مینویسند، مجموعههایی با صدها سناریو بر پایه TestNG و JUnit و NUnit و Cucumber ساخته شدهاند و بازنویسی آنها معمولاً از آسانی Playwright گرانتر درمیآید. پختهترین چهره Playwright سمت Node.js است: اجراگر آزمون خودش با اجرای موازی، مقایسه تصویر صفحه و ضبط خودکار ردگیری میآید. در Python راه توصیهشده افزونه pytest است. جمعآوری داده با C# را در نوشته گرفتن داده از وبسایت با C#: HttpClient و پروکسی آوردهایم.
از دید اسکرپینگ، انتخاب زبان بیشتر وقتها جلوتر از انتخاب ابزار میایستد: اگر خطی که داده را پردازش میکند در Python باشد هر دو ابزار کار میکنند و اگر در Node.js باشد Playwright طبیعیتر مینشیند. مقایسه این دو زبان در نوشته اسکرپینگ وب: JavaScript یا Python؟ آمده است.
نصب مرورگر: Selenium Manager و playwright install
راهنماهای قدیمی Selenium میگویند ChromeDriver متناسب با نسخه Chrome خود را دستی دانلود کنید و مسیرش را با executable_path بدهید. هر دو پشت سر ماندهاند: در Selenium 4.49 فراخوانی webdriver.Chrome() تنها پارامترهای options و service و keep_alive را میپذیرد و یافتن درایور را از نسخه 4.6 به بعد Selenium Manager که همراه کتابخانه میآید انجام میدهد: نسخه مرورگر نصبشده را تشخیص میدهد، درایور متناسب را دانلود میکند و در پوشه ~/.cache/selenium نگه میدارد. در آزمون ما برای Chrome 153 نصبشده، ChromeDriver 153 را بدون هیچ گام اضافی دانلود کرد. بنا بر سند، اگر مرورگر نصب نباشد میتواند Chrome و Firefox و Edge را هم دانلود کند؛ این ابزار هنوز با شماره نسخه بتا عرضه میشود.
رویکرد Playwright وارونه است: به مرورگر سیستم اعتماد نمیکند. فرمان playwright install chromium ساخت خودش را دانلود میکند و هر نسخه Playwright به ساخت مشخصی از مرورگر قفل میشود. اگر کتابخانه را بهروز کنید و اجرای دوباره فرمان install را فراموش کنید، خطای «Executable doesn't exist» میگیرید؛ ما هم در آزمونهای این نوشته آن را گرفتیم.
داد و ستد چنین است: Selenium همان مرورگری را میراند که کاربران شما واقعاً به کار میبرند و خودش بهروز میشود، و این برای آزمون معنا دارد، اما با بهروزرسانی مرورگر رفتار میتواند تغییر کند. در Playwright نسخه مرورگر با کد قفل میشود؛ زمان بهروزرسانی را خودتان برمیگزینید.
کار موازی: Grid یا context؟
در Playwright واحد موازیسازی همان context است. یک فرایند مرورگر باز میشود و هر کار context خود و در صورت خواست پروکسی خود را میگیرد:
import asyncio

from playwright.async_api import async_playwright

URLS = [f"https://quotes.toscrape.com/js/page/{n}/" for n in range(1, 4)]
PROXY = {"server": "http://pr.proxynet.io:8000", "username": "user", "password": "pass"}


async def scrape(browser, url):
    context = await browser.new_context(proxy=PROXY)  # isolated session with its own proxy
    try:
        page = await context.new_page()
        await page.goto(url)
        quotes = page.locator("div.quote span.text")
        await quotes.first.wait_for()
        return url, await quotes.count()
    finally:
        await context.close()


async def main():
    async with async_playwright() as p:
        browser = await p.chromium.launch()  # a single browser process
        for url, count in await asyncio.gather(*(scrape(browser, u) for u in URLS)):
            print(url, count)
        await browser.close()


asyncio.run(main())
در Selenium واحد، خود مرورگر است. همین کار با استخر نخی نوشته میشود که برای هر کار یک درایور باز میکند:
from concurrent.futures import ThreadPoolExecutor

from selenium import webdriver
from selenium.webdriver.common.by import By
from selenium.webdriver.support import expected_conditions as EC
from selenium.webdriver.support.ui import WebDriverWait

URLS = [f"https://quotes.toscrape.com/js/page/{n}/" for n in range(1, 4)]


def scrape(url):
    options = webdriver.ChromeOptions()
    options.add_argument("--headless=new")
    options.add_argument("--proxy-server=http://pr.proxynet.io:8000")  # with an IP whitelist
    driver = webdriver.Chrome(options=options)  # one browser process per task
    try:
        driver.get(url)
        quotes = WebDriverWait(driver, 15).until(
            EC.presence_of_all_elements_located((By.CSS_SELECTOR, "div.quote span.text"))
        )
        return url, len(quotes)
    finally:
        driver.quit()


with ThreadPoolExecutor(max_workers=3) as pool:
    for url, count in pool.map(scrape, URLS):
        print(url, count)
هر دو اسکریپت از سه صفحه ده نقلقول برگرداندند. تفاوت در مصرف منابع است: در اولی یک مرورگر و در دومی سه مرورگر و سه فرایند درایور باز میشود. در بیست نشست همزمان این تفاوت مستقیم روی حافظه مینشیند. اینکه همروندی و موازیسازی در اسکرپینگ کی به کار میآیند در نوشته همروندی و موازیسازی در وب اسکرپینگ آمده است.
جایی که Selenium نیرومند است پخش میان ماشینهاست. Selenium Grid فرمانها را به مرورگرهای ماشینهای دور هدایت میکند؛ بنا بر سند رسمیاش هدفش اجرای موازی آزمونها روی بیش از یک ماشین است. راه انداختن ماتریس «Edge روی Windows و Safari روی macOS و Firefox روی Linux» از یک مجموعه واحد کار Grid است. Playwright برابر مستقیمی ندارد: پخش میان ماشینها را به سامانه CI شما وامیگذارد. توانایی اتصال به Grid هم در مستنداتش آزمایشی نشانهگذاری شده و تنها مرورگرهای مبتنی بر Chromium را در بر میگیرد.
ابزارهای اشکالزدایی
در این سرفصل Playwright آشکارا جلوتر است. ضبطی که با context.tracing.start(screenshots=True, snapshots=True) آغاز و با tracing.stop(path="trace.zip") تمام میشود، با فرمان playwright show-trace trace.zip باز میشود: تصویر DOM پیش و پس از هر کنش، درخواستهای شبکه و پیامهای کنسول روی یک خط زمان میایستند. پاسخ این پرسش که پویش شبانه چرا خالی برگشت را صبح از همین فایل میگیرید. PWDEBUG=1 هم Inspector را باز میکند و اسکریپت را گام به گام پیش میبرد و playwright codegen کاری را که در مرورگر میکنید به کد تبدیل میکند.
در Selenium ابزار همترازی به صورت یگانه وجود ندارد. با driver.save_screenshot() تصویر صفحه میگیرید و در Chrome قابلیت goog:loggingPrefs را روشن میکنید و با driver.get_log("browser") پیامهای کنسول را میخوانید؛ هر دو را آزمودیم و کار میکنند. نیاز ضبط و پخش را افزونه Selenium IDE برآورده میکند. شنیدن زنده درخواستهای شبکه با BiDi میآید، اما برای گزارشی که بعداً در آن میگردید به چارچوبهای گزارشدهی تکیه میکنید.
سرعت: چرا رقم نمیدهیم؟
بیشتر مقایسههای اینترنتی درصدی از جنس «Playwright اینقدر سریعتر است» با خود دارند؛ این رقمها روی دستگاه نویسنده و روی صفحه خود او گرفته شدهاند. معماری انتظاری به سود Playwright میسازد: به جای یک درخواست HTTP برای هر فرمان، یک اتصال باز؛ به جای مرورگر، context. اما در پویش واقعی که از پروکسی میگذرد، بخش بزرگ زمان در شبکه و در زمان پاسخ سایت مقصد میگذرد؛ در نمونه ما هر دو اسکریپت در سایه ده ثانیه تأخیر صفحه تمام شدند.
اگر میخواهید اندازه بگیرید، روی هدف خودتان و با همان پروکسی و همان همروندی، با نمونهای چند ده صفحهای اندازه بگیرید. در بیشتر پروژهها سود اصلی نه از عوض کردن ابزار، که از باز نکردن بیجهت مرورگر میآید.
کاربردها
- جمعآوری داده از صفحههای پویا: در پروژه تازه، شنیدن درخواست و مسدود کردن منابع در Playwright ترافیک را کم میکند؛ طرح کلی در صفحه راهکار جمعآوری داده آمده است.
- پویش منظم شمار زیادی صفحه: منطق صف و کشف به ابزار وابسته نیست؛ صفحه راهکار خزنده وب و نوشته صفحهبندی چیست و در اسکرپینگ چگونه پویش میشود؟ را ببینید.
- آزمون برنامه شما از کشورهای گوناگون: در Playwright یک context برای هر کشور و در Selenium یک نشست برای هر کشور؛ جزئیات در صفحه آزمون برنامه است.
- آزمون سازگاری میان مرورگرها: اگر Safari واقعی و ماتریس سیستمعامل لازم دارید، Selenium و Grid.
- پویش انبوه صفحههای مستقل: در هر دو ابزار با پروکسی چرخشی یک نشانی دروازه بس است؛ چرخش را خود دروازه انجام میدهد.
ابزار هرچه باشد چارچوب تغییر نمیکند: قواعد robots.txt و شرایط استفاده را رعایت کنید، اگر API رسمی هست از آن استفاده کنید و سرعت درخواست را در حدی نگه دارید که سایت تاب بیاورد. جزئیات در نوشته فایل robots.txt چیست و چگونه آن را بخوانیم؟ آمده است.
اشتباهات رایج
- جاسازی اطلاعات ورود در نشانی پروکسی در Selenium. Chrome آن را به کار نمیبرد؛ در آزمون ما نتیجه یا صفحه خطا بود یا اتصال مستقیم بدون پروکسی.
- فرض اینکه صفحه باز شده چون
driver.get()خطا نداد. Selenium کد وضعیت را نمیدهد؛ عنصری را که انتظار دارید و IP خروجی را راستیآزمایی کنید. - گمان اینکه
count()یاall()در Playwright منتظر میمانند. منتظر نمیمانند؛ نخستfirst.wait_for(). - حل کردن انتظار با
time.sleep(). هم کند است و هم شکننده؛ در Selenium ازWebDriverWaitو در Playwright از انتظار locator استفاده کنید. - درهم آمیختن انتظار ضمنی و صریح در Selenium. سند رسمی هشدار میدهد: زمانها پیشبینیناپذیر میشوند.
- فرا نخواندن
driver.quit()در Selenium. هر نشست بستهنشده یک فرایند Chrome و یک فرایند درایور جا میگذارد؛ ازtry/finallyاستفاده کنید. - کوچاندن مجموعه Selenium کارآمد تنها به خاطر مد روز. هزینه گذار در انتخابگرها نیست، در منطق انتظار و زیرساخت آزمون است.
- بهروز کردن Playwright و بهروز نکردن مرورگرها. هر نسخه ساخت خودش را میخواهد؛ گام
playwright installرا به ایمیج CI بیفزایید.
راهنمای انتخاب
| نیاز | پیشنهاد |
|---|---|
| پروژه اسکرپینگ تازه با Python یا Node.js | Playwright |
| پروکسی با نام کاربری و رمز عبور | Playwright؛ در Selenium به لیست سفید IP بروید |
| دهها نشست مستقل روی یک ماشین و IP جدا برای هر نشست | Playwright با پروکسی برای هر context |
| مجموعه آزمون Selenium کارآمد و نگهداریشده | در Selenium بمانید |
| تیم آزمون سازمانی با تکیه بر Java یا C# | هر دو میشود؛ چارچوب موجود و تجربه تعیین میکند |
| Ruby | Selenium |
| آزمون روی Safari واقعی و سیستمعاملهای گوناگون | Selenium و Grid |
| اشکالزدایی پسین در کارهای شبانه | Playwright و Trace Viewer |
| خواندن پاسخ شبکه و مسدود کردن تصویر و فونت | Playwright (درونساخت) |
| داده در کد منبع صفحه یا در نقطه پایانی JSON | هیچکدام: کلاینت ساده HTTP یا Scrapy |
پرسشهای متداول
آیا Playwright جای Selenium را میگیرد؟
در پروژههای تازه بارها نخستین انتخاب میشود، اما گفتن اینکه جای آن را گرفته درست نیست. Selenium پیادهسازی مرجع یک استاندارد W3C است، درایورهایش را سازندگان مرورگر مینویسند و ارتباط دوسویهای که کم بود از راه خود استاندارد با WebDriver BiDi افزوده میشود. هر دو پروژه فعالانه توسعه مییابند.
گذر از Selenium به Playwright دشوار است؟
انتخابگرها تا حد زیادی منتقل میشوند؛ CSS و XPath در هر دو کار میکنند. بخشی که زحمت میخواهد منطق انتظار است: بلوکهای WebDriverWait برداشته میشوند و جریانی بر پایه locator جایشان میآید؛ در سمت آزمون هم شیءهای صفحه و گزارشدهی و گامهای CI از نو برپا میشوند. اسکریپت کوچک در یک روز منتقل میشود؛ در مجموعهای با صدها سناریو کمخطرتر آن است که نخست سناریوهای تازه را با Playwright بنویسید و قدیمیها را سر جایشان بگذارید.
آیا هر دو را میتوان در یک پروژه با هم به کار برد؟
بله، به هم نمیپیچند. آرایش رایج آن است که مجموعه رگرسیون Selenium را نگه دارید و کارهای تازه را با Playwright بنویسید. نکتهای که باید مراقبش بود، اداره همزمان دو مدل جداگانه نصب مرورگر در ایمیج CI است.
آیا در Selenium پروکسی با نام کاربری و رمز عبور هیچ به کار نمیآید؟
از راه استاندارد نه: تعریف پروکسی در WebDriver فیلد اطلاعات ورود ندارد و Chrome هم اطلاعات جاسازیشده در نشانی را به کار نمیبرد. بستههای شخص ثالثی که یک پروکسی بازفرست محلی در میانه میگذارند این خلأ را پر میکنند، اما وابستگی تازهای میآورند. اگر از سروری با IP ثابت کار میکنید، لیست سفید IP هم سادهتر است و هم امنتر؛ رمز اصلاً در کد نمیآید.
آیا Selenium در Python از Playwright کندتر است؟
پاسخ عمومی وجود ندارد. معماری به سود Playwright است، اما در پویشی که از پروکسی میگذرد زمان را بیشتر شبکه و سایت مقصد تعیین میکنند. درصدهای منتشرشده را به کار خودتان منتقل نکنید؛ روی همان هدف و با همان پروکسی و همان همروندی خودتان اندازه بگیرید.
آیا این دو در حالت headless متفاوت رفتار میکنند؟
هر دو بدون پنجره کار میکنند. Playwright به صورت پیشفرض headless باز میشود و برای آن ساخت جداگانهای با نام «headless shell» دانلود میکند؛ برای دیدن پنجره launch(headless=False) مینویسید. Selenium به صورت پیشفرض با پنجره باز میشود و در Chrome با آرگومان --headless=new به حالت بیپنجره میرود. تنظیم پروکسی در هر دو حالت یکسان است.
خلاصه
Playwright و Selenium یک کار را از دو راه انجام میدهند. Selenium فرمانها را از راه W3C WebDriver به درایور سازنده مرورگر میفرستد؛ زبانهای بیشتر، Safari واقعی و پخش میان ماشینها با Grid را پوشش میدهد و انتظار و اطلاعات ورود پروکسی را به شما وامیگذارد. Playwright با مرورگر اتصالی پایدار برقرار میکند؛ خودش صبر میکند، پروکسی را با نام کاربری و رمز عبور برای هر context میگیرد، ترافیک شبکه را میشنود و با فایل ردگیری اشکالزدایی را آسان میکند. در پروژه تازه اسکرپینگ، Playwright با کد کمتر شما را پیش میبرد؛ اگر مجموعه Selenium کارآمدی دارید، بستن آن به پروکسی با لیست سفید IP بیشتر وقتها بس است. گونههای پروکسی که با هر دو ابزار میتوانید به کار ببرید در خدمات پروکسی ما آمدهاند.