Un cliente escribe «mi pedido nunca llegó» en el buscador de ayuda de una tienda, y el artículo que lo resuelve se titula «Seguimiento de un paquete extraviado». Una búsqueda por palabras clave no devuelve nada útil, porque los dos textos no comparten ninguna palabra con contenido propio. Una búsqueda semántica coloca ese artículo en primer lugar, porque las dos frases hablan del mismo problema.
Este artículo explica qué es la búsqueda semántica, cómo funciona desde el texto hasta los resultados ordenados, qué es un embedding, en qué se diferencia de la búsqueda por palabras clave y de la híbrida, qué hace una base de datos vectorial, qué cambia para el SEO y dónde falla.
¿Qué es la búsqueda semántica?
La búsqueda semántica es una forma de recuperar documentos según lo que significa una consulta y no según las palabras que contiene. «Semántico» significa simplemente «relativo al significado»: un motor semántico trata «vuelos baratos a Roma» y «tarifas aéreas económicas para Roma» como la misma petición, aunque solo compartan una palabra.
El enfoque anterior es la búsqueda por palabras clave, también llamada búsqueda léxica. El motor busca las palabras de la consulta en un índice invertido, una lista de qué documentos contienen qué palabras, y puntúa los documentos que las contienen. Es rápida y exacta, pero ciega al significado: una página que dice «automóvil» no aparece en una búsqueda de «auto» salvo que alguien haya añadido ese sinónimo a mano.
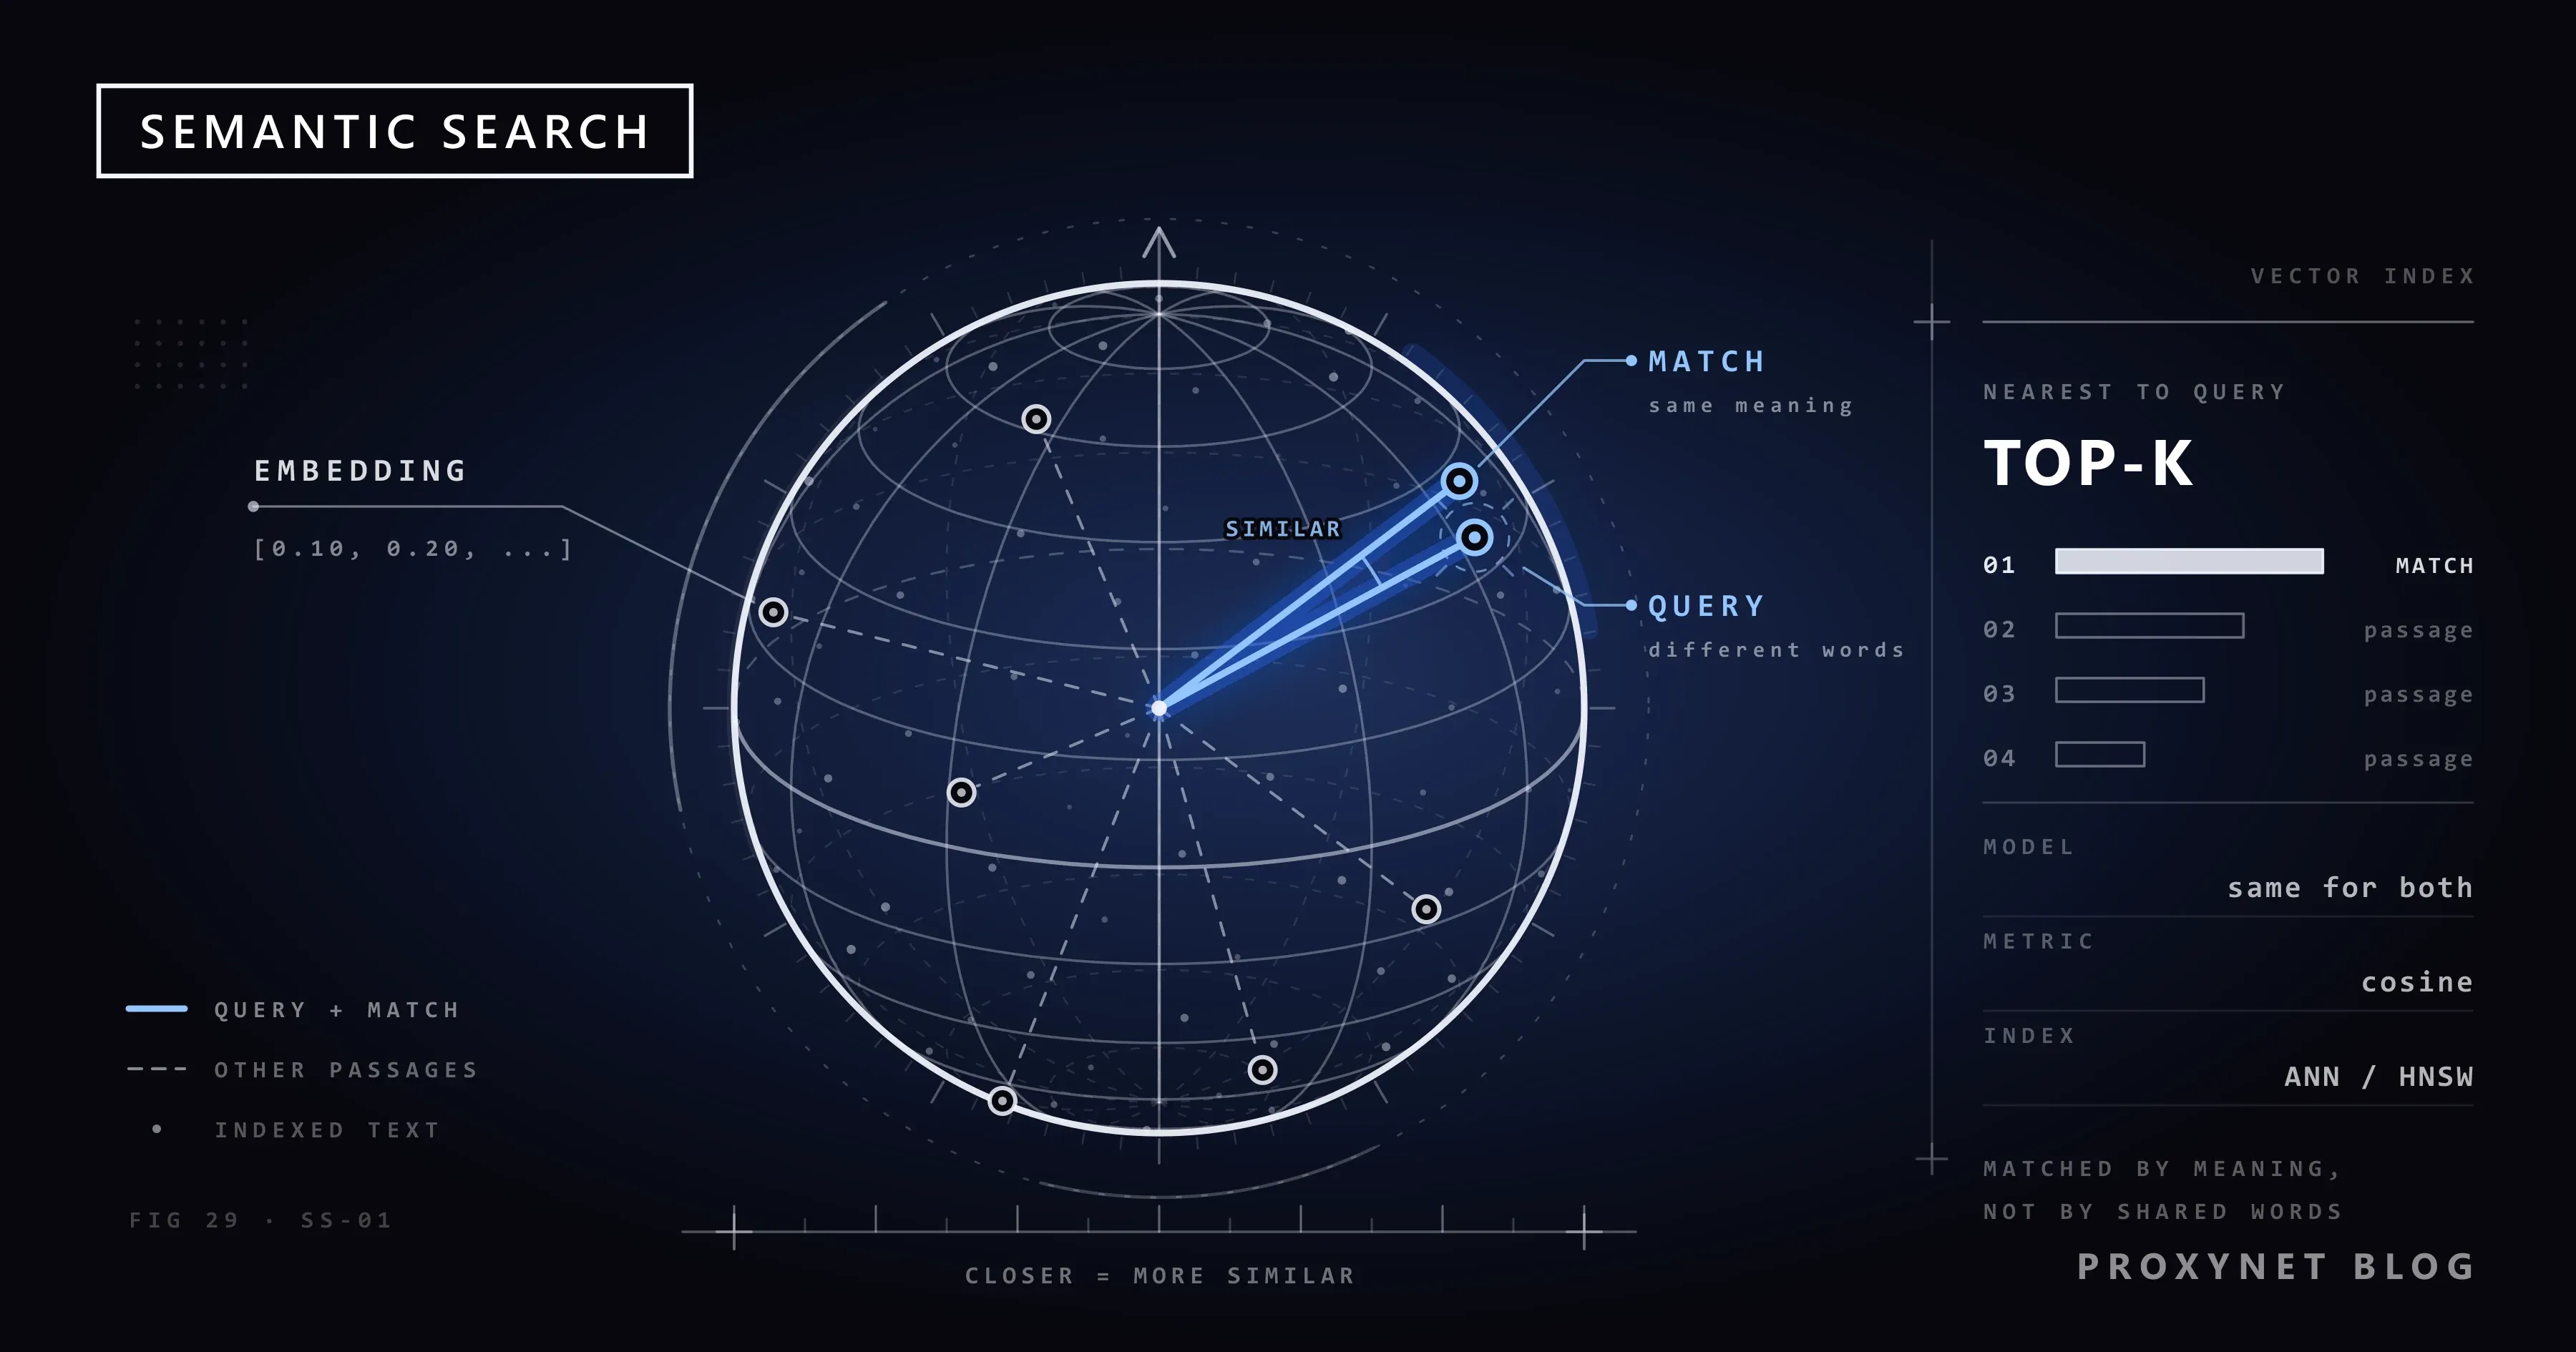
Hoy, «búsqueda semántica» casi siempre significa recuperación densa (dense retrieval): una red neuronal convierte los textos en vectores, es decir, en listas de números, y el motor los compara por su distancia.
¿Cómo funciona la búsqueda semántica?
La búsqueda semántica funciona en dos fases: de antemano convierte tus documentos en vectores y los guarda, y en cada consulta convierte la consulta en un vector y busca los vectores guardados más cercanos.
- Divide los documentos en pasajes. Un solo vector para una página larga mezcla sus temas, así que la mayoría de los sistemas indexa párrafos o secciones, cada uno con su título y su dirección de origen.
- Convierte cada pasaje en un embedding. Un modelo de embeddings, una red neuronal entrenada para esta tarea, lee el pasaje y devuelve una lista de números de longitud fija.
- Guarda los vectores en un índice, junto con el texto del pasaje y metadatos como la fecha, el idioma y quién puede verlo.
- Convierte la consulta con el mismo modelo. Un modelo distinto, o incluso otra versión del mismo, produce números que no se pueden comparar.
- Encuentra los vecinos más cercanos. El índice devuelve los vectores guardados más próximos al vector de la consulta; en colecciones grandes es una búsqueda aproximada que cede un poco de precisión a cambio de mucha velocidad.
- Ordena y filtra. Los resultados se ordenan por similitud, se filtran por metadatos (solo este idioma, solo los documentos que este usuario puede abrir) y se recortan a los 10 o 50 más parecidos.
- Reordena, si hace falta. Un reordenador es un modelo más lento que lee juntos la consulta y cada pasaje candidato. Es demasiado lento para toda la colección, así que solo reordena la lista corta.
¿Qué es un embedding?
Un embedding es una lista de números que representa un texto de modo que los textos con significados parecidos reciben números parecidos. El curso de aprendizaje automático de Google lo define como «una representación vectorial de datos en un espacio de embedding», en el que la distancia entre dos elementos puede leerse como una medida de cuánto se parecen; su lección sobre el espacio de embedding lo muestra con alimentos colocados a lo largo de dimensiones imaginarias.
Un ejemplo inventado hace concreta la idea. Supón que un modelo diminuto describe cada texto con tres números: cuánto trata de volar, cuánto de precio y cuánto de hoteles. Los modelos reales usan cientos o miles de números cuyas dimensiones no tienen nombre; las etiquetas de aquí solo sirven para hacer visible la idea.
| Texto | Vector ilustrativo | Distancia a la consulta |
|---|---|---|
| Consulta: «tarifas aéreas económicas Roma» | [0.85, 0.85, 0.05] | – |
| «vuelos baratos a Roma» | [0.90, 0.80, 0.10] | 0,09 |
| «volar a Roma por poco dinero» | [0.80, 0.90, 0.10] | 0,09 |
| «hoteles recomendados en Roma» | [0.10, 0.20, 0.90] | 1,31 |
La consulta solo comparte «Roma» con los tres textos, así que un motor de palabras clave no puede distinguirlos. En el espacio vectorial, los dos textos sobre vuelos quedan junto a la consulta y el de hoteles queda lejos, de modo que la búsqueda semántica pone primero los vuelos. La «distancia» es la distancia en línea recta de siempre entre dos puntos, solo que en tres dimensiones en lugar de dos.
Los modelos modernos además son contextuales: la misma palabra recibe números distintos según la frase que la rodea, así que «sentarse en un banco del parque» y «abrir una cuenta en el banco» caen en vecindarios diferentes.
Los embeddings de frases hicieron que esto fuera práctico. En el artículo de Sentence-BERT de 2019, Nils Reimers e Iryna Gurevych calcularon que encontrar el par más parecido entre 10.000 frases con BERT, que tiene que leer juntas las dos frases de cada par, llevaría unas 65 horas; con un embedding por frase comparado mediante la similitud del coseno, llevó unos 5 segundos. Todo motor semántico se apoya en esa separación: convertir los documentos una sola vez y, en el momento de la consulta, comparar vectores baratos.
Búsqueda semántica, por palabras clave e híbrida: ¿en qué se diferencian?
La búsqueda por palabras clave empareja las palabras de la consulta, la semántica empareja su significado y la híbrida ejecuta las dos y combina los resultados. La fórmula clásica de posicionamiento por palabras clave es BM25, del sistema Okapi presentado en la conferencia TREC-3 en 1994. Sube un documento en la clasificación cuando las palabras de la consulta aparecen en él con frecuencia y son raras en el resto de la colección, y corrige según la longitud del documento.
| Palabras clave (BM25) | Semántica (vectores) | Híbrida | |
|---|---|---|---|
| Empareja por | Palabras compartidas | Significado parecido | Ambos |
| Sinónimos y paráfrasis | Solo si están en una lista | Sí | Sí |
| Códigos y nombres exactos | Fuerte | Débil | Fuerte |
| Por qué coincidió un resultado | Visible | Difícil de explicar | En parte visible |
| Qué necesita | Un índice invertido | Un modelo y un índice vectorial | Ambos |
En preguntas escritas en lenguaje natural, la recuperación densa gana con claridad. En el artículo de Dense Passage Retrieval de 2020, un recuperador entrenado con pares de pregunta y pasaje encontró un pasaje con la respuesta entre sus 20 primeros resultados entre 9 y 19 puntos porcentuales más a menudo que un sistema BM25 sólido, según el conjunto de datos.
La búsqueda híbrida existe porque cada método falla donde el otro funciona. La forma habitual de combinar las dos listas es la fusión de rangos recíprocos (reciprocal rank fusion, RRF), de un artículo presentado en SIGIR en 2009 por Gordon Cormack y sus colegas: un documento recibe 1/(60 + su posición) de cada lista en la que aparece, y las sumas fijan el orden final. Un pasaje que queda primero por palabras clave y tercero por vectores suma unos 0,0323 y supera a otro que solo una lista puso primero, con unos 0,0164. Como RRF usa solo posiciones, nunca hay que comparar las puntuaciones incompatibles de los dos sistemas.
¿Qué es una base de datos vectorial?
Una base de datos vectorial es una base de datos creada para guardar embeddings y encontrar rápido los más cercanos a un vector dado. Para cada elemento guarda el vector, el texto original o un puntero a él, y metadatos como la dirección, la fecha, el idioma o los permisos de acceso, para que los resultados puedan filtrarse y mostrarse.
Hace falta porque comparar una consulta con cada vector guardado, lo que se llama búsqueda exacta o por fuerza bruta, se vuelve lento cuando la colección crece hasta millones de elementos. En su lugar, las bases de datos vectoriales construyen un índice de vecinos más cercanos aproximados (ANN, approximate nearest neighbour). Uno muy común es HNSW (hierarchical navigable small world), un grafo por capas en el que la búsqueda salta de vecino en vecino hacia la consulta y examina solo una pequeña parte de la colección. «Aproximado» significa que de vez en cuando puede pasar por alto uno de los vectores realmente más cercanos a cambio de una respuesta mucho más rápida.
La búsqueda vectorial aparece en cuatro formas habituales, y lo que ya usas suele decidir entre ellas:
- Bases de datos vectoriales dedicadas: sistemas creados solo para esta tarea, con índices ANN, filtros por metadatos y replicación.
- Soporte vectorial en una base de datos que ya usas: pgvector, por ejemplo, añade búsqueda por similitud vectorial a PostgreSQL. Busca de forma exacta por defecto y pasa a la búsqueda aproximada cuando añades un índice HNSW o IVFFlat.
- Motores de búsqueda con campos vectoriales: motores de búsqueda por palabras clave que también guardan vectores, de modo que una consulta híbrida se ejecuta en un solo sistema.
- Bibliotecas dentro de tu programa: Faiss, una biblioteca con licencia MIT desarrollada sobre todo en el grupo de investigación en IA de Meta, construye índices vectoriales y busca en ellos en memoria, sin servidor.
Un índice está tan al día como los documentos que tiene detrás. Las páginas cambian, así que hay que descargarlas y convertirlas de nuevo en embeddings de forma periódica, que es el trabajo de un rastreador web cuando los documentos están en la web.
¿Dónde te encuentras con la búsqueda semántica?
- Búsqueda de Google: Google dice que sus sistemas emparejan el significado de las consultas y las páginas, no solo sus palabras.
- Buscadores de sitios y centros de ayuda: «mi pedido nunca llegó» encuentra el artículo sobre envíos extraviados.
- Chatbots y asistentes de IA: en RAG (generación aumentada por recuperación), la búsqueda semántica encuentra los pasajes a partir de los que responde el modelo.
- Tiendas en línea: «zapatos para estar de pie todo el día» encuentra calzado de trabajo cuyos títulos nunca usan esa frase.
La búsqueda semántica sobre contenido web necesita primero las páginas. Tu propio centro de ayuda es fácil de indexar; un asistente que responde a partir de fuentes públicas, como documentación de productos o precios de muchas tiendas, tiene que recopilar esas páginas, extraer el texto legible y volver a descargarlo cuando cambia. Algunas páginas también varían según el país del visitante, así que la copia que indexas debería venir del mercado en el que están tus usuarios, por ejemplo a través de un proxy en ese país. La parte de la recopilación se trata en Web scraping para RAG: de HTML a fragmentos Markdown limpios.
¿Qué cambia la búsqueda semántica para el SEO?
Para el SEO, la búsqueda semántica significa que Google empareja el significado de una consulta con el de una página, así que una página puede posicionarse por formulaciones que nunca usa, y repetir variantes de una palabra clave no aporta nada. Google describió el cambio en 2019, cuando dijo que BERT le ayudaba a entender mejor una de cada 10 búsquedas en inglés en Estados Unidos; en uno de sus ejemplos, la palabra «to» de «2019 brazil traveler to usa need a visa» decide en qué dirección viaja la persona.
La guía sobre los sistemas de posicionamiento de la Búsqueda de Google describe tres sistemas de este tipo. BERT permite entender «cómo las combinaciones de palabras pueden expresar diferentes significados e intenciones»; la coincidencia neuronal sirve para comprender «representaciones de conceptos en consultas y páginas» y relacionarlas entre sí; RankBrain muestra contenido relevante aunque no contenga exactamente todas las palabras utilizadas en la búsqueda. Google no publica cómo están construidos, así que toma como conjeturas las afirmaciones sobre «los vectores de Google».
La guía de SEO para principiantes saca la conclusión práctica: los sistemas de coincidencia de idiomas de Google «pueden entender cómo se relaciona tu página con muchas consultas», y no necesitas prever todas las variaciones de una búsqueda. Eso sí, las palabras clave no han desaparecido: Google sigue considerando «el indicio más básico» de relevancia que el contenido incluya las palabras clave de la consulta.
- Escribe una página completa por tema e intención de búsqueda, no una página pobre por cada variante de palabra clave.
- Responde a la pregunta pronto y con claridad, como la formulan los lectores, y luego cubre sus preguntas siguientes.
- Usa los nombres exactos que usan tus lectores para productos, códigos de error y lugares; emparejar por significado no sustituye a una coincidencia exacta con un código.
- Olvídate de los trucos. El exceso de palabras clave, el texto oculto y las páginas producidas en masa para cubrir formulaciones figuran en las políticas de spam de Google.
¿Dónde falla la búsqueda semántica?
La búsqueda semántica falla donde la cadena exacta importa más que el significado: códigos de producto, números de pieza, códigos de error, nombres y cifras. Para un modelo de embeddings, «error 0x80070005» y «error 0x80070057» pueden quedar muy cerca porque son el mismo tipo de cosa, pero quien escribió uno quiere exactamente ese.
- Nombres raros y palabras nuevas: un modelo entrenado antes del lanzamiento de un producto nunca ha visto su nombre.
- Negaciones y límites: «portátiles sin pantalla táctil» puede poner arriba portátiles con pantalla táctil, porque el texto trata de pantallas táctiles. Precios, fechas y tamaños funcionan mejor como filtros.
- No hay resultado vacío: los vecinos más cercanos siempre existen, así que una pregunta que tus documentos no pueden responder igualmente devuelve los pasajes «más cercanos». Sin un umbral de similitud, un asistente responde a partir de algo irrelevante.
- Idiomas y jerga: un modelo entrenado sobre todo con inglés general puede rendir peor en español o con términos especializados; pruébalo con tus propias consultas.
La solución habitual para los tres primeros problemas es la búsqueda híbrida: un índice de palabras clave para coincidencias exactas y filtros, y vectores para las paráfrasis.
Errores comunes
- Mezclar modelos de embeddings. Las consultas y los documentos convertidos con modelos o versiones distintos no se pueden comparar; un modelo nuevo obliga a convertirlo todo de nuevo.
- Un vector por página larga. La media de diez temas no encaja bien con ninguno. Indexa pasajes.
- Eliminar la búsqueda por palabras clave. Los usuarios siguen pegando números de pedido, códigos de error y nombres.
- No tener un conjunto de prueba. Guarda unas cuantas docenas de consultas reales con el resultado que debería devolver cada una y revisa los 10 primeros después de cada cambio.
- Dejar los permisos fuera del índice. Si los permisos de acceso no se filtran con cada pasaje, el índice entrega documentos internos a las personas equivocadas.
- Indexar lo que no puedes usar. Las páginas cuyos términos prohíben la reutilización, o las que están llenas de datos personales protegidos por el RGPD o la KVKK de Türkiye, no pasan a ser de libre uso por haberse convertido en vectores.
Guía de decisión
| Tu situación | Qué usar |
|---|---|
| Los usuarios buscan por código de producto, SKU o nombre | Búsqueda por palabras clave con lista de sinónimos |
| Los usuarios preguntan con sus propias palabras | Búsqueda semántica con un modelo de embeddings |
| Los dos tipos de consulta | Búsqueda híbrida combinada con fusión de rangos |
| Unos pocos miles de pasajes | Búsqueda exacta en memoria o en tu base de datos actual |
| Millones de pasajes con filtros | Un índice ANN en una base de datos vectorial o un motor de búsqueda |
| Un chatbot que debe citar fuentes | Recuperación híbrida, un reordenador y una dirección de origen por pasaje |
| Una página que no aparece en Google para formulaciones relacionadas | Una página completa por tema e intención |
| Respuestas sacadas de páginas web públicas | Recopilar y actualizar las páginas antes de indexarlas |
Preguntas frecuentes
¿La búsqueda semántica es lo mismo que la búsqueda vectorial?
No exactamente. La búsqueda semántica es el objetivo: encontrar resultados por significado. La búsqueda vectorial es la técnica habitual para lograrlo: encontrar los vectores más cercanos en un índice. La búsqueda vectorial también puede comparar imágenes o sonidos, y una búsqueda semántica rudimentaria puede construirse sin vectores, con listas de sinónimos y reescritura de consultas.
¿Qué diferencia hay entre la búsqueda semántica y RAG?
La búsqueda semántica encuentra y ordena pasajes. RAG coloca los pasajes que devolvió una búsqueda en el prompt de un modelo de lenguaje y hace que el modelo escriba una respuesta a partir de ellos, así que la búsqueda semántica suele ser el paso de recuperación dentro de RAG. Los agentes de investigación con IA ejecutan muchas de estas búsquedas en bucle, como explica nuestra guía sobre deep research.
¿Qué es la similitud del coseno en la búsqueda semántica?
La similitud del coseno mide el ángulo entre dos vectores: 1 significa que apuntan en la misma dirección, y los valores cercanos a 0 significan que los textos tienen poco en común. No tiene en cuenta la longitud, así que un texto largo y uno corto sobre el mismo tema pueden puntuar cerca de 1. En el ejemplo anterior, los dos textos sobre vuelos obtienen 0,997 frente a la consulta y el de hoteles, 0,269.
¿En qué se diferencia una base de datos vectorial de una relacional?
Una base de datos relacional encuentra las filas que cumplen una condición exacta, como un precio inferior a 50, y no devuelve nada cuando ninguna fila la cumple. Una base de datos vectorial encuentra los elementos más parecidos a un vector dado y siempre devuelve los más cercanos. Muchos sistemas usan las dos: filtros relacionales y ordenación vectorial.
¿Necesito una base de datos vectorial para la búsqueda semántica?
No siempre. Para unos pocos miles de pasajes suele bastar una búsqueda exacta en memoria o una extensión vectorial como pgvector en una base de datos que ya tienes en marcha. Una base de datos vectorial dedicada compensa con millones de vectores, actualizaciones frecuentes, filtros estrictos o varias aplicaciones que comparten un índice.
¿Qué es el SEO semántico?
El SEO semántico es un nombre del sector para escribir páginas en torno a temas, entidades e intención de búsqueda en lugar de palabras clave sueltas. Se deriva de lo que dice Google sobre cómo empareja el significado: responde a la pregunta por completo, usa las palabras de tus lectores y deja que una buena página cubra las variantes de una consulta.
En resumen
La búsqueda semántica encuentra resultados por significado: un modelo convierte pasajes y consultas en embeddings, un índice encuentra los pasajes más cercanos a la consulta y un reordenador opcional afina el orden. Supera a la búsqueda por palabras clave en paráfrasis y preguntas naturales y pierde en códigos, nombres y números exactos, por eso la búsqueda híbrida con fusión de rangos es una elección habitual en producción. Para el SEO, las propias guías de Google apuntan a páginas completas por tema e intención en lugar de variantes de palabras clave. Cuando el índice se construye con páginas web públicas, recopilarlas es la parte difícil; nuestra Web Scraping API, un servicio de extracción gestionada de páginas disponible a través del equipo de ventas, se describe en la página de extracción de datos.