Eine Kundin tippt „meine Bestellung ist nie angekommen“ in die Hilfesuche eines Onlineshops, und der Artikel, der genau das beantwortet, heißt „Verlorene Pakete nachverfolgen“. Eine Keyword-Suche liefert nichts Brauchbares, weil die beiden Texte kein inhaltstragendes Wort gemeinsam haben. Eine semantische Suche setzt diesen Artikel an die erste Stelle, weil beide Sätze vom selben Problem handeln.
Dieser Beitrag erklärt, was semantische Suche ist, wie sie vom Text bis zur sortierten Ergebnisliste funktioniert, was ein Embedding ist, wie sie sich von Keyword- und hybrider Suche unterscheidet, was eine Vektordatenbank leistet, was sich für SEO ändert und wo sie versagt.
Was ist semantische Suche?
Semantische Suche ist eine Art, Dokumente danach zu finden, was eine Anfrage bedeutet, und nicht danach, welche Wörter sie enthält. „Semantisch“ heißt einfach „die Bedeutung betreffend“: Eine semantische Suchmaschine behandelt „günstige Flüge nach Rom“ und „Billigairlines mit Ziel Rom“ als dieselbe Anfrage, obwohl sie nur ein Wort gemeinsam haben.
Der ältere Ansatz ist die Keyword-Suche, auch lexikalische Suche genannt. Die Suchmaschine schlägt die Wörter der Anfrage in einem invertierten Index nach, einer Liste, welche Dokumente welche Wörter enthalten, und bewertet die Dokumente, in denen sie vorkommen. Das ist schnell und exakt, aber blind für Bedeutung: Eine Seite, auf der „Automobil“ steht, passt nicht zur Suche nach „Auto“, solange niemand dieses Synonym von Hand hinterlegt hat.
Heute meint „semantische Suche“ fast immer Dense Retrieval, den Abruf über dichte Vektoren: Ein neuronales Netz verwandelt Texte in Vektoren, also Listen von Zahlen, und die Suchmaschine vergleicht sie über ihren Abstand.
Wie funktioniert semantische Suche?
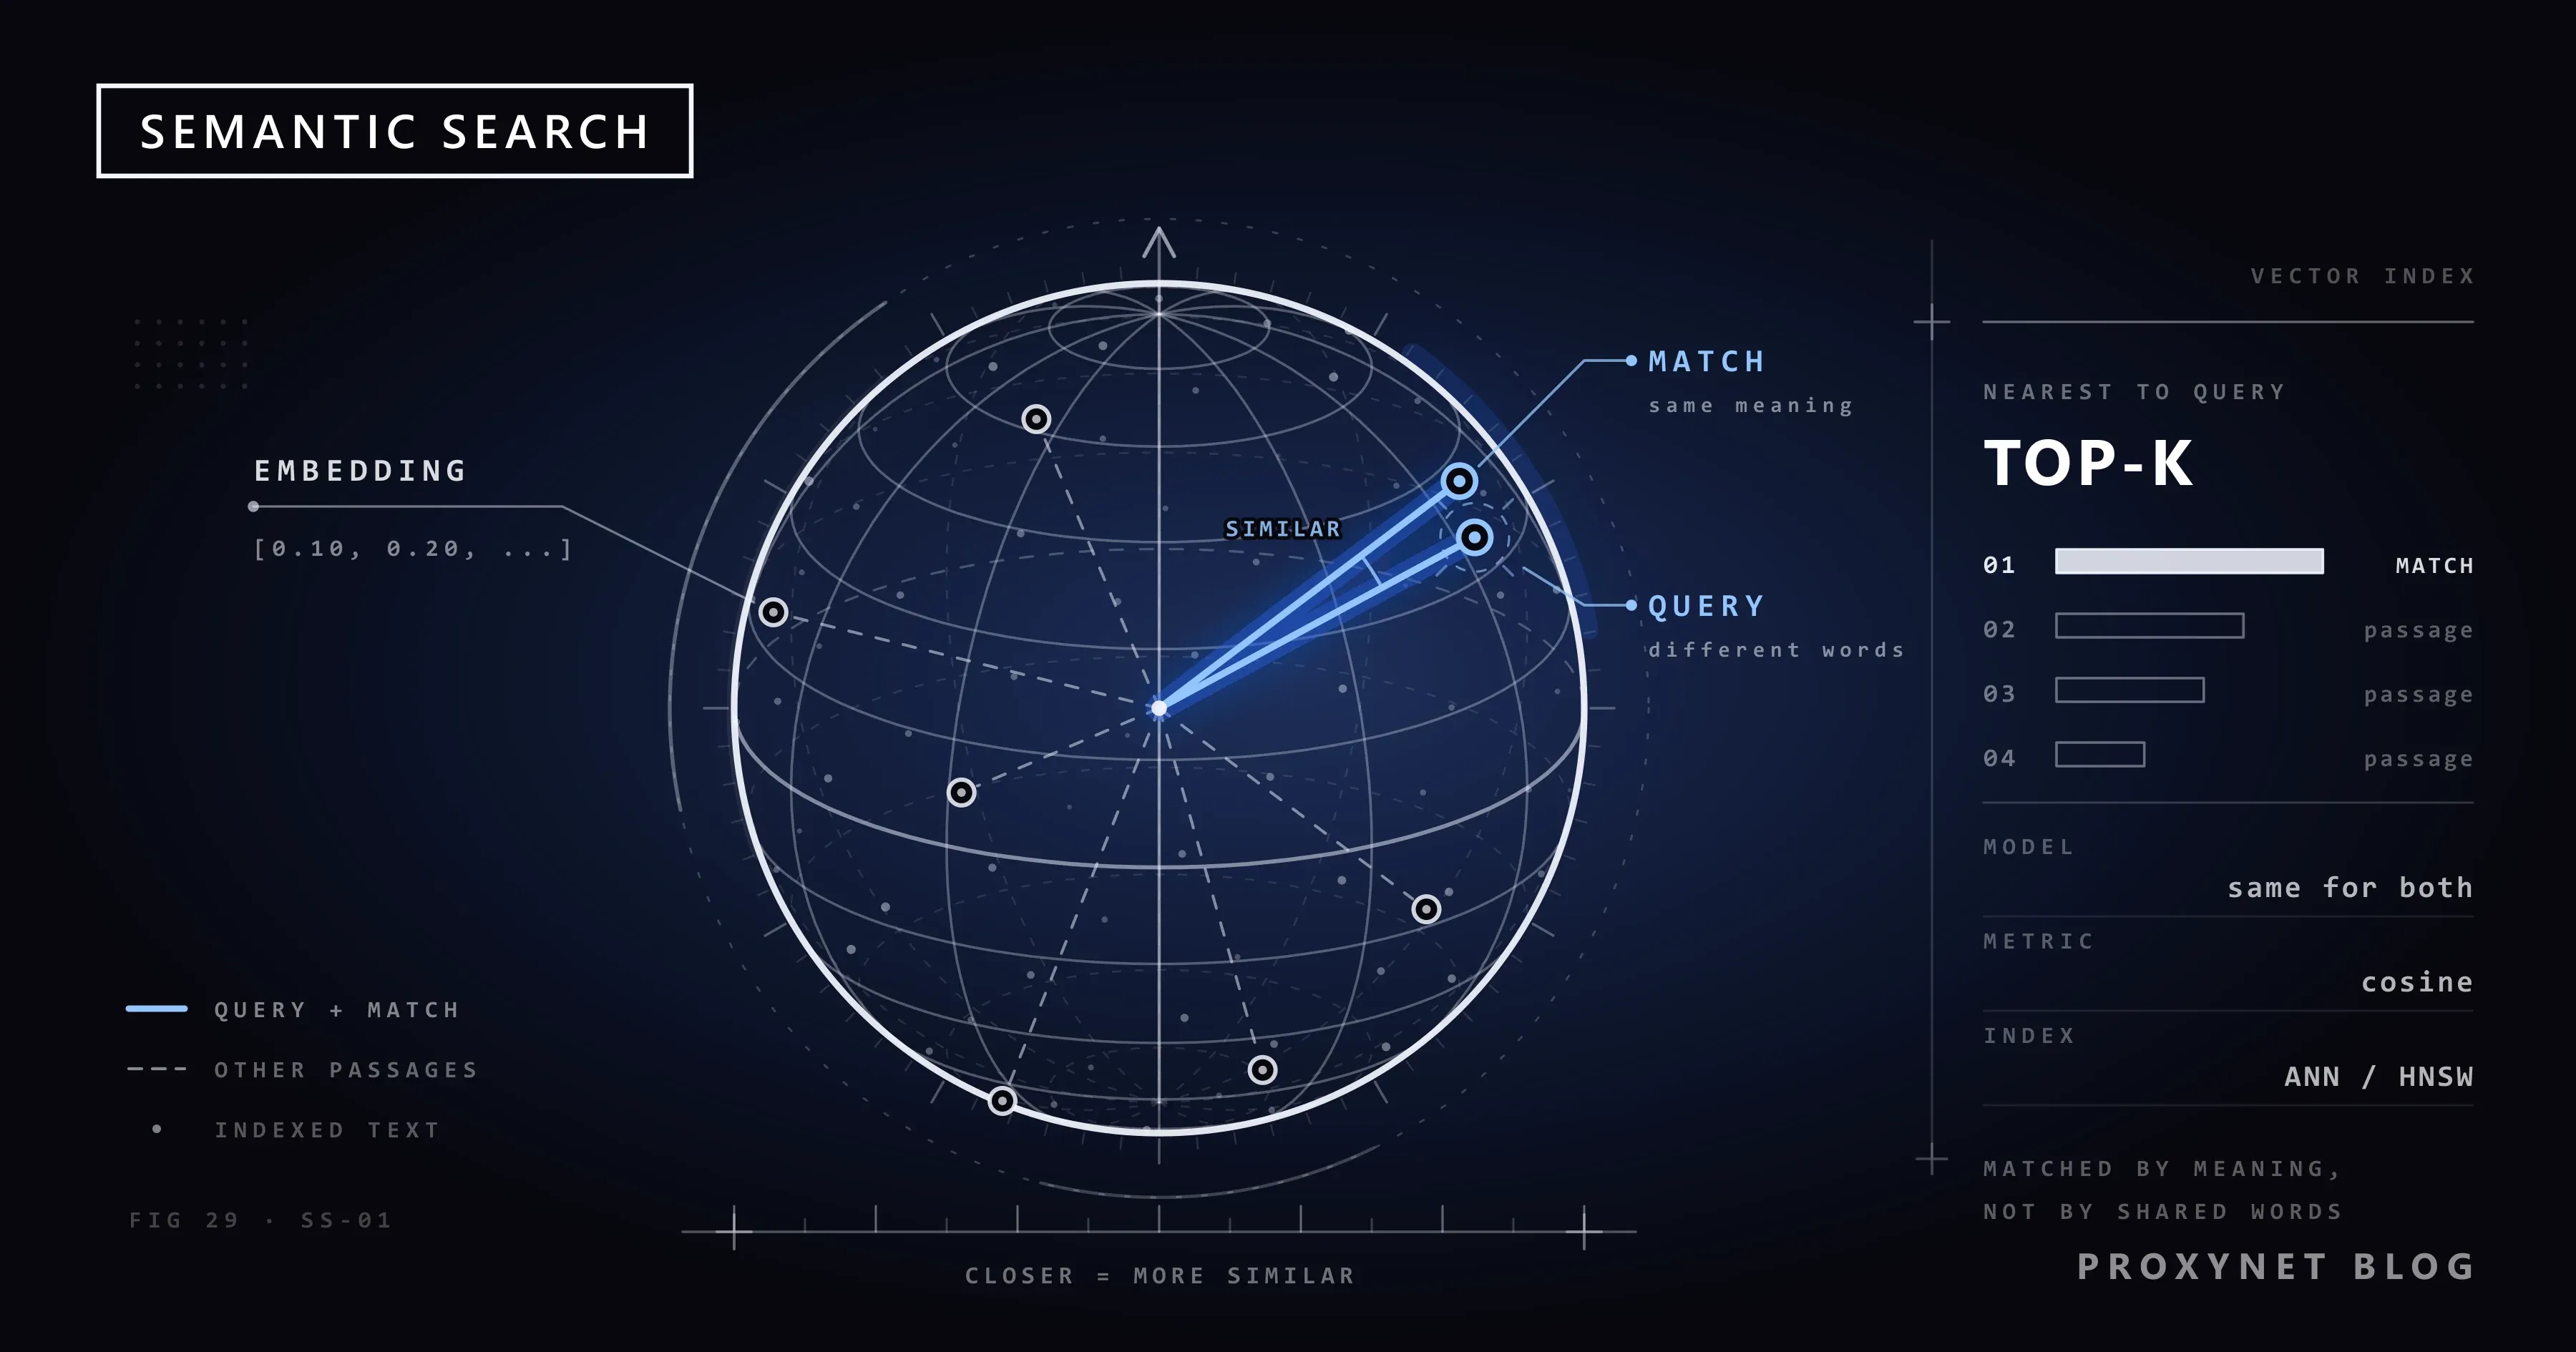
Semantische Suche arbeitet in zwei Phasen: Vorab verwandelt sie Ihre Dokumente in Vektoren und speichert sie, und bei jeder Anfrage verwandelt sie die Anfrage in einen Vektor und sucht die nächstgelegenen gespeicherten Vektoren.
- Zerlegen Sie die Dokumente in Passagen. Ein einziger Vektor für eine lange Seite verwischt ihre Themen, deshalb indexieren die meisten Systeme Absätze oder Abschnitte, jeweils mit Titel und Quelladresse.
- Verwandeln Sie jede Passage in ein Embedding. Ein Embedding-Modell, ein für diese Aufgabe trainiertes neuronales Netz, liest die Passage und gibt eine Zahlenliste fester Länge aus.
- Speichern Sie die Vektoren in einem Index, zusammen mit dem Passagentext und Metadaten wie Datum, Sprache und der Angabe, wer die Passage sehen darf.
- Betten Sie die Anfrage mit demselben Modell ein. Ein anderes Modell, ja schon eine andere Version desselben Modells, erzeugt Zahlen, die sich nicht vergleichen lassen.
- Finden Sie die nächsten Nachbarn. Der Index liefert die gespeicherten Vektoren, die dem Anfragevektor am nächsten liegen; bei großen Sammlungen ist das eine approximative Suche, die ein wenig Genauigkeit gegen viel Geschwindigkeit eintauscht.
- Sortieren und filtern Sie. Die Ergebnisse werden nach Ähnlichkeit geordnet, nach Metadaten gefiltert (nur diese Sprache, nur Dokumente, die dieser Nutzer öffnen darf) und auf die 10 oder 50 ähnlichsten gekürzt.
- Ordnen Sie bei Bedarf neu. Ein Reranker ist ein langsameres Modell, das die Anfrage und jede Kandidatenpassage gemeinsam liest. Für die ganze Sammlung ist er zu langsam, deshalb ordnet er nur die kurze Liste neu.
Was ist ein Embedding?
Ein Embedding (deutsch auch Einbettung) ist eine Liste von Zahlen, die ein Textstück so darstellt, dass Texte mit ähnlicher Bedeutung ähnliche Zahlen erhalten. Der Machine-Learning-Crashkurs von Google beschreibt es als Vektordarstellung von Daten in einem Embedding-Raum, in dem sich der Abstand zwischen zwei Elementen als Maß für ihre Ähnlichkeit lesen lässt; seine Lektion zum Embedding-Raum zeigt das an Lebensmitteln, die entlang gedachter Dimensionen angeordnet sind.
Ein erfundenes Beispiel macht die Idee greifbar. Angenommen, ein winziges Modell beschreibt jeden Text mit drei Zahlen: wie sehr er vom Fliegen handelt, wie sehr vom Preis und wie sehr von Hotels. Echte Modelle verwenden Hunderte oder Tausende Zahlen, deren Dimensionen keine Namen haben; die Bezeichnungen hier machen die Idee nur sichtbar.
| Text | Vektor zur Veranschaulichung | Abstand zur Anfrage |
|---|---|---|
| Anfrage: „preiswerte Luftreise Rom“ | [0.85, 0.85, 0.05] | – |
| „günstige Flüge nach Rom“ | [0.90, 0.80, 0.10] | 0,09 |
| „billig nach Rom fliegen“ | [0.80, 0.90, 0.10] | 0,09 |
| „empfehlenswerte Hotels in Rom“ | [0.10, 0.20, 0.90] | 1,31 |
Die Anfrage teilt mit allen drei Texten nur das Wort „Rom“, deshalb kann eine Keyword-Suchmaschine sie nicht auseinanderhalten. Im Vektorraum liegen die beiden Flugtexte direkt neben der Anfrage und der Hoteltext weit entfernt, also stellt die semantische Suche die Flüge nach vorn. „Abstand“ ist hier der gewöhnliche geradlinige Abstand zwischen zwei Punkten, nur in drei statt in zwei Dimensionen.
Moderne Modelle sind außerdem kontextabhängig: Dasselbe Wort erhält je nach umgebendem Satz andere Zahlen, sodass „sich auf eine Bank im Park setzen“ und „ein Konto bei der Bank eröffnen“ in verschiedenen Nachbarschaften landen.
Satz-Embeddings haben das praktikabel gemacht. Im Sentence-BERT-Paper von 2019 rechneten Nils Reimers und Iryna Gurevych vor, dass es mit BERT, das jedes Paar gemeinsam lesen muss, etwa 65 Stunden dauern würde, unter 10.000 Sätzen das ähnlichste Paar zu finden; mit einem Embedding pro Satz, verglichen über die Kosinus-Ähnlichkeit, dauerte es etwa 5 Sekunden. Jede semantische Suchmaschine beruht auf dieser Trennung: Dokumente einmal einbetten, zur Anfragezeit nur günstige Vektoren vergleichen.
Semantische, Keyword- und hybride Suche: Was ist der Unterschied?
Die Keyword-Suche gleicht die Wörter der Anfrage ab, die semantische Suche ihre Bedeutung, und die hybride Suche nutzt beide und vereint die Ergebnislisten. Die klassische Ranking-Formel der Keyword-Suche ist BM25 aus dem Okapi-System, das 1994 auf der Konferenz TREC-3 vorgestellt wurde. Sie stuft ein Dokument höher ein, wenn die Wörter der Anfrage darin häufig und im Rest der Sammlung selten vorkommen, und gleicht die Dokumentlänge aus.
| Keyword (BM25) | Semantisch (Vektoren) | Hybrid | |
|---|---|---|---|
| Abgleich über | Gemeinsame Wörter | Ähnliche Bedeutung | Beides |
| Synonyme und Umschreibungen | Nur wenn hinterlegt | Ja | Ja |
| Exakte Codes und Namen | Stark | Schwach | Stark |
| Warum ein Treffer passt | Sichtbar | Schwer zu erklären | Teilweise sichtbar |
| Was sie braucht | Einen invertierten Index | Ein Modell und einen Vektorindex | Beides |
Bei Fragen in natürlicher Sprache gewinnt Dense Retrieval deutlich. Im Paper zu Dense Passage Retrieval von 2020 fand ein Retriever, der auf Paaren aus Frage und Passage trainiert wurde, eine Passage mit der Antwort unter seinen ersten 20 Ergebnissen je nach Datensatz 9 bis 19 Prozentpunkte häufiger als ein starkes BM25-System.
Hybride Suche gibt es, weil jede Methode dort versagt, wo die andere funktioniert. Der übliche Weg, die beiden Listen zusammenzuführen, ist Reciprocal Rank Fusion (RRF) aus einem SIGIR-Paper von 2009 von Gordon Cormack und Kollegen: Ein Dokument erhält aus jeder Liste, in der es vorkommt, 1/(60 + sein Rang), und die Summen bestimmen die endgültige Reihenfolge. Eine Passage, die bei den Keywords auf Platz eins und bei den Vektoren auf Platz drei steht, kommt auf etwa 0,0323 und schlägt eine Passage, die nur eine einzige Liste auf Platz eins gesetzt hat, mit etwa 0,0164. Weil RRF nur Positionen verwendet, müssen die unvereinbaren Scores der beiden Systeme nie miteinander verglichen werden.
Was ist eine Vektordatenbank?
Eine Vektordatenbank ist eine Datenbank, die dafür gebaut ist, Embeddings zu speichern und schnell diejenigen zu finden, die einem gegebenen Vektor am nächsten liegen. Zu jedem Eintrag hält sie den Vektor, den Originaltext oder einen Verweis darauf und Metadaten wie Adresse, Datum, Sprache oder Zugriffsrechte, damit sich die Ergebnisse filtern und anzeigen lassen.
Sie wird gebraucht, weil der Vergleich einer Anfrage mit jedem gespeicherten Vektor, die sogenannte exakte oder Brute-Force-Suche, langsam wird, sobald eine Sammlung in die Millionen wächst. Vektordatenbanken bauen stattdessen einen ANN-Index (Approximate Nearest Neighbour, eine ungefähre Suche nach den nächsten Nachbarn). Ein verbreiteter ist HNSW (Hierarchical Navigable Small World), ein geschichteter Graph, in dem eine Suche von Nachbar zu Nachbar in Richtung der Anfrage springt und nur einen kleinen Teil der Sammlung prüft. „Approximativ“ heißt, dass sie gelegentlich einen der wirklich nächsten Vektoren verpassen kann und dafür weit schneller antwortet.
Vektorsuche gibt es in vier verbreiteten Formen, und meist entscheidet das, was Sie bereits betreiben:
- Eigenständige Vektordatenbanken: Systeme, die nur für diese Aufgabe gebaut sind, mit ANN-Indizes, Metadatenfiltern und Replikation.
- Vektorunterstützung in einer Datenbank, die Sie schon nutzen: pgvector zum Beispiel ergänzt PostgreSQL um eine Vektor-Ähnlichkeitssuche. Standardmäßig sucht es exakt und wechselt zur approximativen Suche, sobald Sie einen HNSW- oder IVFFlat-Index anlegen.
- Suchmaschinen mit Vektorfeldern: Keyword-Suchmaschinen, die auch Vektoren speichern, sodass eine hybride Anfrage in einem einzigen System läuft.
- Bibliotheken in Ihrem Programm: Faiss, eine MIT-lizenzierte Bibliothek, die überwiegend in der KI-Forschungsgruppe von Meta entwickelt wurde, baut und durchsucht Vektorindizes im Arbeitsspeicher, ohne Server.
Ein Index ist nur so aktuell wie die Dokumente dahinter. Seiten ändern sich, also müssen sie regelmäßig neu abgerufen und neu eingebettet werden; liegen die Dokumente im Web, ist das die Aufgabe eines Web-Crawlers.
Wo begegnet Ihnen semantische Suche?
- Google Suche: Google sagt, dass seine Systeme die Bedeutung von Anfragen und Seiten abgleichen, nicht nur ihre Wörter.
- Website- und Hilfecenter-Suche: „meine Bestellung ist nie angekommen“ findet den Artikel über verlorene Sendungen.
- Chatbots und KI-Assistenten: Bei RAG (Retrieval-Augmented Generation, abrufgestützte Generierung) findet die semantische Suche die Passagen, aus denen das Modell antwortet.
- Onlineshops: „Schuhe für langes Stehen“ findet Arbeitsschuhe, in deren Titel diese Formulierung nie vorkommt.
Semantische Suche über Webinhalte braucht zuerst die Seiten. Das eigene Hilfecenter lässt sich leicht indexieren; ein Assistent, der aus öffentlichen Quellen antwortet, etwa aus Produktdokumentation oder aus Preisen vieler Shops, muss diese Seiten sammeln, den lesbaren Text extrahieren und ihn erneut abrufen, wenn er sich ändert. Manche Seiten unterscheiden sich außerdem nach dem Land des Besuchers, deshalb sollte die indexierte Fassung aus dem Markt stammen, in dem Ihre Nutzer sind, zum Beispiel über einen Proxy in diesem Land. Wie das Sammeln funktioniert, zeigt unser Beitrag Web Scraping für RAG: Von HTML zu sauberen Markdown-Chunks.
Was ändert semantische Suche für SEO?
Für SEO bedeutet semantische Suche, dass Google die Bedeutung einer Anfrage mit der Bedeutung einer Seite abgleicht; eine Seite kann also für Formulierungen ranken, die sie nie verwendet, und das Wiederholen von Keyword-Varianten bringt nichts. Google beschrieb diesen Wandel 2019, als es erklärte, BERT helfe ihm, etwa jede zehnte englischsprachige Suche in den USA besser zu verstehen; in einem Beispiel entscheidet das Wort „to“ in „2019 brazil traveler to usa need a visa“, in welche Richtung die Person reist.
Der Leitfaden zu den Ranking-Systemen der Google Suche beschreibt drei solche Systeme. BERT hilft zu verstehen, „wie Kombinationen von Wörtern verschiedene Bedeutungen und Absichten darstellen“; der neuronale Abgleich erkennt „Darstellungen von Konzepten in Abfragen und auf Seiten“ und gleicht sie miteinander ab; RankBrain liefert relevante Inhalte auch dann, wenn sie nicht genau die in einer Suche verwendeten Wörter enthalten. Google veröffentlicht nicht, wie diese Systeme gebaut sind; Behauptungen über „Googles Vektoren“ sind also Vermutungen.
Der Startleitfaden zur Suchmaschinenoptimierung zieht daraus die praktische Folgerung: Die Systeme von Google für den Sprachabgleich verstehen, wie sich eine Seite auf viele Suchanfragen bezieht, auch wenn sie die genauen Begriffe nicht verwendet, und Sie müssen nicht jede Variante einer Suche vorhersehen. Verschwunden sind Keywords trotzdem nicht: Google nennt es weiterhin das einfachste Zeichen für Relevanz, wenn ein Inhalt dieselben Stichwörter enthält wie die Suchanfrage.
- Schreiben Sie eine vollständige Seite pro Thema und Suchintention, nicht eine dünne Seite pro Keyword-Variante.
- Beantworten Sie die Frage früh und klar, so, wie Leser sie stellen, und behandeln Sie danach ihre Folgefragen.
- Verwenden Sie die exakten Namen, die Ihre Leser verwenden, für Produkte, Fehlercodes und Orte; ein Abgleich nach Bedeutung ersetzt nicht den exakten Treffer bei einem Code.
- Verzichten Sie auf Tricks. Überflüssige Keywords (Keyword-Stuffing), versteckter Text und massenhaft erzeugte Seiten, die bloß Formulierungen abdecken sollen, stehen in den Spamrichtlinien von Google.
Wo versagt semantische Suche?
Semantische Suche versagt dort, wo die exakte Zeichenfolge wichtiger ist als die Bedeutung: bei Produktcodes, Teilenummern, Fehlercodes, Namen und Zahlen. Für ein Embedding-Modell können „Fehler 0x80070005“ und „Fehler 0x80070057“ sehr nah beieinanderliegen, weil sie dieselbe Art von Sache sind, aber wer den einen eingibt, will genau diesen.
- Seltene Namen und neue Wörter: Ein Modell, das vor dem Start eines Produkts trainiert wurde, hat dessen Namen nie gesehen.
- Verneinung und Grenzen: „Laptops ohne Touchscreen“ kann Laptops mit Touchscreen weit oben einordnen, weil der Text von Touchscreens handelt. Preise, Daten und Größen funktionieren besser als Filter.
- Kein leeres Ergebnis: Nächste Nachbarn gibt es immer, also liefert auch eine Frage, die Ihre Dokumente nicht beantworten können, die „nächstgelegenen“ Passagen. Ohne Ähnlichkeitsschwelle antwortet ein Assistent dann aus etwas Irrelevantem.
- Sprachen und Fachjargon: Ein Modell, das überwiegend mit allgemeinem Englisch trainiert wurde, kann auf Deutsch oder bei Fachbegriffen schlechter abschneiden; testen Sie es mit Ihren eigenen Anfragen.
Die übliche Lösung für die ersten drei Punkte ist hybride Suche: ein Keyword-Index für exakte Treffer und Filter, Vektoren für Umschreibungen.
Häufige Fehler
- Embedding-Modelle mischen. Anfragen und Dokumente, die mit verschiedenen Modellen oder Versionen eingebettet wurden, lassen sich nicht vergleichen; ein neues Modell heißt, alles neu einzubetten.
- Ein Vektor pro langer Seite. Ein Durchschnitt aus zehn Themen passt zu keinem davon gut. Indexieren Sie Passagen.
- Die Keyword-Suche abschaffen. Nutzer fügen weiterhin Bestellnummern, Fehlercodes und Namen ein.
- Kein Testset. Halten Sie einige Dutzend echte Anfragen samt dem Ergebnis bereit, das jede liefern soll, und prüfen Sie nach jeder Änderung die ersten 10 Treffer.
- Berechtigungen nicht im Index. Werden die Zugriffsrechte nicht mit jeder Passage gefiltert, gibt der Index interne Dokumente an die falschen Personen heraus.
- Indexieren, was Sie nicht nutzen dürfen. Seiten, deren Nutzungsbedingungen eine Weiterverwendung verbieten, oder Seiten voller personenbezogener Daten, die unter die DSGVO oder in Türkiye unter das KVKK fallen, werden nicht dadurch frei verwendbar, dass man sie in Vektoren verwandelt hat.
Entscheidungshilfe
| Ihre Situation | Was Sie einsetzen |
|---|---|
| Nutzer suchen nach Produktcode, Artikelnummer oder Namen | Keyword-Suche mit Synonymliste |
| Nutzer stellen Fragen in eigenen Worten | Semantische Suche mit einem Embedding-Modell |
| Beide Arten von Anfragen | Hybride Suche, zusammengeführt mit Rank Fusion |
| Einige tausend Passagen | Exakte Suche im Arbeitsspeicher oder in Ihrer bestehenden Datenbank |
| Millionen Passagen mit Filtern | Ein ANN-Index in einer Vektordatenbank oder Suchmaschine |
| Ein Chatbot, der Quellen nennen muss | Hybrides Retrieval, ein Reranker, eine Quelladresse pro Passage |
| Eine Seite, die bei verwandten Formulierungen in Google fehlt | Eine vollständige Seite pro Thema und Intention |
| Antworten aus öffentlichen Webseiten | Seiten vor dem Indexieren sammeln und aktuell halten |
Häufige Fragen
Ist semantische Suche dasselbe wie Vektorsuche?
Nicht ganz. Semantische Suche ist das Ziel, nämlich Ergebnisse nach Bedeutung zu finden; Vektorsuche ist die übliche Technik dafür, nämlich die nächsten Vektoren in einem Index zu finden. Vektorsuche kann auch Bilder oder Töne vergleichen, und eine grobe semantische Suche lässt sich ohne Vektoren bauen, aus Synonymlisten und umgeschriebenen Anfragen.
Was ist der Unterschied zwischen semantischer Suche und RAG?
Semantische Suche findet und sortiert Passagen. RAG stellt die Passagen, die eine Suche geliefert hat, in den Prompt eines Sprachmodells und lässt das Modell daraus eine Antwort schreiben; semantische Suche ist also meist der Abrufschritt innerhalb von RAG. KI-Recherche-Agenten führen viele solcher Suchen in einer Schleife aus, wie unser Leitfaden zu Deep Research erklärt.
Was ist Kosinus-Ähnlichkeit bei der semantischen Suche?
Die Kosinus-Ähnlichkeit misst den Winkel zwischen zwei Vektoren: 1 bedeutet, dass sie in dieselbe Richtung zeigen, und Werte nahe 0 bedeuten, dass die Texte wenig gemeinsam haben. Die Länge spielt keine Rolle, sodass ein langer und ein kurzer Text zum selben Thema trotzdem nahe an 1 liegen können. Im Beispiel oben erreichen beide Flugtexte gegenüber der Anfrage 0,997 und der Hoteltext 0,269.
Was unterscheidet eine Vektordatenbank von einer relationalen Datenbank?
Eine relationale Datenbank findet Zeilen, die eine exakte Bedingung erfüllen, etwa einen Preis unter 50, und liefert nichts, wenn keine Zeile passt. Eine Vektordatenbank findet die Einträge, die einem gegebenen Vektor am ähnlichsten sind, und liefert immer die nächstgelegenen. Viele Systeme nutzen beides: relationale Filter, Sortierung über Vektoren.
Brauche ich für semantische Suche eine Vektordatenbank?
Nicht immer. Für einige tausend Passagen reicht meist eine exakte Suche im Arbeitsspeicher oder eine Vektorerweiterung wie pgvector in einer Datenbank, die Sie bereits betreiben. Eine eigenständige Vektordatenbank lohnt sich bei Millionen von Vektoren, häufigen Aktualisierungen, strengen Filtern oder mehreren Anwendungen, die sich einen Index teilen.
Was ist semantisches SEO?
Semantisches SEO ist ein Branchenbegriff dafür, Seiten um Themen, Entitäten und Suchintention herum zu schreiben statt um einzelne Keywords. Es folgt aus dem, was Google über seinen Abgleich nach Bedeutung sagt: Beantworten Sie die Frage vollständig, verwenden Sie die Wörter Ihrer Leser und lassen Sie eine gute Seite die Varianten einer Anfrage abdecken.
Fazit
Semantische Suche findet Ergebnisse nach Bedeutung: Ein Modell verwandelt Passagen und Anfragen in Embeddings, ein Index findet die Passagen, die der Anfrage am nächsten liegen, und ein optionaler Reranker verfeinert die Reihenfolge. Bei Umschreibungen und natürlich formulierten Fragen schlägt sie die Keyword-Suche, bei exakten Codes, Namen und Zahlen unterliegt sie ihr; deshalb ist hybride Suche mit Rank Fusion in produktiven Systemen eine verbreitete Wahl. Für SEO weisen Googles eigene Leitfäden auf vollständige Seiten zu Themen und Intentionen statt auf Keyword-Varianten. Wird der Index aus öffentlichen Webseiten gebaut, ist das Sammeln der schwierige Teil; unsere Web Scraping API, ein Dienst für verwaltete Seitenextraktion, der über das Vertriebsteam erhältlich ist, wird auf der Seite Data Scraping beschrieben.