Un equipo de marketing necesita saber qué métodos de pago ofrecen las tiendas online de cinco países y cuáles se añadieron en el último año. Un chatbot normal responde en pocos segundos, de memoria y con un puñado de resultados de búsqueda. La misma pregunta en un modo de deep research recibe primero unas preguntas aclaratorias, luego un plan de investigación, diez minutos de silencio y, al final, un informe largo con una tabla, una sección por país y una fuente detrás de cada afirmación.
Este artículo explica qué es deep research, por qué pasos avanza un agente de investigación con IA, en qué se diferencia de un chatbot y de un buscador y qué asistentes lo ofrecen. Después vemos dónde falla, cómo comprobar sus citas, cómo escribir un buen prompt, las API para desarrolladores y qué cambia cuando una empresa ejecuta su propio agente de investigación. Revisamos los datos de cada proveedor en sus páginas de ayuda el 17 de noviembre de 2026.
¿Qué es deep research?
Deep research es una función de IA que planifica y lleva a cabo una investigación de varios pasos sobre una pregunta y devuelve un informe escrito con sus fuentes. El modelo no responde de memoria: busca en la web y en los archivos que conectes, lee lo que encuentra y construye la respuesta con ese material.
Técnicamente, es un agente de IA especializado: un modelo de lenguaje que trabaja en un bucle, elige su siguiente acción, llama a herramientas como la búsqueda y la lectura de páginas y comprueba cada resultado antes de continuar. Nuestro artículo sobre cómo funcionan los agentes de IA explica ese bucle en general; deep research es el mismo bucle ajustado para una sola tarea: leer y sintetizar.
El nombre se extendió en diciembre de 2024, cuando Google añadió Deep Research a Gemini, y OpenAI lanzó deep research en ChatGPT el 2 de febrero de 2025. Un artículo académico de 2025, Characterizing Deep Research, sostiene que el rasgo que lo define no es la longitud del informe, sino el «fan-out»: cuántos conceptos distintos tiene que consultar el sistema. Una pregunta sobre un solo dato necesita una búsqueda; una pregunta sobre cinco mercados, tres tipos de pago y un periodo necesita decenas.
¿Cómo funciona deep research paso a paso?
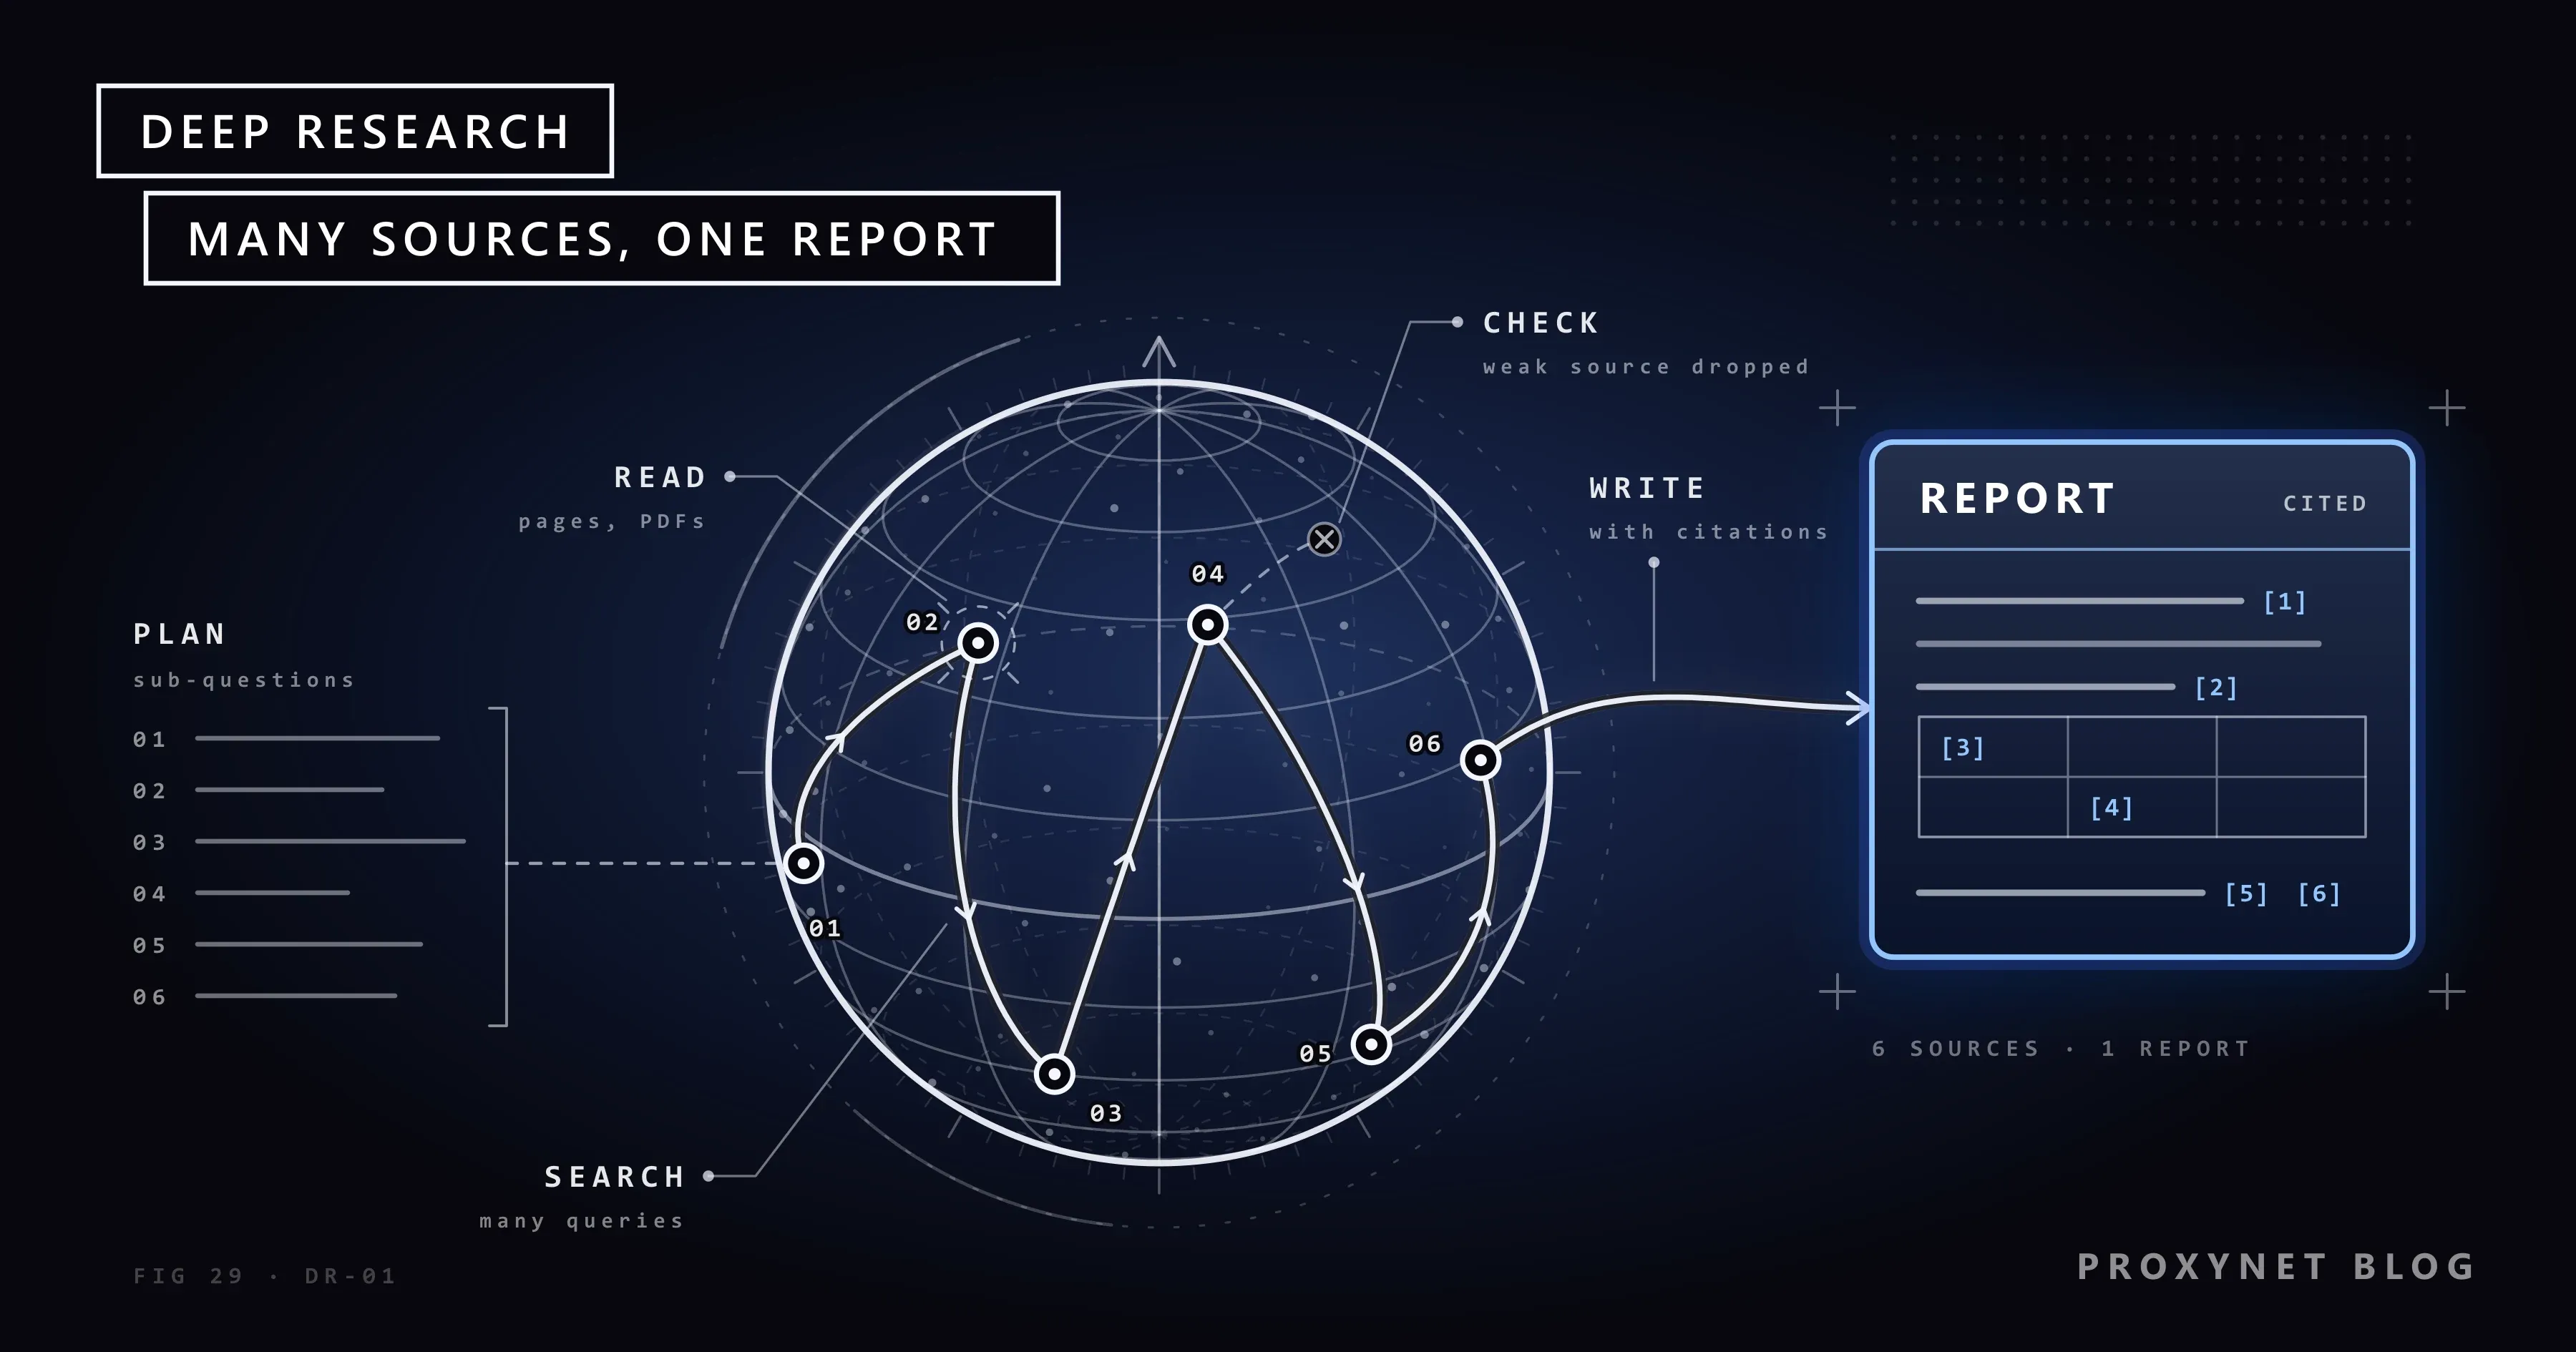
Deep research funciona como un bucle de planificar, buscar, leer y comprobar que se repite hasta cubrir el plan, seguido de un paso de redacción que añade las citas.
- Aclara la pregunta. ChatGPT, por ejemplo, puede preguntar primero por el alcance, como los países o el periodo al que te refieres.
- Redacta un plan. El sistema divide la pregunta en subpreguntas y muestra un plan de investigación; Gemini y ChatGPT te dejan editarlo antes de empezar.
- Busca a lo ancho. Escribe muchas consultas, normalmente cortas y amplias al principio y más concretas a medida que descubre qué fuentes existen.
- Lee las páginas. Abre páginas web, PDF y los archivos o fuentes conectadas que hayas permitido, y se queda con los pasajes que responden a una subpregunta.
- Evalúa y cubre huecos. Compara lo encontrado con el plan, detecta cifras contradictorias o partes que faltan y vuelve a buscar.
- Escribe el informe. Cuando el plan está cubierto o se alcanza un límite de tiempo, redacta un informe estructurado.
- Añade las citas. Cada afirmación se enlaza con la página de la que salió, para que puedas abrir la fuente y comprobarla.
Muchos sistemas reparten este trabajo entre varios agentes. El artículo de ingeniería de Anthropic sobre su sistema de investigación multiagente describe un agente principal que planifica la investigación y lanza varios subagentes que buscan en paralelo, además de un paso aparte de citas que empareja las afirmaciones finales con sus fuentes. Según el artículo, esta configuración usa unas 15 veces más tokens (las unidades de texto que procesa un modelo) que un chat normal, y por eso todos los proveedores limitan cuántas tareas de deep research puedes ejecutar.
¿En qué se diferencia deep research de un chatbot o de un buscador?
Un buscador te da una lista ordenada de páginas para que las leas tú, un chatbot te da una respuesta breve construida con pocas fuentes y deep research te da un informe construido con muchas páginas que ha leído por ti.
| Buscador | Respuesta de chatbot | Deep research | |
|---|---|---|---|
| Tiempo | Instantáneo | Segundos | Varios minutos |
| Fuentes | Enlaces que abres tú | Pocas páginas | De decenas a cientos |
| Resultado | Una lista de resultados | Unos párrafos | Un informe largo con citas |
| Ideal para | Encontrar una página | Un dato rápido | Una pregunta con muchas fuentes |
El verdadero cambio es quién lee. Con un buscador abres diez pestañas y las comparas; con deep research el sistema hace esa lectura, y tu trabajo pasa de leer a comprobar.
¿Qué herramientas de IA ofrecen deep research?
ChatGPT, Gemini, Claude y Perplexity ofrecen un modo de deep research, con nombres, menús y límites distintos que cambian a menudo. Dejamos fuera los precios y las cuotas de cada plan, que cambian todavía más rápido.
ChatGPT. Escribes /Deepresearch en el prompt o eliges Investigación avanzada en el menú de herramientas (+) o en la barra lateral. Según la página de ayuda de OpenAI, la función busca en la web pública o en sitios concretos, lee archivos subidos y usa aplicaciones conectadas; Sites > Gestionar sitios la limita a los dominios que introduzcas. Puedes editar el plan e interrumpir la investigación, y el informe se descarga en Markdown, Word o PDF. La disponibilidad depende de tu plan y de tu país.
Gemini. En la aplicación Gemini, haces clic en Añadir archivos en el cuadro de texto, eliges Deep Research y envías tu pregunta; Gemini muestra un plan que puedes cambiar con Editar plan antes de hacer clic en Empezar investigación. La fuente predeterminada es la Búsqueda de Google, y Fuentes añade tus archivos, cuadernos de NotebookLM y Gmail y Drive si Workspace está conectado. La página de ayuda de Google indica que un informe suele tardar entre 5 y 10 minutos, que debes ser mayor de 18 años y que las solicitudes diarias están limitadas.
Claude. Anthropic llama a la función Research; en la interfaz en español aparece como «Investigación». Funciona en los planes de pago de Claude y necesita la búsqueda web activada: haces clic en +, abajo a la izquierda del chat, y eliges Investigación. La página de ayuda de Anthropic dice que Claude hace búsquedas que se apoyan unas en otras, puede usar fuentes conectadas como Gmail y Google Docs y consume los límites del plan más rápido que un chat normal.
Perplexity. Eliges Research (investigación) en el selector de modo del cuadro de búsqueda. El centro de ayuda de Perplexity dice que los usuarios gratuitos tienen acceso limitado, que la mayoría de las tareas terminan en menos de tres minutos y que el informe se puede exportar a PDF. Cómo llegan estas cuatro herramientas a la web y cómo muestran sus fuentes lo comparamos en ChatGPT, Claude, Gemini y Perplexity: ¿cuál para la web?.
¿En qué es bueno deep research y dónde falla?
Deep research es fuerte en amplitud y débil en criterio: lee más páginas de las que leerías tú, pero no siempre sabe cuáles merecen confianza.
Funciona bien cuando la respuesta está repartida en muchas páginas: un panorama del mercado, las normas de varios países, los antecedentes de una empresa, el primer mapa de un campo desconocido. También encuentra páginas que una búsqueda rápida pasaría por alto, porque sigue buscando con el vocabulario que aprende por el camino. Los fallos vienen sobre todo de las fuentes:
- Las fuentes débiles quedan arriba. Los ingenieros de Anthropic vieron que las primeras versiones preferían granjas de contenido optimizadas para SEO a páginas con autoridad que aparecían más abajo.
- Los muros de pago y los inicios de sesión lo frenan. Lee la web pública y lo que conectas; un informe puede no mencionar nunca el estudio clave que está detrás de un muro de pago.
- Las páginas viejas parecen actuales. Un artículo sin fecha de hace tres años puede aparecer junto a las cifras de este mes.
- Las citas pueden desviarse. El enlace es real, pero la frase es una paráfrasis que cambió el sentido, o la cifra salió de otra página.
- La incertidumbre se pierde. En el lanzamiento, OpenAI escribió que el modelo puede inventar hechos, que le cuesta distinguir la información fiable de los rumores y que a menudo no deja ver su grado de incertidumbre.
¿Cómo se comprueba un informe de deep research?
Un informe de deep research se comprueba abriendo las fuentes de las afirmaciones sobre las que vas a actuar y confirmando que cada una dice lo que dice el informe.
- Elige las afirmaciones clave. Marca los cinco a diez datos de los que depende tu decisión.
- Abre la página citada. Asegúrate de que es la página que nombra el informe, no una portada ni un resultado de búsqueda.
- Encuentra la frase. Busca en la página la cifra o la expresión; si no está, trata la afirmación como no respaldada.
- Revisa la fecha frente al periodo que cubre tu pregunta.
- Ve a la fuente primaria. Si una noticia cita a un organismo regulador, abre la página del propio organismo.
- Busca la otra versión. Pregunta «¿qué fuentes contradicen esto?» o haz una búsqueda normal sobre la afirmación clave.
¿Cómo se escribe un buen prompt de deep research?
Un buen prompt de deep research indica la pregunta, el alcance, las fuentes en las que confías, el periodo y el formato que quieres recibir. El sistema planifica a partir de tus palabras, así que un prompt vago produce un plan vago.
- Alcance: países, sectores, productos, tamaño de empresa.
- Fuentes: sitios oficiales, reguladores, documentos registrados por las empresas, artículos académicos o sitios que quieres excluir. Los ajustes de fuentes, como la lista de sitios de ChatGPT, lo imponen mejor que una frase.
- Periodo: «cambios desde enero de 2026» elimina la mayor parte del material desactualizado.
- Resultado: una tabla comparativa, una sección por mercado, preguntas abiertas al final.
- Incertidumbre: pídele que marque las afirmaciones que se apoyan en una sola fuente.
Un ejemplo que cubre los cinco puntos:
Compara los métodos de pago online que ofrecen los principales sitios de comercio
electrónico de moda en Alemania, España, Polonia, Türkiye y Brasil. Céntrate en
los cambios desde enero de 2026. Prioriza fuentes oficiales: las páginas de pago
de las propias tiendas, los bancos centrales y los anuncios de los sistemas de
pago. Entrega una tabla (país, método, primera aparición) y una sección breve por
país. Marca cada afirmación que se apoye en una sola fuente y enumera las
preguntas que no hayas podido responder.
¿Existe una API de deep research?
Sí, varios proveedores ofrecen deep research a desarrolladores, y la oferta cambia rápido. El 17 de noviembre de 2026, la documentación de Google incluía un agente Gemini Deep Research en versión preliminar, accesible a través de la Interactions API de la Gemini API, y la API de Perplexity asociaba su modelo de deep research al nivel de esfuerzo «high» de su Agent API. OpenAI retiró sus modelos de API dedicados a deep research el 23 de julio de 2026, según su página de modelos retirados. Estas tareas tardan minutos, así que una aplicación las inicia en segundo plano y recoge el informe cuando termina.
¿Qué cambia cuando ejecutas tu propio agente de investigación?
Cuando una organización ejecuta su propio agente de investigación, sus solicitudes se convierten en tráfico automatizado en sitios web ajenos y tienen que seguir las reglas de esos sitios. Una sola tarea puede abrir cientos de páginas, y un servidor que ve demasiadas solicitudes desde una dirección responde con 429 Too Many Requests o la bloquea.
Lo básico es lo mismo que en cualquier crawler que se comporte bien: leer el robots.txt, mantener un límite de solicitudes por sitio, identificar al agente con un user agent honesto, guardar las páginas en caché en lugar de descargarlas dos veces y usar la API oficial del sitio cuando exista. Las páginas detrás de un inicio de sesión o de un muro de pago quedan fuera del alcance, salvo que tengas derecho a usarlas.
La ubicación es la otra mitad. Los precios, las monedas, la disponibilidad y los avisos legales cambian a menudo según el país del visitante, así que un agente que investiga un mercado desde un centro de datos de otro país puede informar de un precio equivocado con una cita que parece correcta. Los equipos que necesitan la vista local envían esas solicitudes a través de Proxies residenciales en el país de destino y registran el país junto a cada página. El proxy cambia el origen de la solicitud; no aumenta el número de solicitudes que acepta un sitio y no es una forma de saltarse un bloqueo.
¿Dónde se usa deep research?
- Investigación de mercado: competidores, precios y normativas en varios países.
- Revisiones bibliográficas: un primer mapa de los artículos antes de leer a fondo los importantes.
- Due diligence: el historial público de un proveedor, un socio o una empresa que se quiere adquirir.
- Normativa y cumplimiento: qué cambió en una norma, cuándo y quién lo dice.
- Planificación de contenidos y SEO: qué se ha publicado ya sobre un tema y qué preguntas siguen abiertas.
Errores comunes
- Tratar el informe como trabajo terminado. Es un primer borrador; comprueba las afirmaciones que vayas a usar.
- Escribir un prompt de una línea. Una pregunta corta produce un plan genérico.
- Saltarse la revisión del plan. Una subpregunta equivocada al principio cuesta diez minutos.
- Usar deep research para un dato rápido. Una búsqueda es más rápida y no gasta ninguna de tus tareas limitadas.
- Dar por hecho que el informe lo cubre todo. Los estudios de pago y las bases de datos privadas faltan si no los conectas.
- Publicar el informe tal cual. Reescríbelo, compruébalo y cita las fuentes originales; las páginas que leyó pertenecen a sus autores.
Guía de decisión
| Necesidad | Recomendación |
|---|---|
| Un dato o una definición | Una respuesta de chatbot o una búsqueda |
| Una pregunta repartida en muchas páginas | Deep research con un prompt acotado |
| Solo fuentes de confianza | Restringe primero los sitios o las fuentes |
| Tus documentos más la web | Una herramienta que conecte tus archivos |
| Investigación dentro de tu producto | La API de un proveedor, en segundo plano |
| Precios o stock locales por país | Tu propio agente, solicitudes con ubicación precisa |
Preguntas frecuentes
¿Deep research es gratis?
En parte. El 17 de noviembre de 2026, Gemini ofrecía Deep Research a usuarios con sesión iniciada y mayores de 18 años, con límites diarios, y Perplexity daba a los usuarios gratuitos acceso limitado a Research. La función Research de Claude requiere un plan de pago, y la asignación de ChatGPT depende de tu plan y de tu país; el contador de uso del producto muestra lo que te queda.
¿Cuánto tarda deep research?
Normalmente, entre unos tres minutos y media hora. Perplexity dice que la mayoría de las tareas terminan en menos de tres minutos, Google indica que en Gemini suele tardar entre 5 y 10 minutos y OpenAI hablaba de 5 a 30 minutos en el lanzamiento. Puedes salir del chat mientras se ejecuta.
¿Cuál es la diferencia entre deep research y la búsqueda web?
La búsqueda web devuelve una respuesta rápida o una lista de enlaces a partir de pocas páginas; deep research planifica una serie de búsquedas, lee muchas páginas y escribe un informe largo con citas. La búsqueda sirve para un dato que necesitas ya; deep research, para una pregunta que te llevaría horas de lectura.
¿Puede deep research leer páginas de pago o privadas?
No, no por sí solo. Lee la web pública y las fuentes que conectes, como archivos subidos, una unidad de almacenamiento en la nube o una cuenta de correo. El contenido detrás de un muro de pago o de un inicio de sesión que no hayas conectado falta, y puede que el informe no lo diga.
¿Puedo fiarme de las citas de deep research?
Solo después de comprobar las que importan. Los enlaces suelen ser reales, pero la frase que respaldan puede ser una paráfrasis libre, una cifra antigua o una afirmación de una página débil. Abre la página, encuentra la frase exacta, revisa la fecha y prefiere la fuente primaria.
¿Deep research es lo mismo que un agente de IA?
Deep research es un tipo de agente de IA. Un agente general puede hacer clic, rellenar formularios y actuar en sitios web; un agente de deep research sobre todo busca, lee y escribe. La página de ayuda de OpenAI, por ejemplo, dice que deep research solo usa las acciones de lectura de las aplicaciones conectadas, nunca sus acciones de escritura.
En resumen
Deep research es un agente de IA que convierte una pregunta en un plan, hace muchas búsquedas, lee las páginas, cubre los huecos y escribe en minutos un informe con citas. ChatGPT, Gemini, Claude y Perplexity ofrecen una versión, y algunos proveedores la venden a través de sus API. El informe sustituye horas de lectura, pero no la comprobación: abre las fuentes de las afirmaciones que uses, prefiere las páginas primarias y vigila las fechas. Para investigaciones que dependen de lo que muestra una página en un país concreto, ejecuta el agente con solicitudes con ubicación precisa, o habla con nosotros sobre nuestra Web Scraping API para la extracción gestionada de páginas.