Bir müşteri, mağazanın yardım sayfasındaki arama kutusuna "siparişim hâlâ gelmedi" yazıyor; sorusunu cevaplayan makalenin başlığı ise "Kaybolan gönderiyi takip etme". Anahtar kelime araması işe yarar bir sonuç getirmez, çünkü iki cümlenin anlam taşıyan ortak bir kelimesi yoktur. Semantik arama ise bu makaleyi ilk sıraya koyar, çünkü iki cümle de aynı sorunu anlatır.
Bu yazıda semantik aramanın ne olduğunu, metinden sıralanmış sonuçlara kadar nasıl çalıştığını, embedding'in (vektör temsili) ne olduğunu, anahtar kelime ve hibrit aramayla farkını, vektör veritabanının ne işe yaradığını, SEO'da neyi değiştirdiğini ve nerede yetersiz kaldığını anlatıyoruz.
Semantik arama nedir?
Semantik arama, belgeleri sorgunun içerdiği kelimelere göre değil, sorgunun ne anlama geldiğine göre bulma yöntemidir. "Semantik" kelimesi "anlamla ilgili" demektir; bu yüzden anlamsal arama adı da kullanılır. Semantik bir arama motoru, "Roma'ya ucuz uçuş" ile "Roma için indirimli uçak bileti" sorgularını, ortak kelimeleri yalnızca "Roma" olduğu hâlde aynı istek olarak görür.
Daha eski yöntem anahtar kelime aramasıdır; sözcüksel arama (lexical search) da denir. Arama motoru sorgudaki kelimeleri ters indekste (inverted index), yani hangi kelimenin hangi belgelerde geçtiğini tutan listede arar ve bu kelimeleri içeren belgeleri puanlar. Hızlıdır ve tam isabetlidir ama anlamı görmez: "otomobil" yazan bir sayfa, biri bu eş anlamlıyı elle eklemedikçe "araba" aramasında çıkmaz.
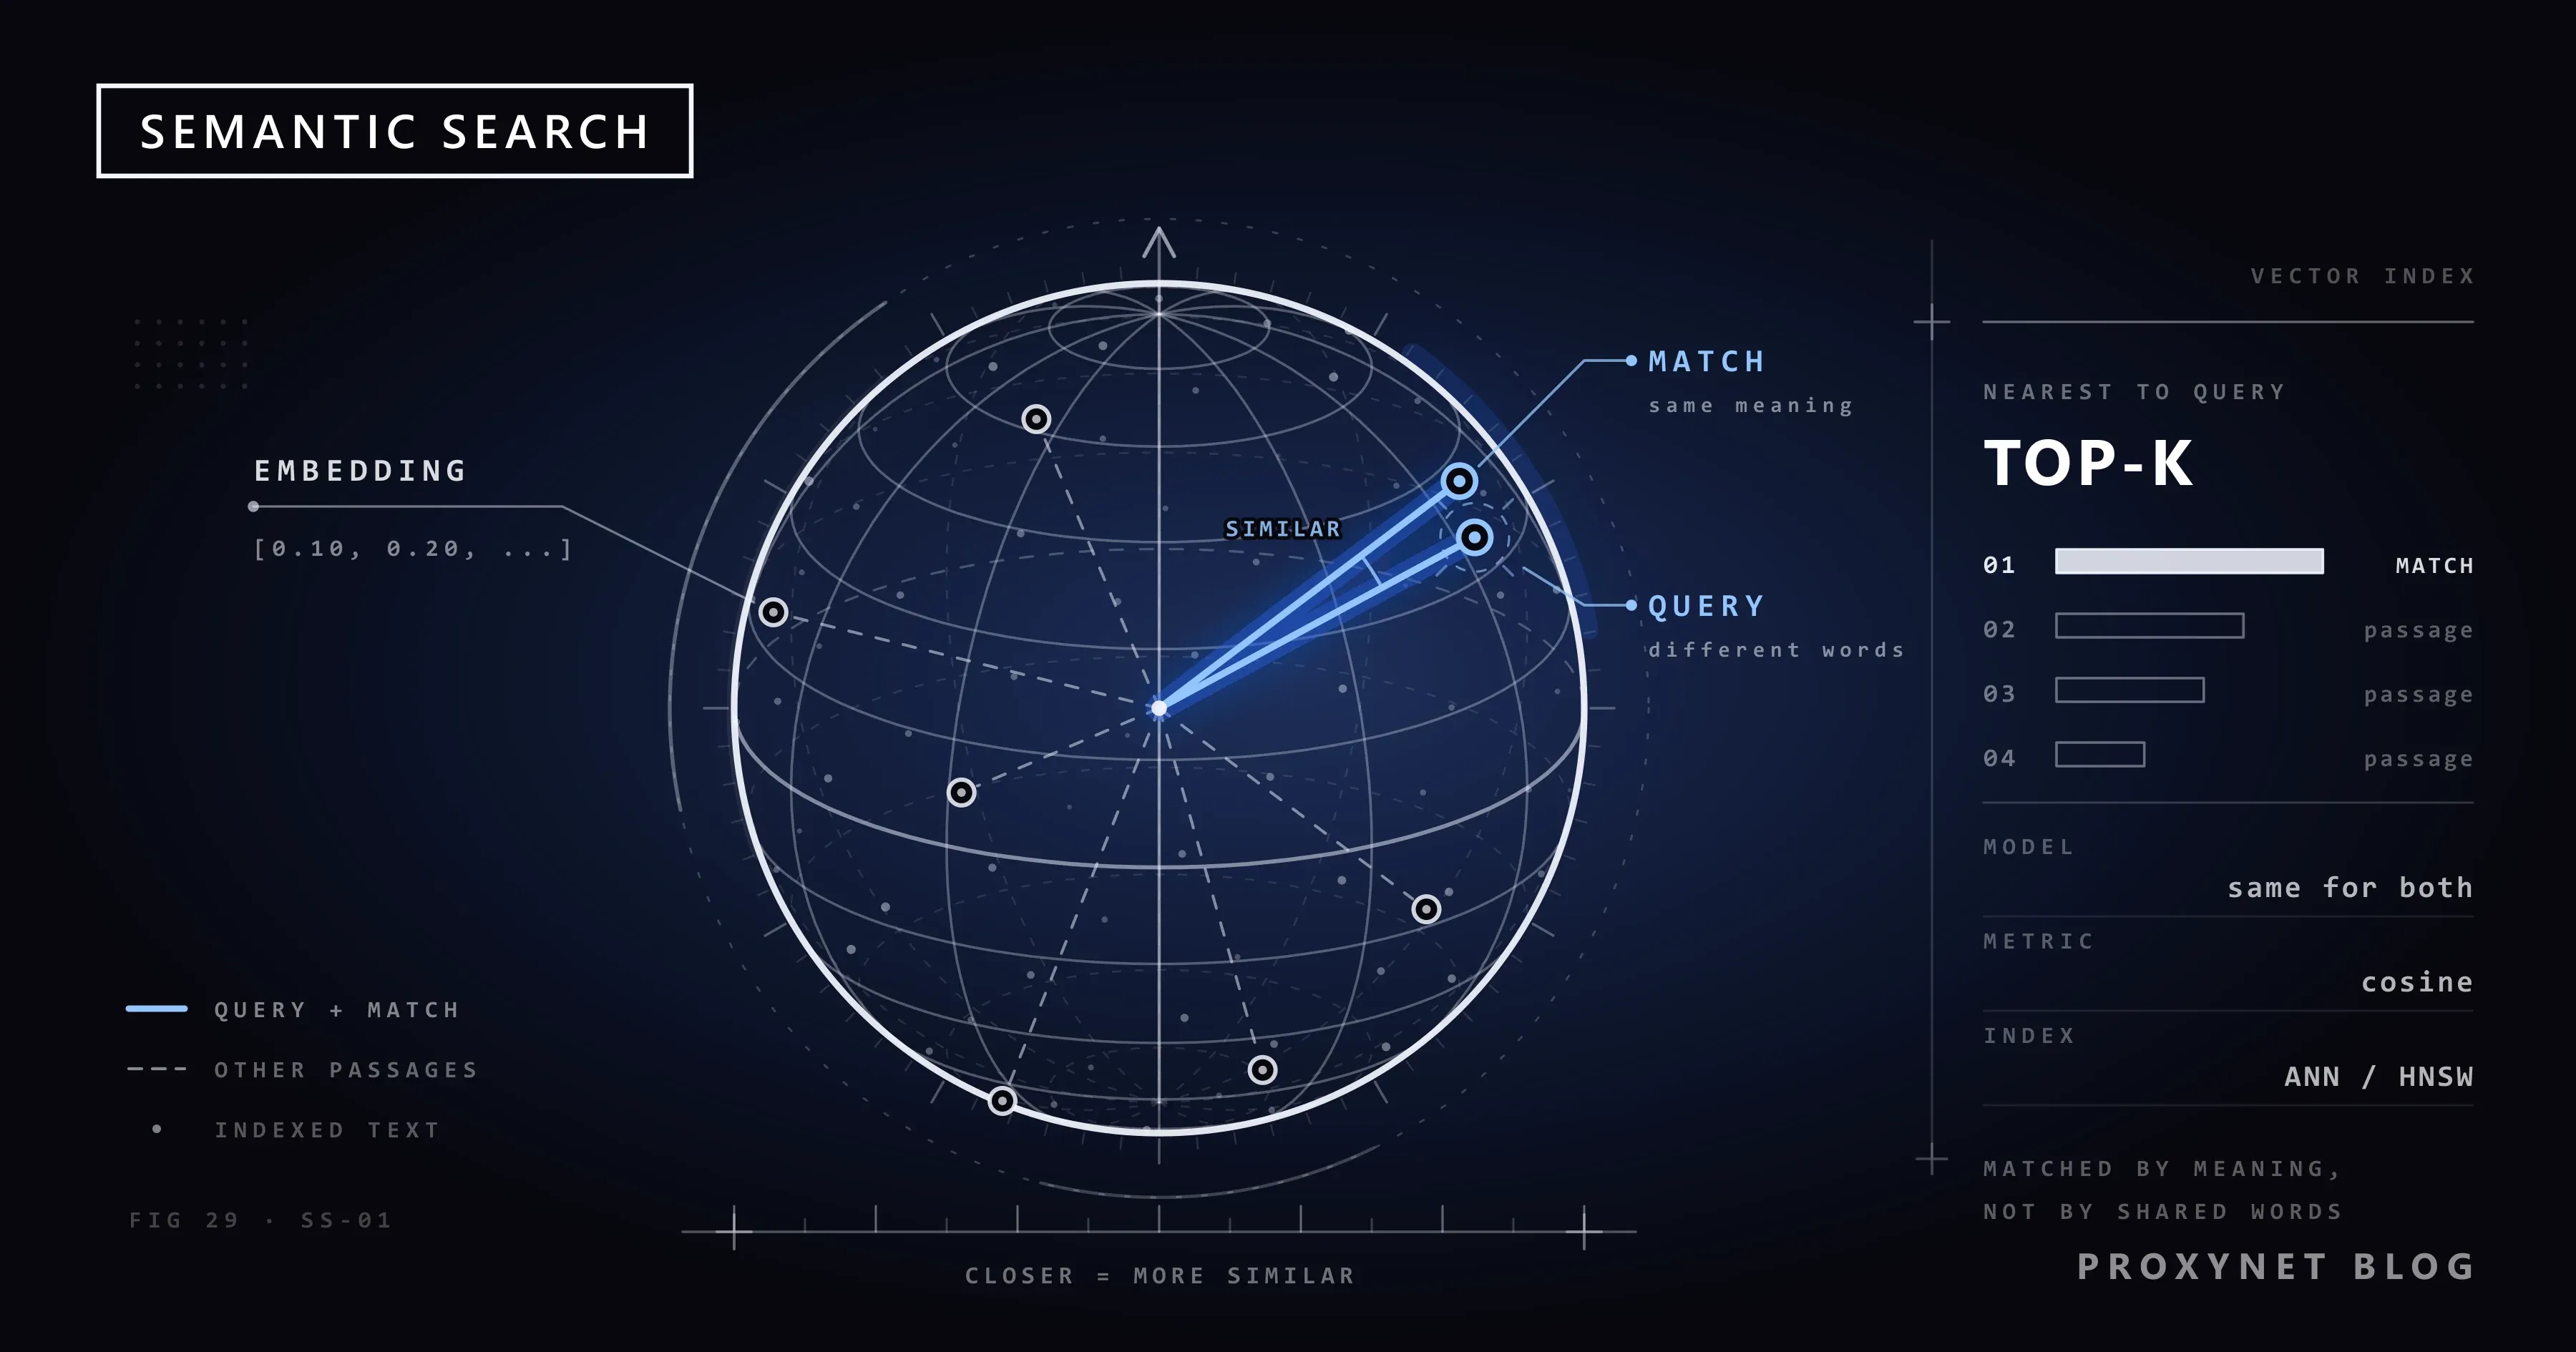
Bugün "semantik arama" denince neredeyse her zaman yoğun vektörlerle getirme (dense retrieval) kastedilir: bir sinir ağı metinleri vektörlere, yani sayı listelerine çevirir ve arama motoru bu vektörleri aralarındaki mesafeye göre karşılaştırır.
Semantik arama nasıl çalışır?
Semantik arama iki aşamada çalışır: önceden belgelerinizi vektörlere çevirip saklar, her sorguda da sorguyu bir vektöre çevirip saklanan vektörler arasında en yakın olanları arar.
- Belgeleri pasajlara bölün. Uzun bir sayfanın tamamına tek vektör vermek sayfadaki konuları birbirine karıştırır; bu yüzden çoğu sistem paragrafları ya da bölümleri, her birini başlığı ve kaynak adresiyle birlikte indeksler.
- Her pasajı bir embedding'e çevirin. Embedding modeli, bu iş için eğitilmiş bir sinir ağıdır; pasajı okur ve sabit uzunlukta bir sayı listesi üretir.
- Vektörleri bir indekste saklayın; yanlarına pasajın metnini ve tarih, dil, kimin görebileceği gibi meta verileri de ekleyin.
- Sorguyu aynı modelle embedding'e çevirin. Başka bir model, hatta aynı modelin başka bir sürümü, karşılaştırılamayan sayılar üretir.
- En yakın komşuları bulun. İndeks, sorgu vektörüne en yakın vektörleri döndürür; büyük koleksiyonlarda bu, çok daha hızlı olmak için biraz isabetten vazgeçen yaklaşık bir aramadır.
- Sıralayın ve filtreleyin. Sonuçlar benzerliğe göre sıralanır, meta verilere göre süzülür (yalnızca bu dildekiler, yalnızca bu kullanıcının açabileceği belgeler) ve en iyi 10 ya da 50 sonuçla sınırlanır.
- Gerekirse yeniden sıralayın. Yeniden sıralayıcı, sorguyu ve her aday pasajı birlikte okuyan daha yavaş bir modeldir. Bütün koleksiyonda çalıştırılamayacak kadar yavaş olduğu için yalnızca kısa listenin sırasını değiştirir.
Embedding nedir?
Embedding, bir metni temsil eden ve anlamı yakın metinlere birbirine yakın sayılar veren bir sayı listesidir. Google'ın makine öğrenmesi kursu embedding'i, verinin embedding uzayındaki vektör temsili olarak tanımlar ve iki öğe arasındaki mesafenin, bu öğelerin ne kadar benzer olduğunun ölçüsü olarak okunabileceğini anlatır; kursun embedding uzayı dersi bunu hayalî boyutlar boyunca dizilmiş yiyeceklerle gösterir.
Varsayımsal bir örnek fikri somutlaştırır. Küçük bir modelin her metni üç sayıyla anlattığını varsayalım: metnin ne kadar uçuşla, ne kadar fiyatla ve ne kadar otelle ilgili olduğu. Gerçek modeller yüzlerce, hatta binlerce sayı kullanır ve bu boyutların adı yoktur; buradaki adlar yalnızca fikri görünür kılmak için verildi.
| Metin | Temsilî vektör | Sorguya mesafe |
|---|---|---|
| Sorgu: "Roma'ya ekonomik uçak bileti" | [0.85, 0.85, 0.05] | – |
| "Roma'ya ucuz uçuşlar" | [0.90, 0.80, 0.10] | 0,09 |
| "Roma'ya uygun fiyatlı uçuşlar" | [0.80, 0.90, 0.10] | 0,09 |
| "Roma'daki en iyi oteller" | [0.10, 0.20, 0.90] | 1,31 |
Sorgu üç metinle de yalnızca "Roma" adını paylaşıyor; bu yüzden anahtar kelime araması onları birbirinden ayıramaz. Vektör uzayında ise iki uçuş metni sorgunun hemen yanında, otel metni çok uzakta durur ve semantik arama uçuşları öne çıkarır. Buradaki "mesafe", iki nokta arasındaki bildiğimiz düz çizgi uzaklığıdır; yalnızca iki yerine üç boyutta ölçülür.
Bugünkü modeller bağlama da duyarlıdır: aynı kelime, içinde geçtiği cümleye göre farklı sayılar alır. Böylece "bir bardak çay" ile "çayın kıyısında yürüyüş" farklı komşuluklara düşer.
Cümle embedding'leri bu yöntemi uygulanabilir hâle getirdi. Nils Reimers ve Iryna Gurevych, 2019 tarihli Sentence-BERT makalesinde, her cümle çiftini birlikte okumak zorunda olan BERT ile 10.000 cümle arasında birbirine en çok benzeyen çifti bulmanın yaklaşık 65 saat süreceğini hesapladı; her cümle için bir kez hesaplanan ve kosinüs benzerliğiyle karşılaştırılan embedding'lerle aynı iş yaklaşık 5 saniye sürdü. Bütün semantik arama motorları bu ayrıma dayanır: belgeler bir kez embedding'e çevrilir, sorgu anında yalnızca ucuz vektörler karşılaştırılır.
Semantik, anahtar kelime ve hibrit arama arasındaki fark nedir?
Anahtar kelime araması sorgunun kelimelerini, semantik arama anlamını eşleştirir; hibrit arama ise ikisini birlikte çalıştırıp sonuçları birleştirir. Anahtar kelime aramasının klasik sıralama formülü BM25'tir ve 1994'teki TREC-3 konferansında sunulan Okapi sisteminden gelir. Sorgu kelimeleri bir belgede sık, koleksiyonun geri kalanında seyrek geçiyorsa o belgeyi üst sıraya taşır; belge uzunluğu için de düzeltme yapar.
| Anahtar kelime (BM25) | Semantik (vektör) | Hibrit | |
|---|---|---|---|
| Neyi eşleştirir? | Ortak kelimeleri | Yakın anlamı | İkisini de |
| Eş anlamlılar ve farklı ifadeler | Yalnızca listelenmişse | Evet | Evet |
| Birebir kodlar ve adlar | Güçlü | Zayıf | Güçlü |
| Sonucun neden geldiği | Görünür | Açıklaması zor | Kısmen görünür |
| Neye ihtiyaç duyar? | Ters indeks | Model ve vektör indeksi | İkisine de |
Doğal dille yazılmış sorularda yoğun vektörlerle getirme açık ara öndedir. 2020 tarihli Dense Passage Retrieval makalesinde, soru ve pasaj çiftleriyle eğitilmiş bir arama bileşeni (retriever), cevabı içeren bir pasajı ilk 20 sonucu arasında güçlü bir BM25 sistemine göre, veri setine bağlı olarak 9 ila 19 yüzde puanı daha sık buldu.
Hibrit aramanın var olma nedeni, iki yöntemin birbirinin zayıf kaldığı yerde güçlü olmasıdır. İki listeyi birleştirmenin yaygın yolu, Gordon Cormack ve arkadaşlarının 2009'da SIGIR konferansında sunduğu RRF'tir (reciprocal rank fusion, sıraların tersiyle birleştirme): her belge, göründüğü her listeden 1/(60 + sırası) puan alır ve son sırayı bu puanların toplamı belirler. Anahtar kelime listesinde birinci, vektör listesinde üçüncü olan bir pasaj yaklaşık 0,0323 puan alır ve yalnızca tek bir listede birinci olan pasajı (yaklaşık 0,0164) geçer. RRF yalnızca sıralara baktığı için iki sistemin birbiriyle kıyaslanamayan puanlarını karşılaştırmak gerekmez.
Vektör veritabanı nedir?
Vektör veritabanı, embedding'leri saklamak ve verilen bir vektöre en yakın olanları hızla bulmak için tasarlanmış bir veritabanıdır. Her öğe için vektörü, özgün metni ya da metnin nerede durduğunu gösteren bir işaretçiyi ve adres, tarih, dil ya da erişim hakları gibi meta verileri tutar; böylece sonuçlar süzülebilir ve kullanıcıya gösterilebilir.
Bu tür bir veritabanı gerekir, çünkü sorguyu saklanan her vektörle tek tek karşılaştırmak (tam arama ya da kaba kuvvet araması), koleksiyon milyonlarca öğeye ulaştıkça yavaşlar. Vektör veritabanları bunun yerine yaklaşık en yakın komşu (ANN, approximate nearest neighbour) indeksi kurar. Yaygın olanlardan biri HNSW'dir (hierarchical navigable small world): aramanın komşudan komşuya atlayarak sorguya yaklaştığı ve koleksiyonun yalnızca küçük bir bölümünü incelediği katmanlı bir graf. "Yaklaşık" demek, çok daha hızlı bir cevap karşılığında gerçek en yakın vektörlerden birini ara sıra kaçırabilmesi demektir.
Vektör araması yaygın olarak dört biçimde karşınıza çıkar ve hangisinin uygun olduğunu çoğu zaman zaten kullandığınız sistem belirler:
- Ayrı vektör veritabanları: yalnızca bu iş için geliştirilmiş; ANN indeksleri, meta veri filtreleri ve çoğaltma (replication) sunan sistemler.
- Kullandığınız veritabanına eklenen vektör desteği: örneğin pgvector, PostgreSQL'e vektör benzerliği araması ekler. Varsayılan olarak tam arama yapar; HNSW ya da IVFFlat indeksi eklediğinizde yaklaşık aramaya geçer.
- Vektör alanı olan arama motorları: vektör de saklayabilen anahtar kelime arama motorları; böylece hibrit bir sorgu tek sistemde çalışır.
- Programınızın içinde çalışan kütüphaneler: Faiss, ağırlıklı olarak Meta'nın yapay zekâ araştırma grubunda geliştirilen, MIT lisanslı bir kütüphanedir; vektör indekslerini sunucu olmadan, bellekte kurar ve arar.
Bir indeks, arkasındaki belgeler kadar günceldir. Sayfalar değişir; belgeler web'de duruyorsa belirli aralıklarla yeniden getirilmeleri ve yeniden embedding'e çevrilmeleri gerekir. Bu da sayfaları düzenli olarak dolaşıp getiren bir tarayıcının, yani web crawler'ın işidir.
Semantik aramayla nerelerde karşılaşırsınız?
- Google Arama: Google, sistemlerinin sorguların ve sayfaların yalnızca kelimelerini değil anlamını da eşleştirdiğini söylüyor.
- Site ve yardım merkezi aramaları: "siparişim hâlâ gelmedi" araması kaybolan gönderilerle ilgili makaleyi bulur.
- Sohbet botları ve yapay zekâ asistanları: RAG'de (retrieval-augmented generation, getirmeyle zenginleştirilmiş üretim) semantik arama, modelin cevabını dayandırdığı pasajları bulur.
- E-ticaret siteleri: "bütün gün ayakta durmak için ayakkabı" araması, başlığında bu ifade hiç geçmeyen iş ayakkabılarını bulur.
Web içeriğinde semantik arama yapabilmek için önce sayfalar gerekir. Kendi yardım merkezinizi indekslemek kolaydır, çünkü metin sizindir; ürün belgeleri ya da birçok mağazadaki fiyatlar gibi herkese açık kaynaklardan cevap veren bir asistan ise o sayfaları toplamak, okunabilir metni ayıklamak ve sayfa değiştikçe yeniden getirmek zorundadır. Bazı sayfalar ziyaretçinin ülkesine göre de değişir; bu yüzden indekslediğiniz kopyanın, kullanıcılarınızın bulunduğu pazardan, örneğin o ülkedeki bir proxy üzerinden alınması gerekir. Toplama tarafını RAG Nedir? Web Verisini Temiz Markdown Parçalarına Çevirme yazısında anlattık.
Semantik arama SEO'da neyi değiştirir?
SEO açısından semantik arama, Google'ın sorgunun anlamını sayfanın anlamıyla eşleştirmesi demektir; bu yüzden bir sayfa hiç kullanmadığı ifadelerle de sıralanabilir ve anahtar kelimenin farklı biçimlerini tekrarlamak bir şey kazandırmaz. Google bu değişikliği 2019'da duyurdu ve BERT sayesinde ABD'deki İngilizce aramaların yaklaşık onda birini daha iyi anladığını söyledi. Google'ın örneklerinden birinde "2019 brazil traveler to usa need a visa" sorgusundaki "to" kelimesi, yolculuğun hangi yöne olduğunu belirliyor.
Google'ın sıralama sistemleri rehberi bu türden üç sistem anlatır. BERT, kelimelerin bir araya gelerek nasıl farklı anlamlar ve niyetler ifade ettiğini anlamaya yarar; nöral eşleştirme (neural matching), sorgulardaki ve sayfalardaki kavramların temsillerini birbiriyle eşleştirir; RankBrain ise aramada kullanılan kelimelerin hepsini içermeyen ama ilgili olan içeriği bulmaya yardım eder. Google bu sistemlerin nasıl kurulduğunu yayımlamıyor; bu yüzden "Google'ın vektörleri" hakkındaki iddiaları tahmin olarak okuyun.
Google'ın SEO başlangıç rehberi buradan pratik sonucu çıkarır: Google'ın dil eşleştirme sistemleri, sayfanızın birçok sorguyla ilişkisini, o kelimeleri birebir kullanmasanız bile anlayabilir; içeriğinizin aranabileceği her ifadeyi önceden tahmin etmeye çalışmanız gerekmez. Yine de anahtar kelimeler önemini yitirmedi: Google, bir sayfanın arama sorgusuyla aynı anahtar kelimeleri içermesini hâlâ bilginin alakalı olduğuna dair "en temel sinyal" olarak tanımlar.
- Her konu ve arama niyeti için tek bir eksiksiz sayfa yazın; anahtar kelimenin her varyantı için ayrı, zayıf sayfalar açmayın.
- Soruyu erkenden ve sade bir dille cevaplayın: okurun sorduğu biçimde ele alın, ardından aklına gelecek sonraki soruları da karşılayın.
- Okurların kullandığı adları birebir kullanın: ürün adları, hata kodları, yer adları. Anlama göre eşleştirme, bir kodun birebir eşleşmesinin yerini tutmaz.
- Hilelerden uzak durun. Anahtar kelime doldurma, gizli metin ve farklı ifadeleri kapsamak için seri hâlde üretilmiş sayfalar Google'ın spam politikalarında sayılır.
Semantik arama nerede yetersiz kalır?
Semantik arama, anlamdan çok metnin birebir kendisinin önemli olduğu yerde yetersiz kalır: ürün kodları, parça numaraları, hata kodları, adlar ve sayılar. Bir embedding modeli için "0x80070005 hatası" ile "0x80070057 hatası" aynı türden şeyler oldukları için birbirine çok yakın durabilir; oysa birini yazan kullanıcı tam olarak onu arıyordur.
- Nadir adlar ve yeni kelimeler: bir ürün piyasaya çıkmadan önce eğitilmiş bir model, o ürünün adını hiç görmemiştir.
- Olumsuzluk ve sınırlar: "dokunmatik ekranı olmayan dizüstü bilgisayarlar" araması, metin dokunmatik ekranlardan söz ettiği için dokunmatik ekranlı modelleri üst sıralara taşıyabilir. Fiyat, tarih ve boyut gibi koşullar filtre olarak daha iyi çalışır.
- Boş sonuç olmaması: en yakın komşular her zaman vardır; bu yüzden belgelerinizin cevaplayamadığı bir soru da "en yakın" pasajları getirir. Bir benzerlik eşiği koymazsanız asistan alakasız bir metinden cevap üretir.
- Diller ve uzmanlık terimleri: çoğunlukla genel İngilizce metinlerle eğitilmiş bir model, Türkçe gibi başka dillerde ya da uzmanlık terimlerinde daha zayıf kalabilir; modeli kendi sorgularınızla test edin.
İlk üç sorunun yaygın çözümü hibrit aramadır: birebir eşleşmeler ve filtreler için bir anahtar kelime indeksi, farklı ifadeler için vektörler.
Sık yapılan hatalar
- Embedding modellerini karıştırmak. Farklı modellerle ya da sürümlerle embedding'e çevrilmiş sorgular ve belgeler karşılaştırılamaz; model değişirse her şeyin yeniden çevrilmesi gerekir.
- Uzun bir sayfaya tek vektör vermek. On konunun ortalaması hiçbirine iyi uymaz. Pasajları indeksleyin.
- Anahtar kelime aramasını tamamen kaldırmak. Kullanıcılar hâlâ sipariş numarası, hata kodu ve ad yapıştırır.
- Test kümesi tutmamak. Her birinin hangi sonucu getirmesi gerektiğini yazdığınız birkaç düzine gerçek sorgu saklayın ve her değişiklikten sonra ilk 10 sonuca bakın.
- Erişim haklarını indekse koymamak. Erişim hakları her pasajla birlikte filtrelenmezse indeks, iç belgeleri görmemesi gereken kişilere de gösterir.
- Kullanma hakkınız olmayan içeriği indekslemek. Kullanım şartları yeniden kullanımı yasaklayan sayfalar ya da KVKK veya GDPR kapsamındaki kişisel verilerle dolu sayfalar, vektöre çevrildi diye serbestçe kullanılabilir hâle gelmez.
Karar rehberi
| Durumunuz | Ne kullanmalı? |
|---|---|
| Kullanıcılar ürün kodu, stok kodu ya da adla arıyor | Eş anlamlılar listesiyle anahtar kelime araması |
| Kullanıcılar sorularını kendi cümleleriyle soruyor | Bir embedding modeliyle semantik arama |
| İki tür sorgu da var | Sıra birleştirmeli hibrit arama |
| Birkaç bin pasaj | Bellekte ya da mevcut veritabanınızda tam arama |
| Filtre gereken milyonlarca pasaj | Vektör veritabanında ya da arama motorunda ANN indeksi |
| Kaynak göstermesi gereken bir sohbet botu | Hibrit getirme, yeniden sıralayıcı, her pasaja kaynak adresi |
| Google'da yakın ifadelerde görünmeyen bir sayfa | Her konu ve niyet için tek, eksiksiz sayfa |
| Herkese açık web sayfalarından gelen cevaplar | İndekslemeden önce sayfaları toplamak ve güncel tutmak |
Sıkça sorulan sorular
Semantik arama ile vektör araması aynı şey mi?
Tam olarak değil. Semantik arama bir amaçtır: sonuçları anlama göre bulmak. Vektör araması ise bu amaç için en sık kullanılan tekniktir: bir indeksteki en yakın vektörleri bulmak. Vektör aramasıyla görseller ya da sesler de karşılaştırılabilir; kaba bir semantik arama ise vektör kullanmadan, eş anlamlı listeleri ve sorguyu yeniden yazma yöntemleriyle de kurulabilir.
Semantik arama ile RAG arasındaki fark nedir?
Semantik arama pasajları bulur ve sıralar. RAG ise aramanın döndürdüğü pasajları bir dil modelinin prompt'una koyar ve modelin cevabı bu pasajlardan yazmasını sağlar; yani semantik arama genellikle RAG'in içindeki getirme adımıdır. Yapay zekâ araştırma ajanları bu aramalardan pek çoğunu bir döngü içinde çalıştırır; bunu deep research (derin araştırma) yazımızda anlattık.
Semantik aramada kosinüs benzerliği nedir?
Kosinüs benzerliği iki vektör arasındaki açıyı ölçer: 1 iki vektörün aynı yönü gösterdiği, 0'a yakın değerler ise metinlerin pek ortak yanı olmadığı anlamına gelir. Vektörlerin uzunluğunu hesaba katmaz; bu yüzden aynı konudaki uzun ve kısa iki metin de 1'e yakın puan alabilir. Yukarıdaki örnekte iki uçuş metni sorguya karşı 0,997, otel metni ise 0,269 puan alır.
Vektör veritabanı ile ilişkisel veritabanı arasındaki fark nedir?
İlişkisel veritabanı, fiyatın 50'nin altında olması gibi kesin bir koşulu sağlayan satırları bulur; koşulu sağlayan satır yoksa hiçbir şey döndürmez. Vektör veritabanı ise verilen bir vektöre en çok benzeyen öğeleri bulur ve her zaman en yakın olanları döndürür. Birçok sistem ikisini birlikte kullanır: filtreler ilişkisel tarafta, anlama göre sıralama vektör tarafında yapılır.
Semantik arama için vektör veritabanı gerekir mi?
Her zaman değil. Birkaç bin pasaj için bellekte tam arama ya da zaten kullandığınız veritabanına eklenen pgvector gibi bir vektör eklentisi genellikle yeter. Ayrı bir vektör veritabanı ise milyonlarca vektör, sık güncelleme ve katı filtreler söz konusu olduğunda ya da aynı indeksi birden fazla uygulama kullandığında kendini amorti eder.
Semantik SEO nedir?
Semantik SEO, sayfaları tek tek anahtar kelimeler yerine konular, varlıklar (entity) ve arama niyeti etrafında yazmaya sektörde verilen addır. Google'ın anlamı nasıl eşleştirdiğine dair söylediklerinden doğal olarak çıkar: soruyu eksiksiz cevaplayın, okurlarınızın kelimelerini kullanın ve bir sorgunun farklı biçimlerini tek, iyi bir sayfanın karşılamasına izin verin.
Özet
Semantik arama sonuçları anlama göre bulur: bir model pasajları ve sorguları embedding'lere çevirir, bir indeks sorguya en yakın pasajları bulur, isteğe bağlı bir yeniden sıralayıcı da sırayı iyileştirir. Farklı ifadelerde ve doğal dille sorulan sorularda anahtar kelime aramasını geride bırakır, birebir kodlarda, adlarda ve sayılarda ise ondan geride kalır; bu yüzden canlı sistemlerde sıra birleştirmeli hibrit arama sık tercih edilir. SEO tarafında Google'ın kendi rehberleri, anahtar kelime varyantları yerine konular ve niyetler için eksiksiz sayfalar yazmayı işaret eder. İndeks herkese açık web sayfalarından kuruluyorsa asıl zor iş o sayfaları toplamaktır; satış ekibi üzerinden sunulan yönetilen sayfa çıkarma hizmetimiz Web Scraping API'yi veri kazıma sayfasında anlattık.