Um cliente digita "meu pedido nunca chegou" na busca da central de ajuda de uma loja, e o artigo que responde a isso se chama "Como rastrear uma entrega extraviada". Uma busca por palavras-chave não devolve nada útil, porque os dois textos não têm nenhuma palavra relevante em comum. Uma busca semântica coloca esse artigo em primeiro lugar, porque as duas frases falam do mesmo problema.
Este post explica o que é busca semântica, como ela funciona do texto até os resultados ordenados, o que é um embedding, como ela se compara com a busca por palavras-chave e com a híbrida, o que faz um banco de dados vetorial, o que muda para o SEO e onde ela falha.
O que é busca semântica?
A busca semântica é uma forma de recuperar documentos pelo que uma consulta significa, e não pelas palavras que ela contém. "Semântico" quer dizer simplesmente "relativo ao significado": um mecanismo semântico trata "voos baratos para Roma" e "passagens aéreas econômicas com destino a Roma" como o mesmo pedido, embora as duas tenham só uma palavra em comum.
A abordagem mais antiga é a busca por palavras-chave, também chamada de busca léxica. O mecanismo procura as palavras da consulta em um índice invertido, uma lista de quais documentos contêm quais palavras, e pontua os documentos que as contêm. É rápida e exata, mas cega ao significado: uma página que diz "automóvel" não aparece numa busca por "carro", a menos que alguém tenha cadastrado esse sinônimo à mão.
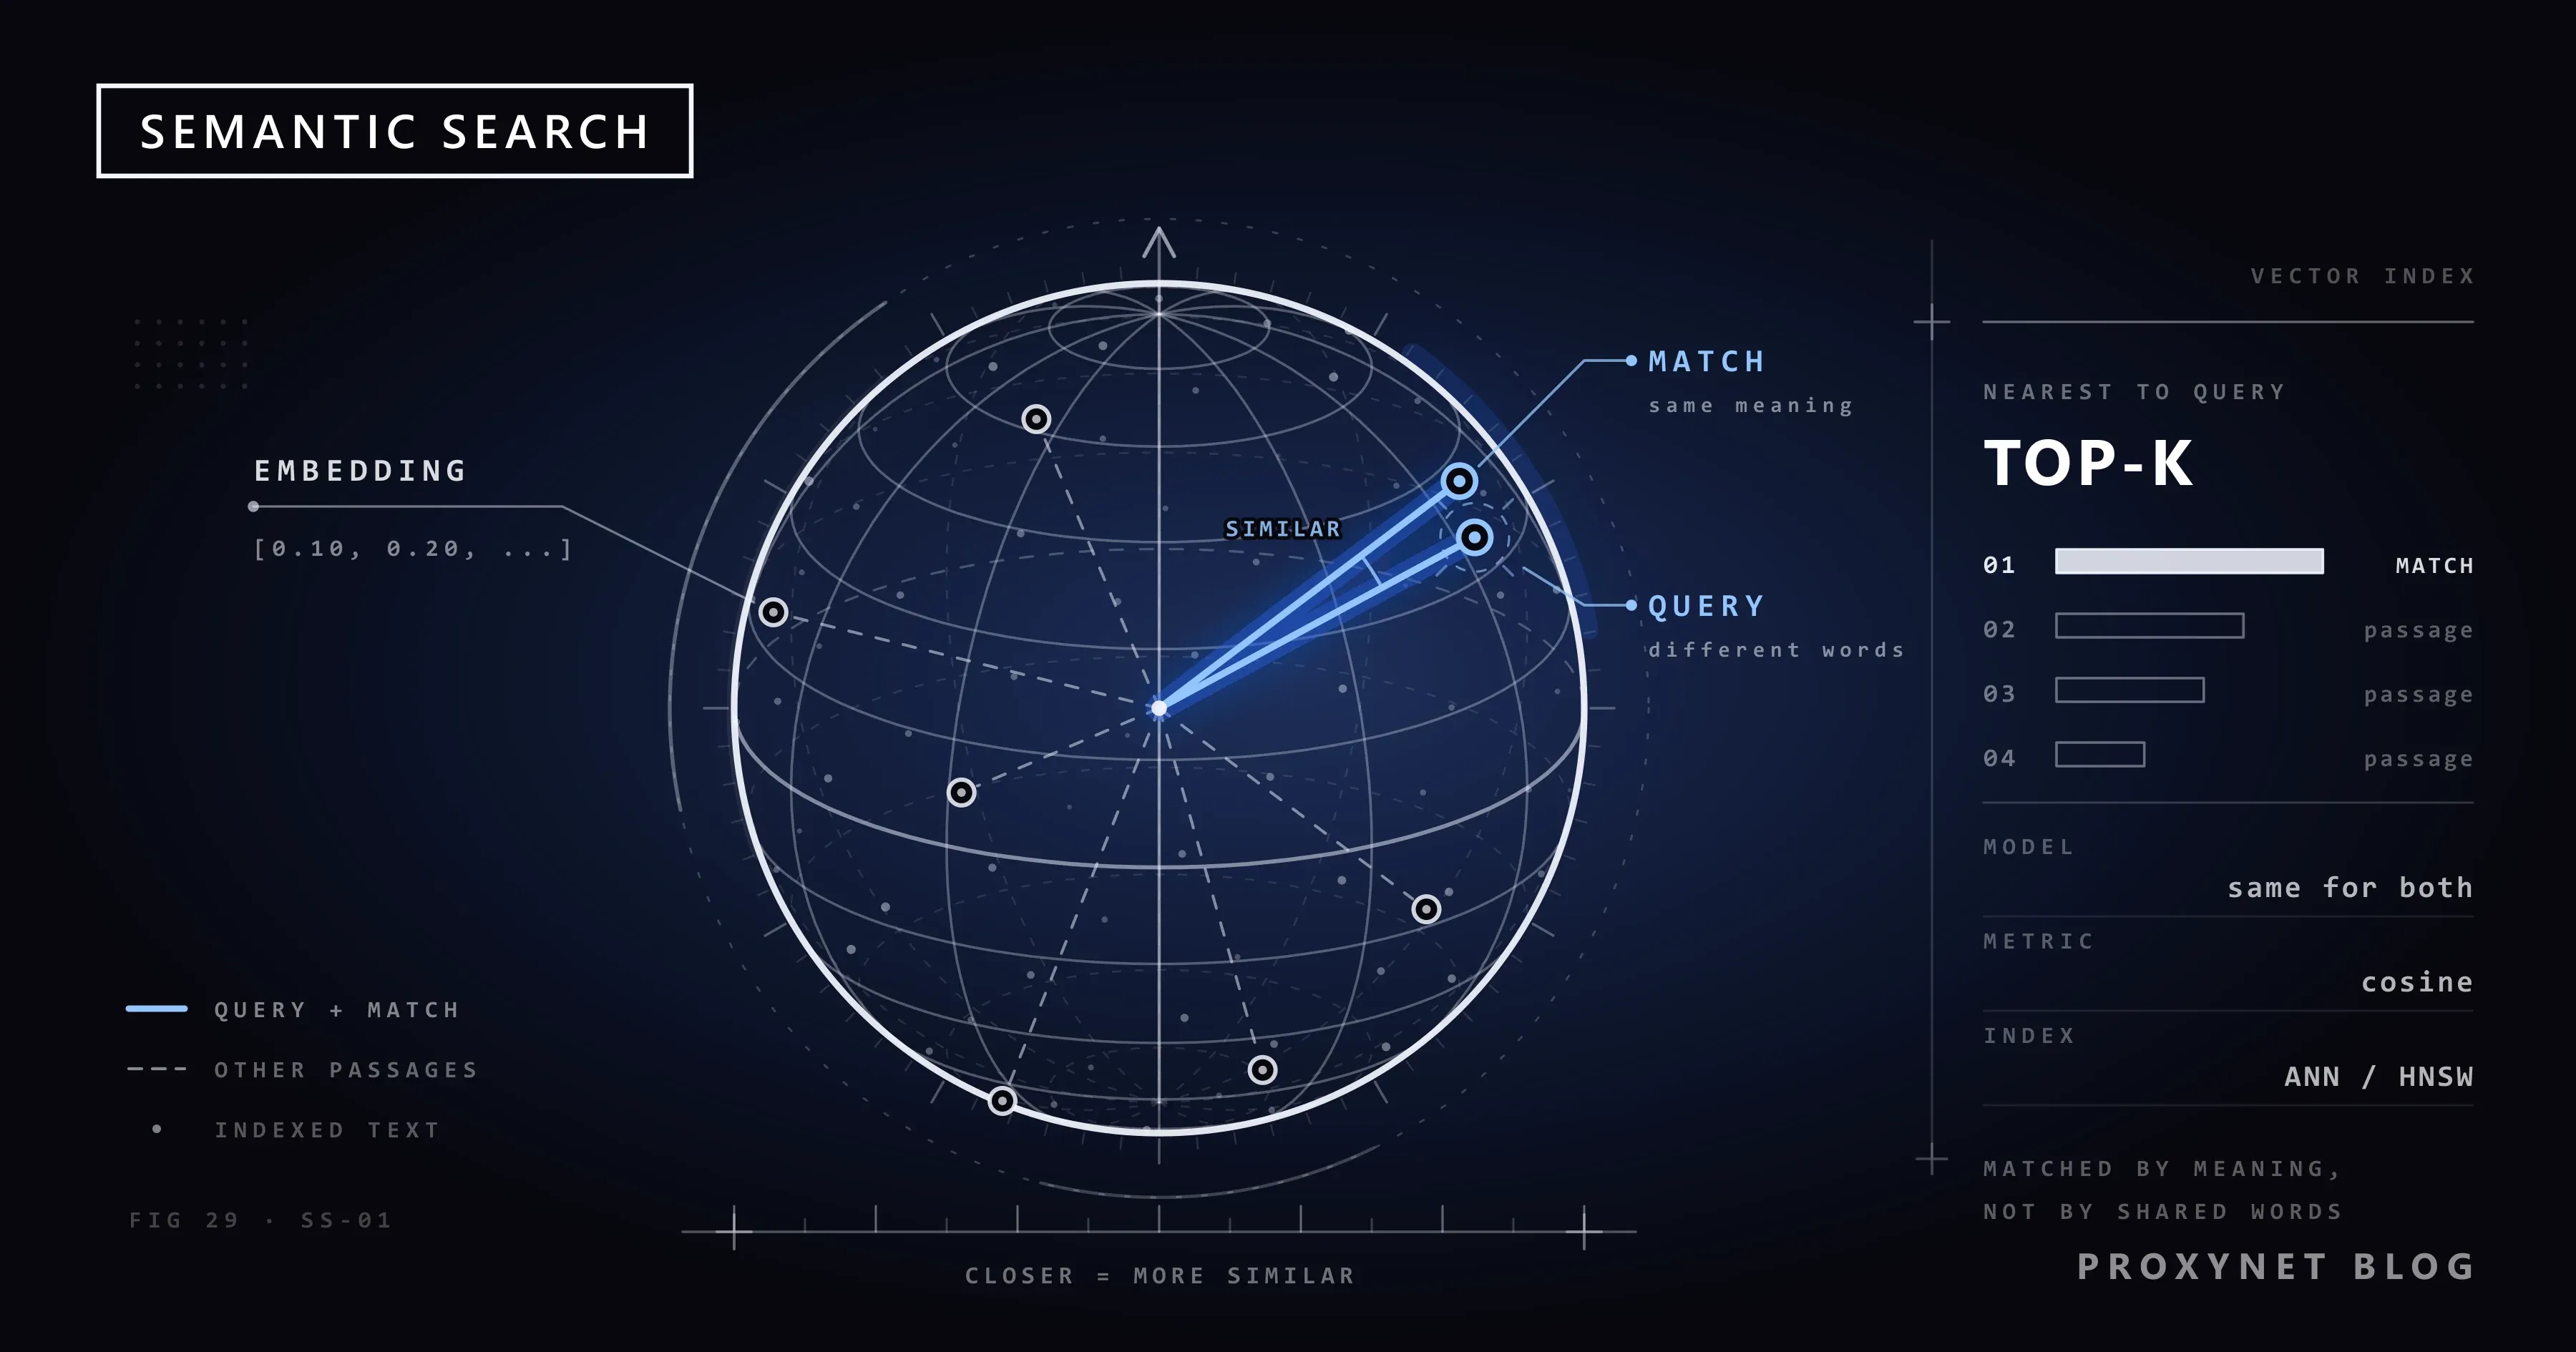
Hoje, "busca semântica" quase sempre quer dizer recuperação densa (dense retrieval): uma rede neural transforma textos em vetores, ou seja, em listas de números, e o mecanismo os compara pela distância.
Como funciona a busca semântica?
A busca semântica funciona em duas fases: antes, ela transforma seus documentos em vetores e os guarda; a cada consulta, transforma a consulta em um vetor e procura os vetores guardados mais próximos.
- Divida os documentos em trechos. Um único vetor para uma página longa mistura os assuntos dela, então a maioria dos sistemas indexa parágrafos ou seções, cada um com seu título e seu endereço de origem.
- Transforme cada trecho em um embedding. Um modelo de embedding, uma rede neural treinada para essa tarefa, lê o trecho e gera uma lista de números de tamanho fixo.
- Guarde os vetores em um índice, junto com o texto do trecho e metadados como data, idioma e quem pode vê-lo.
- Gere o embedding da consulta com o mesmo modelo. Um modelo diferente, ou até outra versão do mesmo modelo, produz números que não podem ser comparados.
- Encontre os vizinhos mais próximos. O índice devolve os vetores guardados mais próximos do vetor da consulta; em coleções grandes, essa é uma busca aproximada que abre mão de um pouco de precisão em troca de muita velocidade.
- Ordene e filtre. Os resultados são ordenados por similaridade, filtrados por metadados (só este idioma, só os documentos que este usuário pode abrir) e cortados nos 10 ou 50 mais parecidos.
- Reordene, se precisar. Um reranker é um modelo mais lento que lê juntos a consulta e cada trecho candidato. Ele é lento demais para a coleção inteira, então só reordena a lista curta.
O que é um embedding?
Um embedding é uma lista de números que representa um texto de modo que textos com significados parecidos recebam números parecidos. O curso de machine learning do Google o define como "uma representação vetorial de dados em um espaço de embedding", no qual a distância entre dois itens pode ser lida como uma medida de quanto eles se parecem; a lição sobre o espaço de embedding mostra isso com alimentos dispostos ao longo de dimensões imaginárias.
Um exemplo inventado deixa a ideia concreta. Suponha que um modelo minúsculo descreva cada texto com três números: o quanto ele fala de voar, de preço e de hotéis. Os modelos reais usam centenas ou milhares de números cujas dimensões não têm nome; os rótulos aqui servem só para tornar a ideia visível.
| Texto | Vetor ilustrativo | Distância até a consulta |
|---|---|---|
| Consulta: "passagens aéreas econômicas Roma" | [0.85, 0.85, 0.05] | – |
| "voos baratos para Roma" | [0.90, 0.80, 0.10] | 0,09 |
| "voar até Roma pagando pouco" | [0.80, 0.90, 0.10] | 0,09 |
| "hotéis recomendados em Roma" | [0.10, 0.20, 0.90] | 1,31 |
A consulta compartilha só "Roma" com os três textos, então um mecanismo de palavras-chave não consegue diferenciá-los. No espaço vetorial, os dois textos sobre voos ficam ao lado da consulta e o texto sobre hotéis fica longe, e a busca semântica coloca os voos primeiro. A "distância" é a distância comum em linha reta entre dois pontos, só que em três dimensões em vez de duas.
Os modelos modernos também são contextuais: a mesma palavra recebe números diferentes dependendo da frase em volta, e por isso "suco de manga" e "camisa de manga curta" caem em vizinhanças diferentes.
Os embeddings de frases tornaram isso viável. No artigo do Sentence-BERT, de 2019, Nils Reimers e Iryna Gurevych calcularam que encontrar o par mais parecido entre 10.000 frases com o BERT, que precisa ler juntas as duas frases de cada par, levaria cerca de 65 horas; com um embedding por frase comparado pela similaridade de cosseno, levou cerca de 5 segundos. Todo mecanismo semântico depende dessa separação: gerar os embeddings dos documentos uma única vez e, na hora da consulta, comparar vetores baratos.
Busca semântica, por palavras-chave e híbrida: qual é a diferença?
A busca por palavras-chave compara as palavras da consulta, a busca semântica compara o significado dela, e a busca híbrida roda as duas e junta os resultados. A fórmula clássica de ranqueamento por palavras-chave é o BM25, do sistema Okapi, apresentado na conferência TREC-3 em 1994. Ele coloca um documento mais acima quando as palavras da consulta aparecem nele com frequência e são raras no resto da coleção, e faz uma correção pelo tamanho do documento.
| Palavras-chave (BM25) | Semântica (vetores) | Híbrida | |
|---|---|---|---|
| Compara | Palavras em comum | Significado parecido | Os dois |
| Sinônimos e paráfrases | Só se estiverem listados | Sim | Sim |
| Códigos e nomes exatos | Forte | Fraca | Forte |
| Por que um resultado apareceu | Visível | Difícil de explicar | Em parte visível |
| O que exige | Um índice invertido | Um modelo e um índice vetorial | Os dois |
Em perguntas escritas em linguagem natural, a recuperação densa vence com folga. No artigo do Dense Passage Retrieval, de 2020, um retriever treinado com pares de pergunta e trecho encontrou um trecho com a resposta entre os 20 primeiros resultados de 9 a 19 pontos percentuais mais vezes do que um sistema BM25 forte, dependendo do conjunto de dados.
A busca híbrida existe porque cada método falha onde o outro funciona. A forma usual de juntar as duas listas é a reciprocal rank fusion (RRF, fusão por posição recíproca), de um artigo apresentado no SIGIR em 2009 por Gordon Cormack e colegas: um documento recebe 1/(60 + sua posição) de cada lista em que aparece, e as somas definem a ordem final. Um trecho que ficou em primeiro pelas palavras-chave e em terceiro pelos vetores soma cerca de 0,0323 e supera outro que só uma lista colocou em primeiro, com cerca de 0,0164. Como a RRF usa só posições, as pontuações incompatíveis dos dois sistemas nunca precisam ser comparadas.
O que é um banco de dados vetorial?
Um banco de dados vetorial é um banco de dados feito para guardar embeddings e encontrar rapidamente os mais próximos de um vetor dado. Para cada item, ele guarda o vetor, o texto original ou um ponteiro para ele, e metadados como endereço, data, idioma ou permissões de acesso, para que os resultados possam ser filtrados e exibidos.
Ele é necessário porque comparar uma consulta com cada vetor guardado, a chamada busca exata ou por força bruta, fica lento quando a coleção chega aos milhões de itens. Por isso, os bancos de dados vetoriais montam um índice de vizinhos mais próximos aproximados (ANN, approximate nearest neighbour). Um dos mais comuns é o HNSW (hierarchical navigable small world), um grafo em camadas no qual a busca salta de vizinho em vizinho em direção à consulta e examina só uma pequena parte da coleção. "Aproximado" quer dizer que ele pode, de vez em quando, deixar escapar um dos vetores realmente mais próximos em troca de uma resposta muito mais rápida.
A busca vetorial aparece em quatro formas comuns, e o que você já usa costuma decidir entre elas:
- Bancos de dados vetoriais dedicados: sistemas feitos só para essa tarefa, com índices ANN, filtros por metadados e replicação.
- Suporte a vetores em um banco de dados que você já usa: o pgvector, por exemplo, adiciona busca por similaridade vetorial ao PostgreSQL. Por padrão ele faz busca exata e passa para a busca aproximada quando você adiciona um índice HNSW ou IVFFlat.
- Mecanismos de busca com campos vetoriais: mecanismos de busca por palavras-chave que também guardam vetores, de modo que uma consulta híbrida roda em um só sistema.
- Bibliotecas dentro do seu programa: o Faiss, uma biblioteca com licença MIT desenvolvida principalmente no grupo de pesquisa em IA da Meta, monta índices vetoriais e faz buscas neles na memória, sem servidor.
Um índice é tão atual quanto os documentos por trás dele. As páginas mudam, então precisam ser buscadas de novo e ter os embeddings refeitos periodicamente, que é o trabalho de um web crawler quando os documentos estão na web.
Onde você encontra a busca semântica?
- Pesquisa Google: o Google diz que os sistemas dele comparam o significado das consultas e das páginas, não só as palavras.
- Busca de sites e centrais de ajuda: "meu pedido nunca chegou" encontra o artigo sobre entregas extraviadas.
- Chatbots e assistentes de IA: no RAG (geração aumentada por recuperação), a busca semântica encontra os trechos a partir dos quais o modelo responde.
- Lojas on-line: "sapatos para ficar em pé o dia todo" encontra calçados de trabalho cujos títulos nunca usam essa frase.
A busca semântica sobre conteúdo da web precisa primeiro das páginas. A sua própria central de ajuda é fácil de indexar; um assistente que responde a partir de fontes públicas, como documentação de produtos ou preços em muitas lojas, precisa coletar essas páginas, extrair o texto legível e buscá-lo de novo quando ele muda. Algumas páginas também variam conforme o país do visitante, então a cópia que você indexa deve vir do mercado em que seus usuários estão, por exemplo por meio de um proxy nesse país. A parte da coleta está em Web scraping para RAG: de HTML a chunks de Markdown limpos.
O que a busca semântica muda para o SEO?
Para o SEO, a busca semântica significa que o Google compara o significado de uma consulta com o significado de uma página; assim, uma página pode ranquear para formulações que nunca usa, e repetir variações de uma palavra-chave não acrescenta nada. O Google descreveu essa mudança em 2019, quando disse que o BERT o ajudava a entender cerca de uma em cada 10 buscas em inglês nos Estados Unidos; em um dos exemplos, a palavra "to" em "2019 brazil traveler to usa need a visa" decide em que direção a pessoa está viajando.
O guia sobre os sistemas de classificação da Pesquisa Google descreve três sistemas desse tipo. O BERT serve para entender "como as combinações de palavras expressam diferentes significados e intenções"; a correspondência neural entende "representações de conceitos em consultas e páginas" e faz a correspondência entre elas; o RankBrain retorna conteúdo relevante mesmo quando ele não tem todas as palavras exatas usadas na pesquisa. O Google não publica como esses sistemas são construídos, então trate as afirmações sobre "os vetores do Google" como palpites.
O guia de SEO para iniciantes tira a conclusão prática: os sistemas de correspondência de idiomas do Google "conseguem entender como a página está relacionada a muitas consultas", e você não precisa antecipar todas as variações de uma busca. As palavras-chave não sumiram, porém: o Google ainda chama de "o indicador mais básico" de relevância o fato de um conteúdo ter as mesmas palavras-chave da consulta.
- Escreva uma página completa por tema e intenção de busca, e não uma página rasa para cada variação de palavra-chave.
- Responda à pergunta logo e com clareza, do jeito que os leitores a fazem, e depois cubra as perguntas seguintes.
- Use os nomes exatos que os leitores usam para produtos, códigos de erro e lugares; a correspondência pelo significado não substitui a correspondência exata de um código.
- Deixe os truques de lado. Excesso de palavras-chave, texto oculto e páginas produzidas em massa para cobrir formulações aparecem nas políticas de spam do Google.
Onde a busca semântica falha?
A busca semântica falha onde a sequência exata importa mais do que o significado: códigos de produto, números de peça, códigos de erro, nomes e números. Para um modelo de embedding, "erro 0x80070005" e "erro 0x80070057" podem ficar muito próximos por serem o mesmo tipo de coisa, mas quem digitou um quer exatamente aquele.
- Nomes raros e palavras novas: um modelo treinado antes do lançamento de um produto nunca viu o nome dele.
- Negação e limites: "notebooks sem tela sensível ao toque" pode colocar no alto notebooks com tela sensível ao toque, porque o texto fala de telas sensíveis ao toque. Preços, datas e tamanhos funcionam melhor como filtros.
- Nenhum resultado vazio: sempre existem vizinhos mais próximos, então uma pergunta que seus documentos não conseguem responder ainda devolve os trechos "mais próximos". Sem um limite mínimo de similaridade, um assistente responde a partir de algo irrelevante.
- Idiomas e jargão: um modelo treinado principalmente com inglês geral pode ir pior em português ou com termos técnicos; teste-o com as suas próprias consultas.
A solução usual para os três primeiros problemas é a busca híbrida: um índice de palavras-chave para correspondências exatas e filtros, vetores para as paráfrases.
Erros comuns
- Misturar modelos de embedding. Consultas e documentos convertidos com modelos ou versões diferentes não podem ser comparados; um modelo novo significa refazer todos os embeddings.
- Um vetor por página longa. A média de dez assuntos não combina bem com nenhum deles. Indexe trechos.
- Abandonar a busca por palavras-chave. Os usuários continuam colando números de pedido, códigos de erro e nomes.
- Não ter um conjunto de teste. Mantenha algumas dezenas de consultas reais com o resultado que cada uma deve trazer e confira os 10 primeiros depois de cada mudança.
- Deixar as permissões fora do índice. Se as permissões de acesso não forem filtradas com cada trecho, o índice entrega documentos internos às pessoas erradas.
- Indexar o que você não pode usar. Páginas cujos termos proíbem a reutilização, ou páginas cheias de dados pessoais cobertos pelo GDPR ou pela KVKK da Türkiye, não ficam liberadas só porque viraram vetores.
Guia de decisão
| A sua situação | O que usar |
|---|---|
| Os usuários buscam por código de produto, SKU ou nome | Busca por palavras-chave com lista de termos equivalentes |
| Os usuários fazem perguntas com as próprias palavras | Busca semântica com um modelo de embedding |
| Os dois tipos de consulta | Busca híbrida com fusão por posição |
| Alguns milhares de trechos | Busca exata na memória ou no banco de dados atual |
| Milhões de trechos com filtros | Um índice ANN em um banco de dados vetorial ou mecanismo de busca |
| Um chatbot que precisa citar fontes | Recuperação híbrida, um reranker, um endereço de origem por trecho |
| Uma página que não aparece no Google para formulações próximas | Uma página completa por tema e intenção |
| Respostas tiradas de páginas web públicas | Coletar e atualizar as páginas antes de indexar |
Perguntas frequentes
Busca semântica é o mesmo que busca vetorial?
Não exatamente. A busca semântica é o objetivo: encontrar resultados pelo significado. A busca vetorial é a técnica usual para isso: encontrar os vetores mais próximos em um índice. A busca vetorial também pode comparar imagens ou sons, e uma busca semântica simples pode ser feita sem vetores, com listas de termos equivalentes e reescrita de consultas.
Qual é a diferença entre busca semântica e RAG?
A busca semântica encontra e ordena trechos. O RAG coloca os trechos que uma busca devolveu no prompt de um modelo de linguagem e faz o modelo escrever uma resposta a partir deles; ou seja, a busca semântica costuma ser a etapa de recuperação dentro do RAG. Agentes de pesquisa com IA rodam muitas dessas buscas em um loop, como explica o nosso guia sobre deep research.
O que é similaridade de cosseno na busca semântica?
A similaridade de cosseno mede o ângulo entre dois vetores: 1 significa que eles apontam na mesma direção, e valores perto de 0 significam que os textos têm pouco em comum. Ela ignora o comprimento, então um texto longo e um curto sobre o mesmo assunto ainda podem marcar perto de 1. No exemplo acima, os dois textos sobre voos marcam 0,997 em relação à consulta, e o texto sobre hotéis, 0,269.
Qual é a diferença entre um banco de dados vetorial e um relacional?
Um banco de dados relacional encontra as linhas que atendem a uma condição exata, como um preço abaixo de 50, e não devolve nada quando nenhuma linha atende. Um banco de dados vetorial encontra os itens mais parecidos com um vetor dado e sempre devolve os mais próximos. Muitos sistemas usam os dois: filtros relacionais, ordenação vetorial.
Preciso de um banco de dados vetorial para busca semântica?
Nem sempre. Para alguns milhares de trechos, a busca exata na memória ou uma extensão vetorial como o pgvector em um banco de dados que você já usa costuma bastar. Um banco de dados vetorial dedicado compensa com milhões de vetores, atualizações frequentes, filtros rígidos ou várias aplicações compartilhando um índice.
O que é SEO semântico?
SEO semântico é um nome do mercado para escrever páginas em torno de temas, entidades e intenção de busca, em vez de palavras-chave isoladas. Ele decorre do que o Google diz sobre como compara significados: responda à pergunta por completo, use as palavras dos seus leitores e deixe uma boa página cobrir as variações de uma consulta.
Em resumo
A busca semântica encontra resultados pelo significado: um modelo transforma trechos e consultas em embeddings, um índice encontra os trechos mais próximos da consulta e um reranker opcional refina a ordem. Ela supera a busca por palavras-chave em paráfrases e perguntas naturais e perde em códigos, nomes e números exatos, por isso a busca híbrida com fusão por posição é uma escolha comum em produção. Para o SEO, os próprios guias do Google apontam para páginas completas por tema e intenção, e não para variações de palavra-chave. Quando o índice é montado com páginas web públicas, coletá-las é a parte difícil; a nossa Web Scraping API, um serviço de extração gerenciada de páginas disponível pela equipe de vendas, está descrita na página de extração de dados.