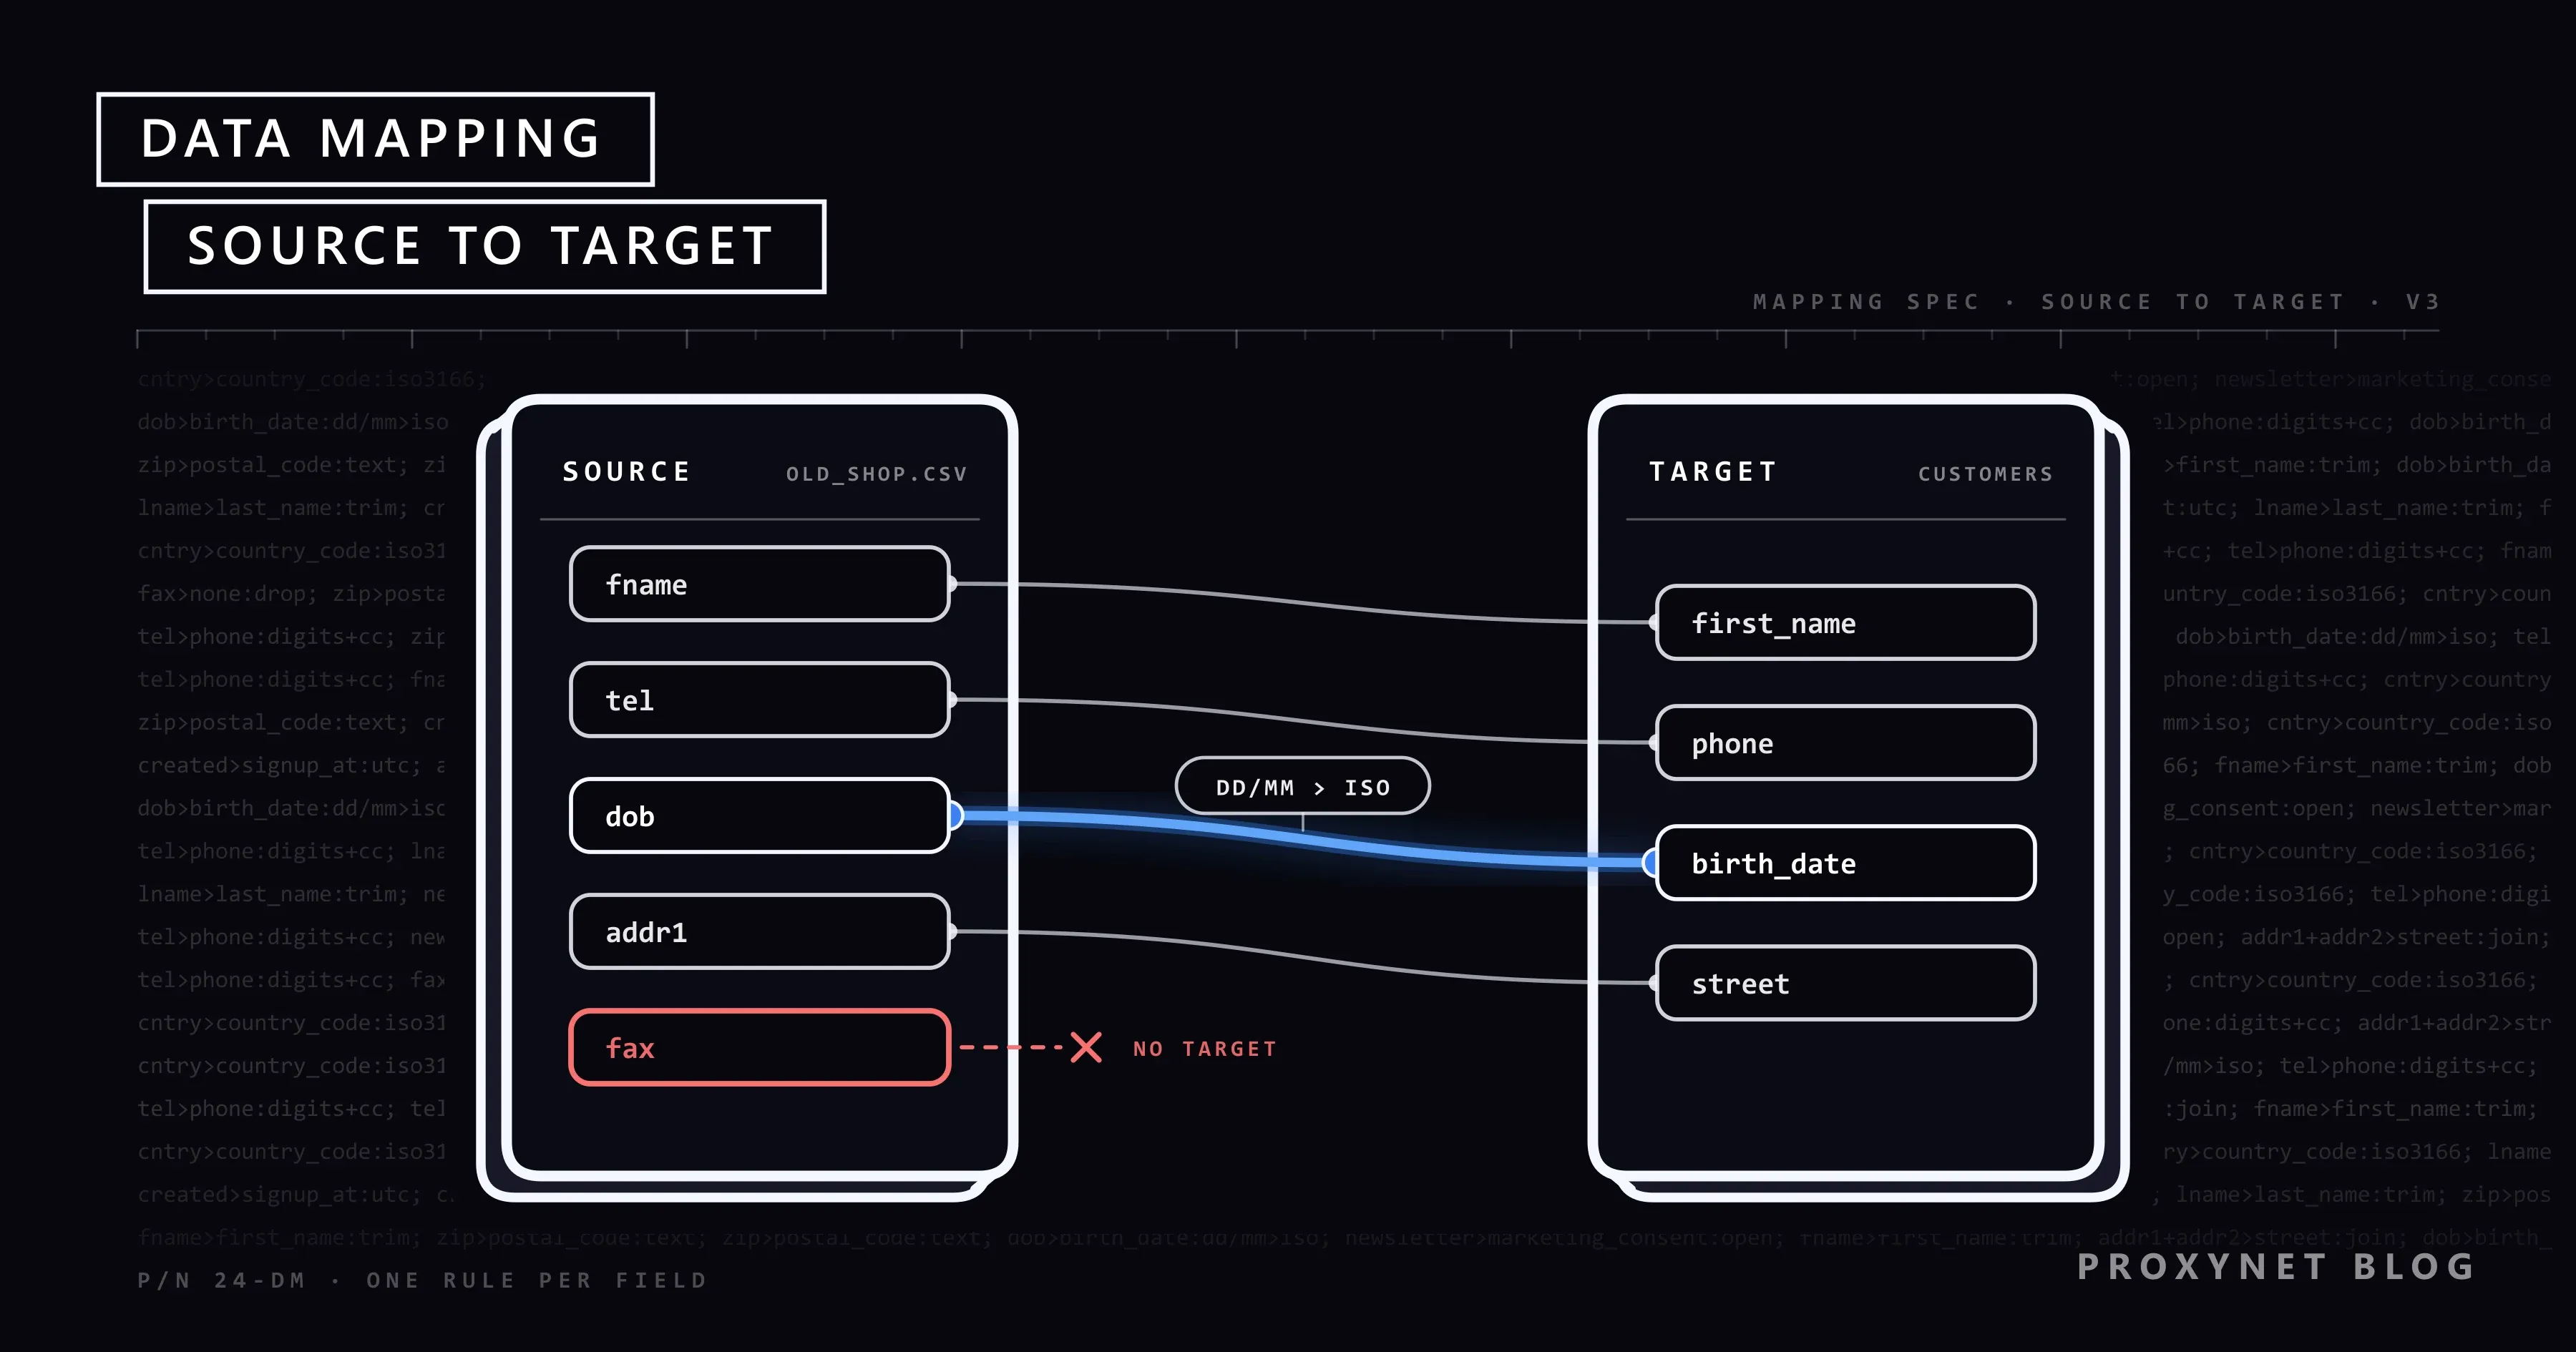
Ein kleiner Onlineshop zieht auf eine neue E-Commerce-Plattform um. Das alte System exportiert 38.000 Kunden mit Spalten namens fname, tel und dob, und die Geburtstage sehen aus wie 03/04/1990; die neue Plattform erwartet first_name, eine Telefonnummer mit Ländervorwahl und Datumsangaben in der Form 1990-04-03. Bevor irgendetwas importiert wird, muss jemand Spalte für Spalte festlegen, wohin jeder Wert gehört und wie er sich unterwegs verändert. Diese Tabelle mit Entscheidungen ist eine Datenkarte, und sie zu erstellen heißt Data Mapping.
Eine Woche später stellt die Datenschutzverantwortliche des Shops unter demselben Begriff eine ganz andere Frage: Welche Systeme enthalten Kundendaten, zu welchem Zweck, und wer erhält sie? Dieser Beitrag behandelt beide Bedeutungen: das Feld-Mapping und sein Dokument, die wichtigsten Vorgehensweisen und die Art, wie Datenschutzteams personenbezogene Daten für die DSGVO und das türkische Gesetz Nr. 6698 über den Schutz personenbezogener Daten (KVKK) erfassen.
Was ist Data Mapping?
Data Mapping ist die Arbeit, zu beschreiben, wie Daten an einem Ort den Daten an einem anderen Ort entsprechen. Das Ergebnis ist eine Karte: eine Liste von Paaren (dieses Quellfeld wird zu jenem Zielfeld) mit einer Regel für jedes Paar oder, im Datenschutz, eine Liste, wo personenbezogene Daten liegen und wohin sie gehen.
Der Begriff deckt zwei Aufgaben ab, die eine Methode teilen, aber verschiedenen Lesern dienen:
| Bedeutung | Beantwortete Frage | Üblicherweise zuständig | Ergebnis |
|---|---|---|---|
| Integrations-Mapping | Wohin gehört jedes Feld, und wie verändert es sich? | Data Engineer oder Analyst | Mapping-Dokument von Quelle zu Ziel |
| Datenschutz-Mapping | Welche personenbezogenen Daten haben wir, warum, und wohin fließen sie? | Datenschutzverantwortliche oder Datenschutzbeauftragter | Dateninventar, Datenflusskarte, Verarbeitungsverzeichnis |
Wie funktioniert das Mapping von Feld zu Feld?
Das Mapping von Feld zu Feld funktioniert so: Man listet die Felder beider Seiten auf, bildet Paare und schreibt für jedes Paar eine Umwandlungsregel, bevor irgendwelche Daten bewegt werden. Ein typischer Ablauf hat sieben Schritte:
- Die Quelle profilieren. Listen Sie jedes Feld mit Typ, einigen Beispielwerten, dem Anteil leerer Einträge und dem verwendeten Format auf. Eine Spalte namens
phonekann Festnetznummern, Mobilnummern und die Worte „an der Rezeption fragen“ enthalten. - Das Zielschema festlegen. Ein Schema ist die formale Beschreibung einer Datenstruktur: welche Felder es gibt, welche Typen sie haben, welche Pflicht sind und welche Werte erlaubt sind.
- Die Felder paaren. Ordnen Sie jedes Quellfeld einem Zielfeld zu. Manche Paare sind eins zu eins; andere teilen ein Feld in zwei auf oder fügen mehrere zu einem zusammen.
- Die Transformationsregeln schreiben. Legen Sie fest, wie sich jeder Wert ändert: Datumsformate, Dezimaltrennzeichen, Einheiten, Währungen, Codelisten (
MundFzumaleundfemale), das Entfernen von Leerzeichen und Standardwerte für leere Felder. - Entscheiden, was nicht übernommen wird. Jedes Quellfeld wird am Ende zugeordnet, bewusst verworfen oder als offene Frage markiert. Stilles Weglassen ist der Weg, auf dem Daten verloren gehen.
- Mit echten Stichproben testen. Schicken Sie einige hundert Einträge durch die Regeln und vergleichen Sie das Ergebnis von Hand mit der Quelle, auch bei leeren Feldern, Namen mit Akzenten und Extremwerten.
- Ausführen, überwachen, versionieren. Zählen Sie bei jedem Lauf die ein- und ausgehenden Einträge, protokollieren Sie abgewiesene Zeilen und versionieren Sie die Karte, damit eine Änderung in einem der beiden Systeme zu einer Änderung der Karte führt.
In Schritt 4 verstecken sich die meisten Fehler. Auf unserem Testrechner interpretierte Node.js 24 die Zeichenfolge „03/04/1990“ als 4. März 1990, nicht als 3. April; in UTC umgerechnet wurde daraus der 3. März, weil die Uhr des Rechners an diesem Datum zwei Stunden vor UTC lag, und „13/04/1990“ wurde als ungültiges Datum abgelehnt. Eine Regel, die nur „Geburtsdatum zu ISO-Datum“ sagt, ohne die Reihenfolge in der Quelle zu nennen (Tag zuerst oder Monat zuerst), überlässt diese Wahl dem Parser, der gerade zufällig läuft.
Wie sieht ein Data-Mapping-Dokument aus?
Ein Data-Mapping-Dokument ist eine Tabelle mit einer Zeile pro Feld, die zeigt, woher jeder Wert kommt, wohin er geht und welche Regel ihn verändert. Für die Shop-Migration von oben:
| Quellfeld | Zielfeld | Regel |
|---|---|---|
fname | first_name | Leerzeichen am Rand entfernen |
tel | phone | Nur Ziffern, Ländervorwahl ergänzen |
dob | birth_date | Als DD/MM/YYYY lesen, als YYYY-MM-DD schreiben |
addr1 + addr2 | street | Mit einem Leerzeichen verbinden |
cntry | country_code | Ländername zu zweistelligem Code nach ISO 3166 |
fax | (keins) | Verworfen: nicht mehr genutzt |
newsletter | marketing_consent | Offen: Einwilligungsnachweise prüfen |
Echte Dokumente ergänzen Spalten für Datentyp, Verantwortliche und Teststatus; die meisten „Data-Mapping-Vorlagen“ sind genau diese Tabelle mit diesen zusätzlichen Spalten. Die letzten beiden Zeilen sind die wichtigsten. Ein verworfenes Feld ist eine Entscheidung, die jemand freigegeben hat, und eine Einwilligung lässt sich nicht einfach annehmen: Hat das alte System nie festgehalten, wie eine Einwilligung erteilt wurde, darf das neue sie nicht als erteilt anzeigen.
Welche Arten von Data Mapping gibt es?
Data Mapping wird auf drei Arten erledigt: manuell, schemabasiert mit Werkzeugunterstützung und automatisiert mit Zuordnungsvorschlägen. Die meisten echten Projekte mischen alle drei.
| Vorgehen | Funktionsweise | Passt zu | Hauptrisiko |
|---|---|---|---|
| Manuell | Menschen paaren Felder in einer Tabellenkalkulation | Kleine oder einmalige Migrationen | Tippfehler, keine Tests |
| Schemabasiert | Beide Schemas in einem Werkzeug; Regeln im Editor oder im Code | Wiederkehrende Integrationen, ETL | Code und Dokument laufen auseinander |
| Automatisiert | Werkzeug schlägt Paare nach Namen, Typen und Beispielwerten vor | Viele ähnliche Quellen | Selbstsichere falsche Treffer |
Automatische Vorschläge sparen Zeit bei offensichtlichen Paaren wie email zu email_address, aber ein Name sagt wenig über die Bedeutung: date ist in einer Quelle das Bestelldatum und in einer anderen das Lieferdatum. Behandeln Sie jedes vorgeschlagene Paar als Vorschlag, den ein Mensch bestätigt.
Feldbeziehungen gibt es in mehreren Formen, und jede braucht ihre eigene Regel: eins zu eins, viele zu eins (zwei Adresszeilen werden verbunden), eins zu viele (ein vollständiger Name wird in zwei Teile zerlegt, was bei vielen echten Namen scheitert), Nachschlagen über eine Referenztabelle und Konstanten, die in der Quelle fehlen.
Worin unterscheidet sich Data Mapping von Transformation, ETL und Data Lineage?
Data Mapping ist die Spezifikation, die Transformation ist die Ausführung ihrer Regeln, ETL ist die Pipeline, die sie ausführt, und Data Lineage (Datenherkunft) ist der Nachweis, woher ein Wert tatsächlich stammt. Die Karte sagt „dob wird zu birth_date, Tag zuerst lesen“; die Transformation ist der Schritt, der das erledigt. ETL (Extrahieren, Transformieren, Laden) holt Daten aus der Quelle, wendet diese Transformationen an und lädt das Ergebnis in eine Datenbank, wie Was ist ETL? Schritt für Schritt zeigt.
Data Lineage blickt zurück: Für eine Zahl auf einem Dashboard zeigt sie, welche Tabellen, Jobs und Quellfelder sie erzeugt haben, und ein gutes Mapping-Dokument macht diese Spur leichter nachvollziehbar. Ein Data Dictionary (Datenwörterbuch) beschreibt die Felder eines einzelnen Systems, ohne sie zu einem anderen in Beziehung zu setzen.
Das Mapping kommt außerdem vor der Bereinigung. Sobald die Felder zueinander passen, werden falsche, doppelte oder widersprüchliche Werte sichtbar und lassen sich korrigieren; Was ist Datenbereinigung? behandelt diesen Schritt.
Was bedeutet Data Mapping im Datenschutz?
Im Datenschutz bedeutet Data Mapping herauszufinden, welche personenbezogenen Daten eine Organisation hat, wo sie gespeichert sind, warum sie verarbeitet werden, wer sie erhält und wie lange sie aufbewahrt werden. Personenbezogene Daten sind alle Informationen über eine identifizierte oder identifizierbare Person: ein Name, eine E-Mail-Adresse, eine Kundennummer, eine IP-Adresse in einem Serverprotokoll.
Datenschutzteams erstellen meist zwei Dinge. Ein Dateninventar listet Verarbeitungstätigkeiten auf (Lohnabrechnung, Bewerbungen, Bestellabwicklung, Newsletter) mit den Daten und Systemen, die jede davon nutzt. Eine Datenflusskarte zeigt, wie sich diese Daten bewegen: aus einem Webformular in die Shop-Datenbank, weiter zu einem Zahlungsdienstleister, jede Nacht in ein CRM, jeden Monat zu einem Steuerbüro im Ausland. In den Flüssen zeigen sich die Überraschungen, etwa ein Support-Werkzeug, das vollständige Kundendatensätze auf einen Server in einem anderen Land kopiert.
Was verlangt Artikel 30 DSGVO?
Artikel 30 DSGVO verpflichtet jeden Verantwortlichen, also die Stelle, die über Zwecke und Mittel der Verarbeitung personenbezogener Daten entscheidet, ein schriftliches Verzeichnis seiner Verarbeitungstätigkeiten zu führen, im deutschen Sprachgebrauch oft VVT abgekürzt (englisch RoPA). Das Verzeichnis muss Folgendes enthalten:
- Namen und Kontaktdaten des Verantwortlichen sowie gegebenenfalls seines Vertreters und seines Datenschutzbeauftragten;
- die Zwecke der Verarbeitung;
- die Kategorien betroffener Personen und die Kategorien personenbezogener Daten;
- die Kategorien von Empfängern, einschließlich Empfängern in anderen Ländern;
- Übermittlungen in Länder außerhalb der EU oder an internationale Organisationen;
- wenn möglich, die vorgesehenen Löschfristen für jede Datenkategorie;
- wenn möglich, eine allgemeine Beschreibung der Sicherheitsmaßnahmen.
Auftragsverarbeiter, also Unternehmen, die Daten im Auftrag eines Verantwortlichen verarbeiten, etwa ein Hosting- oder Lohnabrechnungsdienstleister, führen ein eigenes, kürzeres Verzeichnis. Beide Verzeichnisse dürfen elektronisch geführt werden und müssen der Aufsichtsbehörde auf Anfrage vorgelegt werden (DSGVO-Text auf EUR-Lex).
Die Ausnahme für Organisationen mit weniger als 250 Mitarbeitern ist enger, als sie klingt. Sie gilt nur, wenn die Verarbeitung voraussichtlich kein Risiko für die Rechte der Betroffenen birgt, nur gelegentlich erfolgt und weder besondere Kategorien personenbezogener Daten (etwa Gesundheitsdaten) noch Daten über strafrechtliche Verurteilungen umfasst. Lohnabrechnung und Kundendatenbank sind keine gelegentliche Verarbeitung, deshalb führen die meisten kleinen Unternehmen trotzdem ein Verzeichnis. Die Europäische Kommission hat Änderungen an dieser Ausnahme vorgeschlagen; am 19. November 2026 führt EUR-Lex sie weiterhin als Vorschläge, nicht als geltende Änderungen.
Der Leitfaden des Europäischen Datenschutzausschusses (EDSA) für kleine Unternehmen bietet einen praktischen Einstieg: Ermitteln Sie, welche Ihrer Tätigkeiten personenbezogene Daten betreffen, etwa Personalgewinnung, Lohnabrechnung oder Zutrittsausweise, und beschreiben Sie jede davon (EDSA-Leitfaden für kleine Unternehmen). Die Datenkarte ist das Arbeitsmaterial, das Verzeichnis nach Artikel 30 das formale Dokument, das daraus entsteht; die zusätzlichen Details der Karte (Tabellennamen, Felder, Server) halten das Verzeichnis korrekt.
Dieselbe Karte speist auch eine Datenschutz-Folgenabschätzung (DSFA). Artikel 35 verlangt sie vor einer Verarbeitung, die voraussichtlich ein hohes Risiko für Menschen mit sich bringt, etwa die umfangreiche Verarbeitung von Gesundheitsdaten, und niemand kann das Risiko von Daten einschätzen, die er nicht gefunden hat.
Das türkische Datenschutzgesetz Nr. 6698 (KVKK) kennt ein enges Gegenstück. Nach der türkischen Verordnung über das Register der Verantwortlichen erstellen Verantwortliche, die sich im öffentlichen Register VERBIS eintragen müssen, ein Inventar der Verarbeitung personenbezogener Daten. Es umfasst Zwecke und Rechtsgrundlagen, Datenkategorien, Empfängergruppen, Personengruppen, maximale Aufbewahrungsfristen, geplante Übermittlungen ins Ausland und Sicherheitsmaßnahmen, und der Registereintrag stützt sich darauf.
Wie erstellen Sie eine Karte personenbezogener Daten?
Sie erstellen eine Karte personenbezogener Daten, indem Sie bei den Geschäftstätigkeiten beginnen statt bei den Datenbanken und dann jede Tätigkeit zu ihren Systemen, Daten und Empfängern verfolgen:
- Die Tätigkeiten auflisten. Fragen Sie jedes Team, was es mit Informationen über Menschen tut: Personalgewinnung, Lohnabrechnung, Vertrieb, Support, Marketing, Website-Analyse, Sicherheitsprotokolle.
- Die Systeme finden. Nennen Sie die Anwendungen, Datenbanken, Tabellen, Netzlaufwerke und Postfächer, die jede Tätigkeit nutzt, einschließlich Software, die Dienstleister für Sie betreiben.
- Daten und Personen festhalten. Notieren Sie, welche Datenkategorien (Kontakt, Zahlung, Gesundheit) über welche Gruppen (Kunden, Beschäftigte, Bewerber, Besucher) gespeichert sind.
- Zweck und Rechtsgrundlage notieren. Schreiben Sie auf, warum die Daten verarbeitet werden und auf welcher Grundlage das Gesetz es erlaubt.
- Die Flüsse verfolgen. Halten Sie fest, woher die Daten kommen, welche Dienstleister sie erhalten und ob sie das Land verlassen.
- Aufbewahrung und Sicherheit festlegen. Geben Sie an, wie lange jede Kategorie aufbewahrt wird und was sie schützt.
- Aktuell halten. Koppeln Sie Aktualisierungen an Ereignisse: ein neues Werkzeug, ein neuer Dienstleister, ein neues Formular auf der Website.
Teams, die öffentliche Webdaten erheben, sollten auch diese Datensätze aufnehmen, denn gescrapte Seiten enthalten oft Namen, Profillinks oder E-Mail-Adressen; der Beitrag dazu, wie Sie mit personenbezogenen Daten in Scraping-Datensätzen umgehen, erklärt, wie man solche Felder reduziert.
Wo kommen Proxys beim Data Mapping ins Spiel?
Proxys kommen vor dem Mapping ins Spiel, in der Erhebungsphase, wenn die Daten, die Sie zuordnen, von öffentlichen Webseiten in mehreren Ländern stammen. Eine Produktseite in Deutschland schreibt den Preis mit Dezimalkomma, die US-Version mit Punkt, und eine Website kennzeichnet den Bestand mit availability, während eine andere nur ein Abzeichen zeigt. Ein Proxy-Ausgang in jedem Land zeigt die Seite, die ein lokaler Besucher sieht, und alle Versionen auf ein Schema abzubilden (Produkt, Preis, Währung, Bestand, Land, Erhebungszeitpunkt) ist der erste Schritt vor jedem Vergleich. Teams, die die Daten lieber schon strukturiert erhalten, können unsere Web Scraping API nutzen, eine verwaltete Seitenextraktion, erhältlich über unser Vertriebsteam.
Eine Datenkarte ist auch ein Sicherheitswerkzeug: Sie zeigt, was ein Datenleck offenlegen würde. Sicherheitsteams, die öffentliche Quellen auf geleakte Unternehmensdaten überwachen, nutzen Proxys für Datensicherheit, um diese Recherche getrennt vom eigenen Netzwerk durchzuführen, innerhalb der rechtlichen Grenzen, die dafür gelten.
Wo wird Data Mapping eingesetzt?
- Datenmigrationen: der Umzug auf ein neues CRM, eine neue Shop-Plattform oder ein neues Buchhaltungssystem.
- ETL und Data Warehouses: viele Systeme in ein gemeinsames Berichtsmodell laden.
- Integrationen: Bestellungen zwischen einem Shop und einem Rechnungsprogramm synchron halten.
- Fusionen: Kunden- und Produktdaten zweier Unternehmen zusammenführen.
- Webdaten: Seiten vieler Websites und Länder in eine einzige Tabelle überführen.
- Datenschutz-Compliance: das Verzeichnis nach DSGVO, das KVKK-Inventar, Datenschutz-Folgenabschätzungen und Anfragen von Personen, die eine Kopie ihrer Daten verlangen.
Häufige Fehler
- Nur nach dem Feldnamen zuordnen.
date,statusundtypebedeuten in verschiedenen Systemen Verschiedenes. - Quellformate nicht benennen. Datumsangaben, Dezimaltrennzeichen, Einheiten und Zeichenkodierungen brauchen eine ausdrückliche Regel.
- Felder stillschweigend weglassen. Jedes nicht zugeordnete Feld braucht eine festgehaltene Entscheidung.
- Nur saubere Zeilen testen. Leere Felder, lange Namen und fremde Schriftzeichen brechen Regeln, die bei ordentlichen Stichproben funktionieren.
- Das Dokument mit dem Go-live für fertig halten. Eine Schemaänderung ohne Kartenänderung beschädigt Daten unbemerkt.
- Einwilligungen ohne Nachweis übernehmen. Sie brauchen einen Beleg, keinen Standardwert.
- Die Datenschutzkarte nur aus IT-Systemen erstellen. Tabellen, Postfächer und Werkzeuge von Dienstleistern enthalten ebenfalls personenbezogene Daten.
Entscheidungshilfe
| Bedarf | Empfehlung |
|---|---|
| Daten einmalig in ein neues System übertragen | Tabelle von Quelle zu Ziel, an Stichproben getestet |
| Wiederkehrende Integration | Schemabasiertes Mapping im ETL-Werkzeug, versioniert |
| Viele ähnliche Quellen (Feeds, Websites) | Ein Zielschema; Werkzeugvorschläge von einem Menschen bestätigt |
| Verzeichnis von Verarbeitungstätigkeiten nach DSGVO | Zuerst ein Inventar nach Tätigkeiten, dann das Verzeichnis nach Artikel 30 |
| Verarbeitung mit hohem Risiko geplant | Zuerst die Datenkarte, dann eine DSFA |
| Registrierter Verantwortlicher in Türkiye | KVKK-Verarbeitungsinventar als Grundlage für VERBIS |
| Eine Person verlangt ihre Daten | Mit der Karte jedes System finden, das sie speichert |
Häufige Fragen
Was ist Data Mapping, einfach erklärt?
Data Mapping heißt festzulegen, wohin jedes Datenelement geht, wenn es von einem System in ein anderes wandert, und wie es sich dabei verändert. Im Datenschutz bedeutet es aufzulisten, wo personenbezogene Daten gespeichert sind, warum, und wer sie erhält.
Was ist ein Beispiel für Data Mapping?
Ein Shop, der auf eine neue Plattform umzieht, ordnet seine alte Spalte fname dem neuen Feld first_name zu und wandelt Geburtstage von 03/04/1990 in 1990-04-03 um. Ein Beispiel aus dem Datenschutz ist eine Tabelle, die zeigt, dass Kunden-E-Mail-Adressen in der Shop-Datenbank liegen, an ein Newsletter-Werkzeug gehen und zwei Jahre nach der letzten Bestellung gelöscht werden.
Kann ich Data Mapping in Excel machen?
Ja. Für einmalige Migrationen ist eine Tabellenkalkulation das häufigste Format: eine Zeile pro Feld mit Quelle, Ziel, Regel, Typ und Status. Bei wiederkehrenden Integrationen bleibt die Tabelle die Spezifikation und die Regeln liegen im ETL-Werkzeug; aktualisieren Sie beides gemeinsam.
Was bedeutet Data Mapping nach der DSGVO?
Es ist die Vorarbeit für das Verzeichnis nach Artikel 30: welche personenbezogenen Daten Sie verarbeiten, warum, über wen, wer sie erhält, wohin sie gehen und wie lange sie aufbewahrt werden. Die Verordnung verlangt das Verzeichnis, kein Diagramm, aber nur wenige Organisationen können ein korrektes Verzeichnis schreiben, ohne vorher zu kartieren.
Ist eine Datenkarte dasselbe wie ein Verzeichnis von Verarbeitungstätigkeiten?
Nein. Die Datenkarte ist die detaillierte Arbeitsansicht von Systemen, Feldern und Flüssen; das Verzeichnis ist die formale Liste, die die DSGVO verlangt, geordnet nach Tätigkeiten. Die meisten Teams erstellen das Verzeichnis aus der Karte.
Wer ist für Data Mapping verantwortlich?
Bei Integrationen gehört das Mapping-Dokument den Data Engineers oder dem Migrationsteam, und die fachlich Verantwortlichen bestätigen die Bedeutung jedes Feldes. Im Datenschutz ist der Verantwortliche zuständig, meist über eine Datenschutzverantwortliche oder einen Datenschutzbeauftragten, der die Angaben aller Teams sammelt.
Fazit
Data Mapping bedeutet, Felder zwischen Systemen mit einer schriftlichen Regel für jedes Paar zuzuordnen und für den Datenschutz personenbezogene Daten, ihre Zwecke und ihre Flüsse zu erfassen. Das Feld-Mapping scheitert an unbenannten Formaten und stillem Weglassen; das Datenschutz-Mapping beginnt bei den Tätigkeiten und wird zum Verzeichnis nach Artikel 30 DSGVO oder, in Türkiye, zum KVKK-Inventar. Wenn Ihre Quellen öffentliche Webseiten in mehreren Ländern sind, bilden Sie sie von Anfang an auf ein Schema ab und erheben Sie jede Seite aus dem Land, das sie beschreibt, zum Beispiel über einen Residential-Proxy mit Länder-Targeting.