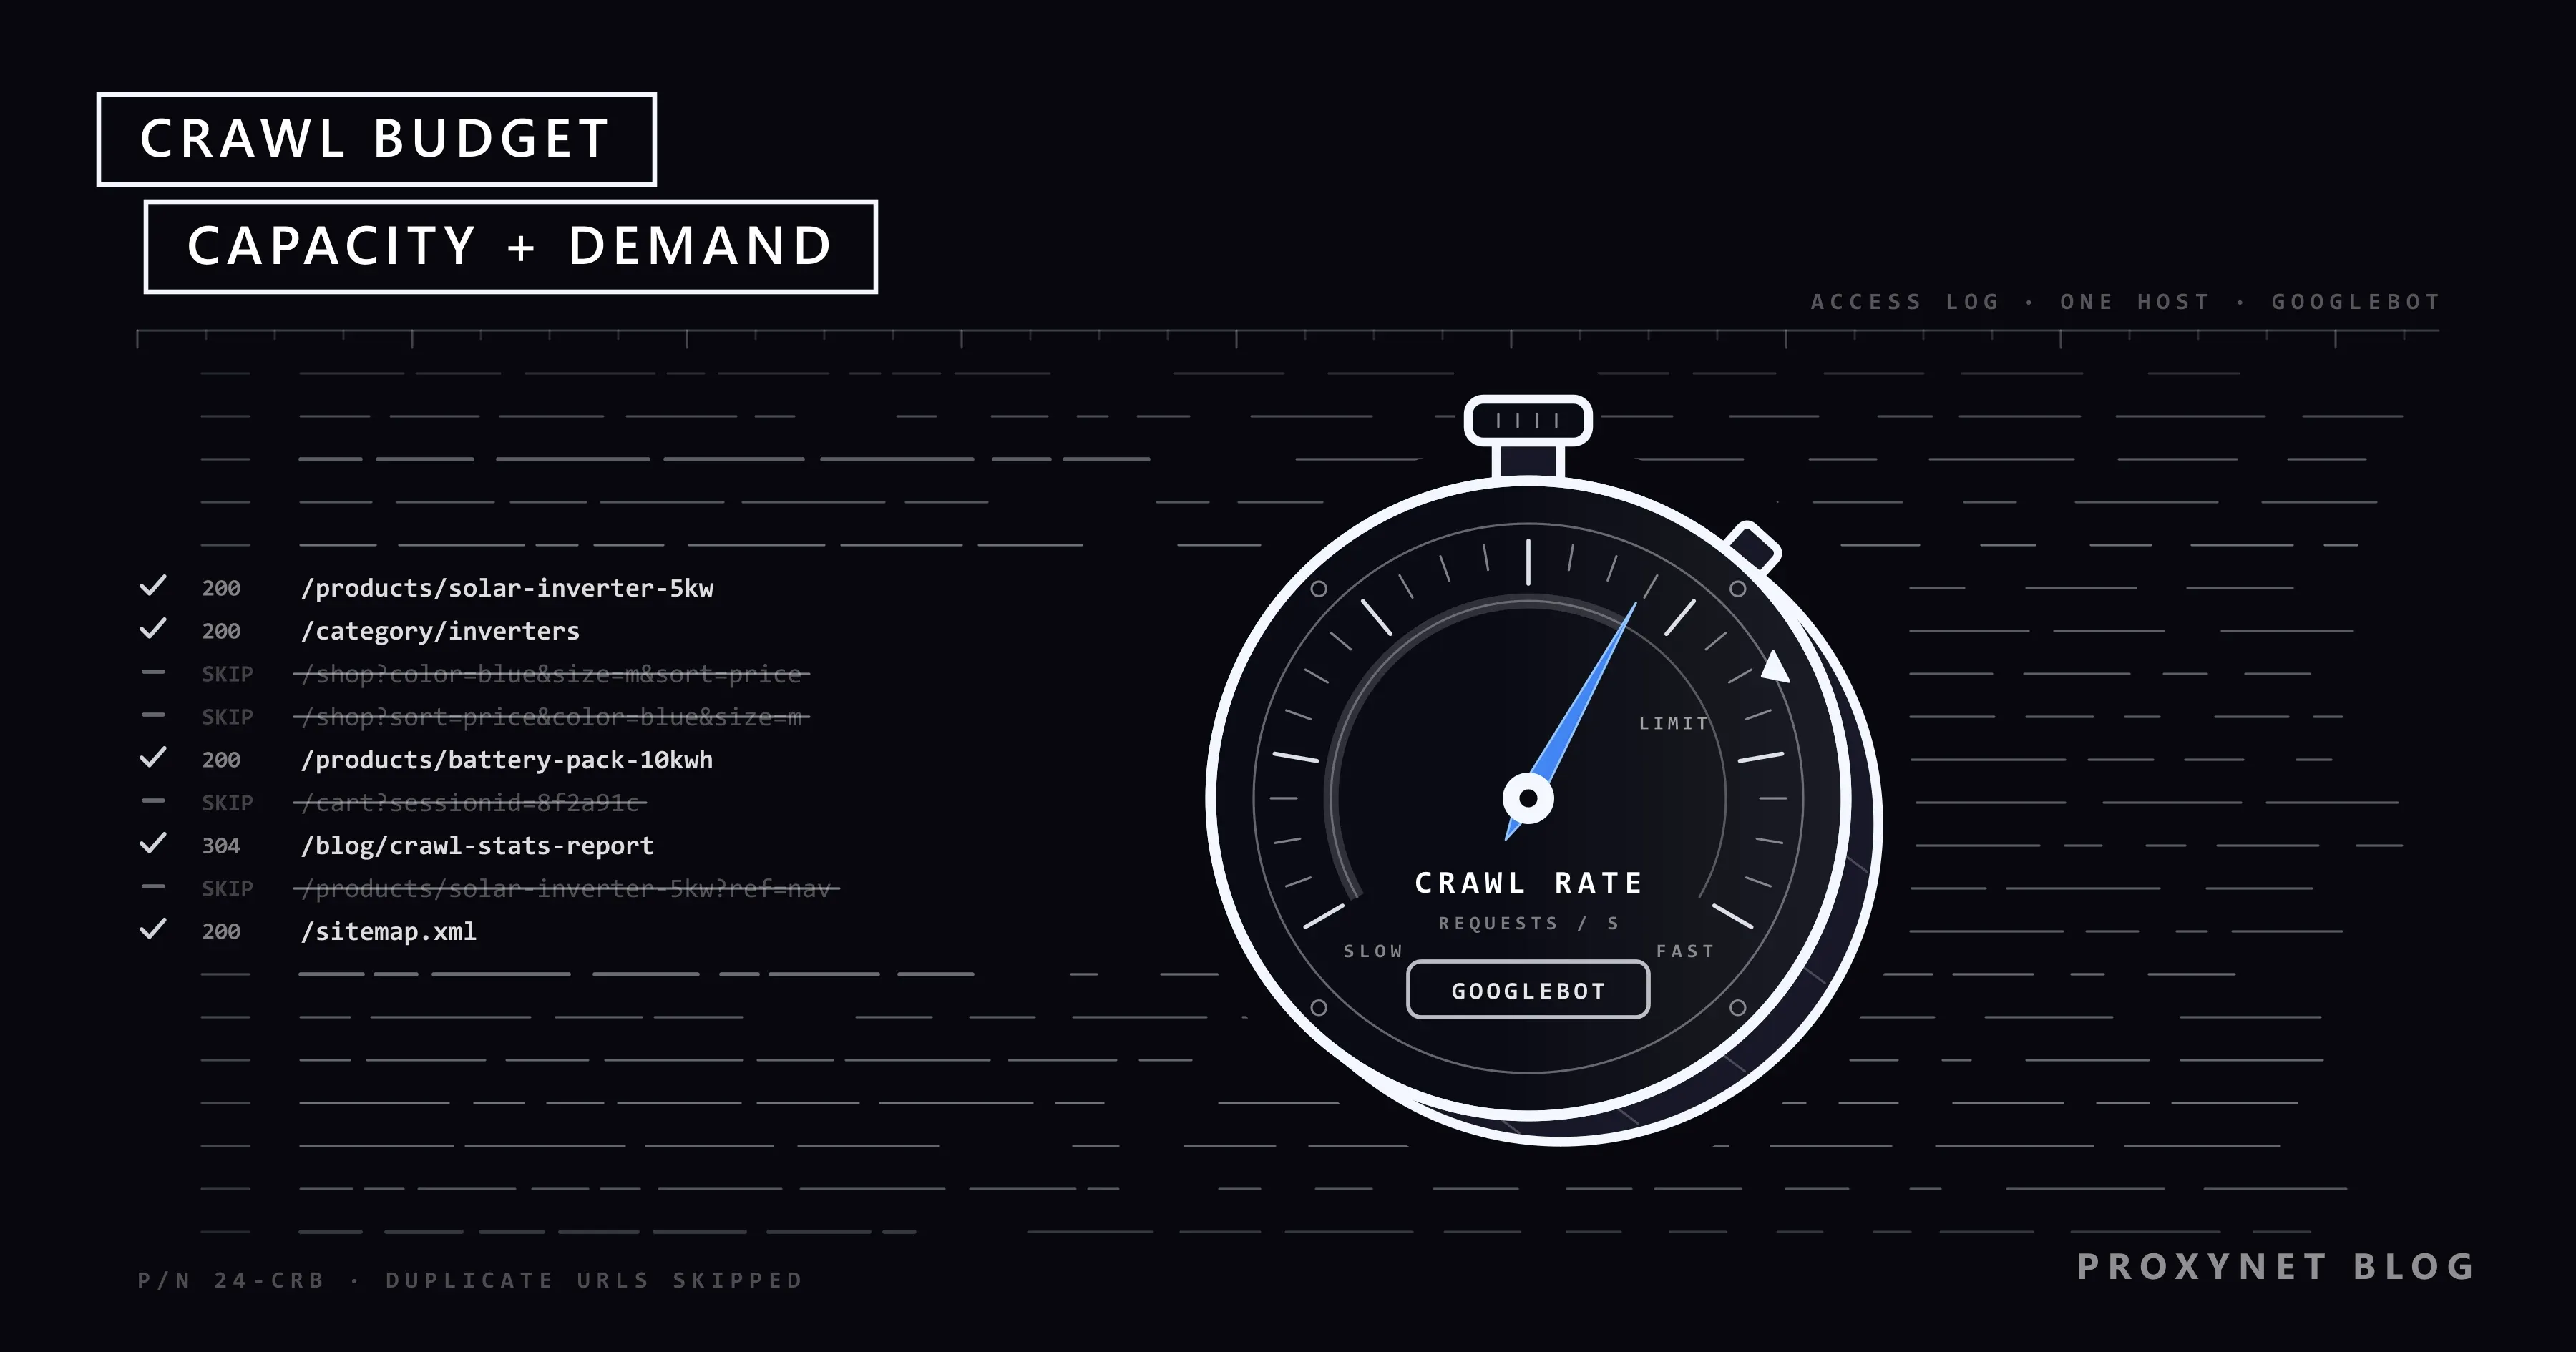
Sie fügen einem Onlineshop 20.000 Produktseiten hinzu, reichen die Sitemap ein, und drei Wochen später führt die Search Console die meisten davon als „Gefunden – zurzeit nicht indexiert“. Ihre Serverlogs erzählen die andere Hälfte der Geschichte: Der Googlebot war fleißig, aber vor allem auf Filteradressen wie ?color=blue&size=m&sort=price. Die Seiten, auf die es Ihnen ankommt, stehen in einer Warteschlange, die nur begrenzt schnell vorankommt. SEO-Fachleute nennen diese Grenze Crawl-Budget.
Dieser Artikel erklärt das Crawl-Budget mit Googles eigenen Begriffen, welche Websites sich darum kümmern sollten und wie der Googlebot von einer gefundenen URL bis zur Indexierung gelangt. Danach geht es darum, was Crawls verschwendet, wie Sie sie prüfen, was die beiden Status „zurzeit nicht indexiert“ bedeuten und wie Sie einen gefälschten Googlebot erkennen.
Was ist das Crawl-Budget?
Das Crawl-Budget ist die Zahl der URLs, die Google auf Ihrer Website crawlen kann und will, und der Begriff stammt von Google selbst, das ihn auf Deutsch Crawling-Budget nennt: Der Leitfaden Crawling-Budget optimieren beschreibt es als Budget für die URLs einer Website, die Google crawlen kann und möchte. Crawlen heißt, dass ein Programm, hier der Googlebot, eine URL anfordert und herunterlädt, was der Server zurückgibt. Ohne vorheriges Crawling gelangt nichts in den Index von Google.
Das Budget gilt pro Hostname; www.example.com und shop.example.com haben also jeweils ein eigenes. Es gibt keine Zahl, die Sie nachschlagen oder in einer Einstellung erhöhen könnten; das Budget ergibt sich aus zwei Größen, die Google laufend misst.
Was sind Crawling-Kapazitätslimit und Crawling-Bedarf?
Das Crawling-Kapazitätslimit gibt an, wie viel der Googlebot crawlen kann, ohne Ihren Server zu überlasten, und der Crawling-Bedarf, wie viel er crawlen will. In der Praxis bestimmt der kleinere der beiden Werte Ihr Budget.
Das Crawling-Kapazitätslimit, von Google auch Hostlast genannt, begrenzt, wie lange Ihr Server insgesamt Verbindungen für Google offen hält; gezählt werden sowohl die Zahl paralleler Verbindungen als auch ihre Dauer. Jede Website startet mit demselben vorsichtigen Limit. Antwortet Ihr Server schnell und gleichmäßig, hebt Google es mit der Zeit an; langsame Antworten, 5xx-Fehler oder 429 Too Many Requests senken es. Das Limit teilen sich alle Crawler von Google, sodass intensives Abrufen durch einen Bild- oder Anzeigen-Crawler dem Googlebot weniger Spielraum lässt.
Der Crawling-Bedarf hängt von drei Faktoren ab, die Google nennt. Das wahrgenommene Inventar umfasst jede URL, die Google von Ihrer Website kennt; Google versucht, die meisten davon zu crawlen, sodass Tausende nutzlose URLs die Warteschlange aufblähen. Beliebte URLs werden häufiger gecrawlt, und veraltete werden erneut gecrawlt, um Änderungen zu erfassen. Ein Umzug der Website erhöht den Bedarf eine Zeit lang. Selbst bei freier Kapazität bedeutet geringer Bedarf weniger Crawling; ein schneller Server allein sorgt also nicht dafür, dass inhaltsarme Seiten öfter gecrawlt werden.
Ist das Crawl-Budget für Ihre Website wichtig?
Für die meisten Websites nicht. Der Leitfaden von Google richtet sich an drei Arten von Websites:
- Websites mit rund 1 Million oder mehr einzelnen Seiten, deren Inhalt sich etwa einmal pro Woche ändert.
- Websites mit rund 10.000 oder mehr einzelnen Seiten, deren Inhalt sich täglich ändert.
- Websites, bei denen ein großer Teil der URLs unter „Gefunden – zurzeit nicht indexiert“ steht.
Google nennt diese Werte grobe Schätzungen. Werden Ihre neuen Seiten in der Regel noch am Tag der Veröffentlichung gecrawlt, genügen eine aktuelle Sitemap und gelegentlich ein Blick in den Bericht zur Seitenindexierung. Eine Website mit 300 Seiten und einem nicht indexierten Blogartikel hat ein anderes Problem, meist Qualität, Duplikate oder schwache interne Verlinkung.
Wie crawlt der Googlebot eine Website, Schritt für Schritt?
Der Googlebot arbeitet eine Warteschlange ab: Er findet URLs, plant sie ein, ruft sie innerhalb der Grenzen Ihres Servers ab, rendert sie und gibt sie für die Entscheidung über die Indexierung weiter.
- Finden. Google erfährt von URLs über gecrawlte Seiten, deren Links und Sitemaps.
- Einplanen. Ein Algorithmus entscheidet, welche URLs abgerufen werden, wie oft und wie viele pro Besuch.
- robots.txt prüfen. Der Googlebot liest robots.txt, die Textdatei im Stammverzeichnis der Website, die Pfade auflistet, von denen sich Crawler fernhalten sollen; Was ist robots.txt und wie liest man die Datei? erklärt, wie ihre Regeln greifen.
- Abrufen, je nach Zustand des Servers. Langsame Antworten, 5xx-Fehler und 429-Antworten lassen den Googlebot zurückschalten.
- Rendern. Google führt das JavaScript der Seite in einer aktuellen Chrome-Version aus; Skripte, Stylesheets und Bilder sind ebenfalls Crawling-Anfragen.
- Über die Indexierung entscheiden. Google gruppiert nahezu identische Seiten, wählt pro Gruppe eine kanonische URL (die Version, die in den Ergebnissen erscheinen kann) und entscheidet, ob sie indexiert wird.
- Erneut crawlen. Bekannte Seiten kehren für ein erneutes Crawling in die Warteschlange zurück.
Das Crawl-Budget wirkt in den Schritten 2 bis 4. Nutzlose URLs aus Schritt 1 oder ein langsamer Schritt 4 verkleinern, was für die Seiten übrig bleibt, auf die es Ihnen ankommt.
Was verschwendet Crawl-Budget?
URLs, die keine eigenständigen, indexierbaren Inhalte liefern, verschwenden Crawl-Budget, ebenso ein Server, der den Googlebot zum Abbremsen zwingt.
| Ursache | Typisches Beispiel | Lösung |
|---|---|---|
| Facettierte Filter | ?color=red&size=m&sort=price | Filterparameter per Disallow sperren |
| Endlose Kalender | /events?month=2031-07 und weiter | Nach echten Terminen nicht weiter verlinken |
| Sitzungs-IDs in URLs | ?sessionid=8f3a9c | Sitzungen in Cookies halten |
| Weiterleitungsketten | A zu B zu C zu D | Direkt auf die End-URL verlinken |
| Soft-404-Fehler | Seite „Keine Ergebnisse“ mit Status 200 | 404 oder 410 zurückgeben |
| Tracking-Parameter | ?utm_source= in internen Links | Saubere interne Links nutzen |
| Langsamer Server, 5xx, 429 | Timeouts zu Stoßzeiten | Kapazität erhöhen, Fehler beheben |
Die facettierte Navigation, also die Filteroptionen auf Kategorieseiten, ist in Shops der größte dieser Posten: Drei Farben, fünf Größen und vier Sortierungen ergeben schon 60 URLs für eine einzige Kategorie. Google rät, unerwünschte Filter-URLs in robots.txt zu sperren und für leere Filterkombinationen 404 zurückzugeben, weil rel="canonical" und nofollow das weniger zuverlässig regeln. Ein paar Zeilen genügen; * steht für eine beliebige Zeichenfolge:
User-agent: *
Disallow: /*?*sort=
Disallow: /*?*color=
Disallow: /*?*sessionid=
Wie prüfen Sie Ihr Crawl-Budget?
Google zeigt keine Budgetzahl an. Sie prüfen deshalb, wie der Googlebot seine Besuche tatsächlich verteilt, und zwar im Bericht „Crawling-Statistik“ der Search Console und in Ihren Serverlogs.
Der Bericht liegt unter Einstellungen > Crawling-Statistik und funktioniert nur in einer Property auf Stammebene: einer Domain-Property oder einer URL-Präfix-Property für das Stammverzeichnis der Website. Seine Diagramme zeigen Crawling-Anfragen insgesamt, Gesamtgröße des Downloads und Durchschnittliche Reaktionszeit, aufgeschlüsselt nach Antwort, Dateityp, Zweck (Erkennung für neue URLs, Aktualisierung für erneutes Crawlen) und Googlebot-Typ. Die Hilfeseite zum Bericht „Crawling-Statistik“ erklärt jeden Teil und weist darauf hin, dass Websites mit weniger als 1.000 Seiten den Bericht selten brauchen.
Worauf Sie achten sollten:
- Hoststatus: robots.txt-Abruf, DNS-Auflösung und Serververbindung über 90 Tage. Probleme hier begrenzen das Crawling zuerst.
- Durchschnittliche Reaktionszeit: Eine steigende Linie drückt das Kapazitätslimit nach unten.
- Crawling-Antworten: Viele 3xx-, 404- oder 5xx-Antworten bedeuten verschwendete Besuche.
- Crawling-Zweck: Wenige Anfragen zur Erkennung auf einer Website, die täglich veröffentlicht, bedeuten, dass neue URLs nur langsam gefunden werden.
Serverlogs zeigen jede Anfrage mit Uhrzeit, URL, Statuscode und User-Agent. Behalten Sie nur verifizierte Googlebot-Anfragen, gruppieren Sie die URLs nach Muster (Produkte, Filter, alte Kampagnen) und vergleichen Sie die Zahlen mit den Seiten, die gecrawlt werden sollen. Bei beispielsweise 5.000 Googlebot-Anfragen pro Tag und 600.000 zu aktualisierenden URLs dauert ein vollständiger Durchlauf rund 120 Tage.
Wie verbessern Sie das Crawl-Budget?
Sie verbessern das Crawl-Budget, indem Sie nutzlose URLs aus dem Blickfeld von Google nehmen und Ihren Server schneller und zuverlässiger machen.
- Nutzlose URL-Bereiche in robots.txt sperren. Typisch sind Filter, die interne Suche und Sortierungen. Nicht mit
noindex: Google muss die Seite abrufen, um das Tag zu sehen. - Duplikate zusammenführen. Weiterleitungen und
rel="canonical"sind beide starke Signale dafür, welche URL die maßgebliche ist. - Für entfernte Seiten 404 oder 410 zurückgeben. Ein 404 ist ein starkes Signal, die URL nicht erneut zu crawlen. Beheben Sie Soft-404-Fehler, also „Nicht gefunden“-Seiten mit Status 200, die Google immer wieder crawlt.
- Sitemaps aktuell halten, mit ehrlichen
lastmod-Daten. Ändern Sielastmodnur, wenn sich der Inhalt ändert; Die Sitemap einer Website finden und alle Seiten auflisten zeigt, wie Sitemap-Dateien aussehen. - Weiterleitungswege kürzen. Setzen Sie interne Links direkt auf End-URLs.
- Den Server schnell machen. Kürzere Antwortzeiten heben das Kapazitätslimit, und Antworten mit
304 Not Modifiedersparen das erneute Senden unveränderter Seiten. - 503 oder 429 nur im Notfall nutzen. Google warnt, dass URLs, die diese Codes länger als ein bis zwei Tage liefern, aus dem Index fallen können.
Bereiche in robots.txt zu sperren, verschiebt ihr Budget nicht auf andere Seiten, es sei denn, die Website war bereits am Kapazitätslimit. Und meldet der Live-Test des URL-Prüftools Hostlast überschritten, hilft nur mehr Serverkapazität.
Was bedeuten „Gecrawlt – zurzeit nicht indexiert“ und „Gefunden – zurzeit nicht indexiert“?
„Gefunden – zurzeit nicht indexiert“ bedeutet, dass Google die URL kennt, sie aber noch nicht abgerufen hat; „Gecrawlt – zurzeit nicht indexiert“ bedeutet, dass Google sie abgerufen und vorerst entschieden hat, sie nicht zu indexieren. Beide erscheinen im Bericht zur Seitenindexierung der Search Console, und meist weist nur der erste Status auf das Crawl-Budget hin.
| Status | Was passiert ist | Was zu tun ist |
|---|---|---|
| Gefunden – zurzeit nicht indexiert | Gefunden, Crawling verschoben | Server beschleunigen, nutzlose URLs reduzieren |
| Gecrawlt – zurzeit nicht indexiert | Abgerufen, nicht indexiert | Seite verbessern oder zusammenführen |
Für „Gefunden“ nennt Googles Hilfeseite zum Bericht zur Seitenindexierung den typischen Grund: Google ging davon aus, dass der Besuch die Website überlasten würde, und hat das Crawling neu geplant. Prüfen Sie zuerst Hoststatus und Antwortzeiten und stellen Sie dann sicher, dass die Seiten von gecrawlten Seiten aus verlinkt sind und nicht nur in der Sitemap stehen.
„Gecrawlt“ kommt häufig vor und muss laut Google nicht unbedingt behoben werden, weil Google kanonische Seiten indexiert, die es wert sind, angezeigt zu werden, nicht jede URL. Prüfen Sie eine Stichprobe im URL-Prüftool, verbessern oder bündeln Sie die wichtigen Seiten und lassen Sie den Rest ruhen. Nach einer Korrektur startet Fehlerbehebung überprüfen eine erneute Prüfung, die etwa zwei Wochen dauern kann.
Wie prüfen Sie, ob ein Besucher wirklich der Googlebot ist?
Sie prüfen den Googlebot anhand seiner IP-Adresse, nie anhand seines User-Agents. Jeder Client kann „Googlebot“ in seinen User-Agent-Header schreiben, und solche gefälschten Einträge verzerren jede Crawling-Analyse.
Googles Seite zur Überprüfung seiner Crawler nennt zwei Methoden. Die manuelle braucht zwei DNS-Abfragen: Ein umgekehrter DNS-Lookup der IP muss einen Namen liefern, der auf googlebot.com, google.com oder googleusercontent.com endet, und ein vorwärtsgerichteter Lookup dieses Namens muss dieselbe IP zurückgeben. Wir haben das am 17. November 2026 für die Adresse aus Googles eigenem Beispiel ausgeführt (Ausgabe gekürzt; host erledigt dasselbe unter Linux und macOS):
> nslookup 66.249.66.1
Name:    crawl-66-249-66-1.googlebot.com
Address:  66.249.66.1

> nslookup crawl-66-249-66-1.googlebot.com
Name:    crawl-66-249-66-1.googlebot.com
Address:  66.249.66.1
Die automatische Methode gleicht die IP mit JSON-Dateien der Adressbereiche ab, die Google veröffentlicht; common-crawlers.json deckt den Googlebot ab. Unsere Kopie, erstellt am 16. November 2026, enthielt 66.249.66.0/27, den Bereich mit der Adresse oben.
Bot-Management-Systeme führen dieselbe Prüfung aus, um echte Suchmaschinen-Crawler durchzulassen und Nachahmer zu stoppen; Bot-Erkennung: So funktionieren Anti-Bot-Systeme zeigt, wo sie zwischen ihren anderen Ebenen sitzt.
Wie sollten sich Ihre eigenen SEO-Crawler verhalten?
Ihre eigenen Audit-Crawler und Monitoring-Tools sollten so rücksichtsvoll crawlen wie der Googlebot, denn auf Ihrer Website greifen sie auf dieselbe Serverkapazität zu. Ein Audit mit voller Geschwindigkeit zu Stoßzeiten kann die Antwortzeiten erhöhen und 5xx-Fehler auslösen, genau die Signale, die den Googlebot sein Limit senken lassen. Wählen Sie eine Rate, die der Server mühelos verkraftet, legen Sie große Audits in ruhige Zeiten, befolgen Sie robots.txt und senden Sie einen erkennbaren User-Agent mit Kontakt-URL; unsere Seite zur Web-Crawler-Lösung behandelt Crawling im großen Maßstab.
Senden Sie aus Ihrem eigenen Crawler nie einen Googlebot-User-Agent. Websites verifizieren den Googlebot per DNS und sperren Nachahmer, und sich als Crawler eines anderen Unternehmens auszugeben, ist Täuschung, kein Testtrick.
Ein Proxy hat bei einem Crawl-Audit genau eine ehrliche Aufgabe: die Seite zu zeigen, die Besucher in einem anderen Land bekommen. Google weist darauf hin, dass die Standard-IP-Adressen des Googlebot offenbar in den USA liegen; das ist ein Grund, weshalb Google getrennte URLs pro Sprache oder Region mit hreflang empfiehlt statt Seiten, die sich je nach Standort des Besuchers ändern. Ein Residential-Proxy im Zielland und in der Zielstadt ruft diese Versionen so ab, wie es ein lokaler Besucher tun würde; einen Weg um die Rate-Limits einer Website bietet er nicht.
Wo spielt das Crawl-Budget eine Rolle?
- Onlineshops: Kategorieseiten vervielfachen sich zu Tausenden von Filter- und Sortierkombinationen.
- Nachrichtenseiten: Neue Artikel müssen innerhalb von Stunden gecrawlt werden, während das Archiv weiter wächst.
- Kleinanzeigen und Marktplätze: Angebote laufen täglich ab, entfernte Seiten brauchen daher echte 404- oder 410-Antworten.
- Website-Umzüge: Jede URL wird unter ihrer neuen Adresse erneut gecrawlt, und Weiterleitungsketten bremsen das.
- JavaScript-lastige Websites: Jede Seite braucht mehrere Skript- und Datenanfragen, bevor Google ihren Inhalt sieht.
Häufige Fehler
noindexnutzen, um Crawl-Budget zu sparen. Google muss die Seite abrufen, um das Tag zu lesen.- Jede URL unter „Gecrawlt – zurzeit nicht indexiert“ als Budgetproblem behandeln. Meist geht es um Qualität oder Duplikate.
lastmodbei jeder URL auf den Build-Zeitpunkt setzen. Google nutzt das Datum nur, wenn es durchgängig stimmt.- Bei einem Ausfall oder Umzug tagelang 503 ausliefern. Seiten können aus dem Index fallen.
- Dem User-Agent in Ihren Logs vertrauen. Zählen Sie nur verifizierte Googlebot-Anfragen.
- Intern auf weitergeleitete oder parametrisierte URLs verlinken. Jeder interne Link ist eine Crawling-Anfrage, die Sie bewusst ausgeben.
Entscheidungshilfe
| Ihre Situation | Was zu tun ist |
|---|---|
| Neue Seiten werden am Tag der Veröffentlichung gecrawlt | Sitemap aktuell halten; mehr nicht |
| Viele URLs unter „Gefunden – zurzeit nicht indexiert“ | Hoststatus und Antwortzeiten prüfen; nutzlose URLs reduzieren |
| Viele URLs unter „Gecrawlt – zurzeit nicht indexiert“ | Inhaltsarme Seiten verbessern, zusammenführen oder entfernen |
| Crawling-Statistik voller Parameter-URLs | Diese Muster in robots.txt per Disallow sperren |
| Viele 3xx-Antworten in der Crawling-Statistik | Direkt auf End-URLs verlinken |
| URL-Prüftool meldet „Hostlast überschritten“ | Serverkapazität erhöhen |
| „Googlebot“-Anfragen von unbekannten IPs | Per DNS oder IP-Bereichen prüfen; Nachahmer sperren |
| Der Googlebot überlastet gerade den Server | Stunden, nicht Tage lang 503 oder 429 zurückgeben |
Häufige Fragen
Wie prüfe ich mein Crawl-Budget in der Google Search Console?
Öffnen Sie in einer Property auf Stammebene Einstellungen > Crawling-Statistik und dort den Bericht. Eine Budgetzahl gibt es nicht, aber der Bericht zeigt die Crawling-Anfragen insgesamt, die Downloadgröße, die durchschnittliche Reaktionszeit und den Hoststatus. Vergleichen Sie die täglichen Crawling-Anfragen mit der Zahl der URLs, die gecrawlt werden sollen.
Beeinflusst das Crawl-Budget das Ranking?
Nicht direkt. Google schrieb 2017, dass eine höhere Crawling-Frequenz nicht unbedingt zu besseren Positionen führt und Crawling kein Rankingsignal ist. Indirekt spielt es eine Rolle: Eine Seite, die nie gecrawlt wird, kann nicht ranken.
Ist das Crawl-Budget für kleine Websites ein Thema?
Meist nicht. Googles Leitfaden zielt auf Websites mit rund einer Million Seiten oder mit mehr als 10.000 Seiten, die sich täglich ändern. Auf einer kleinen Website liegt eine nicht indexierte Seite fast immer an Qualität, Duplikaten oder interner Verlinkung.
Wie kann ich mein Crawl-Budget erhöhen?
Arbeiten Sie an beiden Seiten. Die Kapazität wächst, wenn der Server schnell und fehlerfrei antwortet. Der Bedarf wächst, wenn Google weniger nutzlose URLs und mehr abrufenswerte Seiten findet; sperren Sie also Parameterbereiche, führen Sie Duplikate zusammen und verlinken Sie wichtige Seiten intern.
Wo finde ich die IP-Bereiche des Googlebot?
Google veröffentlicht sie als JSON-Dateien, die auf seiner Seite zur Crawler-Überprüfung verlinkt sind; common-crawlers.json deckt den Googlebot ab. Die Bereiche ändern sich. Laden Sie die Datei daher regelmäßig neu, statt Adressen einmalig in eine Firewall-Regel zu kopieren.
Verbrauchen CSS-, JavaScript- und Bilddateien Crawl-Budget?
Ja. Jede URL, die der Googlebot abruft, zählt, auch Stylesheets, Skripte, Bilder und API-Antworten, die eine Seite zum Rendern braucht. Die Aufschlüsselung nach Dateityp in der Crawling-Statistik zeigt diesen Anteil für Ihre Website.
Fazit
Das Crawl-Budget ist die Menge an URLs, die der Googlebot auf einem Hostnamen crawlen kann und will: Das Kapazitätslimit folgt dem Zustand Ihres Servers, der Bedarf folgt der Zahl der URLs, die Google kennt, ihrer Beliebtheit und ihrer Änderungshäufigkeit. Wichtig ist es für sehr große oder sich schnell ändernde Websites. Halten Sie nutzlose URLs von Google fern, antworten Sie schnell und korrekt und behandeln Sie „Gefunden“ und „Gecrawlt – zurzeit nicht indexiert“ als verschiedene Probleme. Um während eines Audits zu sehen, wie Ihre Seiten aus anderen Ländern aussehen, werfen Sie einen Blick auf unsere SEO-Proxy-Lösung.