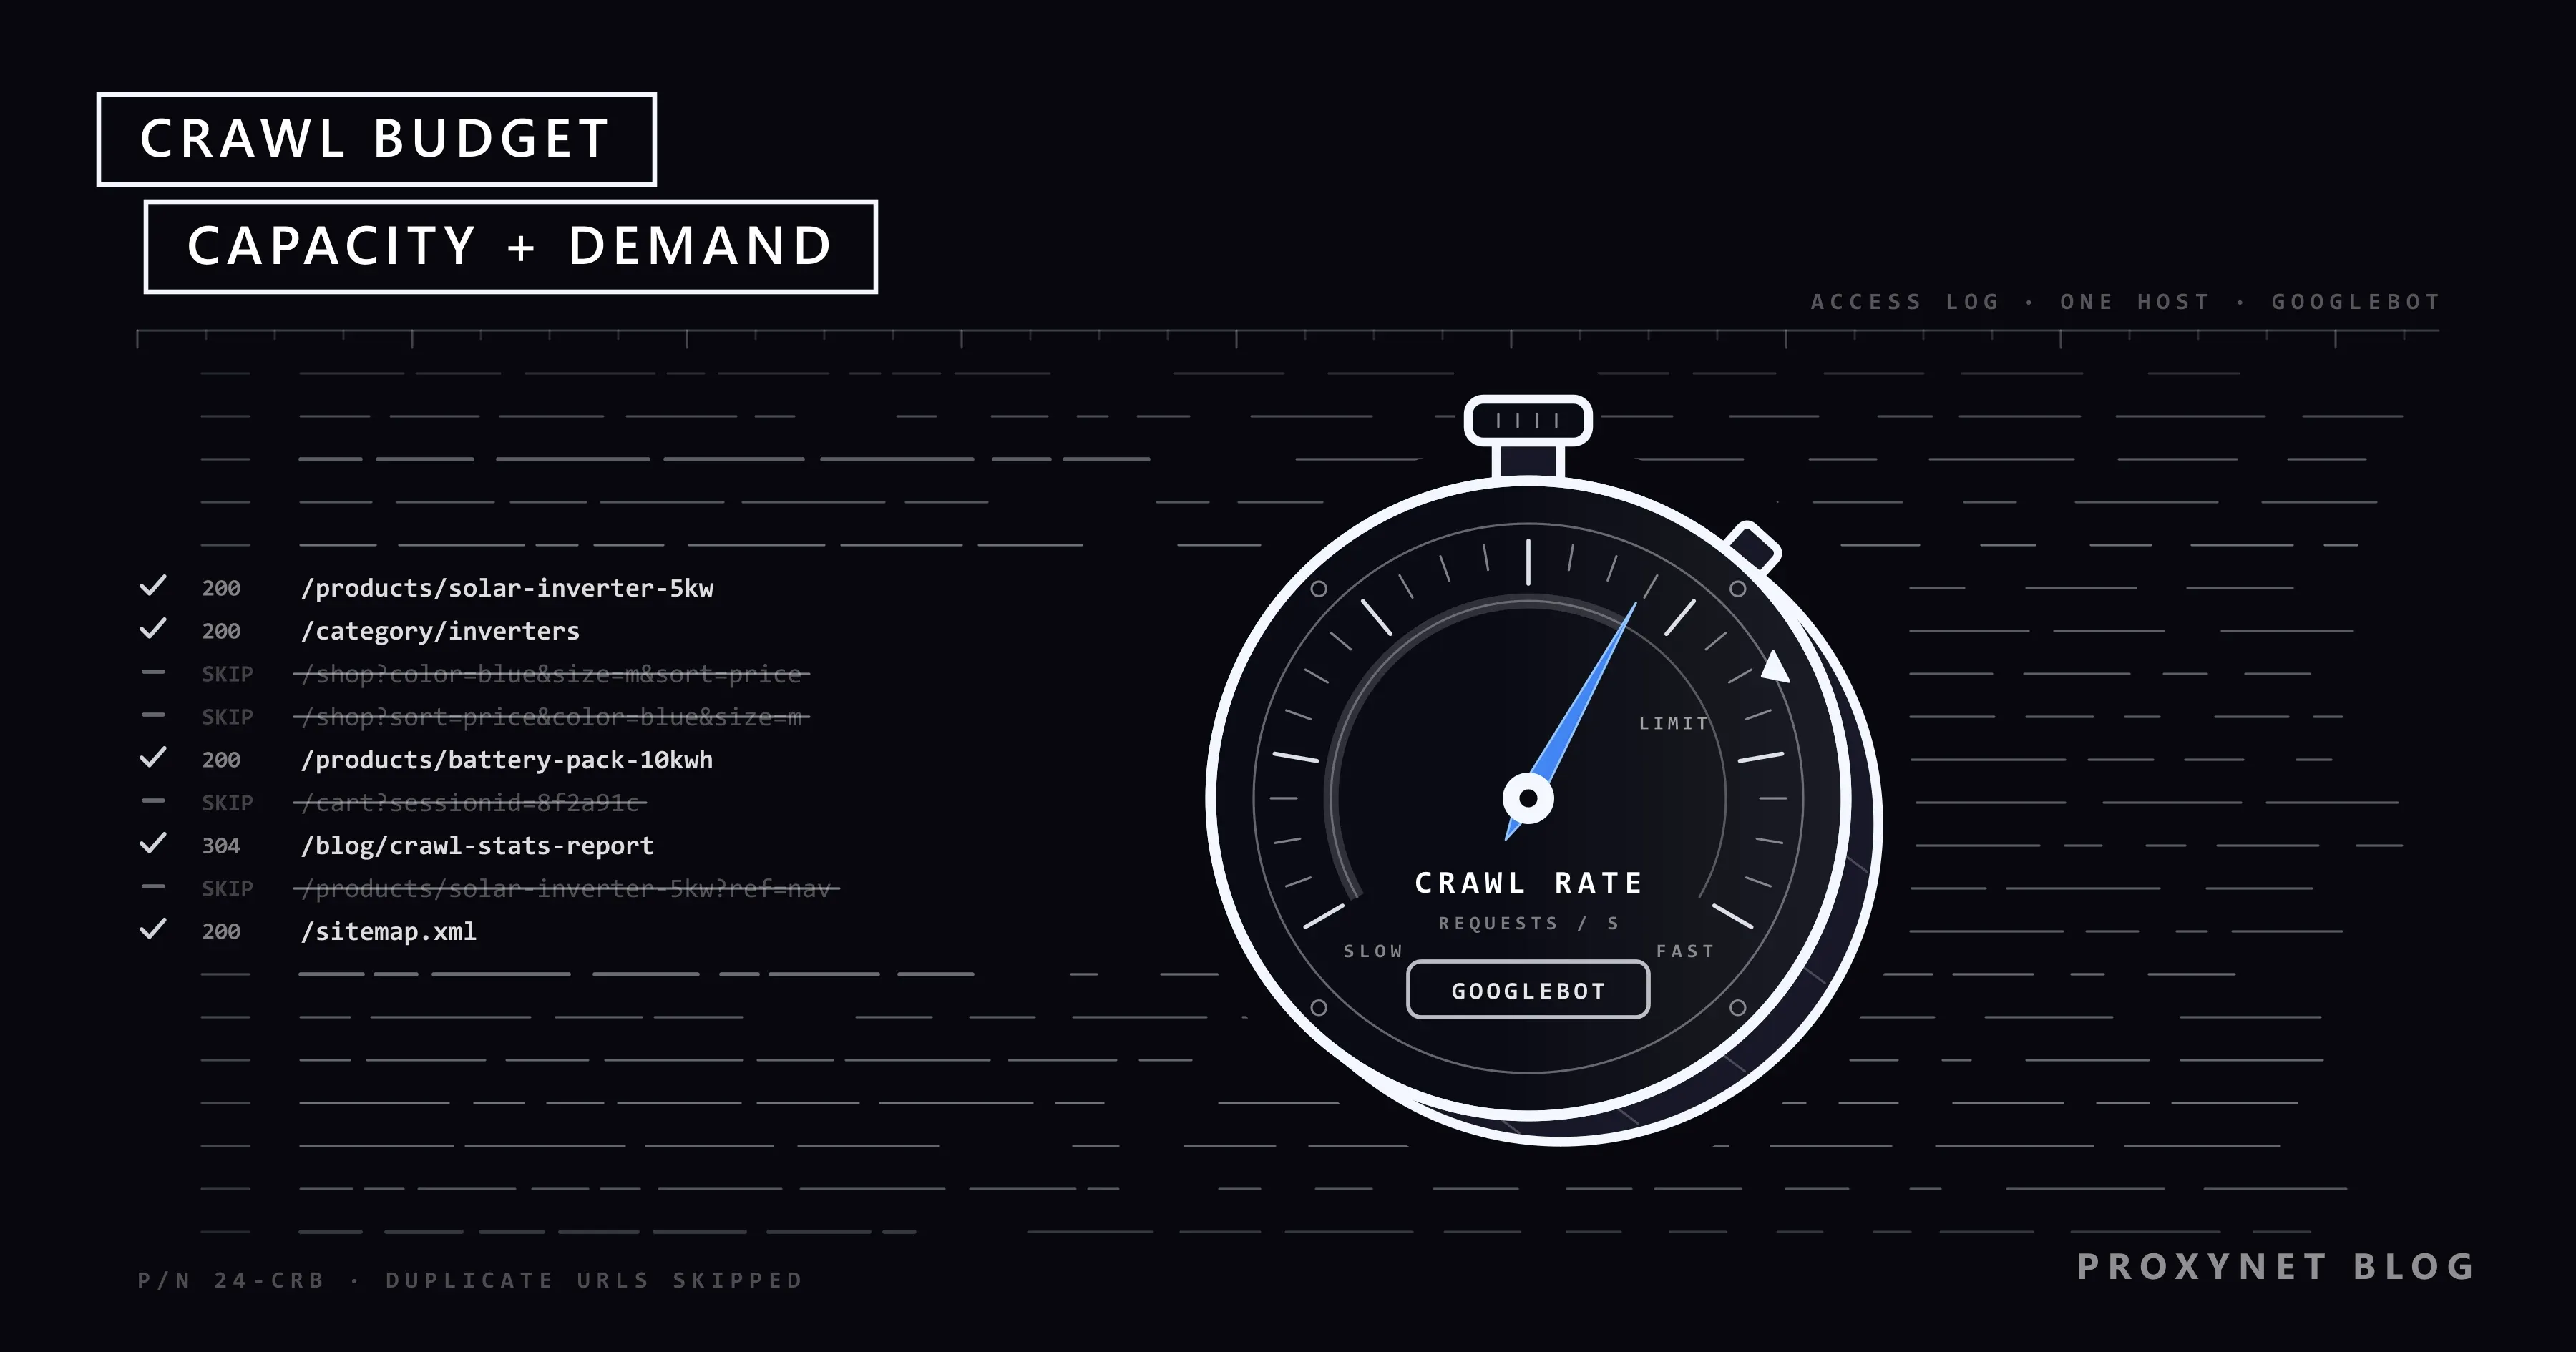
Bir internet mağazasına 20.000 ürün sayfası ekliyor, site haritasını gönderiyorsunuz; üç hafta sonra Search Console bunların çoğunu "Bulundu: Şu anda dizine eklenmiş değil" olarak gösteriyor. Sunucu log kayıtları hikâyenin öbür yarısını anlatıyor: Googlebot boş durmamış, ama zamanının çoğunu ?color=blue&size=m&sort=price gibi filtre adreslerine harcamış. Önemsediğiniz sayfalar, sınırlı bir hızla ilerleyen bir kuyrukta bekliyor. SEO'cular bu sınıra tarama bütçesi (crawl budget) diyor.
Bu yazıda tarama bütçesini Google'ın kendi terimleriyle, hangi sitelerin bu konuya kafa yorması gerektiğini ve Googlebot'un bir URL'yi bulmaktan dizine eklemeye kadar izlediği yolu anlatıyoruz. Ardından taramayı neyin boşa harcadığına, bunu nasıl ölçeceğinize, iki "dizine eklenmiş değil" durumuna ve sahte Googlebot'u nasıl ayırt edeceğinize geçiyoruz.
Tarama bütçesi nedir?
Tarama bütçesi, Google'ın sitenizde tarayabildiği ve taramaya istekli olduğu URL sayısıdır ve terim Google'ın kendisine aittir: Optimize your crawl budget rehberi onu "Google'ın tarayabildiği ve taramak istediği URL'ler kümesi" diye tanımlar. Tarama, bir programın, burada Googlebot'un, bir URL'yi isteyip sunucunun döndürdüğü içeriği indirmesidir. Taranmayan hiçbir sayfa Google'ın dizinine giremez.
Bütçe ana makine adı (hostname) başına belirlenir; www.example.com ile shop.example.com'un bütçeleri ayrıdır. Bakabileceğiniz ya da bir ayardan yükseltebileceğiniz bir sayı yoktur; bütçe, Google'ın sürekli ölçtüğü iki şeyin sonucudur.
Tarama kapasitesi sınırı ve tarama talebi nedir?
Tarama kapasitesi sınırı, Googlebot'un sunucunuzu yormadan ne kadar tarayabileceğidir; tarama talebi ise ne kadar taramak istediğidir. Pratikte bütçeyi ikisinden düşük olanı belirler.
Tarama kapasitesi sınırı (crawl capacity limit), Google'ın hostload da dediği değerdir. Sunucunuzun Google için açık bağlantı tutmaya harcadığı toplam süreyi sınırlar ve bunu yaparken hem paralel bağlantı sayısını hem de her bağlantının süresini hesaba katar. Her site aynı temkinli sınırla başlar. Sunucunuz hızlı ve tutarlı cevap verirse Google sınırı zamanla yükseltir; yavaş yanıtlar, 5xx hataları ya da 429 Too Many Requests sınırı düşürür. Sınır Google'ın bütün tarayıcıları (crawler) arasında paylaşılır; görsel ya da reklam tarayıcısının yoğun taraması Googlebot'a kalan payı azaltır.
Tarama talebi (crawl demand) Google'ın saydığı üç etkene bağlıdır. Algılanan envanter, Google'ın sitenizde bildiği bütün URL'lerdir; Google bunların çoğunu taramaya çalıştığı için binlerce gereksiz URL kuyruğu şişirir. Popüler URL'ler daha sık taranır, bayatlayan sayfalar da değişiklikleri yakalamak için yeniden taranır. Sitenin yeni adrese taşınması da talebi bir süre artırır. Kapasite boşta olsa bile talep düşükse tarama azalır; yani tek başına hızlı bir sunucu, zayıf sayfaların daha çok taranmasını sağlamaz.
Tarama bütçesi sitenizi ilgilendirir mi?
Çoğu siteyi ilgilendirmez. Google'ın rehberi üç tür site için yazılmıştır:
- Yaklaşık 1 milyon ya da daha fazla benzersiz sayfası olan ve içeriği haftada bir civarında değişen siteler.
- Yaklaşık 10.000 ya da daha fazla benzersiz sayfası olan ve içeriği her gün değişen siteler.
- URL'lerinin büyük kısmı "Bulundu: Şu anda dizine eklenmiş değil" durumunda bekleyen siteler.
Google bu sayıları kaba tahmin olarak verir. Yeni sayfalarınız genellikle yayımlandığı gün taranıyorsa site haritasını güncel tutmak ve Sayfa dizine ekleme raporuna ara sıra bakmak yeterlidir. Dizine girmeyen bir blog yazısı olan 300 sayfalık bir sitenin sorunu ise başkadır; çoğunlukla içerik kalitesi, kopya sayfalar ya da zayıf iç linklerdir.
Googlebot bir siteyi adım adım nasıl tarar?
Googlebot bir kuyruk üzerinden çalışır: URL'leri bulur, sıraya koyar, sunucunuzun sınırları içinde indirir, işler ve dizine ekleme kararı için bir sonraki aşamaya aktarır.
- Bulma. Google URL'leri daha önce taradığı sayfalardan, bu sayfalardaki linklerden ve site haritalarından öğrenir.
- Sıraya koyma. Bir algoritma hangi URL'lerin, ne sıklıkla ve her ziyarette kaç tane indirileceğine karar verir.
- robots.txt kontrolü. Googlebot, sitenin kök dizinindeki ve tarayıcıların uzak durması gereken yolları listeleyen metin dosyası robots.txt'yi okur; kuralların nasıl eşleştiğini robots.txt Dosyası Nedir, Nasıl Okunur? yazısında anlattık.
- Sunucunun durumuna göre indirme. Yavaş yanıtlar, 5xx hataları ve 429'lar Googlebot'u yavaşlatır.
- İşleme (render). Google sayfanın JavaScript'ini güncel bir Chrome sürümünde çalıştırır; betikler, stil dosyaları ve görseller de birer tarama isteğidir.
- Dizine ekleme kararı. Google birbirine çok benzeyen sayfaları gruplar, her grup için bir standart URL (canonical, arama sonuçlarında gösterilebilecek sürüm) seçer ve onu dizine ekleyip eklemeyeceğine karar verir.
- Yeniden tarama. Bilinen sayfalar, yenileme taraması için kuyruğa geri döner.
Tarama bütçesi 2-4. adımlarda devreye girer. 1. adımda kuyruğa eklenen gereksiz URL'ler ya da yavaşlayan 4. adım, önemsediğiniz sayfalara kalan payı küçültür.
Tarama bütçesini ne boşa harcar?
Benzersiz ve dizine eklenebilir içerik üretmeyen URL'ler tarama bütçesini boşa harcar; Googlebot'u yavaşlamaya zorlayan bir sunucu da öyle.
| Neden | Tipik örnek | Çözüm |
|---|---|---|
| Filtreli gezinme | ?color=red&size=m&sort=price | Filtre parametrelerini engelleyin |
| Sonsuz takvimler | /events?month=2031-07 ve sonrası | Gerçek tarihlerden sonrasına link vermeyin |
| URL'de oturum kimliği | ?sessionid=8f3a9c | Oturumu çerezde tutun |
| Yönlendirme zincirleri | A'dan B'ye, C'ye, D'ye | Doğrudan son URL'ye link verin |
| Soft 404 | 200 koduyla dönen "Sonuç yok" sayfası | 404 ya da 410 döndürün |
| İzleme parametreleri | İç linklerde ?utm_source= | Temiz iç linkler kullanın |
| Yavaş sunucu, 5xx, 429 | Yoğun saatlerde zaman aşımı | Kapasite ekleyin, hataları giderin |
Filtreli gezinme (faceted navigation), yani kategori sayfalarındaki filtre seçenekleri, mağazalarda bunların en büyüğüdür: üç renk, beş beden ve dört sıralama seçeneği tek bir kategori için 60 URL demektir. Google, istenmeyen filtre URL'lerini robots.txt ile engellemeyi ve ürün çıkmayan filtre birleşimlerinde 404 döndürmeyi önerir, çünkü rel="canonical" ve nofollow bu sorunu daha az güvenilir biçimde çözer. Birkaç satır yeterlidir; * herhangi bir karakter dizisinin yerini tutar:
User-agent: *
Disallow: /*?*sort=
Disallow: /*?*color=
Disallow: /*?*sessionid=
Tarama bütçenizi nasıl kontrol edersiniz?
Google bütçe için bir sayı göstermez; bu yüzden Googlebot'un ziyaretlerini gerçekte nasıl harcadığına bakarsınız: Search Console'daki Tarama İstatistikleri raporunda ve sunucu log kayıtlarınızda.
Rapora Ayarlar > Tarama istatistikleri yolundan ulaşılır ve rapor yalnız kök düzeydeki bir mülkte, yani bir Alan mülkünde ya da sitenin köküne ait bir URL-önek mülkünde çalışır. Grafikler Toplam tarama istekleri, Toplam indirme boyutu ve Ortalama yanıt süresi değerlerini gösterir; altında istekler yanıta, dosya türüne, tarama amacına (yeni URL'ler için Keşfetme, yeniden taramalar için Yenileme) ve Googlebot türüne göre ayrılır. Google'ın Tarama İstatistikleri raporu yardım sayfası her bölümü açıklar ve bin sayfadan az içeriği olan sitelerin bu rapora nadiren ihtiyaç duyduğunu belirtir.
Nelere bakmalı:
- Ana makinenin durumu: son 90 günde robots.txt getirme, DNS çözümleme ve sunucu bağlantısı. Buradaki sorunlar taramayı her şeyden önce sınırlar.
- Ortalama yanıt süresi: yükselen bir çizgi kapasite sınırını aşağı çeker.
- Tarama yanıtları: 3xx, 404 ya da 5xx yanıtların payı yüksekse ziyaretler boşa gidiyordur.
- Tarama amacı: her gün yayın yapan bir sitede keşif istekleri azsa yeni URL'ler geç bulunuyordur.
Sunucu log kayıtları her isteği zamanı, URL'si, durum kodu ve user agent'ıyla birlikte gösterir. Yalnız doğrulanmış Googlebot isteklerini bırakın, URL'leri kalıba göre gruplayın (ürünler, filtreler, eski kampanyalar) ve sayıları taranmasını istediğiniz sayfalarla karşılaştırın. Örneğin günde 5.000 Googlebot isteği ve yenilenmesi gereken 600.000 URL varsa tam bir tur yaklaşık 120 gün sürer.
Tarama bütçesini nasıl iyileştirirsiniz?
Tarama bütçesini, gereksiz URL'leri Google'ın gözünden çıkarıp sunucunuzu daha hızlı ve güvenilir hâle getirerek iyileştirirsiniz.
- Gereksiz URL alanlarını robots.txt ile engelleyin. Filtreler, site içi arama ve sıralama seçenekleri tipik örneklerdir.
noindexbu işi görmez: Google etiketi görmek için sayfayı yine indirir. - Kopyaları birleştirin. Yönlendirmeler de
rel="canonical"de hangi URL'nin asıl olduğunu gösteren güçlü sinyallerdir. - Kaldırılan sayfalarda 404 ya da 410 döndürün. 404, Google için URL'yi bir daha taramamaya yönelik güçlü bir sinyaldir. Soft 404'leri, yani 200 koduyla gönderilen "bulunamadı" sayfalarını düzeltin; Google bunları taramayı sürdürür.
- Site haritalarını güncel,
lastmodtarihlerini dürüst tutun.lastmoddeğerini yalnız içerik değiştiğinde güncelleyin; site haritası dosyalarının nasıl göründüğünü Sitemap Nasıl Bulunur? Bir Sitenin Tüm Sayfalarını Görmek yazısında gösterdik. - Yönlendirme yollarını kısaltın. İç linkleri doğrudan son URL'ye verin.
- Sunucuyu hızlandırın. Düşük yanıt süreleri kapasite sınırını yükseltir;
304 Not Modifiedyanıtları değişmeyen sayfaların yeniden gönderilmesini önler. - 503 ya da 429'u yalnız acil durumda kullanın. Google, bu kodları bir iki günden uzun süre döndüren URL'lerin dizinden düşebileceği konusunda uyarır.
robots.txt ile bölümleri engellemek, site zaten kapasite sınırına dayanmamışsa onların bütçesini başka sayfalara aktarmaz. URL Denetleme aracının canlı testi Ana makine yükü aşıldı uyarısı veriyorsa çözüm sunucu kapasitesini artırmaktır.
"Tarandı: Şu anda dizine eklenmiş değil" ve "Bulundu: Şu anda dizine eklenmiş değil" ne anlama gelir?
"Bulundu: Şu anda dizine eklenmiş değil", Google'ın URL'yi bildiği ama henüz indirmediği anlamına gelir. "Tarandı: Şu anda dizine eklenmiş değil" ise Google'ın URL'yi indirdiğini ama şimdilik dizine eklememeye karar verdiğini gösterir. İkisi de Search Console'daki Sayfa dizine ekleme raporunda görünür ve genellikle yalnız ilki tarama bütçesine işaret eder.
| Durum | Ne oldu | Ne yapmalı |
|---|---|---|
| Bulundu: Şu anda dizine eklenmiş değil | Bulundu, tarama ertelendi | Sunucuyu hızlandırın, gereksiz URL'leri azaltın |
| Tarandı: Şu anda dizine eklenmiş değil | İndirildi, dizine eklenmedi | Sayfayı iyileştirin ya da birleştirin |
"Bulundu" için Google'ın Sayfa dizine ekleme raporu yardım sayfası tipik nedeni verir: Google ziyaretin siteyi aşırı yükleyeceğini öngörmüş ve taramayı yeniden planlamıştır. Önce ana makinenin durumuna ve yanıt sürelerine bakın, sonra bu sayfaların yalnız site haritasında listelenmekle kalmayıp taranmış sayfalardan link aldığından emin olun.
"Tarandı" sık görülen bir durumdur ve Google'ın ifadesiyle her zaman müdahale gerektirmez, çünkü Google her URL'yi değil, göstermeye değer standart sayfaları dizine ekler. URL Denetleme aracında bir örneklem inceleyin, önemli sayfaları iyileştirin ya da birleştirin, gerisini bırakın. Bir düzeltmeden sonra Düzeltmeyi Doğrula düğmesi, yaklaşık iki hafta sürebilen bir yeniden kontrol başlatır.
Bir ziyaretçinin gerçekten Googlebot olduğunu nasıl doğrularsınız?
Googlebot'u user agent'ından değil, IP adresinden doğrularsınız. Herhangi bir istemci User-Agent başlığına "Googlebot" yazabilir ve bu sahte kayıtlar her tarama analizini bozar.
Google'ın tarayıcılarını doğrulama sayfası iki yöntem verir. Elle yapılan yöntemde iki DNS sorgusu yeterlidir: IP adresinin ters DNS sorgusu googlebot.com, google.com ya da googleusercontent.com ile biten bir ad döndürmeli, bu adın ileri DNS sorgusu da aynı IP'yi vermelidir. Bu kontrolü 17 Kasım 2026'da, Google'ın kendi örneğinde kullandığı adres için yaptık (çıktı kısaltıldı; Linux ve macOS'ta host komutu aynı işi görür):
> nslookup 66.249.66.1
Name:    crawl-66-249-66-1.googlebot.com
Address:  66.249.66.1

> nslookup crawl-66-249-66-1.googlebot.com
Name:    crawl-66-249-66-1.googlebot.com
Address:  66.249.66.1
Otomatik yöntem, IP'yi Google'ın yayımladığı adres aralığı JSON dosyalarıyla karşılaştırır; Googlebot'u common-crawlers.json kapsar. 16 Kasım 2026'da üretilmiş kopyamızda, yukarıdaki adresi içeren 66.249.66.0/27 aralığı yer alıyordu.
Bot yönetim sistemleri gerçek arama motoru tarayıcılarını geçirip taklitçileri durdurmak için aynı kontrolü yapar; bu kontrolün diğer katmanlar arasındaki yerini Bot Tespiti Nasıl Yapılır? Anti-Bot Sistemlerinin Mantığı yazısında anlattık.
Kendi SEO tarayıcılarınız nasıl davranmalı?
Kendi denetim tarayıcılarınız ve izleme araçlarınız da Googlebot kadar nazik taramalıdır, çünkü kendi sitenizde aynı sunucu kapasitesini kullanırlar. Yoğun saatlerde tam hızla çalışan bir denetim yanıt sürelerini artırıp 5xx hatalarına yol açabilir; bunlar Googlebot'un sınırını düşürmesine neden olan sinyallerin ta kendisidir. Sunucunun rahat kaldırdığı bir hız belirleyin, büyük denetimleri yoğun olmayan saatlere koyun, robots.txt'ye uyun ve kim olduğunuzu söyleyen, iletişim adresi içeren bir user agent gönderin; büyük ölçekli tarama için web crawler çözümü sayfamıza bakabilirsiniz.
Kendi tarayıcınızdan asla Googlebot user agent'ı göndermeyin. Siteler Googlebot'u DNS ile doğrular ve taklitçileri engeller; başka bir şirketin tarayıcısı gibi davranmak bir test hilesi değil, aldatmadır.
Bir tarama denetiminde proxy'nin tek bir dürüst görevi vardır: başka bir ülkedeki ziyaretçilerin gördüğü sayfayı göstermek. Google, Googlebot'un varsayılan IP adreslerinin ABD'de göründüğünü belirtir; ziyaretçinin konumuna göre değişen sayfalar yerine her dil ya da ülke için hreflang ile işaretlenmiş ayrı URL'ler önermesinin bir nedeni de budur. Hedef ülke ve şehirdeki bir Residential Proxy, bu sürümleri o ülkedeki bir ziyaretçi gibi ister; bir sitenin hız sınırlarını aşmanın yolu değildir.
Tarama bütçesi nerelerde karşınıza çıkar?
- İnternet mağazaları: kategori sayfaları binlerce filtre ve sıralama birleşimine dönüşür.
- Haber siteleri: arşiv büyürken yeni haberlerin saatler içinde taranması gerekir.
- İlan siteleri ve pazar yerleri: ilanlar her gün sona erer; kaldırılan sayfalar gerçek 404 ya da 410 yanıtı vermelidir.
- Site taşıma: her URL yeni adresinde yeniden taranır; yönlendirme zincirleri bunu yavaşlatır.
- JavaScript ağırlıklı siteler: Google içeriği görmeden önce her sayfa için birkaç betik ve veri isteği gerekir.
Sık yapılan hatalar
- Tarama bütçesi kazanmak için
noindexkullanmak. Google etiketi okumak için sayfayı indirmek zorundadır. - Her "Tarandı: Şu anda dizine eklenmiş değil" URL'sini bütçe sorunu saymak. Konu genellikle kalite ya da kopya içeriktir.
- Her URL'de
lastmoddeğerini derleme zamanına ayarlamak. Google bu tarihi yalnız tutarlı biçimde doğruysa kullanır. - Kesinti ya da taşıma sırasında günlerce 503 döndürmek. Sayfalar dizinden düşebilir.
- Log kayıtlarındaki user agent'a güvenmek. Yalnız doğrulanmış Googlebot isteklerini sayın.
- İç linkleri yönlendirilen ya da parametreli URL'lere vermek. Her iç link, harcanmasına sizin karar verdiğiniz bir tarama isteğidir.
Karar rehberi
| Durumunuz | Ne yapmalı |
|---|---|
| Yeni sayfalar yayımlandığı gün taranıyor | Site haritasını güncel tutun, o kadar |
| Çok sayıda "Bulundu: Şu anda dizine eklenmiş değil" URL'si | Ana makinenin durumuna ve yanıt sürelerine bakın; gereksiz URL'leri azaltın |
| Çok sayıda "Tarandı: Şu anda dizine eklenmiş değil" URL'si | Zayıf sayfaları iyileştirin, birleştirin ya da kaldırın |
| Tarama İstatistikleri parametreli URL'lerle dolu | Bu kalıpları robots.txt'de engelleyin |
| Tarama İstatistikleri'nde çok sayıda 3xx yanıtı | Doğrudan son URL'lere link verin |
| URL Denetleme "Ana makine yükü aşıldı" diyor | Sunucu kapasitesini artırın |
| Bilinmeyen IP'lerden gelen "Googlebot" istekleri | DNS ya da IP aralıklarıyla doğrulayın; taklitçileri engelleyin |
| Googlebot şu anda sunucuyu yoruyor | Günlerce değil, birkaç saat 503 ya da 429 döndürün |
Sıkça sorulan sorular
Google Search Console'da tarama bütçemi nasıl kontrol ederim?
Kök düzeydeki bir mülkte Ayarlar > Tarama istatistikleri yolundan raporu açın. Bütçe için bir sayı yoktur ama rapor toplam tarama isteklerini, indirme boyutunu, ortalama yanıt süresini ve ana makinenin durumunu gösterir. Günlük tarama isteklerini, taranmasını istediğiniz URL sayısıyla karşılaştırın.
Tarama bütçesi sıralamayı etkiler mi?
Doğrudan etkilemez. Google 2017'de, daha yüksek tarama hızının arama sonuçlarında mutlaka daha iyi konum getirmediğini ve taramanın bir sıralama sinyali olmadığını yazdı. Dolaylı etkisi ise vardır: hiç taranmayan bir sayfa sıralamaya giremez.
Tarama bütçesi küçük siteler için sorun mudur?
Genellikle değildir. Google'ın rehberi bir milyon civarında sayfası olan ya da her gün değişen 10.000'den fazla sayfası olan siteleri hedefler. Küçük bir sitede dizine girmeyen bir sayfanın nedeni neredeyse her zaman kalite, kopya içerik ya da iç linklerdir.
Tarama bütçemi nasıl artırabilirim?
İki tarafta birden çalışın. Kapasite, sunucu hızlı ve hatasız cevap verdikçe büyür. Talep, Google daha az gereksiz URL ve indirmeye değer daha çok sayfa buldukça artar; bu yüzden parametre alanlarını engelleyin, kopyaları birleştirin ve önemli sayfalara iç link verin.
Googlebot'un IP aralıklarını nerede bulabilirim?
Google bunları, tarayıcı doğrulama sayfasından linklenen JSON dosyaları olarak yayımlar; Googlebot'u common-crawlers.json kapsar. Aralıklar değişir; adresleri bir kez güvenlik duvarı kuralına kopyalamak yerine dosyayı düzenli olarak yeniden yükleyin.
CSS, JavaScript ve görsel dosyaları tarama bütçesi harcar mı?
Evet. Googlebot'un indirdiği her URL sayılır; bir sayfanın işlenmesi için gereken stil dosyaları, betikler, görseller ve API yanıtları da buna dahildir. Tarama İstatistikleri raporundaki dosya türü dökümü, bu payın sitenizde ne kadar olduğunu gösterir.
Özet
Tarama bütçesi, Googlebot'un bir ana makine adında tarayabildiği ve taramak istediği URL'lerin kümesidir: kapasite sınırı sunucunuzun sağlığını izler, talep ise Google'ın kaç URL bildiğini, bunların ne kadar popüler olduğunu ve ne sıklıkla değiştiğini. Konu çok büyük ya da hızlı değişen siteler için önemlidir. Gereksiz URL'leri Google'ın gözünden uzak tutun, hızlı ve doğru yanıt verin; "Bulundu" ile "Tarandı" durumlarını iki ayrı sorun olarak ele alın. Bir denetim sırasında sayfalarınızın başka ülkelerden nasıl göründüğünü görmek için SEO proxy çözümümüze göz atın.