In Ihrem Server-Log steht eine Zeile mit CCBot/2.0 (https://commoncrawl.org/faq/). Oder das Datenkapitel im Paper eines KI-Modells sagt, dass der größte Teil der Trainingstexte aus „gefiltertem Common Crawl“ stammt. Beides führt an denselben Ort: zu einer gemeinnützigen Organisation, die seit 2008 das öffentliche Web kopiert und die Kopien jedem gibt, der sie haben möchte.
Dieser Beitrag zeigt, was ein Crawl enthält, wie sich der Crawler verhält, wie groß und wie aktuell die Daten sind (mit der offiziellen Crawl-Liste, wie wir sie am 17. November 2026 gelesen haben), wer sie nutzt, wo sie an Grenzen stoßen, wie Website-Betreiber sich ausschließen und wie sich Common Crawl von der Wayback Machine unterscheidet.
Was ist Common Crawl?
Common Crawl ist eine nach US-Steuerrecht als 501(c)(3) anerkannte gemeinnützige Organisation, die das Web crawlt und die gesammelten Seiten als offenen Datensatz veröffentlicht. Ihre Website beschreibt einen Korpus von mehr als 300 Milliarden Seiten, frei und offen seit 2007 und in über 10.000 Forschungsarbeiten zitiert (gelesen am 17. November 2026).
Der Gedanke dahinter ist praktisch: Milliarden Seiten zu crawlen erfordert Server und Ingenieure, die sich nur große Unternehmen leisten können, also übernimmt eine Gruppe die Arbeit und teilt das Ergebnis. Die Daten liegen auf Amazon S3 in der Region US East (N. Virginia) und lassen sich auch über HTTPS von data.commoncrawl.org herunterladen. Common Crawl ist keine Suchmaschine: Es gibt keine gerankten Ergebnisse, nur einen Index, der Adressen nachschlägt.
Was enthält ein Crawl von Common Crawl?
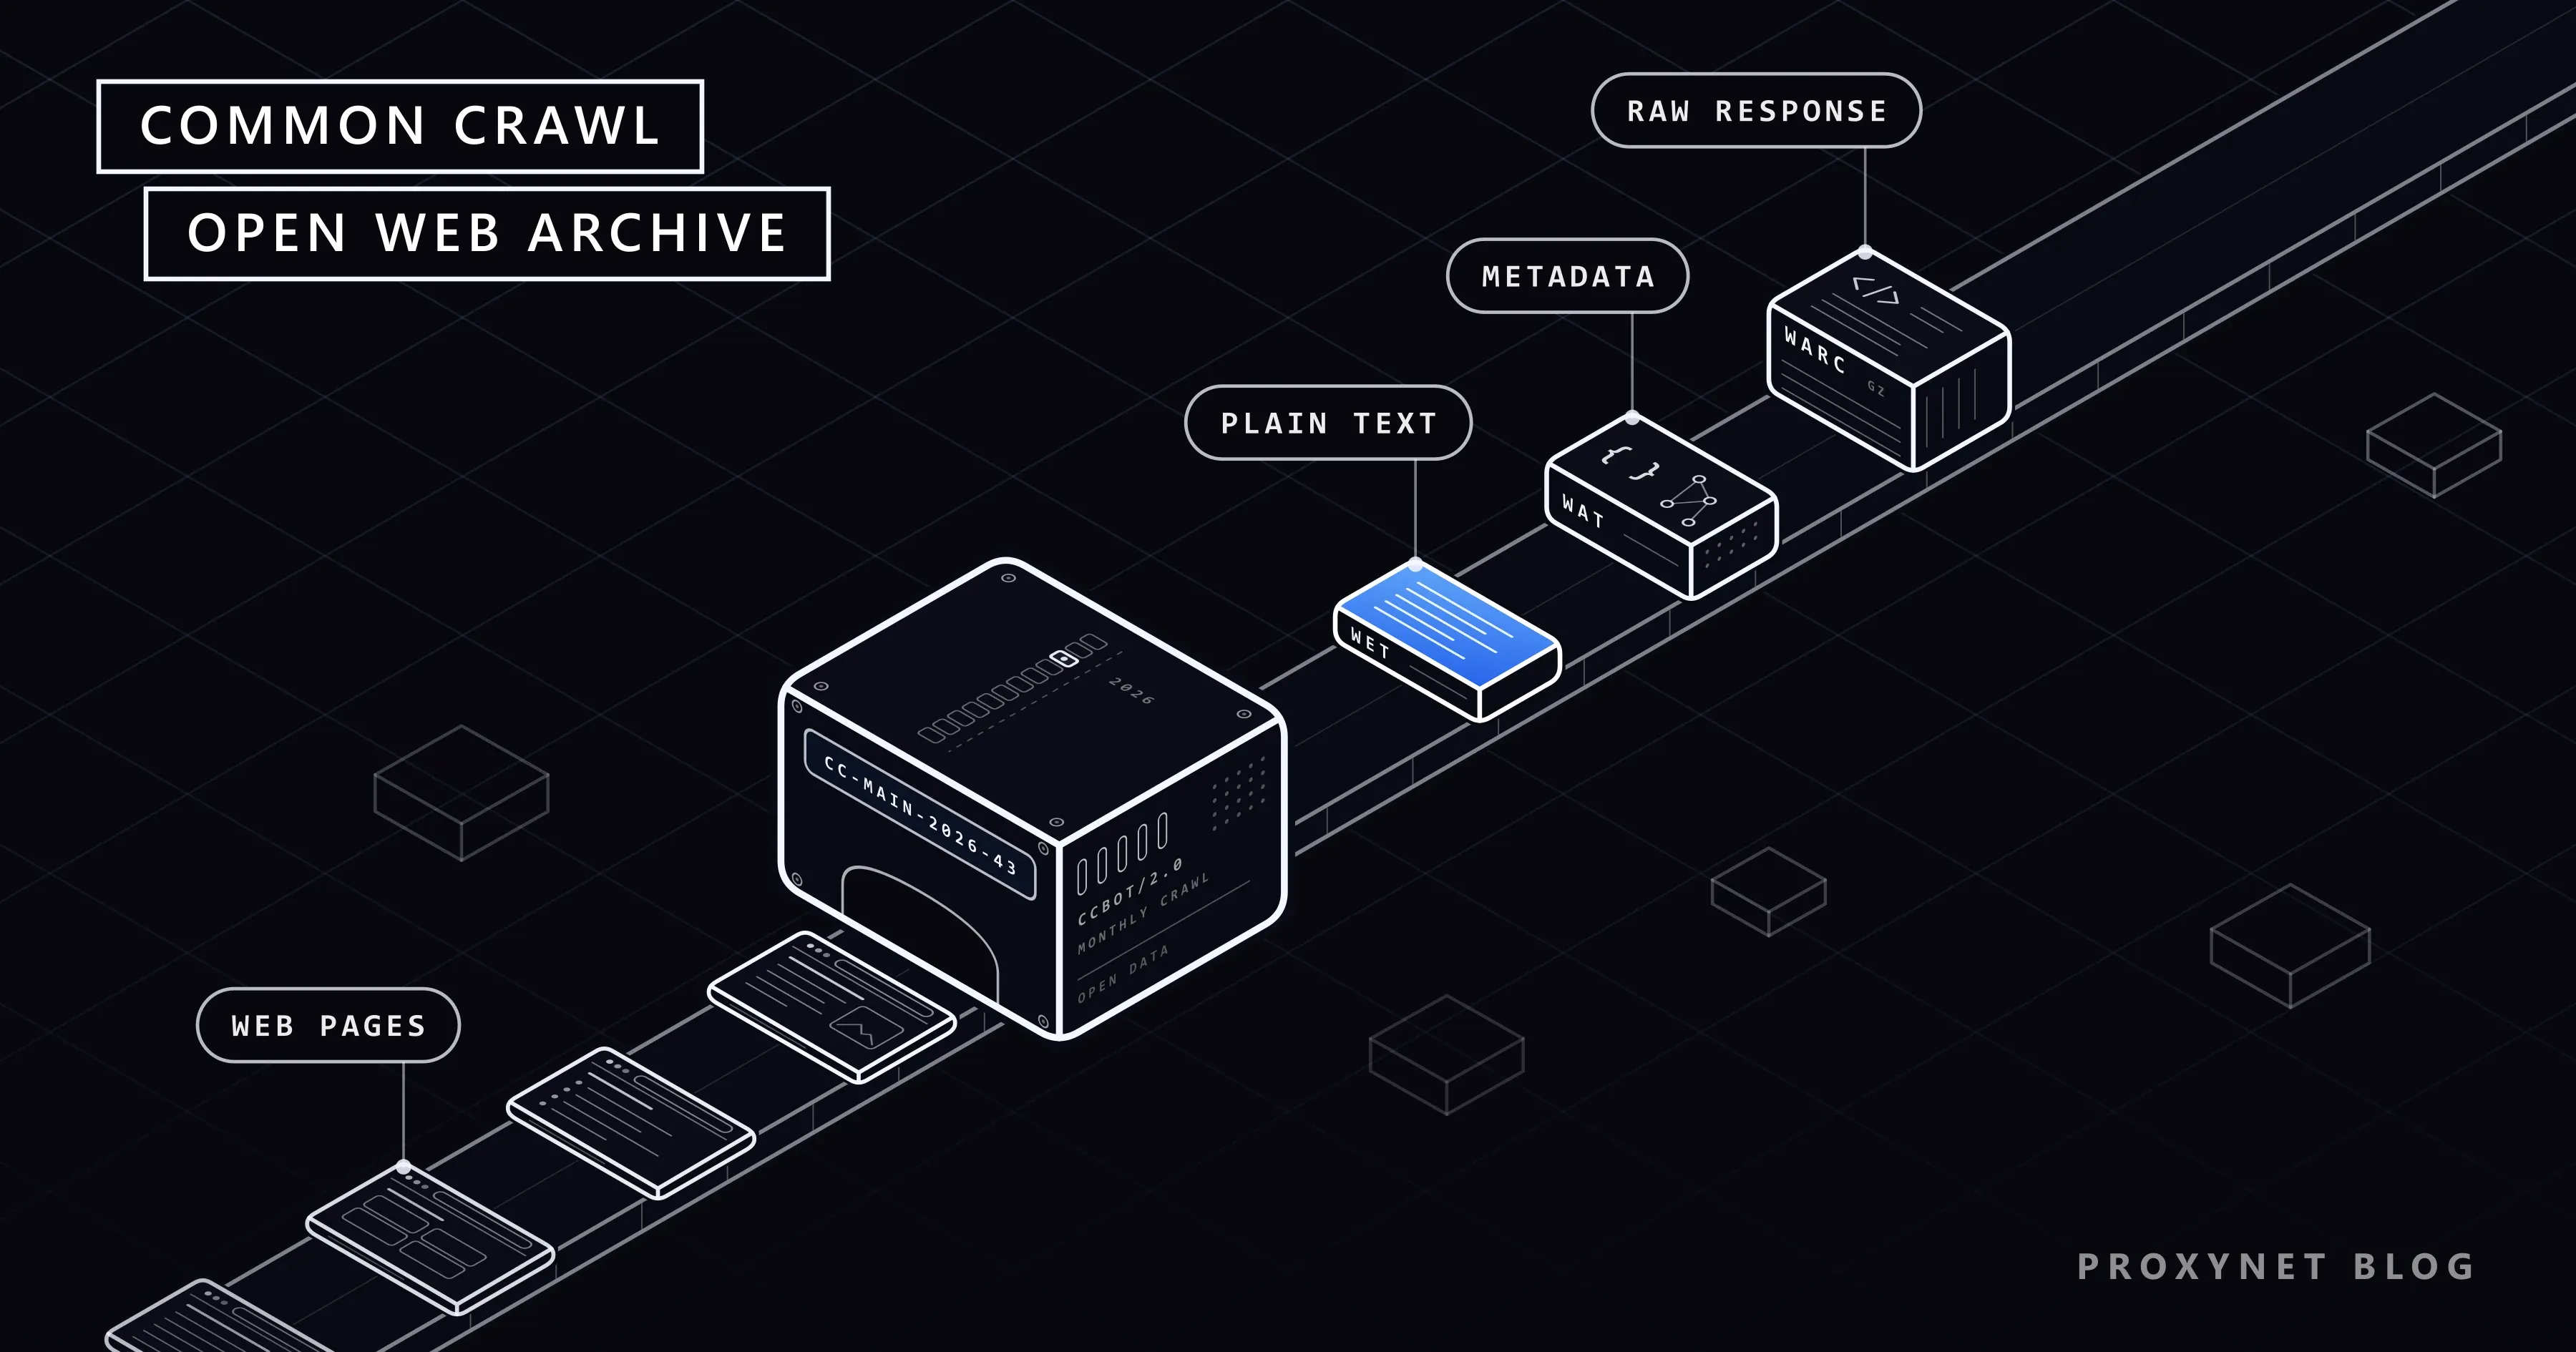
Jeder Crawl wird als Dateien in drei Formaten veröffentlicht, dazu kommen Indizes, die angeben, wo eine bestimmte Seite gespeichert ist.
- WARC (Web ARChive) ist der Rohdatensatz: für jede Seite die HTTP-Anfrage, die CCBot gesendet hat, und die vollständige Antwort einschließlich Header und HTML.
- WAT-Dateien enthalten Metadaten, die aus jedem WARC-Datensatz berechnet und als JSON gespeichert werden: Antwort-Header, die auf der Seite gefundenen Links und weitere Angaben.
- WET (WARC Encapsulated Text)-Dateien enthalten nur den reinen Text, der aus jeder Seite extrahiert wurde.
- Der URL-Index beantwortet die Frage „Wurde diese Adresse erfasst, und wo liegt sie?“. Eine Abfrage liefert den Erfassungszeitpunkt, den HTTP-Status sowie Datei, Offset und Länge des Datensatzes. Eine zweite Form, der URL Index im Parquet-Format, eignet sich, um Millionen Zeilen mit Datenbankwerkzeugen zu filtern.
robots.txt-Dateien und Antworten mit einem anderen Status als 200, etwa Weiterleitungen und Fehler, werden als eigene Sets veröffentlicht. Die Hauptbestandteile des Crawls vom Oktober 2026, mit den komprimierten Größen aus der Ankündigung von Common Crawl:
| Datei | Inhalt | Größe (komprimiert) | Typische Nutzung |
|---|---|---|---|
| WARC | Anfragen, Antworten, rohes HTML | 86,19 TiB | Seiten auf eigene Weise neu auswerten |
| WAT | Header und Links als JSON | 14,06 TiB | Linkgraphen, Website-Analysen |
| WET | Extrahierter reiner Text | 5,85 TiB | Sprachdaten, Textanalyse |
| URL-Index | Erfasste Adressen und Speicherorte | 0,43 TiB | Seiten vor dem Download finden |
Ein Tebibyte (TiB) entspricht etwa 1,1 Terabyte. Der Text ist etwa ein Fünfzehntel so groß wie das Rohdatenarchiv. Ein Team, das nur Wörter braucht, beginnt daher mit WET-Dateien, und eines, das die Seitenstruktur oder einen besseren Textextraktor braucht, mit WARC.
Wie sammelt CCBot Seiten?
Der Crawler von Common Crawl, CCBot, liest zuerst die robots.txt, ruft reines HTML ab und wird langsamer, wenn ein Server an seine Grenzen kommt. Die folgenden Angaben stammen aus der FAQ von Common Crawl, gelesen am 17. November 2026.
- Er prüft die robots.txt. Sperrt die Datei CCBot, wird die Seite nicht abgerufen; Common Crawl prüft die Datei von Zeit zu Zeit erneut.
- Er gibt sich zu erkennen. Die Anfragen tragen den User-Agent
CCBot/2.0 (https://commoncrawl.org/faq/)und kommen aus einigen eigenen IP-Bereichen, die in der FAQ aufgeführt sind. Eine Reverse-DNS-Abfrage zu einer echten IPv4-Adresse von CCBot liefert einen Namen, der aufcrawl.commoncrawl.orgendet; so lässt er sich von Bots unterscheiden, die sich nur den Namen leihen. - Er findet Seiten über Links und Sitemaps. CCBot folgt Links von anderen Websites, kann also Seiten erreichen, die Sie selbst nie verlinkt haben, und liest jede Sitemap, die in der robots.txt angegeben ist.
nofollow-Links respektiert er. - Er ruft HTML ab, ohne Skripte auszuführen. Kein JavaScript, keine Cookies: Eine Seite, deren Inhalt erst im Browser aufgebaut wird, kann im Archiv fast leer sein.
- Er hält ein Tempo ein. Zwischen zwei Anfragen an dieselbe Website wartet er einige Sekunden, bei 429 (zu viele Anfragen) und 5xx-Fehlern zieht er sich zurück, und er befolgt
Crawl-delay. - Er zieht Stichproben. Common Crawl archiviert keine ganzen Websites, sondern behält eine zufällig ausgewählte Teilmenge der Seiten jeder Website.
- Er veröffentlicht. Die Erfassungen werden in WARC-Dateien geschrieben; WAT, WET und die Indizes werden daraus abgeleitet, und der Crawl erscheint unter einer ID wie
CC-MAIN-2026-43.
Wie groß ist Common Crawl und wie oft wird es aktualisiert?
Common Crawl veröffentlicht jeden Monat einen neuen Crawl; 2025 und 2026 erschien für jeden Monat einer. Die offizielle Liste der Crawls ist eine JSON-Datei unter https://index.commoncrawl.org/collinfo.json. Wir haben sie einmal gelesen, am 17. November 2026 um 02:02 UTC; das sind ihre ersten beiden Einträge, unverändert:
[
  {
    "id": "CC-MAIN-2026-43",
    "name": "October 2026 Index",
    "timegate": "https://index.commoncrawl.org/CC-MAIN-2026-43/",
    "cdx-api": "https://index.commoncrawl.org/CC-MAIN-2026-43-index",
    "from": "2026-10-05T10:56:23",
    "to": "2026-10-18T05:34:47"
  },
  {
    "id": "CC-MAIN-2026-39",
    "name": "September 2026 Index",
    "timegate": "https://index.commoncrawl.org/CC-MAIN-2026-39/",
    "cdx-api": "https://index.commoncrawl.org/CC-MAIN-2026-39-index",
    "from": "2026-09-04T13:16:03",
    "to": "2026-09-17T05:59:21"
  },
Die Liste enthielt 129 Einträge. Der neueste, CC-MAIN-2026-43, wurde zwischen dem 5. und dem 18. Oktober 2026 gecrawlt; der älteste deckt 2008 bis 2009 im Format ARC ab, dem Vorgänger von WARC. Jeder Eintrag hat eine cdx-api-Adresse, den Index für diesen Crawl, und die Daten zeigen den Rhythmus: etwa zwei Wochen Crawling, dann eine Pause bis zum nächsten Monat.
Die Ankündigung des Crawls vom Oktober 2026, die Common Crawl am 21. Oktober veröffentlichte, nennt seine Größe: 2,16 Milliarden Seiten oder 371,19 TiB unkomprimiert, von 41,4 Millionen Hosts und 34,3 Millionen registrierten Domains. 830,1 Millionen dieser Seiten lagen unter Adressen, die kein früherer Crawl besucht hatte; mit den übrigen können Forschende dieselbe URL über mehrere Monate vergleichen.
Ein separater Nachrichtendatensatz, CC-NEWS, startete 2016. Er veröffentlicht Artikel von Nachrichtenseiten kurz nach der Erfassung, statt auf die monatliche Veröffentlichung zu warten.
Wer nutzt Common Crawl?
Common Crawl nutzen vor allem diejenigen, die Webseiten in großen Mengen brauchen und nicht selbst Milliarden davon crawlen können:
- Training von Sprachmodellen. Ein großes Sprachmodell (LLM) lernt, indem es Text vorhersagt, und braucht Hunderte Milliarden Wörter; Common Crawl ist die größte kostenlose Quelle dafür.
- Akademische Forschung. Linguisten und Webforscher untersuchen, wie das Web aufgebaut ist, welche Sprachen es verwendet und wie sich Seiten verändern.
- SEO und Linkanalyse. WAT-Dateien listen die Links jeder Seite auf, und Common Crawl baut daraus Webgraphen auf Host- und Domain-Ebene mit Rangwerten wie harmonic centrality und PageRank; der Host-Graph von Mai bis Juli 2026 hatte 240,4 Millionen Knoten und 3,7 Milliarden Kanten.
Am besten dokumentiert ist die Nutzung in Modell-Papers. Das GPT-3-Paper von OpenAI beschreibt 41 monatliche Common-Crawl-Teilmengen (Shards) aus den Jahren 2016 bis 2019: 45 TB komprimierter reiner Text vor dem Filtern und 570 GB danach, zusammen 60 % des Trainingsmixes. Die Autoren behielten Seiten, die hochwertigeren Texten ähnelten, und entfernten fast identische Dokumente.
Das T5-Paper von Google baute C4, den Colossal Clean Crawled Corpus, aus einem einzigen Monat von Common Crawl, April 2019, und behielt nach der Bereinigung etwa 750 GB englischen Text. Bereinigte Datensätze wie C4 erlauben es Teams, Common-Crawl-Text zu nutzen, ohne selbst einen rohen Crawl zu verarbeiten.
Training ist eine andere Aufgabe als Fragen zum Heute zu beantworten. Ein Modell, das auf einer Momentaufnahme von 2019 trainiert wurde, kennt nichts Neueres. Deshalb rufen viele KI-Werkzeuge aktuelle Seiten ab, wenn eine Frage gestellt wird; dieses Muster heißt RAG (Retrieval-Augmented Generation, abrufgestützte Generierung). Unser Leitfaden zu Web Scraping für RAG zeigt, wie diese Seiten zu sauberem Text werden.
Wo liegen die Grenzen von Common Crawl?
Common Crawl ist eine große Stichprobe des öffentlichen Webs, einmal im Monat von einem Ort aus gezogen, und jeder Teil dieses Satzes setzt eine Grenze.
- Eine Stichprobe, nicht das Web. Jede Website ist mit einer zufälligen Teilmenge ihrer Seiten vertreten. Websites, die CCBot sperren, fehlen, Seiten hinter einem Login werden nie abgerufen, und per JavaScript aufgebaute Inhalte sind dünn.
- Momentaufnahmen, keine Live-Daten. Eine Seite, die sich gestern geändert hat, erscheint bis zum nächsten Crawl in ihrer alten Version oder gar nicht. Was zwischen zwei Crawls passiert, steht nicht im Hauptdatensatz.
- Ungleich verteilte Sprachen. Common Crawl erkennt die Sprache jeder Seite mit CLD2, einem Open-Source-Detektor. Seine Sprachstatistik für den Crawl vom Oktober 2026 zeigt 42,56 % Englisch, danach Russisch (6,30 %) und Deutsch (5,77 %); Türkisch lag bei 1,14 %.
- Rauschen und Duplikate. Die T5-Autoren schrieben, dass der größte Teil des aus Common Crawl extrahierten Texts keine natürliche Sprache ist, sondern Menüs, Fehlermeldungen und wiederholter Text. Ernsthafte Anwendungen filtern und deduplizieren zuerst.
- Ein einziger Blickwinkel. CCBot arbeitet aus einer Handvoll IP-Bereiche. Eine Website, die Preise, Sprache oder Inhalte nach dem Standort des Besuchers ändert, antwortet CCBot mit der Version, die für diese Adressen gedacht ist.
Darf man Common-Crawl-Daten frei nutzen?
Die Daten von Common Crawl sind kostenlos herunterladbar, doch die Seiten darin gehören weiterhin denen, die sie veröffentlicht haben. Die Nutzungsbedingungen (zuletzt aktualisiert am 7. März 2024) besagen, dass Common Crawl die gecrawlten Inhalte nicht besitzt, dass Nutzer die Urheberrechte Dritter respektieren müssen und dass sie das Risiko ihrer eigenen Nutzung tragen. KI-Training verbieten die Bedingungen nicht, aber Nutzer müssen Common Crawl von Ansprüchen freistellen, die daraus entstehen.
Ob gecrawlte Seiten für KI-Training verwendet werden dürfen, ist umstritten. Im April 2026 schrieb die News/Media Alliance, ein Verband von US-Verlagen, an Common Crawl und forderte, Inhalte von Verlagen auf Anfrage zu entfernen und KI-Nutzung in den Bedingungen zu verbieten. Ob das Training mit kopierten Seiten rechtmäßig ist, wird vor Gerichten und in Gesetzgebungsverfahren noch verhandelt und unterscheidet sich von Land zu Land; fragen Sie bei einem kommerziellen Projekt einen Anwalt in Ihrem Markt.
Seiten können auch personenbezogene Daten wie Namen und E-Mail-Adressen enthalten. Deren Verarbeitung fällt unter Datenschutzgesetze wie die DSGVO in der EU oder das KVKK in Türkiye, unabhängig davon, wer die Seite zuerst erfasst hat.
Wie können Website-Betreiber Common Crawl ausschließen?
Um CCBot von Ihrer Website fernzuhalten, fügen Sie der robots.txt eine Gruppe für ihn hinzu. Die FAQ von Common Crawl nennt diese zwei Zeilen:
User-agent: CCBot
Disallow: /
Wenn Sie ihn stattdessen nur bremsen möchten, geben Sie ihm eine Wartezeit in Sekunden zwischen zwei Anfragen vor:
User-agent: CCBot
Crawl-delay: 2
Wie Gruppen und Regeln gelesen werden, erklärt unser Leitfaden zur robots.txt. Wer CCBot sperrt, hält damit weder GPTBot noch ClaudeBot oder einen anderen Bot fern; jeder braucht eine eigene Gruppe.
Eine robots.txt-Regel gilt für künftige Besuche; Seiten, die vor ihrer Einführung erfasst wurden, stehen bereits in veröffentlichten Crawls. Für rechtliche Löschanfragen führt Common Crawl eine öffentliche Liste namens Opt-Out Ledger.
Common Crawl, Wayback Machine oder ein eigener Crawl
Common Crawl, die Wayback Machine und ein eigener Crawl speichern alle Kopien von Webseiten, beantworten aber unterschiedliche Fragen.
| Common Crawl | Wayback Machine | Eigener Crawl | |
|---|---|---|---|
| Gedacht für | Massenanalyse durch Programme | Ansehen alter Seiten | Ihre konkrete Frage |
| Nutzung | Dateien laden, Index abfragen | Adresse eingeben, Datum wählen | Die Seiten sammeln, die Sie wählen |
| Aktualität | Monatliche Momentaufnahmen | Wann eine Seite gespeichert wurde | So oft, wie Sie es planen |
| Abdeckung | Eine Stichprobe vieler Websites | Gespeicherte Seiten | Nur Ihre Zielwebsites |
| Kosten | Daten gratis, Rechenleistung auf Ihre Kosten | Kostenlos ansehen | Ihr Aufbau und Betrieb |
Die Wayback Machine des Internet Archive ist für Menschen gebaut: Sie geben eine Adresse ein, wählen in einem Kalender eine Aufnahme und sehen die Seite so, wie sie damals aussah, und jeder kann mit Save Page Now eine einzelne Seite speichern lassen. Diese Seite behandelt unser Leitfaden zur Wayback Machine. Common Crawl hat keine solche Ansicht; seine Dateien sind für Code gedacht, der Millionen Seiten auf einmal liest.
Warum Common Crawl keine aktuellen, lokalen Daten liefern kann
Common Crawl kann Ihnen weder den heutigen Preis eines Produkts in Madrid zeigen noch, wie eine Seite für Besucher in Seoul aussieht, weil es einmal im Monat aus wenigen IP-Bereichen crawlt. Solche Daten müssen für Ihre Frage erhoben werden, zu dem Zeitpunkt und von dem Ort aus, auf die es ankommt.
Teams, die Preise verfolgen oder lokalisierte Seiten prüfen, erfassen diese öffentlichen Seiten selbst: nach Zeitplan, in rücksichtsvollem Tempo, im Rahmen der robots.txt und der Nutzungsbedingungen der Website. Um eine Seite so zu sehen, wie sie ein Besucher in einem bestimmten Land oder einer bestimmten Stadt sieht, muss die Anfrage von dort kommen; ein Residential-Proxy mit Länder- und Städte-Targeting leitet sie über einen Heimanschluss an diesem Ort.
Unsere Web-Crawler-Lösung zeigt, wo Proxys in einem solchen Crawler ihren Platz haben. Vor Common Crawl selbst gehören sie nicht: Die FAQ bittet darum, den Index nicht über Proxy-Netzwerke abzufragen, jeweils nur eine Anfrage mit einem eindeutigen User-Agent zu senden und bei 503-Fehlern langsamer zu werden.
Häufige Fehler
- Common Crawl für das ganze Web halten. Es ist eine Stichprobe; dass eine Seite in einem Crawl fehlt, beweist nichts.
- Mit rohem WET-Text trainieren. Er besteht größtenteils aus Menüs, Hinweisen und Duplikaten; erst filtern und deduplizieren.
- Den Index-Server überlasten. Er hat ein strenges Rate-Limit, und eine IP, die zu viele Anfragen sendet, kann für 24 Stunden gesperrt werden. Für breites Filtern nutzen Sie den URL Index im Parquet-Format mit einem Werkzeug wie Amazon Athena oder Apache Spark.
- Erwarten, dass robots.txt alte Crawls bereinigt. Eine neue Regel wirkt nur auf künftige Besuche.
Entscheidungshilfe
| Bedarf | Empfehlung |
|---|---|
| Breiter Webtext für Forschung oder Modelltraining | WET-Dateien oder ein gefilterter Datensatz wie C4 |
| Wie eine Seite an einem früheren Datum aussah | Die Wayback Machine |
| Welche Websites auf welche verlinken | WAT-Dateien oder die Webgraphen von Common Crawl |
| Ob Ihre Website in Common Crawl ist | Eine langsame Abfrage im URL-Index |
| Ihre Website aus künftigen Crawls heraushalten | Eine CCBot-Gruppe in der robots.txt |
| Heutige Preise oder Seiten aus Sicht eines Landes | Ein eigener, rücksichtsvoller Crawl oder ein verwalteter Dienst |
Häufige Fragen
Ist Common Crawl kostenlos?
Ja. Jeder kann die Daten über HTTPS oder von Amazon S3 herunterladen, ohne Common Crawl etwas zu zahlen; Sie zahlen nur Ihren eigenen Speicher und Ihre Rechenleistung, und Common Crawl empfiehlt, die Daten in us-east-1 zu verarbeiten, der AWS-Region, in der sie liegen. Die Seiten behalten ihr Urheberrecht.
Respektiert Common Crawl die robots.txt?
Ja. CCBot liest die robots.txt vor dem Abruf, überspringt, was für CCBot gesperrt ist, befolgt Crawl-delay und respektiert nofollow-Links. Die FAQ listet seine IP-Bereiche auf, sodass Sie prüfen können, ob ein Besucher, der sich CCBot nennt, echt ist.
Enthält Common Crawl Bilder?
Praktisch nicht. Im Crawl vom Oktober 2026 waren 98,31 % der Erfassungen HTML-Seiten und 1,00 % PDF-Dateien, während Bilder nur etwa 0,001 % ausmachten. Das HTML enthält zwar Bildadressen, aber nicht die Bilddateien.
Was ist der Unterschied zwischen Common Crawl und C4?
Common Crawl ist der rohe monatliche Crawl. C4 ist ein bereinigter englischer Datensatz, den Google-Forschende aus einem Monat davon, April 2019, gebaut haben, indem sie Boilerplate-Zeilen, sehr kurze Seiten, Code, anstößige Wörter und wiederholten Text entfernten; übrig blieben etwa 750 GB.
Kann man Common Crawl wie eine Suchmaschine durchsuchen?
Nein. Es gibt keine Volltextsuche und kein Ranking; der Index findet Erfassungen nur nach Adresse oder Adressmuster. Wer den Text durchsuchen will, muss WET-Dateien mit eigenen Werkzeugen verarbeiten.
Wie prüfe ich, ob meine Website in Common Crawl ist?
Öffnen Sie index.commoncrawl.org, wählen Sie einen Crawl und suchen Sie mit einem Platzhalter nach Ihrer Domain, etwa example.com/*. Die Ergebnisse listen jede erfasste URL mit Erfassungszeitpunkt und HTTP-Status auf. Senden Sie immer nur eine Abfrage auf einmal, denn der Server hat ein Rate-Limit.
Fazit
Common Crawl ist eine kostenlose, offene Kopie einer großen Stichprobe des öffentlichen Webs, die CCBot etwa einmal im Monat erfasst und die als Rohseiten (WARC), Metadaten (WAT), reiner Text (WET) und URL-Indizes erscheint. Sie steht hinter einem großen Teil des KI-Trainings und der Webforschung, ist aber eine periodische Stichprobe aus einem einzigen Blickwinkel, muss stark gefiltert werden, und ihre Seiten behalten ihr Urheberrecht. Website-Betreiber steuern CCBot über die robots.txt. Wenn Ihre Daten aktuell oder lokal sein müssen, erheben Sie sie in rücksichtsvollem Tempo oder fragen Sie unser Vertriebsteam nach unserer verwalteten Seitenextraktion.